1/43 Basic IPv6 – adresacja IPv6 w systemie Linux

Budowa adresu, typy, kompresja, konfiguracja i narzędzia

Protokół IPv6 – od adresu do diagnostyki w systemie Linux

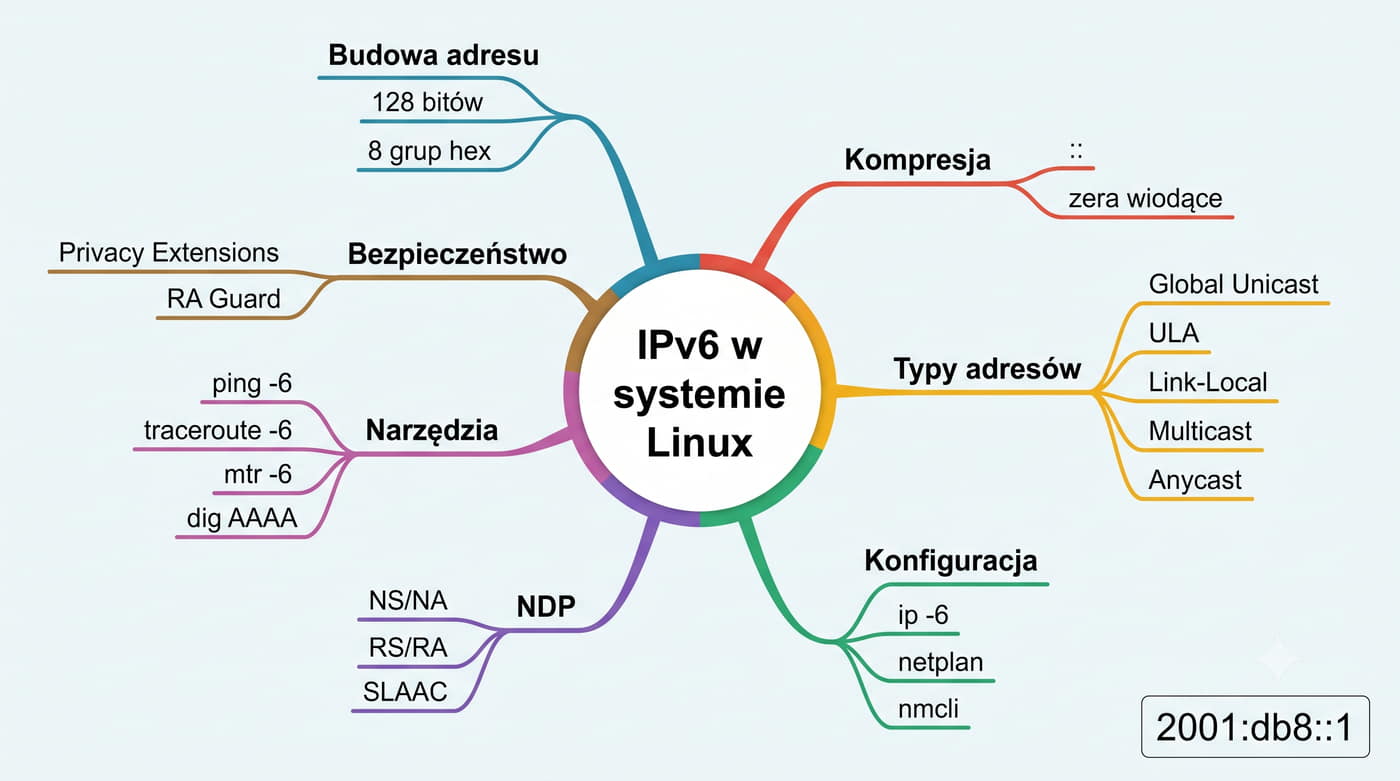
Prezentacja obejmuje kompleksowo adresację IPv6: budowę 128-bitowego adresu, reguły kompresji, typy adresów (global unicast, unique local, link-local, multicast, anycast), konfigurację w systemie Linux i na routerze, oraz narzędzia diagnostyczne: ping -6, traceroute -6, mtr -6, ip -6, ss -6, dig AAAA.

Każdy temat ilustrowany przykładami i diagramami ASCII.

Szczególny nacisk położono na praktyczną konfigurację – od dodania adresu IPv6 na interfejsie, przez ustawienie bramy domyślnej, po trwałą konfigurację w netplan, /etc/network/interfaces i nmcli.

Omówiono również SLAAC jako zamiennik DHCP z IPv4.
Protokół IPv6 został zdefiniowany w dokumencie RFC 8200 (STD 86) w lipcu 2017 roku, a jego głównym celem było zastąpienie starzejącego się protokołu IPv4. Decyzja o stworzeniu nowej wersji wynikała przede wszystkim z przewidywanego wyczerpania puli adresów IPv4, której limit wynosi około 4,3 miliarda adresów. W chwili obecnej, według danych Google, ruch IPv6 stanowi około czterdziestu ośmiu procent całego ruchu internetowego na świecie, a w Polsce odsetek ten systematycznie rośnie. Operatorzy tacy jak Orange, Play czy T-Mobile oferują już IPv6 w swoich sieciach stacjonarnych i mobilnych, co wymusza na administratorach znajomość tego protokołu. IPv6 wprowadza nie tylko większą przestrzeń adresową, ale także usprawnienia w budowie nagłówka, zintegrowane bezpieczeństwo IPsec oraz automatyczną konfigurację SLAAC. W trakcie prezentacji student pozna zarówno podstawy teoretyczne, jak i praktyczne umiejętności konfiguracji w systemie Linux, co jest niezbędne w codziennej pracy administratora sieci. W odróżnieniu od IPv4 w IPv6 nie stosuje się translacji adresów NAT, co przywraca zasadę komunikacji bezpośredniej między hostami. Dodatkową zaletą jest uproszczona budowa nagłówka o stałej długości czterdziestu bajtów, co przyspiesza przetwarzanie pakietów przez routery. Znajomość IPv6 staje się standardem wymaganym przez pracodawców w branży teleinformatycznej.

2/43 Streszczenie

NDP zastępuje ARP: ip -6 neigh show.

IPv6 używa 128-bitowych adresów w notacji colon-hex.

Osiem grup po 16 bitów: 2001:0db8:0000:0000:0000:ff00:0042:8329.

Kompresja: pomiń zera wiodące, zastąp jeden ciąg zer podwójnym dwukropkiem: 2001:db8::ff00:42:8329.

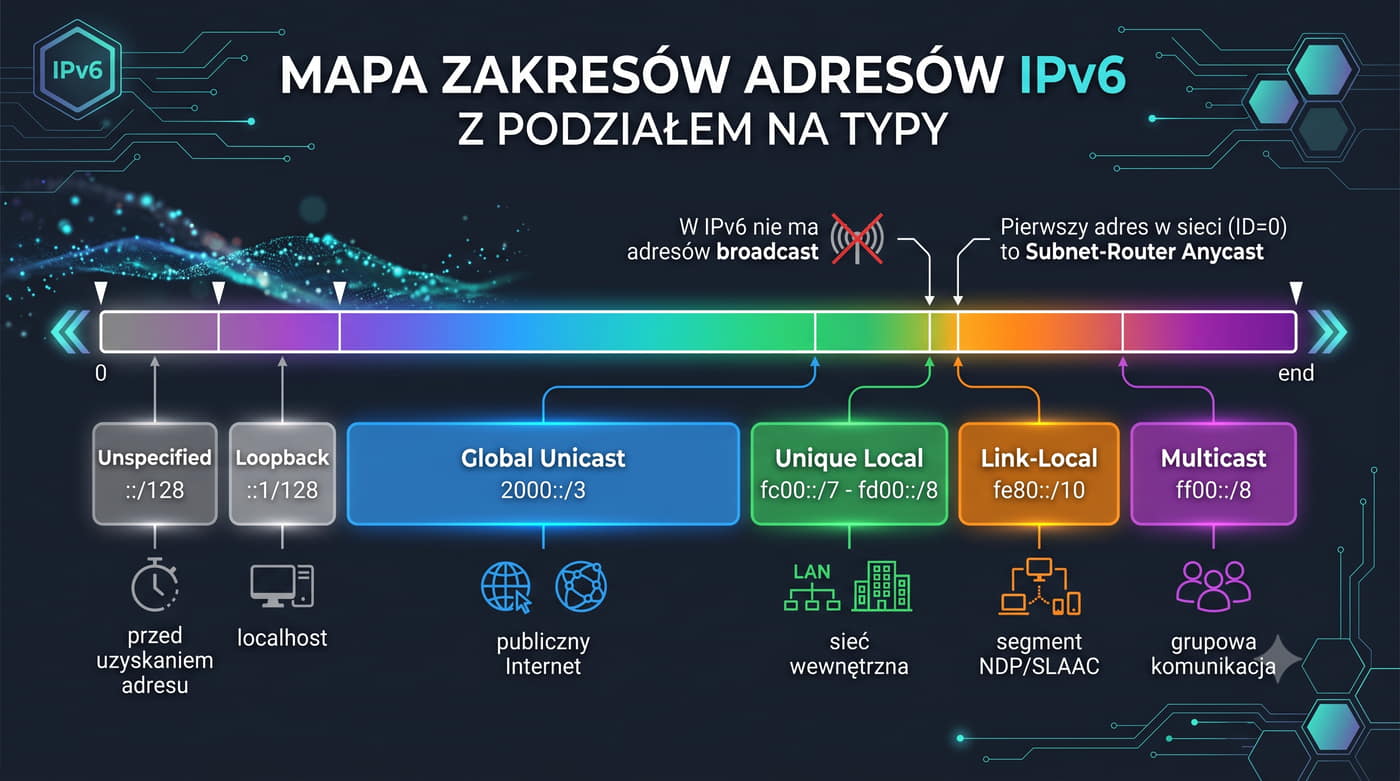
Główne typy: Global Unicast (2000::/3) – adres publiczny, Unique Local (fd00::/8) – prywatny, Link-Local (fe80::/10) – automatyczny, Multicast (ff00::/8) – grupowy, Anycast.

Konfiguracja w Linux: ip -6 addr add 2001:db8::1/64 dev eth0, brama: ip -6 route add default via 2001:db8::1.

Narzędzia: ping -6, traceroute -6, mtr -6, ss -6, dig AAAA.

Protokół NDP zdefiniowany w RFC 4861 pełni w IPv6 funkcje, które w IPv4 realizowały ARP, ICMP Router Discovery i ICMP Redirect. Dzięki zastosowaniu adresów multicast zamiast broadcast NDP jest wydajniejszy i mniej obciąża sieć. Notacja colon-hex, choć na pierwszy rzut oka wydaje się skomplikowana, po opanowaniu reguł kompresji staje się czytelniejsza niż zapis dziesiętny IPv4. Adresacja IPv6 całkowicie eliminuje potrzebę stosowania maski podsieci, zastępując ją długością prefiksu zapisywaną w notacji CIDR. Mechanizm SLAAC umożliwia hostom automatyczne skonfigurowanie adresu bez udziału serwera DHCP, co stanowi znaczące uproszczenie administracji siecią. Każdy interfejs w IPv6 obowiązkowo posiada adres link-local, który służy do komunikacji w obrębie pojedynczego segmentu sieci. Narzędzia diagnostyczne takie jak ping czy traceroute w wersji dla IPv6 działają analogicznie do swoich odpowiedników z IPv4, różniąc się jedynie składnią. Praktyczna umiejętność posługiwania się tymi narzędziami jest niezbędna podczas rozwiązywania problemów sieciowych w środowiskach produkcyjnych.

3/43 Dlaczego IPv6? – ograniczenia IPv4
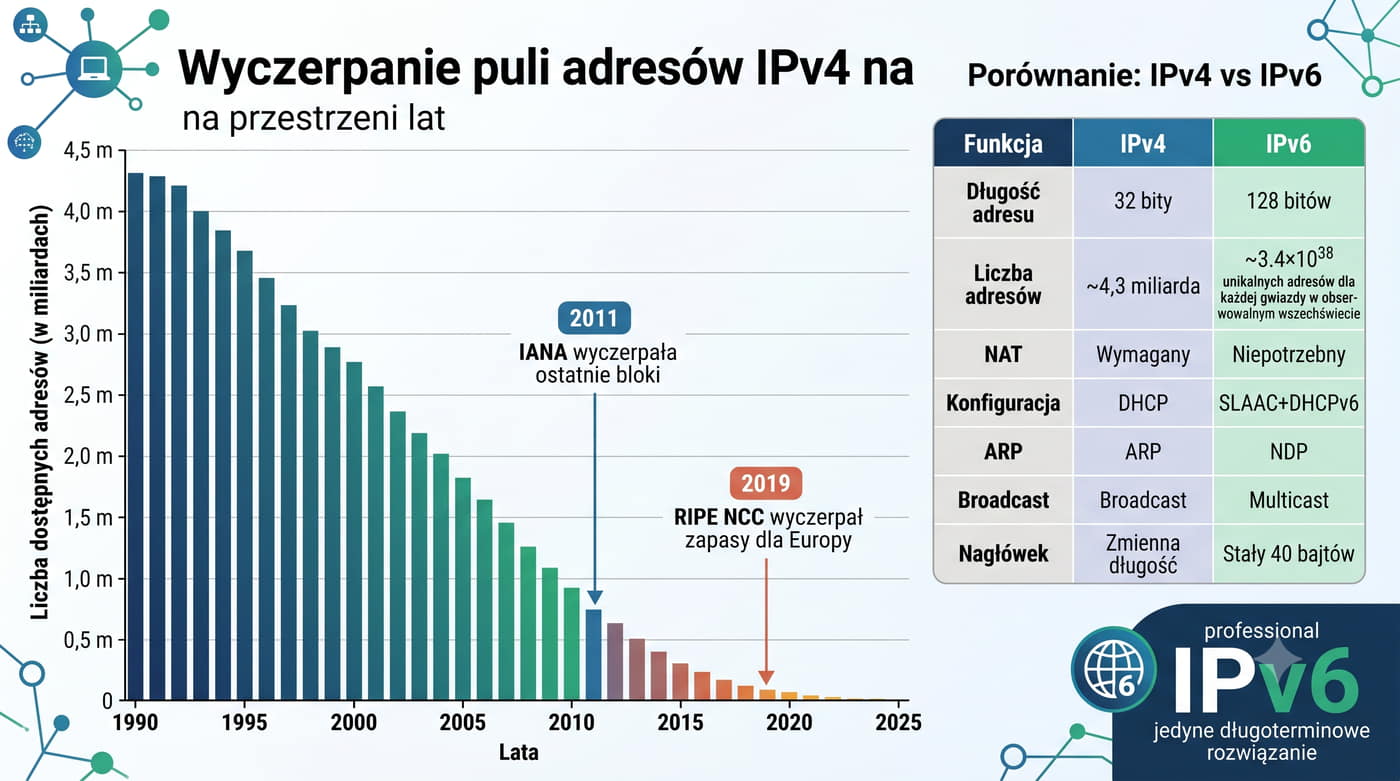
CechaIPv4IPv6
Długość adresu32 bity128 bitów
Liczba adresów~4,3 x 10^9~3,4 x 10^38
NATWymaganyNiepotrzebny (end-to-end)
KonfiguracjaDHCPSLAAC + DHCPv6
ARPBroadcast ARPNDP (multicast)
FragmentacjaW routerachTylko na krańcach (PMTUD)
BroadcastTakNie – multicast
NagłówekZmienna długośćStały 40 bajtów

Rozwiązania tymczasowe (NAT) mają wady.

IPv6 rozwiązuje te problemy.

IPv4 ma 32 bity = ~4,3 miliarda adresów.

Ostatnie wolne bloki adresów IPv4 zostały przydzielone przez organizację IANA w lutym 2011 roku, a europejski rejestr RIPE NCC wyczerpał swoje zapasy w listopadzie 2019 roku. Oznacza to, że nowi dostawcy usług internetowych muszą nabywać adresy IPv4 na rynku wtórnym, co generuje dodatkowe koszty. Mechanizm NAT, choć tymczasowo rozwiązał problem braku adresów, wprowadza poważne ograniczenia dla aplikacji wymagających bezpośredniej komunikacji, takich jak VoIP, gry sieciowe czy transmisje strumieniowe. Ponadto NAT utrudnia identyfikację hostów w logach, co ma znaczenie z punktu widzenia bezpieczeństwa i audytu. IPv6 przywraca model komunikacji end-to-end, co oznacza, że każdy host może mieć własny, publicznie routowalny adres. Dodatkowo stały nagłówek IPv6 o długości czterdziestu bajtów upraszcza przetwarzanie pakietów przez routery. Brak sumy kontrolnej w nagłówku IPv6 wynika z faktu, że jej weryfikację zapewniają już protokoły warstwy drugiej i wyższych. Te zmiany czynią IPv6 protokołem nowocześniejszym i wydajniejszym od swojego poprzednika.

4/43 Literatura i źródła
  • IPv6 Fundamentals – Rick Graziani, Cisco Press
  • IPv6 Security – Scott Hogg, Eric Vyncke
  • TCP/IP Illustrated, Vol. 1 (2nd ed.) – Kevin Fall, W. R. Stevens
  • RFC 8200 – IPv6 Specification, RFC 4291 – Addressing Architecture
  • RFC 4861 – Neighbor Discovery (NDP)
  • Strony man: man ip, man ping, man traceroute
  • test-ipv6.com – test dostępności IPv6

Literatura dotycząca IPv6 jest obszerna i warto sięgać zarówno po pozycje książkowe, jak i oryginalne dokumenty RFC. Książka Ricka Grazianiego IPv6 Fundamentals to doskonałe wprowadzenie dla początkujących, zawierające liczne przykłady konfiguracji na urządzeniach Cisco. Z kolei publikacja IPv6 Security autorstwa Scotta Hogga i Erica Vyncke skupia się na aspektach bezpieczeństwa, które w IPv6 różnią się znacząco od IPv4. Dokument RFC 8200 stanowi aktualną specyfikację protokołu IPv6 i powinien być podstawowym źródłem wiedzy dla każdego administratora. Warto również regularnie odwiedzać stronę test-ipv6.com, która pozwala sprawdzić, czy dane łącze internetowe obsługuje IPv6. Podręcznik TCP/IP Illustrated autorstwa Stevensa i Falla to klasyczna pozycja, która w przystępny sposób wyjaśnia działanie protokołów sieciowych. Strony podręcznika systemowego man ip, man ping i man traceroute są nieocenione podczas codziennej pracy z IPv6 w systemie Linux. Dokument RFC 4291 opisuje architekturę adresacji IPv6 i definiuje poszczególne typy adresów.

5/43 Sprawdzenie czy IPv6 działa w systemie
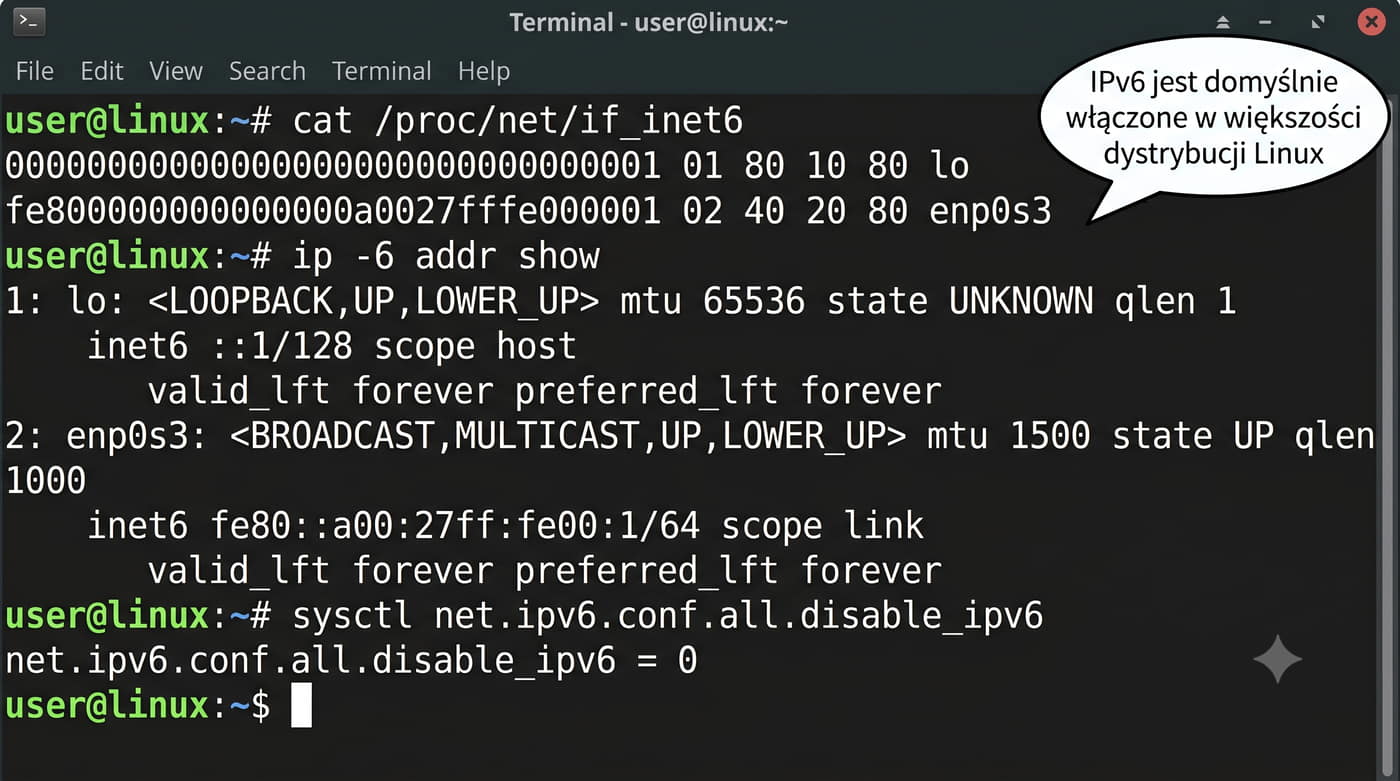
cat /proc/net/if_inet6
# fe8000000000000000027fffe000001 02 40 20 80 enp0s3
# 0000000000000000000000000000001 01 80 10 80 lo

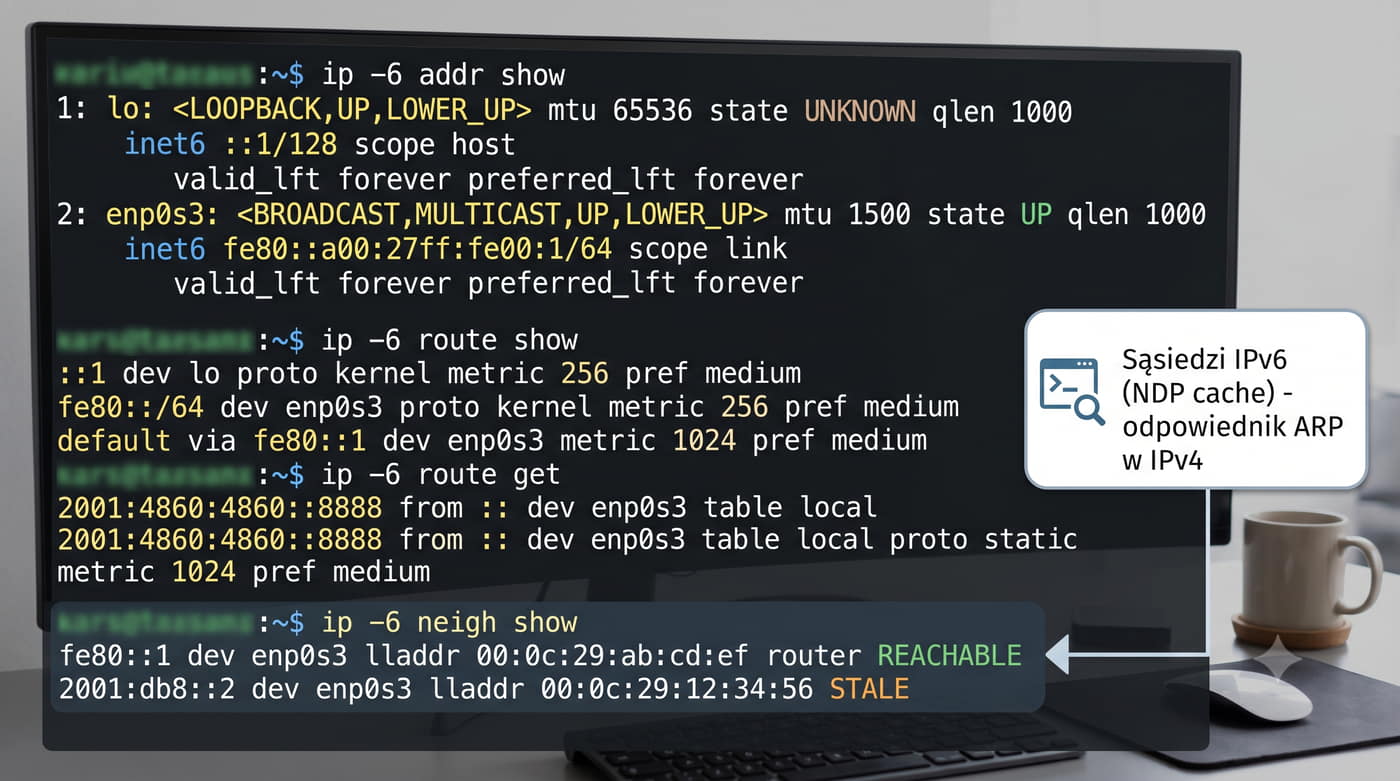
ip -6 addr show
# 1: lo: inet6 ::1/128 scope host
# 2: enp0s3: inet6 fe80::a00:27ff:fe00:1/64 scope link

sysctl net.ipv6.conf.all.disable_ipv6
# = 0 (włączone)

IPv6 jest domyślnie włączone w większości dystrybucji Linux.

Link-Local (fe80::/10) jest automatycznie przypisywany do każdego interfejsu – zawsze obecny.

Plik /proc/net/if_inet6 w systemie Linux zawiera listę wszystkich adresów IPv6 przypisanych do interfejsów, zapisanych w formacie heksadecymalnym bez dwukropków. Polecenie ip -6 addr show dostarcza bardziej czytelnej informacji, pokazując adresy z prefiksami, zakresami oraz stanem interfejsów. Adres link-local o prefiksie fe80::/10 jest generowany automatycznie dla każdego interfejsu i służy do podstawowej komunikacji w segmencie sieci. Jeśli wartość parametru disable_ipv6 wynosi zero, oznacza to, że stos IPv6 w jądrze jest aktywny i gotowy do pracy. W niektórych dystrybucjach, zwłaszcza serwerowych, IPv6 może być celowo wyłączone ze względów polityki bezpieczeństwa. Aby tymczasowo wyłączyć IPv6, można użyć polecenia sysctl -w net.ipv6.conf.all.disable_ipv6=1, jednak zmiana ta nie jest trwała po restarcie. Do trwałego wyłączenia należy dodać odpowiedni wpis do pliku /etc/sysctl.conf lub umieścić plik konfiguracyjny w katalogu /etc/sysctl.d. Warto pamiętać, że wyłączenie IPv6 może wpłynąć na działanie niektórych aplikacji, które preferują ten protokół.

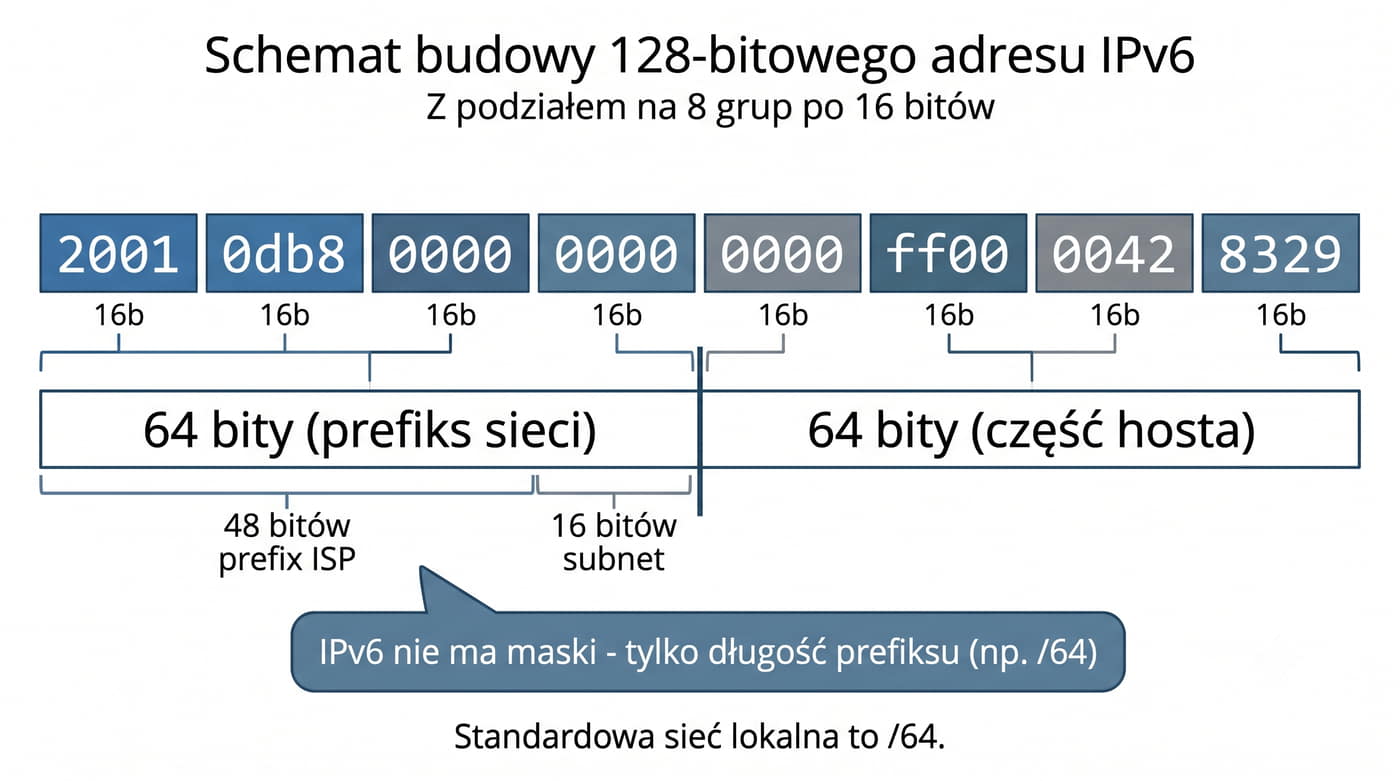
6/43 Budowa adresu IPv6 – 128 bitów, 8 grup
  2001:0db8:0000:0000:0000:ff00:0042:8329
  ││││ ││││ ││││ ││││ ││││ ││││ ││││ ││││
  16b  16b  16b  16b  16b  16b  16b  16b
  └─────────────── 128 bitów ─────────────┘

Struktura:

  |------ 64 bity (prefiks sieci) ------|------- 64 bity (część hosta) ------|
  | 2001:0db8:0000:0000  | 0000:ff00:0042:8329  |
  └─ 48 bitów prefix ISP ─┴─ 16 bitów subnet ─┘
IPv6 nie ma maski – tylko długość prefiksu (np. /64).

Standardowo: /64 dla sieci lokalnej.

Adres IPv6 ma 128 bitów zapisanych jako 8 grup po 16 bitów (4 cyfry hex), oddzielonych dwukropkami:

Prefiks = 64 bity, część hosta = 64 bity.

Adres IPv6 składa się ze stu dwudziestu ośmiu bitów podzielonych na osiem szesnastobitowych grup, co daje w zapisie heksadecymalnym trzydzieści dwa znaki. Każda grupa zawiera cztery cyfry szesnastkowe, a zakres pojedynczej grupy wynosi od 0000 do FFFF włącznie. Podział na część sieciową i hosta standardowo przebiega na granicy sześćdziesiątego czwartego bitu, co daje w każdej sieci lokalnej ogromną przestrzeń adresową. W odróżnieniu od IPv4 w IPv6 nie stosuje się maski podsieci, lecz długość prefiksu zapisywaną po ukośniku, na przykład /64. Prefiks sieci jest przydzielany przez dostawcę usług internetowych i zazwyczaj ma długość od /32 do /56. Administrator wewnątrz organizacji może swobodnie dzielić otrzymany blok na mniejsze podsieci, zachowując zawsze /64 dla sieci LAN. Adresy o prefiksie dłuższym niż /64, na przykład /127, są stosowane wyłącznie na łączach punkt-punkt. Znajomość budowy adresu IPv6 stanowi fundament do zrozumienia mechanizmów takich jak SLAAC czy EUI-64.

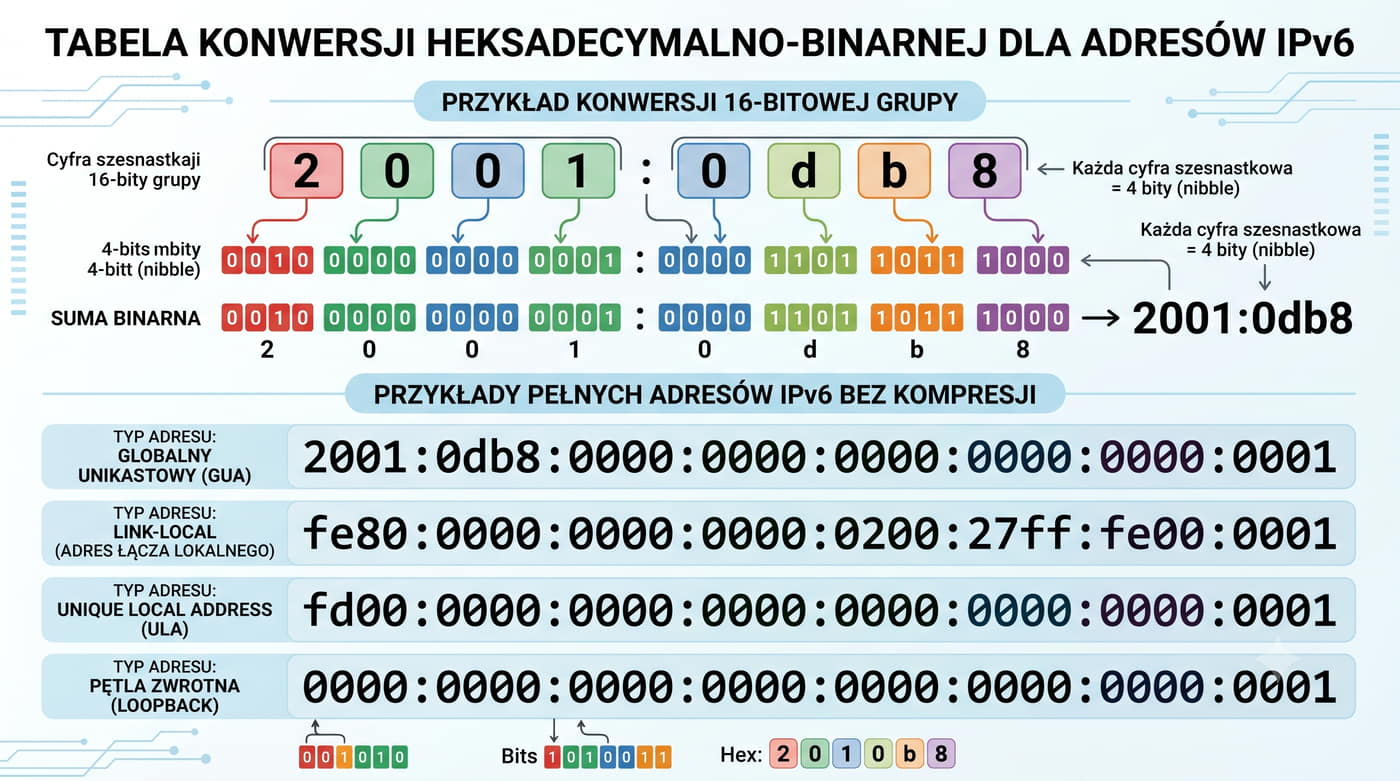
7/43 Zapis heksadecymalny (colon-hex notation)
  0010 0000 0000 0001 : 0000 1101 1011 1000
  2  0  0  1  0  d  b  8
  = 2001  : 0db8

Przykłady pełnych adresów:

2001:0db8:0000:0000:0000:0000:0000:0001  (Global)
fe80:0000:0000:0000:0200:27ff:fe00:0001  (Link-Local)
fd00:0000:0000:0000:0000:0000:0000:0001  (ULA)
0000:0000:0000:0000:0000:0000:0000:0001  (Loopback)

Każda grupa to 16 bitów = 4 cyfry hex (0–9, a–f).

Zapis heksadecymalny w IPv6 wykorzystuje cyfry od zera do dziewięciu oraz litery od a do f, gdzie każda cyfra odpowiada czterem bitom w zapisie binarnym. Przykładowo grupa 2001 w systemie szesnastkowym oznacza w binarnym ciąg 0010 0000 0000 0001. Konwersja między systemem binarnym a heksadecymalnym jest znacznie prostsza niż zamiana na system dziesiętny, co stanowi jedną z przyczyn wyboru właśnie tego zapisu. W zapisie colon-hex każda z ośmiu grup jest oddzielona dwukropkiem, a wiodące zera w danej grupie można pominąć. Pełny adres IPv6 bez kompresji zawiera trzydzieści dwa znaki heksadecymalne oraz siedem dwukropków, czyli łącznie trzydzieści dziewięć znaków – to także maksymalna długość poprawnego zapisu adresu, na przykład 1234:5678:9abc:def1:2345:6789:abcd:ef01. Po kompresji zgodnej z RFC 5952 zapis może być krótszy, jak w przykładzie 2001:db8:1234:5678:90ab:cdef:1234:5678, który liczy trzydzieści osiem znaków. Dla ułatwienia obliczeń warto korzystać z kalkulatorów takich jak ipv6calc lub sipcalc, które automatyzują konwersje. W systemie Linux adresy IPv6 można również konwertować za pomocą narzędzia python3 z biblioteką ipaddress.

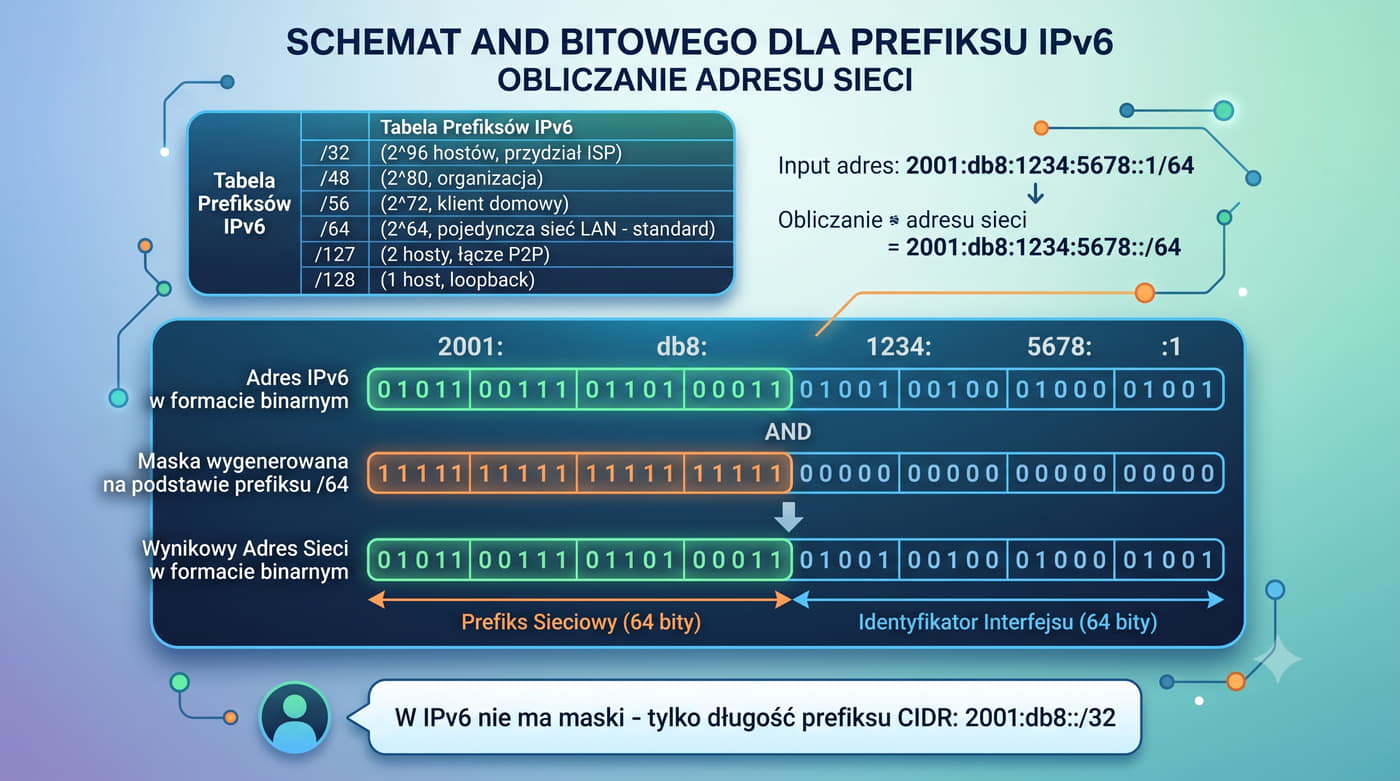
8/43 Prefiks – odpowiednik maski w IPv6
PrefiksHostówZastosowanie
/322^96Przydział ISP (LIR)
/482^80Przydział dla organizacji
/562^72Klient domowy
/642^64Pojedyncza sieć LAN (standard!)
/1272Łącze P2P (RFC 6164)
/1281Pojedynczy adres (loopback)

Obliczenia AND bitowe – jak w IPv4.

Prefiks – liczba bitów sieci od lewej.

W IPv6 nie ma maski – tylko długość prefiksu CIDR: 2001:db8::/32.

Adres 2001:db8:1234:5678::1/64 → sieć 2001:db8:1234:5678::/64.

Długość prefiksu w notacji CIDR określa liczbę bitów identyfikujących sieć, licząc od najbardziej znaczącego bitu adresu. Na przykład prefiks /64 oznacza, że pierwsze sześćdziesiąt cztery bity stanowią część sieciową, a pozostałe bity identyfikują interfejs. W hierarchii przydziału adresów organizacja IANA przydziela rejestrom regionalnym, takim jak RIPE NCC dla Europy, adresy w jednostkowych blokach /12. Rejestr regionalny przydziela dostawcy internetowemu (LIR, Local Internet Registry) blok /32, który ISP dzieli na mniejsze prefiksy /48 lub /56 dla klientów. Klient może następnie podzielić otrzymany blok na sieci /64 dla poszczególnych sieci lokalnych, na przykład osobno dla sieci gościnnej, IoT i podstawowej. Obliczanie adresu sieci w IPv6 wykonuje się za pomocą bitowej koniunkcji adresu i prefiksu, analogicznie jak w IPv4. W praktyce do podziału na podsieci warto używać narzędzi takich jak ipv6calc, które automatyzują obliczenia. Zrozumienie prefiksów IPv6 jest kluczowe przy projektowaniu schematu adresacji w nowej infrastrukturze sieciowej.

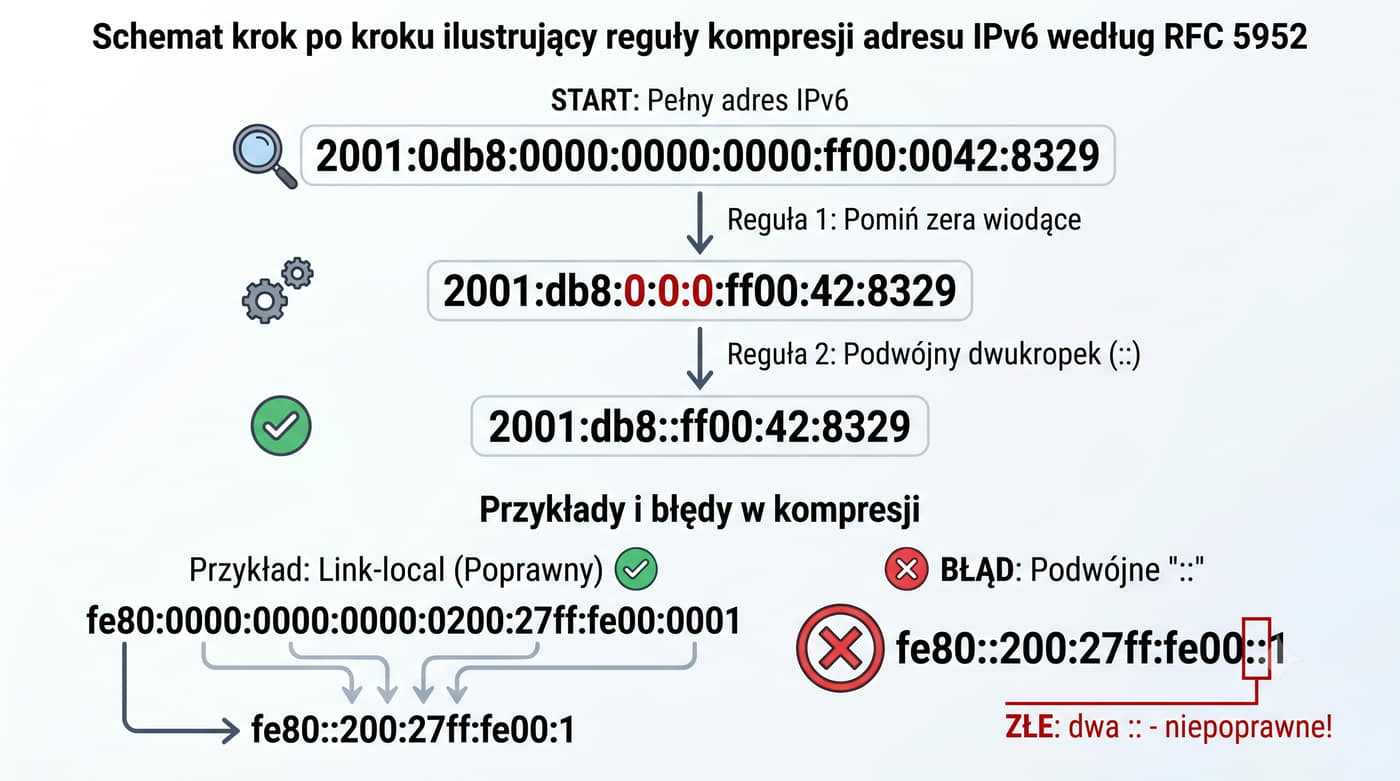
9/43 Kompresja adresu – reguły (RFC 5952)
  2001:0db8:0000:0000:0000:ff00:0042:8329
  →  2001:db8:  0:  0:  0:  ff00:  42:  8329
  fe80:0000:0000:0000:0200:27ff:fe00:0001
  → fe80::200:27ff:fe00:1

  # ZŁE: fe80::200:27ff:fe00::1  (dwa :: – niepoprawne!)
Reguła 1: Pomiń zera wiodące w każdej grupie.
Reguła 2: Podwójny dwukropek (::) – jeden ciąg grup zerowych zastąp ::. Można użyć tylko raz!

Kompresja adresów IPv6 została ustandaryzowana w dokumencie RFC 5952, który precyzyjnie określa zasady skracania zapisu. Pierwsza reguła nakazuje pominięcie zer wiodących w każdej grupie, na przykład zapis 0db8 zamienia się na db8. Druga reguła pozwala zastąpić jeden ciąg kolejnych grup zerowych podwójnym dwukropkiem, ale tylko raz w adresie. Najczęściej popełnianym błędem przez początkujących jest użycie podwójnego dwukropka więcej niż jeden raz, co czyni adres niejednoznacznym i niezgodnym ze specyfikacją. Zgodnie z RFC 5952 podwójny dwukropek powinien zastępować jak najdłuższy ciąg zer, a w przypadku kilku ciągów o równej długości pierwszy z nich. Adres loopback ::1 po dekompresji rozwija się do 0000:0000:0000:0000:0000:0000:0000:0001. Dekompresja adresu polega na zliczeniu grup widocznych po kompresji i uzupełnieniu brakujących do ośmiu grup zerami. Zrozumienie reguł kompresji jest niezbędne przy ręcznym wpisywaniu adresów w plikach konfiguracyjnych.

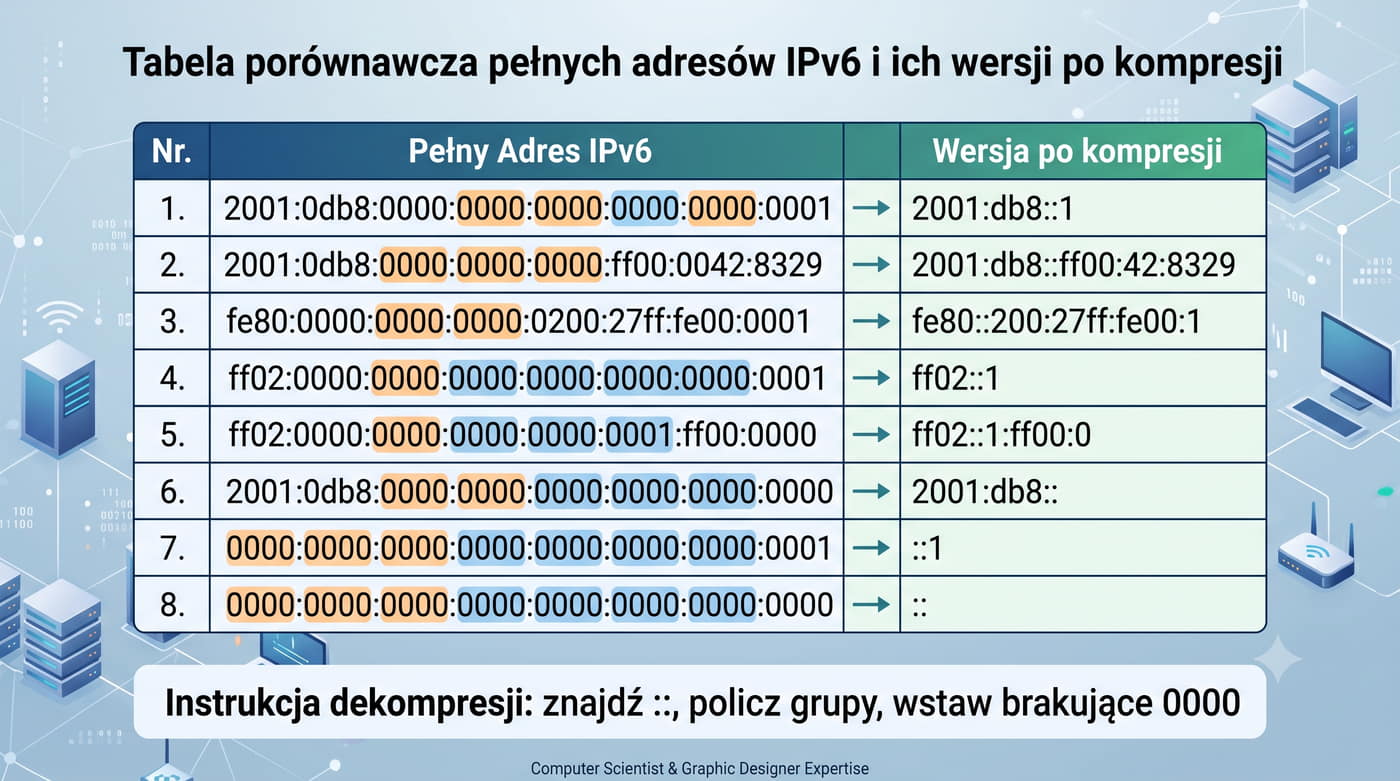
10/43 Kompresja – przykłady
Pełny adresPo kompresji
2001:0db8:0000:0000:0000:0000:0000:00012001:db8::1
2001:0db8:0000:0000:0000:ff00:0042:83292001:db8::ff00:42:8329
fe80:0000:0000:0000:0200:27ff:fe00:0001fe80::200:27ff:fe00:1
ff02:0000:0000:0000:0000:0000:0000:0001ff02::1
ff02:0000:0000:0000:0000:0001:ff00:0000ff02::1:ff00:0
2001:0db8:0000:0000:0000:0000:0000:00002001:db8::
0000:0000:0000:0000:0000:0000:0000:0001::1
0000:0000:0000:0000:0000:0000:0000:0000::

Dekompresja: 1) znajdź ::, 2) policz grupy, 3) wstaw brakujące 0000.

Przykład: 2001:db8::ff00:42:8329 = 5 grup → 3 grupy zer → 2001:0db8:0000:0000:0000:ff00:0042:8329.

W tabeli przedstawiono osiem przykładów adresów IPv6 przed i po kompresji, które ilustrują działanie reguł RFC 5952 w praktyce. Szczególnie wart uwagi jest adres 2001:db8::, w którym po podwójnym dwukropku nie występuje żadna grupa, co oznacza, że wszystkie cztery ostatnie grupy są zerowe. Adres ::1 to adres pętli zwrotnej, który w pełnej wersji rozwija się do siedmiu grup zerowych i jedynki na końcu. Zapis :: z samym podwójnym dwukropkiem oznacza adres nieokreślony, czyli wszystkie sto dwadzieścia osiem bitów równe zero. W przypadku adresów mieszanych IPv4-mapped, takich jak ::ffff:10.0.0.1, ostatnie trzydzieści dwa bity zapisuje się w notacji dziesiętnej typowej dla IPv4. Dekompresja adresu skompresowanego wymaga policzenia widocznych grup i uzupełnienia brakujących do ośmiu. Na przykład adres 2001:db8::ff00:42:8329 ma pięć grup, więc brakujące trzy grupy o wartości 0000 należy wstawić między podwójnym dwukropkiem a grupą ff00. Ćwiczenia praktyczne na dekompresji adresów są doskonałym sposobem na utrwalenie reguł kompresji.

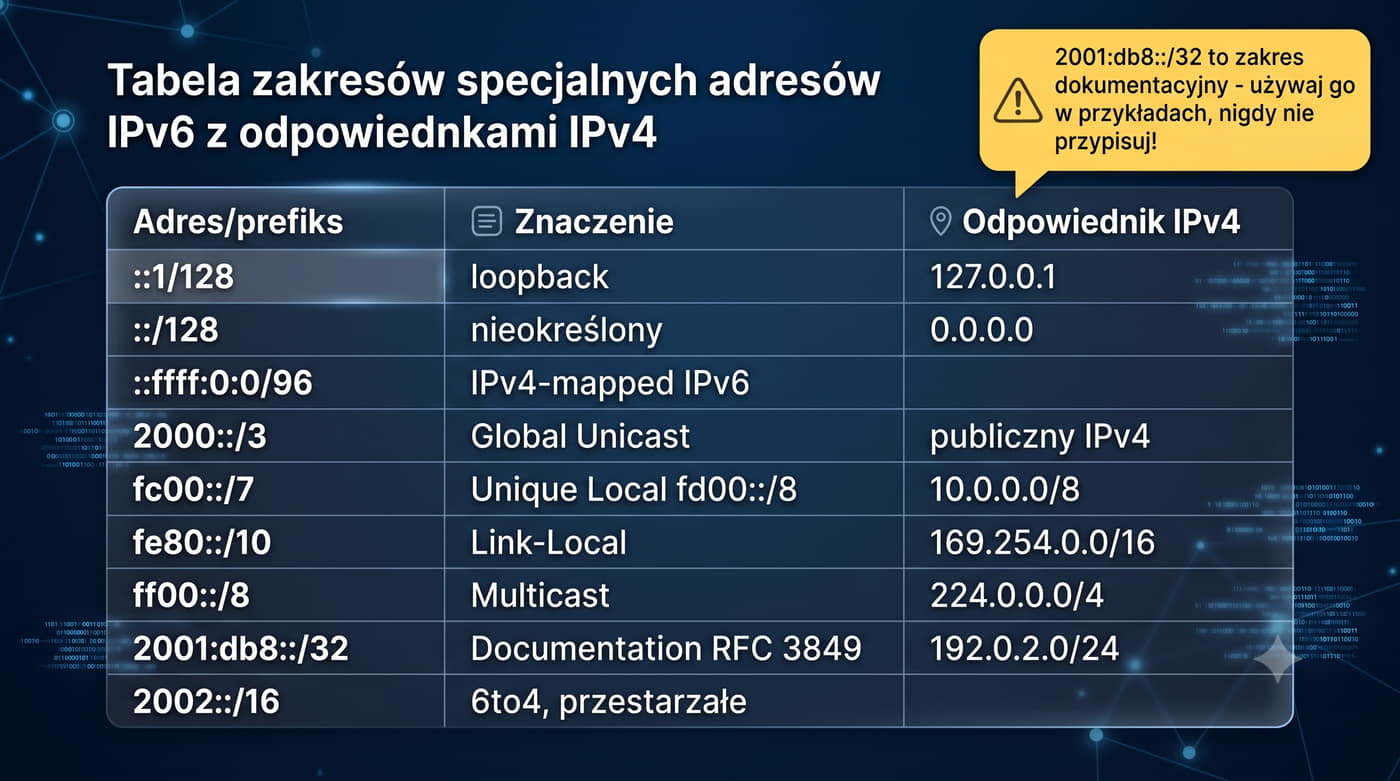
11/43 Specjalne adresy i prefiksy IPv6
Adres/prefiksZnaczenieOdp. IPv4
::1/128Loopback127.0.0.1
::/128Nieokreślony (unspecified)0.0.0.0
::ffff:0:0/96IPv4-mapped IPv6
2000::/3Global UnicastPubliczny IPv4
fc00::/7Unique Local (fd00::/8)10.0.0.0/8
fe80::/10Link-Local169.254.0.0/16
ff00::/8Multicast224.0.0.0/4
2001:db8::/32Documentation (RFC 3849)192.0.2.0/24
2002::/166to4 (przestarzałe)
Pamiętaj: 2001:db8::/32 to zakres dokumentacyjny – używaj go w przykładach, nigdy nie przypisuj!

Adres pętli zwrotnej ::1/128 w IPv6 odpowiada adresowi 127.0.0.1 w IPv4 i służy do komunikacji wewnątrz tego samego hosta. Adres nieokreślony ::/128 jest używany przez host jako adres źródłowy przed uzyskaniem właściwego adresu, na przykład podczas procesu SLAAC. Adresy IPv4-mapped ::ffff:0:0/96 umożliwiają translację między protokołami i są stosowane w mechanizmach przejściowych. Zakres dokumentacyjny 2001:db8::/32 jest zarezerwowany wyłącznie do celów przykładów i testów w literaturze technicznej. Adresy 6to4 z prefiksem 2002::/16 są obecnie uznawane za przestarzałe ze względu na problemy z niezawodnością i bezpieczeństwem. Z punktu widzenia projektowania sieci najważniejsze są trzy główne typy: global unicast do komunikacji publicznej, unique local do sieci wewnętrznych oraz link-local do komunikacji w segmencie. Prefiks 2000::/3 obejmuje wszystkie adresy global unicast od 2000:: do 3fff:ffff:ffff:ffff:ffff:ffff:ffff:ffff. Prawidłowe rozróżnianie tych typów jest niezbędne podczas planowania architektury adresacji IPv6.

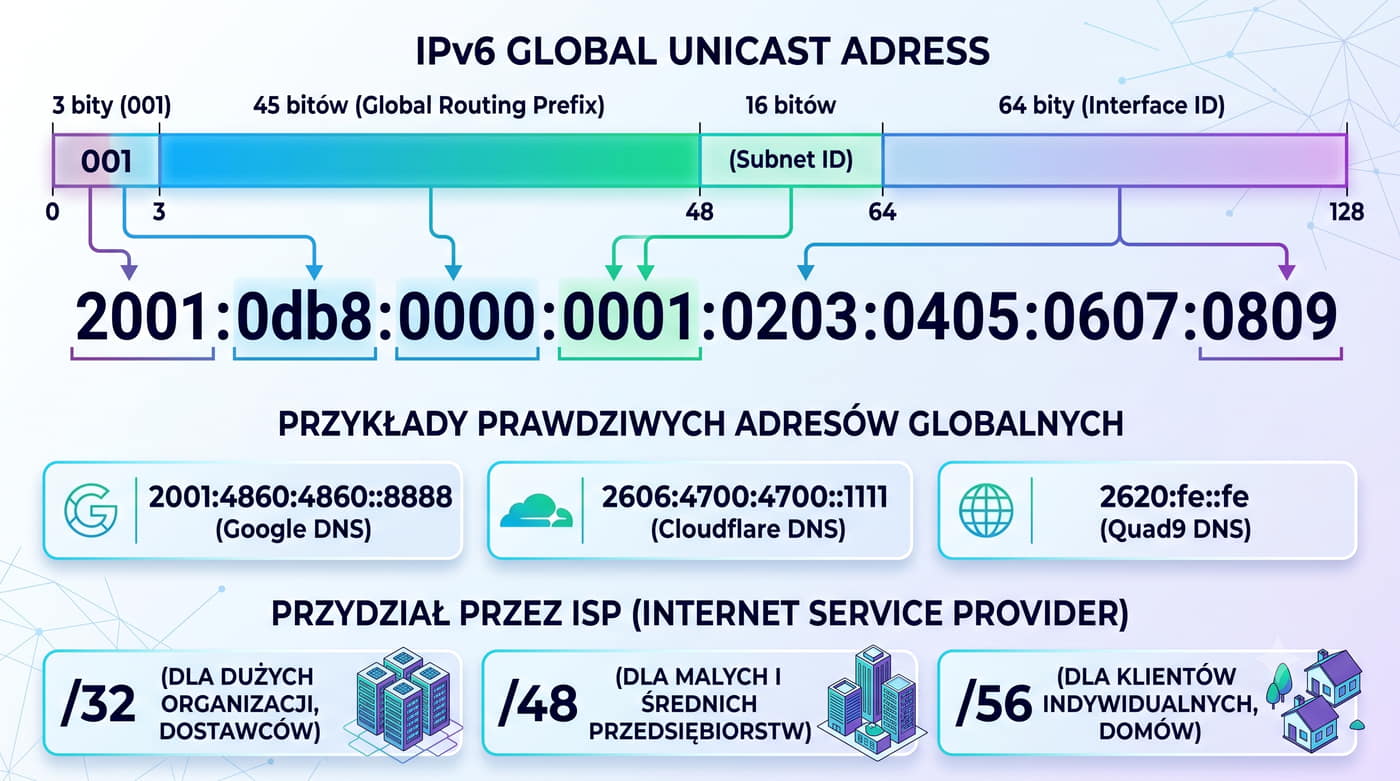
12/43 Global Unicast – adres publiczny (2000::/3)
  | 3 bity | 45 bitów  | 16 bitów  | 64 bity  |
  | 001  | Global Routing  | Subnet ID  | Interface ID  |
  | 2000:  |  db8:  | 0000:  | ...  |
  └── /48 ────┘  ISP  └─ /56 ─┘  klient  └──── /64 ──────┘  LAN

Prawdziwe adresy:

2001:4860:4860::8888  (Google DNS)
2606:4700:4700::1111  (Cloudflare DNS)
2620:fe::fe  (Quad9 DNS)

Przydzielany przez ISP lub RIR.

Adres publiczny, routowany w Internecie.

Global Unicast to podstawowy typ adresu IPv6 służący do komunikacji w publicznym Internecie, identyfikowany przez prefiks 2000::/3. W hierarchii przydziału trzy bity początkowego prefiksu 001 oznaczają, że adres należy do globalnej przestrzeni unicast. Dostawca usług internetowych otrzymuje od rejestru regionalnego blok /32, który następnie dzieli na mniejsze prefiksy /48 lub /56 dla swoich klientów. Klient może wydzielić z otrzymanego bloku poszczególne sieci /64 dla różnych segmentów swojej infrastruktury. W budowie adresu global unicast wyróżnia się część global routing, subnet ID oraz interface ID, przy czym interfejs może być generowany automatycznie przez SLAAC lub konfigurowany ręcznie. Przykładem rzeczywistych adresów global unicast są serwery DNS Google 2001:4860:4860::8888 czy Cloudflare 2606:4700:4700::1111. W systemie Linux adres global unicast można sprawdzić za pomocą polecenia ip -6 addr show, szukając adresów spoza zakresu fe80::. Posiadanie globalnego adresu IPv6 eliminuje konieczność stosowania NAT, co przywraca pełną przejrzystość komunikacji sieciowej.

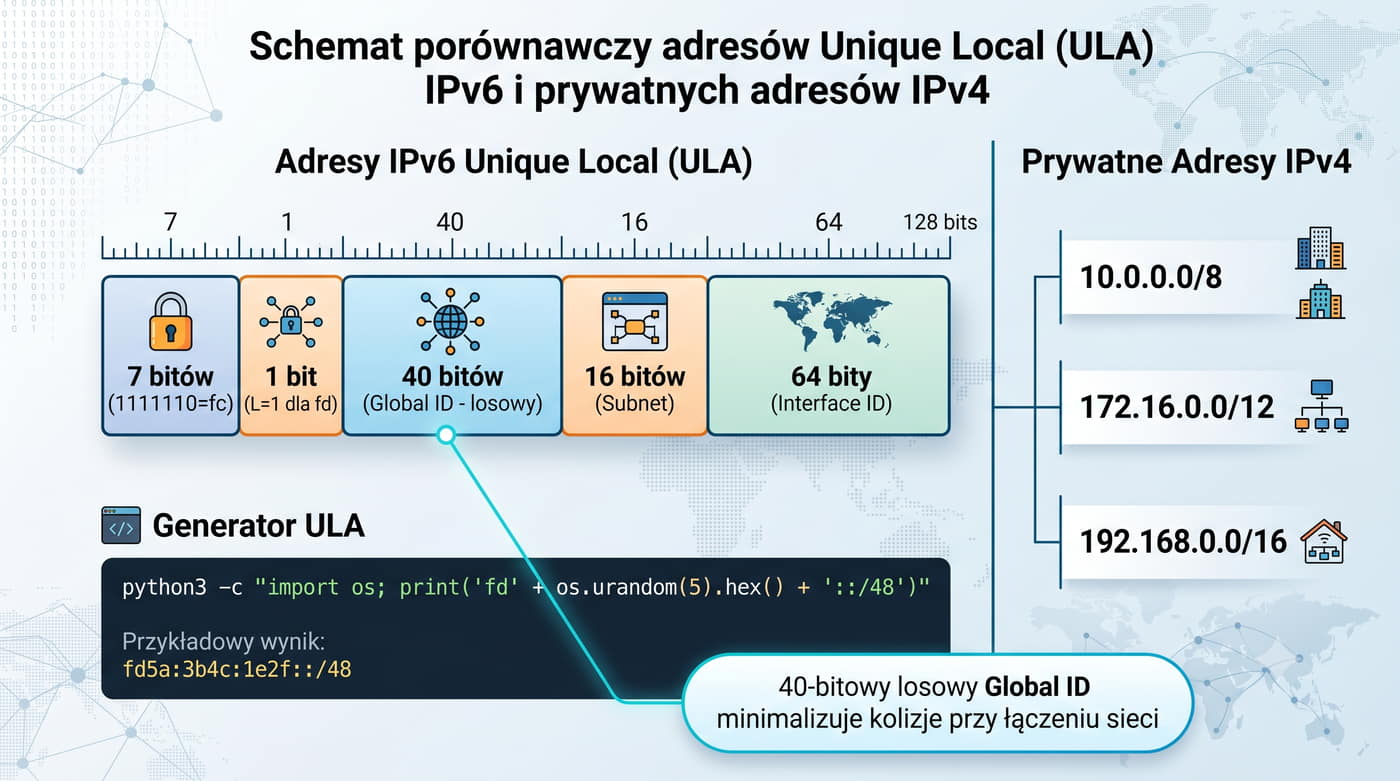
13/43 Unique Local – ULA (fc00::/7, fd00::/8)

Budowa (RFC 4193):

  | 7b | 1b | 40 bitów (Global ID)  | 16b  | 64 bity  |
  | fc | 0  | losowy identyfikator  | Subnet| Interface ID  |
  └─ /48 ────┘

Generowanie ULA:

python3 -c "import os; h=os.urandom(5).hex(); print('fd'+h[0:2]+':'+h[2:6]+':'+h[6:10]+'::/48')"
# fd21:db33:9c90::/48
Różnica od IPv4: 40-bitowy losowy Global ID – minimalizuje kolizje przy łączeniu sieci.

Nieroutowane w Internecie.

Używane w sieciach wewnętrznych.

Odpowiednik prywatnych adresów IPv4 (10.0.0.0/8, 192.168.0.0/16).

Adresy Unique Local zdefiniowane w dokumencie RFC 4193 stanowią odpowiednik prywatnych adresów IPv4, takich jak 10.0.0.0/8 czy 192.168.0.0/16. W odróżnieniu od IPv4 adresy ULA zawierają czterdziestobitowy losowy identyfikator globalny, który minimalizuje ryzyko kolizji przy łączeniu sieci. Prefiks fc00::/7 został zarezerwowany dla ULA, przy czym aktualnie zdefiniowany jest tylko blok fd00::/8 oznaczający lokalnie przypisane adresy. Adresy ULA mogą być routowane wewnątrz organizacji, ale nie są propagowane w publicznym Internecie. Do wygenerowania unikalnego prefiksu ULA można użyć narzędzi takich jak polecenie python3 z losowym ciągiem bajtów lub skorzystać z generatorów online. W przeciwieństwie do adresów link-local adresy ULA mają zakres site i mogą być używane do komunikacji między różnymi podsieciami w obrębie organizacji. Konfiguracja adresów ULA w systemie Linux odbywa się ręcznie lub za pomocą DHCPv6. W przypadku potrzeby dostępu do Internetu z adresu ULA konieczne jest zastosowanie translacji NAT64 lub posiadanie dodatkowego adresu global unicast.

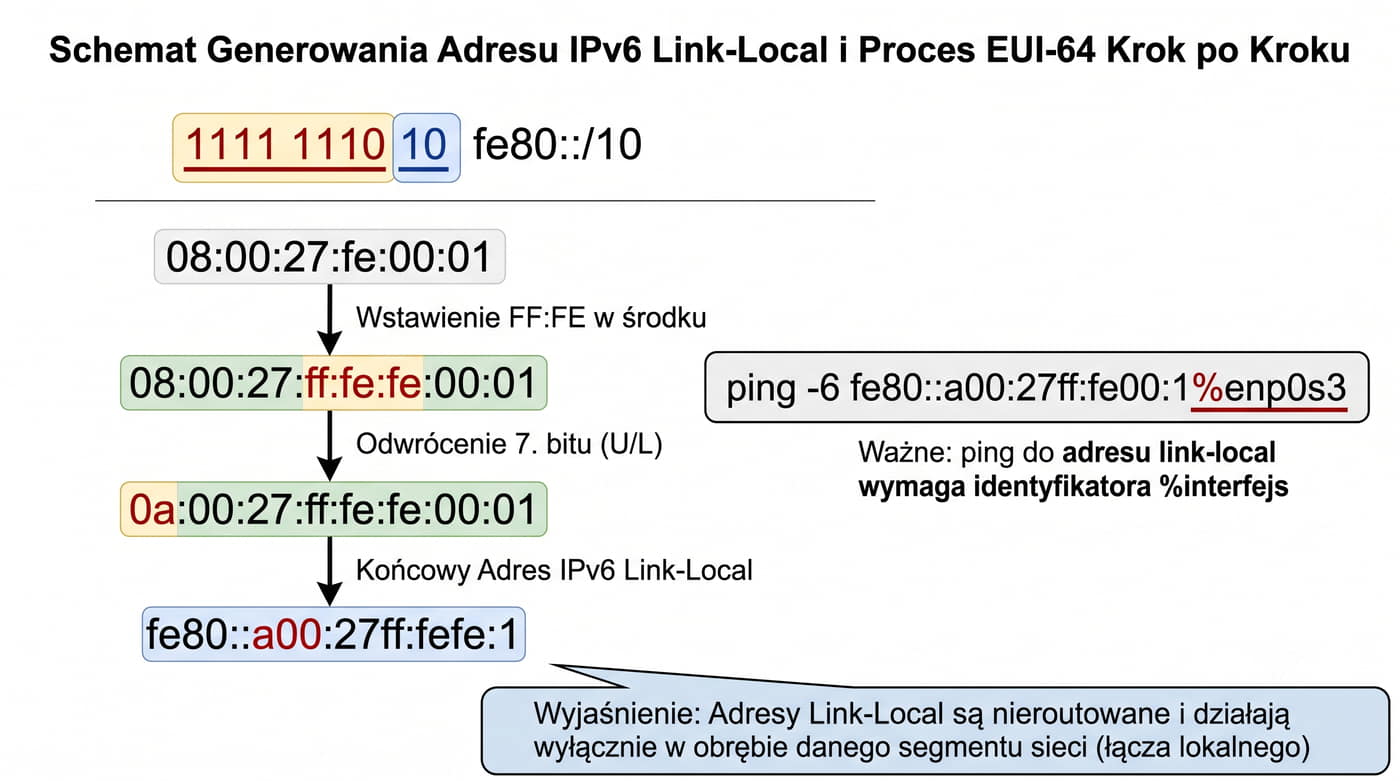
14/43 Link-Local – fe80::/10
  fe80:0000:0000:0000:[interface_id]
  1111 1110 1000 0000 ... (10 bitów = fe80::/10)

Interface ID z EUI-64:

  MAC: 08:00:27:fe:00:01
   EUI-64: 0a:00:27:ff:fe:fe:00:01  (wstaw ff:fe, odwróć 7 bit)
   Adres: fe80::a00:27ff:fefe:1
ping -6 fe80::a00:27ff:fefe:1%enp0s3
Ważne: ping do link-local wymaga %interfejs:

Automatycznie przypisywany do każdego interfejsu.

Wymagany przez NDP, SLAAC, DHCPv6. Nieroutowany – działa tylko w segmencie.

Adres link-local o prefiksie fe80::/10 jest automatycznie przypisywany do każdego interfejsu IPv6 i nie wymaga żadnej konfiguracji ze strony administratora. Adresy te nie są routowane poza segment sieci, co oznacza, że działają wyłącznie w obrębie pojedynczego łącza fizycznego lub VLAN. Generowanie identyfikatora interfejsu dla adresu link-local odbywa się według mechanizmu EUI-64, który przekształca czterdziestoośmiobitowy adres MAC w sześćdziesięcioczworobitowy identyfikator. W mechanizmie EUI-64 wstawia się szesnastobitowy identyfikator FFFE w środek adresu MAC, a następnie odwraca siódmy bit, czyli bit U/L. W nowoczesnych systemach operacyjnych domyślnie stosuje się losowe identyfikatory interfejsu zgodnie z RFC 8981, co utrudnia śledzenie hosta po adresie. Aby wykonać ping na adres link-local, należy w systemie Linux dodać identyfikator interfejsu po znaku procentu, na przykład ping -6 fe80::1%enp0s3. Zapamiętanie tego wymogu jest kluczowe, ponieważ pominięcie interfejsu spowoduje błąd wysyłania pakietu. Adresy link-local odgrywają fundamentalną rolę w działaniu protokołów NDP, SLAAC i DHCPv6.

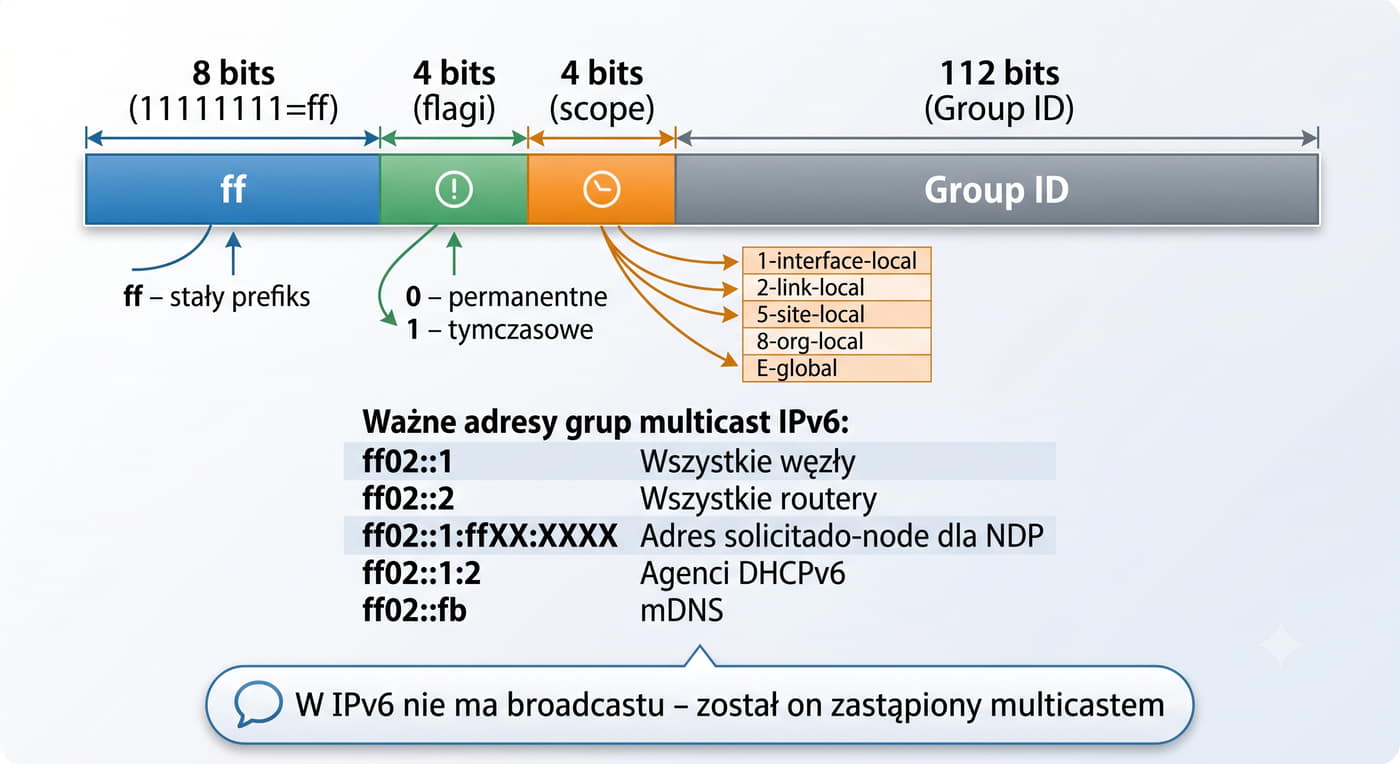
15/43 Multicast – ff00::/8
  | 8 bitów | 4b | 4b | 112 bitów grupa  |
  | 11111111|flag|scope| Group ID  |
  | ff  |  |  |  |

Ważne grupy multicast:

ff02::1  # Wszystkie węzły IPv6 (odp. broadcast)
ff02::2  # Wszystkie routery
ff02::1:ffXX:XXXX  # Solicited-Node (dla NDP)
ff02::1:2  # DHCPv6
ff02::fb  # mDNS

Scope:1 (interface), 2 (link), 5 (site), 8 (org), E (global).

W IPv6 nie ma broadcastu – zastąpiony multicastem.

Adresy multicast w IPv6 zastępują całkowicie mechanizm broadcast znany z IPv4, co zmniejsza obciążenie sieci niepotrzebnym ruchem. Grupy multicast są identyfikowane przez prefiks ff00::/8, po którym następuje czterobitowe pole flag, czterobitowe pole zakresu oraz stuczternastobitowy identyfikator grupy. Najważniejszą grupą multicast w IPv6 jest ff02::1 oznaczająca wszystkie węzły w segmencie, która częściowo odpowiada broadcastowi z IPv4. Do komunikacji z routerami służy grupa ff02::2, a do obsługi DHCPv6 wykorzystywana jest grupa ff02::1:2. Zakresy multicast określają zasięg propagacji: od zakresu interfejsu przez zakres łącza i witryny aż po zakres globalny. W systemie Linux listę aktywnych grup multicast można wyświetlić poleceniem ip -6 maddr show. Protokół MLD, czyli Multicast Listener Discovery, pełni w IPv6 funkcję analogiczną do IGMP w IPv4, umożliwiając hostom zgłaszanie chęci przyłączania się do grup multicast. Zastosowanie multicastu zamiast broadcastu znacząco poprawia wydajność sieci, szczególnie w środowiskach z dużą liczbą hostów.

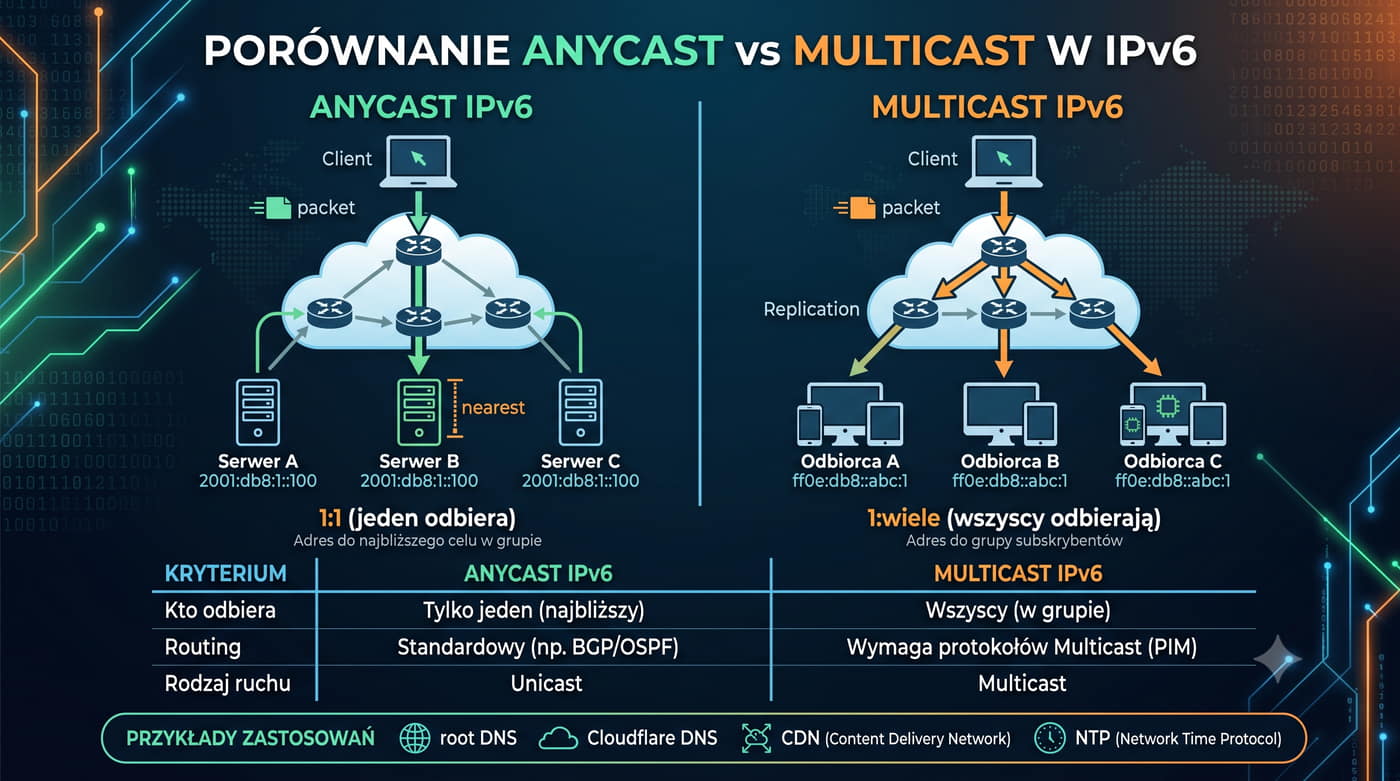
16/43 Anycast – jeden adres, wiele węzłów
CechaAnycastMulticast
Kto odbieraJeden (najbliższy)Wszyscy w grupie
RoutingStandardowyWymaga PIM
RuchUnicast (1:1)Multicast (1:wiele)
W IPv6: każdy adres unicast może być anycast – deklarowany w konfiguracji routera.

Anycast – ten sam adres przypisany do wielu węzłów.

Pakiet trafia do najbliższego (według routingu).

Zastosowania: root DNS, Cloudflare DNS (1.1.1.1 / 2606:4700:4700::1111), CDN, NTP.

Adresy anycast w IPv6 pozwalają przypisać ten sam adres do wielu węzłów w sieci, przy czym pakiet jest dostarczany tylko do jednego, najbliższego według tablic routingu. Mechanizm ten różni się od multicastu, gdzie pakiet trafia do wszystkich członków grupy. Każdy adres unicast w IPv6 może być jednocześnie adresem anycast, co wymaga jedynie odpowiedniej deklaracji w konfiguracji routera. Zastosowanie anycast obejmuje między innymi serwery DNS, gdzie wiele serwerów na świecie dzieli ten sam adres, a zapytanie trafia do najbliższego geograficznie. W systemie Linux adres anycast można skonfigurować za pomocą polecenia ip -6 addr add z odpowiednią flagą. Podstawowym adresem anycast w każdej podsieci IPv6 jest Subnet-Router Anycast, czyli najniższy adres w sieci z identyfikatorem interfejsu równym zero. Technika anycast znajduje zastosowanie w sieciach CDN oraz w protokole NTP, gdzie kluczowa jest niska latencja. Wykorzystanie anycast pozwala na budowanie odpornych na awarie i wydajnych usług sieciowych.

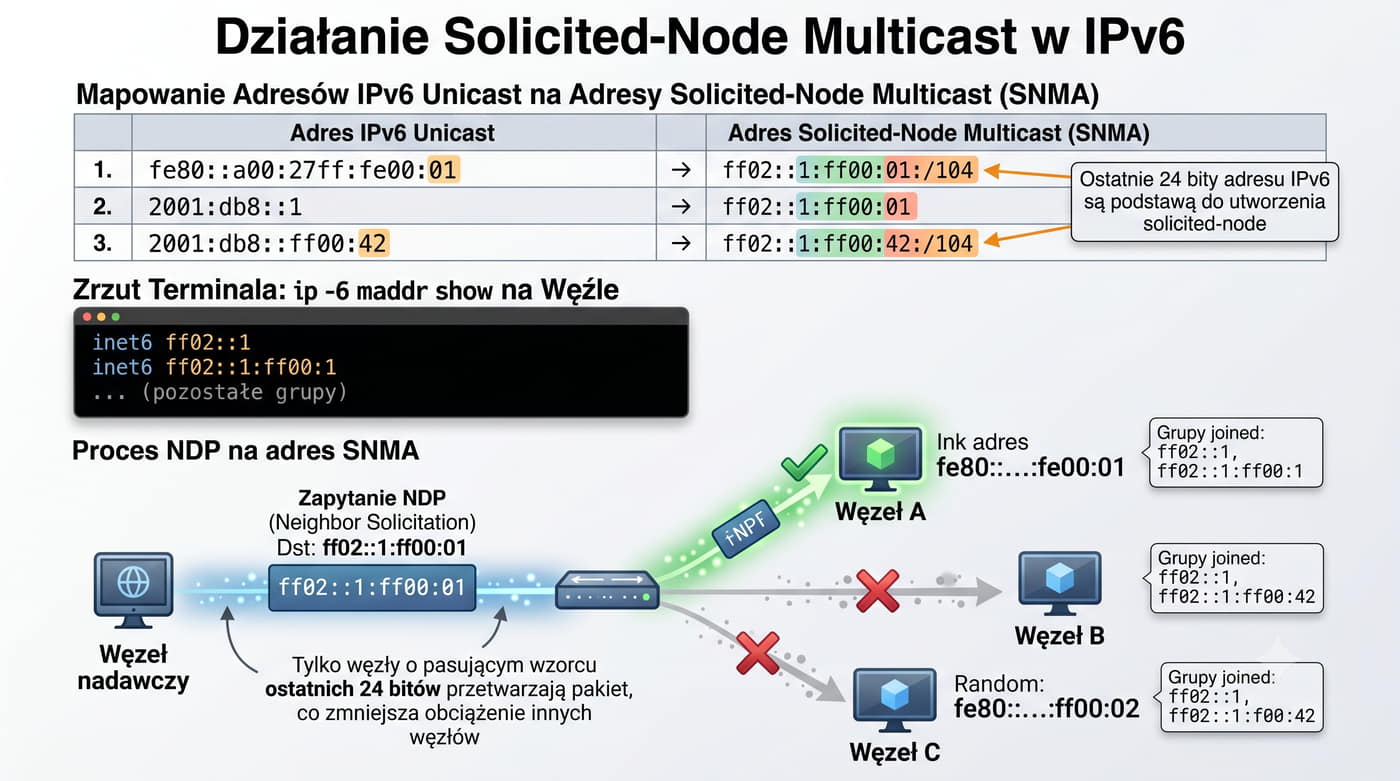
17/43 Solicited-Node Multicast
Adres IPv6Solicited-Node
fe80::a00:27ff:fe00:01ff02::1:ff00:01
2001:db8::1ff02::1:ff00:01
2001:db8::ff00:42ff02::1:ff00:42

Sprawdzenie grup multicast hosta:

ip -6 maddr show
# inet6 ff02::1  (wszystkie węzły)
# inet6 ff02::1:ff00:1 (solicited-node dla ...:1)

Solicited-Node Multicast: ff02::1:ffXX:XXXX, gdzie XX:XXXX to ostatnie 24 bity adresu IPv6.

Adresy solicited-node multicast są podstawowym mechanizmem wykorzystywanym przez protokół NDP do rozwiązywania adresów warstwy drugiej. Każdy host IPv6 nasłuchuje na adresie solicited-node utworzonym na podstawie ostatnich dwudziestu czterech bitów jego adresu IPv6. Wzorzec adresu solicited-node to ff02::1:ffXX:XXXX, gdzie XX:XXXX reprezentuje właśnie ostatnie trzy bajty adresu docelowego. Gdy host chce poznać adres MAC innego hosta, wysyła zapytanie Neighbor Solicitation właśnie na adres solicited-node, a nie na broadcast jak w ARP. Dzięki temu zapytanie przetwarzają tylko te hosty, których ostatnie dwadzieścia cztery bity adresu pasują do wzorca. W sieci zawierającej setki hostów każdy nasłuchuje tylko na własnej grupie solicited-node, co znacząco ogranicza liczbę przetwarzanych pakietów. Polecenie ip -6 maddr show wyświetla między innymi adresy solicited-node, na których nasłuchuje dany interfejs. Mechanizm ten stanowi kluczową zaletę IPv6 w porównaniu z IPv4 pod względem wydajności i skalowalności.

18/43 Podsumowanie typów adresów IPv6
TypPrefiksUżycie
Global Unicast2000::/3Publiczny Internet
Unique Localfd00::/8Sieć wewnętrzna
Link-Localfe80::/10Segment (NDP, SLAAC)
Multicastff00::/8Grupowa komunikacja
AnycastNajbliższy węzeł
Loopback::1/128Localhost
Unspecified::/128Przed uzyskaniem adresu

W IPv6 nie ma adresów broadcast.

Ostatni (ff...ff) to zwykły unicast.

Pierwszy adres w sieci (ID=0) to Subnet-Router Anycast.

W IPv6 wyróżnia się pięć podstawowych typów adresów unicast: global unicast do komunikacji publicznej, unique local do sieci wewnętrznych, link-local do segmentu lokalnego, multicast do komunikacji grupowej oraz anycast do kierowania ruchu do najbliższego węzła. W odróżnieniu od IPv4 w IPv6 nie istnieją adresy broadcast, a ich funkcję pełnią odpowiednie grupy multicast, przede wszystkim ff02::1. Ostatni adres w podsieci IPv6, czyli z wszystkimi bitami hosta ustawionymi na jeden, jest zwykłym adresem unicast, a nie broadcastem jak w IPv4. Pierwszy adres w każdej sieci, z identyfikatorem interfejsu równym zero, jest zarezerwowany jako Subnet-Router Anycast. W systemie Linux adresy różnych typów można rozróżnić po zakresie wyświetlanym przez polecenie ip -6 addr show. Każdy interfejs posiada co najmniej adres link-local i może mieć wiele adresów różnych typów jednocześnie. Zrozumienie różnic między poszczególnymi typami adresów jest niezbędne do poprawnego projektowania sieci IPv6. Wybór odpowiedniego typu adresu zależy od wymagań dotyczących zasięgu komunikacji i poziomu bezpieczeństwa.

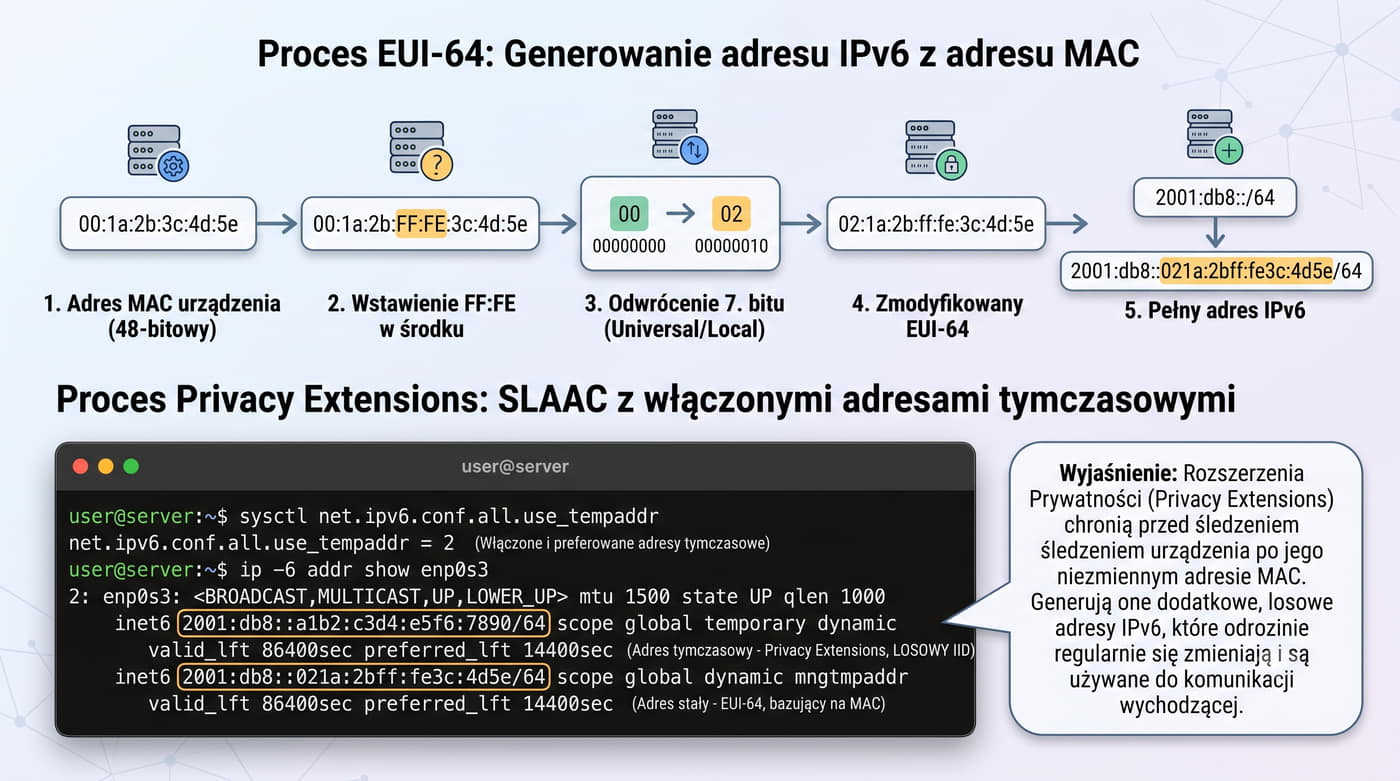
19/43 Interface ID – EUI-64 i Privacy Extensions

1. EUI-64 (z adresu MAC):

  MAC: 00:1a:2b:3c:4d:5e
  EUI-64: 02:1a:2b:ff:fe:3c:4d:5e
  Adres: 2001:db8::21a:2bff:fe3c:4d5e/64
sysctl net.ipv6.conf.all.use_tempaddr
# 2 = włączone (domyślnie w Ubuntu/Fedora)
# 0 = wyłączone (tylko EUI-64)

ip -6 addr show enp0s3
# inet6 2001:db8::a00:27ff:fe00:1/64 scope global permanent
# inet6 2001:db8::cafe:1234:5678:9abc/64 scope global temporary

2. Losowy (Privacy Extensions – RFC 8981):

Identyfikator interfejsu w adresie IPv6 może być generowany na dwa sposoby: według algorytmu EUI-64 lub z wykorzystaniem losowych wartości zgodnych z RFC 8981. Mechanizm EUI-64 przekształca czterdziestoośmiobitowy adres MAC na sześćdziesięcioczworobitowy identyfikator poprzez wstawienie szesnastu bitów FFFE w środek adresu. Po wstawieniu FFFE należy odwrócić siódmy bit licząc od lewej, czyli bit oznaczający unikalność adresu MAC. W rezultacie adres MAC 00:1a:2b:3c:4d:5e przekształca się w identyfikator 021a:2bff:fe3c:4d5e. Mechanizm Privacy Extensions z RFC 8981 generuje tymczasowe, losowe identyfikatory interfejsu, które są zmieniane okresowo, zazwyczaj co dwadzieścia cztery godziny. W systemie Linux parametr use_tempaddr o wartości dwa włącza Privacy Extensions, co jest domyślnym ustawieniem w dystrybucjach Ubuntu i Fedora. Aplikacje wychodzące wykorzystują tymczasowe adresy, aby utrudnić śledzenie hosta, natomiast serwery używają stałych adresów EUI-64. W wynikach polecenia ip -6 addr show adresy tymczasowe są oznaczone etykietą temporary, a stałe jako permanent.

20/43 Sprawdzanie IPv6 – ip -6

Lista adresów IPv6:

ip -6 addr show
ip -6 addr show scope global  # bez link-local

ip -6 addr show dev enp0s3

Lista tras IPv6:

ip -6 route show
ip -6 route show default  # tylko brama
ip -6 route get 2001:4860:4860::8888  # która trasa?
ip -6 neigh show
# fe80::1 dev enp0s3 lladdr 00:50:56:00:00:01 router REACHABLE
# 2001:db8::2 dev enp0s3 lladdr 08:00:27:fe:00:02 STALE

Sąsiedzi IPv6 ( NDP cache – odpowiednik ARP ):

Pakiet iproute2 zawiera narzędzie ip, które w systemie Linux jest podstawowym programem do konfiguracji sieci, w tym obsługi IPv6. Polecenie ip -6 addr show wyświetla wszystkie adresy IPv6 przypisane do interfejsów wraz z długością prefiksu i zakresem. Aby wyświetlić tylko adresy globalne bez adresów link-local, stosuje się opcję scope global. Tablica sąsiadów NDP, wyświetlana poleceniem ip -6 neigh show, pełni tę samą funkcję co tablica ARP w IPv4. Trasy IPv6 można przeglądać za pomocą ip -6 route show, a domyślną trasę wyświetlić z opcją default. Polecenie ip -6 route get pozwala sprawdzić, którą trasą zostanie wysłany pakiet do konkretnego adresu docelowego. Statystyki interfejsów dla IPv6 dostępne są za pomocą polecenia ip -s -6 link show. Znajomość tych poleceń jest niezbędna do codziennej diagnostyki i konfiguracji sieci IPv6 w systemie Linux.

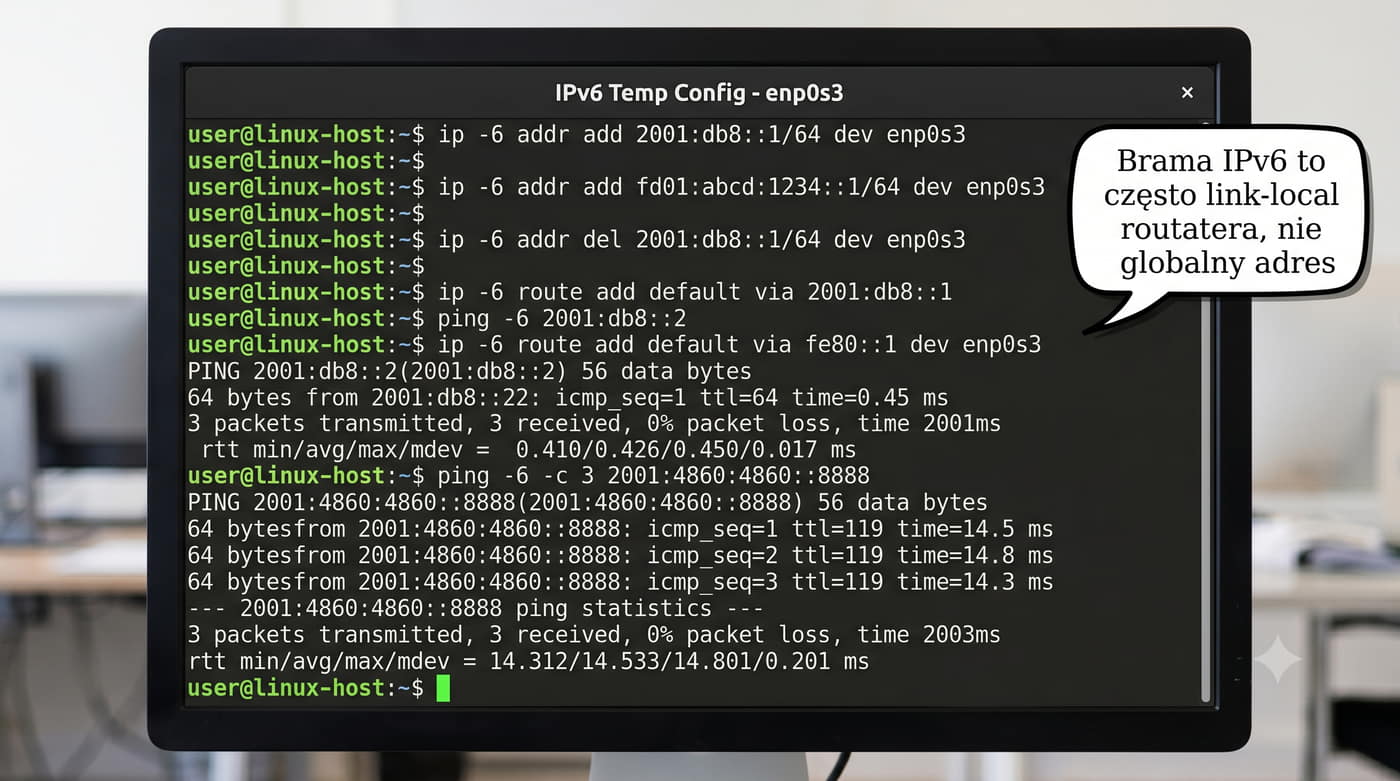
21/43 Dodawanie adresu IPv6 tymczasowo (ip)

Dodanie globalnego adresu:

ip -6 addr add 2001:db8::1/64 dev enp0s3

Dodanie ULA:

ip -6 addr add fd01:abcd:1234::1/64 dev enp0s3

Usunięcie:

ip -6 addr del 2001:db8::1/64 dev enp0s3

Brama domyślna IPv6:

ip -6 route add default via 2001:db8::1
# lub (częściej) przez link-local:
ip -6 route add default via fe80::1 dev enp0s3

Sprawdzenie:

ping -6 2001:db8::2
ping -6 -c 3 2001:4860:4860::8888  # Google DNS IPv6

Tymczasowe dodawanie adresów IPv6 za pomocą polecenia ip -6 addr add jest wygodne do testów, ale zmiany nie przetrwają restartu systemu. Do jednego interfejsu można dodać wiele adresów IPv6, zarówno global unicast, jak i unique local. Brama domyślna w IPv6 często ma adres link-local routera, a nie adres globalny, co oznacza konieczność podania interfejsu w poleceniu. Po dodaniu bramy domyślnej warto sprawdzić łączność za pomocą ping -6 do adresu zdalnego, na przykład serwera DNS Google. Usunięcie adresu wykonuje się poleceniem ip -6 addr del, podając ten sam adres i prefiks. W przypadku tras z bramą link-local obowiązkowe jest użycie parametru dev z nazwą interfejsu. Aby zweryfikować poprawność konfiguracji, można użyć polecenia ip -6 route get z adresem docelowym. Praktyczne ćwiczenia z tymczasową konfiguracją pozwalają zrozumieć działanie routingu IPv6 bez ryzyka trwałego uszkodzenia ustawień sieciowych.

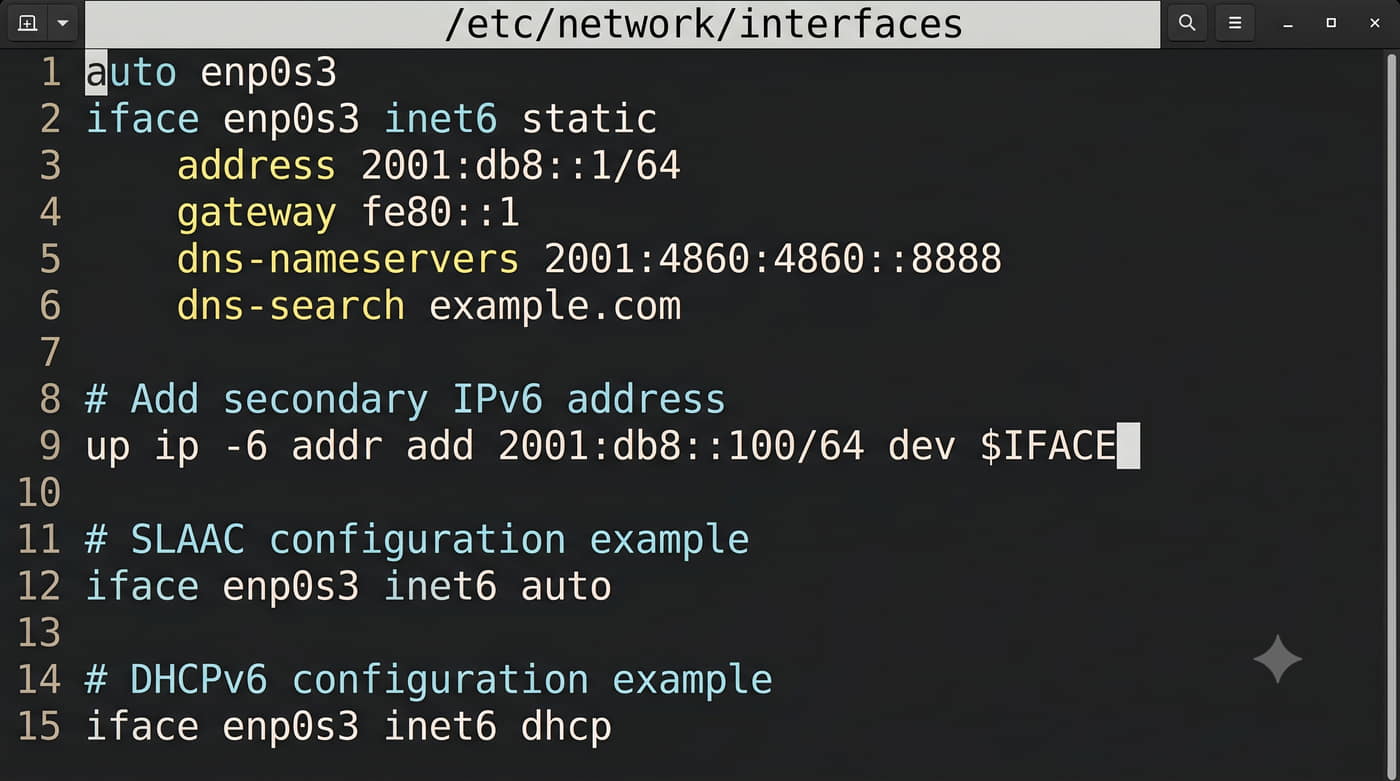
22/43 Trwała konfiguracja – /etc/network/interfaces (Debian)

Statyczny IPv6:

auto enp0s3
iface enp0s3 inet6 static
  address 2001:db8::1/64
  gateway fe80::1
  dns-nameservers 2001:4860:4860::8888
  dns-search example.com

Drugi adres:

iface enp0s3 inet6 static
  address 2001:db8::1/64
  up ip -6 addr add 2001:db8::100/64 dev $IFACE

SLAAC: iface enp0s3 inet6 auto

DHCPv6: iface enp0s3 inet6 dhcp

W systemie Debian i pochodnych trwała konfiguracja IPv6 może być realizowana za pomocą pliku /etc/network/interfaces z użyciem składni ifupdown. Metoda inet6 static umożliwia ręczne określenie adresu, prefiksu i bramy domyślnej dla IPv6. Brama w konfiguracji statycznej jest często podawana jako adres link-local routera, ponieważ ta metoda jest niezależna od zmian adresacji globalnej. Metoda inet6 auto włącza automatyczną konfigurację SLAAC, która pobiera prefiks z komunikatów Router Advertisement. Opcja inet6 dhcp umożliwia użycie protokołu DHCPv6 do pobrania adresu i opcji konfiguracyjnych. W pliku można zdefiniować wiele adresów IPv6 dla tego samego interfejsu, dodając osobne dyrektywy address. Serwery DNS IPv6 konfiguruje się za pomocą dyrektywy dns-nameservers z adresem IPv6. Po modyfikacji pliku konfiguracyjnego należy zrestartować usługę sieciową poleceniem systemctl restart networking.

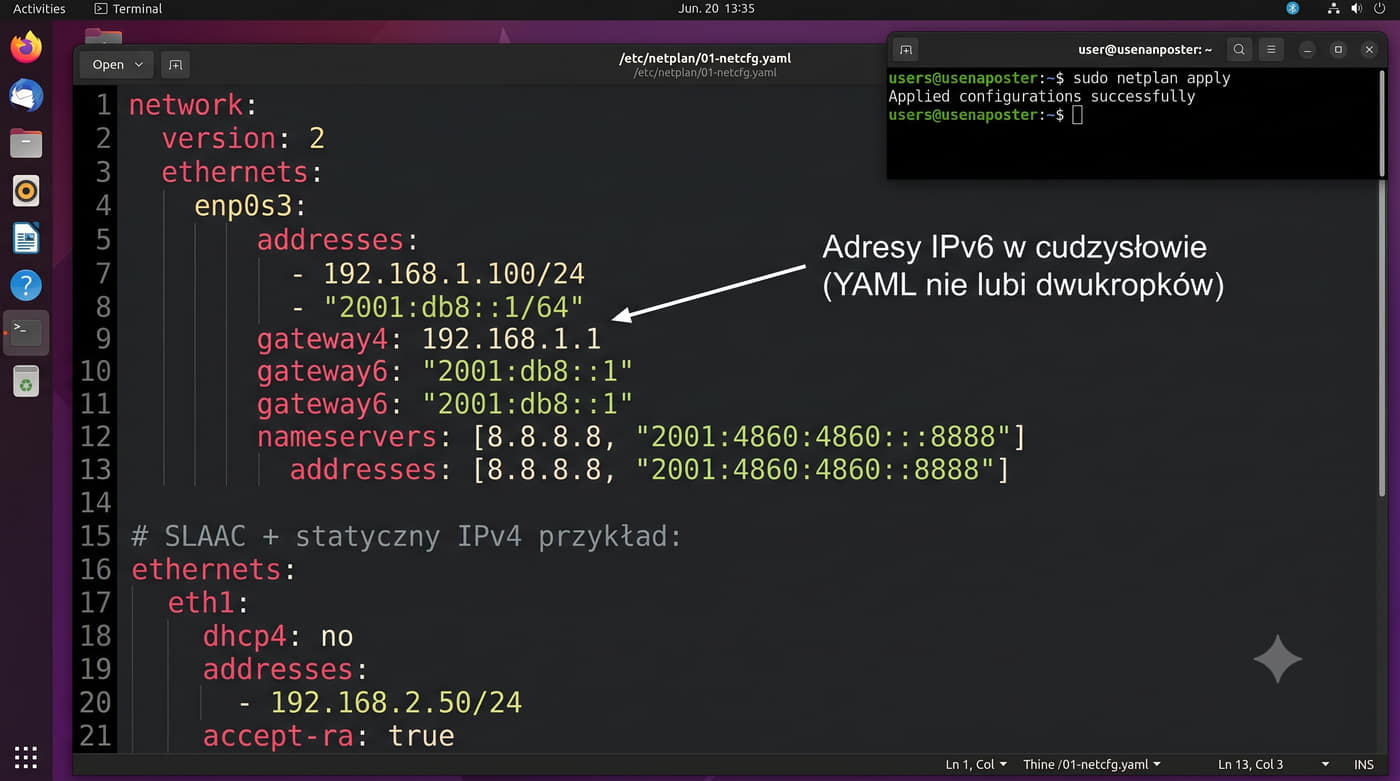
23/43 Netplan – konfiguracja IPv6 (Ubuntu 18.04+)

Statyczny IPv4 + IPv6:

# /etc/netplan/01-netcfg.yaml
network:
  version: 2
  ethernets:
    enp0s3:
      addresses:
        - 192.168.1.100/24
        - "2001:db8::1/64"
      routes:
        - to: 0.0.0.0/0
          via: 192.168.1.1
        - to: "::/0"
          via: "2001:db8::1"
      nameservers:
        addresses:
          - 8.8.8.8
          - "2001:4860:4860::8888"

SLAAC + statyczny IPv4:

# /etc/netplan/01-netcfg.yaml
network:
  version: 2
  ethernets:
    enp0s3:
      addresses:
        - 192.168.1.100/24
      routes:
        - to: 0.0.0.0/0
          via: 192.168.1.1
      accept-ra: true

Aktywacja: sudo netplan apply

Netplan to narzędzie do konfiguracji sieci wprowadzone w Ubuntu 18.04, które czyta pliki YAML i generuje konfigurację dla systemd-networkd lub NetworkManagera. Adresy IPv6 w plikach YAML netplan muszą być ujęte w cudzysłów, ponieważ dwukropek w adresie jest interpretowany jako znak specjalny w tym formacie. Zamiast przestarzałych dyrektyw gateway4 i gateway6 zaleca się używanie sekcji routes z opcjami to i via. Do włączenia SLAAC w netplanie służy opcja accept-ra ustawiona na true, która pozwala na automatyczne przyjmowanie komunikatów Router Advertisement. Pliki konfiguracyjne netplan znajdują się w katalogu /etc/netplan/ i mają rozszerzenie .yaml. Po każdej zmianie konfiguracji wymagane jest wykonanie polecenia sudo netplan apply. Netplan automatycznie wywołuje odpowiednie narzędzia dla wybranego backentu, co ujednolica proces konfiguracji. Znajomość składni netplan jest niezbędna dla administratorów systemów Ubuntu w środowiskach produkcyjnych.

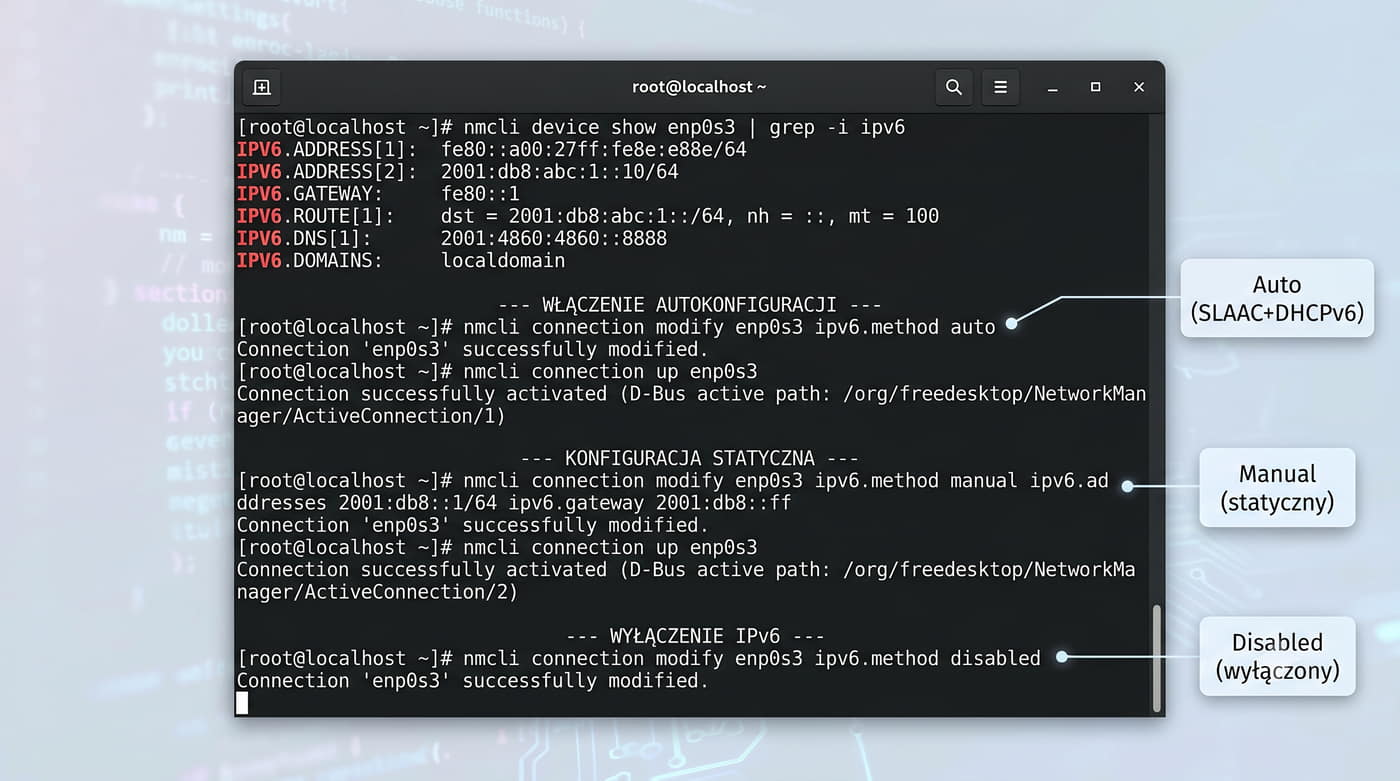
24/43 Konfiguracja IPv6 – nmcli

Sprawdzenie statusu:

nmcli device show enp0s3 | grep -i ipv6

Włączenie IPv6 (DHCPv6 + SLAAC):

nmcli connection modify enp0s3 ipv6.method auto
nmcli connection up enp0s3

Adres statyczny:

nmcli connection modify enp0s3 \
  ipv6.method manual \
  ipv6.addresses 2001:db8::1/64 \
  ipv6.gateway 2001:db8::ff
nmcli connection up enp0s3

Wyłączenie IPv6:

nmcli connection modify enp0s3 ipv6.method disabled

nmcli – menedżer sieci NetworkManager – wspiera IPv6:

NetworkManager z narzędziem nmcli oferuje wygodną konfigurację IPv6 zarówno z linii poleceń, jak i z interfejsu graficznego. Metoda ipv6.method auto włącza automatyczną konfigurację z użyciem SLAAC i opcjonalnie DHCPv6. W przypadku konfiguracji statycznej ustawia się ipv6.method manual oraz podaje adresy i bramę za pomocą odpowiednich parametrów. NetworkManager przechowuje konfiguracje połączeń w profilach, które można modyfikować poleceniem nmcli connection modify. Po każdej zmianie profilu należy go aktywować poleceniem nmcli connection up lub nmcli device reapply. Metoda ipv6.method disabled całkowicie wyłącza IPv6 dla danego połączenia, co może być przydatne w celach diagnostycznych. NetworkManager obsługuje również zaawansowane opcje, takie jak adresy tymczasowe zgodne z Privacy Extensions. Polecenie nmcli device show enp0s3 z filtrowaniem przez grep -i ipv6 pozwala szybko sprawdzić aktualny stan konfiguracji IPv6 interfejsu.

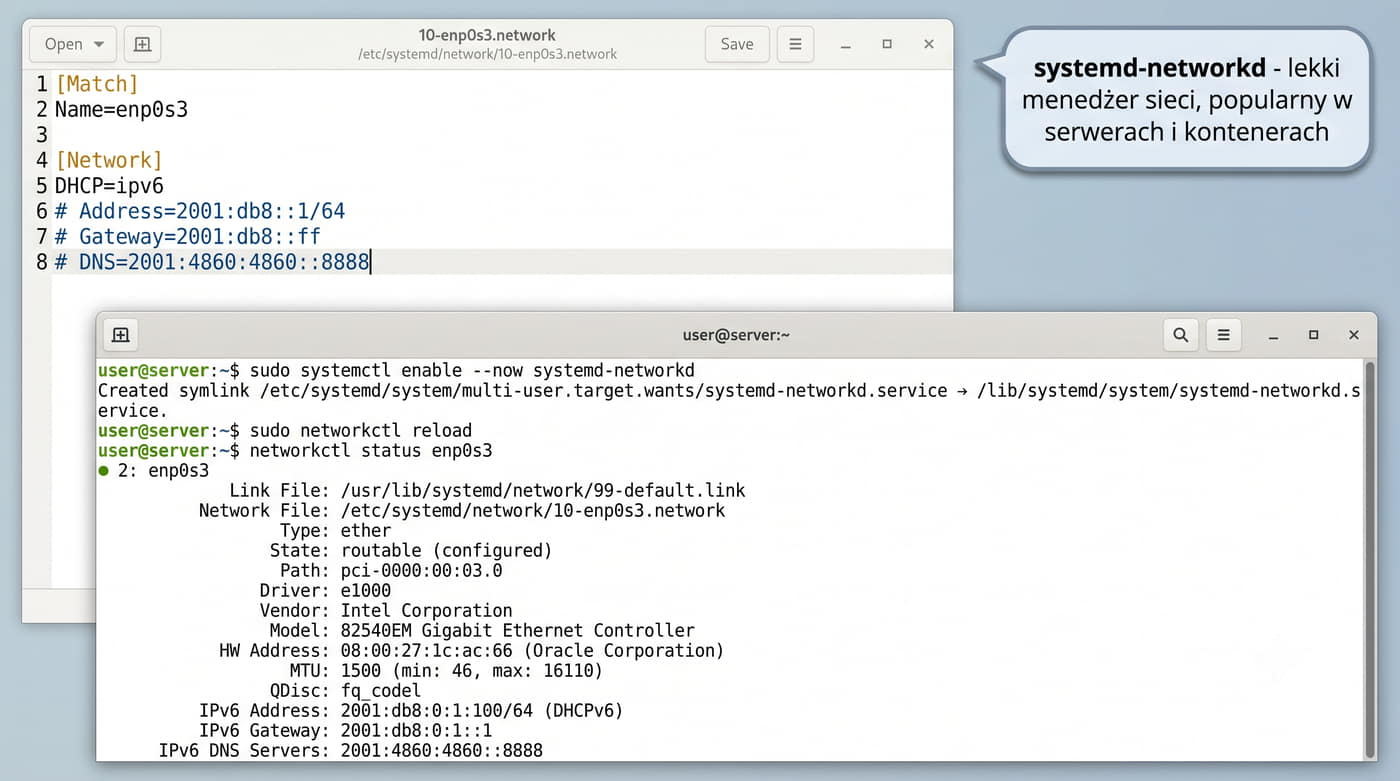
25/43 Konfiguracja IPv6 – systemd-networkd
[Match]
Name=enp0s3

[Network]
DHCP=ipv6
# lub statycznie:
# Address=2001:db8::1/64
# Gateway=2001:db8::ff
# DNS=2001:4860:4860::8888

Aktywacja:

sudo systemctl enable --now systemd-networkd
sudo networkctl reload

Podgląd:

networkctl status enp0s3

systemd-networkd – alternatywny menedżer sieci, lekki, popularny w serwerach i kontenerach.

Plik: /etc/systemd/network/10-enp0s3.network

systemd-networkd to lekki menedżer sieci wchodzący w skład systemd, popularny w serwerach, kontenerach i systemach wbudowanych. Pliki konfiguracyjne znajdują się w katalogu /etc/systemd/network/ i mają rozszerzenie .network dla konfiguracji interfejsów. Sekcja Match określa, którego interfejsu dotyczy konfiguracja, a sekcja Network definiuje adresy, bramę i serwery DNS. Do włączenia SLAAC w systemd-networkd służy opcja IPv6AcceptRA ustawiona na yes. Polecenie networkctl status wyświetla szczegółowe informacje o stanie interfejsów, w tym adresy IPv6. Podobnie jak netplan, systemd-networkd nie wymaga uruchomionego NetworkManagera, co czyni go idealnym rozwiązaniem dla serwerów. Konfigurację statyczną IPv6 w systemd-networkd realizuje się przez opcje Address i Gateway w sekcji Network. Po modyfikacji pliku należy przeładować konfigurację poleceniem sudo networkctl reload.

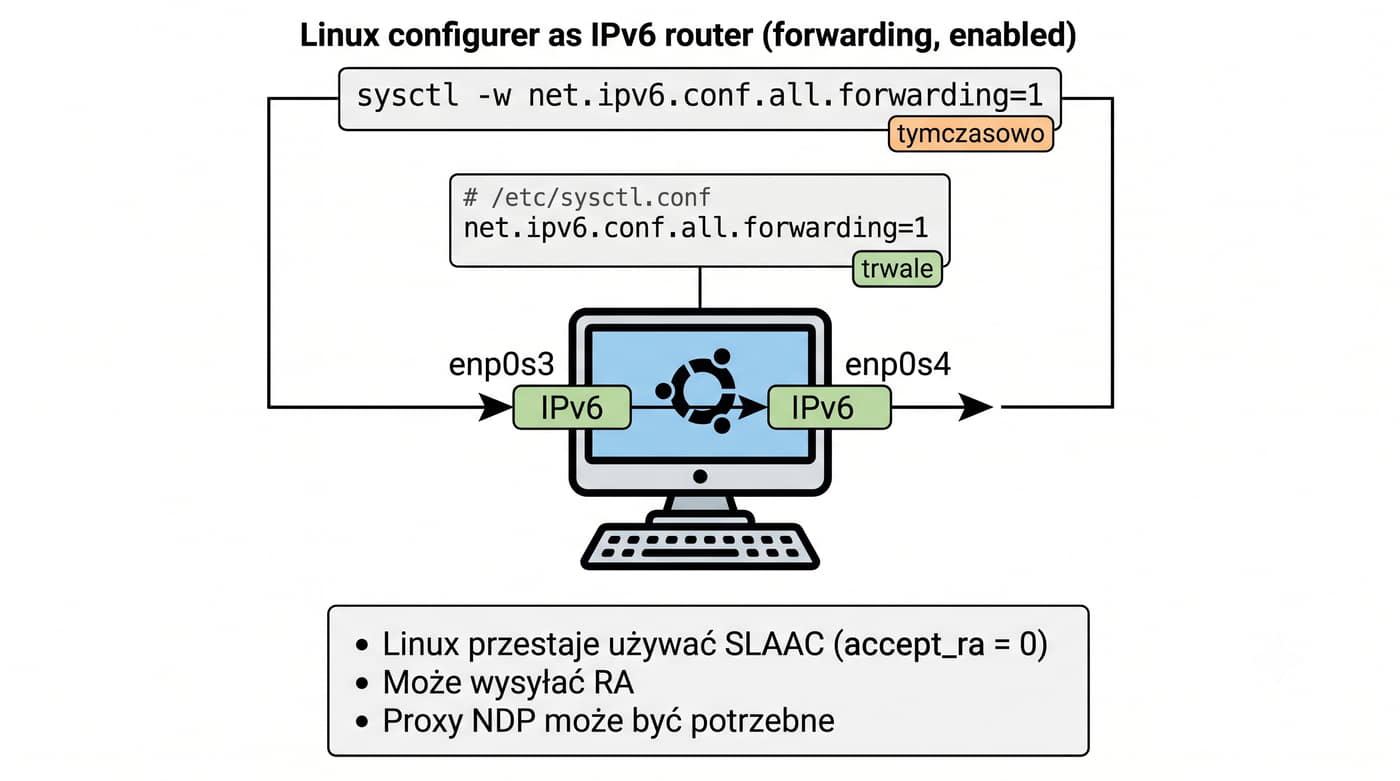
26/43 Linux jako router IPv6 – forwarding
# tymczasowo (do restartu)
sudo sysctl -w net.ipv6.conf.all.forwarding=1

# trwale
echo "net.ipv6.conf.all.forwarding=1" | sudo tee -a /etc/sysctl.conf
sudo sysctl -p

Konsekwencje włączenia forwarding:

  • Linux przestaje używać SLAAC (accept_ra = 0)
  • Może wysyłać RA (Router Advertisement) jeśli skonfigurowano radvd lub systemd-networkd
  • Proxy NDP może być potrzebne dla pojedynczych /64

Sprawdzenie:

sysctl net.ipv6.conf.all.forwarding
cat /proc/sys/net/ipv6/conf/all/forwarding

Aby Linux przekazywał pakiety IPv6 między interfejsami:

Włączenie przekazywania pakietów IPv6 w systemie Linux wymaga ustawienia parametru net.ipv6.conf.all.forwarding na wartość jeden. Forwarding IPv6 jest niezależny od przekazywania pakietów IPv4, co oznacza, że można włączyć forwarding tylko dla jednego protokołu. Włączenie forwarding powoduje, że Linux przestaje automatycznie akceptować komunikaty Router Advertisement, ponieważ zaczyna pełnić rolę routera. Dla interfejsów, na których Linux ma działać jako router, należy dodatkowo wyłączyć akceptację RA przez ustawienie accept_ra na zero. Po włączeniu forwardingu można skonfigurować usługę radvd do wysyłania własnych komunikatów RA. W przypadku pojedynczych adresów /64 przydzielonych do interfejsu może być konieczne włączenie Proxy NDP. Sprawdzenie aktualnego stanu forwardingu wykonuje się poleceniem sysctl net.ipv6.conf.all.forwarding. Linux jako router IPv6 może być pełnoprawną alternatywą dla komercyjnych rozwiązań sprzętowych.

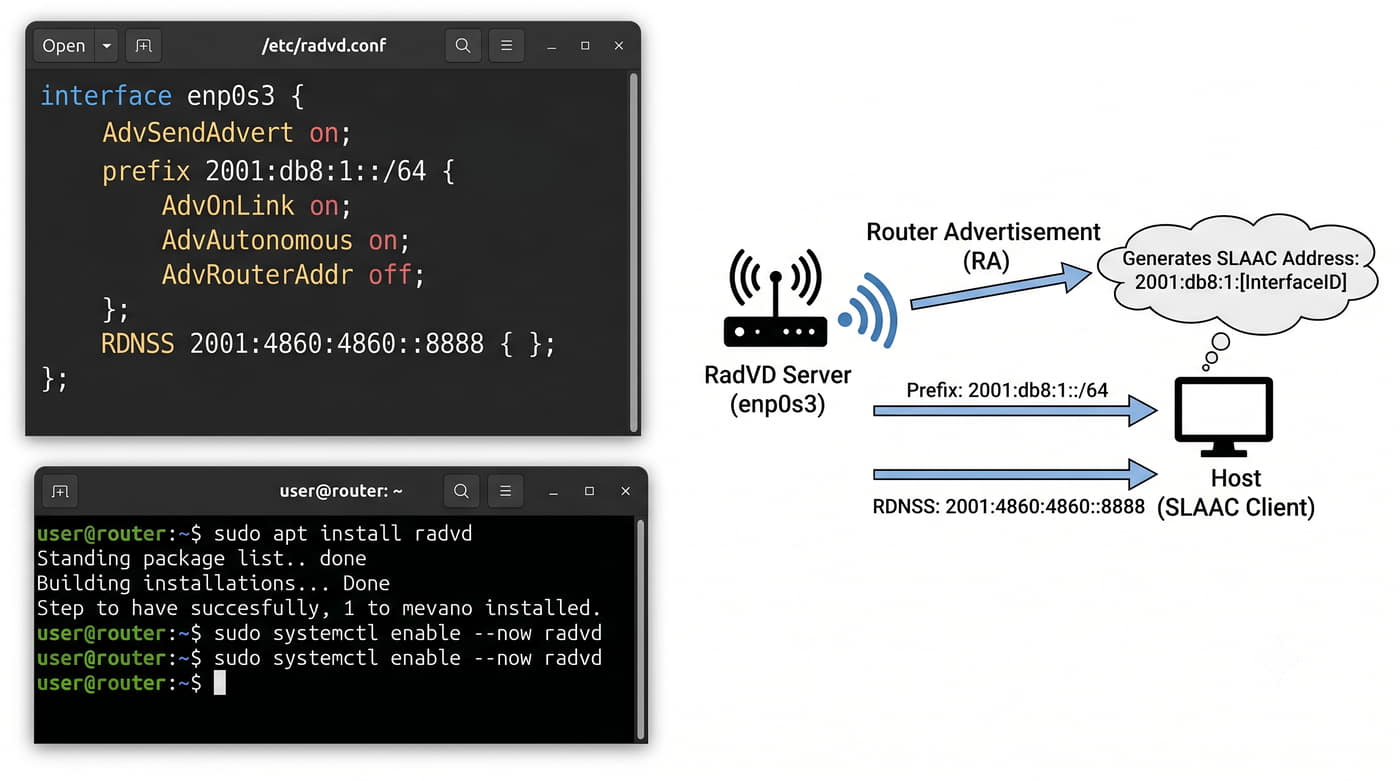
27/43 Router Linux – radvd (Router Advertisement)

Instalacja: sudo apt install radvd

Konfiguracja /etc/radvd.conf:

interface enp0s3
{
  AdvSendAdvert on;
  prefix 2001:db8:1::/64
  {
  AdvOnLink on;
  AdvAutonomous on;
  AdvRouterAddr off;
  };
  RDNSS 2001:4860:4860::8888 { };
};

Uruchomienie:

sudo systemctl enable --now radvd

radvd – Router Advertisement Daemon – ogłasza prefiksy IPv6 w sieci lokalnej.

Hosty otrzymają adres SLAAC z prefiksu 2001:db8:1::/64.

Program radvd, czyli Router Advertisement Daemon, wysyła cykliczne komunikaty RA lub odpowiada na zapytania RS od hostów w sieci lokalnej. W pliku konfiguracyjnym /etc/radvd.conf definiuje się interfejs, na którym ma być wysyłane ogłoszenie oraz prefiks do dystrybucji. Opcja AdvAutonomous on włącza SLAAC, co pozwala hostom na automatyczne generowanie adresów na podstawie otrzymanego prefiksu. Aby wymusić użycie DHCPv6 obok SLAAC, dodaje się flagę AdvManagedFlag on lub AdvOtherConfigFlag on w konfiguracji radvd. Opcjonalnie w radvd można zdefiniować serwery DNS za pomocą dyrektywy RDNSS, które hosty automatycznie skonfigurują jako resolvery. Przed uruchomieniem radvd należy upewnić się, że forwarding IPv6 jest włączony na serwerze. Alternatywą dla radvd jest systemd-networkd z opcją [IPv6Prefix] w pliku .network. radvd pozostaje jednak popularnym narzędziem ze względu na swoją elastyczność i bogaty zestaw opcji konfiguracyjnych.

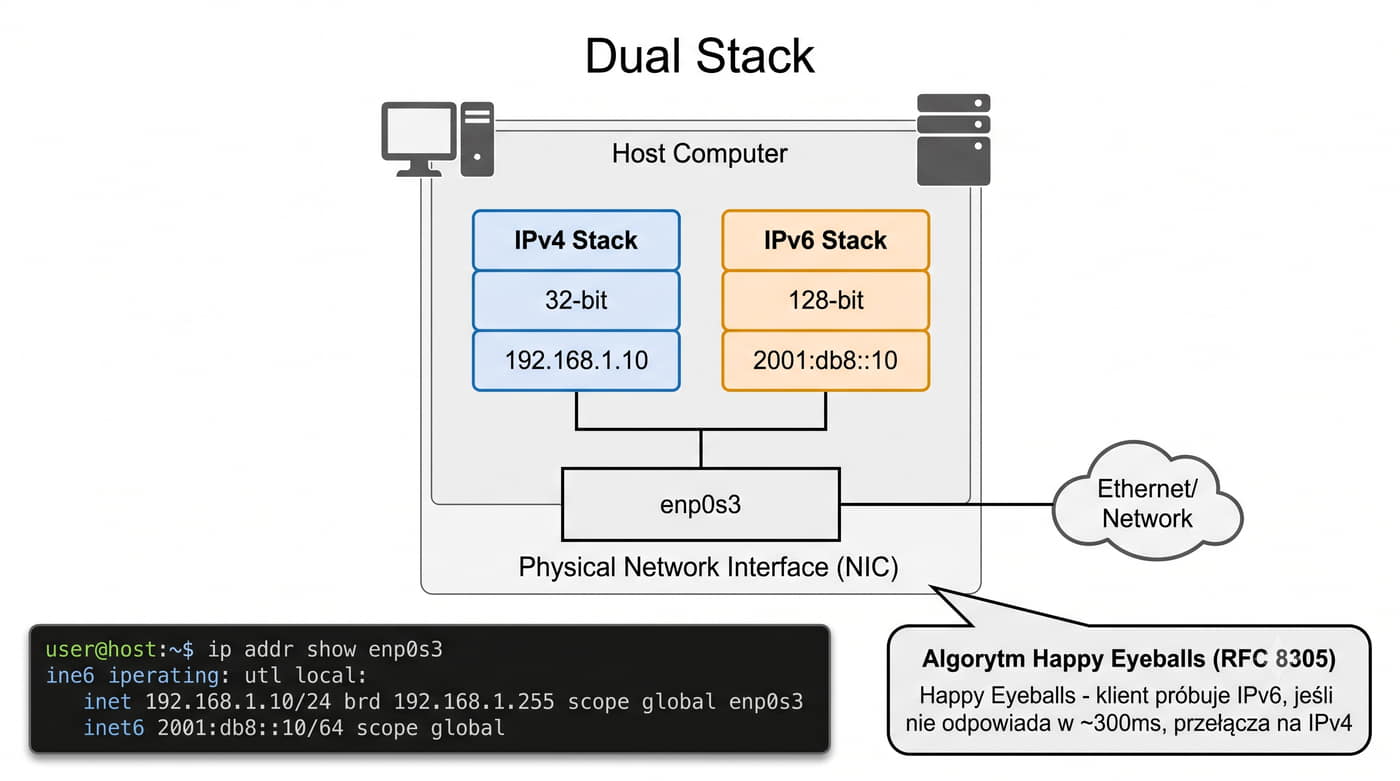
28/43 Dual Stack – IPv4 + IPv6 jednocześnie

Przykład – adresacja dual:

ip addr show enp0s3
3: enp0s3: ...
  inet 192.168.1.10/24 brd 192.168.1.255
  inet6 2001:db8::10/64

Sprawdzenie aktywnych połączeń:

ss -tln
# IPv4: 0.0.0.0:22
# IPv6: :::22  (v6-wildcard obsługuje też v4)

Dual Stack – host lub router obsługuje jednocześnie IPv4 i IPv6.

Gniazdo IPv6 :::22 domyślnie akceptuje także połączenia IPv4 (chyba że ustawiono net.ipv6.bindv6only=1).

Aplikacja wybiera protokół – zwykle preferuje IPv6 (wybór adresu wg RFC 6724, łączność wg RFC 8305, Happy Eyeballs).

Dual Stack to najprostsza i najczęściej stosowana strategia przejściowa, w której host posiada jednocześnie adres IPv4 i IPv6. Gniazdo nasłuchujące na adresie IPv6 :: (wildcard) domyślnie akceptuje również połączenia przychodzące od klientów IPv4, chyba że włączono opcję bindv6only. Mechanizm Happy Eyeballs zdefiniowany w RFC 8305 pozwala aplikacjom na równoległe próby połączenia przez IPv6 i IPv4. Klient próbuje najpierw połączenia IPv6, a jeśli nie otrzyma odpowiedzi w ciągu około 250 milisekund (zalecenie RFC 8305), przełącza się na IPv4. Dzięki temu użytkownik nie odczuwa opóźnień, gdy IPv6 nie działa poprawnie dla danej usługi. W systemie Linux preferencję protokołu można sprawdzić w pliku /etc/gai.conf, który definiuje kolejność rozwiązywania nazw. Praktycznie wszystkie nowoczesne systemy operacyjne i aplikacje obsługują Dual Stack bez dodatkowej konfiguracji. Model Dual Stack jest rekomendowany przez organizację IETF jako podstawowa metoda wdrażania IPv6.

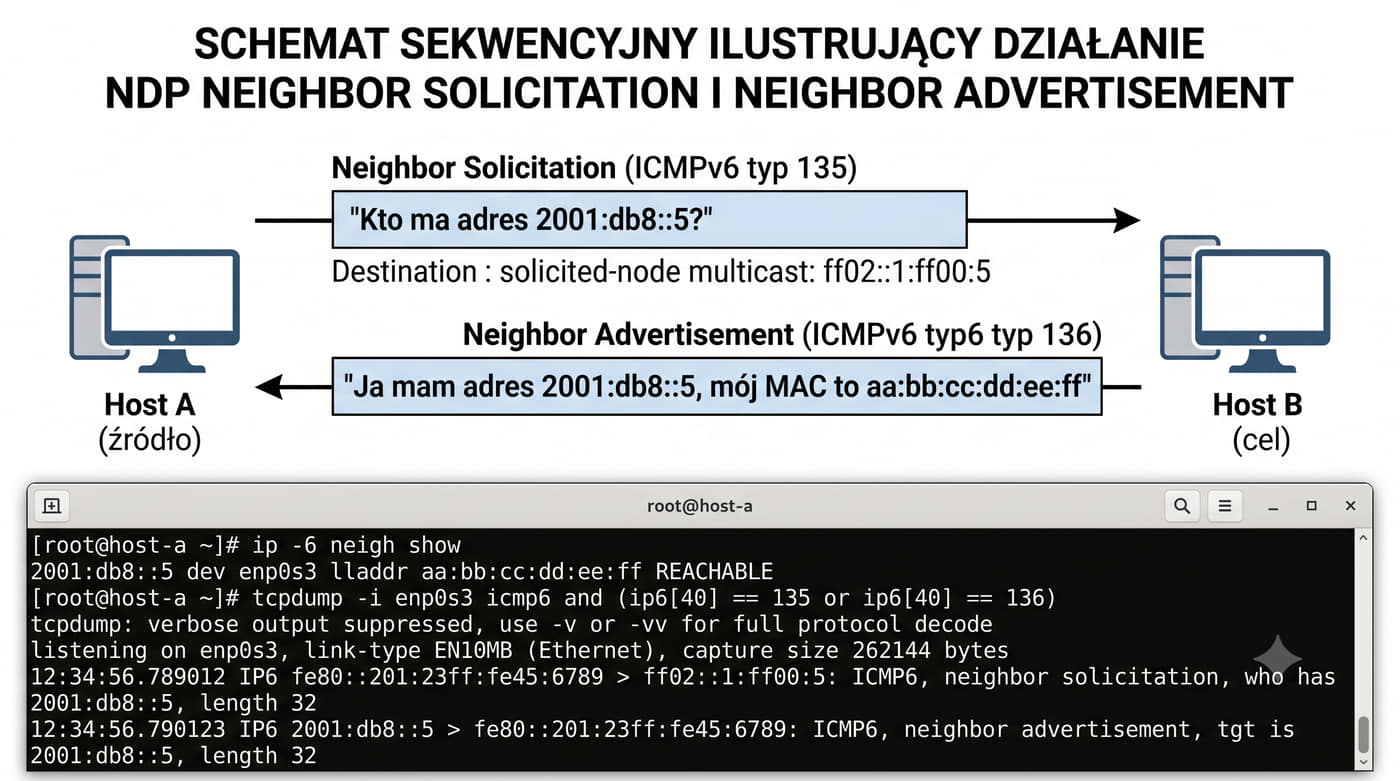
29/43 NDP – Neighbor Discovery Protocol (NS/NA)

Obserwacja NDP:

# Tabela sąsiadów (odpowiednik ARP):
ip -6 neigh show

# Nasłuchiwanie NDP:
tcpdump -i enp0s3 icmp6 and 'ip6[40] == 135 or ip6[40] == 136'

NDP – odpowiednik ARP w IPv4, działa w ICMPv6.

Neighbor Solicitation (NS) – ICMPv6 typ 135:"Kto ma adres 2001:db8::5?" – wysyłany na adres solicited-node multicast.

Neighbor Advertisement (NA) – ICMPv6 typ 136:"Ja mam adres 2001:db8::5, mój MAC to aa:bb:cc:dd:ee:ff".

Protokół NDP zdefiniowany w RFC 4861 zastępuje w IPv4 protokół ARP oraz funkcje ICMP Router Discovery i ICMP Redirect. Neighbor Solicitation wysyłany na adres solicited-node multicast pozwala poznać adres MAC hosta o danym adresie IPv6. Neighbor Advertisement jest odpowiedzią na zapytanie NS, zawierającą adres MAC nadawcy i potwierdzenie posiadania adresu IPv6. W systemie Linux tabelę sąsiadów NDP można podejrzeć poleceniem ip -6 neigh show, które działa analogicznie do polecenia arp w IPv4. Do przechwytywania ruchu NDP służy program tcpdump z filtrem ICMPv6 typów 135 i 136. NDP obsługuje również mechanizm Duplicate Address Detection, czyli DAD, który sprawdza unikalność adresu przed jego użyciem. Wykrywanie nieosiągalności sąsiada, czyli Neighbor Unreachability Detection, pozwala na wykrycie awarii łącza. Zastosowanie multicastu zamiast broadcastu w NDP znacząco redukuje obciążenie sieci w porównaniu z ARP.

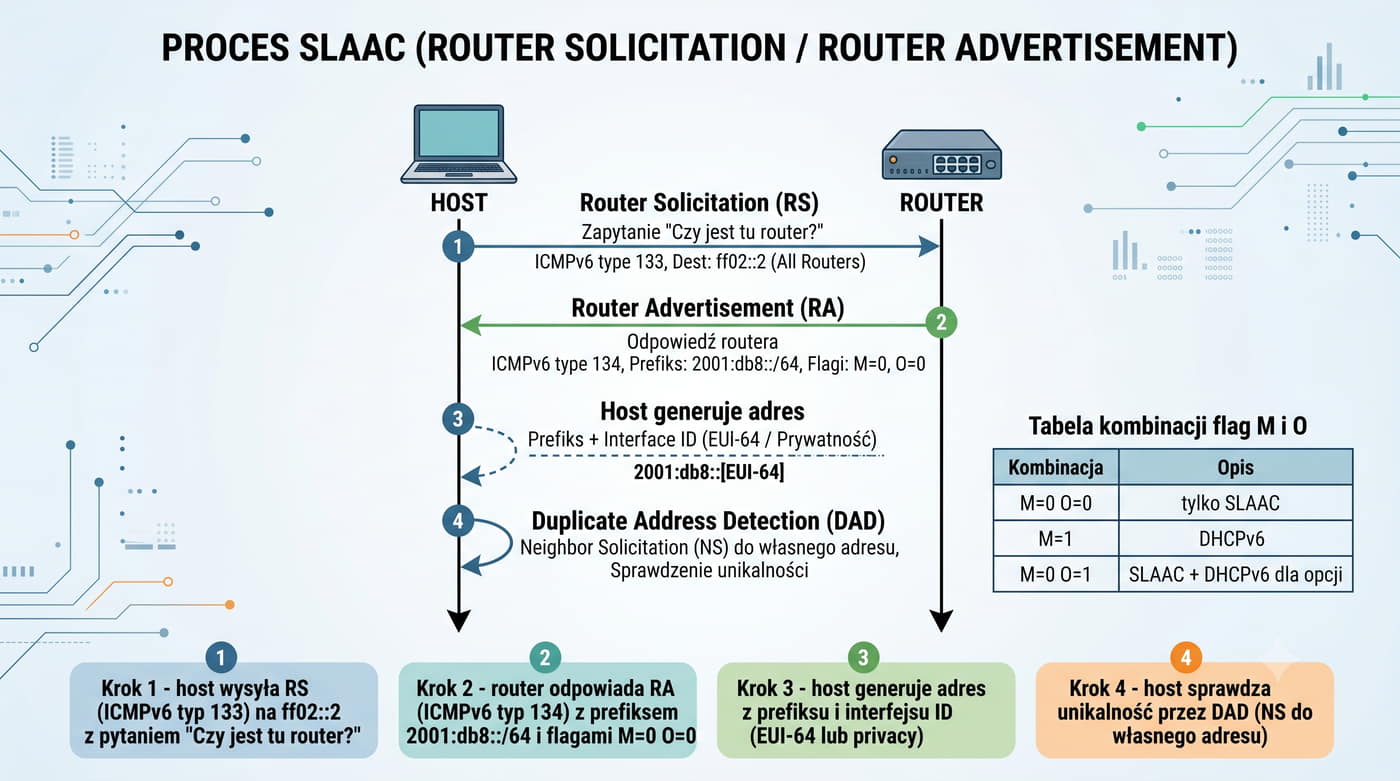
30/43 NDP – Router Solicitation / SLAAC
  1. Host wysyła RS (lub czeka na cykliczne RA)
  2. Router odpowiada RA z prefiksem (PIO – Prefix Information Option)
  3. Host generuje adres: prefiks + interfejs (EUI-64 lub privacy)
  4. Host sprawdza unikalność (DAD – NS do własnego adresu)

Router Solicitation (RS) – ICMPv6 typ 133:Host pyta "Czy jest tu router?" – multicast FF02::2.

Router Advertisement (RA) – ICMPv6 typ 134:Router odpowiada: "Jestem routerem, używaj prefiksu 2001:db8::/64, M=0, O=0".

SLAAC – Stateless Address Autoconfiguration:

Flagi w RA:M (Managed) – użyj DHCPv6, O (Other) – DHCPv6 dla opcji.

Proces SLAAC rozpoczyna się od wysłania przez host Router Solicitation na adres multicast ff02::2 lub oczekiwania na cykliczne Router Advertisement. Router odpowiada komunikatem RA zawierającym prefiks sieci oraz opcjonalne flagi konfiguracyjne. Host na podstawie prefiksu z RA generuje swój adres IPv6, łącząc prefiks z identyfikatorem interfejsu wygenerowanym według EUI-64 lub Privacy Extensions. Przed rozpoczęciem używania adresu host wykonuje Duplicate Address Detection, wysyłając Neighbor Solicitation do własnego adresu. Flaga M w RA informuje hosty, że muszą użyć DHCPv6 do uzyskania adresu, natomiast flaga O nakazuje użycie DHCPv6 do pobrania opcji, takich jak DNS. Gdy obie flagi M i O są równe zero, host korzysta wyłącznie z SLAAC bez DHCPv6. Mechanizm SLAAC znacząco upraszcza zarządzanie siecią, ponieważ nie wymaga serwera DHCP. Administrator musi jednak pamiętać o odpowiednim skonfigurowaniu routera do wysyłania poprawnych komunikatów RA.

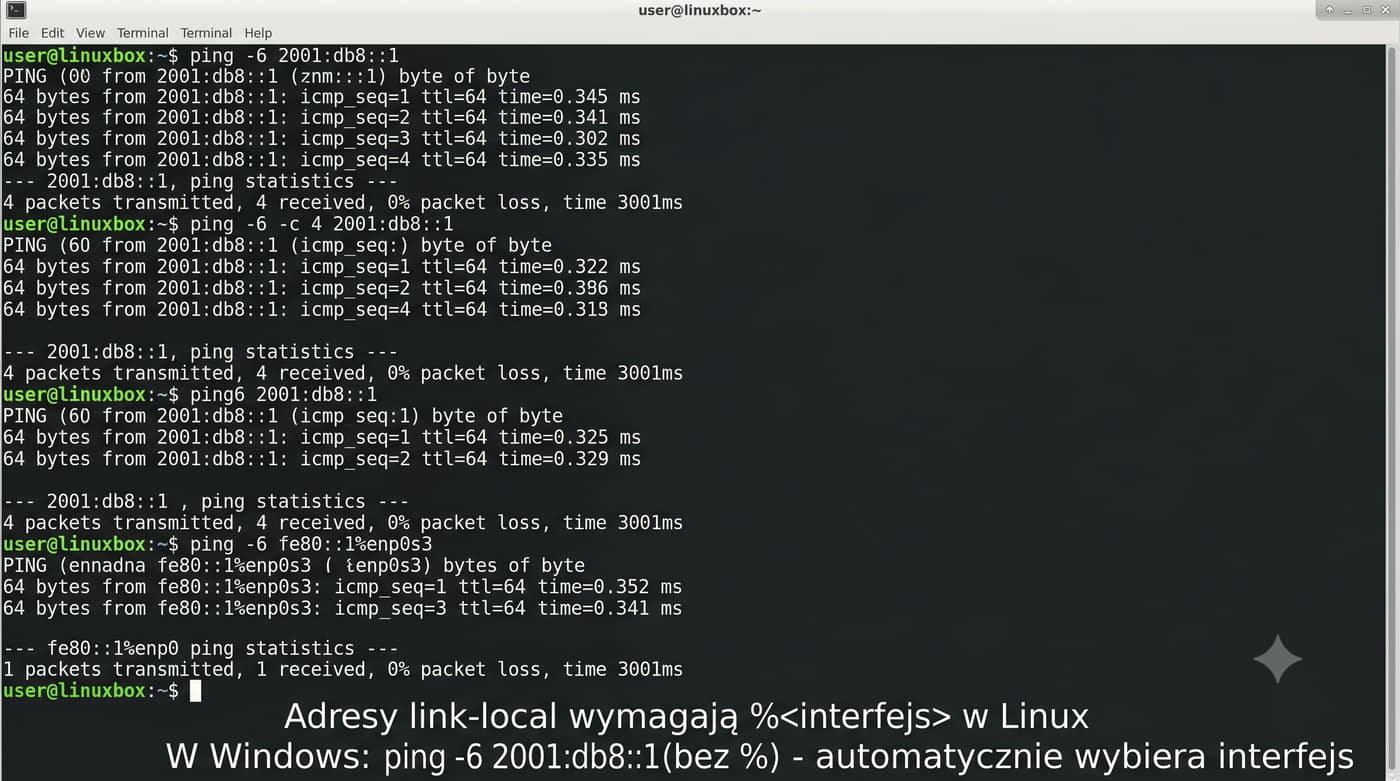
31/43 Narzędzia – ping6 / ping -6

ping dla IPv6:

# jawnie protokół IPv6
ping -6 2001:db8::1
ping -6 -c 4 2001:db8::1

# lub stara składnia (ping6)
ping6 2001:db8::1
ping6 -c 4 2001:db8::1

# ping do interfejsu (link-local wymaga scope)
ping -6 fe80::1%enp0s3
ping6 -c 2 fe80::1%enp0s3

Wskazówki:

  • Adresy link-local wymagają %<interfejs> w Linux
  • W Windows adresy globalne, jak ping -6 2001:db8::1, pinguje się bez %, natomiast adresy link-local wymagają identyfikatora strefy, np. ping -6 fe80::1%5

Narzędzie ping w wersji dla IPv6 wykorzystuje ICMPv6 Echo Request typu 128 i Echo Reply typu 129, odpowiednik ICMP Echo w IPv4. W nowoczesnych dystrybucjach Linux ping z flagą -6 wymusza użycie protokołu IPv6, ale program automatycznie wybiera IPv6, jeśli nazwa DNS zwraca rekord AAAA. W starszych systemach ping6 było osobnym narzędziem, obecnie zunifikowanym z ping. Podczas pingowania adresów link-local wymagane jest podanie identyfikatora interfejsu po znaku procentu, na przykład ping -6 fe80::1%enp0s3. W systemie Windows adresy link-local można pingować bez podawania interfejsu, ponieważ system automatycznie wybiera odpowiedni interfejs. Ping IPv6 obsługuje wszystkie standardowe opcje znane z IPv4, takie jak liczba pakietów, interwał czy rozmiar pakietu. Do testowania łączności IPv6 z adresem publicznym warto użyć serwera DNS Google 2001:4860:4860::8888. Narzędzie ping jest pierwszym krokiem w diagnostyce problemów sieciowych również w przypadku IPv6.

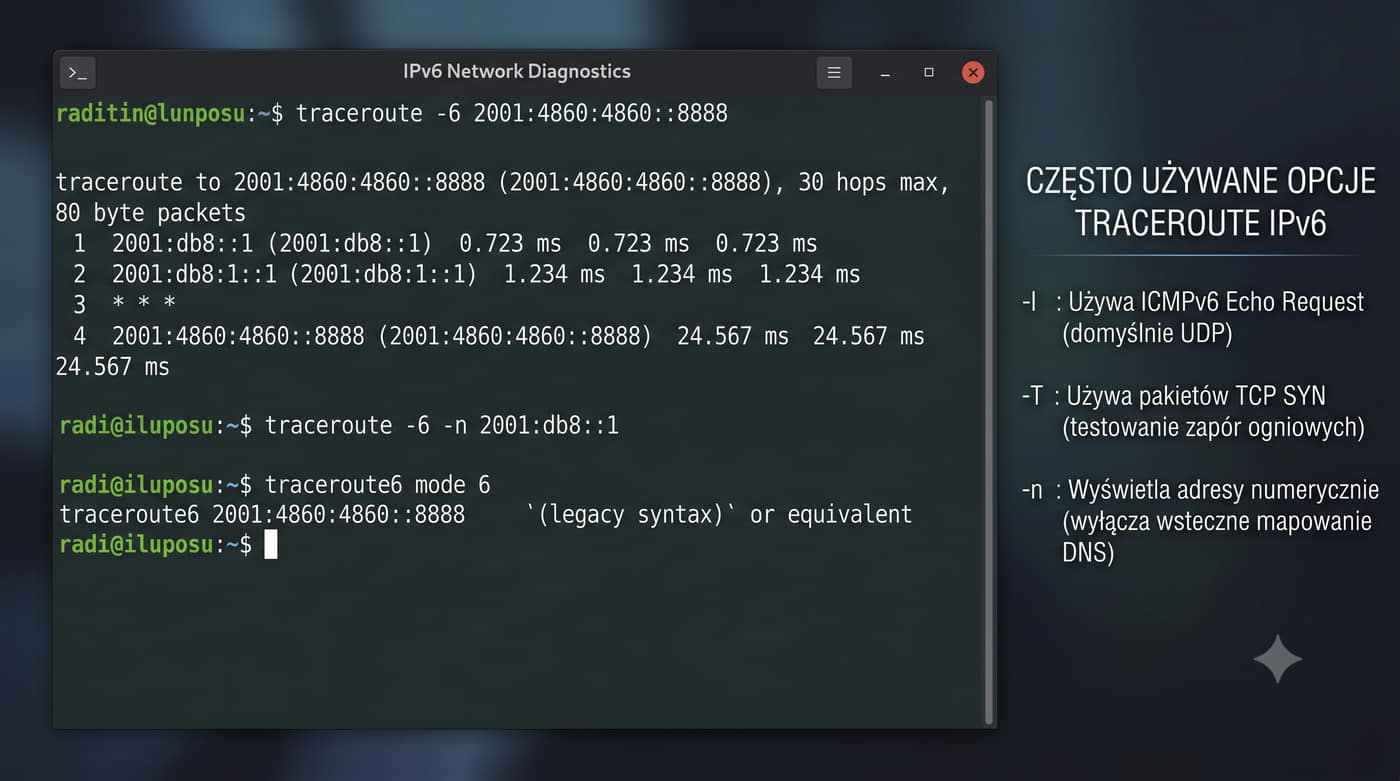
32/43 Narzędzia – traceroute -6
# jawnie IPv6
traceroute -6 2001:db8::1
traceroute -6 -n 2001:db8::1

# stara składnia
traceroute6 2001:4860:4860::8888

Przykładowy wynik:

traceroute to 2001:4860:4860::8888 (2001:4860:4860::8888)
 1  2001:db8::1  0.723 ms  0.689 ms  0.498 ms
 2  2001:db8:1::1  1.234 ms  1.567 ms  1.345 ms
 3  * * *
 4  2001:4860:4860::8888  24.567 ms  24.123 ms  23.987 ms

Wskazówki:

  • Domyślnie pakiet UDP (zwiększający TTL/Hop Limit)
  • -I – używa ICMPv6 Echo
  • -T – używa TCP SYN

traceroute dla IPv6 – traceroute6 lub traceroute -6:

Narzędzie traceroute w wersji dla IPv6 wykorzystuje pole Hop Limit w nagłówku IPv6, które jest odpowiednikiem TTL w IPv4. Domyślnie traceroute -6 wysyła pakiety UDP na docelowy port, zwiększając stopniowo wartość Hop Limit od jednego aż do osiągnięcia celu. W systemie Linux pole Hop Limit jest ośmiobitowe, więc maksymalna możliwa wartość to 255; domyślna wartość nadawana pakietom wynosi jednak 64. Opcja -I w traceroute przełącza na pakiety ICMPv6 Echo, a opcja -T używa pakietów TCP SYN, co może być przydatne przy blokadach firewall. W systemie Windows odpowiednikiem jest polecenie tracert -6, które domyślnie używa ICMPv6. Nowoczesne wersje traceroute automatycznie rozpoznają protokół na podstawie adresu docelowego, co eliminuje konieczność podawania flagi -6. Brak odpowiedzi z pośrednich routerów może oznaczać, że firewall blokuje pakiety ICMPv6. traceroute jest niezbędnym narzędziem do lokalizacji problemów z routingiem w sieci IPv6.

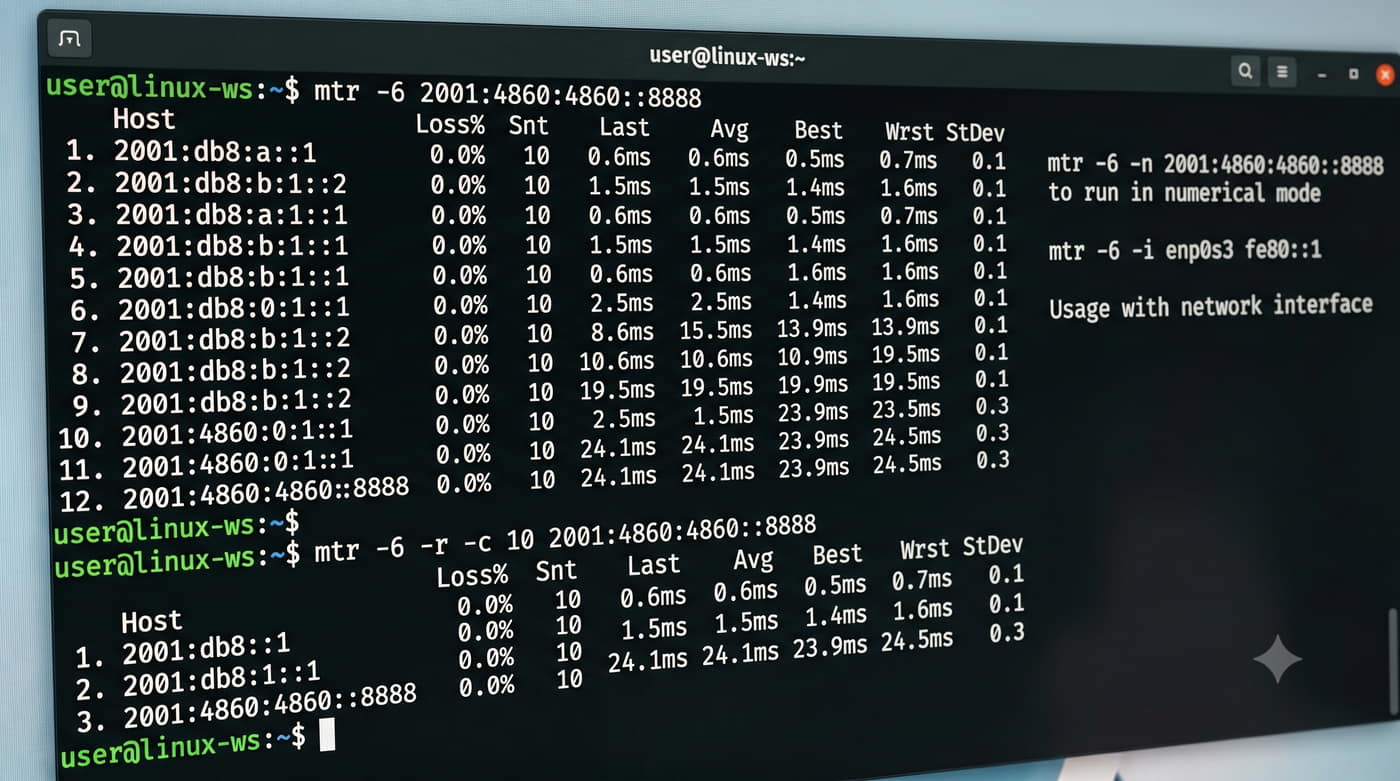
33/43 Narzędzia – mtr -6 (My Traceroute)
# IPv6
mtr -6 2001:4860:4860::8888
mtr -6 -r -c 10 2001:4860:4860::8888
# -r raport, -c liczba pakietów

# wyświetlanie adresów IPv6 zamiast DNS
mtr -6 -n 2001:4860:4860::8888

# interfejs link-local
mtr -6 -I enp0s3 fe80::1

Przykładowy raport:

  Loss%  Snt  Last  Avg  Best  Wrst StDev
 1. 2001:db8::1  0.0%  10  0.5  0.6  0.4  1.2  0.2
 2. 2001:db8:1::1  0.0%  10  1.2  1.5  1.1  2.3  0.3
 3. 2001:4860:4860::8888  0.0%  10  23.4  24.1  22.8  26.7  1.1

mtr łączy ping + traceroute w czasie rzeczywistym:

Narzędzie mtr łączy w sobie funkcjonalność ping i traceroute, wyświetlając w czasie rzeczywistym statystyki opóźnień i strat pakietów na każdym hopie. Wersja dla IPv6 uruchamiana jest flagą -6 lub automatycznie po podaniu adresu IPv6 jako celu. Raport mtr z opcją -r i -c pozwala na wygenerowanie zbiorczych statystyk do analizy w skryptach. mtr jest szczególnie przydatny do diagnostyki asymetrycznych ścieżek routingu, gdzie ping i traceroute osobno mogą nie ujawnić problemu. W przypadku adresów link-local konieczne jest podanie interfejsu za pomocą opcji -I (wielka litera), analogicznie jak w ping (mała litera -i oznacza w mtr odstęp czasu między pakietami). Program mtr domyślnie wyświetla nazwy DNS dla każdego hopha, ale opcja -n pozwala na wyświetlenie samych adresów IP. Wykres strat pakietów w mtr pomaga szybko zidentyfikować przeciążone lub uszkodzone łącza. mtr to standardowe narzędzie w zestawie każdego administratora sieci pracującego z IPv6.

34/43 Narzędzia – ip -6 zaawansowane

Polecenie ip z rodziną -6:

Adresy:

ip -6 addr show
ip -6 addr show dev enp0s3
ip -6 addr add 2001:db8::5/64 dev enp0s3

Sąsiedzi (NDP cache):

ip -6 neigh show
ip -6 neigh show dev enp0s3
ip -6 neigh flush dev enp0s3

Trasy:

ip -6 route show
ip -6 route show dev enp0s3
ip -6 route get 2001:db8::1
ip -6 route add 2001:db8:2::/64 via 2001:db8::ff

Podgląd połączeń:

ss -6 -tln
ss -6 -uap

Zaawansowane użycie polecenia ip -6 obejmuje zarządzanie tablicą sąsiadów, trasami oraz adresami na interfejsach. Polecenie ip -6 neigh flush pozwala na wyczyszczenie całej tablicy NDP, co jest przydatne przy rozwiązywaniu problemów z nieaktualnymi wpisami. Do diagnostyki routingu szczególnie przydatne jest ip -6 route get, które pokazuje konkretną trasę do wskazanego adresu docelowego. Polecenie ip -6 addr flush usuwa wszystkie adresy IPv6 z interfejsu, co może być potrzebne przy zmianie konfiguracji. Podgląd aktywnych połączeń IPv6 realizuje się za pomocą ss -6 z odpowiednimi opcjami, na przykład ss -6 -tln dla nasłuchujących gniazd TCP. W systemie Linux narzędzie ip z flagą -6 działa identycznie jak dla IPv4, ale operuje wyłącznie na protokole IPv6. Wszystkie operacje na adresach, trasach i sąsiadach dostępne w ip dla IPv4 mają swoje odpowiedniki w ip -6. Znajomość tych zaawansowanych poleceń znacząco przyspiesza rozwiązywanie problemów sieciowych.

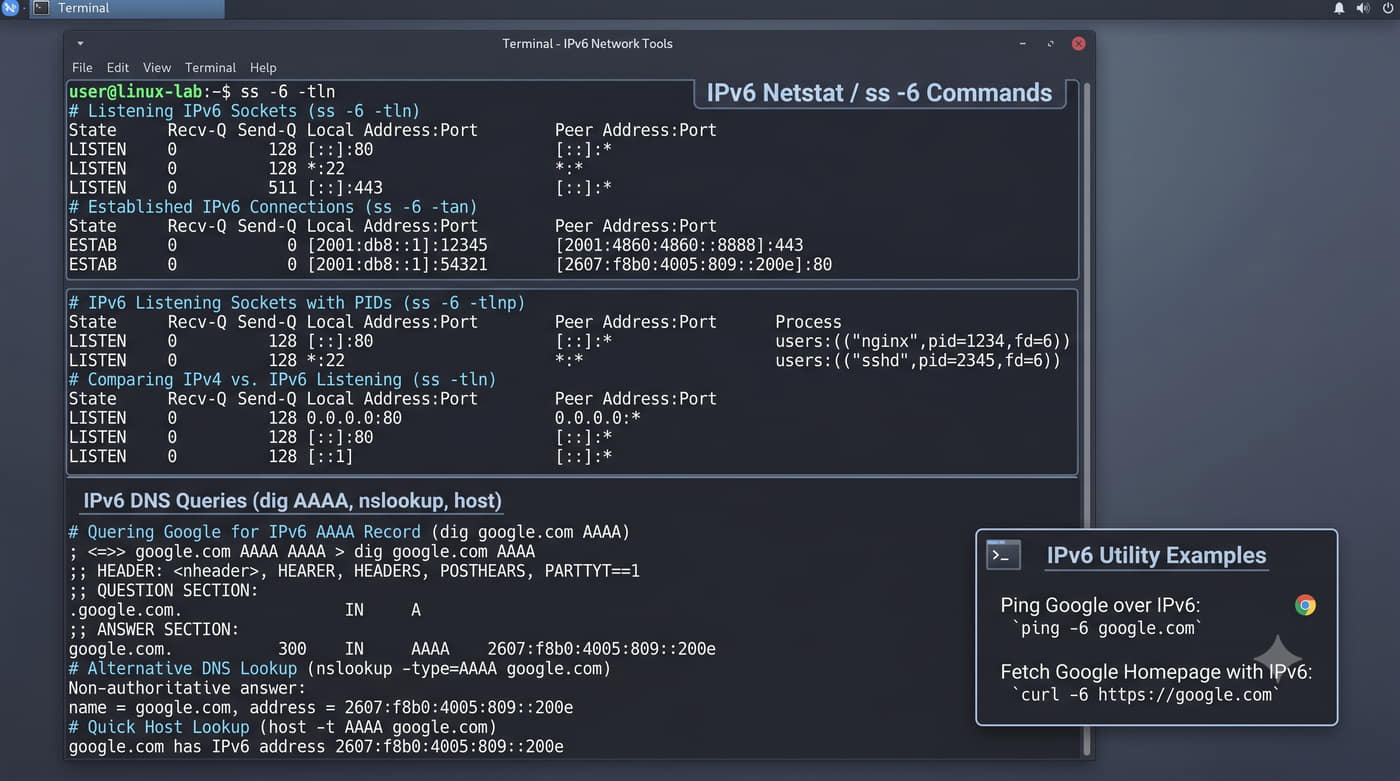
35/43 Narzędzia – ss -6 i DNS AAAA

ss -6 – gniazda IPv6:

# wszystkie nasłuchujące IPv6
ss -6 -tln

# połączenia TCP IPv6 (ustanowione)
ss -6 -tan

# socket IPv6 z procesem
ss -6 -tlnp

# porównanie IPv4 vs IPv6
ss -tln  # wszystkie (IPv4 + IPv6)

DNS AAAA – rekord dla IPv6:

# zapytanie o rekord AAAA
dig google.com AAAA
nslookup -type=AAAA google.com
host -t AAAA google.com
ping -6 google.com
curl -6 https://google.com

Sprawdzenie dostępności IPv6 dla domeny:

Narzędzie ss z flagą -6 wyświetla informacje o gniazdach IPv6, w tym nasłuchujących serwerach i aktywnych połączeniach. Rekord AAAA w DNS jest odpowiednikiem rekordu A dla IPv4 i przechowuje adres IPv6 przypisany do nazwy domenowej. Zapytanie o rekord AAAA wykonuje się za pomocą polecenia dig google.com AAAA lub nslookup z typem AAAA. Odwrotna translacja adresu IPv6 na nazwę domenową odbywa się w specjalnej domenie ip6.arpa, a nie in-addr.arpa jak dla IPv4. Polecenie dig -x z adresem IPv6 automatycznie wykonuje zapytanie PTR w domenie ip6.arpa. W systemie Linux sprawdzenie dostępności IPv6 dla domeny można wykonać za pomocą ping -6 lub curl -6 z nazwą domenową. Większość nowoczesnych przeglądarek, w tym Firefox i Chrome, preferuje IPv6 zgodnie z mechanizmem Happy Eyeballs. Administrator powinien regularnie monitorować dostępność IPv6 swoich usług za pomocą narzędzi takich jak test-ipv6.com.

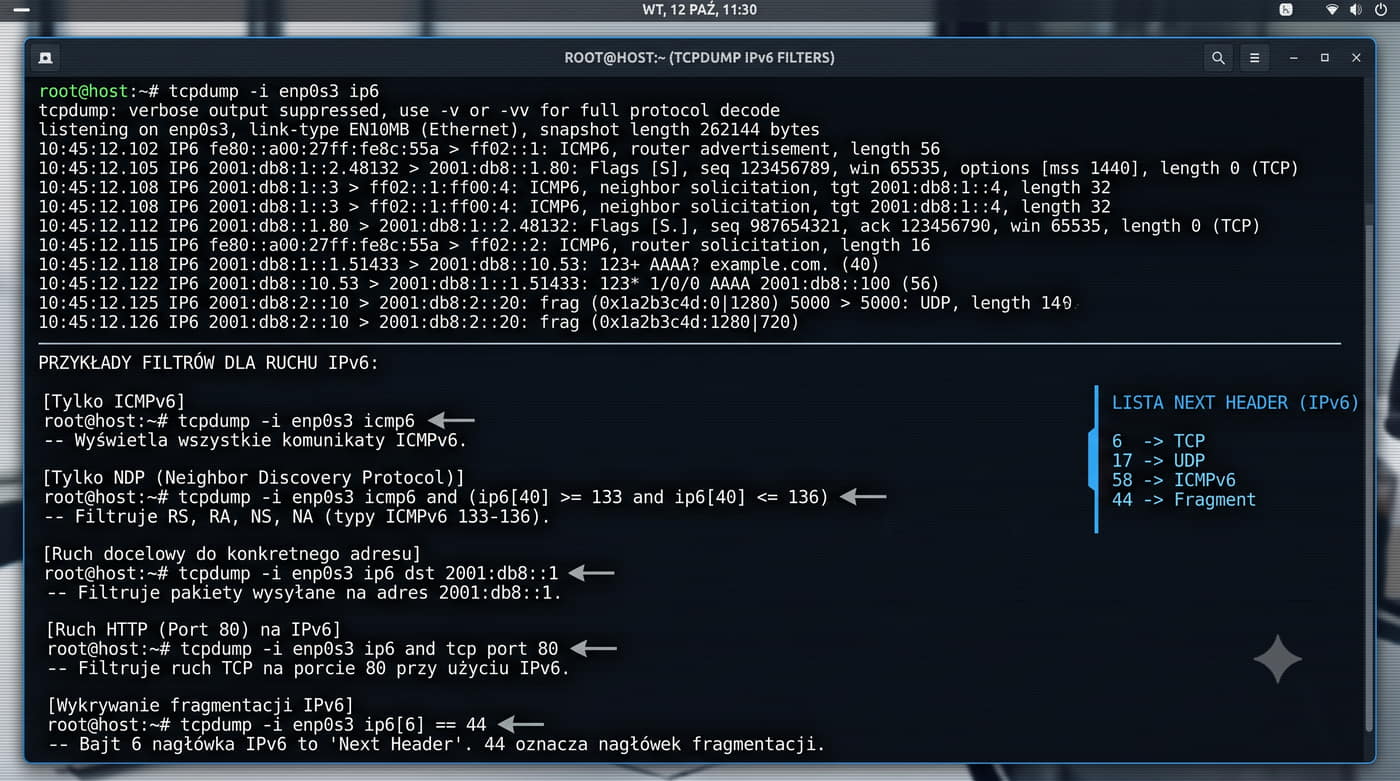
36/43 Narzędzia – tcpdump dla IPv6

tcpdump – analiza ruchu IPv6:

# cały ruch IPv6
tcpdump -i enp0s3 ip6

# tylko ICMPv6
tcpdump -i enp0s3 icmp6

# tylko NDP (NS/NA/RS/RA)
tcpdump -i enp0s3 'icmp6 and (ip6[40] >= 133 and ip6[40] <= 136)'

# ruch do/z konkretnego adresu
tcpdump -i enp0s3 'ip6 dst 2001:db8::1'

# TCP port 80 na IPv6
tcpdump -i enp0s3 'ip6 and tcp port 80'

# filtrowanie po fragmencie
tcpdump -i enp0s3 'ip6[6] == 44'

Program tcpdump z filtrem ip6 przechwytuje cały ruch IPv6, umożliwiając szczegółową analizę pakietów. Filtr icmp6 ogranicza przechwytywanie wyłącznie do komunikatów ICMPv6, co jest przydatne przy debugowaniu NDP i PMTUD. Do obserwacji ruchu NDP stosuje się filtr na typy ICMPv6 od 133 do 136, które odpowiadają RS, RA, NS i NA. W tcpdump można filtrować pakiety IPv6 po konkretnym adresie docelowym lub źródłowym za pomocą wyrażeń ip6 dst i ip6 src. Filtrowanie po Next Header pozwala wyodrębnić pakiety określonego protokołu, na przykład TCP z Next Header 6 lub UDP z Next Header 17. Nagłówek fragmentacji w IPv6 ma wartość Next Header 44 i może być filtrowany za pomocą wyrażenia ip6[6] == 44. W praktyce tcpdump jest nieocenionym narzędziem do diagnozowania problemów z łącznością IPv6. Znajomość filtrów BPF dla IPv6 znacząco przyspiesza lokalizację problemów sieciowych.

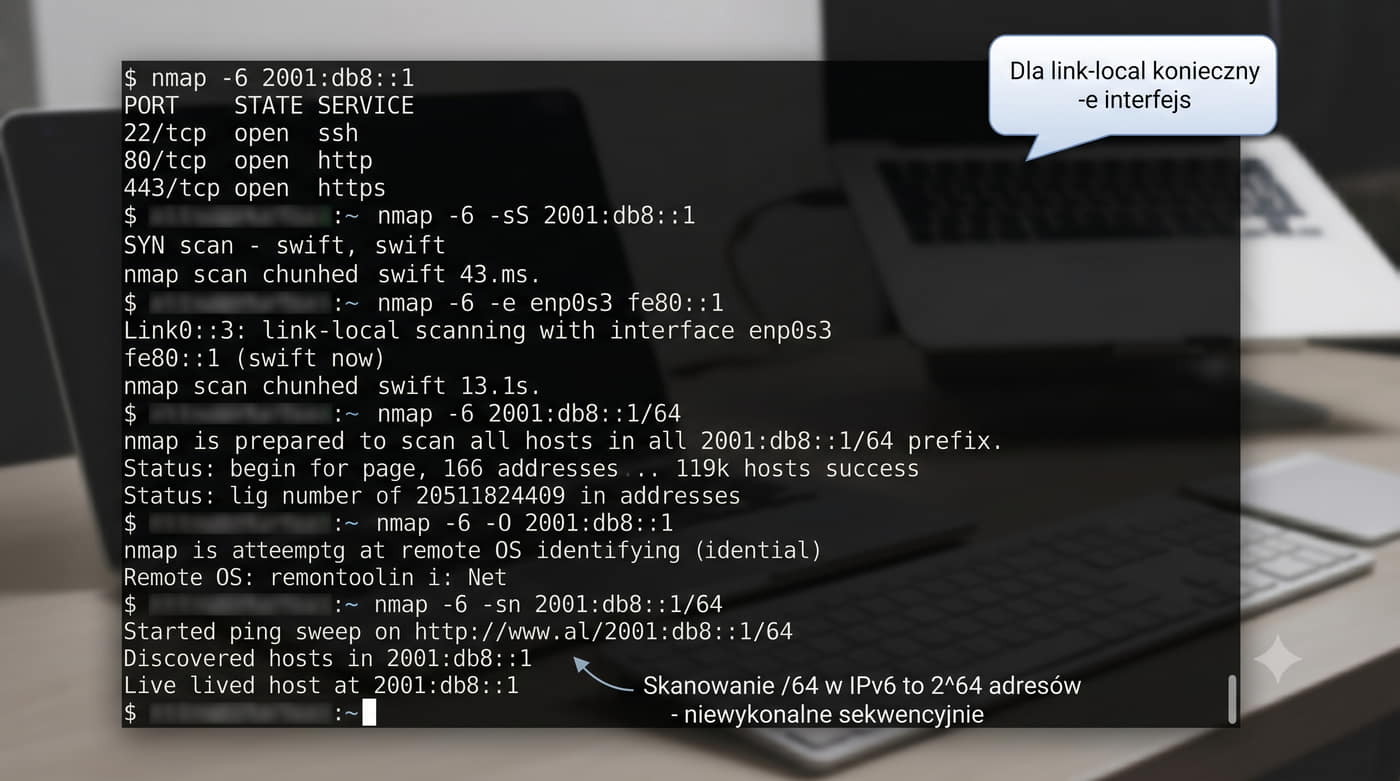
37/43 Narzędzia – nmap dla IPv6

nmap wspiera IPv6 od dawna:

# skanowanie IPv6
nmap -6 2001:db8::1
nmap -6 -sS 2001:db8::1

# skanowanie z interfejsu (dla link-local)
nmap -6 -e enp0s3 fe80::1

# skanowanie subnetu
nmap -6 2001:db8::1/64

# wykrywanie systemu operacyjnego
nmap -6 -O 2001:db8::1

# ping sweep po IPv6
nmap -6 -sn 2001:db8::1/64
Uwaga: Skanowanie /64 w IPv6 to 2^64 adresów – niewykonalne sekwencyjnie. nmap używa heurystyk (ostatnie adresy, adresy EUI-64).

Narzędzie nmap z flagą -6 umożliwia skanowanie portów i wykrywanie usług na hostach IPv6. W przypadku adresów link-local interfejs można wskazać opcją -e albo składnią z procentem, na przykład nmap -6 fe80::1%enp0s3 (obsługiwaną przez nowsze wersje nmap). Skanowanie całej sieci /64 w IPv6 jest praktycznie niewykonalne ze względu na ogromną liczbę możliwych adresów. nmap stosuje heurystyki, takie jak skanowanie ostatnich adresów w podsieci lub adresów wygenerowanych według EUI-64. Do wykrywania systemu operacyjnego na podstawie IPv6 nmap używa dedykowanych sygnatur dla stosów IPv6. Polecenie nmap -6 -sn wykonuje ping sweep po IPv6, wysyłając pakiety ICMPv6 Echo Request i Neighbor Solicitation. W środowiskach produkcyjnych skanowanie IPv6 powinno być stosowane ostrożnie ze względu na możliwość zakłócenia działania sieci. nmap pozostaje standardowym narzędziem do audytu bezpieczeństwa sieci również w przypadku protokołu IPv6.

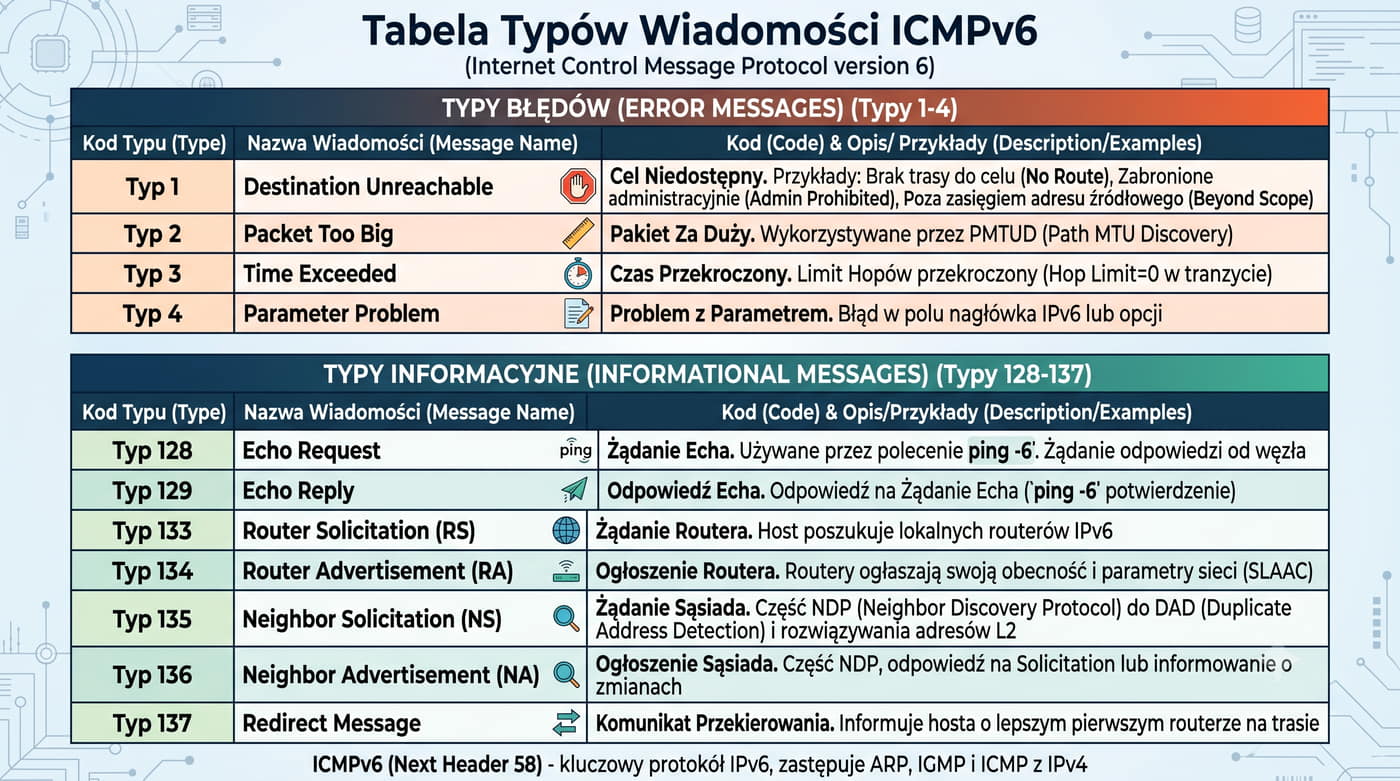
38/43 ICMPv6 – typy wiadomości
TypNazwaRola
1Destination UnreachableBłąd dostarczenia (No Route, Admin Prohibited, Beyond Scope)
2Packet Too BigMTU exceeded – PMTUD
3Time ExceededHop Limit = 0 (traceroute)
4Parameter ProblemBłąd nagłówka IPv6
128Echo Requestping -6
129Echo Replyping -6 odpowiedź
133Router SolicitationRS – "szukam routera"
134Router AdvertisementRA – "jestem routerem, oto prefiks"
135Neighbor SolicitationNS – "kto ma adres?" (NDP/DAD)
136Neighbor AdvertisementNA – "ja mam adres"
137RedirectPrzekierowanie do lepszego routera

ICMPv6 (Next Header 58) – kluczowy protokół IPv6, zastępuje ARP, IGMP i ICMP z IPv4.
Protokół ICMPv6 jest obowiązkowym elementem IPv6, w przeciwieństwie do ICMP w IPv4, który bywa blokowany przez firewall. Komunikaty błędów ICMPv6 obejmują typy od 1 do 4, czyli Destination Unreachable, Packet Too Big, Time Exceeded i Parameter Problem. Typ 2 Packet Too Big jest kluczowy dla mechanizmu PMTUD, ponieważ informuje host o zbyt dużym rozmiarze pakietu. Komunikaty informacyjne obejmują typy od 128 do 137, w tym Echo Request i Echo Reply dla ping, oraz typy NDP od 133 do 137. Zablokowanie ICMPv6 w firewallu może prowadzić do poważnych problemów z łącznością, w tym do całkowitego braku komunikacji. W szczególności blokada typu 2 Packet Too Big uniemożliwia działanie PMTUD, co skutkuje wiszącymi połączeniami TCP. W regułach firewalla należy zawsze przepuszczać komunikaty ICMPv6 związane z NDP i PMTUD. ICMPv6 pełni w IPv6 znacznie więcej funkcji niż ICMP w IPv4, zastępując między innymi ARP i IGMP.

39/43 MTU i PMTUD w IPv6
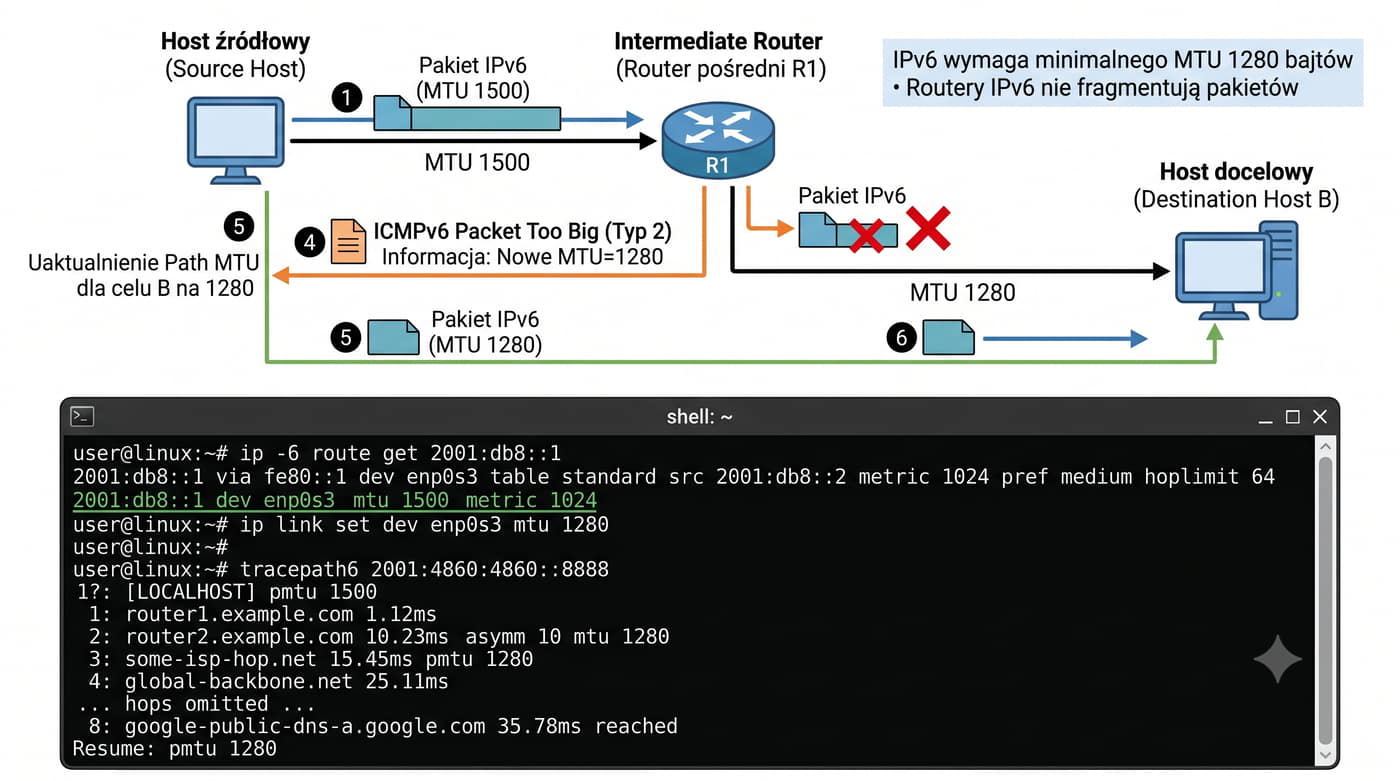
  • Host wysyła pakiet z domyślnym MTU (np. 1500)
  • Jeśli pakiet za duży, router odsyła ICMPv6 Packet Too Big (typ 2)
  • Host zmniejsza MTU i ponawia

Sprawdzenie PMTU:

ip -6 route get 2001:db8::1
# wynik zawiera mtu 1500

# ręczne ustawienie MTU interfejsu
ip link set dev enp0s3 mtu 1280

# podgląd MTU ścieżki
tracepath6 2001:4860:4860::8888

IPv6 wymaga minimalnego MTU 1280 bajtów (vs 576 w IPv4).

Najczęstszy problem: ICMPv6 blokowany w firewallu → PMTUD nie działa → wiszące połączenia.

Routery IPv6 nie fragmentują pakietów – to host musi dostosować rozmiar:

IPv6 wymaga minimalnej wartości MTU wynoszącej 1280 bajtów, co jest znaczącym wzrostem w porównaniu z minimalnym MTU 576 bajtów w IPv4. Mechanizm PMTUD w IPv6 działa przez wysłanie pakietu z domyślnym MTU, a jeśli pakiet jest zbyt duży dla kolejnego łącza, router odsyła ICMPv6 Packet Too Big. Routery IPv6 nie wykonują fragmentacji pakietów, co stanowi istotną różnicę w porównaniu z IPv4, gdzie routery mogły fragmentować pakiety. W IPv6 fragmentacja może być wykonana wyłącznie przez host źródłowy za pomocą nagłówka rozszerzenia Fragment. Do sprawdzenia MTU ścieżki w systemie Linux służy polecenie tracepath6, które wyświetla MTU na każdym hopie. Blokowanie komunikatów ICMPv6 Packet Too Big przez firewall jest jedną z najczęstszych przyczyn problemów z działaniem IPv6. Ręczne ustawienie MTU interfejsu na 1280 może być pomocne w diagnostyce problemów z PMTUD. PMTUD w IPv6 jest niezawodny tylko wtedy, gdy ICMPv6 nie jest blokowany w żadnym punkcie sieci.
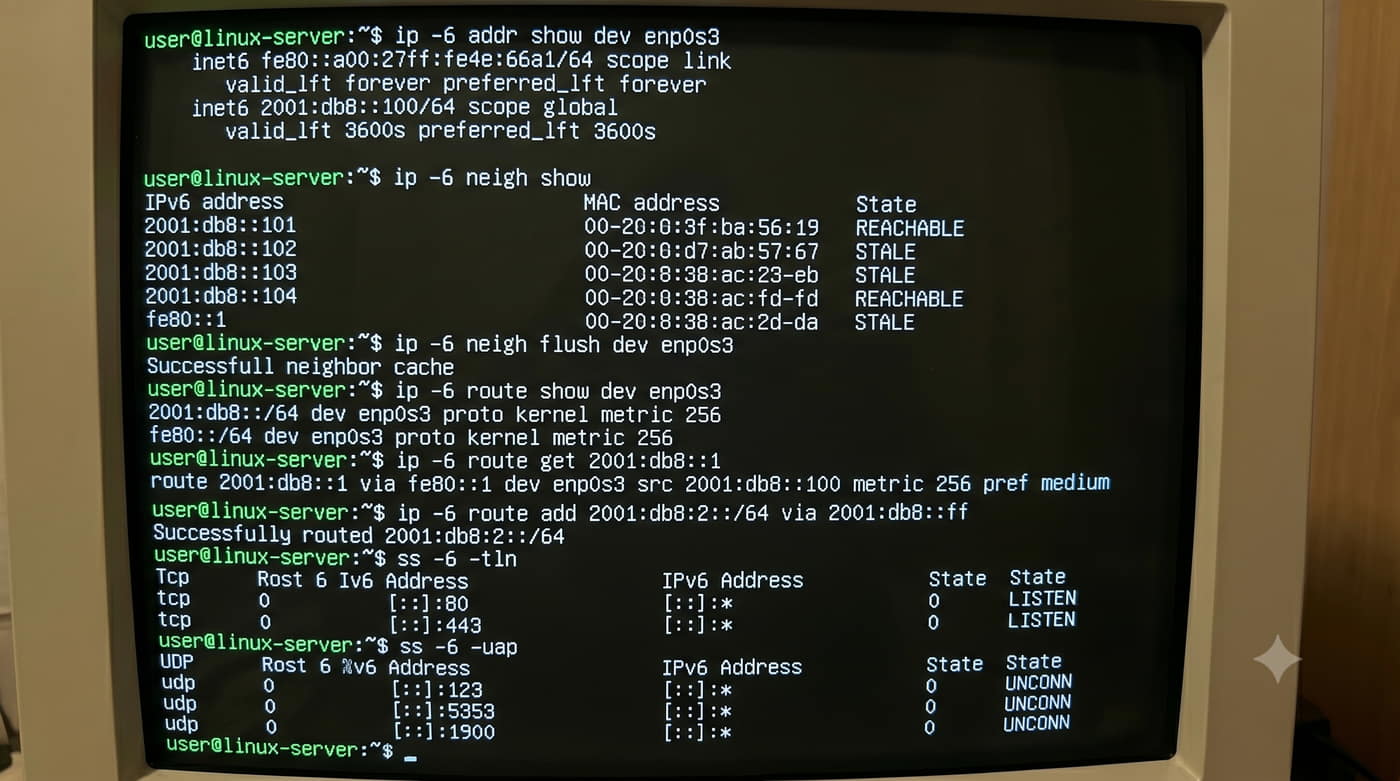
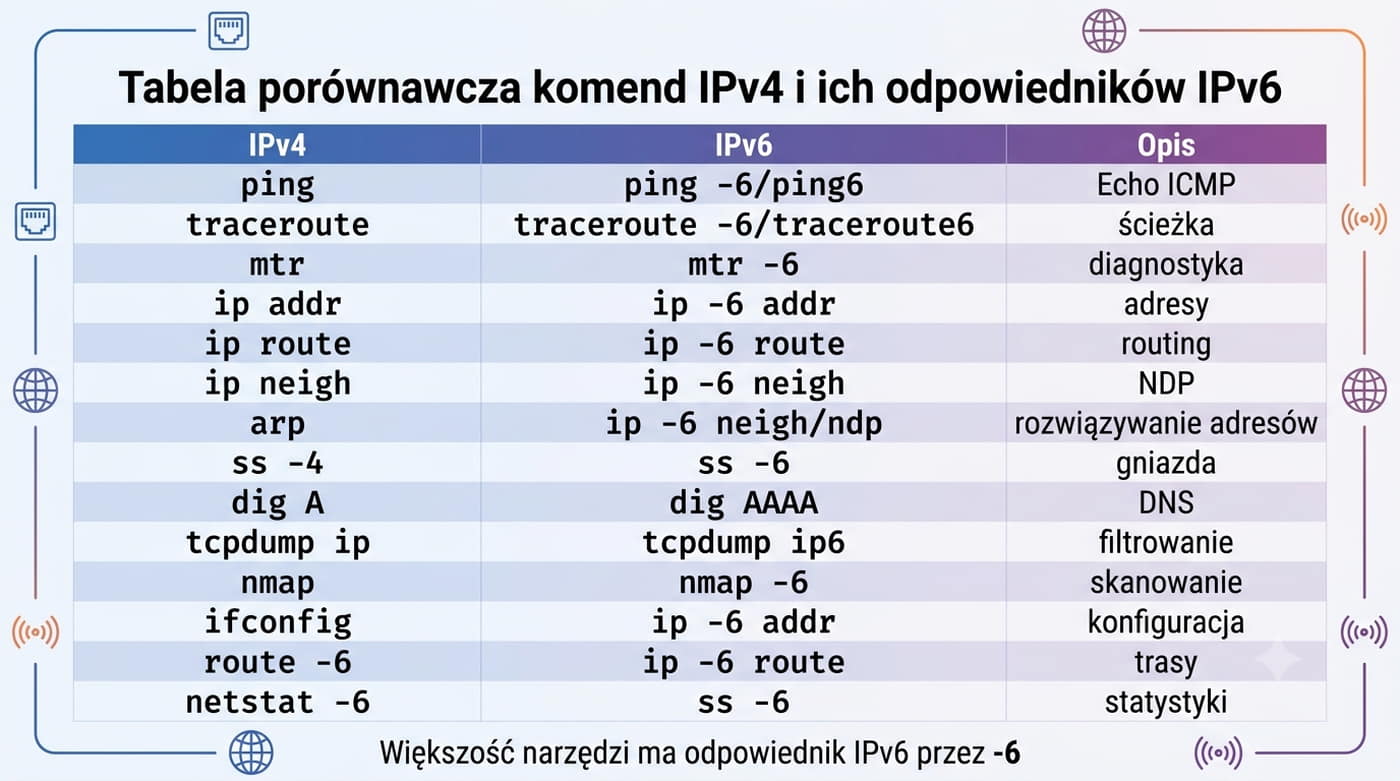
40/43 Tabela komend – IPv6 vs IPv4
IPv4IPv6Opis
pingping -6 / ping6Echo ICMP
traceroutetraceroute -6 / traceroute6Ścieżka pakietów
mtrmtr -6Diagnostyka czasu rzeczywistego
ip addrip -6 addrWyświetlanie adresów
ip routeip -6 routeTablica routingu
ip neighip -6 neighTablica sąsiadów (NDP)
arpip -6 neigh / ndpRozwiązywanie adresów
ss -4ss -6Gniazda sieciowe
dig Adig AAAARekord DNS
tcpdump iptcpdump ip6Filtrowanie ruchu
nmapnmap -6Skanowanie portów
ifconfigip -6 addrKonfiguracja interfejsu
route -6ip -6 routePodgląd tras (przestarzałe)
netstat -6ss -6Statystyki sieci (przestarzałe)

Tabela zestawiająca polecenia IPv4 i IPv6 ułatwia administratorom migrację do nowego protokołu. Polecenia pakietu iproute2 z flagą -6 działają dla IPv6 analogicznie jak ich odpowiedniki dla IPv4 bez flagi. Przestarzałe narzędzia, takie jak ifconfig, route i netstat, w przypadku IPv6 są zastępowane przez ip -6 addr, ip -6 route i ss -6. Ujednolicenie narzędzi w ramach iproute2 upraszcza zarządzanie siecią, ponieważ składnia poleceń jest identyczna dla obu protokołów. Administratorzy znający narzędzia dla IPv4 mogą szybko nauczyć się ich odpowiedników dla IPv6 dzięki spójnej składni. W systemie Linux flagę -6 można stosować praktycznie ze wszystkimi poleceniami iproute2, co czyni pracę z IPv6 intuicyjną. W przypadku starszych narzędzi, takich jak ping, konieczne jest użycie flagi -6 lub dedykowanej wersji ping6. Znajomość odpowiedników poleceń IPv4 w IPv6 jest kluczowa podczas migracji infrastruktury sieciowej.

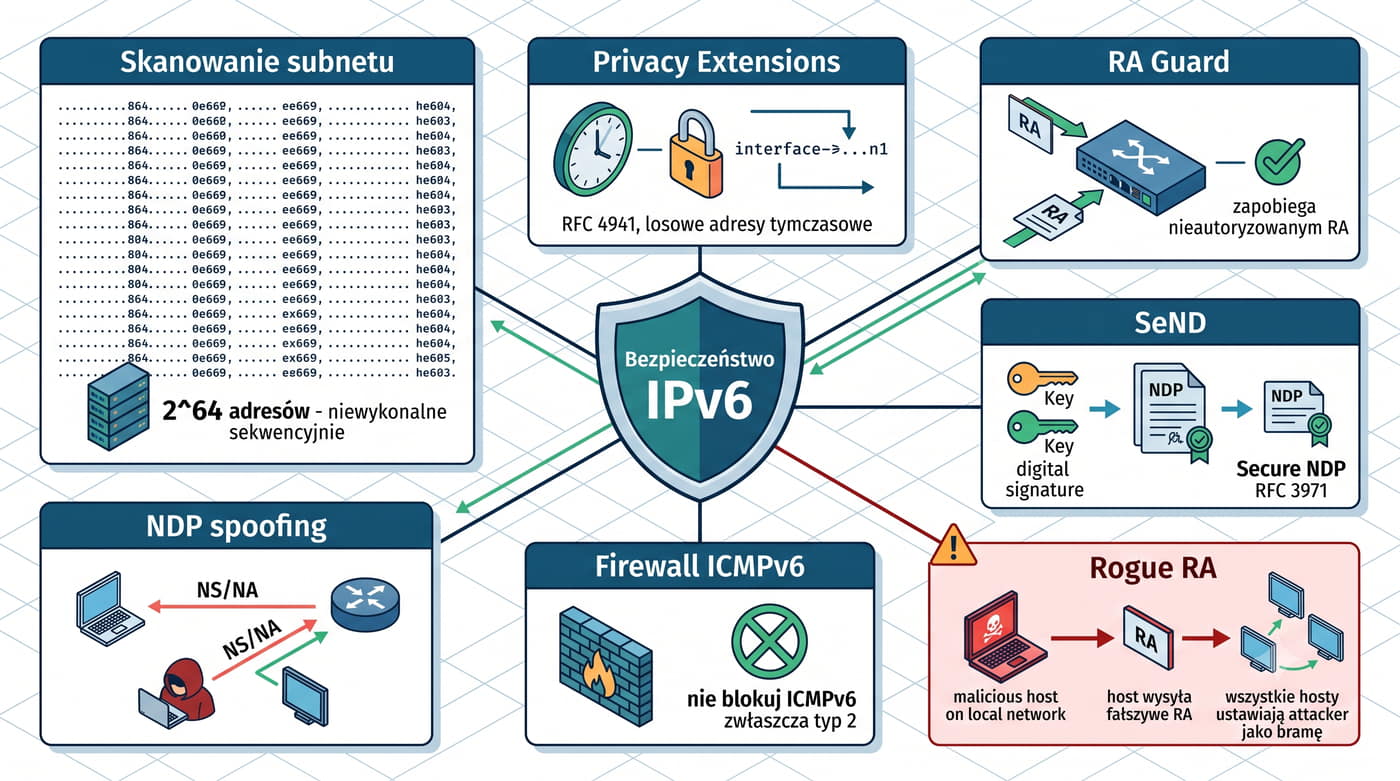
41/43 Bezpieczeństwo IPv6 – podstawy
  • Skanowanie subnetu – /64 to 2^64 adresów – skanowanie sekwencyjne niewykonalne (ale nadal można odkryć adresy przez NDP, DNS, RA)
  • Privacy Extensions (RFC 4941, RFC 8981) – losowe adresy tymczasowe – utrudniają śledzenie hosta
  • RA Guard – zapobiega nieautoryzowanym Router Advertisement (rogue RA – atak MitM)
  • SeND (Secure NDP, RFC 3971) – kryptograficzne uwierzytelnianie NDP (rzadko wdrożone)
  • NDP spoofing – fałszywe NS/NA – odpowiednik ARP spoofing w IPv4
  • Firewall ICMPv6 – nie blokuj ICMPv6 (zwłaszcza typ 2 Packet Too Big, typ 1 Unreachable, ND)

Rogue RA: host wysyła fałszywe RA → wszystkie hosty ustawiają attacker jako bramę.

IPv6 zmienia niektóre aspekty bezpieczeństwa:

Bezpieczeństwo sieci IPv6 różni się od IPv4 w kilku kluczowych aspektach, które administrator musi znać. Duża przestrzeń adresowa /64 utrudnia skanowanie sieci, ale nie uniemożliwia go całkowicie, ponieważ adresy mogą być wykrywane przez NDP i DNS. Mechanizm Privacy Extensions chroni prywatność użytkowników przed śledzeniem poprzez regularną zmianę adresów tymczasowych. Atak Rogue RA polega na wysłaniu fałszywych komunikatów Router Advertisement, które przekierowują ruch przez atakujący host. Zabezpieczenie RA Guard na przełącznikach blokuje nieautoryzowane komunikaty RA na portach dostępowych. Protokół SeND zapewnia kryptograficzne uwierzytelnianie komunikatów NDP, ale jego wdrożenie jest ograniczone ze względu na złożoność. W systemie Linux można ograniczyć ryzyko przez ustawienie accept_ra na zero na zaufanych interfejsach. Firewall dla IPv6 powinien przepuszczać komunikaty ICMPv6 niezbędne do prawidłowego działania protokołu.

42/43 IPv6 – podsumowanie

Co warto zapamiętać:

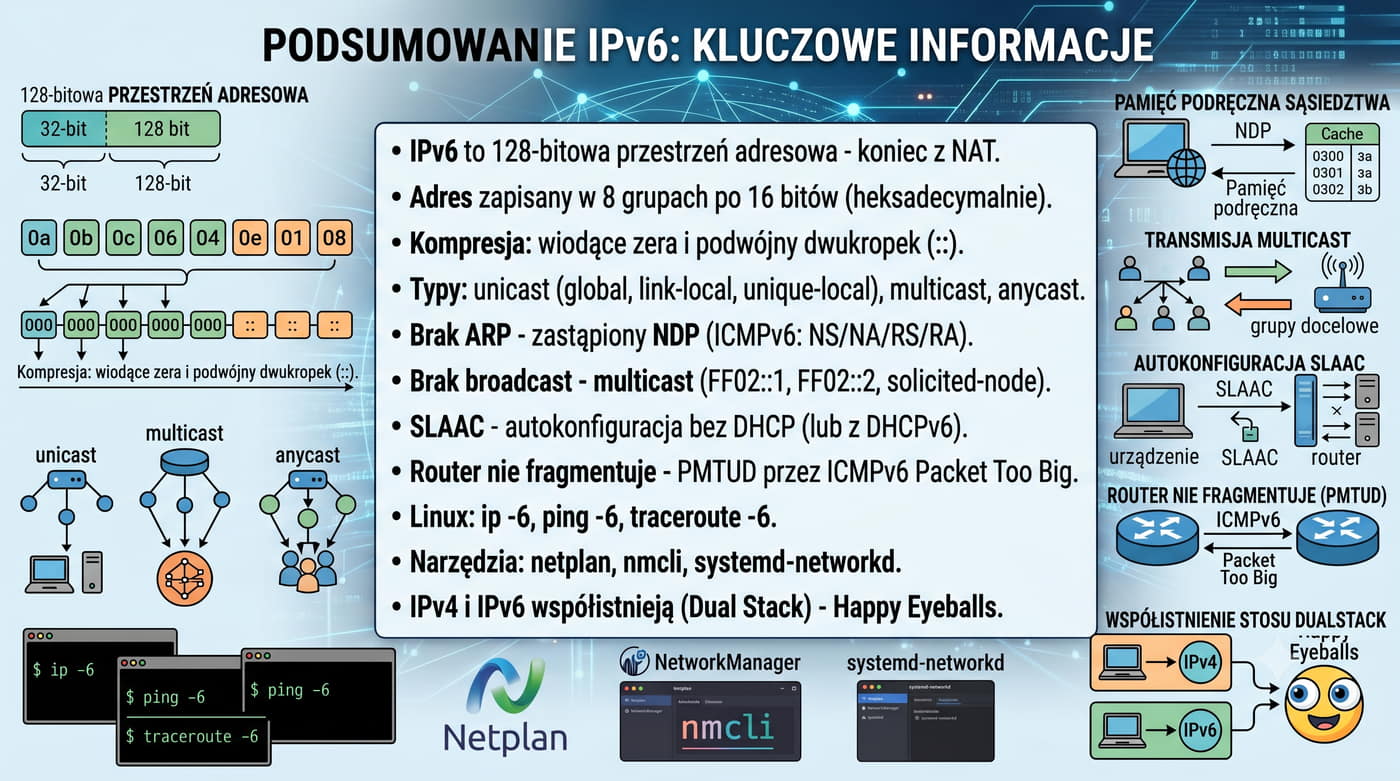
  • IPv6 to 128-bitowa przestrzeń adresowa – koniec z NAT-em (czysty end-to-end)
  • Adres zapisany w 8 grupach po 16 bitów (heksadecymalnie)
  • Kompresja: wiodące zera i podwójny dwukropek (::)
  • Typy: unicast (global, link-local, unique-local), multicast, anycast
  • Brak ARP – zastąpiony NDP (ICMPv6: NS/NA/RS/RA)
  • Brak broadcast – multicast (FF02::1, FF02::2, solicited-node)
  • SLAAC – autokonfiguracja bez DHCP (lub z DHCPv6)
  • Router nie fragmentuje – PMTUD przez ICMPv6 Packet Too Big
  • Linux: ip -6, ping -6, traceroute -6, nmap -6
  • Narzędzia konfiguracji: netplan, nmcli, systemd-networkd
  • IPv6 i IPv4 współistnieją (Dual Stack) – Happy Eyeballs wybiera szybszy

Podsumowując, IPv6 to nie tylko większa przestrzeń adresowa, ale fundamentalnie przeprojektowany protokół sieciowy. Wprowadza on uproszczony nagłówek o stałej długości, wbudowane bezpieczeństwo IPsec oraz automatyczną konfigurację SLAAC. Rezygnacja z NAT przywraca model komunikacji end-to-end, co upraszcza działanie aplikacji sieciowych. Mechanizm NDP zastępuje ARP, a multicast całkowicie eliminuje potrzebę stosowania broadcastu. W systemie Linux wszystkie narzędzia sieciowe obsługują IPv6, często za pomocą tej samej flagi -6. Wdrożenie IPv6 jest nieuniknione ze względu na wyczerpanie puli adresów IPv4. Administratorzy sieci powinni zdobyć praktyczne umiejętności konfiguracji i diagnostyki IPv6. Znajomość IPv6 jest obecnie standardem wymaganym na rynku pracy w branży teleinformatycznej.
43/43 Dziękuję za uwagę!

Pytania?


Igor Brzeżek © 2026

biuro@netstudio.net.pl

Prezentacja "Basic IPv6 – adresacja IPv6 w systemie Linux"

Materiały dydaktyczne – Sieci komputerowe

Serdecznie zachęcam do samodzielnego eksperymentowania z IPv6 w środowisku wirtualnym, na przykład w VirtualBox lub VMware. Praktyczne ćwiczenia z konfiguracją adresów, uruchomieniem radvd i analizą ruchu za pomocą tcpdump są najlepszym sposobem na utrwalenie wiedzy. Warto również skonfigurować własny router IPv6 na Linuxie, aby zrozumieć praktyczne aspekty forwardingu i dystrybucji prefiksów. Do testowania łączności IPv6 z Internetem można użyć publicznych serwerów DNS Google lub Cloudflare. Na stronie test-ipv6.com można sprawdzić, czy dostawca usług internetowych oferuje już IPv6. W przypadku problemów z IPv6 warto sprawdzić logi systemowe za pomocą dmesg i journalctl. Udział w projektach open source związanych z IPv6, takich jak radvd czy systemd-networkd, pogłębia praktyczne zrozumienie protokołu. Życzę owocnej nauki i zachęcam do dalszego zgłębiania tematyki adresacji IPv6.