1/55 Routing dynamiczny

RIP, OSPF, BGP – protokoły routingu w sieciach IP

Prezentacja dotyczy trzech fundamentalnych protokołów routingu dynamicznego: RIP, OSPF i BGP.

Każdy z nich reprezentuje inną kategorię algorytmów: wektor odległości (distance vector), stan łącza (link state) i wektor ścieżki (path vector).

Routing dynamiczny eliminuje potrzebę ręcznej konfiguracji tras na każdym routerze, co jest szczególnie istotne w sieciach o zmiennej topologii.

Protokoły IGP działają wewnątrz systemu autonomicznego, podczas gdy BGP jako jedyny protokół EGP łączy różne systemy autonomiczne w Internecie.

Wybór odpowiedniego protokołu zależy od skali sieci, wymagań dotyczących czasu zbieżności, przepustowości łączy i polityki routingu.

Każdy z omawianych protokołów ma unikalne cechy: RIP jest najprostszy, ale przestarzały, OSPF stanowi standard w nowoczesnych sieciach korporacyjnych, a BGP jest kręgosłupem Internetu.
Routing dynamiczny stanowi fundament nowoczesnych sieci IP, ponieważ umożliwia automatyczne dostosowywanie tablic routingu do zmian w topologii bez udziału administratora. Protokoły dynamiczne wymieniają między sobą informacje o dostępnych trasach, korzystając z określonych metryk do wyboru najlepszej ścieżki. Trzy główne protokoły omawiane w tej prezentacji to RIP, OSPF i BGP, z których każdy reprezentuje inną klasę algorytmów.

RIP działa na zasadzie wektora odległości, co oznacza, że routery przekazują sobie całe tablice routingu i polegają na informacjach pochodzących od sąsiadów. OSPF wykorzystuje algorytm stanu łącza, dzięki któremu każdy router buduje pełną mapę topologii sieci i samodzielnie oblicza optymalne trasy. BGP jako protokół wektora ścieżki działa na poziomie międzysystemowym i podejmuje decyzje na podstawie polityki biznesowej oraz atrybutów ścieżki.

Zrozumienie różnic między tymi protokołami jest kluczowe dla projektowania skalowalnych i niezawodnych sieci. Administrator sieci musi wiedzieć, kiedy zastosować prosty protokół wektora odległości, a kiedy sięgnąć po zaawansowane rozwiązania oparte na stanie łącza lub wektorze ścieżki.

2/55 Automatyzacja tras

Wprowadzenie do routingu dynamicznego

Routing dynamiczny opiera się na automatycznej wymianie informacji o trasach między routerami bez konieczności ręcznej ingerencji administratora.

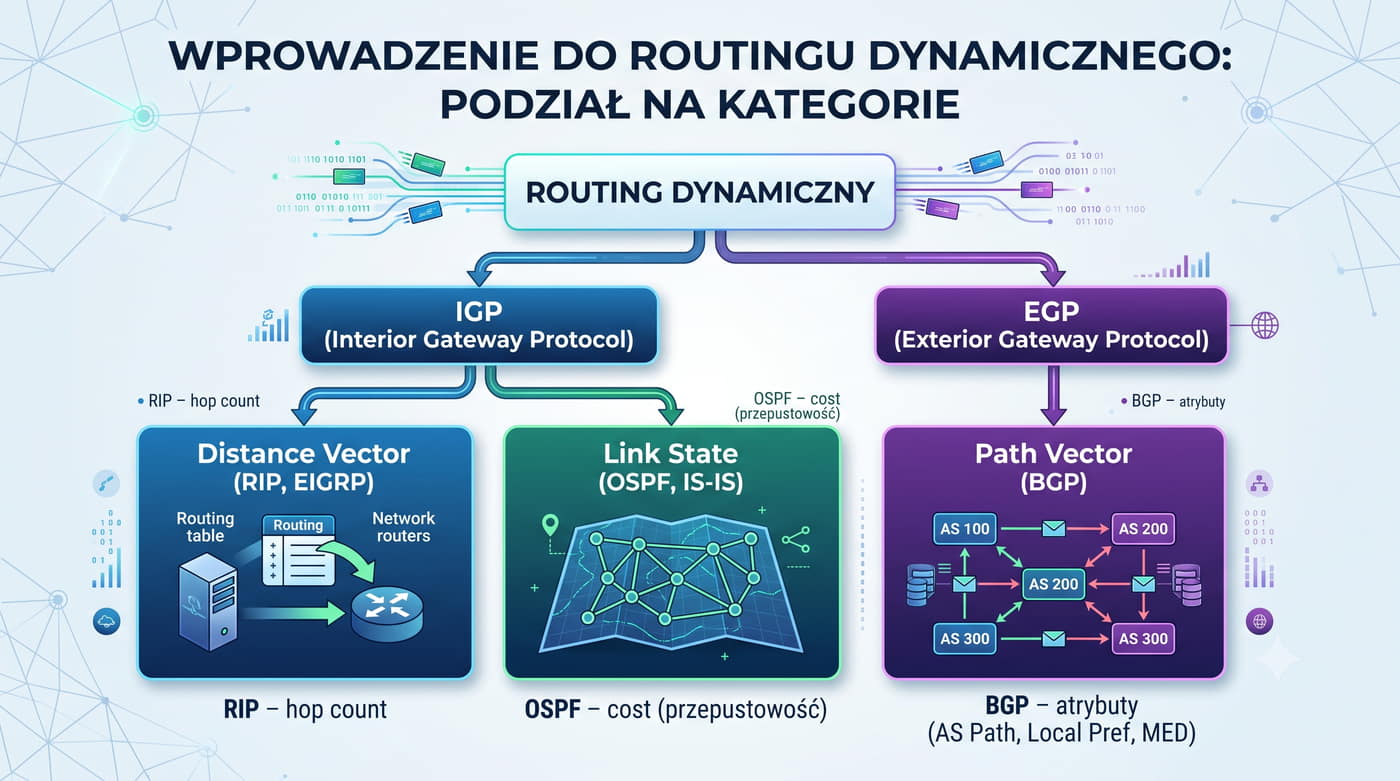
Protokoły routingu dynamicznego dzielą się na dwie główne kategorie: IGP (Interior Gateway Protocol) działające wewnątrz jednego systemu autonomicznego oraz EGP (Exterior Gateway Protocol) łączące różne systemy autonomiczne.

IGP dzielą się dalej na protokoły wektora odległości (RIP, EIGRP), które przekazują tablice routingu do sąsiadów, oraz protokoły stanu łącza (OSPF, IS-IS), które budują pełną mapę topologii sieci.

BGP jako protokół wektora ścieżki używa atrybutów do podejmowania decyzji routingu na podstawie polityki biznesowej.

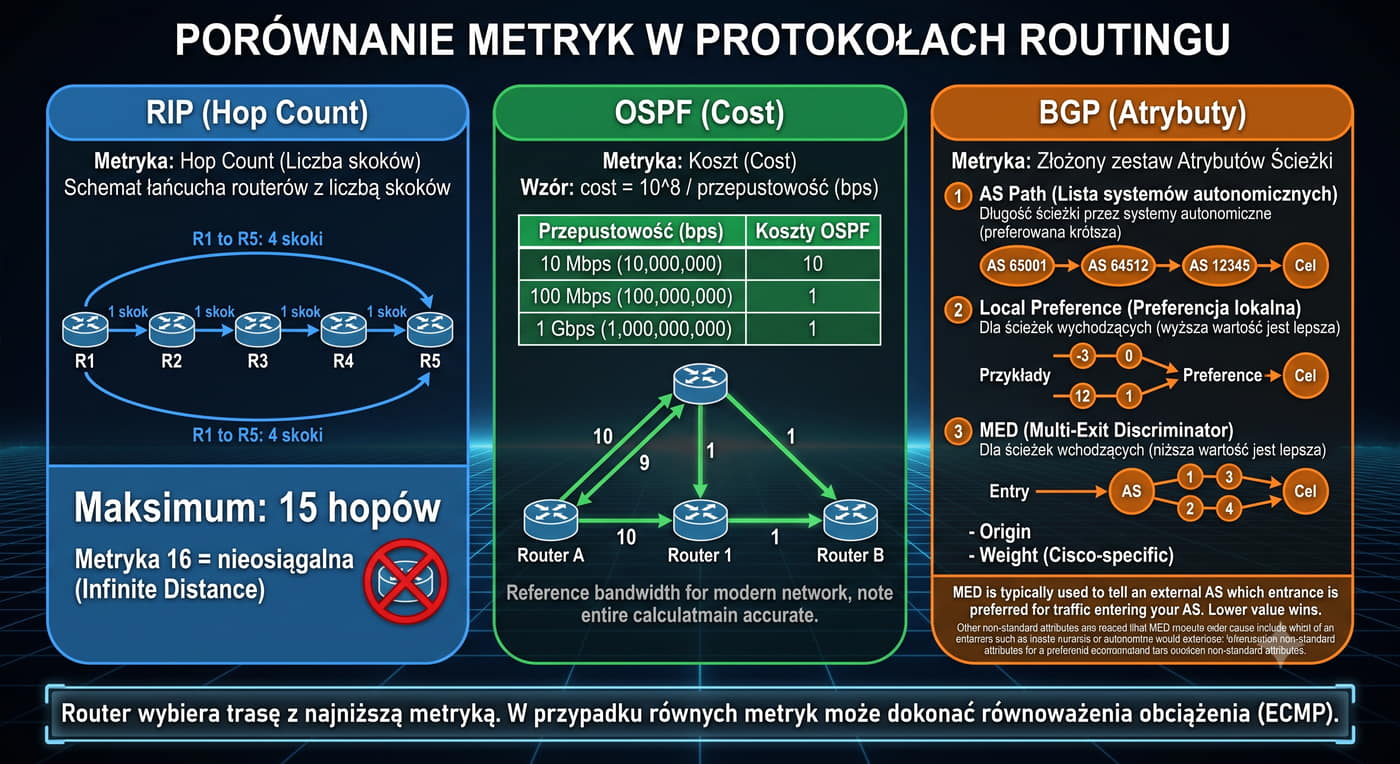
Metryka protokołu określa koszt trasy i służy do wyboru najlepszej ścieżki.

RIP używa liczby skoków (hop count), OSPF używa kosztu zależnego od przepustowości, a BGP używa atrybutów takich jak AS Path, Local Preference i MED.

Automatyzacja tras w routingu dynamicznym polega na wymianie komunikatów routingowych między sąsiednimi routerami, dzięki czemu każdy z nich poznaje sieci dostępne w całej domenie routingu. Proces ten eliminuje konieczność ręcznego wpisywania tras statycznych na każdym urządzeniu sieciowym, co znacząco zmniejsza ryzyko błędów konfiguracji. Protokoły IGP, takie jak RIP i OSPF, działają wewnątrz pojedynczego systemu autonomicznego i dbają o spójność tras wewnętrznych.

Protokoły wektora odległości działają na zasadzie okresowej wymiany całych tablic routingu, co jest proste w implementacji, ale generuje znaczny ruch sieciowy. Protokoły stanu łącza wymieniają jedynie informacje o stanie własnych łączy, co pozwala każdemu routerowi zbudować kompletną mapę topologii i obliczyć optymalne trasy algorytmem Dijkstry.

BGP jako protokół EGP różni się od IGP tym, że nie kieruje się wyłącznie kosztem trasy, ale uwzględnia również politykę biznesową organizacji. Współczesne sieci korporacyjne często łączą w sobie wiele protokołów routingu, stosując OSPF wewnątrz sieci i BGP do komunikacji z dostawcami Internetu.
3/55 Literatura

Materiały źródłowe i dokumentacja

Podręcznik Andrew S. Tanenbauma to kompleksowe źródło wiedzy o architekturze sieci i protokołach routingu.

Klasyczna literatura przedmiotu obejmuje podręczniki akademickie oraz dokumentacje techniczne.

Książka Krzysztofa Nowickiego i Józefa Woźniaka dotyczy routingu w sieciach IP i stanowi polskie opracowanie akademickie.

Dokumentacja RFC (Request for Comments) to podstawowe źródło informacji o standardach protokołów: RFC 1058 dla RIP, RFC 2328 dla OSPFv2 i RFC 4271 dla BGP-4.

Materiały Cisco Systems dotyczące konfiguracji i diagnostyki protokołów routingu są niezbędne w praktyce administracyjnej.

MikroTik Wiki zawiera przykłady konfiguracji routingu dynamicznego w systemie RouterOS, w tym RIP, OSPF i BGP na urządzeniach tego producenta.

Literatura dotycząca protokołów routingu dynamicznego jest obszerna i obejmuje zarówno klasyczne podręczniki akademickie, jak i dokumentację techniczną standardów RFC. Dokumenty RFC są publikowane przez Internet Engineering Task Force i stanowią oficjalne specyfikacje protokołów używanych w Internecie. Znajomość odpowiednich RFC jest niezbędna do głębokiego zrozumienia mechanizmów działania protokołów routingu.

Wśród polskojęzycznych źródeł warto wymienić podręczniki akademickie autorstwa Krzysztofa Nowickiego i innych polskich specjalistów z zakresu sieci komputerowych. Dokumentacja producentów sprzętu sieciowego, takich jak Cisco Systems i MikroTik, dostarcza praktycznych przykładów konfiguracji protokołów routingu na rzeczywistych urządzeniach.

Materiały dydaktyczne dostępne na stronach katedr telekomunikacji polskich uczelni technicznych stanowią cenne uzupełnienie wiedzy teoretycznej. Współczesny administrator sieci powinien regularnie śledzić zmiany w dokumentacjach RFC i uaktualniać swoją wiedzę o nowe standardy i zalecenia.

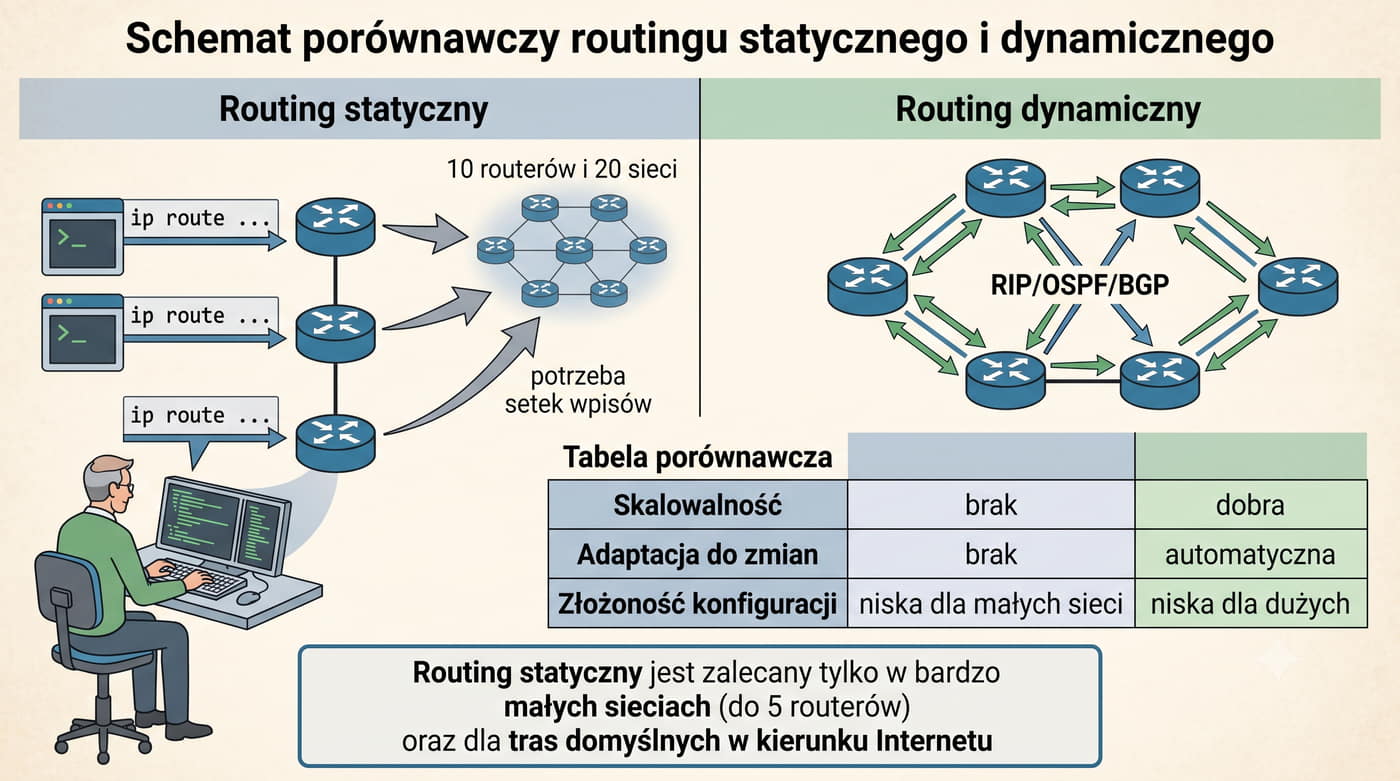
4/55 Routing statyczny vs dynamiczny

Ograniczenia konfiguracji ręcznej

Routing statyczny wymaga od administratora ręcznego dodania każdej trasy na każdym routerze w sieci.

W przypadku topologii z 10 routerami i 20 sieciami liczba wpisów do skonfigurowania może sięgać setek, co jest podatne na błędy i czasochłonne.

Brak adaptacji do zmian topologii stanowi największą wadę routingu statycznego.

W przypadku awarii łącza router kontynuuje próby przesyłania pakietów przez nieistniejącą trasę, co powoduje utratę łączności do czasu ręcznej interwencji administratora.

Routing statyczny nie skaluje się w dużych sieciach – wzrost liczby routerów i sieci powoduje kwadratowy wzrost liczby wymaganych wpisów.

Z tego względu routing statyczny jest zalecany tylko w bardzo małych sieciach (do 5 routerów) oraz dla tras domyślnych w kierunku Internetu.
Routing statyczny i dynamiczny różnią się przede wszystkim skalowalnością i sposobem reagowania na zmiany topologii sieci. W przypadku routingu statycznego administrator musi ręcznie skonfigurować każdą trasę na każdym routerze, co w większych sieciach staje się niepraktyczne i podatne na błędy. Każda zmiana w infrastrukturze, taka jak dodanie nowego łącza czy awaria istniejącego, wymaga ręcznej ingerencji na wszystkich dotkniętych urządzeniach.

Routing dynamiczny automatyzuje ten proces poprzez protokoły wymiany informacji o trasach, które same wykrywają zmiany topologii i dostosowują tablice routingu. Dzięki temu czas reakcji na awarię jest znacznie krótszy, a ryzyko błędów konfiguracyjnych maleje. W sieciach o złożonej topologii różnica w nakładzie pracy między routingiem statycznym a dynamicznym jest ogromna.

Routing statyczny znajduje jednak zastosowanie w małych sieciach do pięciu routerów oraz przy konfiguracji tras domyślnych w kierunku Internetu. W takich przypadkach prostota i przewidywalność zachowania są ważniejsze niż automatyczna adaptacja do zmian.
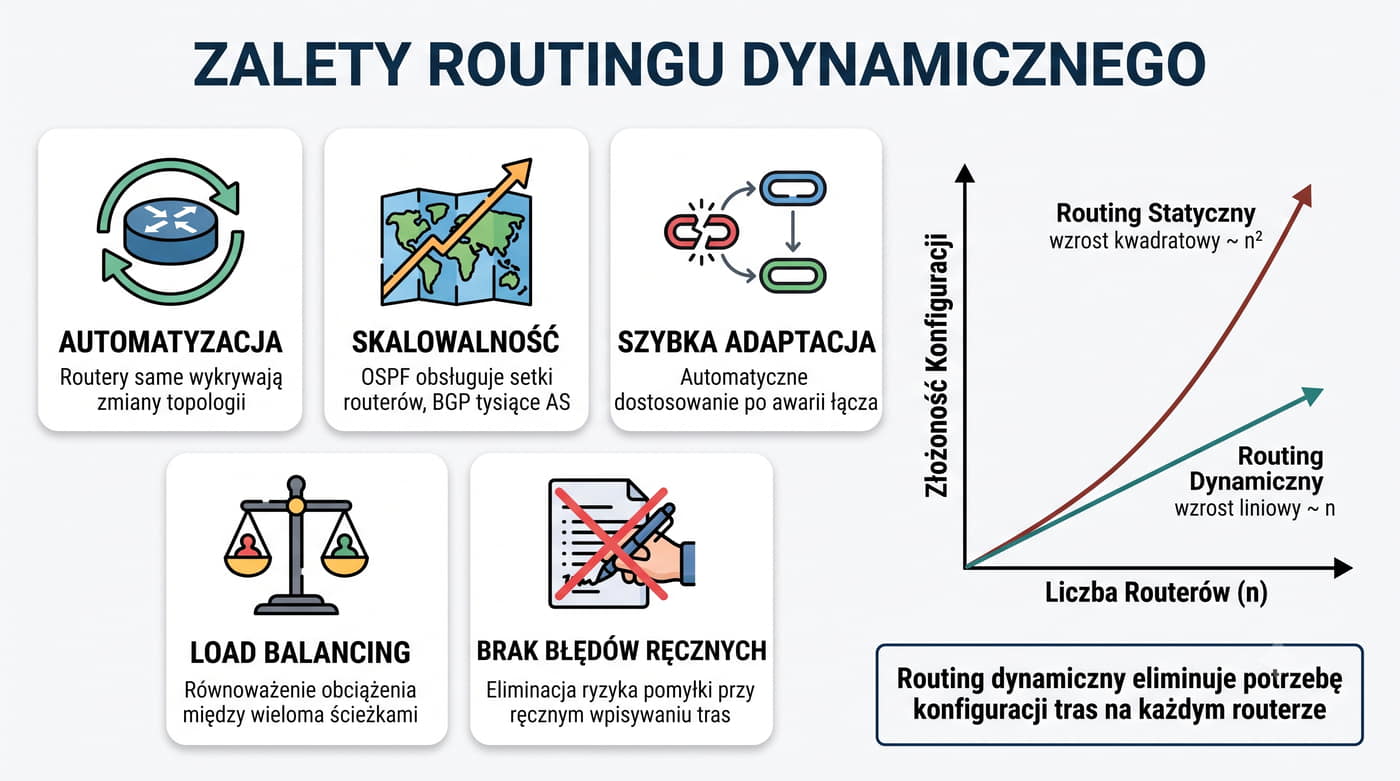
5/55 Zalety routingu dynamicznego

Automatyzacja i skalowalność

Routing dynamiczny automatyzuje proces poznawania tras dzięki mechanizmowi wymiany informacji routingu między routerami.

Routery korzystające z protokołu dynamicznego automatycznie wykrywają zmiany topologii, takie jak awaria łącza czy dodanie nowej sieci, i dostosowują tablice routingu bez potrzeby ręcznej interwencji.

Skalowalność routingu dynamicznego jest ogromna – protokoły takie jak OSPF mogą obsługiwać setki routerów w jednym systemie autonomicznym, a BGP obsługuje tysiące systemów autonomicznych w skali globalnego Internetu.
Routing dynamiczny umożliwia również równoważenie obciążenia (load balancing) między wieloma ścieżkami o równym koszcie, co zwiększa efektywne wykorzystanie dostępnego pasma.

Routing dynamiczny oferuje szereg zalet, które czynią go niezbędnym w nowoczesnych sieciach komputerowych. Automatyczne wykrywanie zmian topologii pozwala na szybką adaptację do awarii łączy bez konieczności interwencji administratora, co minimalizuje przestoje w działaniu sieci. Skalowalność jest kolejnym kluczowym atutem protokoły dynamiczne mogą obsługiwać sieci złożone z setek, a nawet tysięcy routerów.

Równoważenie obciążenia to kolejna ważna funkcja dostępna w protokołach dynamicznych. Gdy istnieje wiele ścieżek o równym koszcie do tej samej sieci docelowej, router może rozdzielić ruch między nie, zwiększając efektywne wykorzystanie dostępnego pasma. Protokoły stanu łącza dodatkowo zapewniają szybką zbieżność rzędu sekund i gwarantują topologię wolną od pętli routingu.

Wybór odpowiedniego protokołu dynamicznego zależy od wielu czynników, w tym od wielkości sieci, wymaganej szybkości zbieżności, dostępnej przepustowości łączy oraz złożoności konfiguracji. Protokoły stanu łącza są obecnie standardem w sieciach korporacyjnych, podczas gdy BGP dominuje w środowiskach operatorskich.

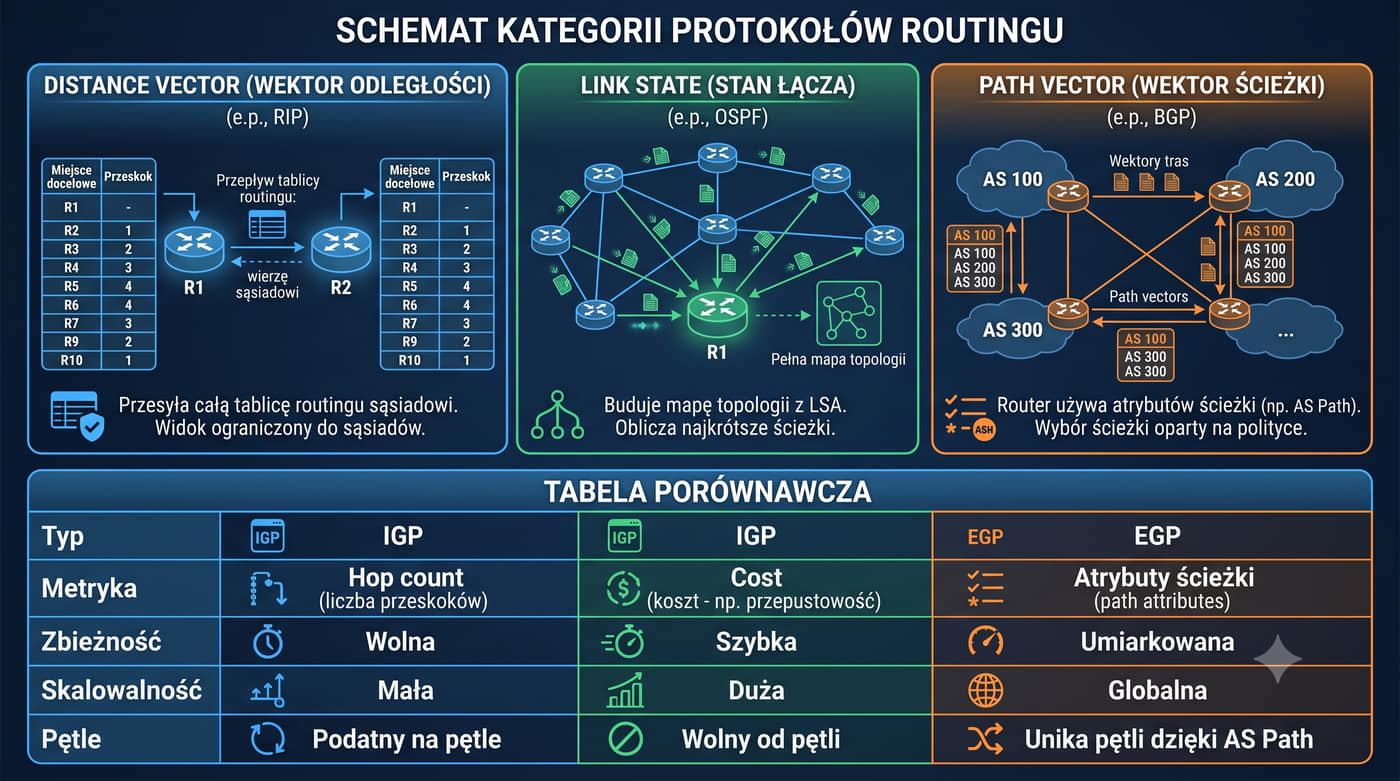
6/55 Kategorie protokołów routingu

IGP vs EGP, Distance Vector vs Link State

Protokoły routingu dzielą się na dwie główne kategorie: IGP (Interior Gateway Protocol) działające wewnątrz pojedynczego systemu autonomicznego oraz EGP (Exterior Gateway Protocol) łączące różne systemy autonomiczne.

Protokoły wektora odległości (distance vector) działają na zasadzie wymiany całej tablicy routingu z bezpośrednimi sąsiadami.

Każdy router ufa informacjom otrzymanym od sąsiada i dodaje własny koszt do danej trasy.

Protokoły stanu łącza (link state) budują pełną mapę topologii sieci przez wymianę informacji o stanie własnych łączy (LSA).

Każdy router oblicza niezależnie najlepsze ścieżki za pomocą algorytmu najkrótszej ścieżki (SPF).

Podział protokołów routingu na kategorie IGP i EGP wynika z architektury systemów autonomicznych w Internecie. Protokoły IGP służą do wymiany informacji o trasach wewnątrz jednego systemu autonomicznego i mogą być oparte na algorytmach wektora odległości lub stanu łącza. Protokoły EGP, z których jedynym dziś stosowanym jest BGP, łączą różne systemy autonomiczne i umożliwiają globalną komunikację w Internecie.

Protokoły wektora odległości charakteryzują się prostotą implementacji, ale mają istotne wady: wolno zbiegają do stabilnego stanu po zmianie topologii i są podatne na pętle routingu. Z kolei protokoły stanu łącza wymagają więcej zasobów obliczeniowych, ale oferują szybką zbieżność i gwarantują brak pętli routingu dzięki algorytmowi najkrótszej ścieżki.

BGP jako protokół wektora ścieżki stanowi hybrydę obu podejść przechowuje pełną ścieżkę AS, co zapobiega pętlom, a jednocześnie pozwala na elastyczne sterowanie ruchem przez modyfikację atrybutów. Wybór odpowiedniej kategorii protokołu zależy od konkretnych wymagań sieciowych i biznesowych.

7/55 System autonomiczny (AS)

Definicja i rola w routingu globalnym

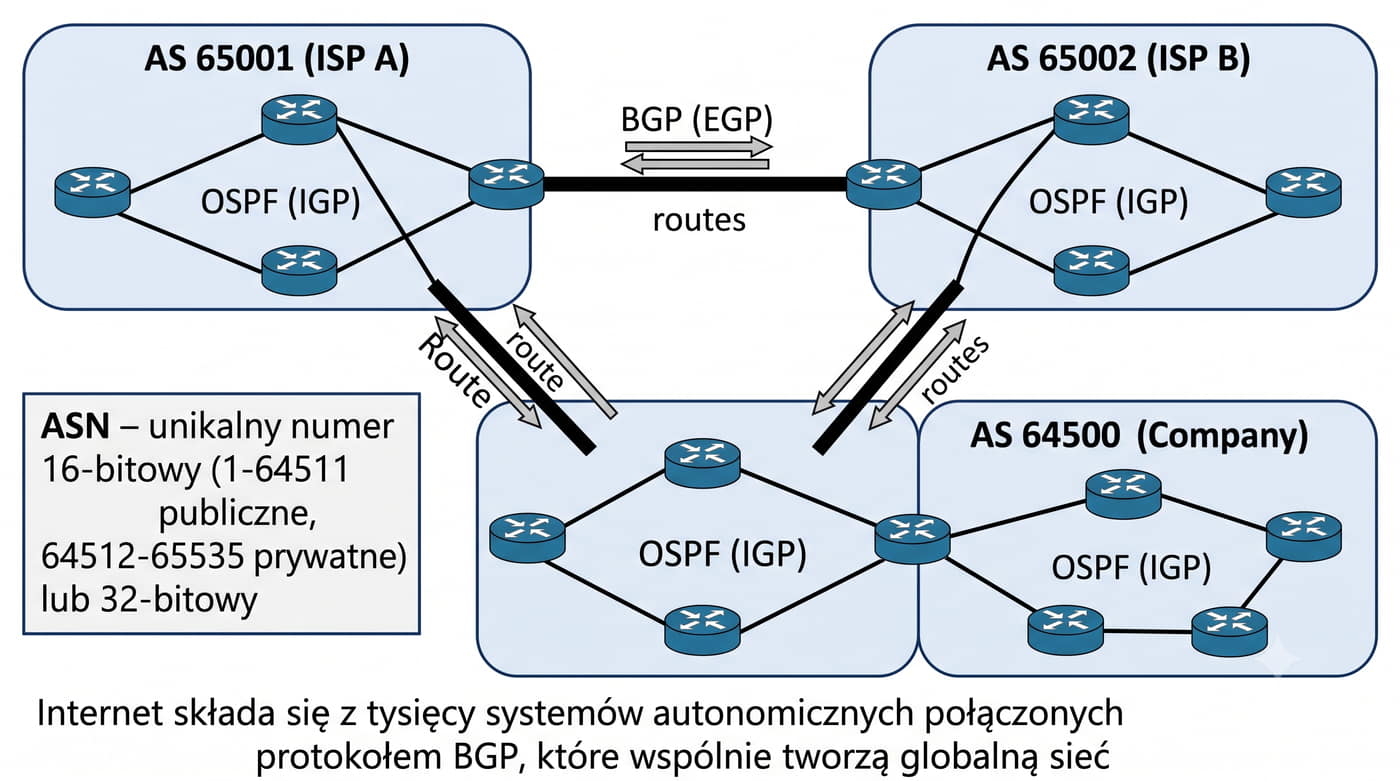
System autonomiczny (AS) to zbiór sieci IP zarządzanych przez jedną organizację, które realizują wspólną politykę routingu.

Każdy AS otrzymuje unikalny numer ASN (Autonomous System Number), który może być 16-bitowy (1-64511 publiczne, 64512-65535 prywatne) lub 32-bitowy w nowszym standardzie.

Wewnątrz AS działają protokoły IGP (RIP, OSPF, IS-IS), które dbają o spójność tras wewnętrznych.

Między AS działa protokół EGP (BGP), który wymienia informacje o trasach między różnymi organizacjami.

Koncepcja AS jest kluczowa dla zrozumienia architektury Internetu.
Internet składa się z tysięcy systemów autonomicznych połączonych protokołem BGP, które wspólnie tworzą globalną sieć.

System autonomiczny to podstawowa jednostka organizacyjna w architekturze routingu globalnego Internetu. Każdy AS posiada unikalny numer ASN nadawany przez regionalne rejestry internetowe, takie jak RIPE NCC dla Europy. Numeracja ASN została rozszerzona z 16 bitów do 32 bitów w 2007 roku ze względu na wyczerpanie puli dostępnych numerów.
Wewnątrz systemu autonomicznego routery mogą korzystać z różnych protokołów IGP, takich jak OSPF, IS-IS czy EIGRP, które zapewniają spójność routingu wewnętrznego. Na granicy AS routery BGP wymieniają informacje o trasach z sąsiednimi systemami autonomicznymi, co umożliwia komunikację między różnymi organizacjami w skali globalnej.

Koncepcja AS jest kluczowa dla zrozumienia, jak działa Internet na poziomie globalnym. Bez podziału na systemy autonomiczne zarządzanie routingiem między tysiącami różnych organizacji byłoby niemożliwe z powodu ogromnej liczby tras i konieczności uwzględniania polityk biznesowych.

8/55 Metryki w protokołach routingu

Hop count, cost, atrybuty BGP

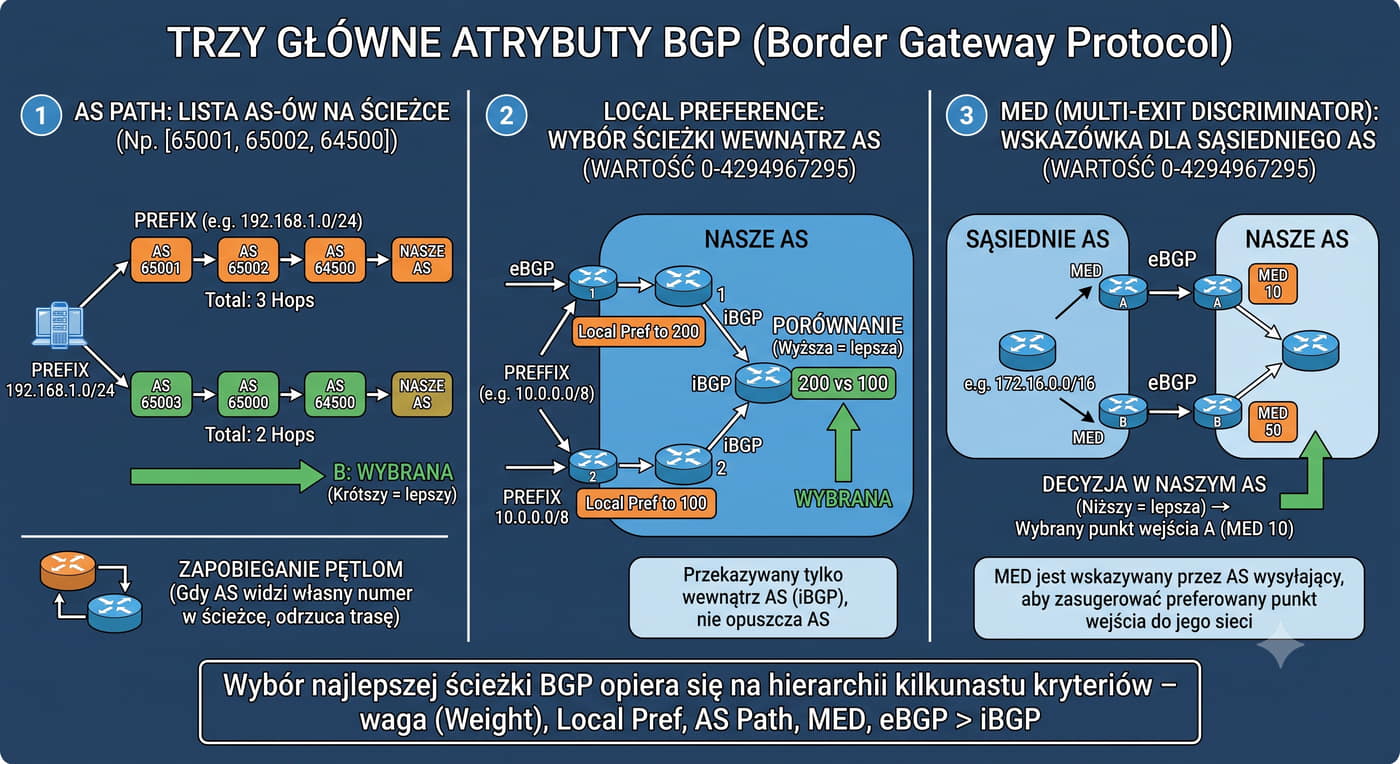
Atrybut AS Path to lista AS-ów na ścieżce, Local Preference to preferencja wewnątrz AS, a MED to wskazówka dla sąsiedniego AS.

Metryka w protokołach routingu to wartość liczbowa przypisana do każdej trasy, która określa koszt lub odległość do sieci docelowej.

Router wybiera trasę z najniższą metryką (najlepszą), a w przypadku równych metryk może dokonać równoważenia obciążenia.

RIP używa liczby skoków (hop count) jako metryki – każdy router na ścieżce zwiększa metrykę o 1.

Maksymalna dopuszczalna wartość to 15 hopów, a 16 oznacza trasę nieosiągalną.

OSPF używa kosztu (cost) obliczanego jako 10^8 / przepustowość łącza w bps.

BGP używa złożonego systemu atrybutów ścieżki zamiast pojedynczej metryki.

Metryka w protokołach routingu stanowi kryterium wyboru najlepszej ścieżki spośród wielu dostępnych tras do tej samej sieci docelowej. Każdy protokół routingu definiuje własną metrykę, która odzwierciedla specyficzne cechy sieci, takie jak odległość, przepustowość, opóźnienie czy niezawodność łącza. W protokole RIP metryka hop count jest najprostsza możliwa, ale nie uwzględnia rzeczywistej jakości łączy.

OSPF używa kosztu opartego na przepustowości, co pozwala na bardziej precyzyjne kierowanie ruchem w sieciach o zróżnicowanych parametrach łączy. Dla łącza Fast Ethernet o przepustowości 100 Mb/s koszt wynosi 1, podczas gdy dla łącza T1 o przepustowości 1,544 Mb/s koszt wynosi około 64, co oznacza, że OSPF preferuje szybsze łącza.

BGP całkowicie odchodzi od koncepcji pojedynczej metryki na rzecz systemu atrybutów ścieżki, które uwzględniają aspekty polityczne i biznesowe. W praktyce administrator BGP może wpływać na wybór ścieżek przez modyfikację takich atrybutów jak Local Preference, AS Path i MED.

9/55 Odległość administracyjna (AD)

Wiarygodność źródła trasy

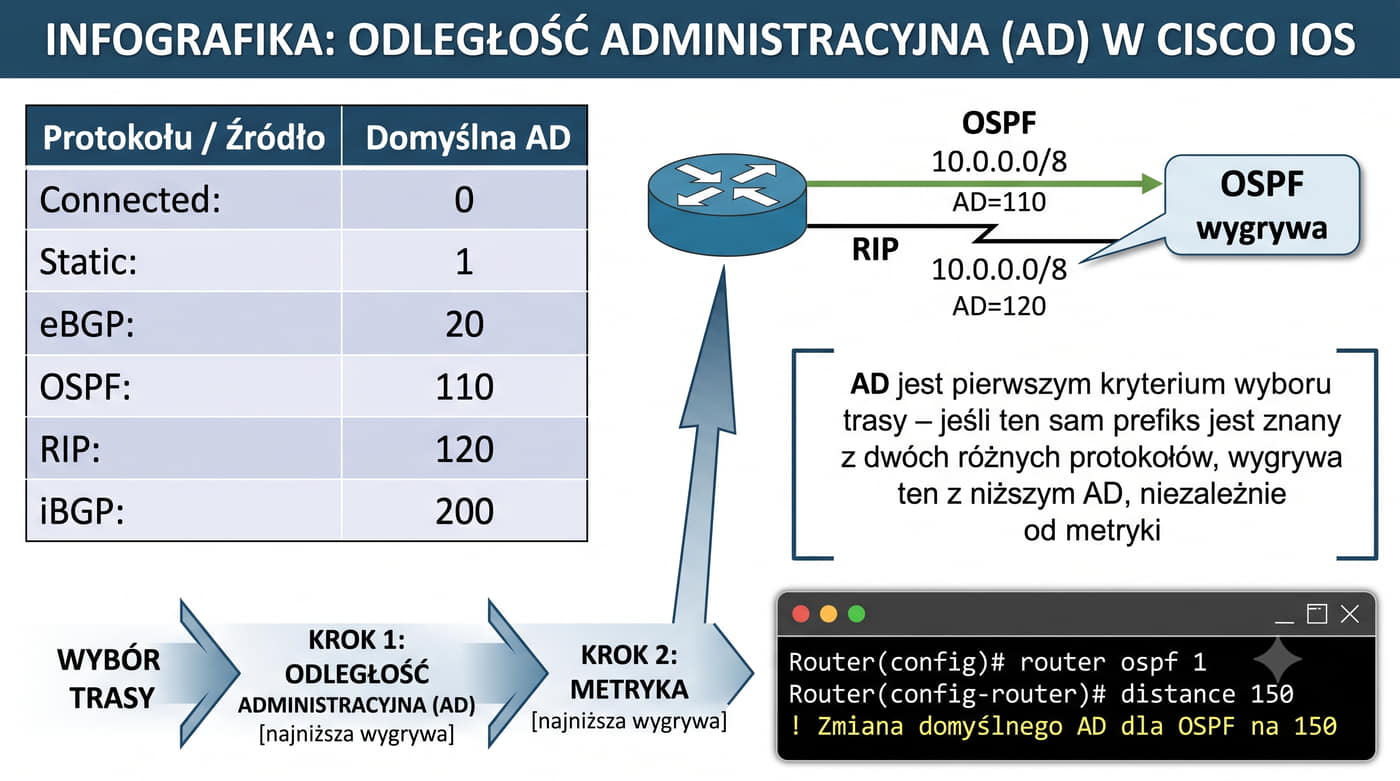
Odległość administracyjna (AD) to liczbowa miara wiarygodności źródła trasy w systemie Cisco IOS.

Im niższą wartość AD, tym bardziej wiarygodne jest źródło trasy.

AD jest pierwszym kryterium wyboru trasy – jeśli ten sam prefiks jest znany z dwóch różnych protokołów, wygrywa ten z niższym AD.

Domyślne wartości AD w Cisco IOS: connected – 0, trasa statyczna – 1, eBGP – 20, OSPF – 110, RIP – 120, iBGP – 200.

Na przykład jeśli router zna trasę do 10.0.0.0/8 zarówno z OSPF (AD=110) jak i z RIP (AD=120), wybiera trasę OSPF.

AD może być modyfikowana ręcznie przez administratora, co pozwala na sterowanie wyborem źródeł tras.

Polecenie distance 150 w trybie konfiguracji protokołu routingu zmienia AD dla danego protokołu.

Odległość administracyjna stanowi pierwszy etap selekcji tras w routerach Cisco IOS i jest używana do rozstrzygania konfliktów między różnymi źródłami tras. Jeśli router zna tę samą sieć docelową z dwóch różnych protokołów routingu, wybiera tę z niższą wartością AD, niezależnie od metryki. Mechanizm ten pozwala na hierarchiczne traktowanie źródeł tras według ich domniemanej wiarygodności.

Domyślne wartości AD w Cisco IOS odzwierciedlają typowe założenia projektowe: trasy bezpośrednio podłączone mają AD 0 jako najbardziej wiarygodne, trasy statyczne mają AD 1, a protokoły dynamiczne mają wartości pośrednie. Wartość AD dla eBGP wynosi 20, ponieważ trasy zewnętrzne są uznawane za bardziej wiarygodne niż trasy wewnętrznych protokołów IGP.

Administrator może modyfikować domyślne wartości AD dla poszczególnych protokołów routingu, co pozwala na precyzyjne sterowanie wyborem tras w złożonych środowiskach sieciowych. Należy jednak zachować ostrożność przy zmianie AD, ponieważ nieprzemyślana modyfikacja może prowadzić do nieoczekiwanych zmian w tablicy routingu.

10/55 Najdłuższy prefiks

Longest Prefix Match

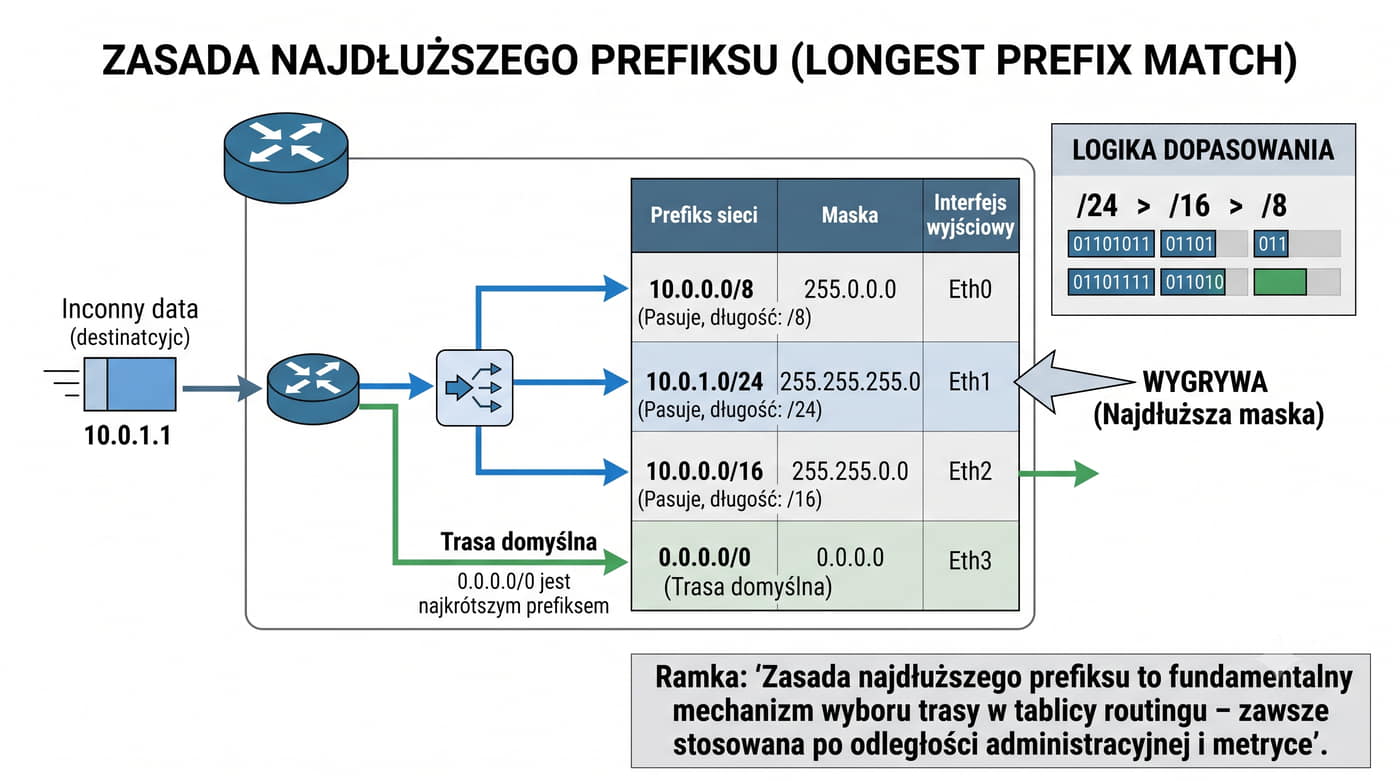
Zasada najdłuższego prefiksu (Longest Prefix Match) to fundamentalny mechanizm wyboru trasy w tablicy routingu.
Zasada najdłuższego prefiksu umożliwia stosowanie tras sumarycznych obok bardziej szczegółowych tras.

Gdy pakiet ma być przekazany do sieci docelowej, router przeszukuje tablicę routingu w poszukiwaniu wpisu, który najbardziej precyzyjnie pasuje do adresu docelowego.

Na przykład jeśli tablica routingu zawiera trzy wpisy: 10.0.0.0/8, 10.0.1.0/24 i 10.0.0.0/16, a pakiet jest adresowany do 10.0.1.1, router wybierze wpis 10.0.1.0/24, ponieważ ma najdłuższą maskę.

Trasa domyślna 0.0.0.0/0 jest najkrótszym prefiksem i jest wybierana tylko wtedy, gdy żadna bardziej szczegółowa trasa nie pasuje.

Zasada najdłuższego prefiksu jest fundamentalnym mechanizmem działania tablicy routingu IP. Gdy router otrzymuje pakiet, porównuje adres docelowy ze wszystkimi wpisami w tablicy i wybiera ten z najdłuższą maską. Mechanizm działa niezależnie od metryki i AD.

Dzięki tej zasadzie możliwe jest stosowanie tras sumarycznych obok szczegółowych. Administrator może mieć trasę domyślną 0.0.0.0/0 i szczegółowe trasy dla sieci wewnętrznych bez konfliktu.

Im bardziej precyzyjna trasa, tym wyższy priorytet przy przekazywaniu pakietów. Mechanizm umożliwia elastyczne projektowanie adresacji i routingu w sieciach IP.

11/55 Czas zbieżności

Convergence time w RIP, OSPF i BGP

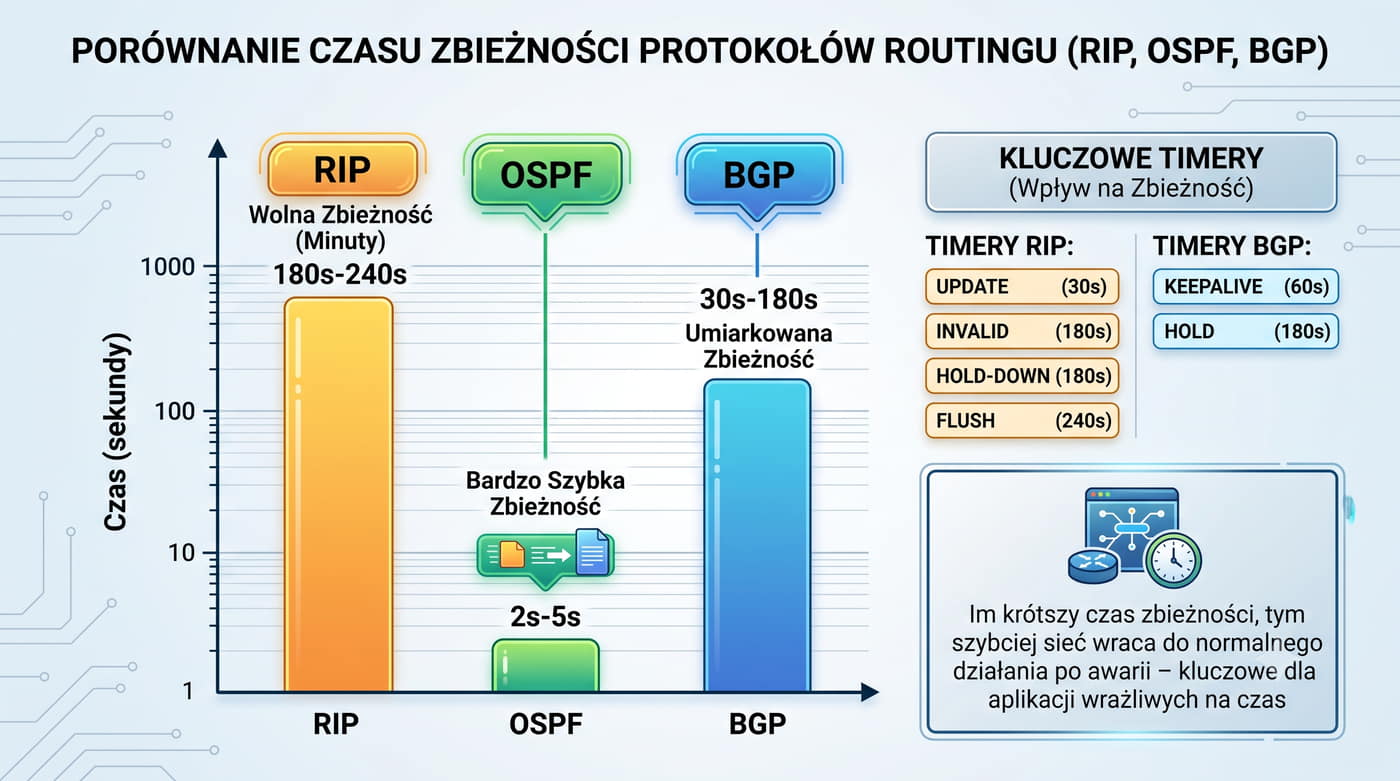
Czas zbieżności (convergence time) to okres od momentu zmiany topologii sieci do chwili, gdy wszystkie routery w sieci mają spójne i stabilne tablice routingu.

Im krótszy czas zbieżności, tym szybciej sieć wraca do normalnego działania po awarii.

RIP charakteryzuje się najwolniejszym czasem zbieżności, wynoszącym od kilkudziesięciu sekund do kilku minut.

Wynika to z długich timerów: Invalid Timer (180s) i Flush Timer (240s) oraz mechanizmu Hold-Down.

OSPF osiąga szybką zbieżność w ciągu kilku sekund dzięki natychmiastowej propagacji LSA i algorytmowi SPF.

BGP ma umiarkowany czas zbieżności, od kilku sekund do minut, co wynika z timerów Keepalive (60s) i Hold (180s).

Czas zbieżności w protokołach routingu dynamicznego jest jednym z najważniejszych parametrów określających jakość działania sieci po awarii łącza. Protokół RIP charakteryzuje się najdłuższym czasem zbieżności spośród omawianych protokołów, co wynika z długich timerów Invalid i Hold-Down ustawionych na 180 sekund. W tym czasie pakiety mogą być kierowane nieprawidłowo lub tracone, co wpływa na dostępność usług sieciowych.

Protokół OSPF osiąga zbieżność w czasie rzędu sekund dzięki natychmiastowemu wykrywaniu zmian topologii przez protokół Hello i szybkiemu przeliczeniu ścieżek algorytmem Dijkstry. W nowoczesnych sieciach korporacyjnych jest to wartość krytyczna, ponieważ każda sekunda przestoju wiąże się ze stratami finansowymi.

BGP charakteryzuje się umiarkowanym czasem zbieżności, który w praktyce może wynosić od kilku sekund do kilku minut z powodu konieczności propagacji zmian przez wiele systemów autonomicznych oraz długich timerów Keepalive i Hold.

12/55 Podsumowanie bloku I

Wprowadzenie do routingu dynamicznego

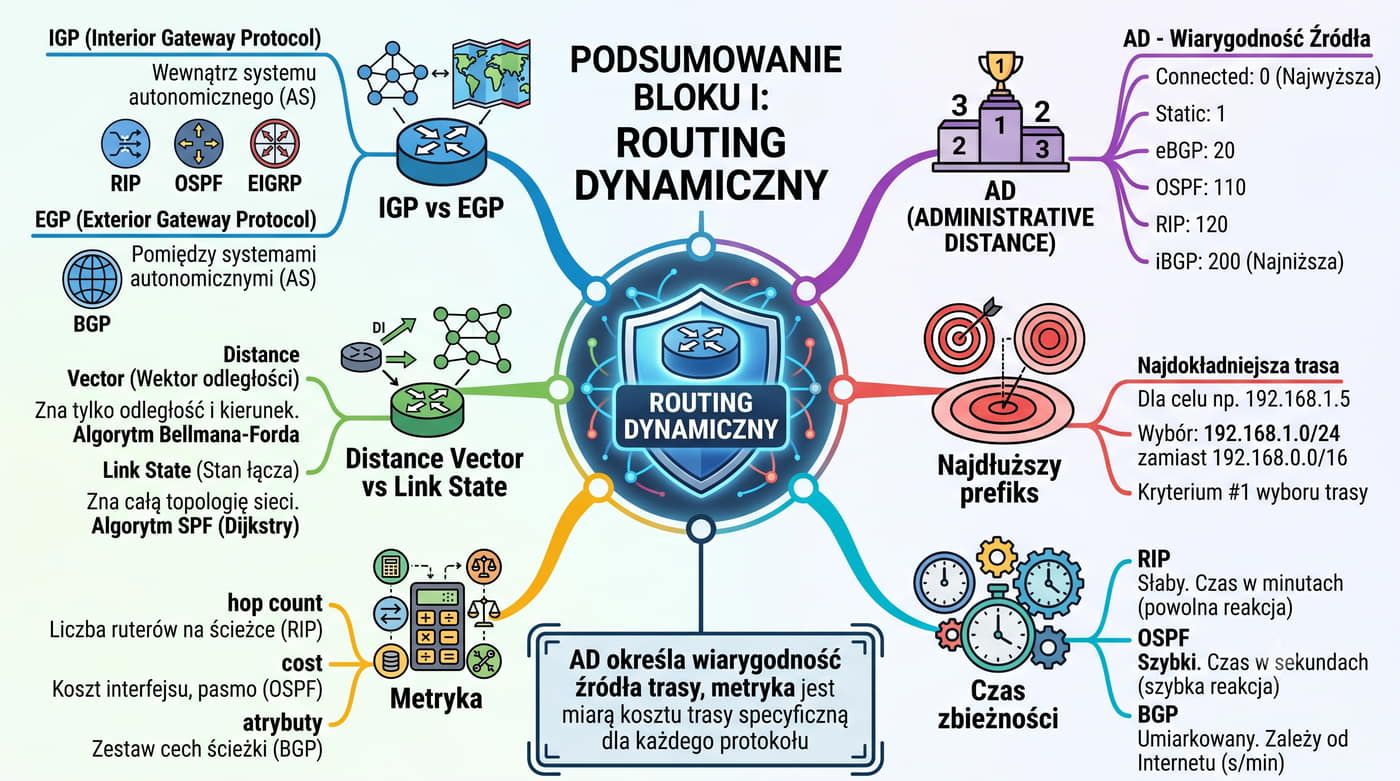
Podsumowanie bloku I utrwala najważniejsze koncepcje routingu dynamicznego.

AD określa wiarygodność źródła trasy.

IGP działa wewnątrz systemu autonomicznego, EGP między systemami autonomicznymi.

Distance Vector (RIP) wymienia całe tablice routingu z sąsiadami, Link State (OSPF) buduje mapę topologii.

Metryka jest miarą kosztu trasy specyficzną dla każdego protokołu (hop count, koszt, atrybuty).

Najdłuższy prefiks to pierwsze kryterium wyboru trasy w tablicy routingu.

Czas zbieżności to kluczowy parametr określający szybkość adaptacji sieci do zmian topologii.

RIP jest najwolniejszy, OSPF najszybszy, BGP umiarkowany.

Blok I prezentacji wprowadził podstawowe koncepcje routingu dynamicznego, które stanowią fundament dla zrozumienia bardziej zaawansowanych protokołów omawianych w dalszej części. Kluczowe pojęcia takie jak IGP i EGP, metryka, odległość administracyjna oraz najdłuższy prefiks są niezbędne do świadomego projektowania i administrowania sieciami IP.

Zrozumienie różnicy między protokołami wektora odległości a protokołami stanu łącza jest szczególnie istotne, ponieważ determinuje wybór odpowiedniego protokołu dla konkretnej sieci. Protokoły wektora odległości są prostsze w konfiguracji, ale oferują gorszą wydajność w porównaniu z protokołami stanu łącza, które zapewniają szybką zbieżność i skalowalność.

Czas zbieżności jako parametr jakościowy protokołu routingu ma bezpośredni wpływ na niezawodność sieci i powinien być starannie analizowany przy wyborze protokołu. Współczesne sieci korporacyjne wymagają czasów zbieżności rzędu sekund, co wyklucza stosowanie przestarzałych protokołów takich jak RIP.

13/55 RIP – Routing Information Protocol

Historia i podstawy

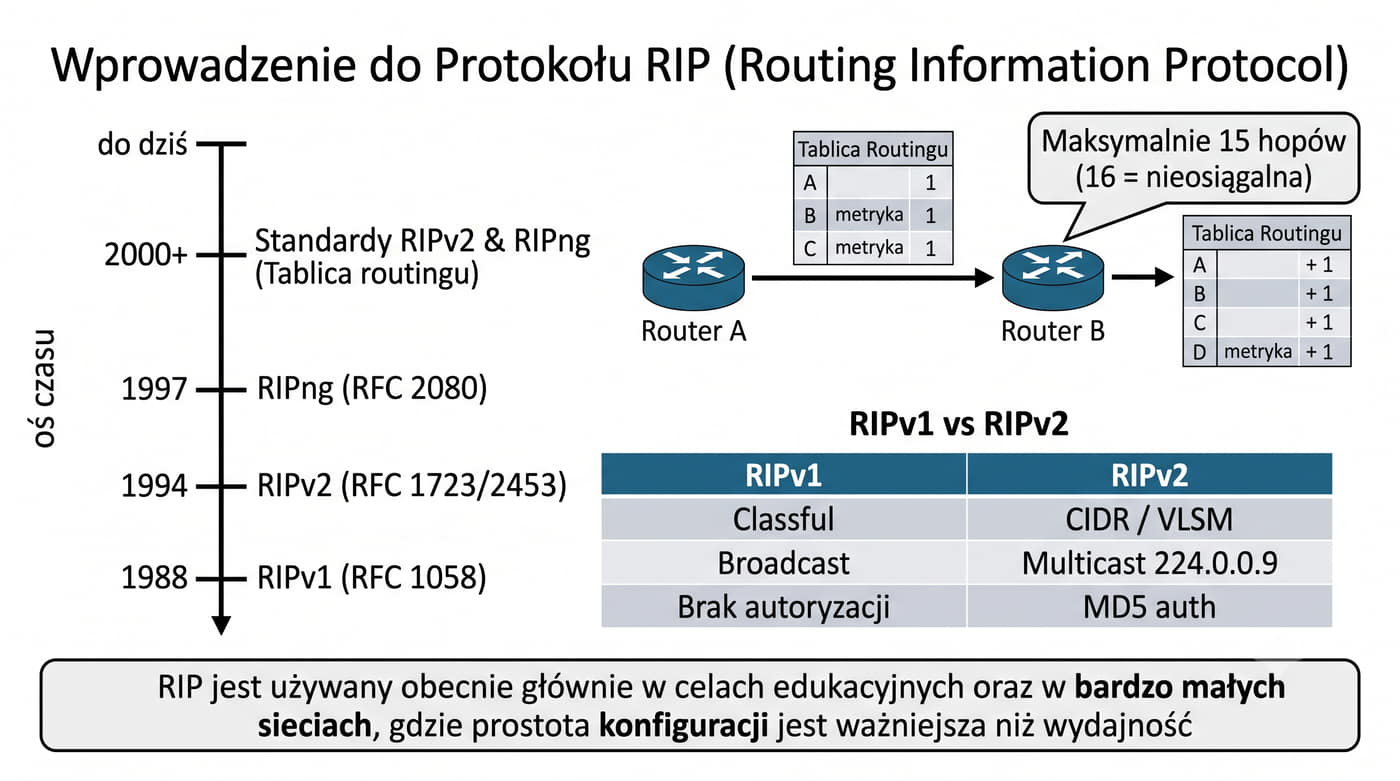
RIP (Routing Information Protocol) to najstarszy protokół routingu dynamicznego, zdefiniowany w RFC 1058 w 1988 roku.

Należy do kategorii protokołów wektora odległości (distance vector) – każdy router przekazuje sąsiadom swoją tablicę routingu, a sąsiad dodaje 1 do metryki i porównuje z własną tablicą.

Maksymalna liczba skoków w RIP wynosi 15 – trasa o metryce 16 jest uznawana za nieosiągalną.

To ograniczenie uniemożliwia stosowanie RIP w sieciach większych niż 15 hopów.

RIPv2 (RFC 2453) wprowadził obsługę CIDR i masek podsieci, uwierzytelnianie MD5 oraz multicast 224.0.0.9.

RIP jest używany obecnie głównie w celach edukacyjnych oraz w bardzo małych sieciach, gdzie prostota konfiguracji jest ważniejsza niż wydajność.

Protokół RIP jest najstarszym i najbardziej podstawowym protokołem routingu dynamicznego, który mimo swoich ograniczeń odegrał kluczową rolę w rozwoju sieci komputerowych. Został opracowany na podstawie wcześniejszego protokołu Gateway Information Protocol i przez wiele lat stanowił standardowy protokół routingu w sieciach opartych na systemie UNIX. Jego prostota sprawiła, że stał się pierwszym protokołem routingu, z którym zapoznają się studenci kierunków informatycznych.

RIPv1 działał w trybie classful, co oznaczało, że nie przesyłał informacji o masce podsieci i automatycznie sumaryzował trasy na granicach klas adresowych. Było to poważne ograniczenie, które uniemożliwiało stosowanie VLSM i CIDR. RIPv2 rozwiązał ten problem przez dodanie pola maski podsieci do komunikatów aktualizacji, co umożliwiło obsługę bezklasowego routingu.

Mimo swojej prostoty RIP jest rzadko stosowany w nowoczesnych sieciach produkcyjnych ze względu na ograniczenia skalowalności i wydajności. Znajomość RIP jest jednak istotna w kontekście edukacyjnym, ponieważ ilustruje podstawowe mechanizmy routingu dynamicznego.

14/55 Zasada działania distance vector

Wymiana tablic routingu w RIP

Zasada działania protokołu wektora odległości w RIP opiera się na wymianie całej tablicy routingu między sąsiadami co 30 sekund (Update Timer).

Każdy router okresowo wysyła swoją tablicę w postaci broadcastu (RIPv1) lub multicastu (RIPv2) na adres 224.0.0.9.

Jeśli nowa trasa ma niższą metrykę niż istniejąca, router aktualizuje wpis w tablicy routingu.

Jeśli metryka jest równa, router może dodać trasę jako drugą ścieżkę do równoważenia obciążenia (do 4 równych ścieżek w Cisco IOS).

Mechanizm ten określa się mianem "rumour routing" (plotkowy routing), ponieważ router wierzy informacji otrzymanej od sąsiada, nie sprawdzając jej poprawności.

Protokół wektora odległości działa na zasadzie okresowej wymiany całej tablicy routingu między sąsiednimi routerami. Każdy router przechowuje tablicę z metrykami i co 30 sekund wysyła ją do sąsiadów, którzy aktualizują własne tablice.

Mechanizm ten nazywa się plotkowym routingiem, ponieważ routery polegają na informacjach od sąsiadów bez weryfikacji. Błędna informacja może zostać rozpropagowana w sieci.

Algorytm wektora odległości jest podatny na pętle routingu i ma wolny czas zbieżności. Współczesne sieci korzystają głównie z protokołów stanu łącza.

15/55 Pętle routingu i mechanizmy zapobiegawcze

Split Horizon, Route Poisoning, Hold-Down

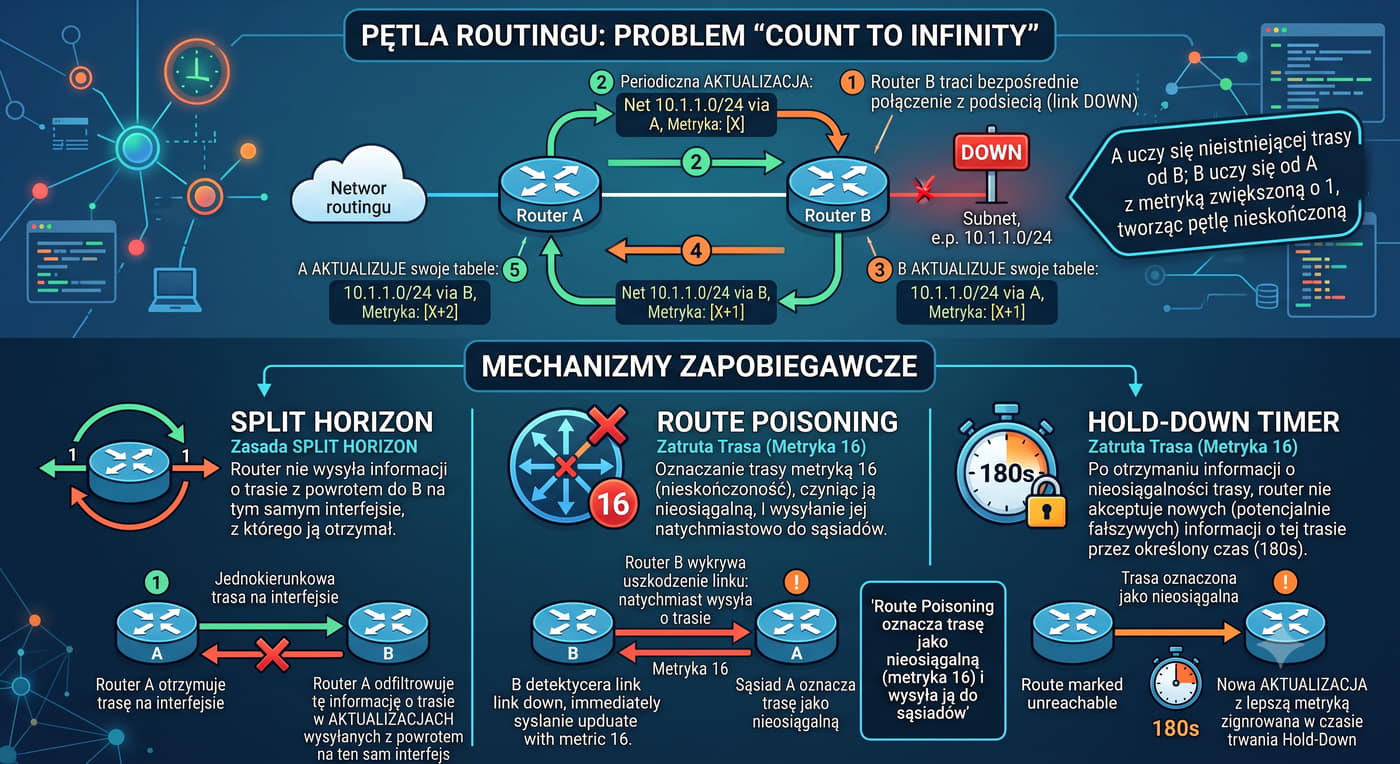
Route Poisoning oznacza trasę jako nieosiągalną (metryka 16) i wysyła ją do sąsiadów.

Pętla routingu (route loop) to sytuacja, w której dwa lub więcej routerów wzajemnie uczą się od siebie błędnych tras, powodując, że pakiety krążą w nieskończoność.

W RIP pętla może powstać, gdy router A uczy się trasy od routera B po tym, jak ta trasa przestała istnieć.

Split Horizon to podstawowy mechanizm zapobiegający pętlom – router nie wysyła informacji o trasie z powrotem przez ten sam interfejs, z którego ją otrzymał.

Hold-Down Timer to mechanizm zapobiegający przedwczesnemu zaakceptowaniu błędnej trasy.

Gdy router otrzymuje informację o nieosiągalności trasy, uruchamia timer Hold-Down (180s), podczas którego nie akceptuje nowych informacji o tej trasie.

Pętle routingu stanowią jedno z najpoważniejszych zagrożeń dla stabilności sieci IP wykorzystujących protokoły wektora odległości. W sytuacji pętli routingowej pakiety krążą między routerami w nieskończoność, aż do wyczerpania wartości TTL w nagłówku IP, co prowadzi do marnowania pasma i obciążenia procesorów routerów. Problem ten jest szczególnie widoczny w protokole RIP ze względu na jego mechanizm plotkowego routingu.

Aby zapobiegać pętlom, protokół RIP implementuje trzy mechanizmy zabezpieczające. Split Horizon zapobiega sytuacji, w której router odsyła informację o trasie z powrotem przez ten sam interfejs, z którego ją otrzymał, co eliminuje najprostsze pętle dwuwęzłowe. Route Poisoning oznacza trasę jako nieosiągalną z metryką 16, co informuje sąsiadów o jej niedostępności. Hold-Down Timer zapobiega przedwczesnemu zaakceptowaniu błędnej trasy przez odczekanie okresu stabilizacji.

Mimo tych mechanizmów RIP pozostaje protokołem podatnym na problemy związane z pętlami, szczególnie w złożonych topologiach sieciowych. Protokoły stanu łącza eliminują ten problem całkowicie dzięki algorytmowi najkrótszej ścieżki.

16/55 RIPv1 vs RIPv2 vs RIPng

Ewolucja protokołu RIP

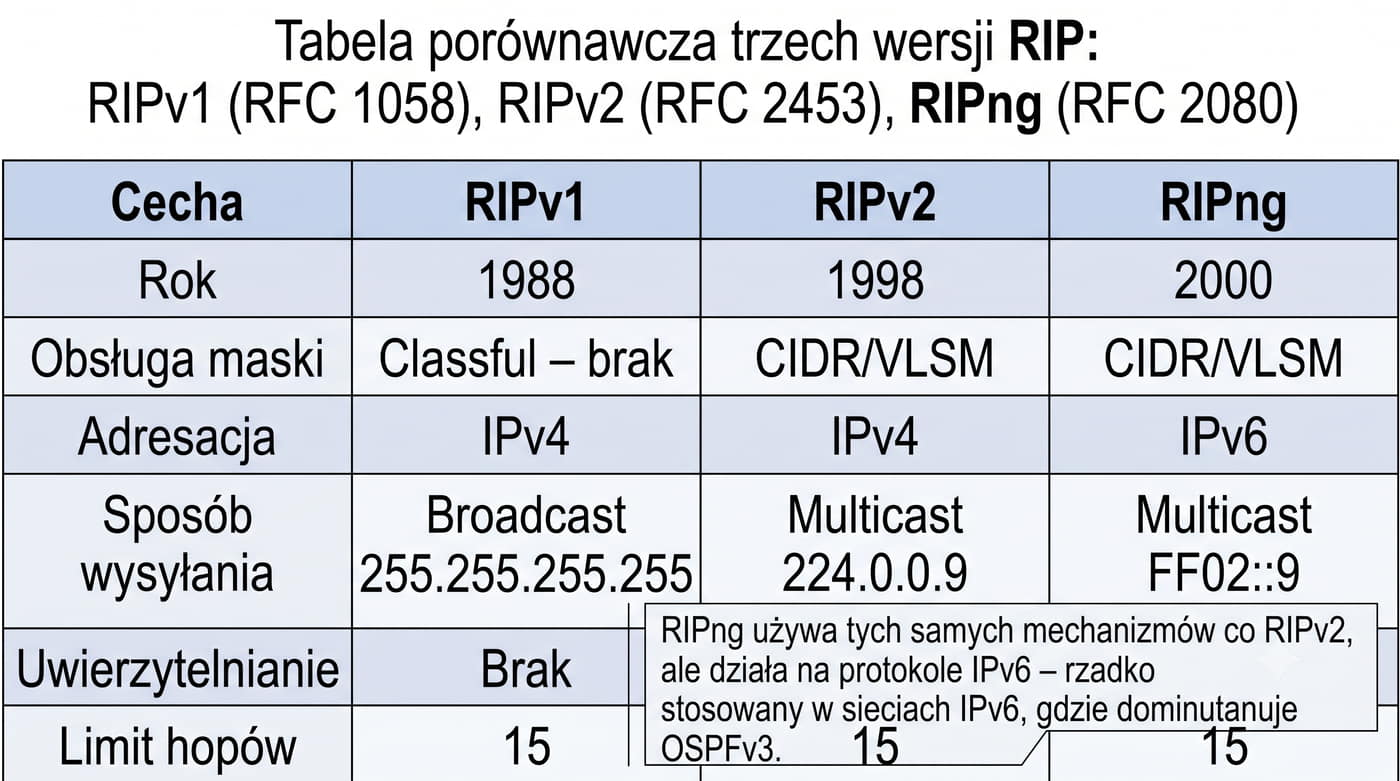
RIPv1 (RFC 1058) to oryginalna wersja protokołu RIP, która działa w trybie classful – nie przesyła informacji o masce podsieci.

W efekcie RIPv1 nie obsługuje CIDR (Classless Inter-Domain Routing) i VLSM (Variable Length Subnet Mask).

RIPv2 (RFC 2453) wprowadza pole maski podsieci w aktualizacjach routingu, co umożliwia obsługę CIDR i VLSM.

Zamiast broadcastu RIPv2 używa multicastu 224.0.0.9, co redukuje obciążenie hostów.

Uwierzytelnianie MD5 zapobiega przyjmowaniu fałszywych aktualizacji.

RIPng (RFC 2080) to wersja RIP dla IPv6, która używa tych samych mechanizmów co RIPv2, ale działa na protokole IPv6.

Ze względu na ograniczenia RIP jest rzadko stosowany w sieciach IPv6, gdzie dominuje OSPFv3.

Ewolucja protokołu RIP od wersji 1 do RIPng obrazuje rozwój technologii routingu w odpowiedzi na zmieniające się wymagania sieci IP. RIPv1 został opracowany w czasach, gdy adresacja IP opierała się wyłącznie na klasach A, B i C, a pojęcie VLSM jeszcze nie istniało. Wprowadzenie RIPv2 w 1994 roku było odpowiedzią na potrzebę obsługi bezklasowego routingu i CIDR, który umożliwił bardziej efektywne wykorzystanie przestrzeni adresowej IPv4.

RIPv2 wprowadził również istotne ulepszenia w zakresie bezpieczeństwa przez dodanie uwierzytelniania MD5, które zapobiega przyjmowaniu fałszywych aktualizacji routingu od nieuprawnionych źródeł. Zastąpienie broadcastu multicastem 224.0.0.9 zmniejszyło obciążenie sieci, ponieważ tylko routery RIP przetwarzają pakiety wysłane na ten adres grupowy, a nie wszystkie hosty w segmencie sieci.

RIPng został zaprojektowany jako proste rozszerzenie RIP dla IPv6, ale ze względu na ograniczenia protokołu nie zdobył większej popularności w sieciach IPv6. W środowiskach IPv6 dominuje OSPFv3, który oferuje znacznie lepszą wydajność i skalowalność.

17/55 Timery RIP

Update, Invalid, Hold-Down, Flush

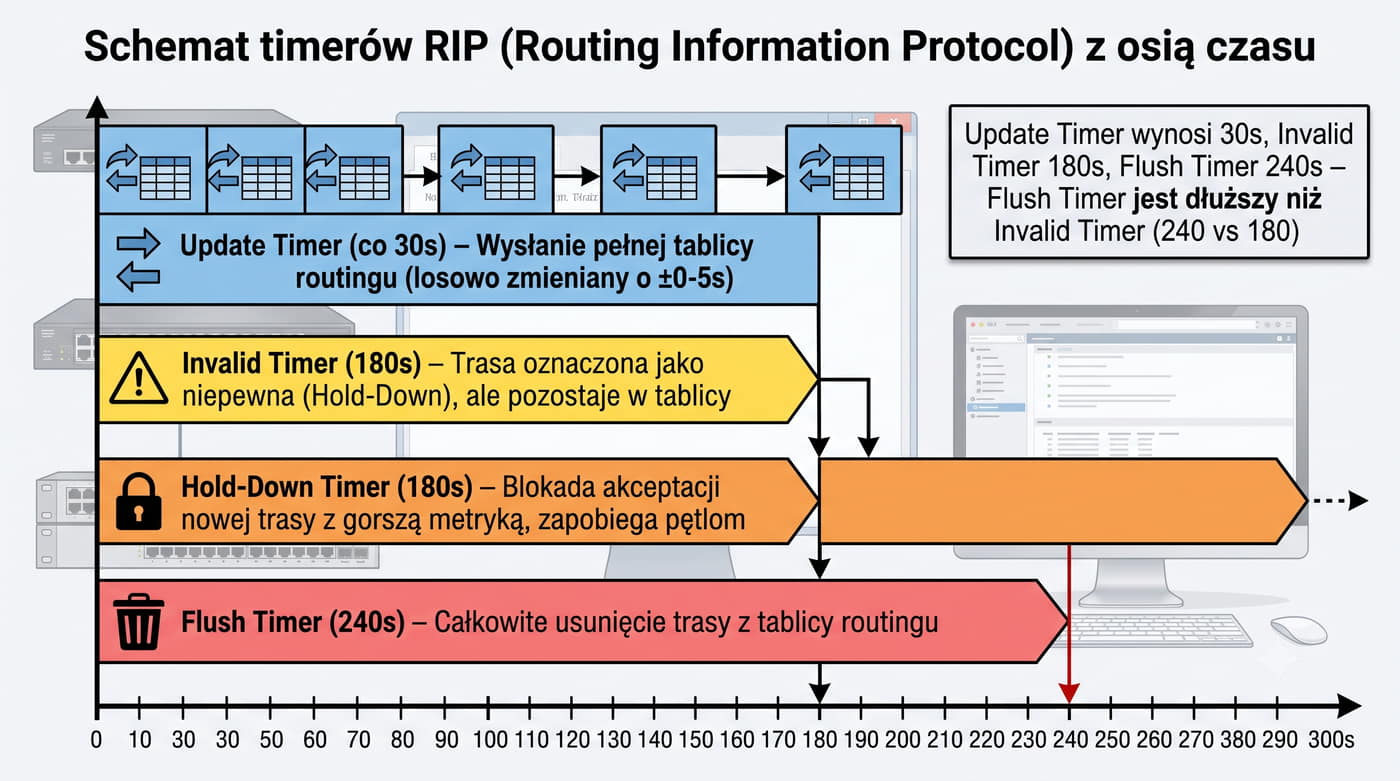
Timery RIP kontrolują częstotliwość wysyłania aktualizacji oraz czas życia tras w tablicy routingu.

Update Timer wynosi 30 sekund i określa odstęp między kolejnymi wysłaniami całej tablicy routingu.

Wartość timera jest losowo zmieniana o 0-5 sekund.

Invalid Timer (180 sekund) to czas, po którym trasa jest oznaczana jako niepewna (invalid), jeśli router nie otrzyma aktualizacji od sąsiada dla tej trasy.

Po upływie Invalid Timer trasa pozostaje w tablicy, ale nie jest używana do przekazywania pakietów.

Flush Timer (240 sekund) to czas, po którym trasa jest całkowicie usuwana z tablicy routingu.

Flush Timer jest dłuższy niż Invalid Timer (240 vs 180).

Po usunięciu trasy router może zaakceptować nową informację o tej samej sieci.

System timerów w protokole RIP został zaprojektowany tak, aby zapewnić stabilność działania sieci kosztem szybkości zbieżności. Cztery timery RIP współpracują ze sobą, tworząc mechanizm kontroli cyklu życia tras w tablicy routingu. Update Timer o wartości 30 sekund jest celowo losowo modyfikowany w zakresie od 25 do 30 sekund, aby zapobiec synchronizacji aktualizacji na wielu routerach jednocześnie, co mogłoby przeciążyć łącza sieciowe.

Invalid Timer o wartości 180 sekund stanowi bufor bezpieczeństwa, który pozwala na przejściowe opóźnienia w dostarczaniu aktualizacji bez utraty tras. Jeśli router nie otrzyma aktualizacji dla danej trasy przez 180 sekund, oznacza ją jako niepewną, ale nie usuwa od razu z tablicy routingu. Daje to szansę na odzyskanie trasy, jeśli opóźnienie było spowodowane chwilowym przeciążeniem sieci.

Flush Timer o wartości 240 sekund całkowicie usuwa trasę z tablicy routingu, co umożliwia zaakceptowanie nowej informacji o tej samej sieci od alternatywnego sąsiada. Ten zachowawczy mechanizm timerów jest głównym powodem wolnej zbieżności protokołu RIP.

18/55 Konfiguracja RIP w Cisco IOS

Polecenia i weryfikacja

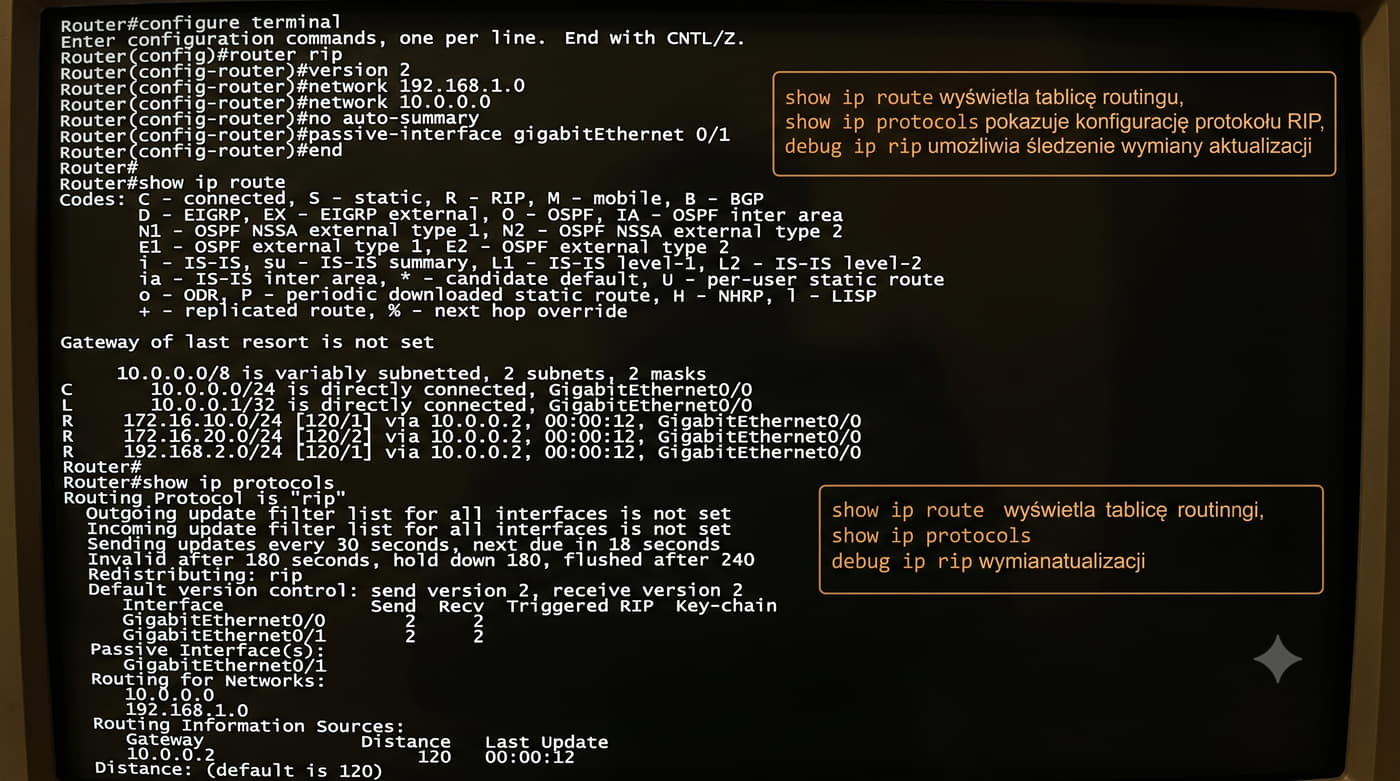
Konfiguracja RIP w Cisco IOS rozpoczyna się od polecenia router rip, które włącza protokół RIP i przechodzi w tryb konfiguracji protokołu.

Polecenie version 2 określa użycie RIPv2 z obsługą CIDR i uwierzytelnianiem.

Polecenie network adres_ip włącza RIP na wszystkich interfejsach należących do podanej sieci.

Polecenie no auto-summary wyłącza automatyczną sumaryzację tras na granicach klas, co jest niezbędne w sieciach z VLSM i CIDR.

Passive-interface służy do wyłączenia wysyłania aktualizacji RIP na interfejsie.

show ip route wyświetla tablicę routingu, w której trasy RIP są oznaczone literą R. show ip protocols pokazuje konfigurację protokołu RIP. debug ip rip umożliwia śledzenie wymiany aktualizacji RIP w czasie rzeczywistym.

Konfiguracja protokołu RIP w systemie Cisco IOS jest procesem stosunkowo prostym, co wynika z natury samego protokołu. Proces rozpoczyna się od polecenia router rip, które przenosi administratora w tryb konfiguracji protokołu routingu. W tym trybie definiuje się wersję protokołu, sieci, które mają być ogłaszane, oraz parametry dodatkowe, takie jak wyłączenie automatycznej sumaryzacji.

Szczególnie ważne jest polecenie no auto-summary, które wyłącza automatyczną sumaryzację tras na granicach klas adresowych. W sieciach z VLSM i CIDR sumaryzacja domyślna prowadziłaby do błędów routingu, ponieważ trasy do podsieci o różnych maskach byłyby łączone w jeden wpis klasowy. Polecenie passive-interface pozwala na wyłączenie wysyłania aktualizacji RIP na wybranych interfejsach, co jest przydatne w sieciach, gdzie nie ma innych routerów RIP.

Diagnostyka protokołu RIP w Cisco IOS opiera się na kilku kluczowych poleceniach show i debug. Polecenie show ip route pozwala na przegląd tablicy routingu, gdzie trasy RIP są oznaczone literą R. Polecenie debug ip rip umożliwia śledzenie aktualizacji RIP w czasie rzeczywistym, co jest nieocenione przy rozwiązywaniu problemów z propagacją tras.

19/55 Konfiguracja RIP w RouterOS

MikroTik RouterOS

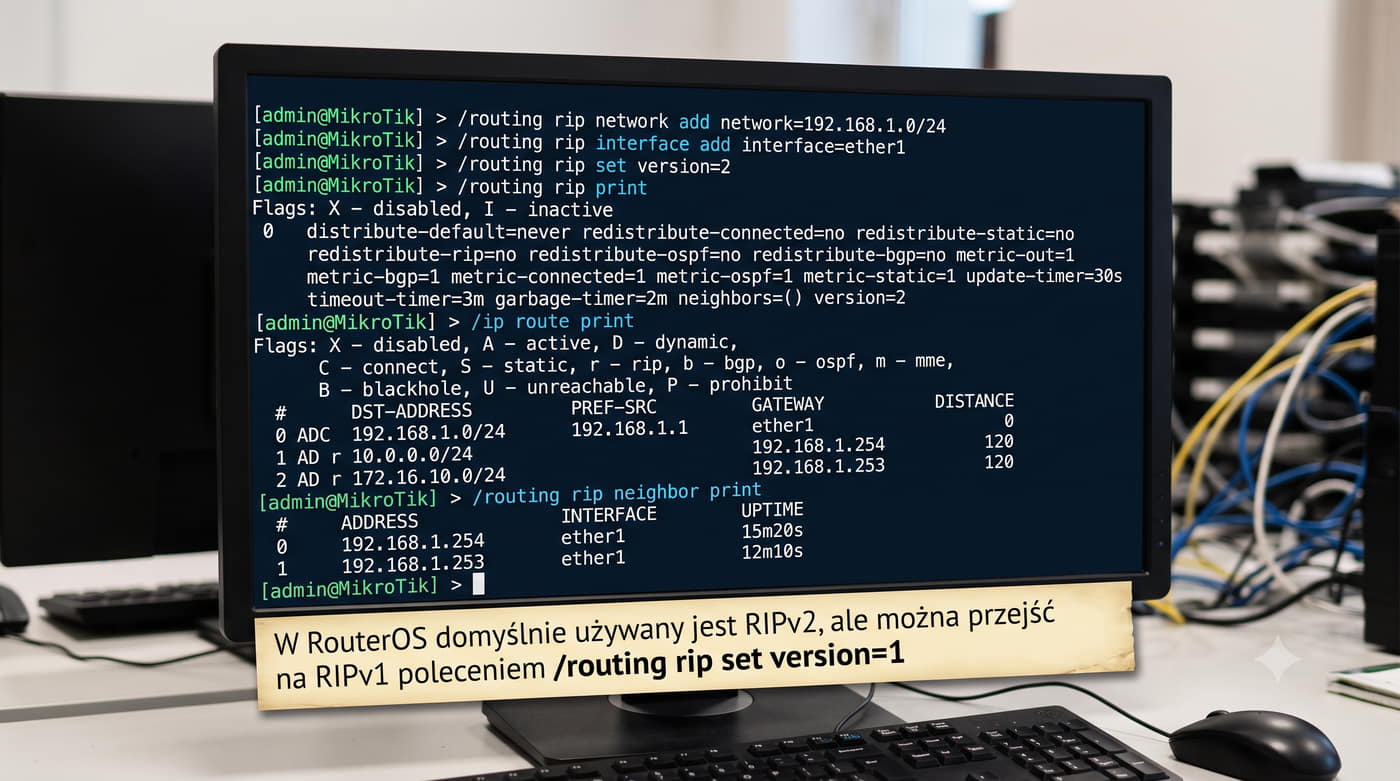
Konfiguracja RIP w RouterOS (MikroTik) jest prosta i opiera się na kilku poleceniach.

Polecenie /routing rip network add address=192.168.1.0/24 dodaje sieć do protokołu RIP.

Polecenie /routing rip interface add interface=ether1 dodaje interfejs do procesu RIP.

RouterOS domyślnie używa RIPv2, ale można przejść na RIPv1 poleceniem /routing rip set version=1.

Polecenie /routing rip print wyświetla konfigurację protokołu RIP.

Weryfikacja tras RIP odbywa się przez polecenie /ip route print, w którym trasy pochodzące z RIP mają flagę "rip".

Polecenie /routing rip route print pokazuje tablicę tras RIP z informacjami o metrykach.

Konfiguracja protokołu RIP w systemie MikroTik RouterOS jest prostsza niż w Cisco IOS, ponieważ RouterOS automatycznie włącza RIPv2 i wymaga minimalnej liczby poleceń. Polecenie /routing rip network add służy do dodawania sieci, która ma być ogłaszana przez protokół RIP, a /routing rip interface add przypisuje interfejs do procesu routingu.

Warto pamiętać, że RouterOS domyślnie używa wersji RIPv2, co oznacza, że obsługuje CIDR i VLSM bez dodatkowej konfiguracji. Jeśli wymagana jest kompatybilność ze starszymi urządzeniami obsługującymi wyłącznie RIPv1, należy przełączyć wersję poleceniem /routing rip set version=1.

Weryfikacja konfiguracji opiera się na poleceniach /routing rip print do przeglądu ustawień protokołu oraz /ip route print do sprawdzenia tras pochodzących z RIP. Polecenie /routing rip route print wyświetla tablicę tras RIP z informacjami o metrykach i timerach.

20/55 Zalety i wady RIP

Kiedy stosować RIP?

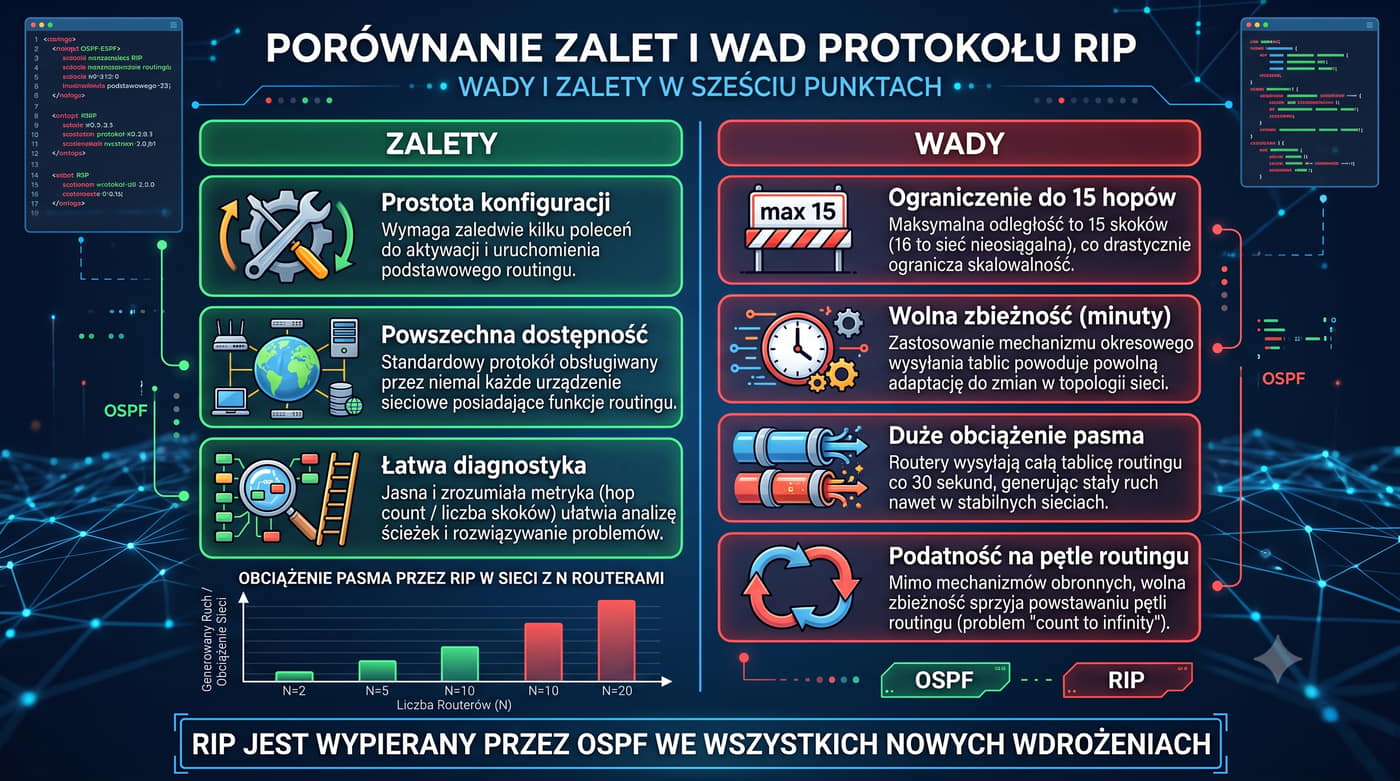
Zalety RIP wynikają głównie z jego prostoty i łatwości konfiguracji.

RIP jest zaimplementowany w każdym urządzeniu sieciowym obsługującym routing.

Konfiguracja RIP ogranicza się do kilku poleceń, a diagnostyka jest prosta dzięki jasnej metryce hop count.

Wady RIP są jednak na tyle istotne, że uniemożliwiają jego stosowanie w średnich i dużych sieciach.

Ograniczenie do 15 hopów sprawia, że RIP nie może być używany w sieciach większych niż 15 routerów.

Wolna zbieżność (minuty) powoduje długie przerwy w łączności po awarii.

Obciążenie pasma generowane przez RIP jest znaczne – co 30 sekund każdy router wysyła całą tablicę routingu, która w większej sieci może mieć setki wpisów.

Z tych powodów RIP jest wypierany przez OSPF.

Zalety protokołu RIP wynikają głównie z jego prostoty. Jest to protokół, który można skonfigurować w ciągu kilku minut, nie wymaga skomplikowanych obliczeń metryk ani planowania obszarów, a jego diagnostyka opiera się wyłącznie na liczbie skoków. Dzięki temu RIP sprawdza się w bardzo małych sieciach, gdzie prostota jest ważniejsza niż wydajność. Główną wadą RIP jest ograniczenie do 15 przeskoków, które wyklucza stosowanie protokołu w większych sieciach. Ponadto okresowa wymiana całych tablic routingu co 30 sekund generuje znaczne obciążenie pasma, a długie timery powodują powolną zbieżność, liczoną w minutach, co w praktyce oznacza długie przerwy w łączności po awarii łącza. Ze względu na te ograniczenia RIP jest wypierany przez protokół OSPF, który oferuje szybką zbieżność, skalowalność i efektywne wykorzystanie pasma. Współcześnie RIP stosuje się przede wszystkim w celach edukacyjnych oraz w bardzo małych, prostych sieciach.

21/55 Przykład sieci z RIP

Propagacja tras w topologii

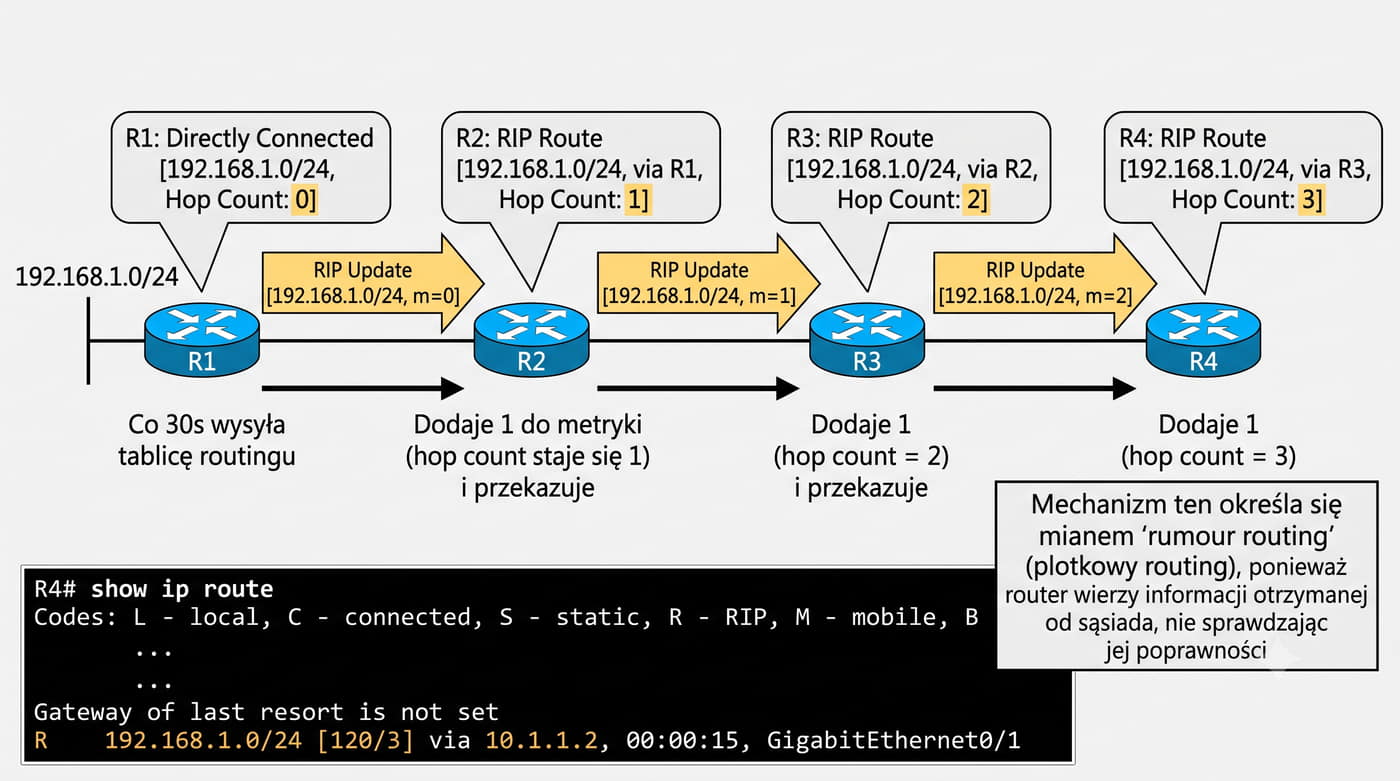
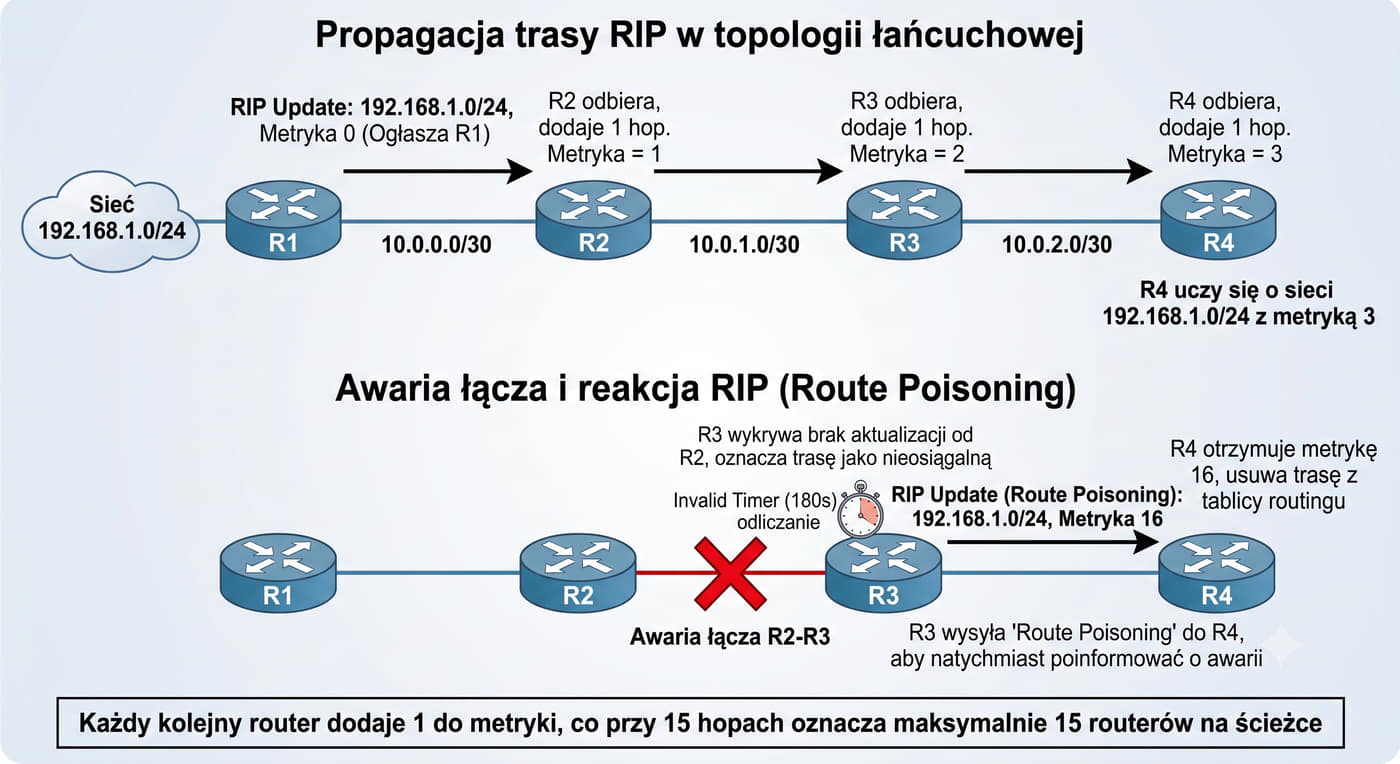
Przykład sieci z RIP pokazuje propagację tras w topologii łańcuchowej z czterema routerami.

Router R1 ma bezpośrednio podłączoną sieć 192.168.1.0/24 i ogłasza ją przez RIP.

Router R2 otrzymuje informację z metryką 1.

Router R3 otrzymuje od R2 trasę z metryką 2.

Router R4 otrzymuje tę trasę z metryką 3.

Każdy kolejny router dodaje 1 do metryki, co przy 15 hopach oznacza maksymalnie 15 routerów na ścieżce.

Po awarii łącza między R2 a R3, router R3 po upływie Invalid Timer (180s) oznacza trasę jako nieosiągalną i wysyła Route Poisoning do R4.

W przykładzie propagacji tras w protokole RIP topologia liniowa ułatwia zrozumienie, w jaki sposób metryka hop count rośnie z każdym następnym routerem. Router R1, mający bezpośrednio podłączoną sieć 192.168.1.0/24, ogłasza ją sąsiadom z metryką 1. Router R2 przyjmuje tę trasę z metryką 1, a następnie, przekazując ją dalej do R3, zwiększa metrykę do 2.W ten sposób metryka rośnie o 1 na każdym kolejnym routerze, co odzwierciedla odległość w liczbie skoków. Przy piętnastu przeskokach metryka osiąga maksymalną dozwoloną wartość, a trasa o metryce 16 jest uznawana za nieosiągalną. To ograniczenie oznacza, że w sieci RIP najdłuższa aktywna ścieżka może obejmować co najwyżej 15 routerów pośrednich. W przypadku awarii łącza między R2 i R3 router R3 przestaje otrzymywać aktualizacje od R2. Po upływie timera Invalid, wynoszącego 180 sekund, trasa zostaje oznaczona jako nieosiągalna, a router informuje o tym sąsiadów, wysyłając komunikat Route Poisoning z metryką 16. Dopiero po tym etapie sąsiednie routery mogą rozpocząć poszukiwanie trasy alternatywnej.

22/55 Podsumowanie bloku II

Protokół RIP

RIPng to wersja dla IPv6.

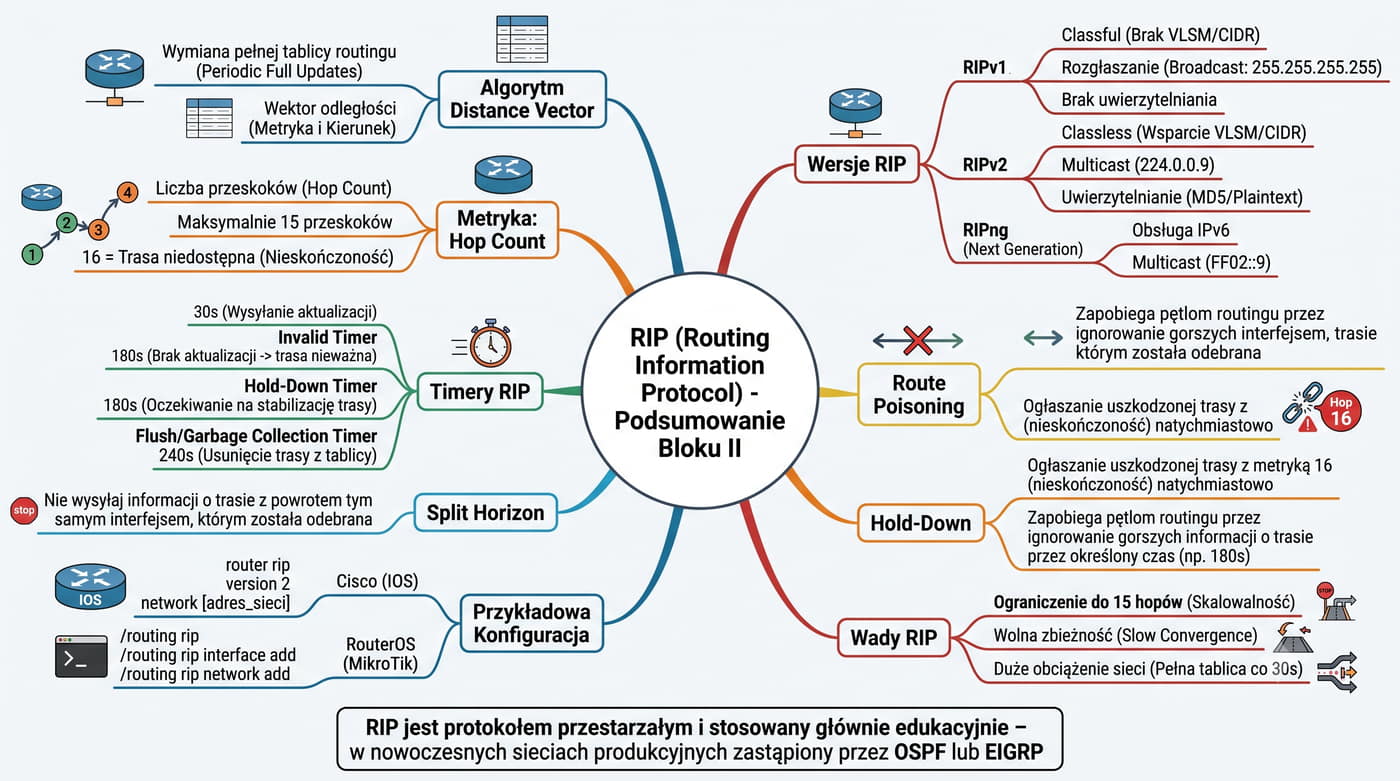
RIP to protokół wektora odległości używający hop count jako metryki z maksymalną wartością 15.

RIPv1 działa w trybie classful, RIPv2 obsługuje CIDR i VLSM oraz używa multicastu 224.0.0.9.

Mechanizmy zapobiegające pętlom to Split Horizon, Route Poisoning i Hold-Down Timer.

Timery RIP: Update (30s), Invalid (180s), Hold-Down (180s) i Flush (240s).

Zalety RIP to prostota i powszechna dostępność.

Wady to ograniczenie do 15 hopów, wolna zbieżność i duże obciążenie pasma.

RIP jest przestarzały i stosowany głównie edukacyjnie.

Drugi blok prezentacji podsumowuje wiedzę o protokole RIP, który jest najprostszym protokołem wektora odległości. Jego metryka, liczba skoków (hop count), ma maksymalną wartość 15, a trasa o metryce 16 jest interpretowana jako nieosiągalna. Protokół wymienia całe tablice routingu z sąsiednimi routerami co 30 sekund, co upraszcza implementację, ale generuje znaczny ruch sieciowy. RIPv1 działał w trybie classful i nie przesyłał informacji o masce podsieci, co uniemożliwiało obsługę VLSM i CIDR. RIPv2 dodał pole maski podsieci, obsługę CIDR oraz uwierzytelnianie MD5, a także zastąpił broadcast multicastem na adres 224.0.0.9. RIPng jest wersją protokołu przeznaczoną dla IPv6.Mechanizmy zabezpieczające przed pętlami routingu to Split Horizon, Route Poisoning oraz Hold-Down Timer. Cztery timery RIP określają cykl życia trasy: Update (30 s), Invalid (180 s), Hold-Down oraz Flush (240 s). RIP jest obecnie stosowany głównie w celach edukacyjnych.

23/55 OSPF – Open Shortest Path First

Wprowadzenie do protokołu stanu łącza

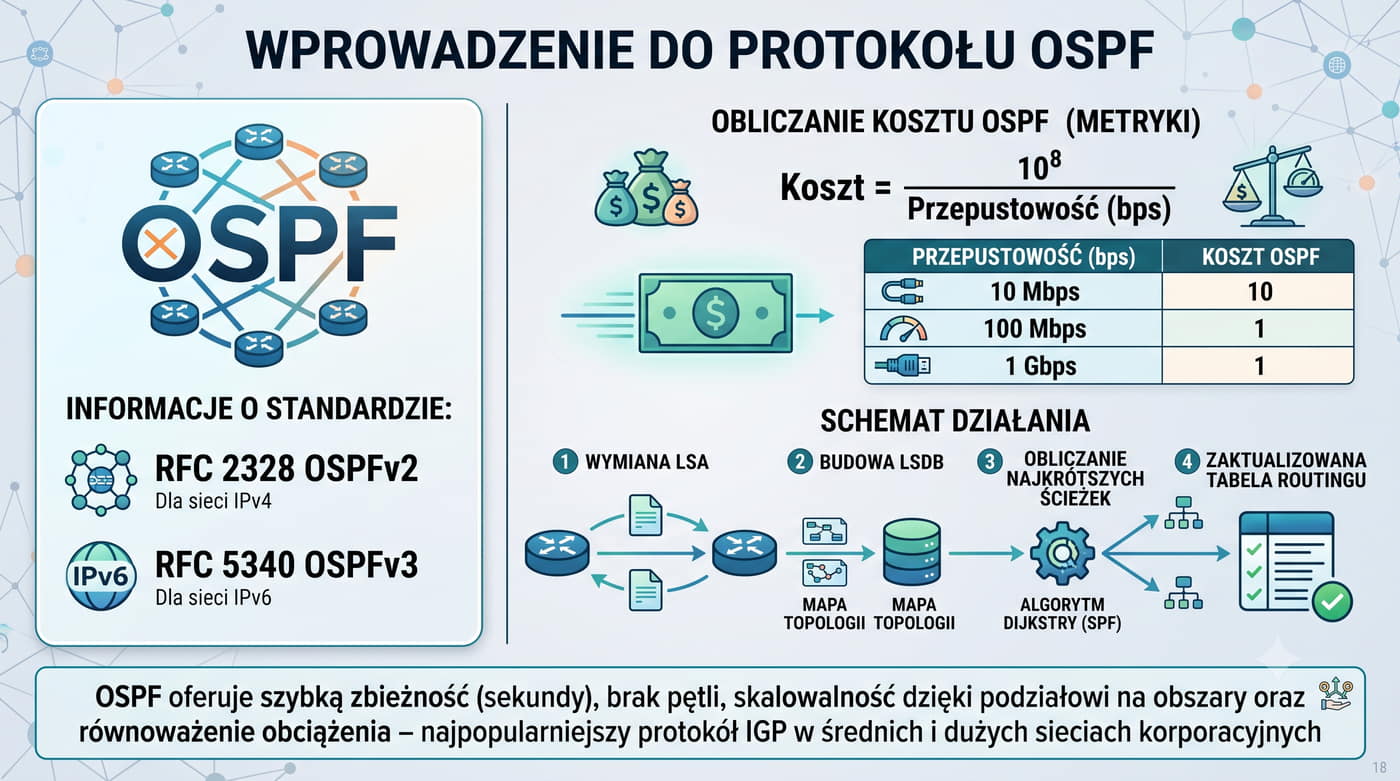
OSPF (Open Shortest Path First) to protokół stanu łącza (link state) zdefiniowany w RFC 2328 (OSPFv2 dla IPv4) i RFC 5340 (OSPFv3 dla IPv6).

W odróżnieniu od protokołów wektora odległości, OSPF buduje pełną mapę topologii sieci (LSDB) i oblicza najkrótsze ścieżki algorytmem Dijkstry.

Metryka OSPF to koszt (cost) obliczany jako 10^8 / przepustowość łącza w bps. Łącze 100 Mbps ma koszt 1, 10 Mbps koszt 10.

Dla łączy szybszych niż 100 Mbps koszt wynosi 1, co może być zmienione przez modyfikację reference bandwidth.

OSPF oferuje szybką zbieżność (sekundy), brak pętli, skalowalność dzięki podziałowi na obszary oraz równoważenie obciążenia.

Jest to najpopularniejszy protokół IGP w średnich i dużych sieciach korporacyjnych.

OSPF jest protokołem stanu łącza (link state), co znacząco różni go od RIP. Zamiast wymiany całych tablic routingu, routery OSPF rozsyłają informacje o stanie swoich łączy, które są gromadzone w bazie danych stanu łącza (LSDB). Na podstawie tej bazy każdy router buduje pełną mapę topologii i samodzielnie oblicza najkrótsze ścieżki algorytmem Dijkstry. Metryka OSPF, zwana kosztem (cost), jest obliczana jako iloraz wartości referencyjnej 10^8 przez przepustowość łącza wyrażoną w bitach na sekundę. Dla łącza 100 Mb/s koszt wynosi 1, dla 10 Mb/s wynosi 10, a dla 1 Mb/s aż 100. Dla łączy szybszych niż 100 Mb/s koszt również wynosi 1, chyba że administrator zmieni wartość referencyjną (reference bandwidth).Dzięki tym cechom OSPF oferuje szybką zbieżność mierzoną w sekundach, brak pętli routingu oraz skalowalność opartą na podziale na obszary. Jest to najpopularniejszy protokół IGP stosowany w średnich i dużych sieciach korporacyjnych.

24/55 Link State vs Distance Vector

Porównanie podejść

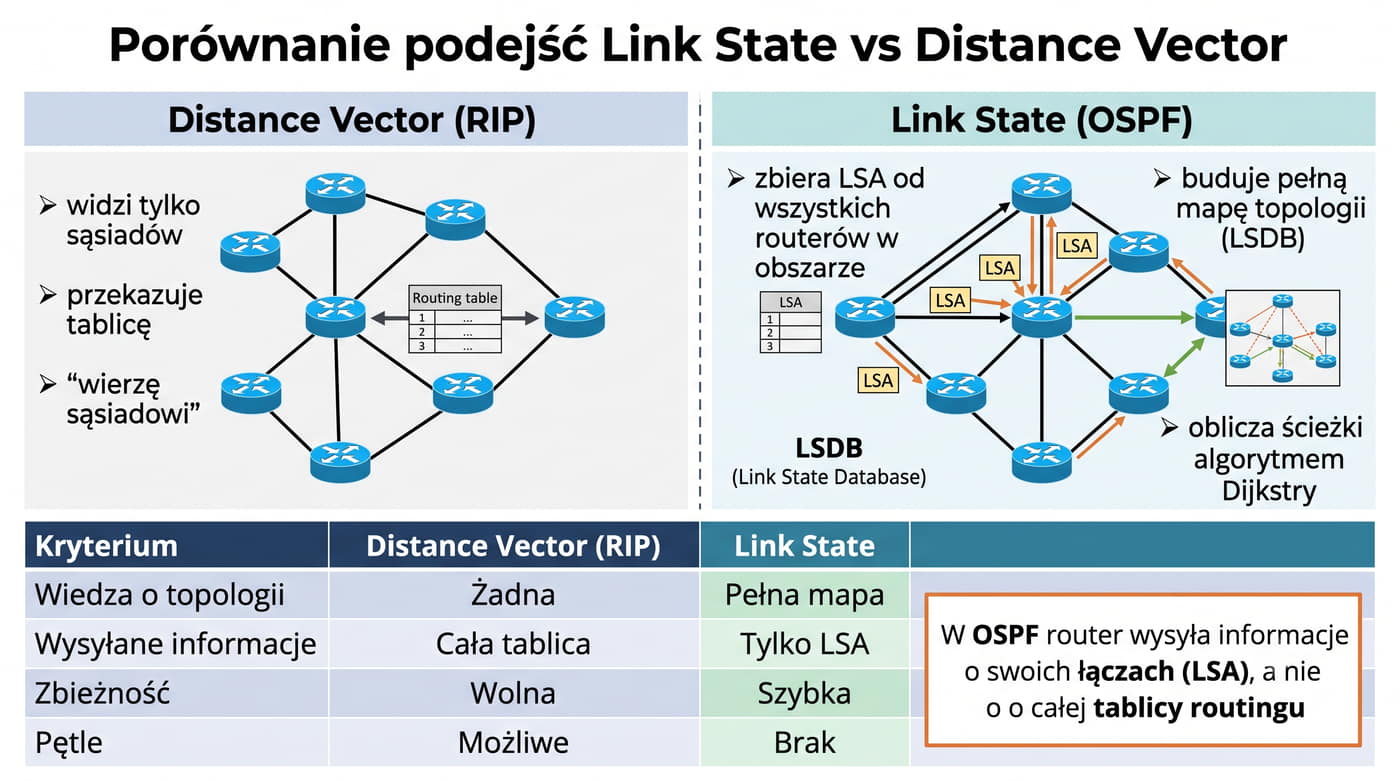
W protokole wektora odległości router nie zna topologii sieci poza swoimi bezpośrednimi sąsiadami – działa na zasadzie "wierze sąsiadowi".

W protokole stanu łącza każdy router zbiera informacje od wszystkich routerów w obszarze.

W OSPF router wysyła informacje o swoich łączach (LSA), a nie o całej tablicy routingu.

Każdy router gromadzi wszystkie LSA z obszaru w LSDB i na jej podstawie buduje kompletną mapę topologii.

Po zbudowaniu pełnej mapy topologii każdy router oblicza niezależnie najkrótsze ścieżki algorytmem Dijkstry, tworząc drzewo SPF (Shortest Path Tree) zakorzenione w danym routerze.

Protokoły stanu łącza i wektora odległości różnią się fundamentalnie. Wektor odległości wymienia całe tablice między sąsiadami bez znajomości topologii. Stan łącza wymienia LSA i buduje mapę sieci na każdym routerze.

Routery OSPF wysyłają informacje o łączach zamiast tablic. Każdy router gromadzi LSA w LSDB i oblicza ścieżki algorytmem Dijkstry.

Niezależne obliczanie tras gwarantuje brak pętli. Koszt obliczeniowy jest wyższy, ale współczesne routery mają wystarczające zasoby.

25/55 Algorytm Dijkstry

Shortest Path First (SPF)

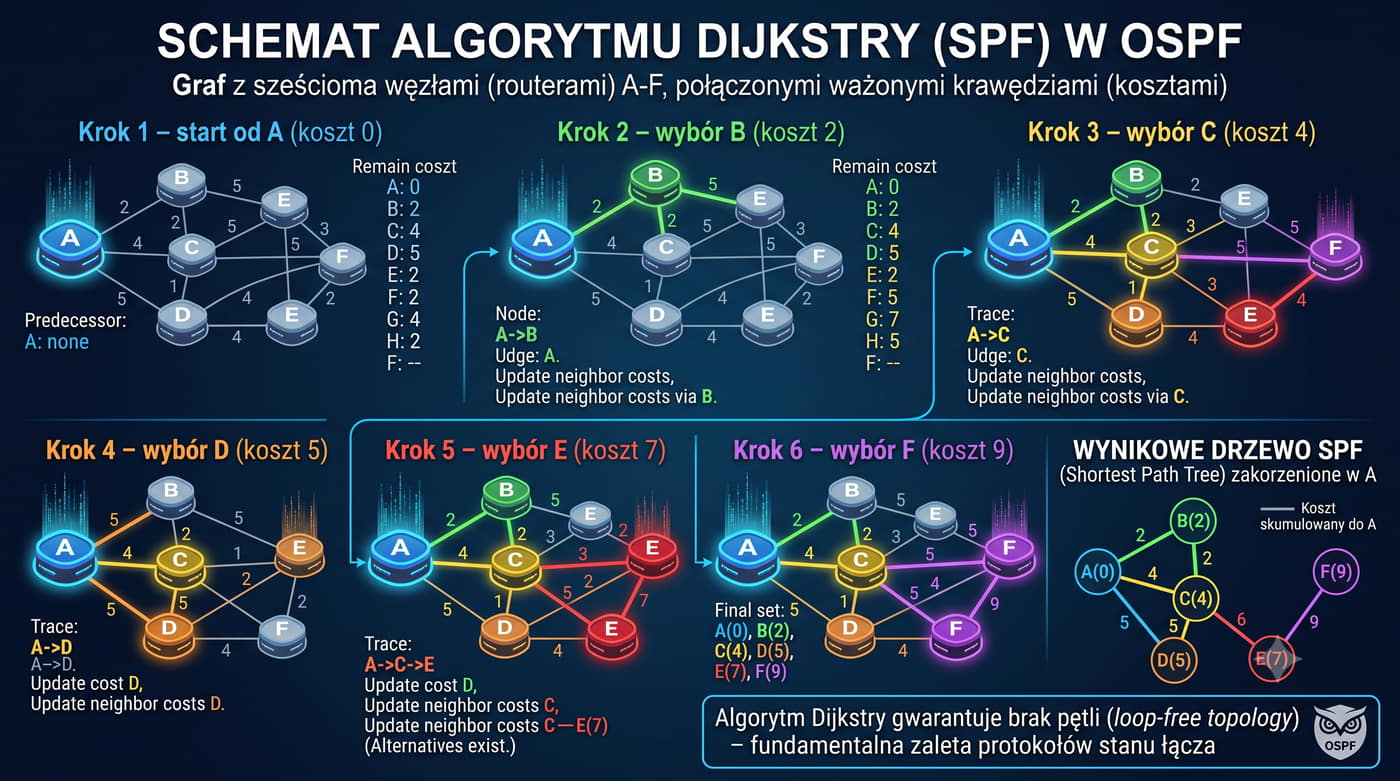
Algorytm Dijkstry został opracowany przez holenderskiego informatyka Edsgera Dijkstrę w 1956 roku.

W kontekście OSPF działa następująco: każdy router buduje graf topologii na podstawie LSDB, gdzie węzłami są routery, a ważonymi krawędziami są łącza z kosztem jako wagą.

Algorytm rozpoczyna od routera źródłowego (samego siebie) i oznacza go jako odwiedzony.

Następnie wybiera nieodwiedzony węzeł z najmniejszym skumulowanym kosztem i aktualizuje koszty sąsiadów.

Proces trwa, aż wszystkie węzły będą odwiedzone.

Drzewo SPF gwarantuje brak pętli (loop-free topology), co jest fundamentalną zaletą protokołów stanu łącza.

Po zmianie topologii OSPF ponownie uruchamia algorytm tylko dla zmienionego obszaru.

Algorytm Dijkstry opracowany w 1956 roku stanowi podstawę działania OSPF. W kontekście protokołu router buduje graf topologii z LSDB, gdzie węzłami są routery, a krawędziami łącza z kosztem jako wagą. Algorytm znajduje najkrótsze ścieżki między źródłem a wszystkimi węzłami.

Router oznacza siebie z kosztem zerowym i iteracyjnie wybiera nieodwiedzony węzeł o najmniejszym koszcie. Po odwiedzeniu wszystkich węzłów powstaje drzewo SPF gwarantujące brak pętli.

W praktyce OSPF przelicza tylko zmieniony obszar. Optymalizacje te redukują obciążenie procesora routera przy częstych zmianach topologii.

26/55 Obszary (areas) w OSPF

Podział domeny routingu

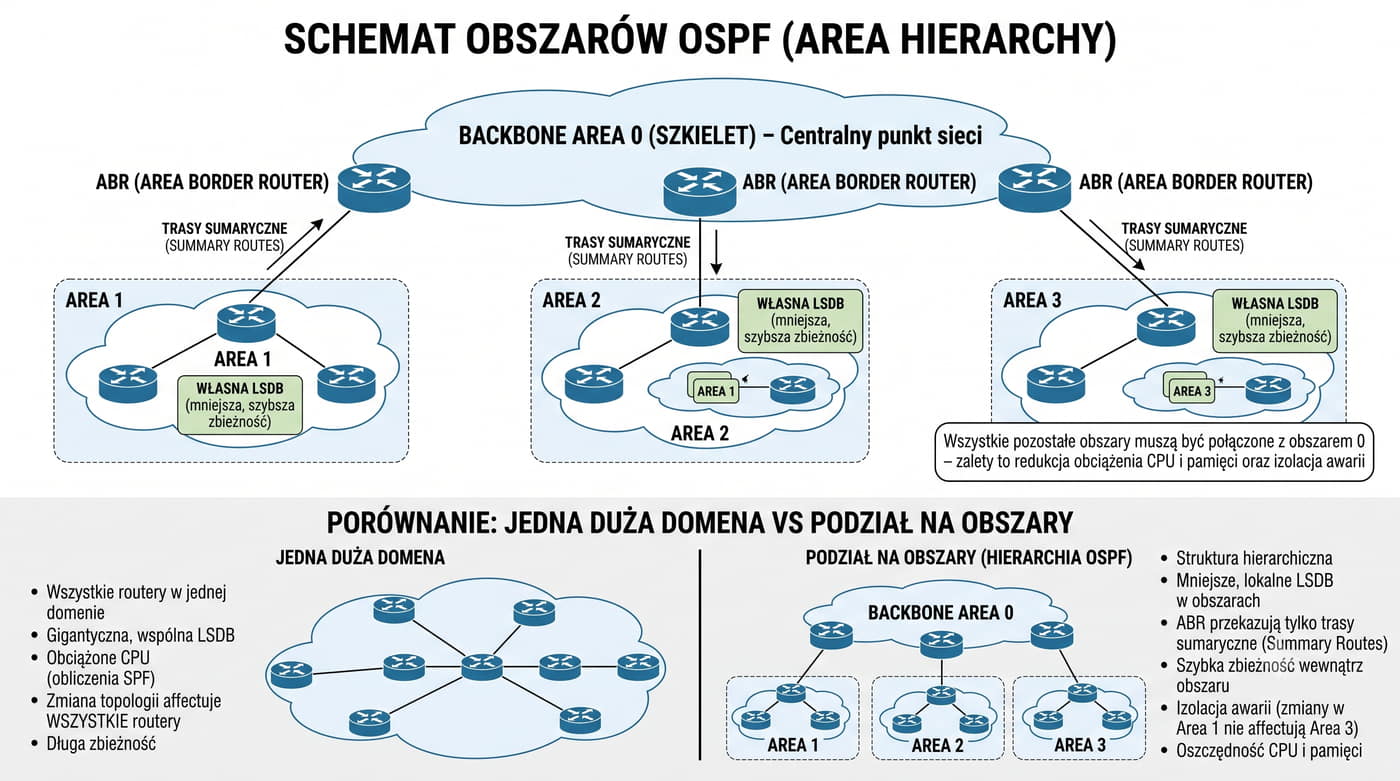
Obszary (areas) w OSPF służą do podziału dużej domeny routingu na mniejsze części.

Obszar 0 (Backbone Area) jest obszarem szkieletowym i stanowi centralny punkt każdej sieci OSPF.

Wszystkie pozostałe obszary muszą być połączone z obszarem 0.

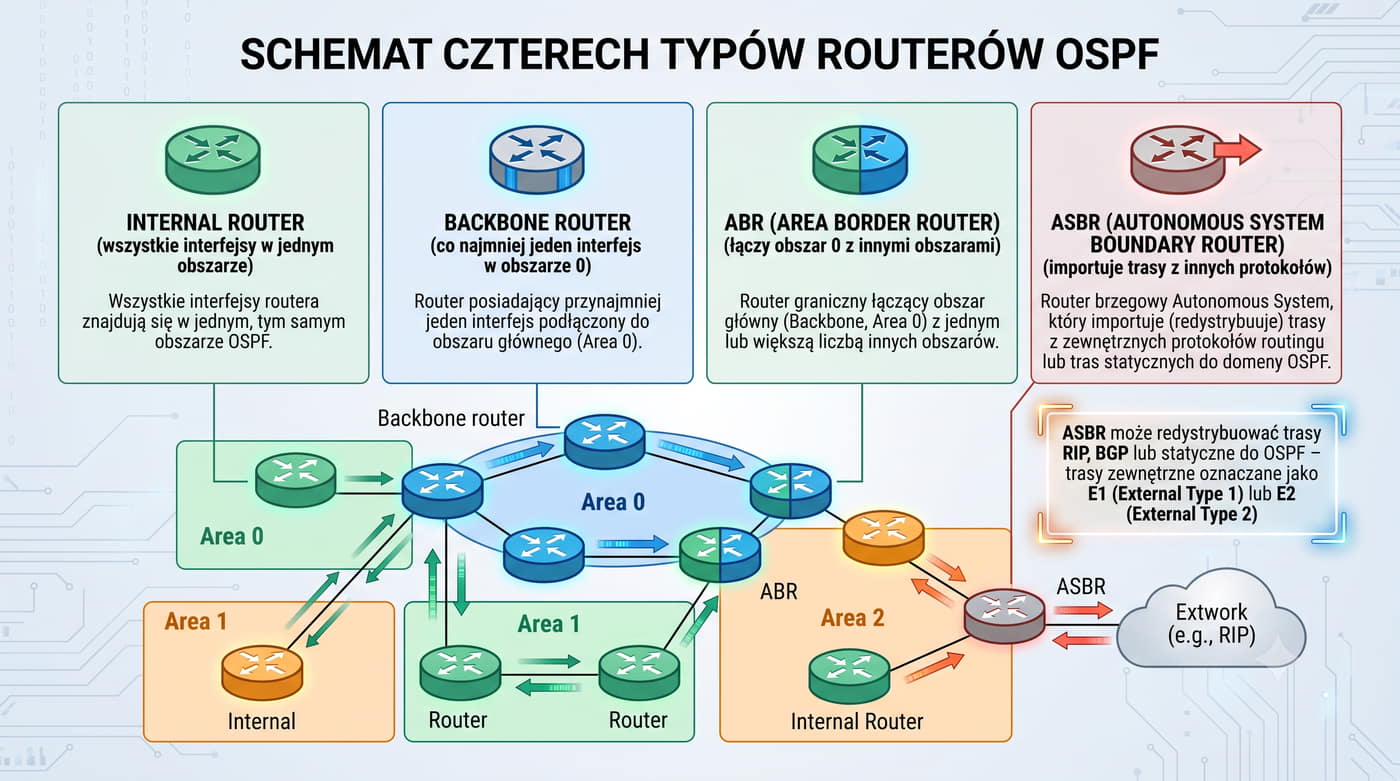
ABR (Area Border Router) to router, który należy do dwóch lub więcej obszarów – co najmniej jednego w obszarze 0 i co najmniej jednego w obszarze nie-szkieletowym.

ABR przekazuje trasy sumaryczne między obszarami.

Zalety obszarów to redukcja obciążenia CPU i pamięci – routery w obszarze 1 nie znają szczegółowych informacji o topologii obszaru 2.

Awaria w jednym obszarze nie wpływa na działanie pozostałych.

Podział domeny OSPF na obszary (areas) jest kluczowym mechanizmem zwiększającym skalowalność protokołu. Obszar 0, nazywany obszarem szkieletowym (backbone area), pełni rolę centralnego punktu łączącego wszystkie pozostałe obszary. Każdy obszar nie-szkieletowy musi być bezpośrednio połączony z obszarem 0, co gwarantuje spójność całej domeny OSPF.Routery ABR (Area Border Router) znajdują się na granicy dwóch lub więcej obszarów i przekazują między nimi trasy sumaryczne, zamiast rozgłaszać szczegółowe informacje o topologii. Dzięki temu router w obszarze 1 nie musi przechowywać informacji o topologii obszaru 2, co redukuje obciążenie pamięci i procesora oraz ogranicza ilość ruchu LSA w sieci. Dodatkową zaletą podziału na obszary jest ograniczenie skutków awarii. Zmiana topologii w jednym obszarze nie wymaga przeliczania drzewa SPF w pozostałych obszarach, co skraca czas zbieżności i zapewnia stabilność działania całej sieci.

27/55 Typy routerów OSPF

Internal, Backbone, ABR, ASBR

Internal Router to router, którego wszystkie interfejsy znajdują się w jednym obszarze.

Backbone Router to router mający co najmniej jeden interfejs w obszarze 0.

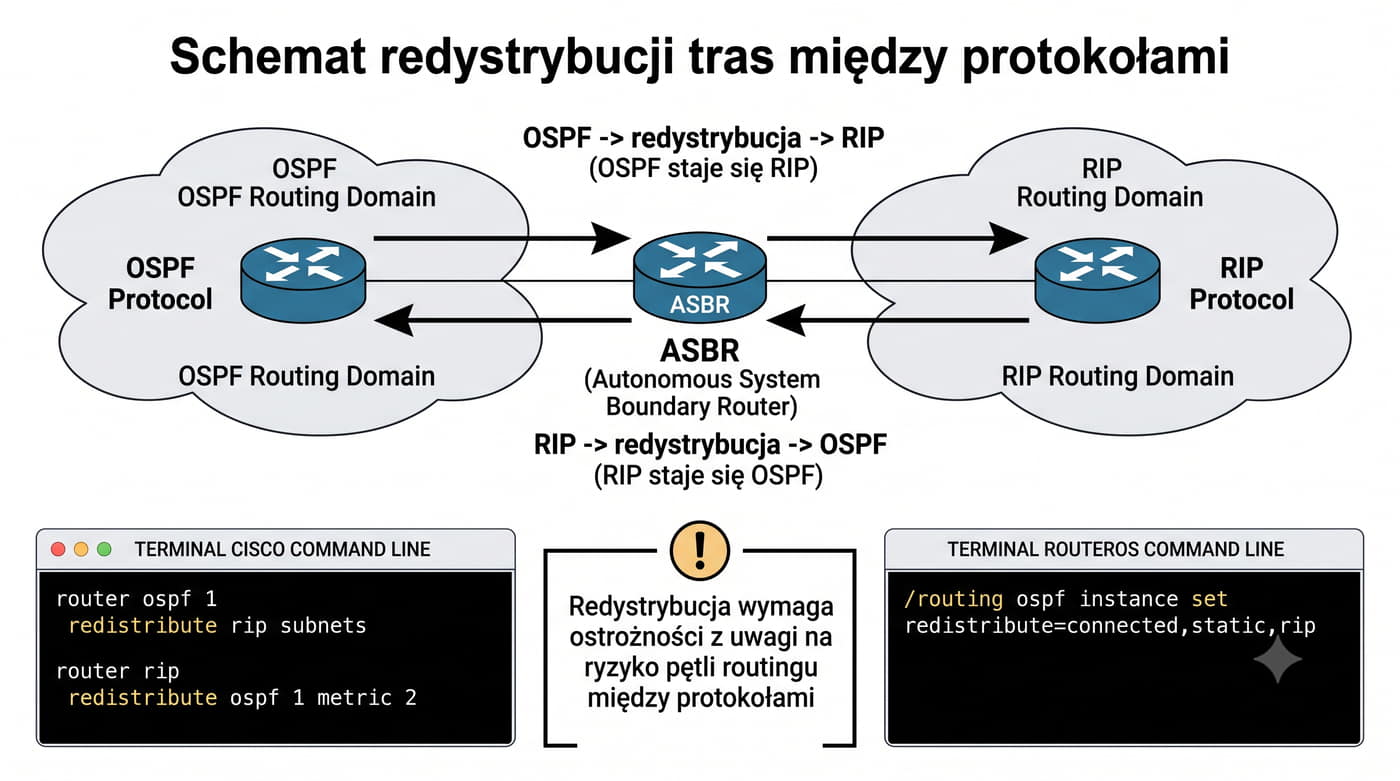
ASBR (Autonomous System Boundary Router) to router importujący trasy z zewnętrznych systemów autonomicznych lub innych protokołów routingu do OSPF.

ASBR może redystrybuować trasy RIP, BGP lub statyczne do OSPF.

Trasy zewnętrzne są oznaczane jako typ E1 (External Type 1 – koszt zewnętrzny + wewnętrzny) lub E2 (External Type 2 – tylko koszt zewnętrzny).

W OSPF wyróżnia się kilka typów routerów, zależnie od ich położenia względem obszarów. Internal Router to urządzenie, którego wszystkie interfejsy znajdują się w jednym obszarze. Backbone Router ma co najmniej jeden interfejs w obszarze 0, natomiast ABR (Area Border Router) łączy obszar szkieletowy z jednym lub większą liczbą obszarów nie-szkieletowych. ASBR (Autonomous System Boundary Router) to router, który importuje trasy z zewnętrznych systemów autonomicznych lub innych protokołów routingu do OSPF. Może redystrybuować trasy RIP, BGP lub statyczne. Trasy zewnętrzne są w OSPF oznaczane jako typy E1 lub E2.Trasa typu E1 (External Type 1) dodaje do metryki zewnętrznej koszt wewnętrzny potrzebny do osiągnięcia ASBR, podczas gdy trasa typu E2 (External Type 2) uwzględnia wyłącznie metrykę zewnętrzną, niezależną od położenia routera w sieci.

28/55 Protokół Hello w OSPF

Wykrywanie sąsiadów

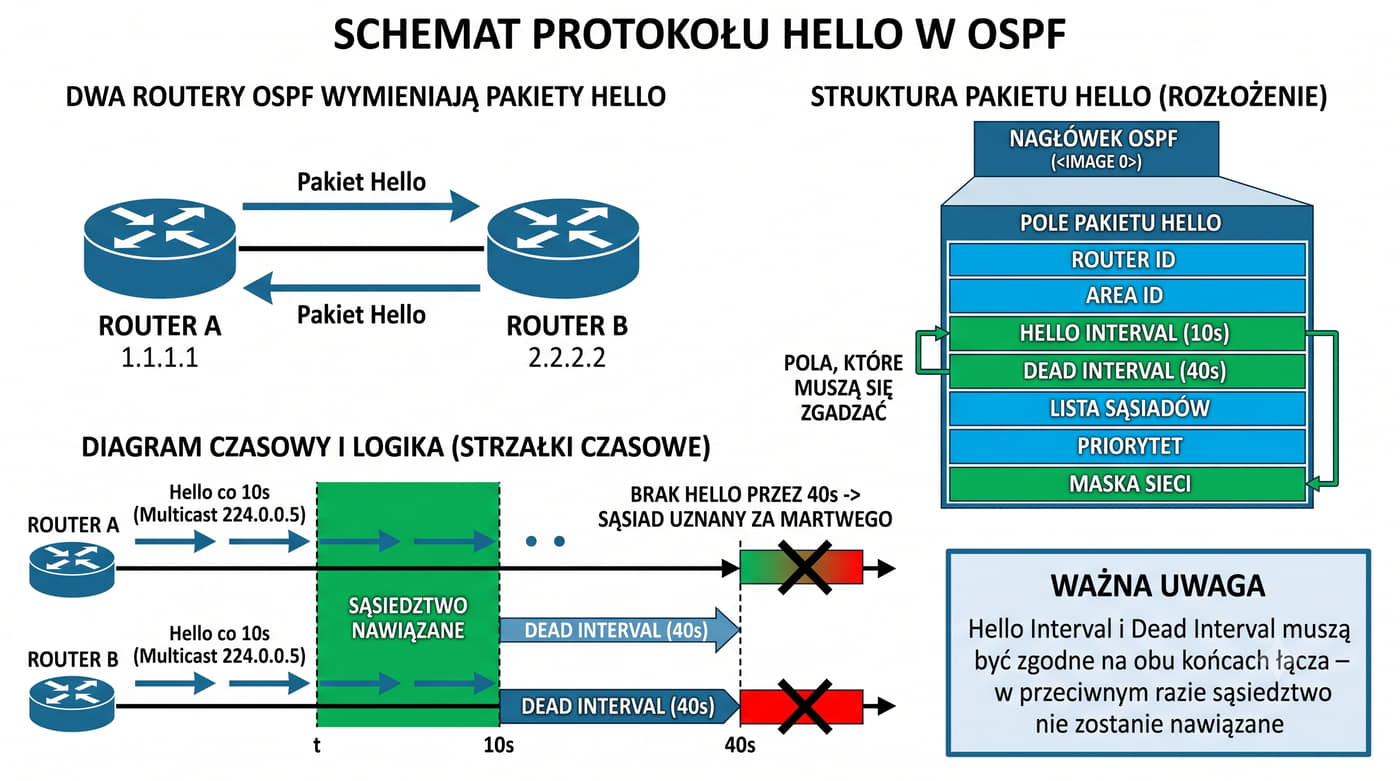
Routery OSPF wysyłają pakiety Hello co 10 sekund na adres multicast 224.0.0.5 (wszystkie routery OSPF) lub 224.0.0.6 (wszystkie DR).

Pakiet Hello zawiera Router ID, Area ID, Hello Interval, Dead Interval i listę sąsiadów.

Dead Interval wynosi domyślnie 40 sekund (4 x Hello Interval).

Jeśli router nie otrzyma Hello od sąsiada w ciągu Dead Interval, uznaje sąsiada za martwego.

Hello Interval i Dead Interval muszą być zgodne na obu końcach łącza.

Po wymianie Hello routery przechodzą przez stany: Down, Init, 2-Way.

W stanie 2-Way następuje wybór DR/BDR na segmencie multi-access.

Mechanizm wykrywania sąsiadów w OSPF opiera się na pakietach Hello, wysyłanych domyślnie co 10 sekund na adres multicast 224.0.0.5, który jest adresem wszystkich routerów OSPF. Adres 224.0.0.6 jest z kolei zarezerwowany dla routerów DR i BDR na segmencie multi-access. Pakiet Hello zawiera między innymi identyfikator routera (Router ID), identyfikator obszaru (Area ID), interwał Hello, interwał Dead oraz listę poznanych sąsiadów. Domyślny interwał Dead wynosi 40 sekund, czyli czterokrotność interwału Hello. Jeśli router nie otrzyma pakietu Hello od sąsiada w ciągu interwału Dead, uznaje go za niedostępny. Interwały Hello i Dead muszą być identyczne po obu stronach łącza, w przeciwnym razie routery nie nawiążą sąsiedztwa. Po wymianie pakietów Hello routery przechodzą kolejne stany sąsiedztwa: Down, Init i 2-Way, a na segmencie multi-access następuje wybór routera DR (Designated Router) i BDR (Backup Designated Router).

29/55 Stany sąsiedztwa OSPF

Od Down do Full

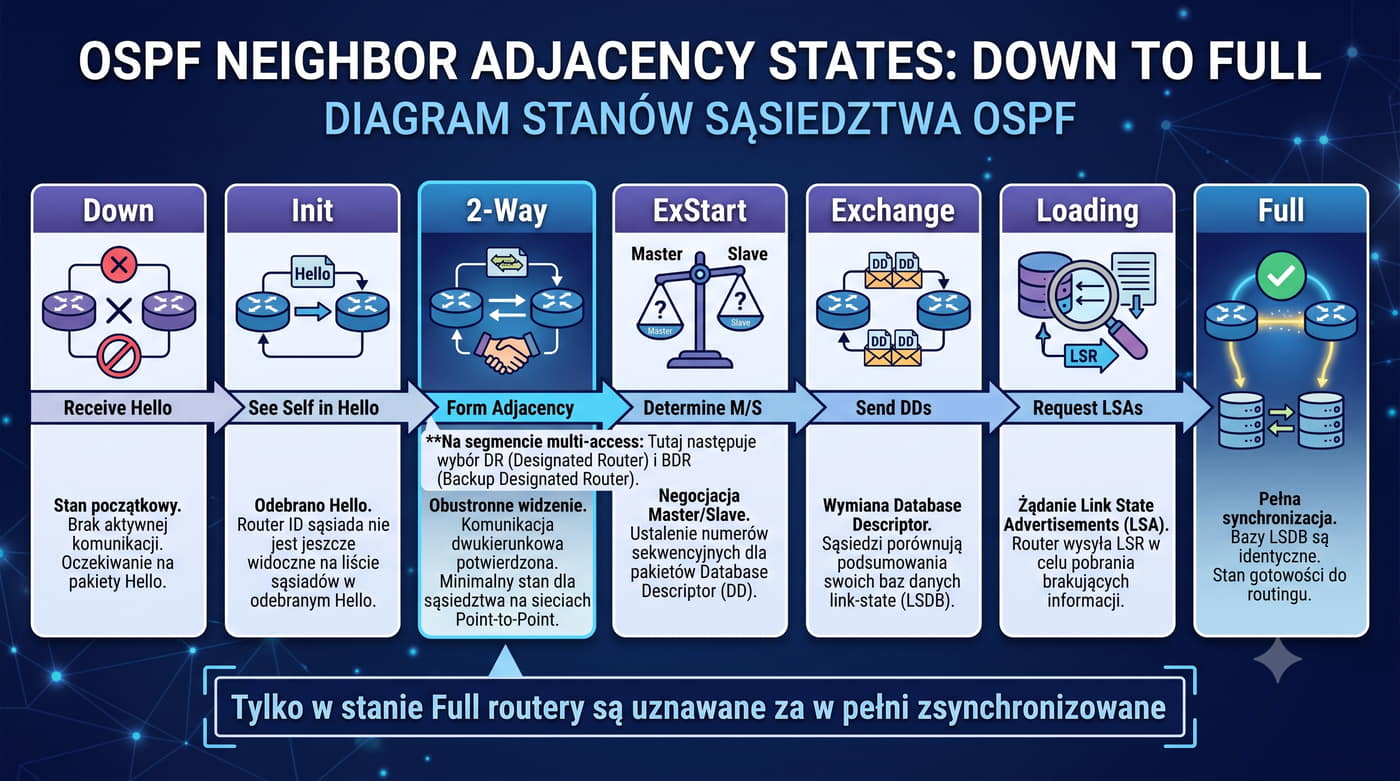
Stan Down oznacza brak komunikacji.

Stan Init oznacza, że router otrzymał Hello od sąsiada.

Stan 2-Way to pierwszy stabilny stan – oba routery widzą się wzajemnie.

Na segmencie multi-access następuje wybór DR i BDR.

Stan ExStart to negocjacja Master/Slave.

Stan Exchange to wymiana DD (Database Description) z nagłówkami LSA.

Stan Loading to żądanie brakujących LSA (LSR), otrzymanie ich (LSU) i potwierdzenie (LSAck).

Stan Full oznacza pełną synchronizację LSDB między routerami.

Tylko w stanie Full routery są uznawane za w pełni zsynchronizowane.

Proces budowania sąsiedztwa OSPF przechodzi przez osiem stanów, z których każdy odzwierciedla kolejny etap synchronizacji bazy danych. Stan Down oznacza brak komunikacji z sąsiadem, a stan Init pojawia się, gdy router otrzymał pakiet Hello od sąsiada, ale sąsiad jeszcze nie widzi tego routera. Stan 2-Way jest pierwszym stabilnym stanem sąsiedztwa – oba routery widzą się wzajemnie w swoich pakietach Hello. Na segmencie multi-access w tym stanie następuje wybór routerów DR i BDR. W kolejnych stanach ExStart i Exchange routery negocjują role Master i Slave oraz wymieniają pakiety DD (Database Description) zawierające opisy nagłówków LSA.W stanie Loading router żąda brakujących LSA pakietami LSR (Link State Request), otrzymuje je w pakietach LSU (Link State Update) i potwierdza pakietami LSAck (Link State Acknowledgment). Stan Full oznacza pełną synchronizację baz danych LSDB i dopiero wtedy sąsiedztwo jest w pełni aktywne.

30/55 LSA – Link State Advertisement

Typy LSA w OSPF

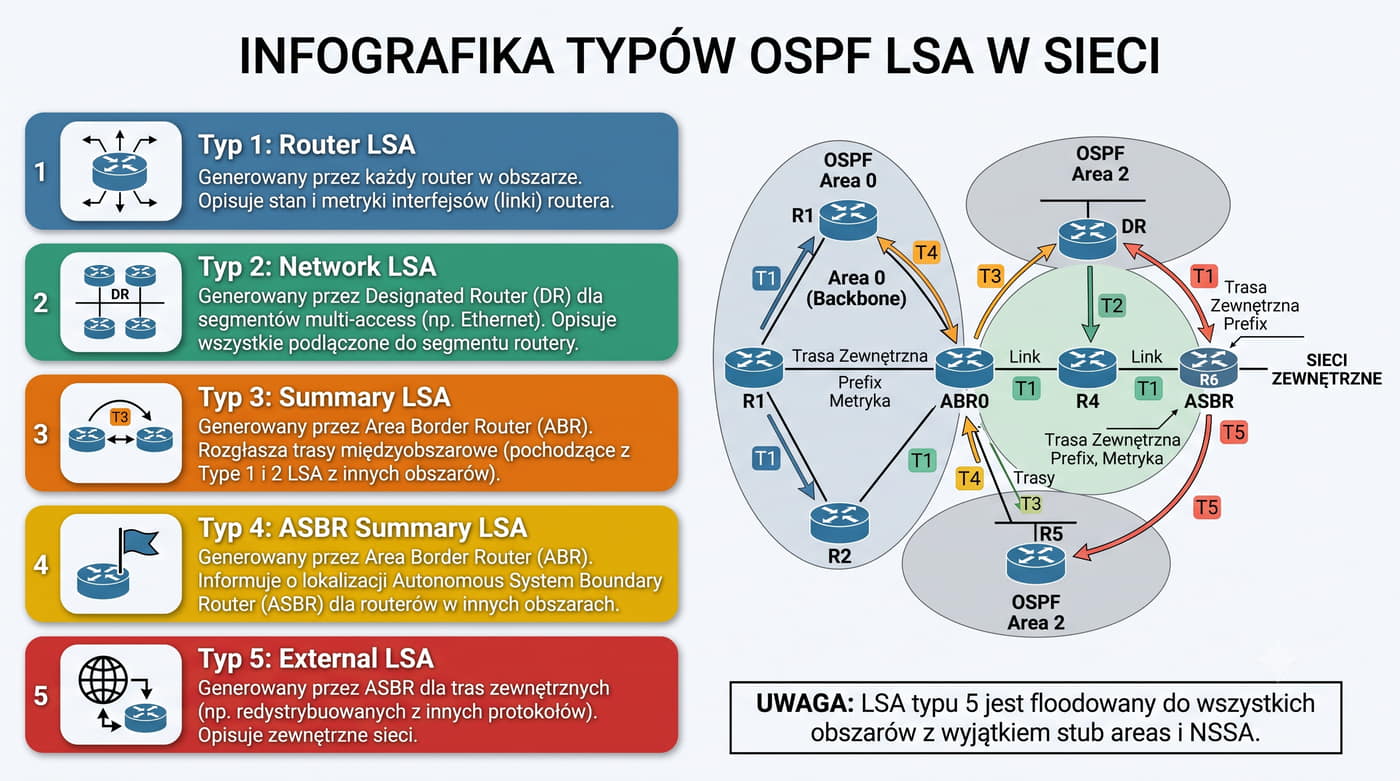
LSA typu 1 (Router LSA) jest generowany przez każdy router i opisuje jego interfejsy.

LSA typu 2 (Network LSA) jest generowany przez DR na segmencie multi-access i opisuje wszystkie routery podłączone do tego segmentu.

LSA typu 3 (Summary LSA) jest generowany przez ABR i opisuje trasy z innych obszarów.

LSA typu 4 (ASBR Summary LSA) wskazuje lokalizację ASBR.

LSA typu 5 (External LSA) opisuje trasy zewnętrzne importowane do OSPF.

LSA typu 5 jest floodowany do wszystkich obszarów z wyjątkiem stub areas i NSSA.

W OSPFv3 dodano typy 8 (Link LSA) i 9 (Intra-Area Prefix LSA).

W OSPF wyróżnia się kilka typów rekordów LSA (Link State Advertisement), z których każdy opisuje inny aspekt topologii sieci. LSA typu 1 (Router LSA) jest generowany przez każdy router i opisuje stan jego własnych łączy. LSA typu 2 (Network LSA) jest generowany przez router DR i opisuje wszystkie routery przyłączone do segmentu multi-access. LSA typu 3 (Summary LSA) jest generowany przez router ABR i opisuje trasy sumaryczne do sieci w innych obszarach. LSA typu 4 (ASBR Summary LSA) informuje o położeniu routerów ASBR. LSA typu 5 (External LSA), generowany przez ASBR, opisuje trasy zewnętrzne, importowane do OSPF z innych źródeł. W OSPFv3, wersji przeznaczonej dla IPv6, dodano LSA typu 8 (Link LSA) opisujące adresy link-local oraz LSA typu 9 (Intra-Area Prefix LSA) opisujące prefiksy adresów w obszarze. Znajomość typów LSA jest istotna przy analizie bazy danych LSDB za pomocą polecenia show ip ospf database.

31/55 DR i BDR

Designated Router i Backup

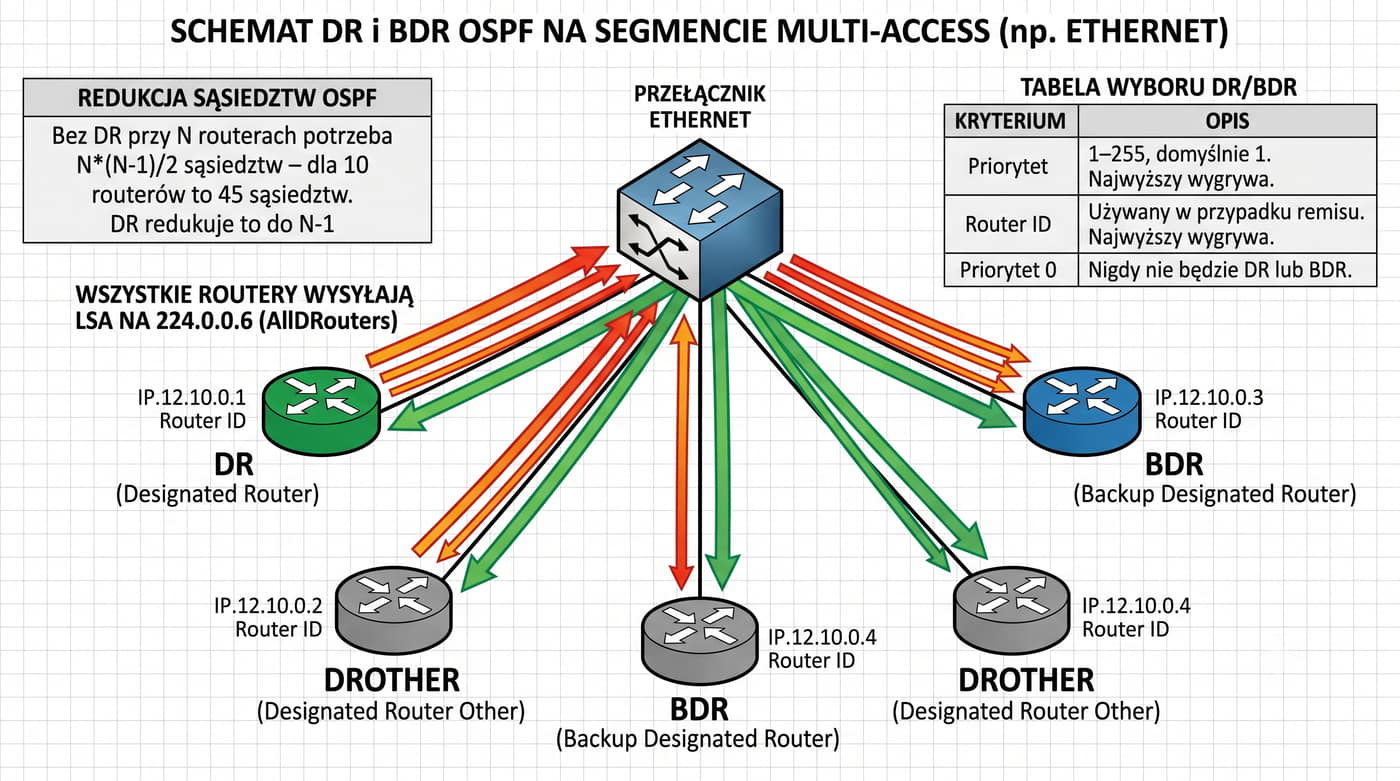
DR (Designated Router) i BDR (Backup Designated Router) redukują liczbę sąsiedztw na segmencie multi-access.

Bez DR przy N routerach potrzeba N*(N-1)/2 sąsiedztw.

Wszystkie routery wysyłają LSA na 224.0.0.6 (AllDR), DR rozsyła je na 224.0.0.5.

BDR przejmuje rolę DR w przypadku awarii DR.

Routery DROTHER utrzymują stan 2-Way z innymi DROTHER i tylko Full z DR i BDR.

Wybór DR/BDR następuje na podstawie priorytetu (domyślnie 1) i Router ID.

Priorytet 0 oznacza, że router nigdy nie będzie DR ani BDR.

W OSPF na segmentach multi-access (np. Ethernet) wybiera się router nadrzędny DR (Designated Router) i zapasowego BDR (Backup Designated Router), aby ograniczyć liczbę relacji sąsiedztwa. W przypadku sieci z pięciu routerów pełne wzajemne sąsiedztwo wymagałoby dziesięciu relacji, natomiast mechanizm DR i BDR redukuje je do czterech relacji z dwoma wybranymi routerami. Bez mechanizmu DR i BDR każdy router musiałby wymieniać LSA z każdym innym routerem na segmencie, co dla N routerów dawałoby n·(n−1)/2 relacji. Dzięki DR i BDR pozostałe routery wymieniają informacje wyłącznie z DR i BDR, co znacząco redukuje ruch sieciowy i obciążenie procesorów. Router DR pełni rolę centralnego punktu wymiany LSA na segmencie. BDR jest zapasowym routerem, który przejmuje rolę DR w przypadku jego awarii. Routery DROther nie biorą udziału w wymianie LSA na warstwie 2 między sobą, lecz komunikują się wyłącznie z DR i BDR. Wybór DR i BDR odbywa się na podstawie priorytetu oraz identyfikatora Router ID.

32/55 Konfiguracja OSPF w Cisco IOS

Polecenia i weryfikacja

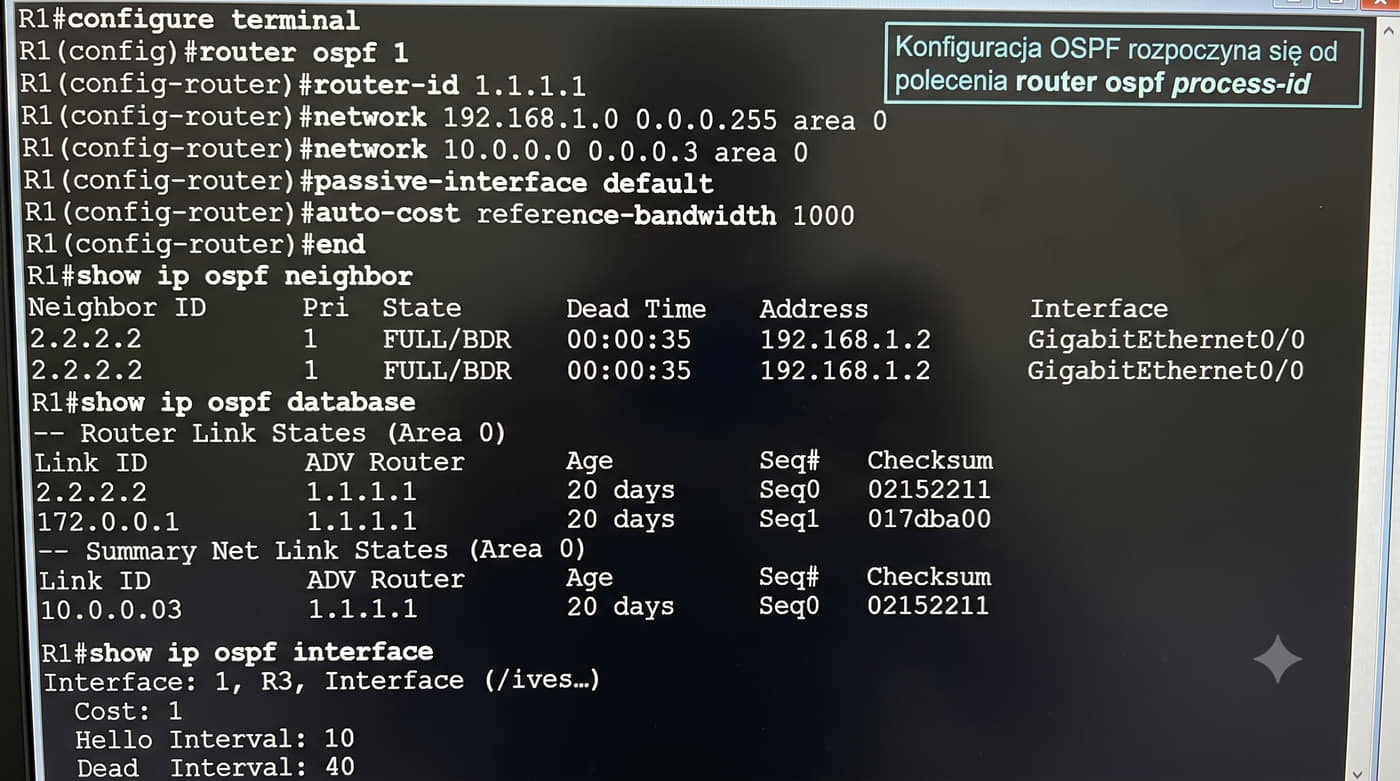
Konfiguracja OSPF rozpoczyna się od polecenia router ospf process-id.

Router-id 1.1.1.1 ręcznie określa Router ID.

Polecenie network 192.168.1.0 0.0.0.255 area 0 włącza OSPF na interfejsach i przypisuje do obszaru 0.

Polecenie passive-interface default włącza tryb passive dla wszystkich interfejsów.

Polecenie auto-cost reference-bandwidth 1000 zmienia referencyjną przepustowość dla obliczania kosztu.

show ip ospf neighbor wyświetla sąsiadów OSPF. show ip ospf database pokazuje LSDB. show ip ospf interface wyświetla informacje o interfejsach OSPF.

Konfiguracja OSPF w systemie Cisco IOS rozpoczyna się od polecenia router ospf proces-id, które tworzy proces OSPF i przenosi administratora w tryb konfiguracji protokołu. Polecenie network adres_sieci maska_dzika_area identyfikator przypisuje interfejsy należące do podanej sieci do wybranego obszaru OSPF.W OSPF używa się tak zwanej odwróconej maski dzikiej (wildcard mask), która jest negacją zwykłej maski podsieci. Na przykład dla sieci 192.168.1.0/24 maska dzika wynosi 0.0.0.255. Polecenie router-id 1.1.1.1 ustala identyfikator routera, a polecenie passive-interface wyłącza wysyłanie pakietów Hello na wskazanym interfejsie. Do diagnostyki OSPF służą polecenia show ip ospf neighbor, wyświetlające stan sąsiedztwa, show ip ospf interface, pokazujące szczegóły interfejsu OSPF, oraz show ip route ospf, filtrujące tablicę routingu do tras pochodzących z OSPF. Polecenie debug ip ospf events umożliwia śledzenie zdarzeń protokołu w czasie rzeczywistym.

33/55 Konfiguracja OSPF w RouterOS

MikroTik RouterOS

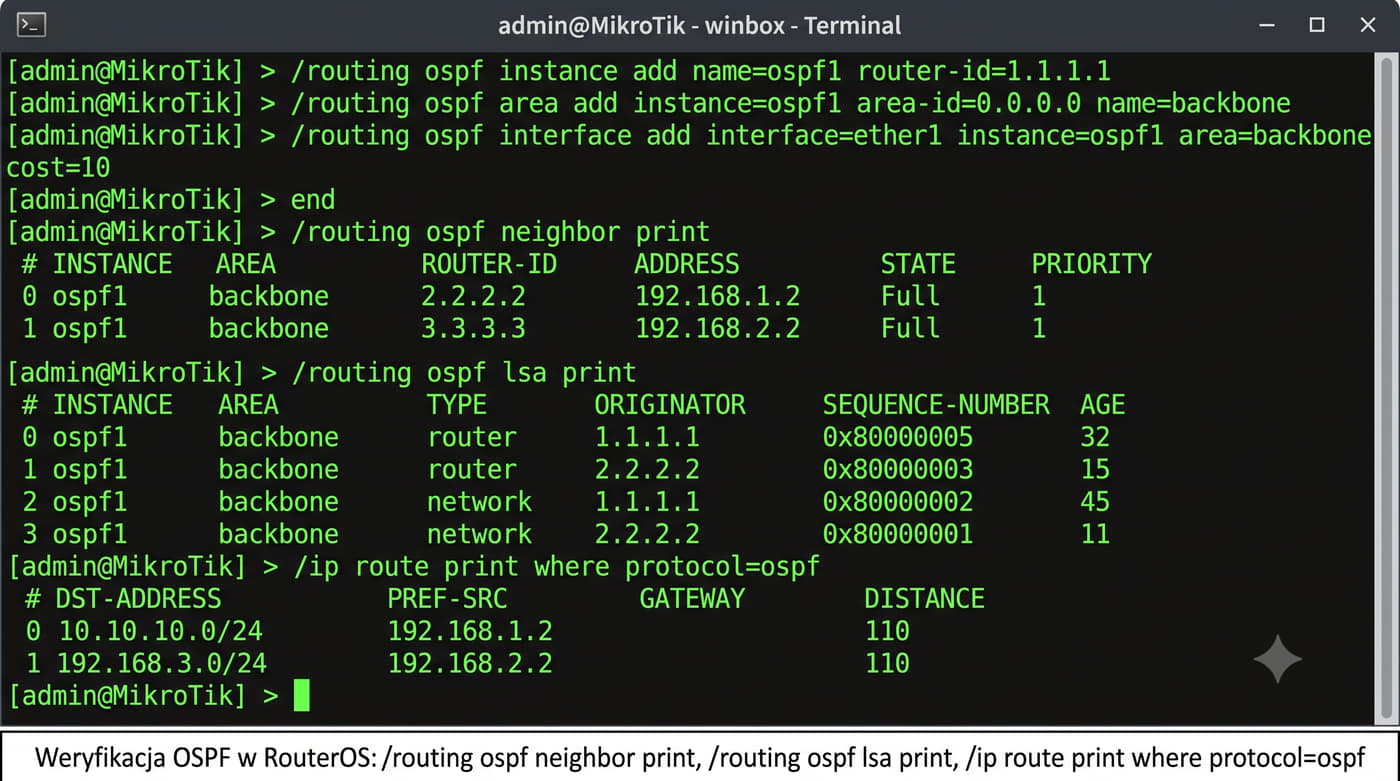
Konfiguracja OSPF w RouterOS: /routing ospf instance add name=ospf1 router-id=1.1.1.1 tworzy instancję. /routing ospf area add instance=ospf1 area-id=0.0.0.0 name=backbone definiuje obszar 0.

/routing ospf interface add interface=ether1 instance=ospf1 area=backbone przypisuje interfejs.

Parametr cost ustawia koszt, network-type określa typ sieci (broadcast, point-to-point).

Weryfikacja: /routing ospf neighbor print, /routing ospf lsa print, /ip route print where protocol=ospf.

Konfiguracja protokołu OSPF w systemie RouterOS firmy MikroTik jest wykonywana w interfejsie wiersza poleceń. W nowszych wersjach RouterOS v7 polecenie /routing ospf instance add name=ospf1 router-id=1.1.1.1 tworzy instancję OSPF, a polecenie /routing ospf area add instance=ospf1 name=backbone area-id=0.0.0.0 definiuje obszar szkieletowy. Polecenie /routing ospf interface add interface=ether1 instance=ospf1 area=backbone przypisuje interfejs do obszaru, natomiast parametry cost i network-type umożliwiają ręczne ustawienie kosztu oraz typu sieci OSPF (broadcast, point-to-point, NBMA). W wersji RouterOS v6 stosowane są polecenia z podmenu /routing ospf, np. /routing ospf network add. Weryfikacja konfiguracji odbywa się za pomocą poleceń /routing ospf neighbor print, wyświetlającego stan sąsiedztwa, /routing ospf lsa print, pokazującego bazę LSA, oraz /ip route print, w którym trasy OSPF są oznaczone flagą. Polecenie /ip route print where protocol=ospf filtruje wynik wyłącznie do tras pochodzących z OSPF.

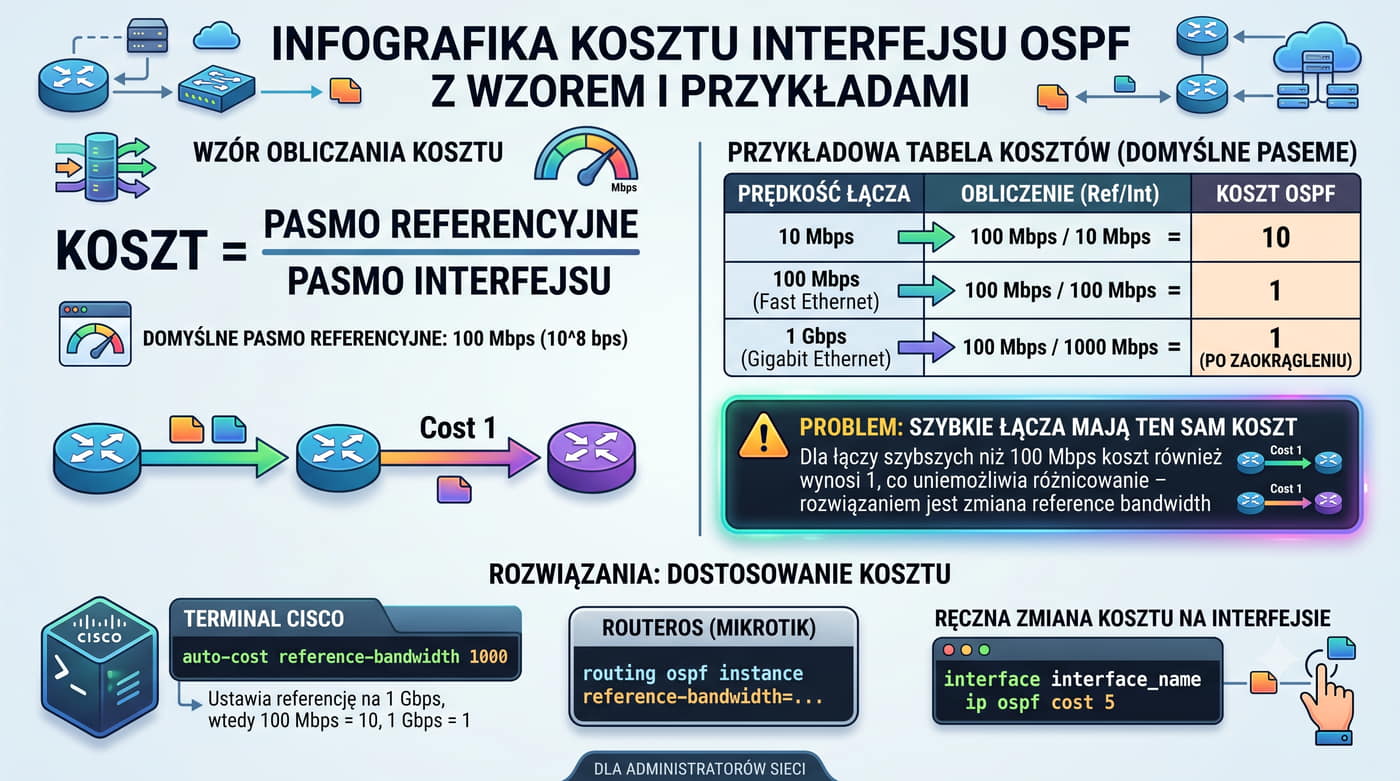
34/55 Koszt interfejsu OSPF

Auto-cost i ręczna regulacja

Koszt OSPF = 10^8 / przepustowość (bps). Łącze 100 Mbps ma koszt 1, 10 Mbps koszt 10.

Dla łączy szybszych niż 100 Mbps koszt również wynosi 1, co uniemożliwia różnicowanie.

Rozwiązaniem jest zmiana reference bandwidth poleceniem auto-cost reference-bandwidth 1000 w Cisco IOS.

Wtedy 100 Mbps ma koszt 10, 1 Gbps koszt 1, 10 Gbps koszt 1.

Ręczna zmiana kosztu: ip ospf cost 5 w Cisco IOS lub parametr cost w RouterOS.

Ręczne ustawienie nadpisuje wartość obliczoną automatycznie.

W OSPF metryka tras jest obliczana automatycznie na podstawie przepustowości łącza. Koszt pojedynczego interfejsu określa wzór: koszt = 10^8 / przepustowość (w bitach na sekundę). Dla łącza 100 Mb/s koszt wynosi 1, dla łącza 10 Mb/s wynosi 10, a dla łącza 1 Mb/s aż 100. Całkowity koszt trasy jest sumą kosztów wszystkich interfejsów na ścieżce. Ponieważ łącza szybsze niż 100 Mb/s również otrzymałyby koszt 1 (wartość ułamkowa jest zaokrąglana w górę do 1), Cisco wprowadziło polecenie auto-cost reference-bandwidth, które zmienia wartość referencyjną. Ustawienie wartości 10000 powiększa koszt łącza 10 Gb/s do 1, a łącza 100 Mb/s do 100, co umożliwia zróżnicowanie kosztów dla szybkich łączy. W Pojedynczych przypadkach administrator może ręcznie nadpisać wyliczony koszt poleceniem ip ospf cost wartość, np. aby wymusić preferowanie konkretnego łącza niezależnie od jego przepustowości. W RouterOS parametr cost jest ustawiany na poziomie interfejsu OSPF poleceniem /routing ospf interface set.

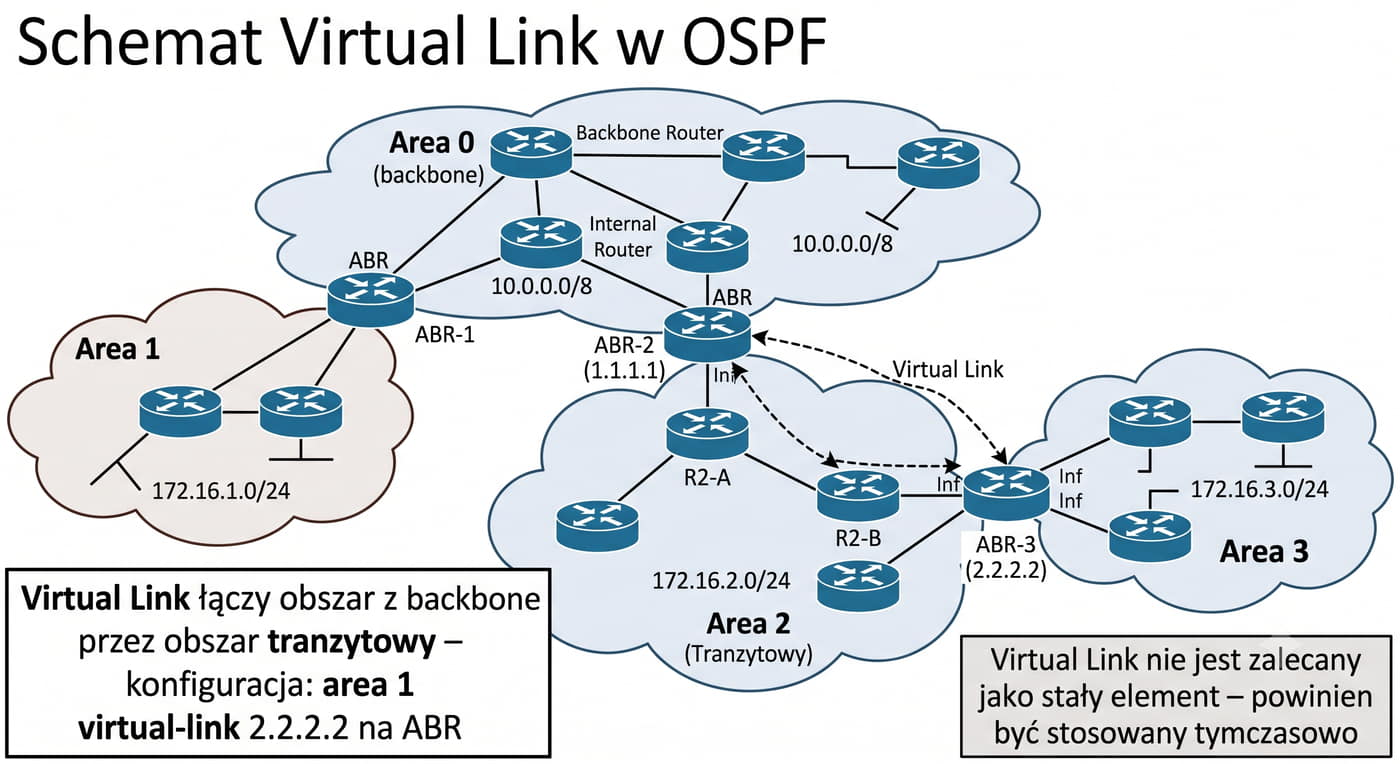
35/55 Virtual Link w OSPF

Łączenie obszarów z backbone

Virtual Link jest częścią backbone.

Virtual Link łączy obszar z backbone przez obszar tranzytowy.

Standard OSPF wymaga fizycznego połączenia każdego obszaru z obszarem 0, ale Virtual Link tworzy logiczne połączenie.

Konfiguracja: area 1 virtual-link 2.2.2.2 na ABR.

Parametry: numer obszaru tranzytowego i Router ID drugiego ABR.

Virtual Link nie jest zalecany jako stały element – powinien być stosowany tymczasowo.

Virtual Link w OSPF to logiczny tunel, który łączy obszar nie-szkieletowy z obszarem szkieletowym przez obszar pośredni, nazywany obszarem tranzytowym. Jest stosowany w wyjątkowych sytuacjach, gdy ze względu na topologię sieci nie istnieje bezpośrednie połączenie fizyczne pomiędzy danym obszarem a obszarem 0.Konfiguracja Virtual Link w Cisco IOS wymaga podania identyfikatora obszaru tranzytowego oraz identyfikatora routera po drugiej stronie łącza, np. area 1 virtual-link 2.2.2.2, gdzie 1 to obszar tranzytowy, a 2.2.2.2 to Router ID sąsiedniego routera ABR. Virtual Link musi być skonfigurowany po obu stronach. Virtual Link nie powinien być rozwiązaniem stałym, lecz środkiem tymczasowym stosowanym podczas migracji lub w sytuacjach awaryjnych. W praktyce zaleca się odpowiednie zaprojektowanie sieci, aby każdy obszar był bezpośrednio połączony z obszarem szkieletowym.

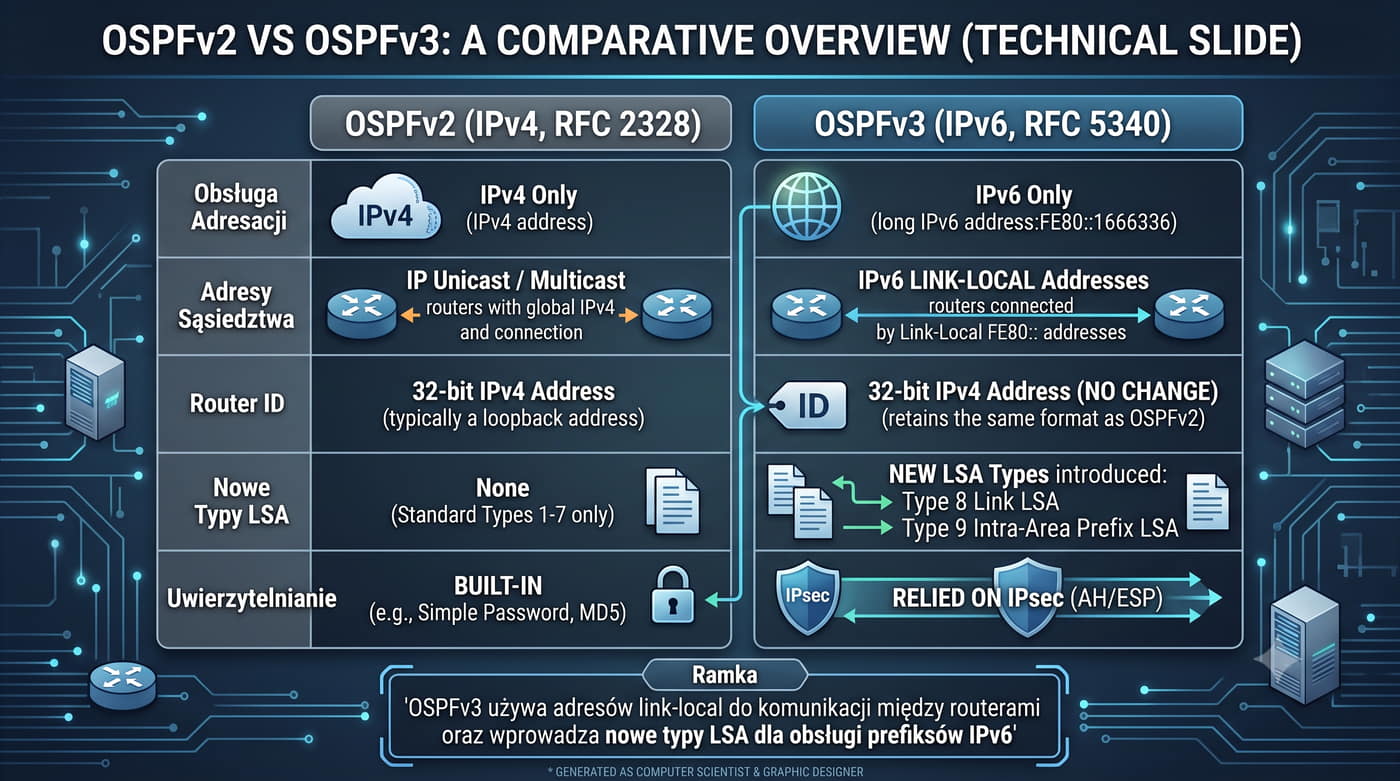
36/55 OSPFv3

OSPF dla IPv6

RouterID pozostaje 32-bitowy (IPv4).

OSPFv3 (RFC 5340) działa na IPv6 i używa adresów IPv6 link-local do komunikacji między routerami.

OSPFv3 wprowadza Link LSA (typ 8) z adresem link-local i Intra-Area Prefix LSA (typ 9) dla prefiksów IPv6.

OSPFv3 używa tych samych mechanizmów co OSPFv2: Hello Protocol, DR/BDR, obszary, algorytm Dijkstry.

OSPFv3, zdefiniowany w RFC 5340, jest wersją protokołu OSPF działającą w środowisku IPv6. W przeciwieństwie do OSPFv2 nie posługuje się adresami IPv4 i wymaga do komunikacji między routerami adresów IPv6 typu link-local. Router ID pozostaje wartością 32-bitową, co pozwala na zachowanie spójności z OSPFv2.Mechanizmy działania OSPFv3 są tożsame z OSPFv2: pozostaje protokół Hello, wybór routerów DR i BDR, podział na obszary oraz obliczanie ścieżek algorytmem Dijkstry. Zmianie ulega sposób przechowywania prefiksów – informacje o adresach IPv6 nie są częścią reakcji LSA opisujących łącza, lecz są przekazywane w oddzielnych rekordach. W OSPFv3 dodano nowe typy LSA: LSA typu 8 (Link LSA), które zawierają adresy IPv6 link-local sąsiadów, oraz LSA typu 9 (Intra-Area Prefix LSA), które przypisują prefiksy IPv6 do poszczególnych routerów lub segmentów. Dzięki temu protokół obsługuje multipleksowanie wielu adresów IPv6 na jednym łączu.

37/55 Porównanie RIP i OSPF

Który protokół wybrać?

RIP używa hop count z limitem 15, OSPF kosztu zależnego od przepustowości.

RIP zbieżny w minutach, OSPF w sekundach.

RIP wysyła tablicę co 30s, OSPF tylko przy zmianach.

RIP jest podatny na pętle, OSPF wolny od pętli.

RIP nie obsługuje obszarów, OSPF dzieli sieć na obszary dla skalowalności.

RIP jest prosty dla małych sieci edukacyjnych.

OSPF jest standardem w nowoczesnych sieciach korporacyjnych.

Porównanie RIP i OSPF pokazuje fundamentalne różnice między wektorem odległości a stanem łącza. RIP używa bardzo prostej metryki, jaką jest liczba skoków, nie uwzględniając przepustowości łączy. OSPF oblicza koszt na podstawie przepustowości, dzięki czemu wybór trasy lepiej odzwierciedla rzeczywiste możliwości łącza. RIP osiąga zbieżność w czasie kilku minut, ponieważ długie timery opóźniają wykrycie awarii i propagację zmian. OSPF osiąga zbieżność w ciągu kilku sekund dzięki natychmiastowemu wykrywaniu zmian przez pakiety Hello i szybkiemu przeliczaniu drzewa SPF. RIP okresowo wysyła całe tablice routingu, generując obciążenie pasma, natomiast OSPF wysyła tylko zmiany LSA.W przeciwieństwie do RIP protokół OSPF wspiera podział na obszary, co czyni go skalowalnym dla dużych sieci, oraz gwarantuje brak pętli routingu. Z tych względów OSPF jest standardem w nowoczesnych sieciach korporacyjnych, podczas gdy RIP znajduje zastosowanie wyłącznie w małych sieciach i celach edukacyjnych.

38/55 Podsumowanie bloku III

Protokół OSPF

Obszary z backbone (obszar 0).

DR i BDR redukują sąsiedztwa.

OSPF to Link State z algorytmem Dijkstry.

Metryka to koszt = 10^8 / przepustowość.

LSA: typ 1 (Router), typ 2 (Network), typ 3 (Summary), typ 4 (ASBR Summary), typ 5 (External).

Stany: Down, Init, 2-Way, ExStart, Exchange, Loading, Full.

Konfiguracja w Cisco IOS (router ospf, network area) i RouterOS (/routing ospf).

OSPF oferuje szybką zbieżność i skalowalność.

Trzeci blok prezentacji podsumowuje wiedzę o protokole OSPF, który jest protokołem stanu łącza. Podstawą działania OSPF jest budowa drzewa SPF (Shortest Path Tree) algorytmem Dijkstry na podstawie bazy danych LSDB, co gwarantuje brak pętli routingu. Podział domeny na obszary z obszarem szkieletowym 0 zapewnia skalowalność. Metryką OSPF jest koszt, obliczany jako 10^8 / przepustowość łącza. Wyróżnia się typy rekordów LSA: typ 1 (Router), typ 2 (Network), typ 3 (Summary), typ 4 (ASBR Summary) i typ 5 (External). Stany sąsiedztwa OSPF obejmują kolejno Down, Init, 2-Way, ExStart, Exchange, Loading i Full. Mechanizm DR i BDR redukuje liczbę relacji sąsiedztwa na segmentach multi-access. Konfigurację OSPF wykonuje się w Cisco IOS poleceniami router ospf i network, a w RouterOS w podmenu /routing ospf. OSPF oferuje szybką zbieżność, skalowalność i niezawodność, co czyni go standardem IGP.

39/55 BGP – Border Gateway Protocol

Protokół zewnętrzny Internetu

BGP działa na porcie TCP 179.

BGP (RFC 4271) łączy systemy autonomiczne w Internecie.

Jest protokołem wektora ścieżki (path vector).

Decyzje są podejmowane na podstawie atrybutów ścieżki, a nie pojedynczej metryki.

Sesja BGP wymienia całe tablice routingu i przyrostowe aktualizacje.

BGP utrzymuje sesję przez Keepalive co 60 sekund.

W odróżnieniu od IGP, BGP podejmuje decyzje na podstawie polityki biznesowej.

Administrator może wpływać na wybór ścieżek przez modyfikację atrybutów.

BGP (Border Gateway Protocol), zdefiniowany w RFC 4271, jest protokołem routingu między systemami autonomicznymi i funkcjonuje jako kręgosłup Internetu. Działa na bazie protokołu TCP na porcie 179, dzięki czemu jego komunikacja jest niezawodna i nie wymaga własnego mechanizmu retransmisji. BGP jest klasyfikowany jako protokół wektora ścieżki (path vector), co oznacza, że decyzje o wyborze trasy są podejmowane na podstawie atrybutów ścieżki, a nie pojedynczej metryki. Po nawiązaniu sesji routery wymieniają całe tablice routingu BGP, a następnie przekazują jedynie przyrostowe aktualizacje. Sesja BGP jest utrzymywana przez pakiety Keepalive wysyłane domyślnie co 60 sekund, a jej zerwanie następuje po upływie interwału Hold, wynoszącego domyślnie 180 sekund. W odróżnieniu od protokołów IGP, BGP kieruje się polityką biznesową, a administrator może wpływać na wybór ścieżek przez modyfikację atrybutów.
40/55 Podstawowe pojęcia BGP

eBGP, iBGP, ASN, peering

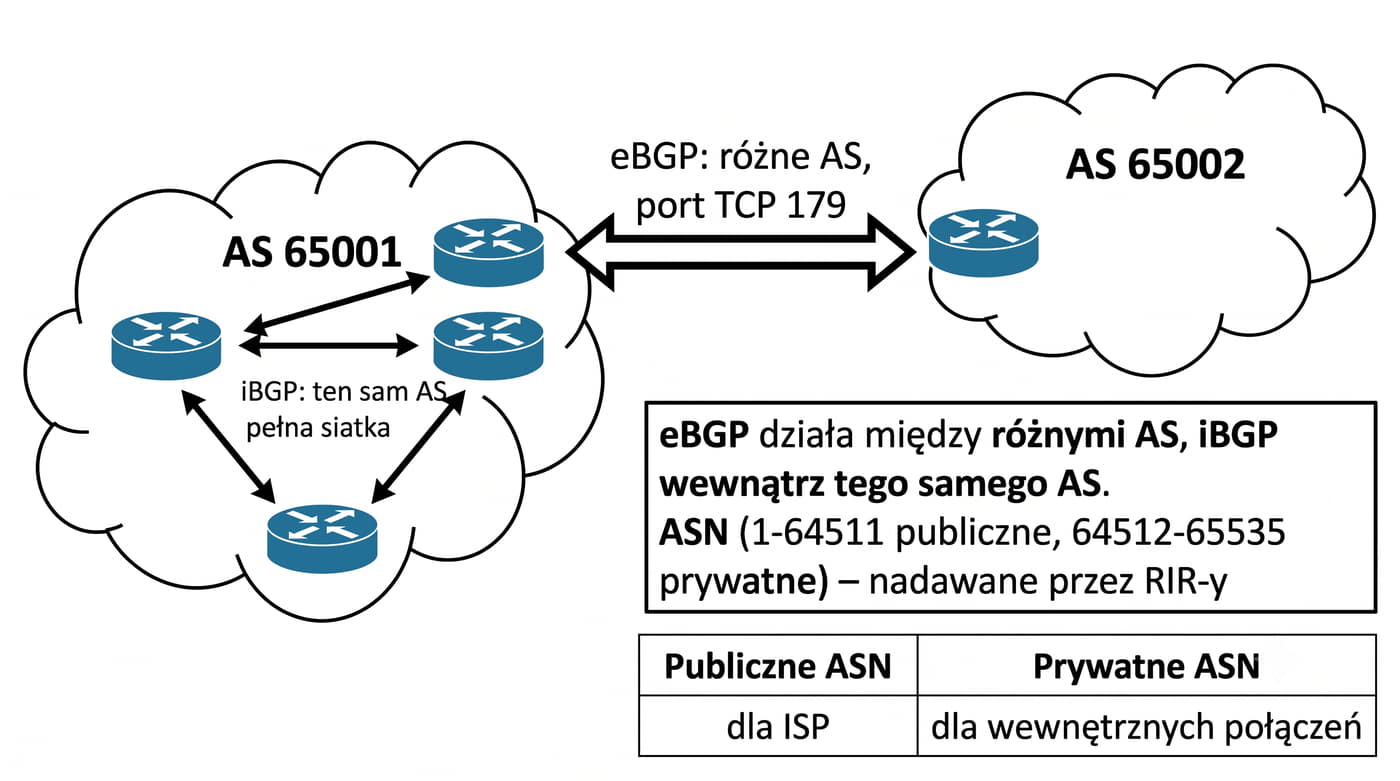
eBGP działa między różnymi AS, a iBGP wewnątrz tego samego AS.

ASN (Autonomous System Number) to unikalny identyfikator AS.

Publiczne ASN z zakresu 1-64511 są nadawane przez RIR-y.

Peering to relacja sąsiedztwa BGP, nawiązywana na porcie TCP 179.

W sesji BGP każdy peer wysyła identyfikator AS i Router ID.

Dla eBGP numer AS sąsiada musi być różny od własnego – jeśli jest taki sam, sesja zostaje odrzucona (próba pętli).

W terminologii BGP rozróżnia się sesje eBGP (External BGP) i iBGP (Internal BGP). Sesja eBGP łączy routery należące do różnych systemów autonomicznych, natomiast sesja iBGP łączy routery wewnątrz tego samego AS. W sesji eBGP sąsiednie routery muszą mieć różne numery AS, a w iBGP – identyczne. ASN (Autonomous System Number) jest unikalnym identyfikatorem systemu autonomicznego w skali globalnej. Publiczne numery ASN z zakresu 1–64511 są przydzielane przez regionalne rejestry internetowe (RIR), natomiast numery prywatne 64512–65535 mogą być używane do swobodnej konfiguracji. Peering to relacja sąsiedztwa BGP nawiązywana pomiędzy dwoma routerami na bazie połączenia TCP na porcie 179. W sesji BGP każdy peer identyfikuje się numerem AS i identyfikatorem Router ID. Jeśli w sesji eBGP numery AS sąsiadów byłyby takie same, sesja zostałaby odrzucona jako próba pętli.

41/55 Atrybuty ścieżki BGP

AS Path, Local Preference, MED

AS Path to lista AS-ów na ścieżce.

Krótszy AS Path jest preferowany.

Niższy MED = wyższa preferencja.

MED to wskazówka dla sąsiedniego AS, które łącze preferować.

Local Preference określa preferencję wyjścia z AS – wyższa wartość = bardziej preferowana trasa.

Local Pref jest przekazywany tylko wewnątrz AS (iBGP).

Next Hop to adres IP następnego routera na ścieżce do sieci docelowej, który może być inny niż adres peera BGP.

Atrybuty BGP służą do podejmowania decyzji politycznych w routingu międzysystemowym. AS Path to lista AS-ów na ścieżce zapobiegająca pętlom, gdzie krótsza ścieżka jest preferowana. Local Preference określa preferowane wyjście z AS i jest przekazywany tylko wewnątrz AS przez iBGP.

Next Hop to adres następnego routera na ścieżce do sieci docelowej. MED to wskazówka dla sąsiedniego AS, które łącze preferować, gdzie niższa wartość jest lepsza.

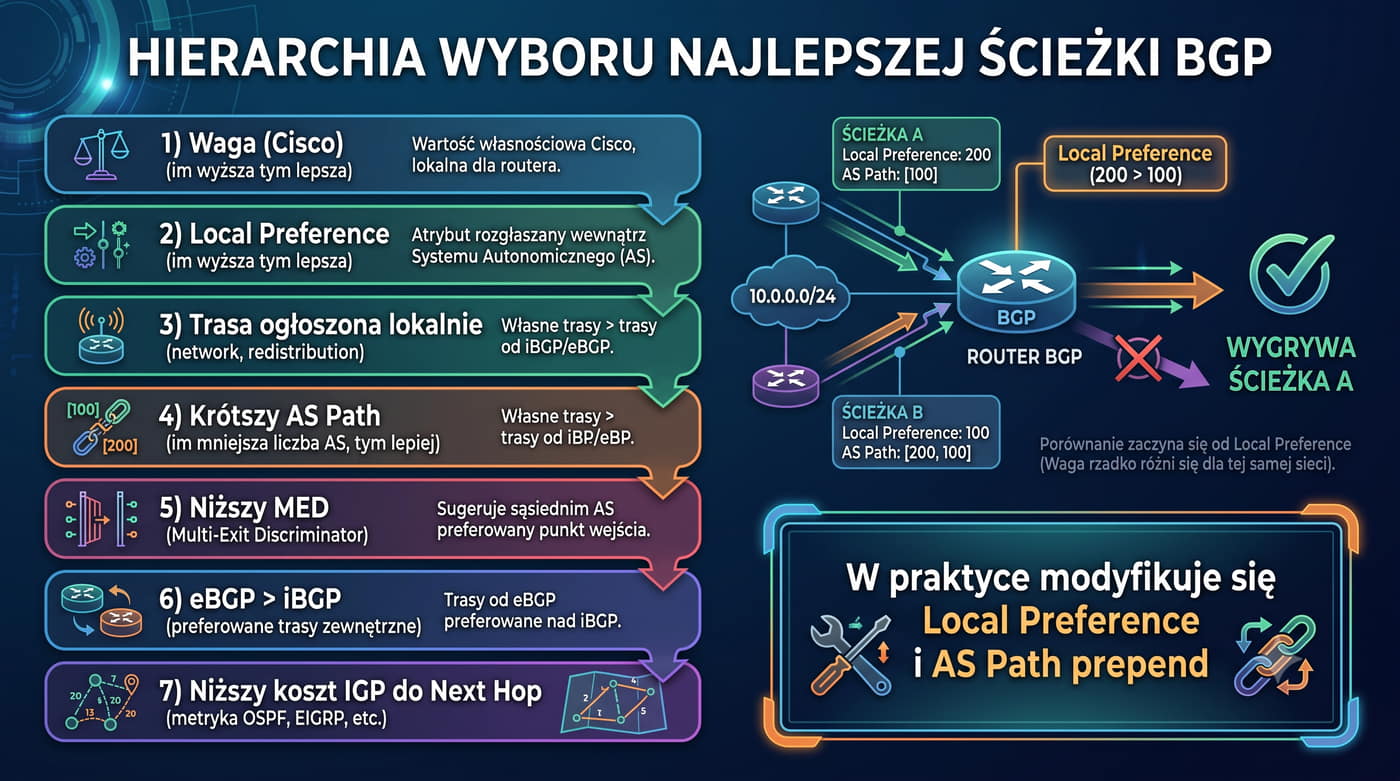
Wybór najlepszej ścieżki opiera się na hierarchii: waga, Local Pref, AS Path, MED, eBGP nad iBGP. W praktyce najczęściej modyfikuje się Local Pref i AS Path prepend.

42/55 Wybór najlepszej ścieżki BGP

Hierarchia kryteriów

Kryteria wyboru w BGP: 1) waga (Cisco), 2) Local Pref, 3) trasa ogłoszona lokalnie, 4) krótszy AS Path, 5) niższy MED, 6) eBGP > iBGP, 7) niższy koszt IGP do Next Hop.

W praktyce modyfikuje się Local Preference (ruch wychodzący) oraz AS Path prepend (zniechęcanie do ruchu przychodzącego).

MED jest rzadziej modyfikowany i służy do wskazywania preferowanego łącza wejściowego dla sąsiedniego AS.

Wybór najlepszej ścieżki BGP jest deterministyczny i podlega ściśle określonej hierarchii kryteriów. Na pierwszym miejscu uwzględnia się wagę (weight) właściwą dla urządzeń Cisco, następnie atrybut Local Preference, a po nim decyduje, czy trasa została ogłoszona lokalnie przez ten router. Kolejne kryteria to długość ścieżki AS, pochodzenie trasy, atrybut MED oraz typ łącza (eBGP przed iBGP).W praktyce wybór ścieżki w BGP jest modyfikowany przez zmianę Local Preference, co wpływa na ruch wychodzący z AS, oraz przez technikę AS Path Prepending, polegającą na wielokrotnym dołączaniu własnego numeru AS do ścieżki, co wydłuża ją i zniechęca sąsiadów do korzystania z danej trasy. Atrybut MED (Multi-Exit Discriminator) jest przekazywany wyłącznie bezpośredniemu sąsiadowi i pozwala wskazać mu preferowany punkt wejścia do naszego systemu autonomicznego. Niższa wartość MED oznacza wyższą preferencję trasy.

43/55 Zapobieganie pętlom w BGP

AS Path loop detection

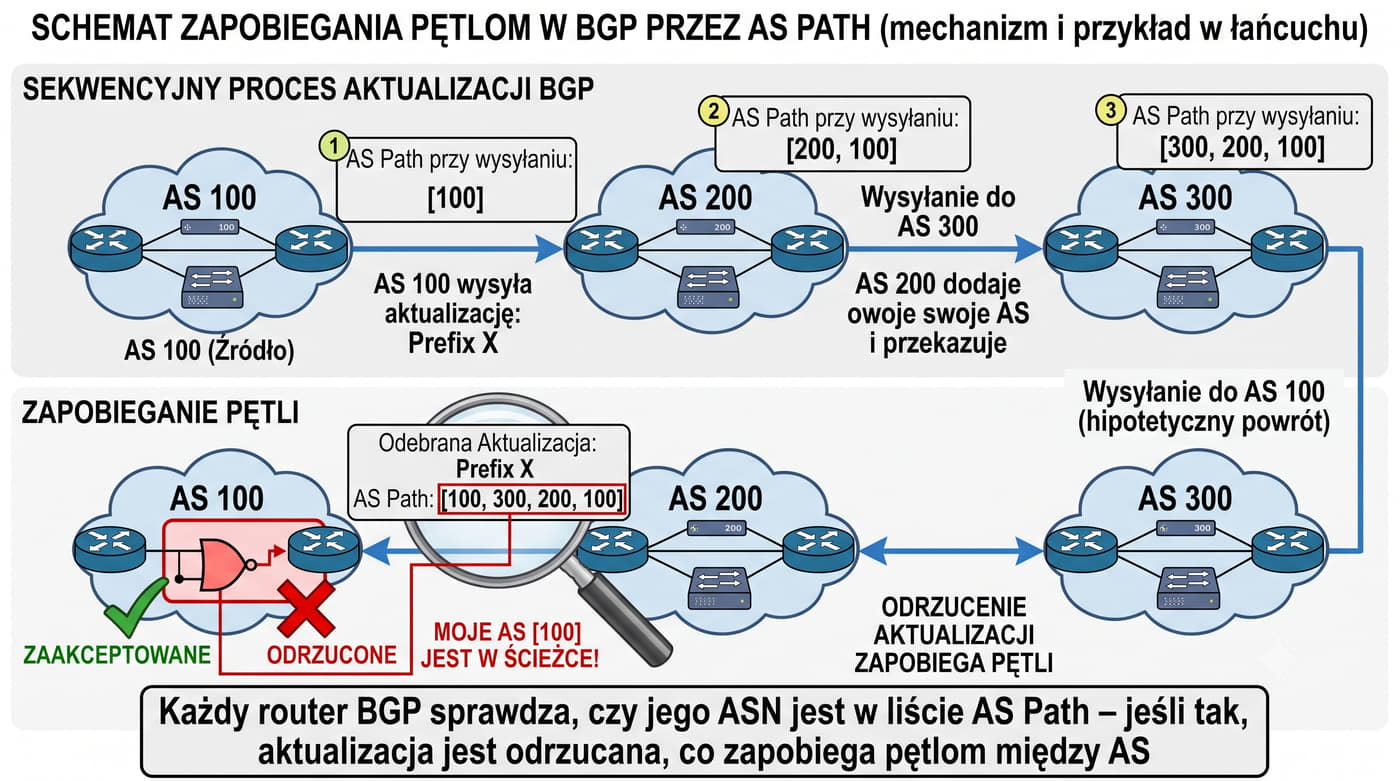
Router w AS 200 odbiera aktualizację z AS Path [100] i przed wysłaniem dalej dodaje własny ASN, tworząc AS Path [200, 100].

Router w AS 300 dodaje swój ASN, otrzymując AS Path [300, 200, 100].

Każdy router BGP sprawdza, czy jego ASN jest w liście AS Path.

Jeśli tak, aktualizacja jest odrzucana – to zapobiega pętlom między AS.

Przykład: AS 100 wysyła z AS Path [100].

Jeśli wróci do AS 100, AS Path = [100, 300, 200, 100] – odrzucone.

W iBGP trasa otrzymana od peera iBGP nie może być przekazana do innego peera iBGP (full mesh lub route reflector).

Zapobieganie pętlom jest kluczową funkcją protokołu BGP, realizowaną dzięki atrybutowi AS Path. Każdy router, który ogłasza trasę, dołącza do ścieżki swój numer AS, tworząc w ten sposób kolejno rosnący łańcuch AS-ów, przez które przeszła informacja o trasie. Gdy router BGP otrzymuje aktualizację, sprawdza, czy jego własny numer AS znajduje się na liście ścieżki AS Path. Jeśli tak się stanie, oznacza to, że trasa powróciła do punktu wyjścia, co świadczy o pętli, i aktualizacja jest odrzucana. Ten mechanizm nazywa się wykrywaniem pętli AS Path. Podobną rolę odgrywają reguły przekazywania: router, który poznał trasę iBGP, nie może ogłosić jej innemu routerowi iBGP. Ta zasada wymusza pełną siatkę sesji iBGP lub zastosowanie mechanizmu route reflectora lub federacji.

44/55 Konfiguracja BGP w Cisco IOS

Polecenia i weryfikacja

router bgp numer_AS włącza BGP. neighbor 10.0.0.2 remote-as 65001 określa sąsiada. network 192.168.1.0 mask 255.255.255.0 ogłasza sieć.

Sieć musi istnieć w tablicy routingu – BGP nie tworzy tras, a jedynie je ogłasza. redistribute umożliwia redystrybucję z innych protokołów.

show ip bgp pokazuje tablicę BGP. show ip bgp summary pokazuje stan sesji. show ip bgp neighbors 10.0.0.2 pokazuje szczegóły.

Konfiguracja BGP w Cisco IOS rozpoczyna się od polecenia router bgp numer_AS, które tworzy proces BGP. Polecenie neighbor 10.0.0.2 remote-as 65001 definiuje sąsiada eBGP i jego numer AS, a polecenie network 192.168.1.0 mask 255.255.255.0 dodaje sieć do ogłaszanych tras. Ważne jest, aby sieć ogłaszana poleceniem network istniała w tablicy routingu - BGP nie tworzy tras, a jedynie je ogłasza. Polecenie redistribute umożliwia wprowadzanie tras z innych protokołów do BGP, a polecenie neighbor x.x.x.x next-hop-self ustawia router jako następny skok dla tras iBGP.Do diagnostyki BGP służą polecenia show ip bgp, wyświetlające tablicę tras BGP, show ip bgp summary, pokazujące status sesji z sąsiadami, oraz show ip bgp neighbors 10.0.0.2, prezentujące szczegóły danej sesji. Polecenie clear ip bgp * resetuje sesje BGP.

45/55 Konfiguracja BGP w RouterOS

MikroTik RouterOS

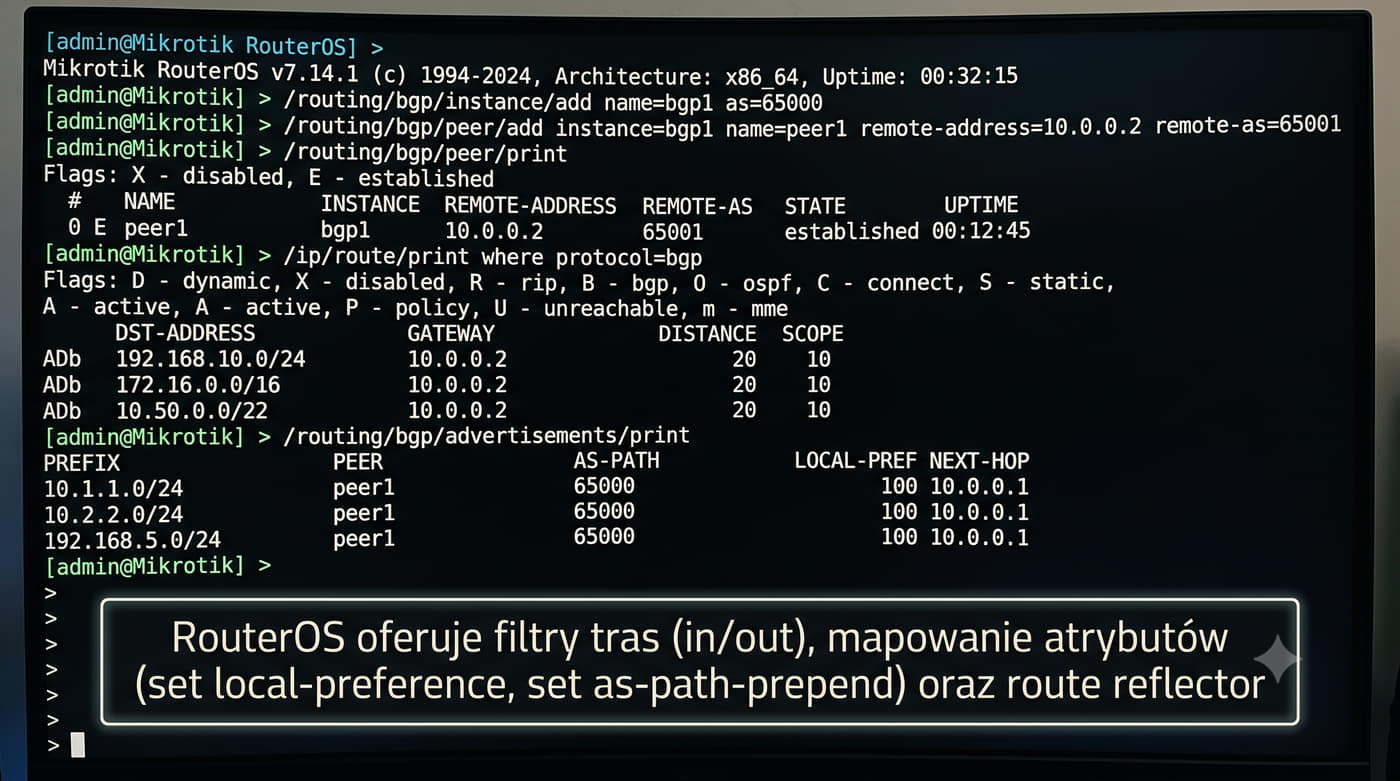
/routing bgp instance add name=bgp1 as=65000 tworzy instancję. /routing bgp peer add instance=bgp1 name=peer1 remote-address=10.0.0.2 remote-as=65001 dodaje sąsiada.

RouterOS oferuje filtry tras (in/out), mapowanie atrybutów (set local-preference, set as-path-prepend) oraz route reflector.

Weryfikacja: /ip route print where protocol=bgp, /routing bgp advertisements print, /routing bgp peer print.

Konfigurację BGP w RouterOS firmy MikroTik wykonuje się za pomocą poleceń w podmenu /routing bgp. W RouterOS v7 polecenie /routing bgp instance add name=bgp1 as=65000 tworzy instancję BGP o zadanym numerze AS, a polecenie /routing bgp connection add instance=bgp1 remote-addresses=10.0.0.2 remote-as=65001 definiuje sąsiada. RouterOS umożliwia precyzyjne sterowanie ruchem dzięki filtrom tras (route filters) definiowanym w języku routingu frr, a także przy użyciu polecenia /routing filter. Filtry pozwalają na modyfikację atrybutów BGP, takich jak Local Preference czy AS Path, oraz na odrzucanie niepożądanych tras. Weryfikacja konfiguracji odbywa się przez polecenia /routing bgp connection print, wyświetlające status sesji, oraz /ip route print, z którego można wyodrębnić trasy BGP poleceniem /ip route print where protocol=bgp.

46/55 iBGP i Route Reflector

Skalowalność BGP wewnątrz AS

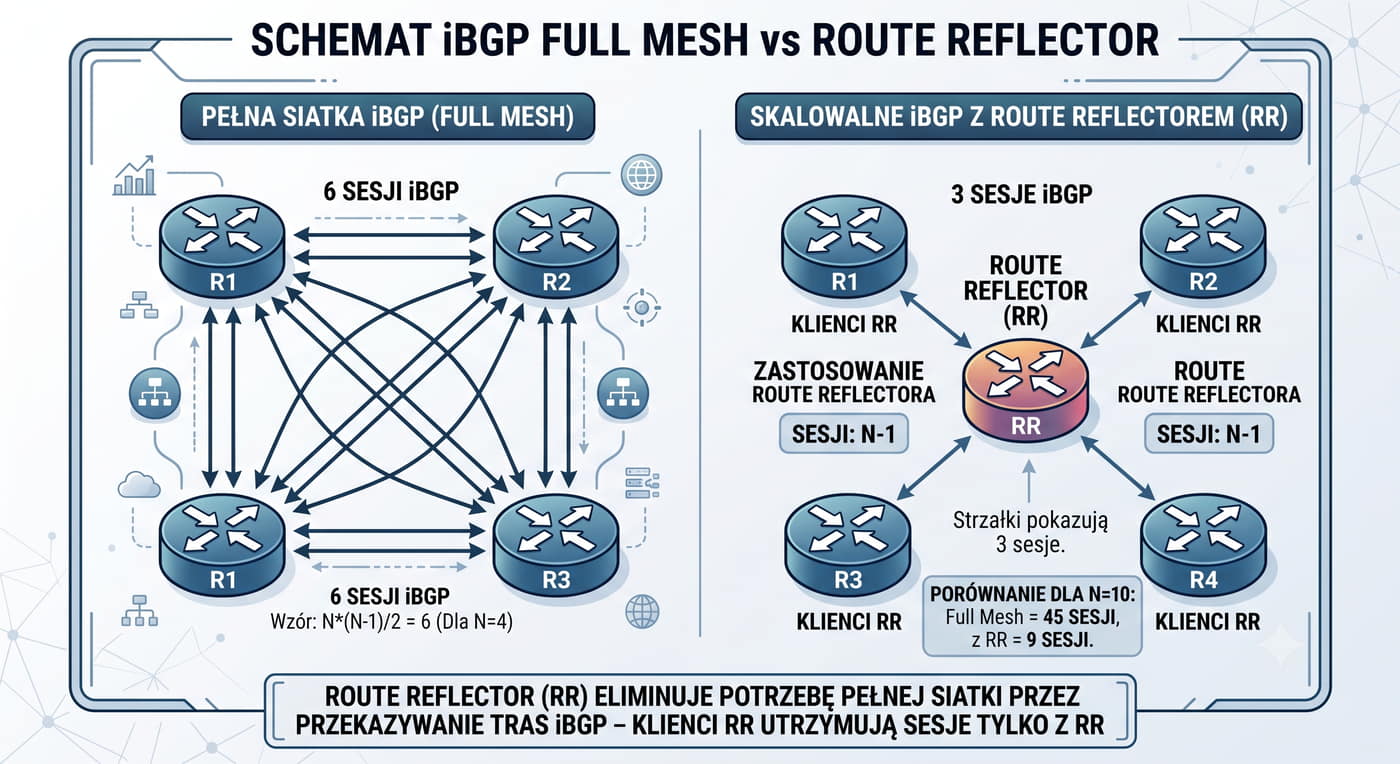
iBGP wymaga pełnej siatki połączeń.

Dla 10 routerów to 45 sesji.

Klienci RR utrzymują sesje tylko z RR.

Route Reflector (RR) eliminuje potrzebę pełnej siatki przez przekazywanie tras iBGP.

Dla N routerów potrzeba N*(N-1)/2 sesji.

Confederations to alternatywna metoda podziału AS na mniejsze sub-AS.

iBGP wymaga pełnej siatki połączeń N(N-1)/2 w AS, ponieważ trasa z iBGP nie może być przekazana do innego peera iBGP. Dla 10 routerów to 45 sesji, dla 20 aż 190. W dużych sieciach ISP jest to niepraktyczne.

Route Reflector rozwiązuje problem przez przekazywanie tras iBGP do klientów, eliminując konieczność pełnej siatki. Klienci RR utrzymują sesje tylko z RR, co znacznie zmniejsza liczbę sesji.

Confederations to alternatywna metoda dzieląca AS na sub-AS. Oba rozwiązania są stosowane w dużych sieciach operatorskich dla skalowalności BGP.

47/55 Polityka routingu w BGP

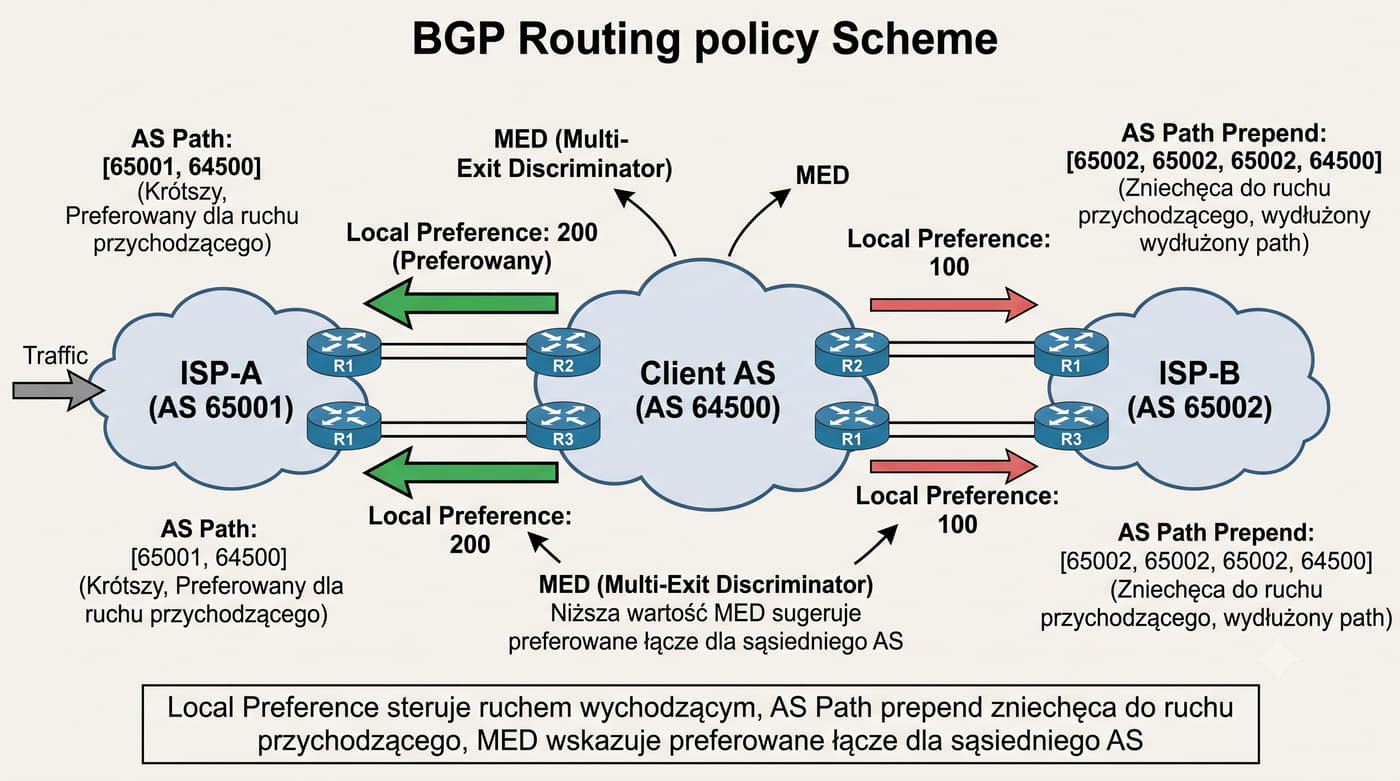
Local Pref, AS Path prepend, MED

Wyższa wartość = preferowane łącze.

Path = [100,100,100] zamiast [100].

MED wpływa na ruch przychodzący.

Local Preference steruje ruchem wychodzącym.

ISP ustawia Local Pref = 200 dla jednego ISP i 100 dla drugiego.

AS Path prepend dodaje własny AS wielokrotnie, wydłużając ścieżkę i zniechęcając innych ISP.

Niższy MED sugeruje sąsiadowi preferowane łącze.

MED jest przekazywany tylko do bezpośredniego sąsiada eBGP.

Polityka routingu w BGP pozwala administratorowi wpływać na przepływ ruchu zarówno wychodzącego, jak i przychodzącego do systemu autonomicznego. Ruch wychodzący jest sterowany głównie atrybutem Local Preference, a ruch przychodzący - atrybutem AS Path i techniką AS Path Prepending. Mechanizm AS Path Prepending polega na wielokrotnym dołączaniu numeru własnego AS do ścieżki w komunikatach BGP. Na przykład zamiast ścieżki [65000] ogłaszana jest ścieżka [65000 65000 65000], co wydłuża trasę i skłania sąsiadów w odległych AS do wyboru innej, krótszej ścieżki. Atrybut MED (Multi-Exit Discriminator) jest przekazywany wyłącznie bezpośredniemu sąsiadowi i umożliwia wskazanie preferowanego punktu wejścia do sieci. Niższa wartość MED sugeruje, że dane łącze jest preferowane. Podobnie Local Preference jest atrybutem wpływu na ruch wychodzący, regulowany w ramach własnego AS.

48/55 Multi-homing z BGP

Przykład praktyczny

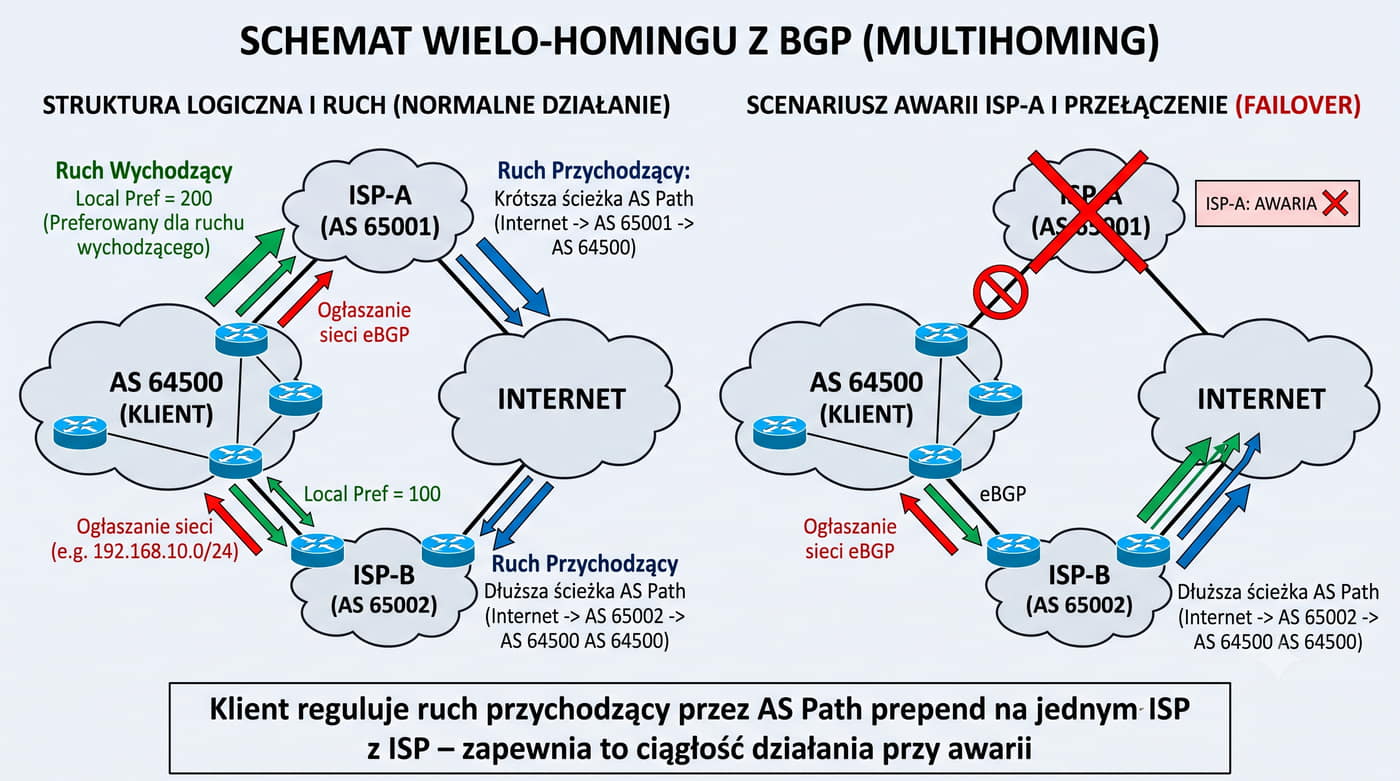
Klient ogłasza swoje sieci do obu ISP.

Ruch wychodzący preferuje ISP-A.

Ruch przychodzący zależy od AS Path.

Klient z AS 64500 łączy się z ISP-A (AS 65001) i ISP-B (AS 65002) przez eBGP.

Local Pref = 200 dla ISP-A, 100 dla ISP-B.

Przy awarii ISP-A, ruch przechodzi przez ISP-B.

Klient reguluje to przez AS Path prepend na jednym z ISP.

Przykład multi-homingu z protokołem BGP pokazuje sposób łączenia klienta z dwoma niezależnymi dostawcami usług internetowych (ISP). Klient z numerem AS 64500 nawiązuje sesje eBGP z ISP-A (AS 65001) i ISP-B (AS 65002), ogłaszając obu swoją sieć. Ruch wychodzący jest kontrolowany przez ustawienie różnych wartości Local Preference: wyższa wartość (np. 200) skieruje ruch przez ISP-A, natomiast niższa (np. 100) jest wartością domyślną dla ISP-B. W przypadku awarii ISP-A ruch będzie automatycznie kierowany przez ISP-B.Ruch przychodzący do sieci klienta jest regulowany przez techniki AS Path Prepending oraz deklarację MED. Przez powiększenie ścieżki AS do jednego z łączy można skłonić dostawców zewnętrznych do wyboru łącza alternatywnego. W ten sposób administrator klienta uzyskuje kontrolę nad ruchem w obu kierunkach.

49/55 Podsumowanie bloku IV

Protokół BGP

ASN = 16/32-bit.

iBGP wymaga pełnej siatki lub RR.

BGP = kręgosłup Internetu.
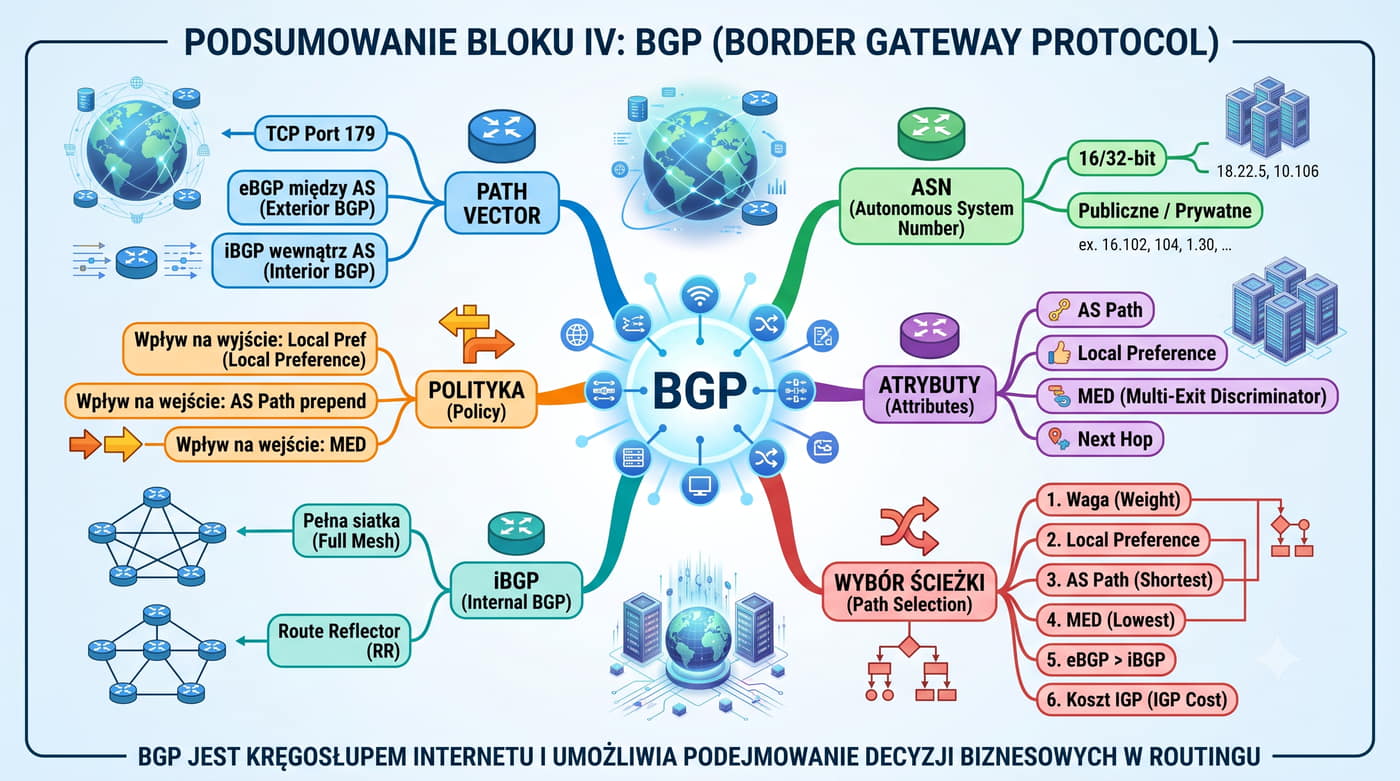
BGP to Path Vector na porcie TCP 179, łączy AS w Internecie. eBGP między AS, iBGP wewnątrz AS.

Atrybuty: AS Path, Local Preference, MED, Next Hop.

Hierarchia: waga, Local Pref, AS Path, MED, eBGP > iBGP.

Polityka: Local Pref, AS Path prepend, MED.

Blok IV podsumowuje BGP jako protokół wektora ścieżki na TCP 179, eBGP między AS, iBGP wewnątrz AS. Wybór na podstawie wagi, Local Pref, AS Path, MED, eBGP nad iBGP. iBGP wymaga full mesh lub Route Reflector.

Atrybuty: AS Path zabezpiecza przed pętlami przez sprawdzanie własnego ASN na liście, Local Pref określa wyjście z AS, MED wskazuje wejście. BGP to kręgosłup Internetu łączący tysiące AS.

Polityka BGP umożliwia decyzje biznesowe przez modyfikacje atrybutów. Znajomość BGP jest niezbędna dla administratorów sieci operatorskich i dużych przedsiębiorstw.

50/55 Tabela porównawcza RIP, OSPF, BGP

Zestawienie protokołów

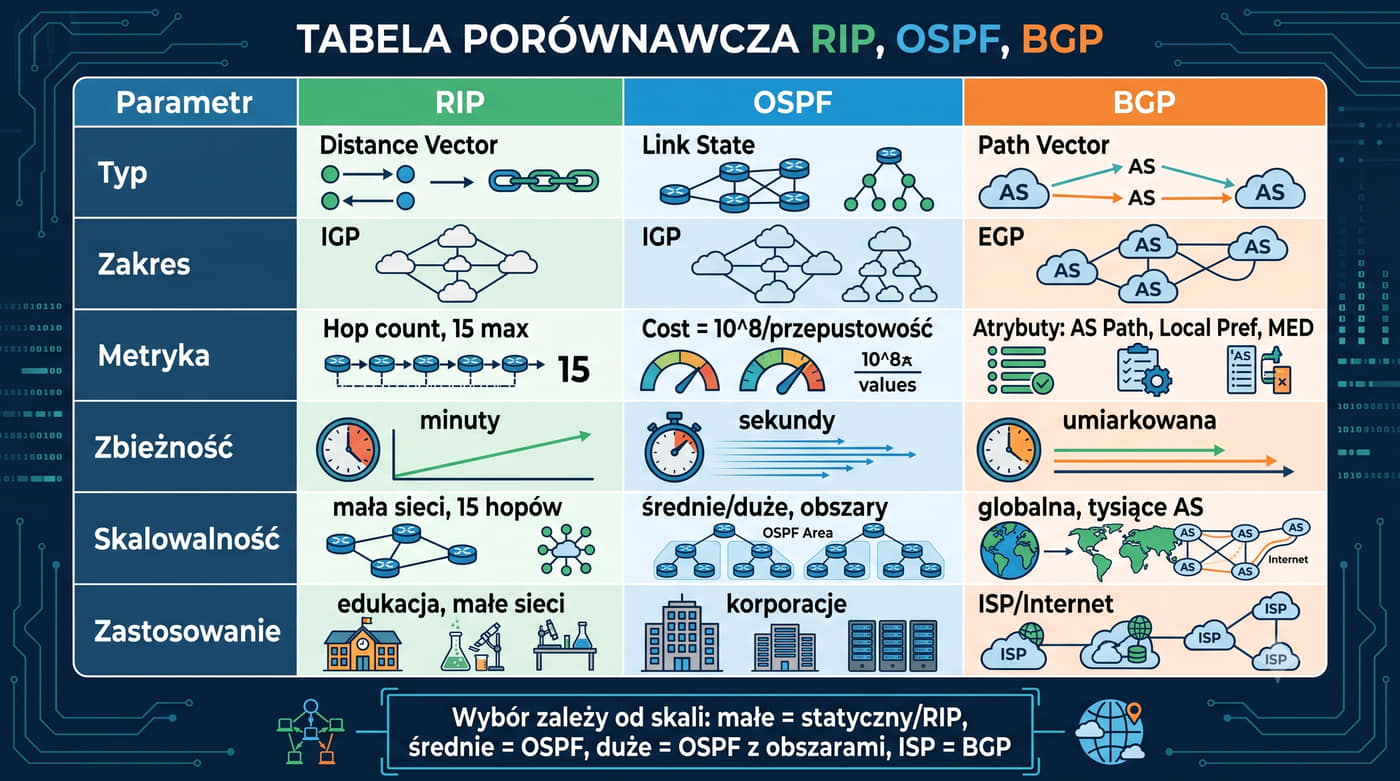
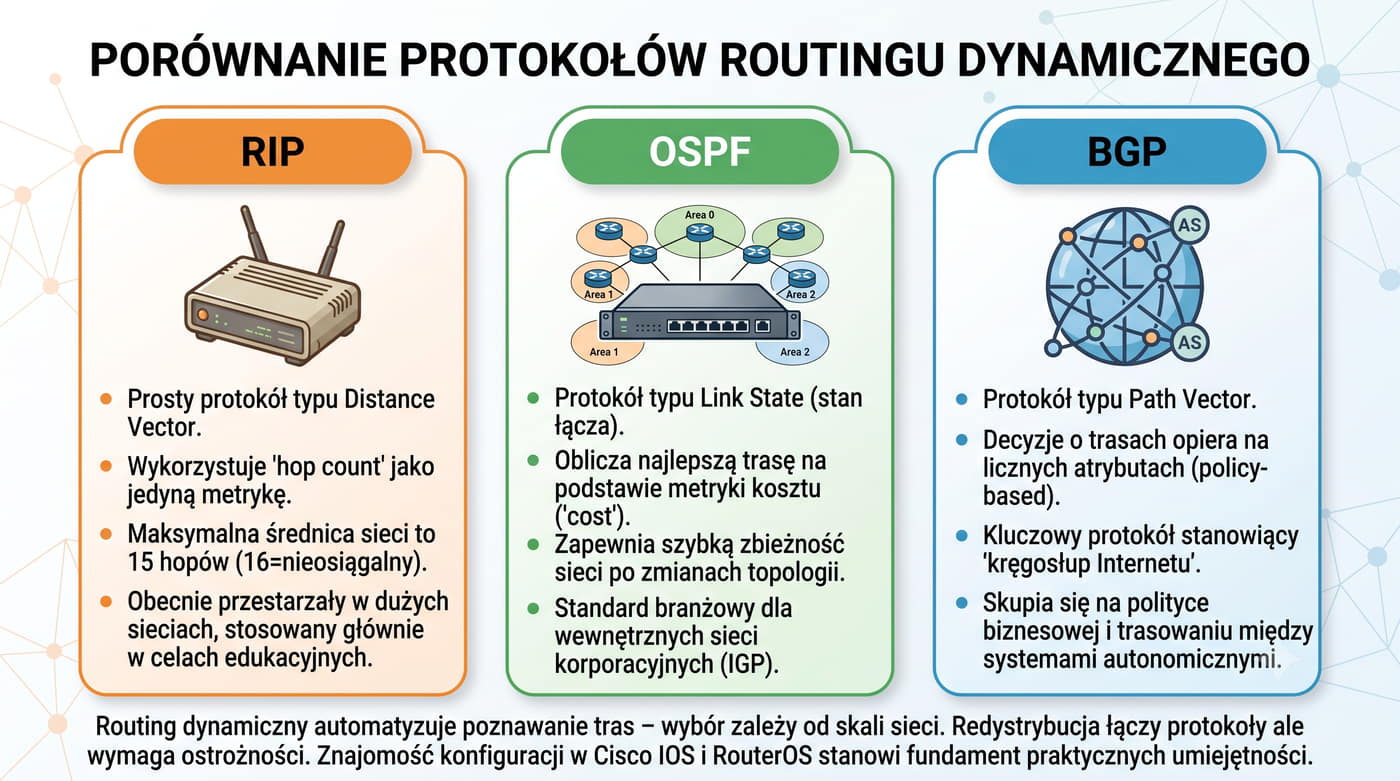
RIP: Distance Vector, IGP, hop count, zbieżność w minutach, max 15 hopów, dla małych sieci.

OSPF: Link State, IGP, koszt, zbieżność w sekundach, obszary, standard w firmach.

BGP: Path Vector, EGP, atrybuty, zbieżność umiarkowana, globalny Internet.

RIP - edukacja, OSPF - korporacje, BGP - ISP.

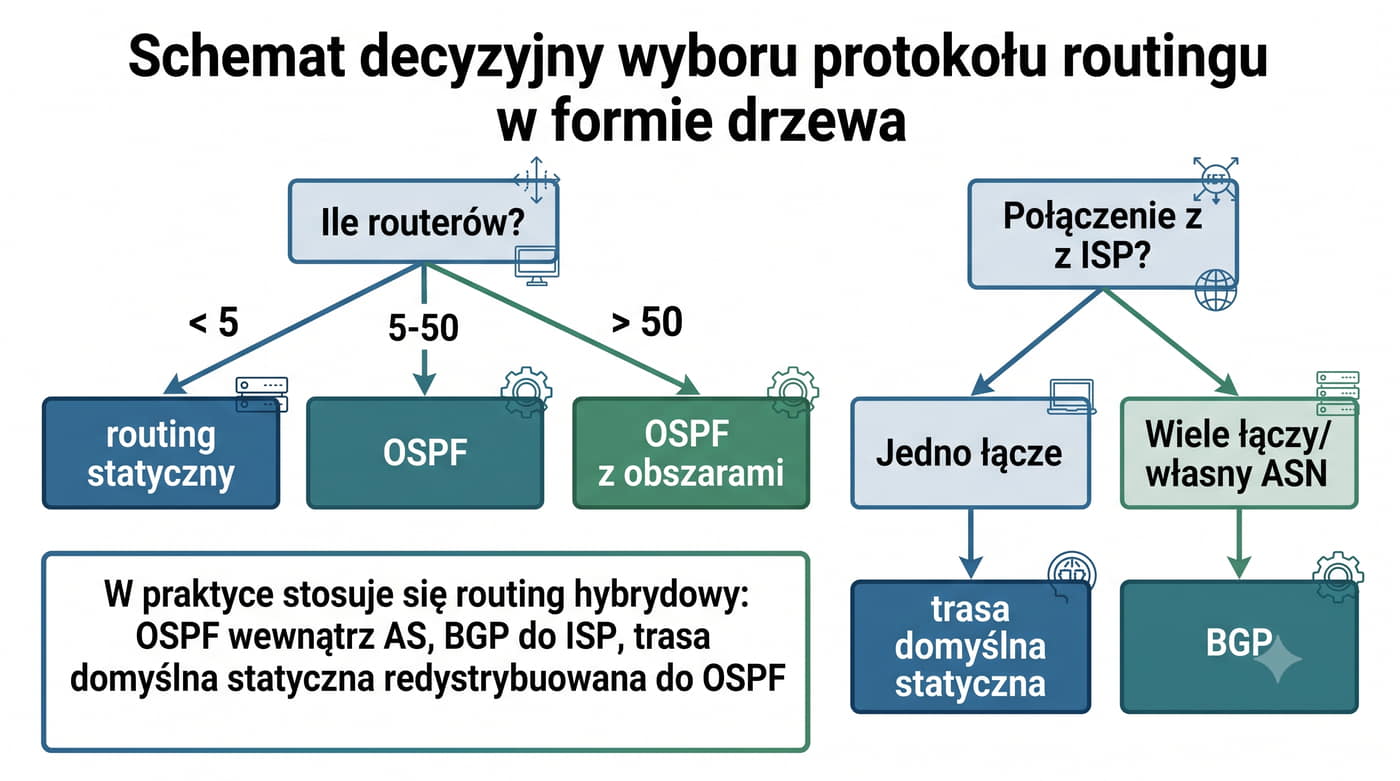
Wybór zależy od skali: małe = statyczny/RIP, średnie = OSPF, duże = OSPF z obszarami, ISP = BGP.

Porównanie trzech protokołów routingu dynamicznego pokazuje, że każdy z nich jest dostosowany do innego obszaru zastosowań w sieciach IP. RIP jest najprostszym protokołem wektora odległości z metryką hop count, przeznaczonym do małych sieci, o zbieżności liczonej w minutach i maksymalnym zasięgu 15 przeskoków. OSPF reprezentuje protokoły stanu łącza, używa metryki kosztu opartej na przepustowości łącza, oferuje szybką zbieżność w sekundach i skalowalność dzięki podziałowi na obszary. Jest standardowym protokołem IGP w średnich i dużych sieciach korporacyjnych. BGP jest protokołem wektora ścieżki stosowanym do łączenia systemów autonomicznych w Internecie. Jego metryka opiera się na atrybutach, a zbieżność jest umiarkowana, licząc od kilku sekund do minut. Podsumowując: RIP jest stosowany w celach edukacyjnych, OSPF w korporacjach, a BGP u operatorów ISP.

51/55 Wybór protokołu routingu

Kryteria decyzyjne

< 5 routerów: routing statyczny.

ISP: BGP.

5-50 routerów: OSPF. > 50: OSPF z obszarami.

Jedno łącze do ISP: trasa domyślna statyczna.

W praktyce hybryda: OSPF wewnątrz AS, BGP do ISP, trasa domyślna statyczna redystrybuowana do OSPF.

Najlepsze podejście zależy od analizy wymagań biznesowych i technicznych.

Wybór protokołu routingu powinien być poprzedzony analizą wielkości sieci, wymagań dotyczących zbieżności oraz umiejętności personelu. W sieciach mniejszych niż 5 routerów wystarcza routing statyczny lub protokół RIP, natomiast w sieciach liczących od 5 do 50 routerów naturalnym wyborem jest OSPF.Dla sieci liczących ponad 50 routerów zaleca się OSPF z podziałem na obszary, natomiast w przypadku łączenia z dostawcami Internetu stosuje się protokół BGP. Jeśli organizacja jest podłączona do ISP jednym łączem, wystarczającą trasa domyślna statyczna z redystrybucją do protokołów wewnętrznych. W praktyce częste jest rozwiązanie hybrydowe: protokół OSPF działający wewnątrz systemu autonomicznego obsługuje routing wewnętrzny, protokół BGP zapewnia łączność z sąsiednimi operatorami, a trasa domyślna statyczna jest redystrybuowana do OSPF. Ostateczny wybór powinien uwzględniać wymagania biznesowe i techniczne.

52/55 Redystrybucja tras

Między protokołami routingu

ASBR pobiera trasy z jednego protokołu i ogłasza je w innym.

Wymaga ostrożności ze względu na ryzyko pętli.

Cisco IOS: router ospf 1 z redistribute rip subnets oraz router rip z redistribute ospf 1 metric 2.

RouterOS: /routing ospf instance set redistribute=connected,static,rip.

Redystrybucja tras to proces wprowadzania informacji o niejawnych trasach pochodzących z jednego źródła routingu do innego. W praktyce dotyczy przenoszenia tras między różnymi protokołami, na przykład między OSPF a BGP, lub między routem a trasami statycznymi. Realizuje to router ASBR w OSPF.Redystrybucja wymaga ostrożności, ponieważ może prowadzić do powstania pętli routingu, gdy trasy są przekazywane między protokołami w obu kierunkach. Aby temu zapobiec, stosuje się odpowiednie parametry metryczne, tagi tras oraz filtry. W Cisco IOS redystrybucję wykonuje się poleceniami router ospf 1 redistribute rip subnets oraz router rip redistribute ospf 1 metric 2. W RouterOS redystrybucję konfiguruje się przez /routing ospf instance set redistribute=connected,static,rip, dzięki czemu trasy sieci lokalnych i statycznych są ogłaszane do OSPF.

53/55 Pytania kontrolne

Bloki I–IV

1. Czym różni się protokół IGP od EGP? Podaj przykłady każdej kategorii.

2. Jak działa protokół distance vector na przykładzie RIP? Jakie ma ograniczenia?

3. Na czym polega działanie OSPF? Czym są obszary i algorytm Dijkstry?

4. W jaki sposób BGP zapobiega pętlom routingu? Wyjaśnij rolę atrybutu AS Path.

5. Porównaj atrybuty AS Path i Local Preference w BGP – jakie są ich funkcje?

6. Jakie czynniki należy uwzględnić przy wyborze protokołu routingu?

7. Na czym polega redystrybucja tras między protokołami? Jakie niesie zagrożenia?

8. Wyjaśnij różnicę między metryką a odległością administracyjną (AD).

Pytania kontrolne w blokach I-IV sprawdzają znajomość najważniejszych koncepcji routingu dynamicznego. Należy umieć wyjaśnić różnicę między protokołami IGP i EGP oraz wskazać przykłady każdej kategorii, a także opisać zasady działania protokołu wektora odległości na przykładzie RIP wraz z jego ograniczeniami. Ważne jest zrozumienie mechanizmu działania OSPF, w tym roli obszarów i algorytmu Dijkstry, oraz sposobu, w jaki BGP zapobiega pętlom routingu, wykorzystując atrybut AS Path. Należy także porównać funkcje atrybutów AS Path i Local Preference oraz wskazać czynniki decydujące o wyborze protokołu routingu. Pojęcia metryki i odległości administracyjnej (AD) należy rozumieć jako dwa różne mechanizmy: metryka porównuje trasy pochodzące z tego samego protokołu, natomiast AD rozstrzyga konflikty między trasami pochodzącymi z różnych źródeł.

54/55 Podsumowanie

Routing dynamiczny – najważniejsze wnioski

RIP prosty, ale przestarzały.

OSPF to standard IGP.

BGP to protokół Internetu.
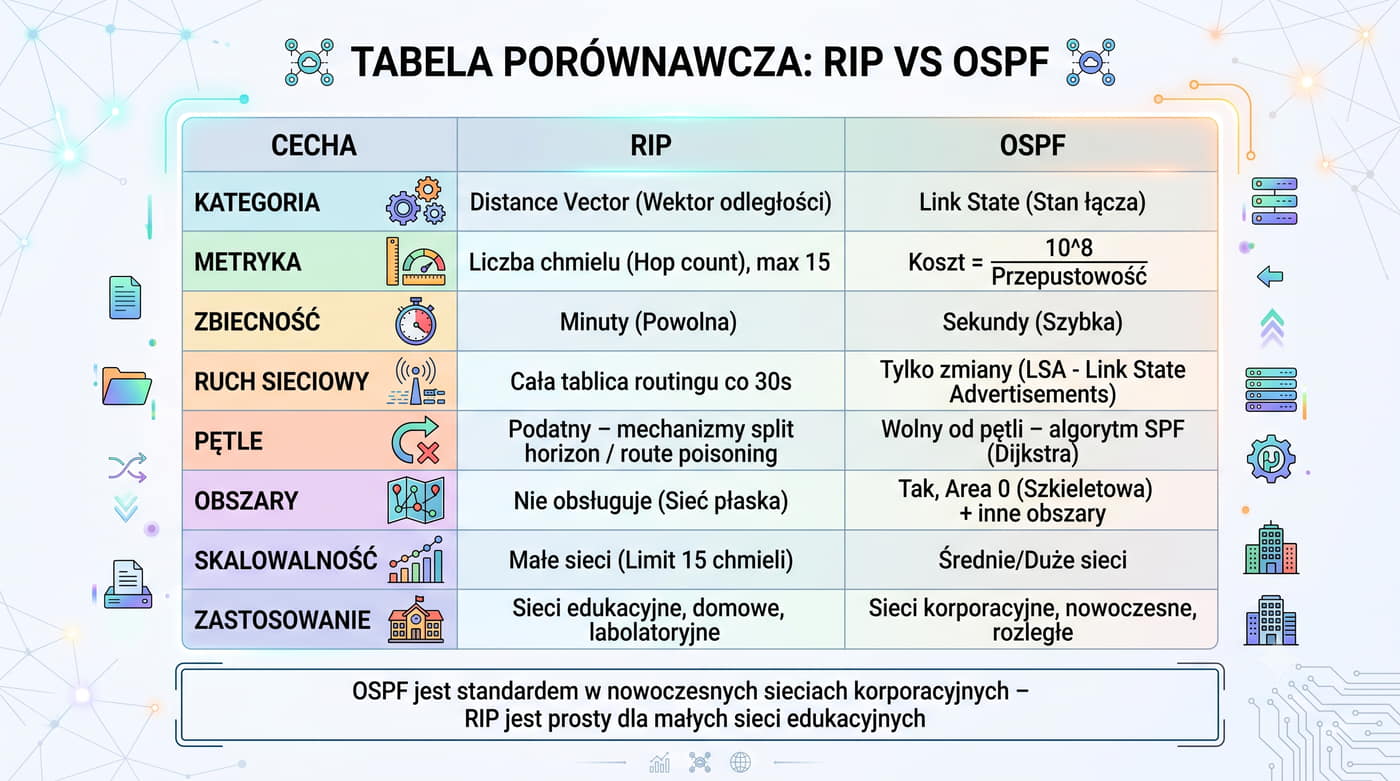
Wybór zależy od skali sieci.

Routing dynamiczny automatyzuje proces poznawania tras w sieci.

Redystrybucja łączy protokoły routingu, ale wymaga ostrożności ze względu na ryzyko pętli.

Znajomość konfiguracji w Cisco IOS i RouterOS stanowi fundament praktycznych umiejętności.

Prezentacja przedstawiła trzy fundamentalne protokoły routingu dynamicznego: RIP, OSPF i BGP. RIP jest najprostszym protokołem wektora odległości, przestarzałym i przeznaczonym głównie do celów edukacyjnych. OSPF jest standardowym protokołem stanu łącza dla sieci korporacyjnych, a BGP stanowi kręgosłup Internetu. Wybór odpowiedniego protokołu zależy od skali sieci i wymagań dotyczących zbieżności. Automatyzacja procesu poznawania tras, jaką zapewnia routing dynamiczny, jest niezbędna w nowoczesnych sieciach o zmiennej topologii. Redystrybucja tras łączy różne protokoły, ale wymaga ostrożności ze względu na ryzyko pętli. Praktyczne umiejętności konfiguracji w systemach Cisco IOS i RouterOS stanowią fundament pracy administratora sieci. Zarządzanie metrykami, odległościami administracyjnymi, obszarami OSPF i atrybutami BGP to kluczowe kompetencje w projektowaniu i utrzymaniu niezawodnych sieci.
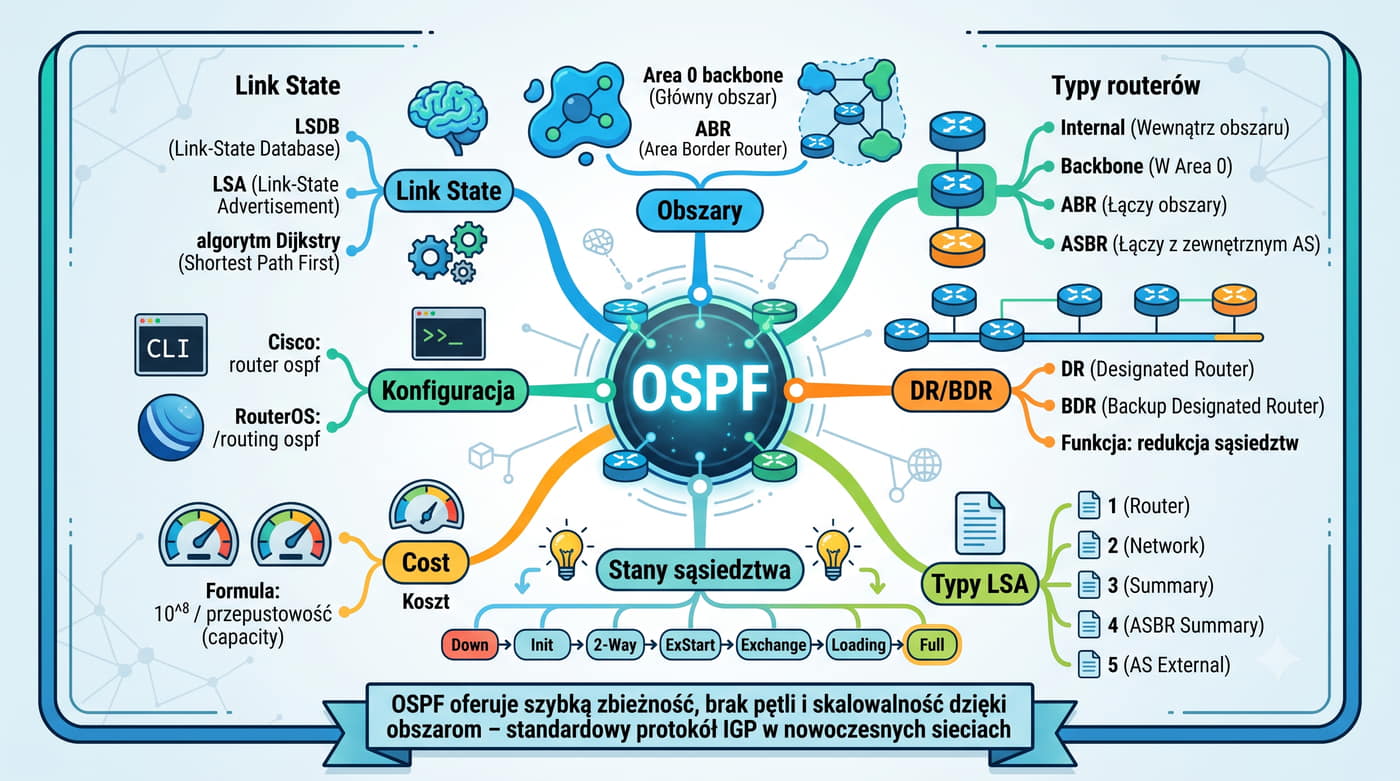
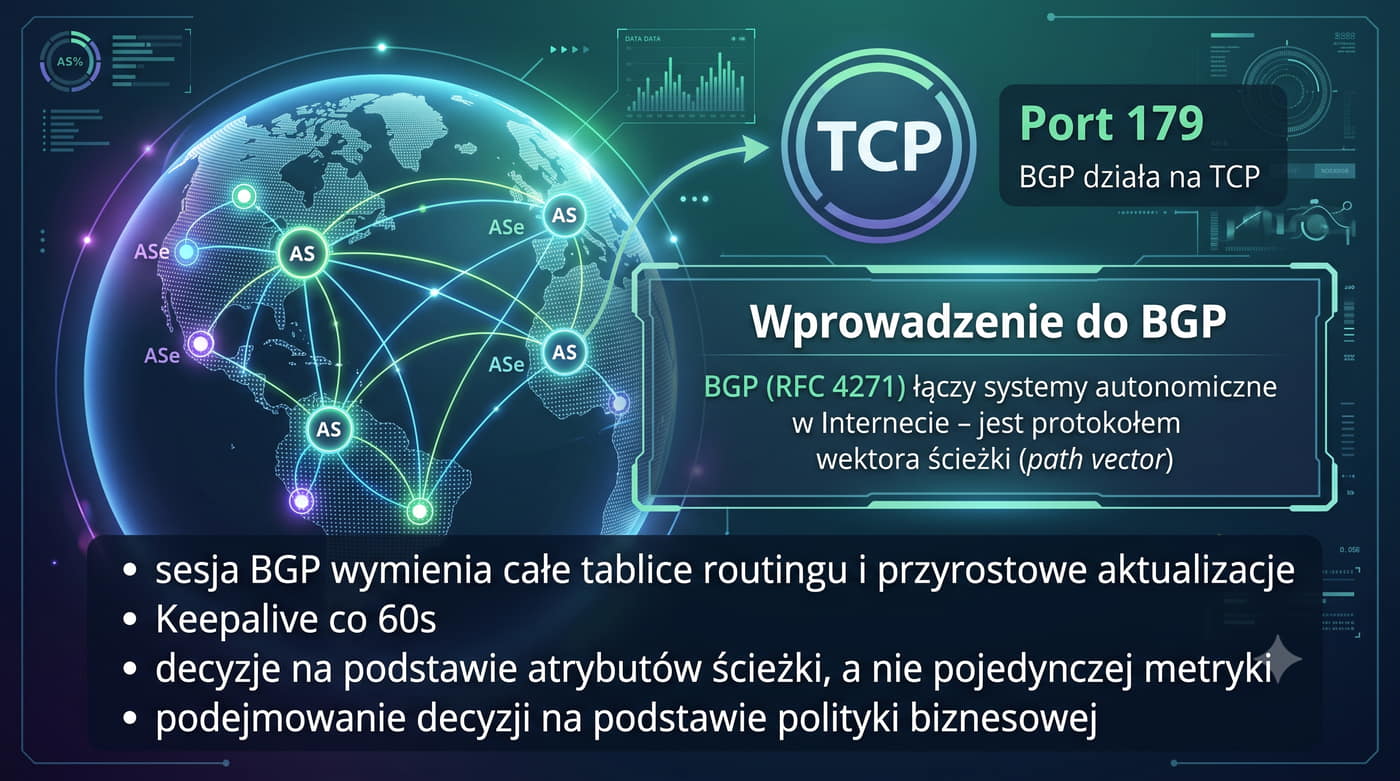
55/55 Koniec prezentacji

Routing dynamiczny – RIP, OSPF, BGP

Dziękuję za uwagę.

Prezentacja przedstawiła trzy fundamentalne protokoły routingu dynamicznego: RIP (wektor odległości), OSPF (stan łącza) i BGP (wektor ścieżki).

Każdy z nich ma unikalne cechy i zastosowanie – od prostych sieci edukacyjnych po globalny Internet.

Routing dynamiczny automatyzuje poznawanie tras i jest kluczowy w nowoczesnych sieciach.

Znajomość konfiguracji w Cisco IOS i RouterOS, zrozumienie metryk, odległości administracyjnej, obszarów OSPF i atrybutów BGP są niezbędne dla każdego administratora sieci.

Zachęcam do praktycznych ćwiczeń z konfiguracji protokołów routingu na symulatorach (Packet Tracer, EVE-NG, GNS3) oraz na rzeczywistych urządzeniach Cisco i MikroTik.

Prezentacja przedstawiła trzy fundamentalne protokoły routingu dynamicznego: RIP jako wektor odległości, OSPF jako stan łącza i BGP jako wektor ścieżki. Każdy protokół ma unikalne cechy i zastosowanie od małych sieci edukacyjnych po globalny Internet.

OSPF oferuje szybką zbieżność i skalowalność przez obszary jako standard IGP. BGP umożliwia łączenie AS z decyzjami politycznymi jako kręgosłup Internetu.

Umiejętności konfiguracji na Cisco IOS i RouterOS są niezbędne dla administratora sieci. Zaleca się regularne ćwiczenia na symulatorach Packet Tracer, EVE-NG i GNS3.