1/55 Ethernet przełączany – przełączniki sieciowe

Prezentacja dotyczy przejścia od modelu współdzielonego medium do sieci przełączanych, co stanowi jeden z najważniejszych przełomów w historii sieci LAN.

W dalszej części przedstawione zostaną mechanizmy uczenia się adresów, tablica przekazywania (FDB), metody przełączania (Store-and-Forward, Cut-Through, Adaptive Switching) oraz zagadnienia związane z autonegocjacją, dupleksem i parametrami interfejsów Ethernet.

Każdy blok teoretyczny zostanie uzupełniony przykładami konfiguracji w systemach Cisco IOS oraz MikroTik RouterOS, co pozwoli studentom na praktyczne zastosowanie zdobytej wiedzy.
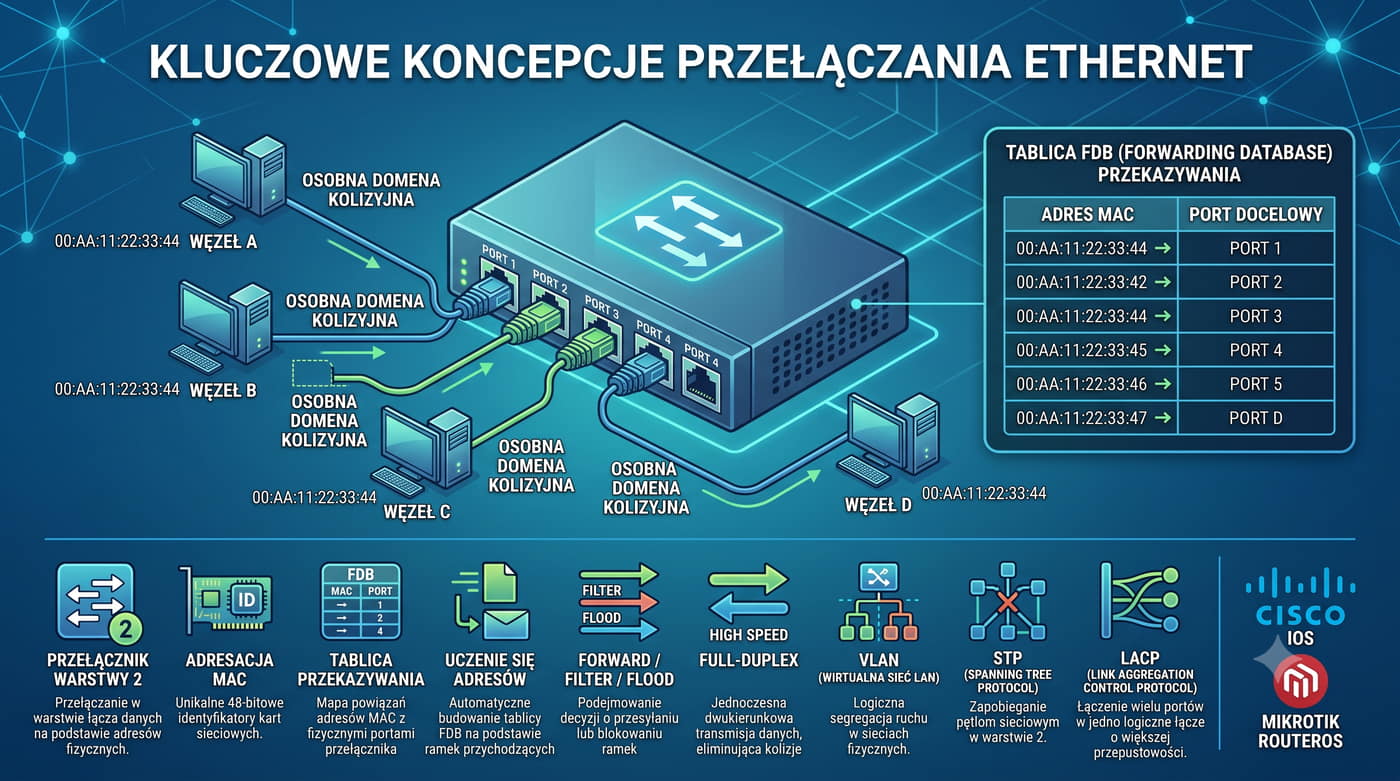
Przełączniki Ethernet stanowią fundament współczesnych sieci lokalnych, wypierając całkowicie starsze koncentratory (huby). Ich podstawowym zadaniem jest analiza adresów MAC w ramkach Ethernet i kierowanie ruchem wyłącznie do portu, przy którym znajduje się odbiorca. Dzięki temu eliminowane są kolizje, które w sieciach z hubem uniemożliwiały równoległe transmisje. Przełącznik można postrzegać jako inteligentne urządzenie warstwy drugiej, które uczy się topologii sieci w sposób dynamiczny. Proces uczenia polega na zapamiętywaniu, z którego portu pochodzi dany adres źródłowy. Informacje te przechowywane są w tablicy przekazywania zwanej Forwarding Database.

Nowoczesne przełączniki obsługują zaawansowane funkcje, takie jak segmentacja VLAN, priorytetyzacja ruchu QoS czy protokoły nadmiarowości (STP, LACP). Ich architektura sprzętowa opiera się na układach ASIC, które potrafią przetwarzać miliony ramek na sekundę. Decyzja o przekazaniu ramki zapada w czasie rzeczywistym, bez angażowania procesora głównego, co gwarantuje przewidywalne opóźnienia. W praktyce przełącznik Ethernet jest urządzeniem krytycznym dla wydajności każdej sieci LAN, a jego poprawna konfiguracja stanowi podstawę egzaminów zawodowych w branży IT.

2/55 Streszczenie

Przełączanie opiera się na trzech podstawowych mechanizmach:

1. Nauka adresów MAC: Przełącznik zapamiętuje mapowanie adresów MAC (źródło → port) w tablicy CAM (Content-Addressable Memory).

2. Przekazywanie ramek: Ramki są przesyłane wyłącznie do portu, do którego podłączony jest host docelowy.

3. Obsługa ruchu rozgłoszeniowego: Ramki z adresem broadcast/multicast są kopiowane do wszystkich portów (z wyjątkiem portu źródłowego).

Dodatkowo, przełączniki implementują protokoły takie jak Spanning Tree Protocol (STP) zapobiegające pętlom oraz VLAN (Virtual LAN) segmentujące sieć logicznie. Modele przetwarzania ramek obejmują store-and-forward (dokładne, ale wolniejsze) i cut-through (szybsze, ale podatne na błędy).

Mechanizmy przełączania omówione w tej prezentacji obejmują trzy fundamentalne procesy: uczenie adresów MAC, przekazywanie ramek oraz obsługę ruchu rozgłoszeniowego. Uczenie polega na pasywnym analizowaniu adresów źródłowych w ramkach przychodzących i wiązaniu ich z numerem portu. Przekazywanie (forwarding) odbywa się na podstawie adresu docelowego – jeśli przełącznik zna lokalizację odbiorcy, ramka trafia wyłącznie do odpowiedniego portu. W przypadku ruchu broadcast lub nieznanego adresu unicast przełącznik stosuje flooding, czyli powielenie ramki na wszystkie porty poza źródłowym.

W codziennej praktyce inżynierskiej kluczowe znaczenie ma zrozumienie, w jaki sposób przełącznik buduje swoją tablicę adresową i jak podejmuje decyzje o filtrowaniu. Dodatkowo istotne są zagadnienia związane z metodą przełączania (store-and-forward, cut-through) oraz wpływem tych metod na opóźnienia i niezawodność transmisji. Prezentacja przedstawia również narzędzia konfiguracyjne w systemach Cisco IOS oraz MikroTik RouterOS, które pozwalają na praktyczne sterowanie pracą urządzenia.

Warto również zwrócić uwagę na fakt, że przełączniki różnią się między sobą pojemnością tablicy adresów MAC oraz obsługiwanymi metodami przełączania. Przełączniki klasy korporacyjnej obsługują setki tysięcy wpisów, podczas gdy modele podstawowe ograniczają się do kilku tysięcy. Różnice te mają bezpośredni wpływ na skalowalność sieci i jej zdolność do obsługi rosnącej liczby urządzeń.

4/55 Ograniczenia modelu współdzielonego

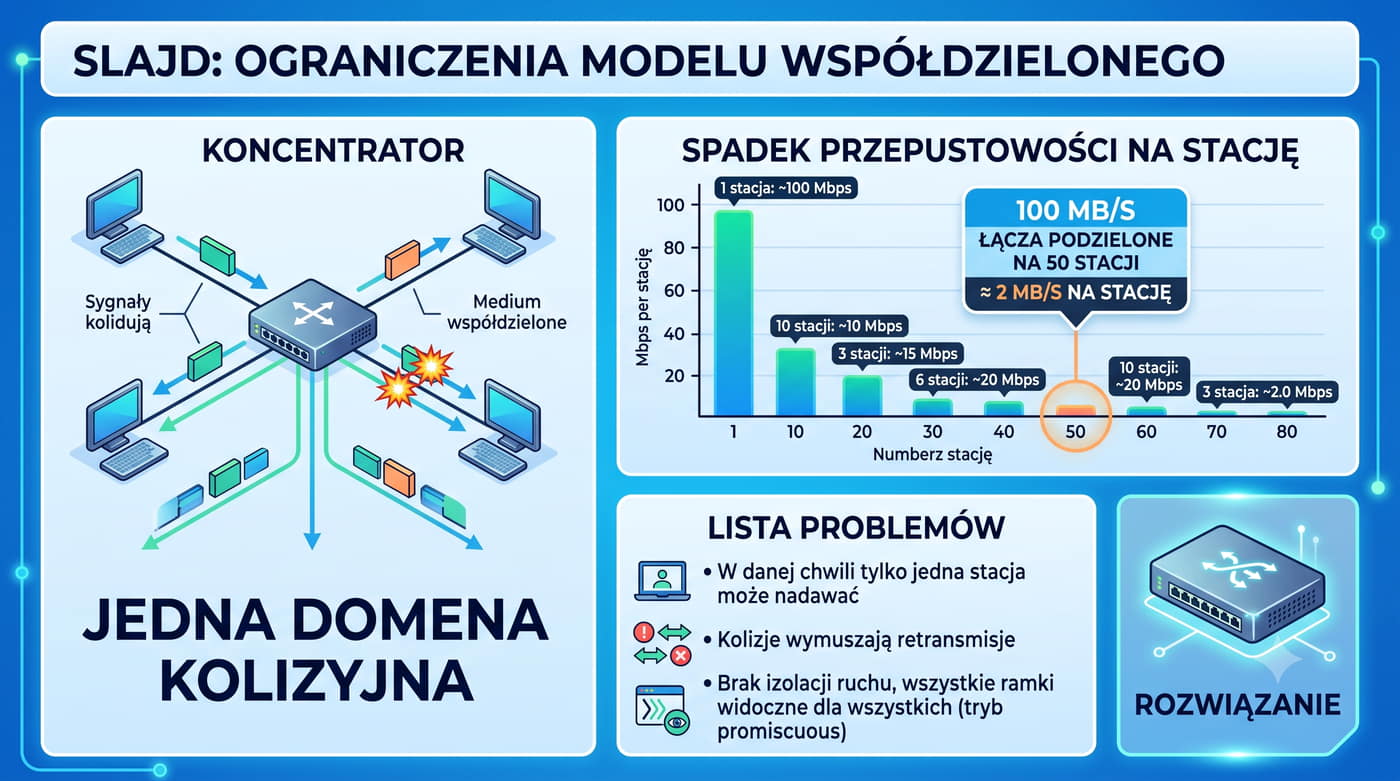
Huby, działające w oparciu o CSMA/CD (Carrier Sense Multiple Access with Collision Detection), charakteryzują się poważnymi wadami:

  • Domena kolizyjna: Wszystkie porty huba tworzą jedną domenę, co prowadzi do chaotycznych kolizji przy wielu aktywnych hostach.
  • Broadcast storms: Nieograniczone kopiowanie ramek rozgłoszeniowych może sparaliżować sieć.
  • Niska przepustowość: Mechanizm CSMA/CD jest nieefektywny w gęstych sieciach (np. 10Base5, 10Base2).
  • Brak skalowalności: Dodanie nowego huba zwiększa rozmiar domeny kolizyjnej. Przełączniki całkowicie eliminują te problemy poprzez segmentację sieci na mniejsze domeny przełączania.

W sieciach opartych na koncentratorach (hubach) wszystkie urządzenia współdzielą to samo pasmo, a mechanizm CSMA/CD wymaga nasłuchiwania medium przed rozpoczęciem transmisji. W miarę wzrostu liczby hostów w jednej domenie kolizyjnej, prawdopodobieństwo kolizji rośnie wykładniczo, co drastycznie ogranicza efektywną przepustowość. Przy 30–40 aktywnych stacjach w segmencie 10BASE-T rzeczywista przepustowość może spaść poniżej 30% wartości nominalnej. Problem ten dotyczył szczególnie sieci o topologii magistrali (10BASE5, 10BASE2), gdzie uszkodzenie pojedynczego odcinka kabla paraliżowało pracę całego segmentu.

Kolejnym ograniczeniem był brak izolacji ruchu – w sieci z hubem każda stacja mogła odbierać wszystkie ramki przesyłane w segmencie, co stwarzało poważne zagrożenie bezpieczeństwa. Narzędzia takie jak Wireshark umożliwiały łatwe przechwytywanie ruchu (sniffing) bez konieczności fizycznego dostępu do urządzenia ofiary. Ponadto huby nie wspierały pracy w trybie full-duplex, ponieważ mechanizm CSMA/CD wymagał ciągłego monitorowania medium. Wszystkie te ograniczenia sprawiły, że sieci współdzielone stały się wąskim gardłem rozwoju aplikacji klient-serwer w latach 90. XX wieku.

5/55 Most (bridge) – pierwszy krok

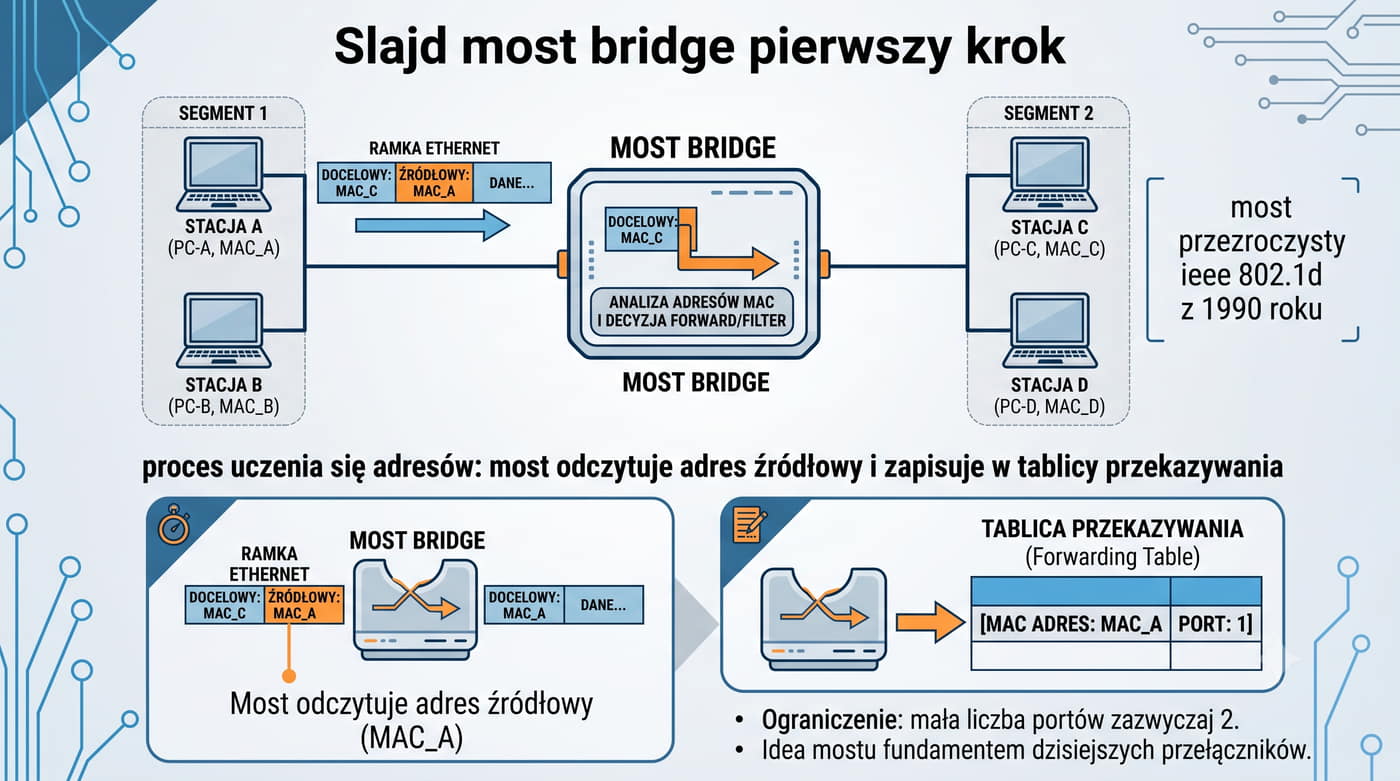
Most zgodny ze standardem IEEE 802.1D to urządzenie warstwy drugiej, które:

  • Uczy się adresów MAC: Tablica bridge’a (do ~2k wpisów) mapuje adresy MAC hostów na porty.
  • Filtruje ruch: Ramki kierowane są tylko do portu docelowego, a broadcast/multicast – do wszystkich portów (oprócz źródłowego).
  • Zapobiega pętlom: Protokół STP (Spanning Tree Protocol) blokuje zbędne połączenia między mostami.

Choć bridge’e były prekursorem przełączników, ich ograniczenia (mała liczba portów, mała tablica MAC, brak wsparcia dla VLAN) sprawiły, że zostały zastąpione przez zaawansowane switche wieloportowe.

Most (bridge) zgodny ze standardem IEEE 802.1D był pierwszym urządzeniem warstwy 2, które potrafiło segmentować domeny kolizyjne. Most działał w oparciu o tablicę adresów MAC przechowującą do około 2000 wpisów, co w połowie lat 90. było wartością wystarczającą dla ówczesnych sieci lokalnych. Proces uczenia adresów polegał na analizie ramek przychodzących i zapisywaniu pary (adres źródłowy, numer portu). Jeśli most nie znał adresu docelowego, ramka była wysyłana na wszystkie porty oprócz źródłowego, co nazywano zalewaniem (flooding). Protokół Spanning Tree (STP) zapobiegał powstawaniu pętli w topologiach z wieloma mostami, blokując nadmiarowe łącza.

Pomimo swoich zalet mosty miały istotne ograniczenia. Przede wszystkim dysponowały niewielką liczbą portów (zazwyczaj 2–4), co utrudniało budowę rozbudowanych sieci. Szybkość przekazywania ramek była ograniczona wydajnością procesora i pamięci, a brak wsparcia dla VLAN uniemożliwiał logiczną segmentację ruchu. Z tych powodów mosty zostały szybko wyparte przez wieloportowe przełączniki, które oferowały znacznie wyższą wydajność i bogatszy zestaw funkcji. Mosty pozostały jednak w pamięci jako dowód na to, że segmentacja domen kolizyjnych jest kluczem do skalowalnych sieci.

6/55 Przełącznik (switch) – definicja i istota

Współczesny przełącznik to wyspecjalizowany układ scalony (ASIC), który:

  • Działa w trybie wirespeed: Ramki są przetwarzane w czasie rzeczywistym (wirespeed) przez dedykowane obwody ASIC, które minimalizują opóźnienia.
  • Obsługuje tysiące urządzeń: Tablica CAM przechowuje setki tysięcy adresów MAC.
  • Wspiera zaawansowane funkcje: QoS (Quality of Service), routing warstwy 3 (L3 switch), segmentacja VLAN, zarządzanie ruchem.

Różnica między bridge’em a switchem leży w skali i złożoności: przełącznik to rozproszony system mostów połączonych magistralą, gdzie każdy port działa jak niezależny mostek, ale koordynowany centralnie. Dzięki temu switche są podstawą nowoczesnych sieci korporacyjnych i data center.

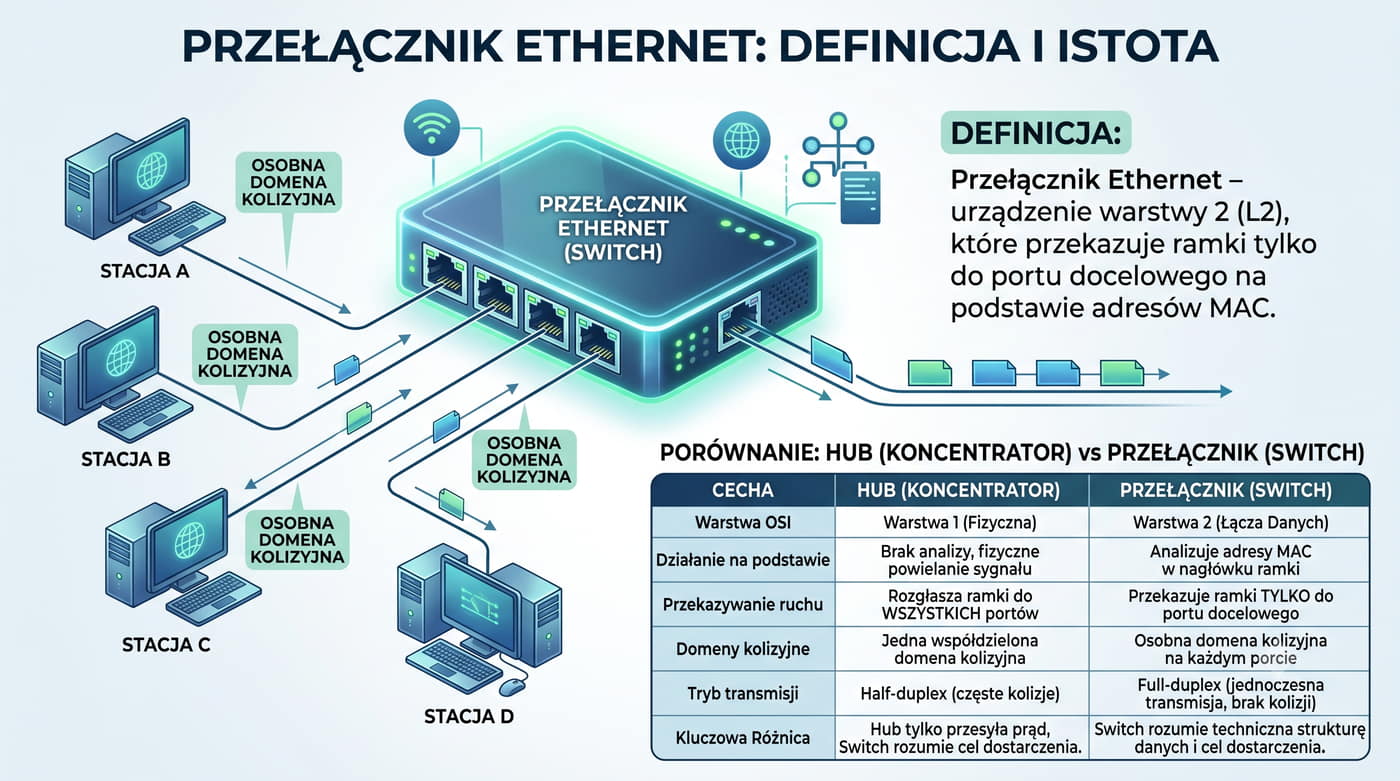
Kluczowa różnica między hubem a switchem: switch nie regeneruje sygnału na wszystkich portach, lecz analizuje zawartość ramki i przekazuje ją tylko do portu docelowego.

Przełącznik Ethernet (switch) to most wieloportowy zintegrowany w pojedynczym układzie scalonym ASIC.

Każdy port switcha stanowi niezależną domenę kolizyjną, co oznacza, że stacje podłączone do różnych portów mogą nadawać jednocześnie bez ryzyka kolizji.

Dzięki temu łącze może pracować w trybie full-duplex, podwajając efektywną przepustowość.

Przełącznik Ethernet, nazywany również switchem, jest w istocie wieloportowym mostem zintegrowanym w pojedynczym układzie ASIC. W odróżnieniu od mostów programowych, w których decyzje o przekazywaniu ramek podejmował procesor, współczesny switch wykonuje te operacje w sprzęcie. Każdy port przełącznika stanowi niezależną domenę kolizyjną, co oznacza, że do portu można podłączyć pojedyncze urządzenie lub kolejny przełącznik bez ryzyka kolizji. Eliminacja mechanizmu CSMA/CD umożliwia pracę w trybie full-duplex, w którym nadawanie i odbiór odbywają się jednocześnie z wykorzystaniem osobnych par przewodów.

Istota działania przełącznika sprowadza się do trzech funkcji realizowanych przez układ ASIC: uczenia się adresów MAC, przekazywania ramek oraz filtrowania ruchu. Nowoczesne switche obsługują tablice CAM zawierające setki tysięcy wpisów, co pozwala na budowanie rozległych sieci korporacyjnych. Zaawansowane modele oferują dodatkowo routing między VLAN (L3 switching), kolejkowanie z priorytetami (QoS) oraz funkcje bezpieczeństwa, takie jak port security czy DHCP snooping. Dzięki architekturze non-blocking przełącznik może przetwarzać ramki na wszystkich portach jednocześnie z pełną prędkością.

Współczesne przełączniki oferują także funkcje zarządzania ruchem, takie jak kolejkowanie priorytetowe (QoS) i ograniczanie prędkości na porcie (rate limiting), które pozwalają na optymalizację przepustowości w sieciach o mieszanym ruchu. Dzięki tym mechanizmom administrator może zagwarantować odpowiednią jakość usług dla aplikacji krytycznych, takich jak VoIP czy systemy transakcyjne.

7/55 Miejsce przełącznika w modelu OSI

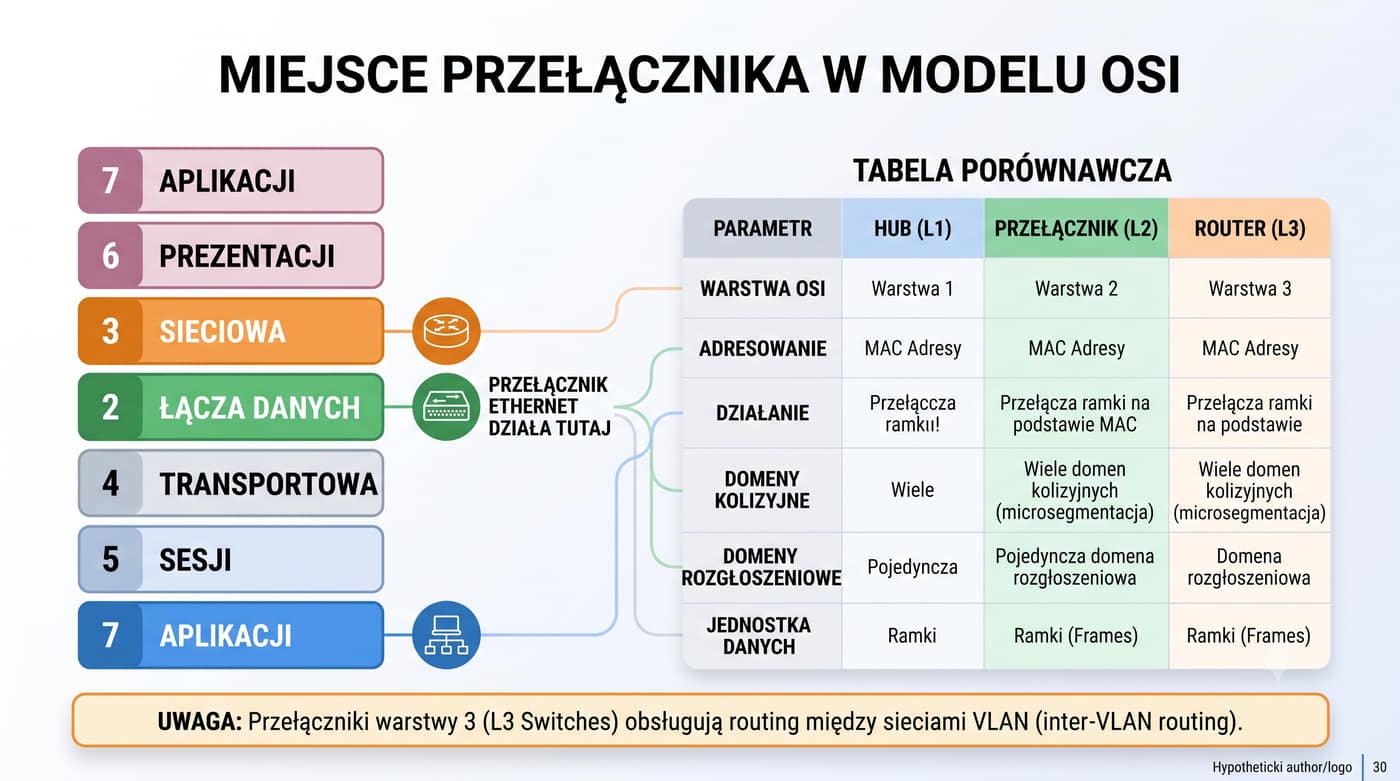
Przełącznik (switch) działa w warstwie 2 modelu OSI (warstwa łącza danych). Jego główne funkcje to:

  • Przetwarzanie adresów MAC (filtrowanie ramek na podstawie adresu docelowego).
  • Tworzenie i zarządzanie tablicą adresów MAC (CAM - Content-Addressable Memory).
  • Izolacja domen kolizyjnych poprzez kierowanie ruchu tylko na odpowiedni port.

W przeciwieństwie do koncentratora (hub), przełącznik nie rozgłasza ramek po całej sieci, co znacząco zwiększa wydajność.

Przełącznik Ethernet działa w warstwie drugiej modelu OSI (Data Link Layer), co oznacza, że operuje na ramkach, a nie na pojedynczych bitach. W ramach tej warstwy switch realizuje dwie podwarstwy: MAC (Media Access Control) odpowiedzialną za adresację fizyczną oraz LLC (Logical Link Control) zarządzającą identyfikacją protokołów. Decyzje o przekazywaniu ramek podejmowane są wyłącznie na podstawie adresów MAC, bez ingerencji w zawartość pakietów warstwy trzeciej. Dla przełącznika ramka IP (IPv4 lub IPv6) jest jedynie ciągiem bajtów rozpoczynającym się od adresów MAC źródłowego i docelowego.

Granica między warstwami 2 i 3 zaciera się w przypadku przełączników wielowarstwowych (L3 switches), które potrafią wykonywać routing na podstawie adresów IP, zachowując przy tym szybkość przełączania sprzętowego. Urządzenia te są powszechnie stosowane w szkieletach sieci korporacyjnych, gdzie pełnią rolę bram domyślnych dla poszczególnych VLAN. W modelu OSI istotne jest zrozumienie, że przełącznik nie modyfikuje zawartości ramki – nie zmienia adresów MAC, nie zmniejsza pola TTL ani nie przelicza sum kontrolnych warstwy 3. Operacje te są domeną routerów i hostów końcowych.

W codziennej praktyce administracyjnej kluczowe jest zrozumienie, że przełącznik warstwy 2 nie ingeruje w adresy IP ani nie wykonuje translacji adresów. Jeśli zajdzie potrzeba komunikacji między różnymi podsieciami, niezbędne jest zastosowanie routera lub przełącznika wielowarstwowego. Granica między przełączaniem a routingiem jest jedną z najważniejszych koncepcji w projektowaniu sieci.

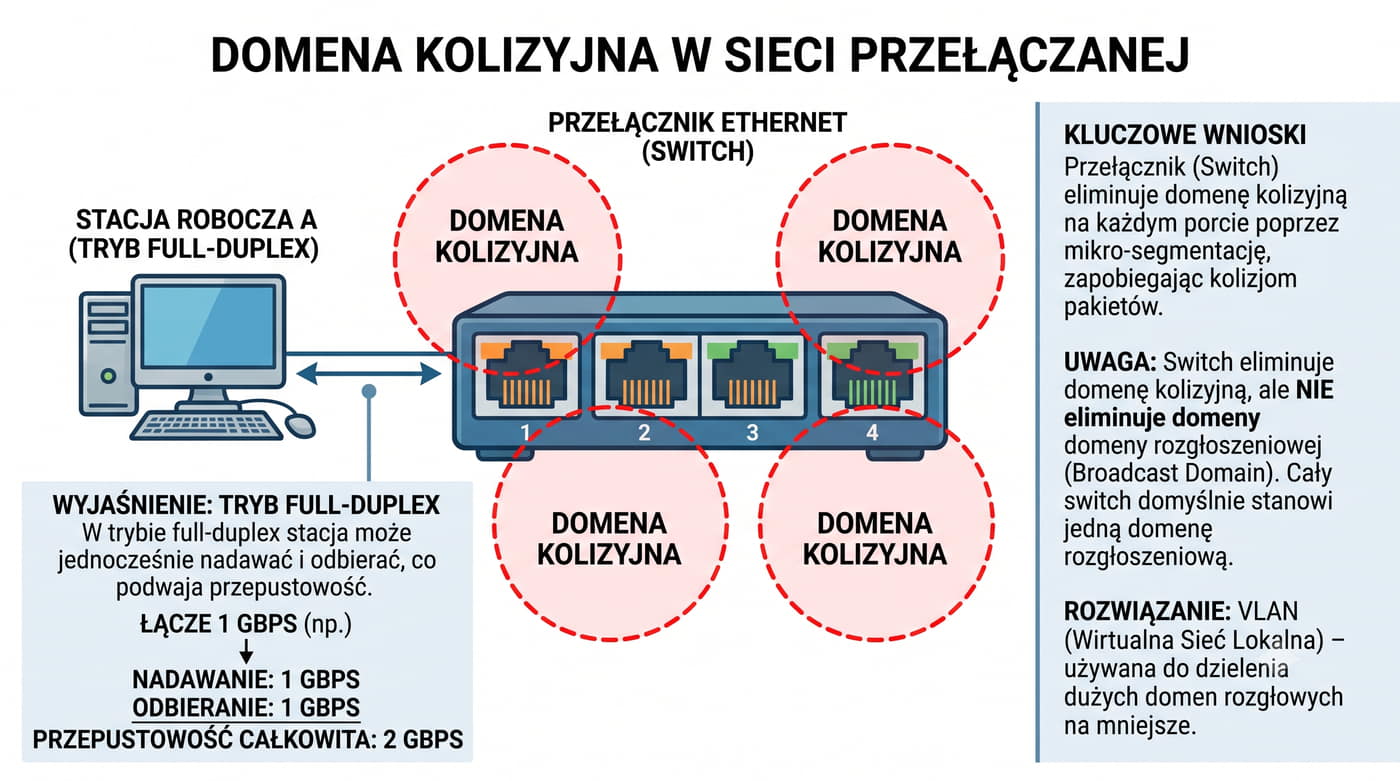
8/55 Domena kolizyjna w sieci przełączanej

Przełącznik tworzy oddzielne domeny kolizyjne dla każdego portu:

  • Każdy port przełącznika stanowi osobną domenę kolizyjną.
  • Kolizje występują tylko między urządzeniami podłączonymi do tego samego portu.
  • Przykład: Dwa komputery na różnych portach nie zakłócają się wzajemnie, nawet jeśli przełącznik łączy wiele portów.
  • W hubach cała sieć to jedna domena kolizyjna, co powoduje chaos przy większej liczbie urządzeń.

W sieci przełączanej każdy port tworzy oddzielną domenę kolizyjną, co zapewnia izolację transmisji między urządzeniami podłączonymi do różnych portów. Oznacza to, że stacja A wysyłająca dane do stacji B na porcie 2 nie powoduje zakłóceń dla stacji C pracującej na porcie 3. W praktyce kolizje mogą wystąpić jedynie wtedy, gdy do jednego portu przełącznika podłączone jest kilka urządzeń za pośrednictwem huba. Z tego względu w nowoczesnych sieciach unika się łączenia hubów z przełącznikami, a każde urządzenie końcowe podłącza się bezpośrednio do portu switcha.

Eliminacja domen kolizyjnych przynosi wymierne korzyści: wzrost efektywnej przepustowości, możliwość jednoczesnej komunikacji wielu par hostów oraz uproszczenie okablowania. W sieci z przełącznikiem nie ma potrzeby stosowania kabli krosowanych (crossover) między przełącznikami, dzięki mechanizmowi Auto MDI/MDI-X. Należy pamiętać, że przełącznik nie eliminuje domen rozgłoszeniowych – ramka broadcast wciąż trafia do wszystkich urządzeń w tej samej sieci logicznej. W dużych sieciach konieczne jest stosowanie VLAN lub routingu, aby ograniczyć zasięg ruchu rozgłoszeniowego.

Analizując zachowanie przełącznika, warto zwrócić uwagę na to, jak radzi sobie on z ruchem broadcast. Mimo że każdy port stanowi oddzielną domenę kolizyjną, ramki rozgłoszeniowe wciąż są przekazywane do wszystkich portów w obrębie tej samej VLAN. Zjawisko to może prowadzić do przeciążenia sieci w przypadku dużej liczby urządzeń lub ataku broadcast storm.

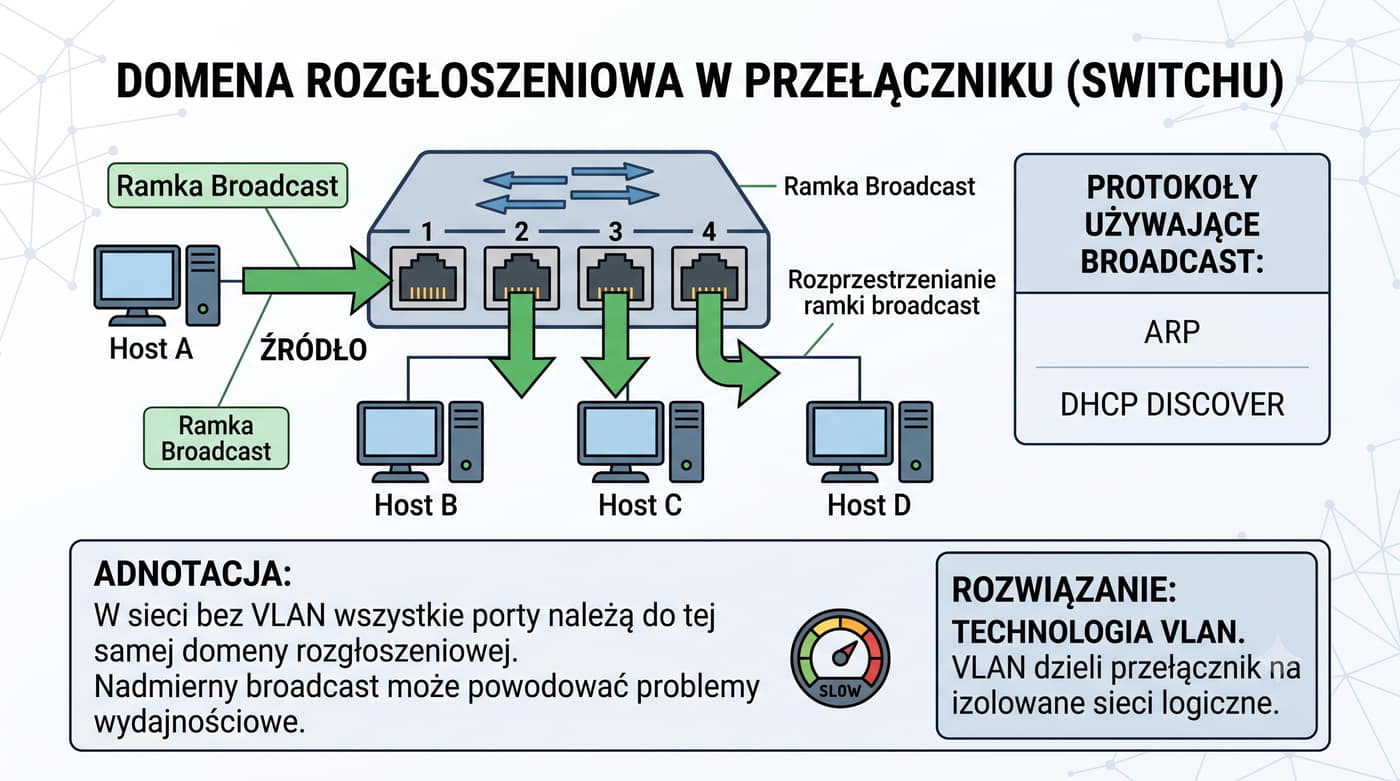
9/55 Domena rozgłoszeniowa w switchu

Przełącznik obsługuje ruch rozgłoszeniowy w następujący sposób:

  • Przełącznik przekazuje całą ramkę broadcast (np. ARP, DHCP) do wszystkich portów z wyjątkiem źródłowego.
  • Każdy przełącznik tworzy jedną domenę rozgłoszeniową dla całego ruchu (bez podziału na VLAN-y).
  • Aby ograniczyć broadcasty, stosuje się VLAN-y – grupowanie portów w logiczne sieci.

Przykład: ARP request na porcie 1 trafi do wszystkich portów przełącznika, ale tylko urządzenia w tej samej VLAN odpowiedzą.

Domena rozgłoszeniowa (broadcast domain) w przełączniku obejmuje wszystkie porty należące do tej samej sieci logicznej, czyli domyślnie wszystkie porty switcha lub wszystkie porty w obrębie jednej VLAN. Ramki broadcast, takie jak zapytania ARP, komunikaty DHCP Discover czy protokół NetBIOS, są przekazywane na wszystkie porty należące do domeny z wyjątkiem portu źródłowego. W dużych sieciach może to prowadzić do znacznego obciążenia pasma i procesorów hostów, które muszą odrzucać nieadresowane do nich ramki. Zjawisko to, zwane broadcast storm, jest szczególnie uciążliwe w sieciach liczących setki urządzeń.

Narzędziem służącym do ograniczania domen rozgłoszeniowych są wirtualne sieci lokalne (VLAN). Dzieląc porty przełącznika na grupy VLAN, można stworzyć odrębne domeny broadcastowe, które nie komunikują się ze sobą bez pośrednictwa routera lub przełącznika warstwy 3. Protokoły takie jak GVRP czy VTP automatyzują dystrybucję informacji o VLAN między przełącznikami, ograniczając konieczność ręcznej konfiguracji. W praktyce inżynierskiej kluczowe jest zrozumienie, że każda VLAN tworzy oddzielną domenę rozgłoszeniową, a router stanowi bramę między nimi.

W sieciach o wysokiej gęstości urządzeń, takich jak akademiki czy hale targowe, ruch rozgłoszeniowy może stanowić znaczącą część całego ruchu sieciowego. Protokoły takie jak ARP generują zapytania broadcast przy każdej próbie nawiązania komunikacji, co przy setkach hostów prowadzi do setek ramek na sekundę. W takich środowiskach stosowanie VLAN i odpowiedniej segmentacji sieci jest absolutnie konieczne.

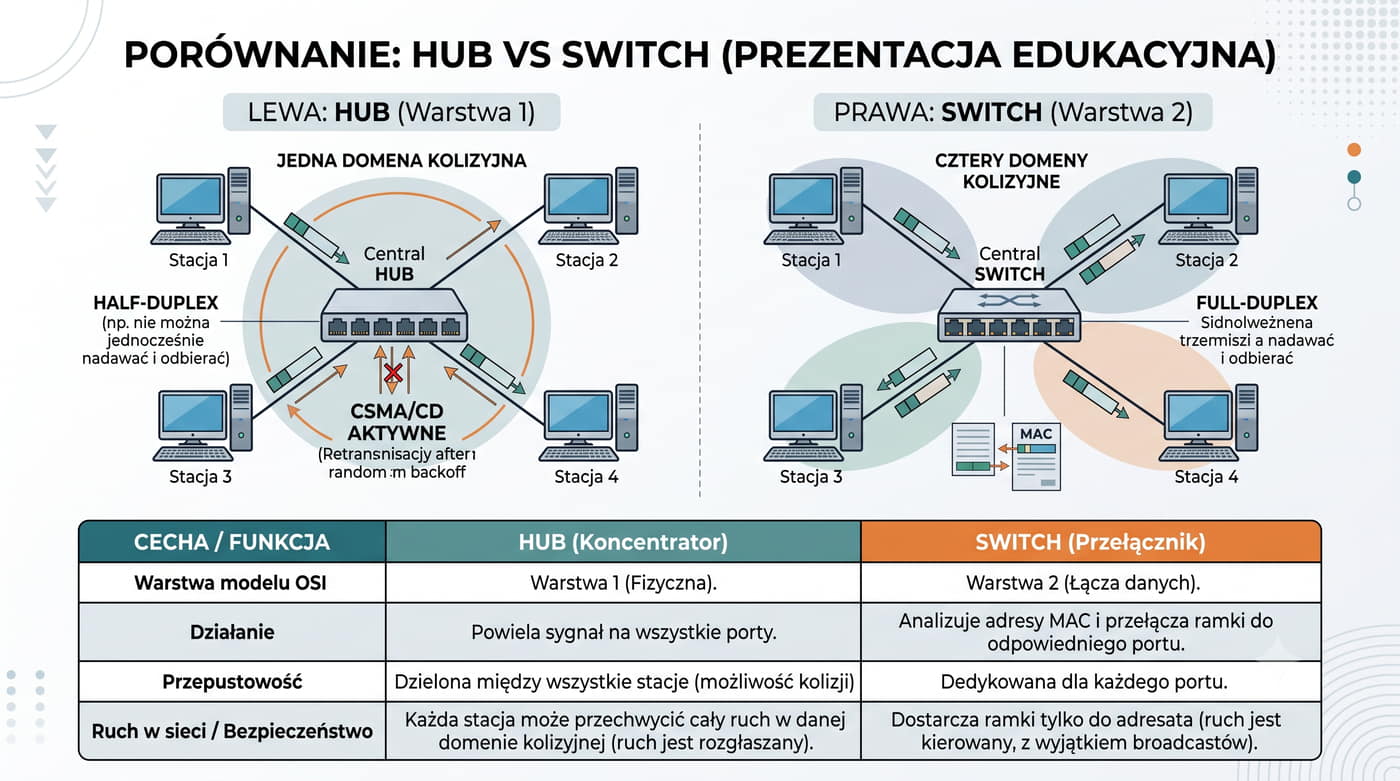
10/55 Hub vs switch – porównanie
Cecha Hub (warstwa 1) Switch (warstwa 2)
Przetwarzanie Brak – rozgłasza wszystkie ramki Inteligentne – filtruje adresy MAC
Wydajność Niska (kolizje na całej sieci) Wysoka (ruch tylko do celu)
Bezpieczeństwo Słabe (każdy widzi ruch) Lepsze (izolacja portów)
Przykład 100 urządzeń → 1 domena kolizyjna 100 urządzeń → 100 domen (przy 1 porcie/urządzenie)

Switch redukuje ruch nawet o 90% w porównaniu z hubem.

Hub i przełącznik to urządzenia o fundamentalnie różnej architekturze i sposobie działania. Hub (koncentrator) działa w warstwie fizycznej modelu OSI, jedynie regenerując sygnał elektryczny i przekazując go na wszystkie porty. Nie posiada żadnej inteligencji – nie analizuje adresów MAC ani nie podejmuje decyzji o routingu ramek. Wszystkie urządzenia podłączone do huba dzielą to samo pasmo, a w przypadku kolizji muszą stosować mechanizm CSMA/CD z wykładniczym czasem oczekiwania (backoff). W rezultacie rzeczywista przepustowość sieci z hubem szybko spada wraz ze wzrostem liczby hostów.

Przełącznik natomiast analizuje adres MAC docelowy każdej ramki i przekazuje ją wyłącznie do portu, przy którym znajduje się odbiorca. Dzięki temu ruch między dwoma parami portów może odbywać się równolegle bez wzajemnych zakłóceń. Switch zapewnia również lepsze bezpieczeństwo, ponieważ stacja nie może przechwycić ramki adresowanej do innego urządzenia (o ile nie stosuje się ataków ARP spoofing lub MAC flooding). Współczesne przełączniki oferują tysiące portów, obsługę VLAN, QoS, agregację łączy (Link Aggregation) i zarządzanie przez SNMP, co czyni je niezbędnymi w każdej profesjonalnej sieci.

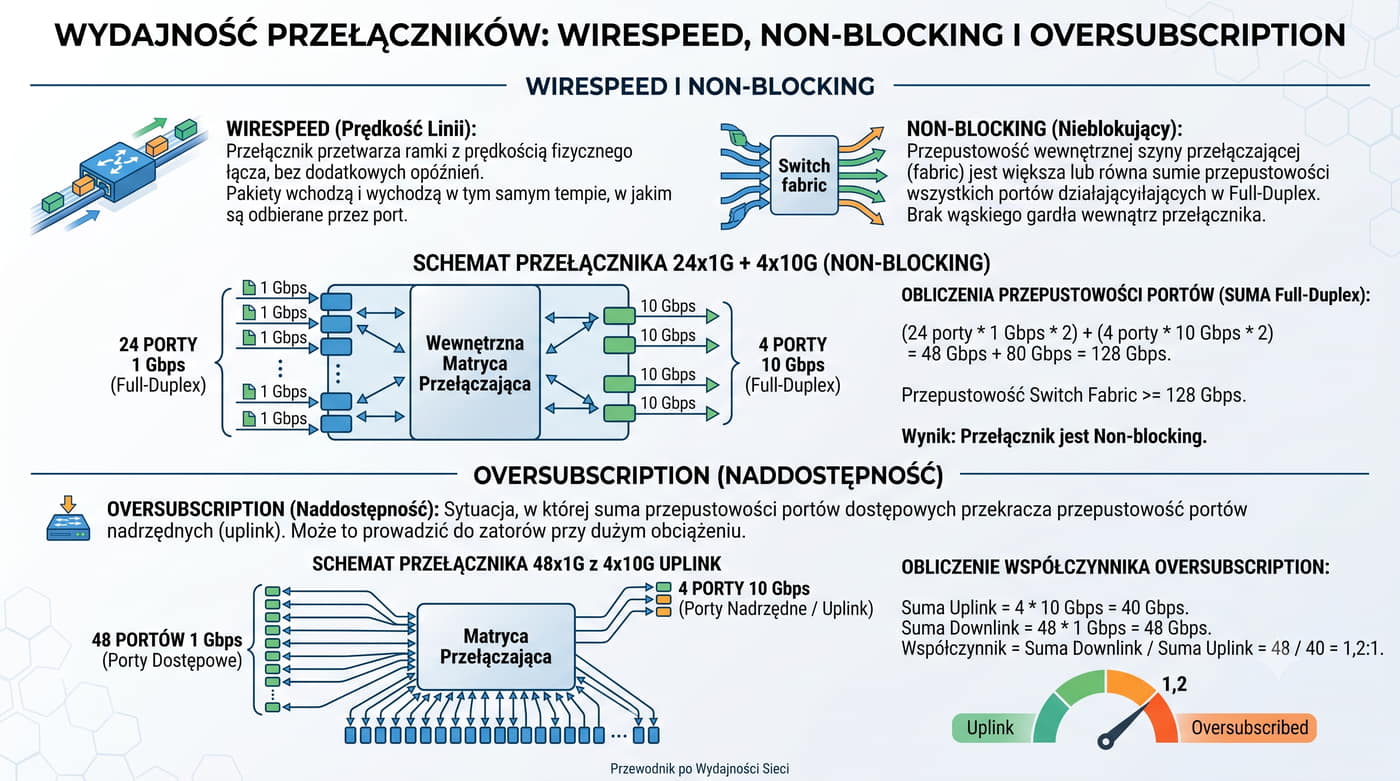
11/55 Wirespeed i non-blocking

Kluczowe parametry wydajności przełącznika:

  • Wirespeed – przepustowość równa prędkości portów (np. 10 Gbps).
  • Non-blocking – architektura, w której wewnętrzna macierz przełączająca (switch fabric) ma przepustowość nie mniejszą niż suma przepustowości wszystkich portów, dzięki czemu ramki nie są kolejkowane nawet przy pełnym obciążeniu.
Przykład obliczenia:

Dla switcha z portami 10 Gbps i 8000 wpisami w CAM:

  • Maks. ruch na port: 10 Gbps.
  • Jeśli dwa urządzenia komunikują się – switch przetwarza obie ramki równolegle (non-blocking).
  • Wirespeed osiągany jest przez brak wąskich gardeł w przetwarzaniu.
Przykład: Cisco Catalyst 9000 obsługuje do 256 000 adresów MAC z wirespeed.

Wirespeed to cecha przełącznika oznaczająca, że każdy port może pracować z nominalną prędkością linii, niezależnie od obciążenia pozostałych portów. Na przykład przełącznik z 24 portami 1 Gbps ma łączną przepustowość 48 Gbps (24 Gbps w każdą stronę), jeśli każdy port pracuje w trybie full-duplex. Osiągnięcie wirespeed wymaga, aby wewnętrzna magistrala przełącznika (switch fabric) miała przepustowość nie mniejszą niż suma przepustowości wszystkich portów. W przeciwnym razie dochodzi do zjawiska blokowania, w którym ramki są kolejkowane i gubione.

Architektura non-blocking zapewnia, że każdy port ma dedykowaną ścieżkę do magistrali przełącznika, bez wspólnego wąskiego gardła. W praktyce oznacza to, że nawet przy maksymalnym obciążeniu wszystkich portów przełącznik jest w stanie przekazywać ramki z nominalną prędkością. Parametr ten jest szczególnie ważny w środowiskach data center, gdzie każda milisekunda opóźnienia ma znaczenie. Współczesne przełączniki Cisco Catalyst 9000 czy MikroTik CRS3xx osiągają przepustowość rzędu setek gigabitów na sekundę, obsługując jednocześnie setki tysięcy wpisów w tablicy CAM.

W praktyce parametr wirespeed osiąga się przez zastosowanie wydajnych układów ASIC oraz odpowiedniego projektu płytki drukowanej, który minimalizuje opóźnienia propagacji sygnału między portami. W przełącznikach klasy carrier dodatkowo stosuje się architekturę Clos, która zapewnia skalowalność do setek portów przy zachowaniu non-blocking. Zrozumienie tych koncepcji jest kluczowe przy wyborze odpowiedniego sprzętu dla sieci wymagających wysokiej dostępności.

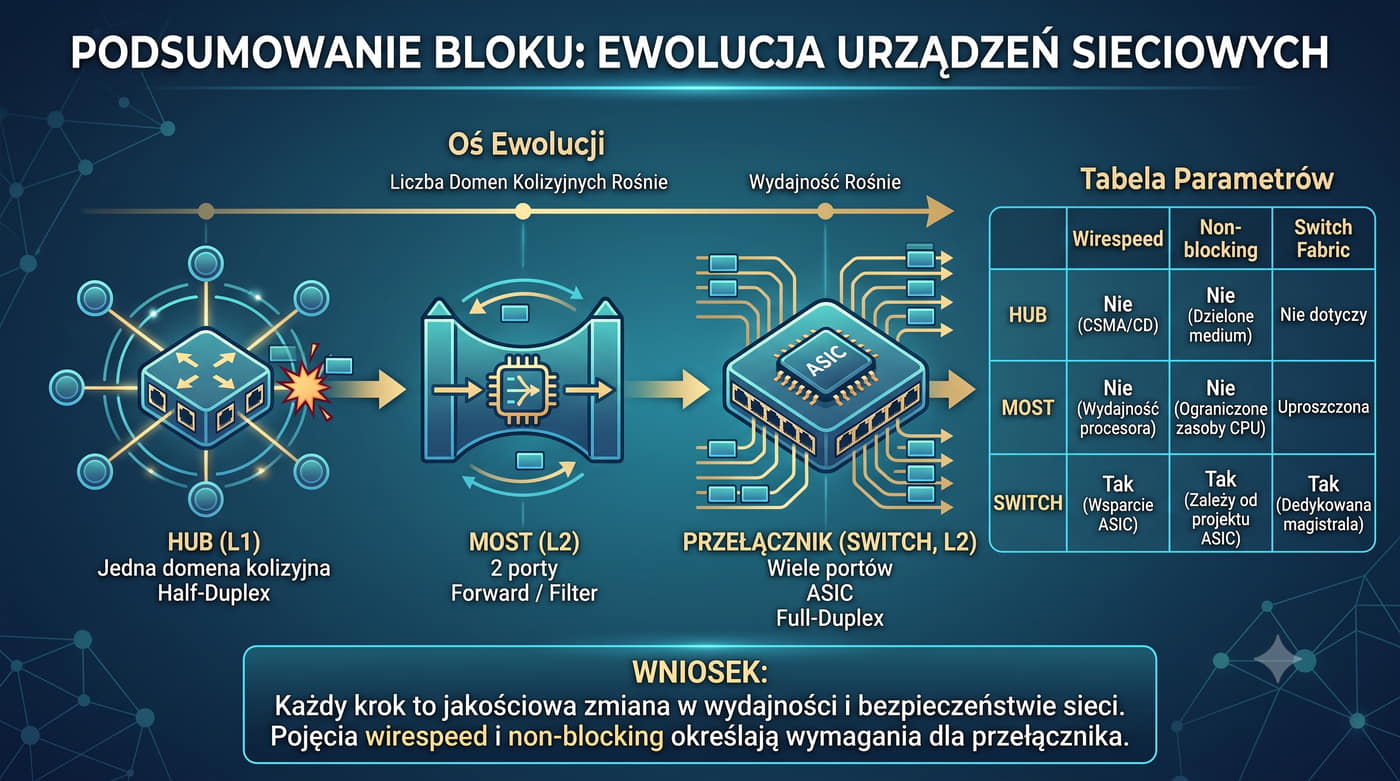
12/55 Podsumowanie bloku I

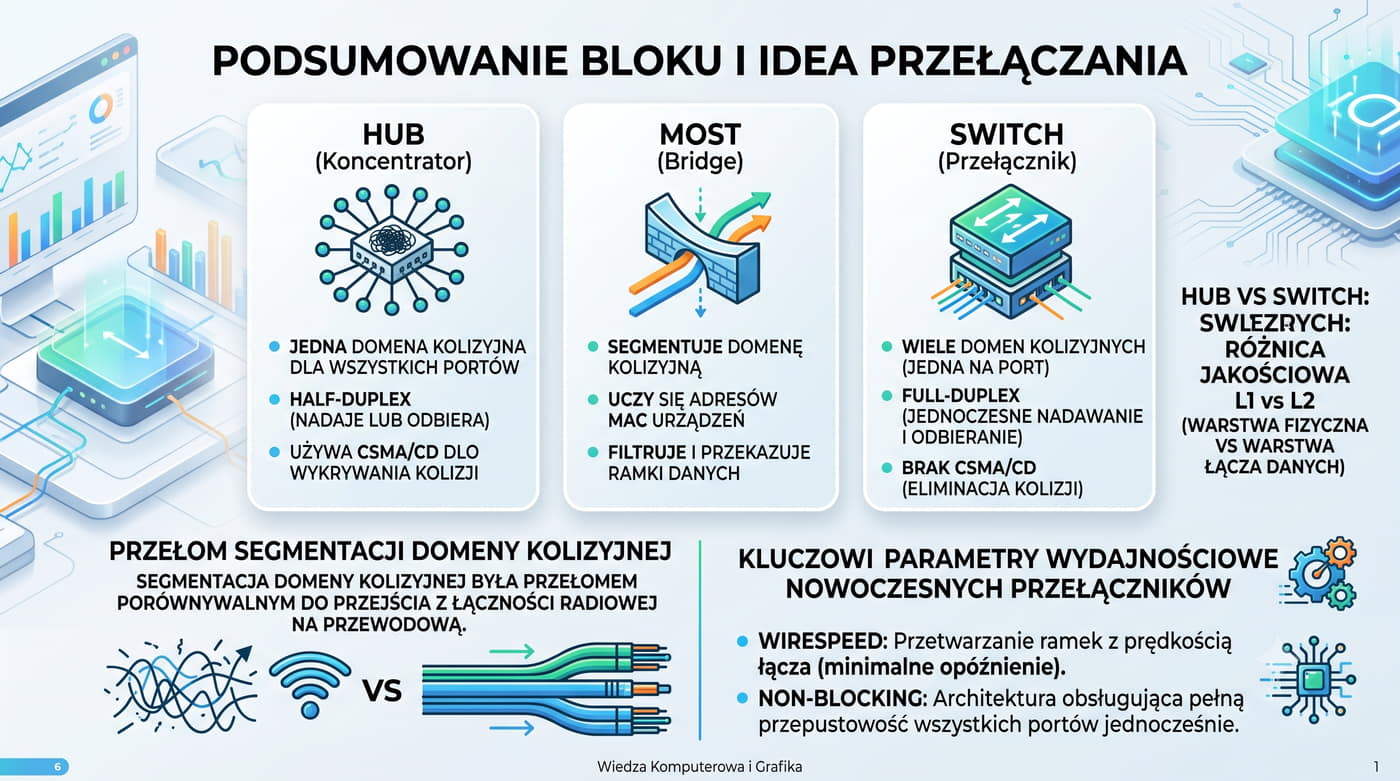
Podsumowanie kluczowych różnic między hubami a switchami:

  • Huby (lata 80.): Proste, tanie, ale nieefektywne (kolizje, brak adresacji).
  • Switche (od lat 90.):
  • Warstwa 2: adresacja MAC, izolacja kolizji.
  • VLAN-y: Segmentacja ruchu.
  • Wydajność: Redukcja ruchu o 90%, wirespeed.
  • Wpływ: Zwiększenie przepustowości, bezpieczeństwa i skalowalności sieci.

Kluczowy krok w rozwoju sieci korporacyjnych – od chaotycznego broadcastu do inteligentnego routingu danych.

Blok I prezentacji wprowadził słuchaczy w zagadnienia związane z ograniczeniami modelu współdzielonego oraz ewolucją w kierunku sieci przełączanych. Kluczowym wnioskiem jest to, że przejście od hubów do switchów stanowiło przełom porównywalny do zastąpienia łączy dzierżawionych technologią Ethernet. Przełącznik nie tylko eliminuje kolizje, ale także umożliwia jednoczesną komunikację wielu par urządzeń, co wielokrotnie zwiększa efektywną przepustowość sieci. Wprowadzenie trybu full-duplex podwoiło dodatkowo przepustowość każdego łącza, ponieważ nadawanie i odbiór mogą odbywać się w tym samym czasie.

Kolejnym istotnym aspektem jest zrozumienie różnicy między domeną kolizyjną a rozgłoszeniową. Przełącznik dzieli sieć na wiele domen kolizyjnych, ale nie rozwiązuje problemu domeny rozgłoszeniowej. Rozwiązaniem tego problemu jest stosowanie VLAN lub routerów, które blokują ruch broadcast na granicach podsieci. Prezentacja podkreśliła również znaczenie skalowalności – sieć oparta na switchach może obejmować tysiące urządzeń bez degradacji wydajności, co w erze hubów było niemożliwe. Te podstawy teoretyczne stanowią fundament dla dalszych bloków poświęconych budowie sprzętowej i konfiguracji przełączników.

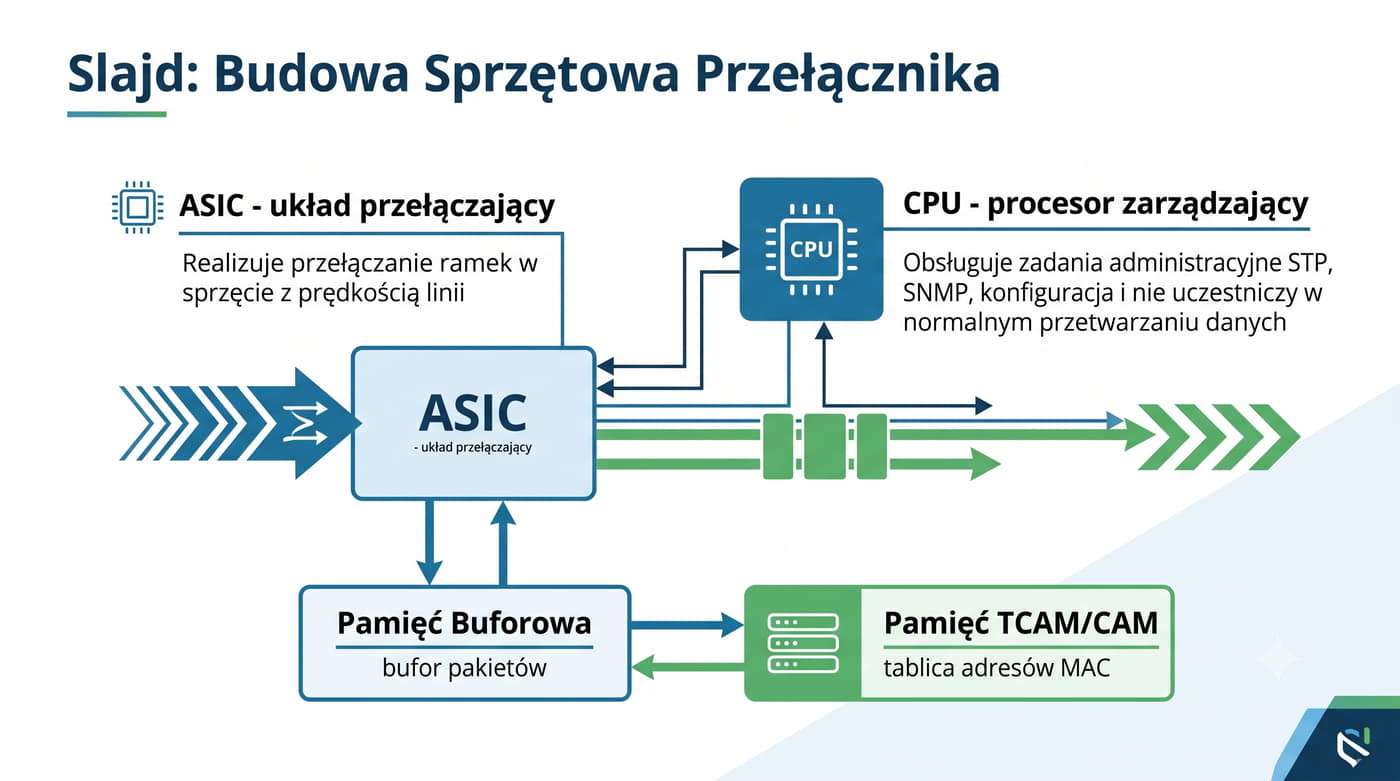
13/55 Budowa sprzętowa przełącznika

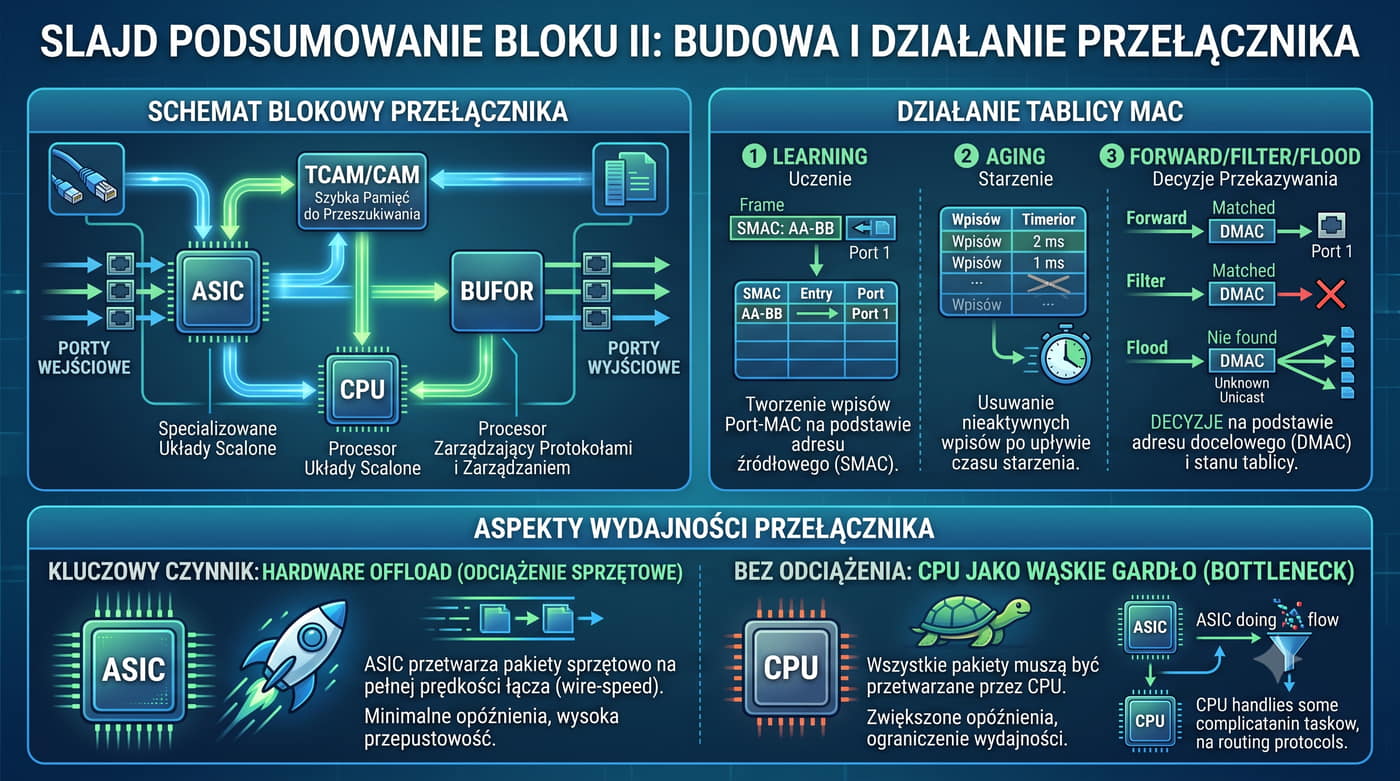
Przełącznik sieciowy składa się z kluczowych komponentów sprzętowych:

  • ASIC (Switch Fabric) - dedykowany układ do przetwarzania ruchu.
  • CPU - zarządza konfiguracją i operacjami systemowymi.
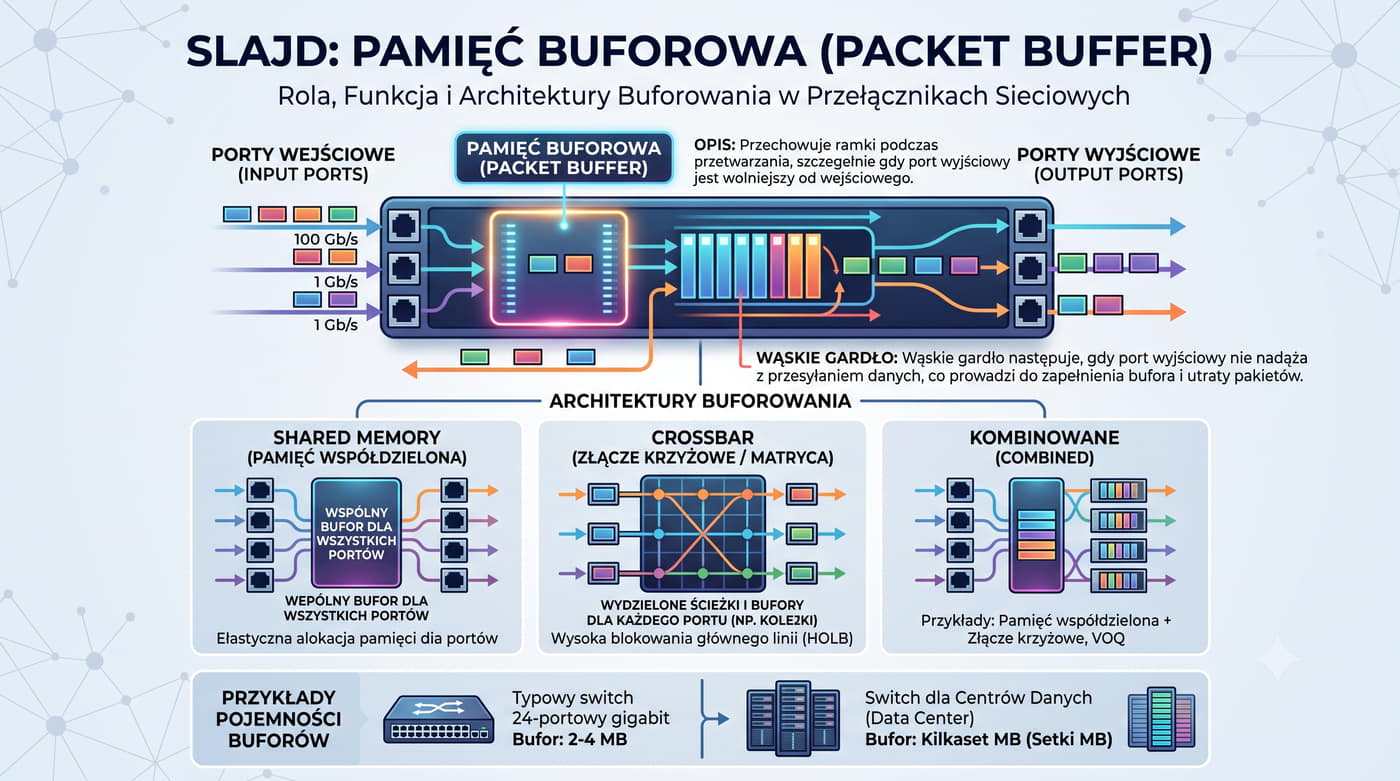
  • Pamięć buforowa (Packet Buffer) - przechowuje ramki w trakcie przetwarzania.
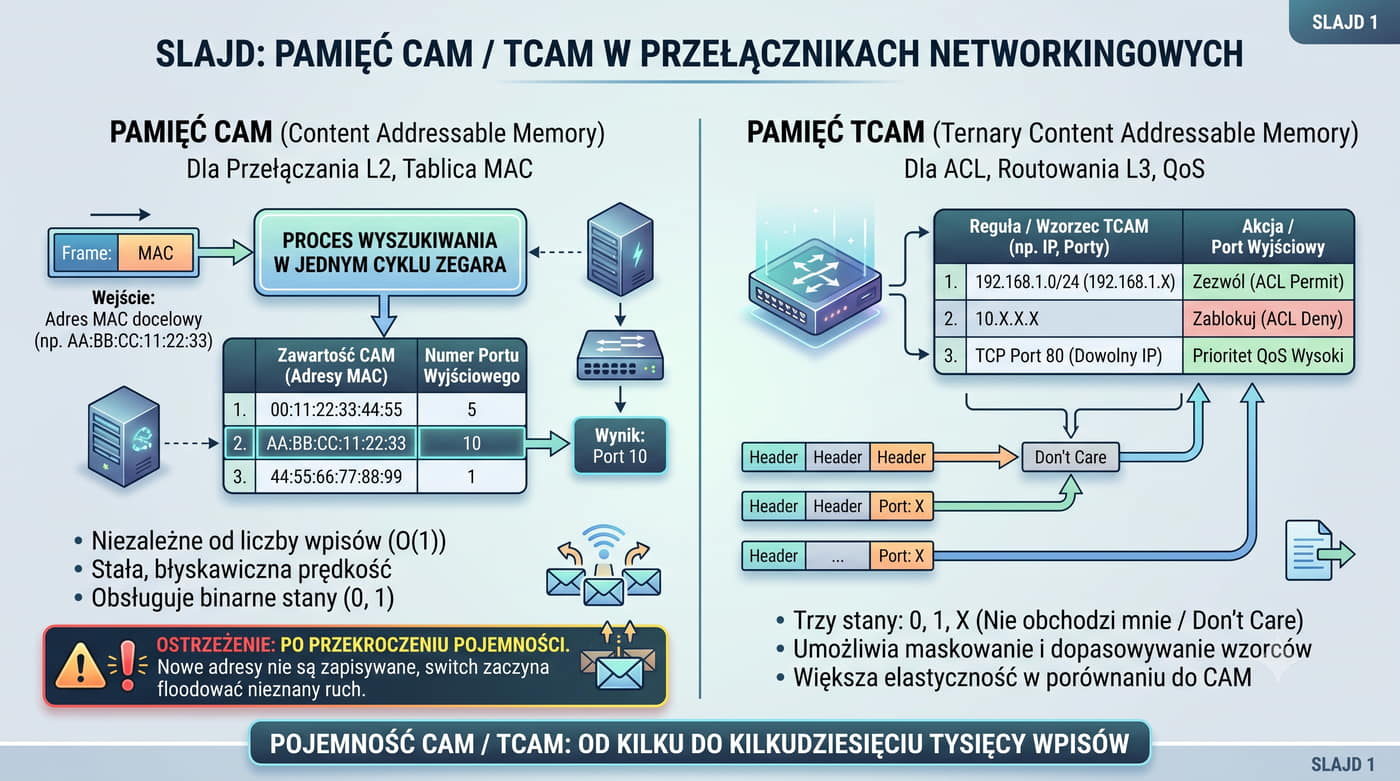
  • Pamięć TCAM (Ternary Content-Addressable Memory) / CAM - szybkie wyszukiwanie adresów MAC.

Budowa sprzętowa przełącznika Ethernet składa się z kilku kluczowych podsystemów, które współpracują ze sobą w celu zapewnienia szybkiego i niezawodnego przekazywania ramek. Centralnym elementem jest układ ASIC (Application-Specific Integrated Circuit), który realizuje operacje przełączania w sprzęcie, bez angażowania procesora głównego. ASIC zawiera matrycę przełączającą (crossbar) łączącą wszystkie porty oraz silniki przetwarzania nagłówków odpowiedzialne za analizę adresów MAC. Układy ASIC są projektowane specjalnie dla konkretnych serii przełączników i oferują wydajność rzędu miliardów bitów na sekundę.

Oprócz ASIC w każdym zarządzalnym przełączniku znajduje się procesor CPU, który zajmuje się konfiguracją, obsługą protokołów sterujących (STP, LLDP, SNMP) oraz diagnostyką. Pamięć buforowa (packet buffer) przechowuje ramki w trakcie przetwarzania, co jest szczególnie ważne w przypadku przeciążenia portu wyjściowego. Pamięć CAM/TCAM stanowi szybką pamięć asocjacyjną, w której przechowywane są wpisy tablicy MAC oraz listy kontroli dostępu (ACL). Wszystkie te komponenty są zintegrowane na jednej płytce drukowanej (PCB) z gniazdami dla modułów SFP, zasilaczami redundantnymi i wentylatorami.

Z punktu widzenia niezawodności, przełączniki klasy enterprise wyposażone są w redundantne zasilacze (hot-swappable) oraz możliwość łączenia w stosy (stacking), co pozwala na zarządzanie wieloma urządzeniami jako jednym logicznym switchem. Wentylatory w takich urządzeniach są często wymienne na gorąco i monitorowane przez system zarządzania. Komponenty te podlegają starzeniu i powinny być regularnie sprawdzane w ramach przeglądów technicznych.

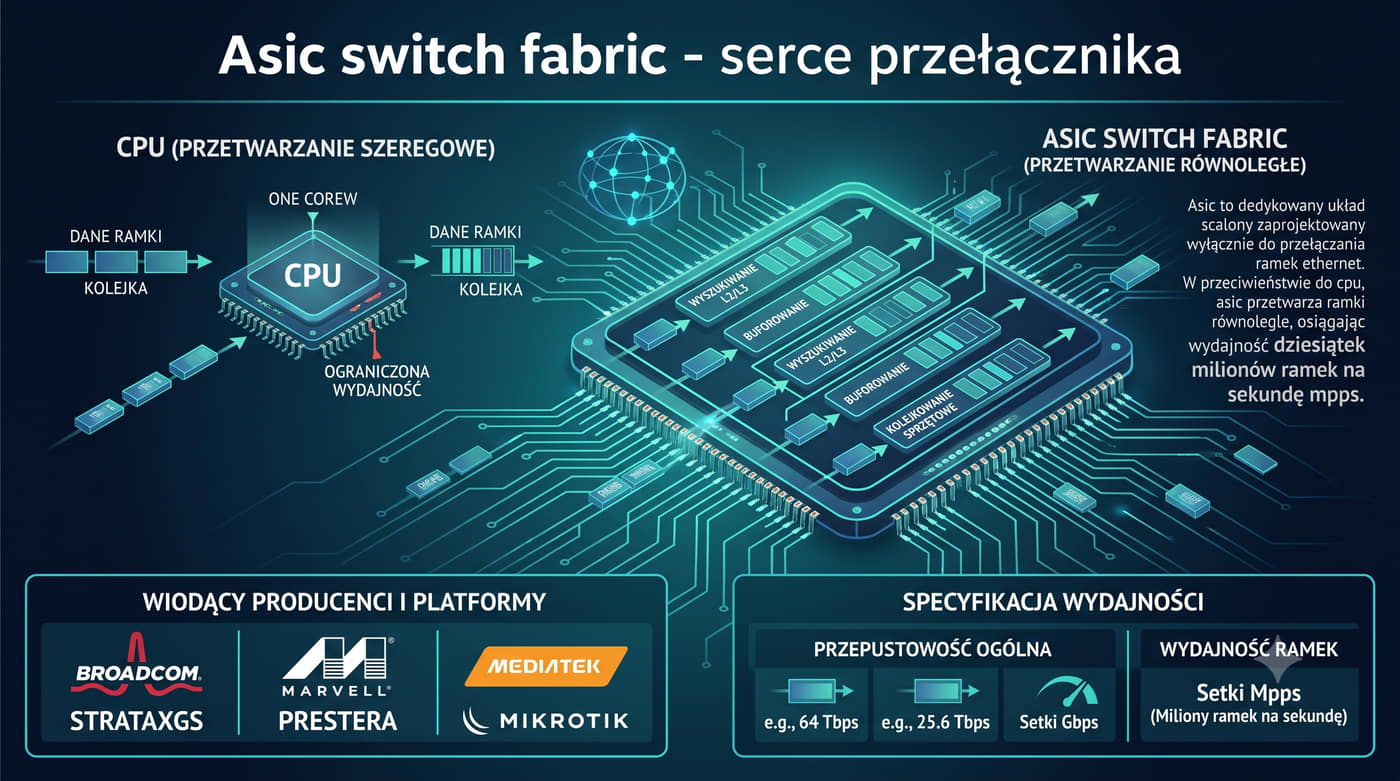
14/55 ASIC (Switch Fabric)

ASIC (Switch Fabric) – dedykowany układ scalony do przetwarzania ruchu. ASIC odpowiada za fizyczne przełączanie pakietów. Zawiera matrycę crossbar do kierowania ramek oraz silniki przetwarzania nagłówków (np. filtrowanie, routing).

Uwaga: ASIC nie obsługuje złożonych protokołów warstwy aplikacji – wymaga wsparcia CPU.

Układ ASIC (Switch Fabric) jest sercem przełącznika – to on podejmuje decyzje o przekazywaniu ramek z szybkością rzędu mikrosekund. ASIC zawiera matrycę krzyżową (crossbar switch), która fizycznie łączy porty wejściowe z wyjściowymi, oraz silniki wyszukiwania adresów MAC w tablicy CAM. Współczesne ASIC, takie jak Broadcom Trident+ czy Marvell Prestera, potrafią przetwarzać ponad 100 milionów ramek na sekundę (Mpps) i obsługiwać przepustowość rzędu terabitów na sekundę. Kluczową zaletą ASIC w porównaniu z rozwiązaniami programowymi jest deterministyczny czas przetwarzania – każda ramka jest obsługiwana w stały, przewidywalny sposób.

Mimo ogromnej wydajności ASIC ma ograniczenia – nie potrafi samodzielnie obsługiwać złożonych protokołów, takich jak BGP, OSPF czy STP. Funkcje te są przekazywane do procesora zarządzającego (CPU), który po podjęciu decyzji konfiguruje ASIC odpowiednimi wpisami. Mechanizm ten, zwany hardware offloading, pozwala na wykorzystanie szybkości ASIC przy jednoczesnej elastyczności oprogramowania. W przełącznikach warstwy 3 ASIC może dodatkowo wykonywać routing IP na podstawie tablicy FIB (Forwarding Information Base), co znacznie przyspiesza przekazywanie pakietów między podsieciami.

W praktyce, gdy nowa ramka dociera do przełącznika, ASIC w pierwszej kolejności sprawdza adres źródłowy i aktualizuje tablicę MAC, a następnie wyszukuje adres docelowy. Jeśli adres docelowy jest znany, ASIC natychmiast ustawia połączenie między odpowiednimi portami przez matrycę crossbar. Cały proces, od odebrania pierwszego bitu do rozpoczęcia transmisji na porcie wyjściowym, trwa zaledwie kilka mikrosekund, co jest nieosiągalne dla rozwiązań programowych.

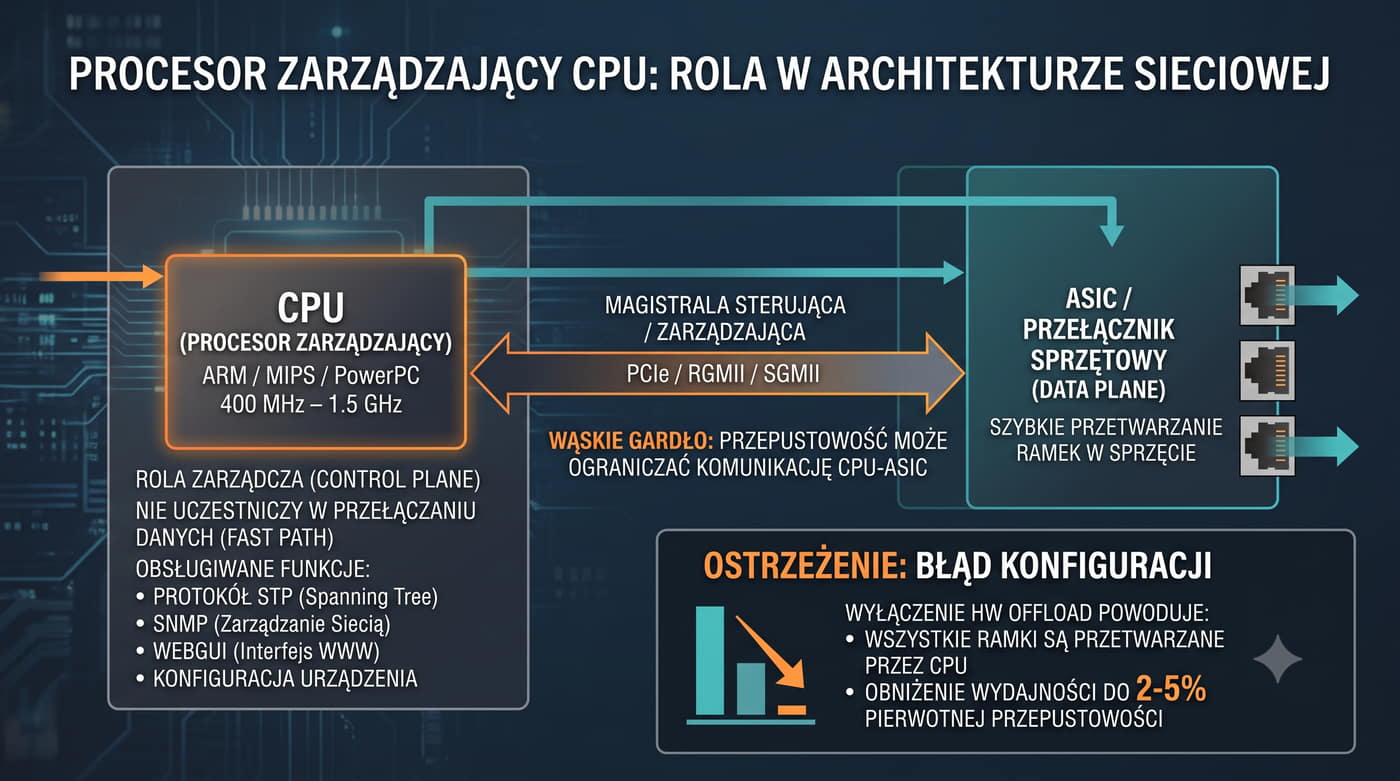
15/55 Procesor zarządzający (CPU)

CPU wykonuje zadania systemowe:

  • Konfiguracja tablicy MAC (learning).
  • Obsługa protokołów (np. STP, Spanning Tree).
  • Zarządzanie stanem połączeń.

Uwaga: Wyłączenie sprzętowego przełączania (HW offload) dla mostu lub interfejsu VLAN powoduje, że wszystkie ramki muszą być przetwarzane programowo przez CPU, co drastycznie obniża wydajność (nawet do 2–5% nominalnej przepustowości).

Procesor zarządzający (CPU) w przełączniku pełni funkcje kontrolne i konfiguracyjne, które nie mogą być realizowane w układzie ASIC. Do zadań CPU należy uruchamianie systemu operacyjnego (Cisco IOS, RouterOS, Cumulus Linux), interpretacja poleceń konfiguracyjnych oraz obsługa protokołów sterujących. CPU odpowiada również za aktualizację tablicy adresów MAC na podstawie informacji z procesu uczenia, a także za zarządzanie buforami ramek. W przypadku wystąpienia błędu w konfiguracji, np. próby przekazywania całego ruchu przez CPU (zamiast ASIC), wydajność przełącznika drastycznie spada, ponieważ procesor nie jest przystosowany do przetwarzania ramek z prędkością linii.

Typowy procesor stosowany w przełącznikach zarządzalnych to układ ARM Cortex-A lub MIPS o częstotliwości 800 MHz–2 GHz, z pamięcią RAM rzędu 256 MB–4 GB. CPU komunikuje się z ASIC za pośrednictwem magistrali PCI Express lub dedykowanego interfejsu. W sytuacjach awaryjnych, takich jak atak MAC flooding lub błędna konfiguracja STP, CPU może zostać przeciążony, co objawia się wzrostem opóźnień i utratą pakietów. Z tego względu w sieciach produkcyjnych monitoruje się obciążenie procesora przełącznika za pomocą poleceń takich jak show processes cpu w Cisco IOS.

16/55 Pamięć buforowa (Packet Buffer)

Gdy ASIC jest przeciążony, ramki są tymczasowo przechowywane w:

  • Pamięci rozproszonej - związanej z portami (Drop-tail Queue).
  • Pamięci centralnej - dla ruchu multicast/broadcast.

Zapobiega to utracie pakietów przy wysokim natężeniu ruchu.

Pamięć buforowa (packet buffer) pełni rolę tymczasowego magazynu dla ramek w trakcie ich przetwarzania przez przełącznik. Gdy wiele ramek jednocześnie dociera do portu wyjściowego, nie wszystkie mogą zostać natychmiast wysłane – część musi poczekać w kolejce. Buforowanie zapobiega utracie pakietów (drop) w przypadku krótkotrwałych przeciążeń (burst traffic). W przełącznikach stosuje się dwa typy buforowania: rozproszone (per-port), gdzie każdy port ma wydzielony fragment pamięci, oraz centralne, gdzie cała pamięć buforowa jest współdzielona przez wszystkie porty. Rozwiązanie centralne jest bardziej elastyczne i efektywnie wykorzystuje zasoby.

Wielkość pamięci buforowej ma bezpośredni wpływ na odporność przełącznika na przeciążenia. W przełącznikach dostępowych typowa wartość to 1–2 MB na port, natomiast w modelach szkieletowych może to być nawet 32 MB na każdy port. Mechanizm zarządzania kolejką (queue management) może stosować strategię Drop-Tail (odrzucanie nadmiarowych ramek) lub RED (Random Early Detection), która probabilistycznie odrzuca ramki zanim bufor się całkowicie zapełni. W sieciach wymagających niskich opóźnień (np. HPC, finanse) stosuje się przełączniki z minimalnymi buforami, co skraca czas kolejkowania kosztem większej podatności na utratę ramek podczas skoków ruchu.

17/55 Pamięć TCAM/CAM

TCAM (Ternary Content-Addressable Memory) zapewnia:

  • Wyszukiwanie dokładnych dopasowań adresów MAC.
  • Obsługę wpisów, filtrów i translacji adresów (NAT).
  • Niskie opóźnienia dzięki strukturze CMOS.

Kluczowa dla funkcji przełączania i bezpieczeństwa.

Pamięć CAM (Content-Addressable Memory) to wyspecjalizowany typ pamięci używany w przełącznikach do przechowywania tablicy adresów MAC. W odróżnieniu od tradycyjnej pamięci RAM, w której dane adresuje się za pomocą adresu komórki, w CAM dane są wyszukiwane na podstawie ich zawartości. Procesor ASIC podaje adres MAC docelowy do pamięci CAM, a ta zwraca numer portu, do którego ramka powinna trafić – wszystko w jednym cyklu zegara. To rozwiązanie jest kluczowe dla osiągnięcia szybkości wirespeed, ponieważ tradycyjne wyszukiwanie binarne w pamięci RAM byłoby zbyt wolne.

Pamięć TCAM (Ternary CAM) rozszerza możliwości CAM poprzez wprowadzenie trzeciego stanu: "dowolne" (wildcard). Jest to niezbędne do przechowywania list dostępu (ACL), w których reguły mogą dotyczyć zakresów adresów lub portów. TCAM jest również wykorzystywany w przełącznikach warstwy 3 do szybkiego wyszukiwania tras w tablicy routingu (FIB). Wadą pamięci TCAM jest wysoki pobór mocy i koszt produkcji – układy TCAM generują znaczną ilość ciepła, co wymaga wydajnego systemu chłodzenia w gęsto upakowanych przełącznikach. Mimo to są one niezastąpione w urządzeniach wymagających szybkiego przetwarzania reguł filtrowania.

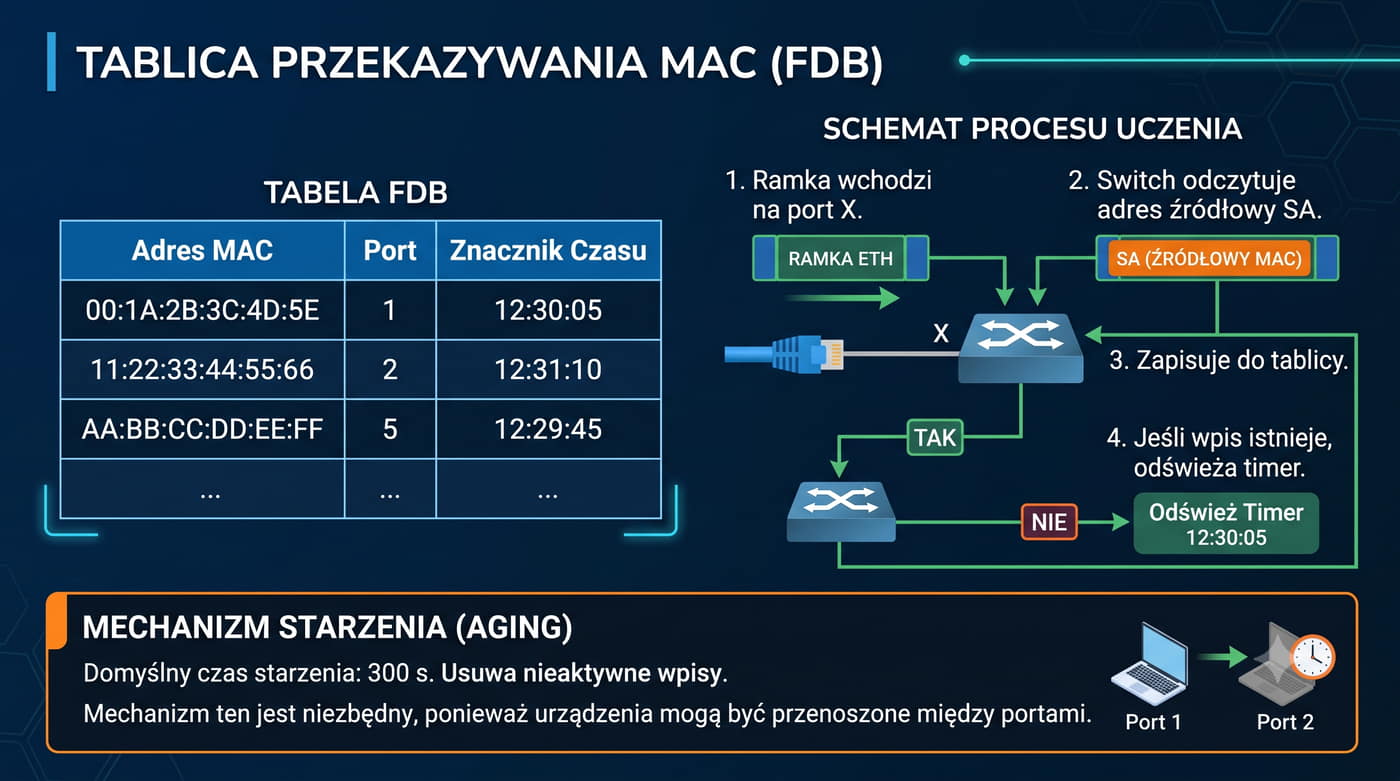
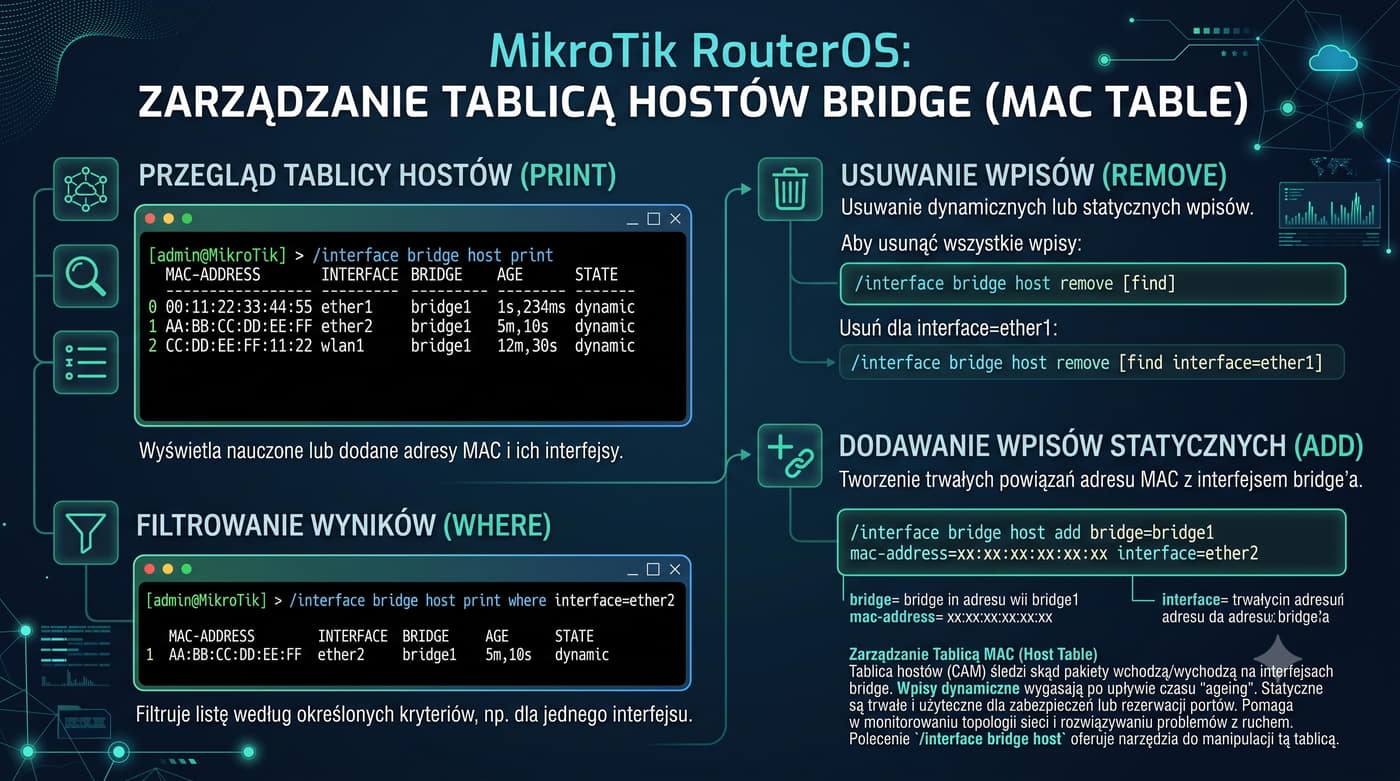
18/55 Tablica MAC (Forwarding Database)

Tablica przechowuje wpisy typu:

MAC_ADDR: Port, (np. 00:1A:2B:3C:4D:5E → Port 5)

Funkcje:

  • Learning - automatyczne dodawanie adresów źródłowych powiązanych z portem.
  • Forwarding - kierowanie ramek na podstawie wpisów.
  • Filtering - odrzucanie ramek, których adres docelowy i źródłowy znajdują się przy tym samym porcie.

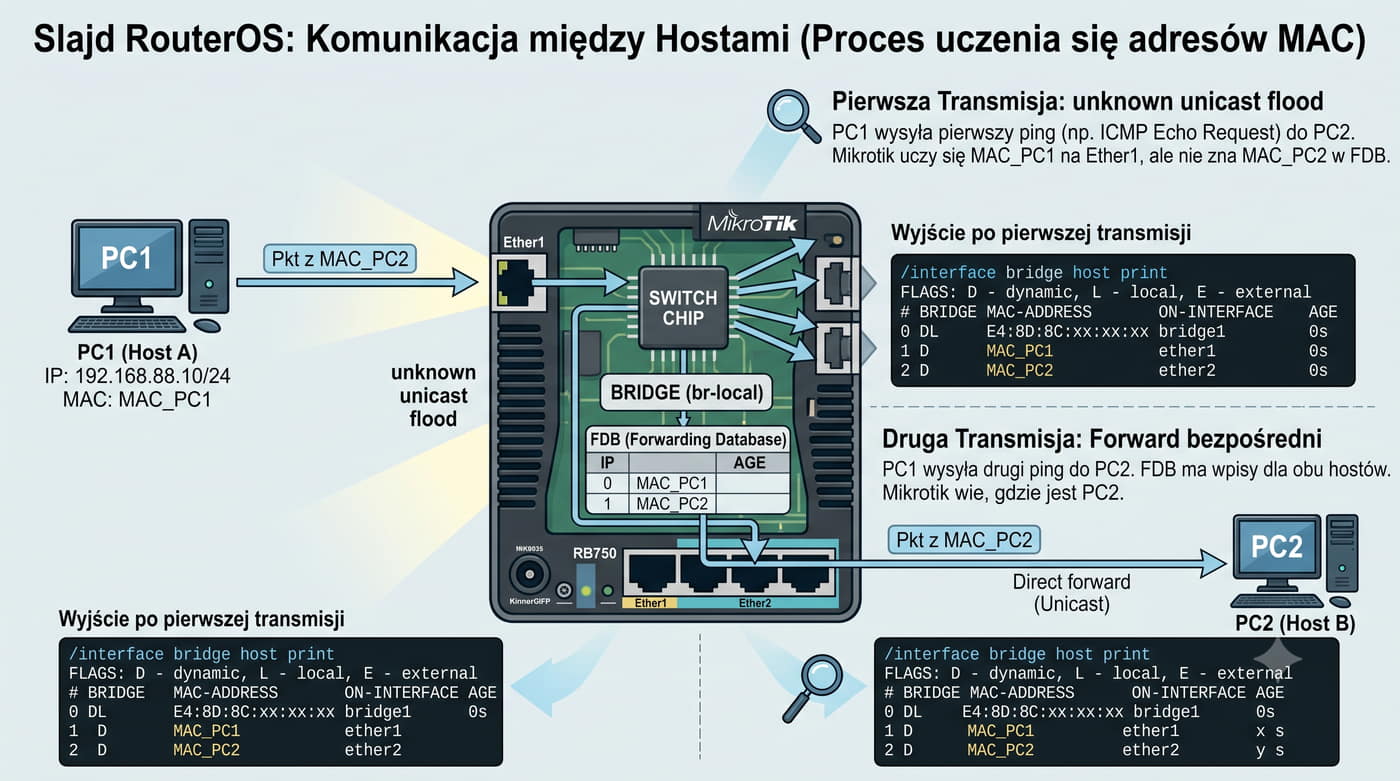
Tablica MAC, nazywana Forwarding Database (FDB) lub tablicą CAM, jest podstawowym mechanizmem umożliwiającym przełącznikowi podejmowanie decyzji o przekazywaniu ramek. Każdy wpis w tablicy zawiera adres MAC urządzenia, numer portu, do którego jest ono podłączone, oraz znacznik czasu ostatniej aktywności. Tablica jest budowana dynamicznie poprzez proces uczenia: gdy ramka wchodzi na określony port, przełącznik odczytuje adres źródłowy i jeśli nie ma go jeszcze w tablicy, dodaje nowy wpis. W stabilnej sieci większość urządzeń jest znana switchowi, dzięki czemu ramki unicast są przekazywane bezpośrednio do odpowiedniego portu.

W zarządzalnych przełącznikach administrator może ręcznie dodawać statyczne wpisy MAC, które nie podlegają procesowi starzenia. Przydaje się to przy serwerach krytycznych lub urządzeniach, których adres MAC nie powinien się zmieniać. Tablice MAC mogą być ograniczone do określonej liczby wpisów – typowy przełącznik dostępowy przechowuje od 8 do 64 tysięcy adresów. Przekroczenie tego limitu, na przykład w wyniku ataku MAC flooding, powoduje, że nowe adresy nie są już uczone (switch wchodzi w tryb fail-open) i zaczyna zalewać wszystkie porty ramkami unicast, co drastycznie obniża wydajność.

W zaawansowanych przełącznikach możliwe jest również tworzenie wpisów tymczasowych, które są automatycznie usuwane po rozłączeniu urządzenia. Mechanizm ten jest szczególnie przydatny w sieciach z dużą rotacją urządzeń, takich jak sieci gościnne czy hotele. Dzięki niemu tablica MAC nie ulega szybkiemu przepełnieniu, a administrator nie musi ręcznie czyścić nieaktualnych wpisów.

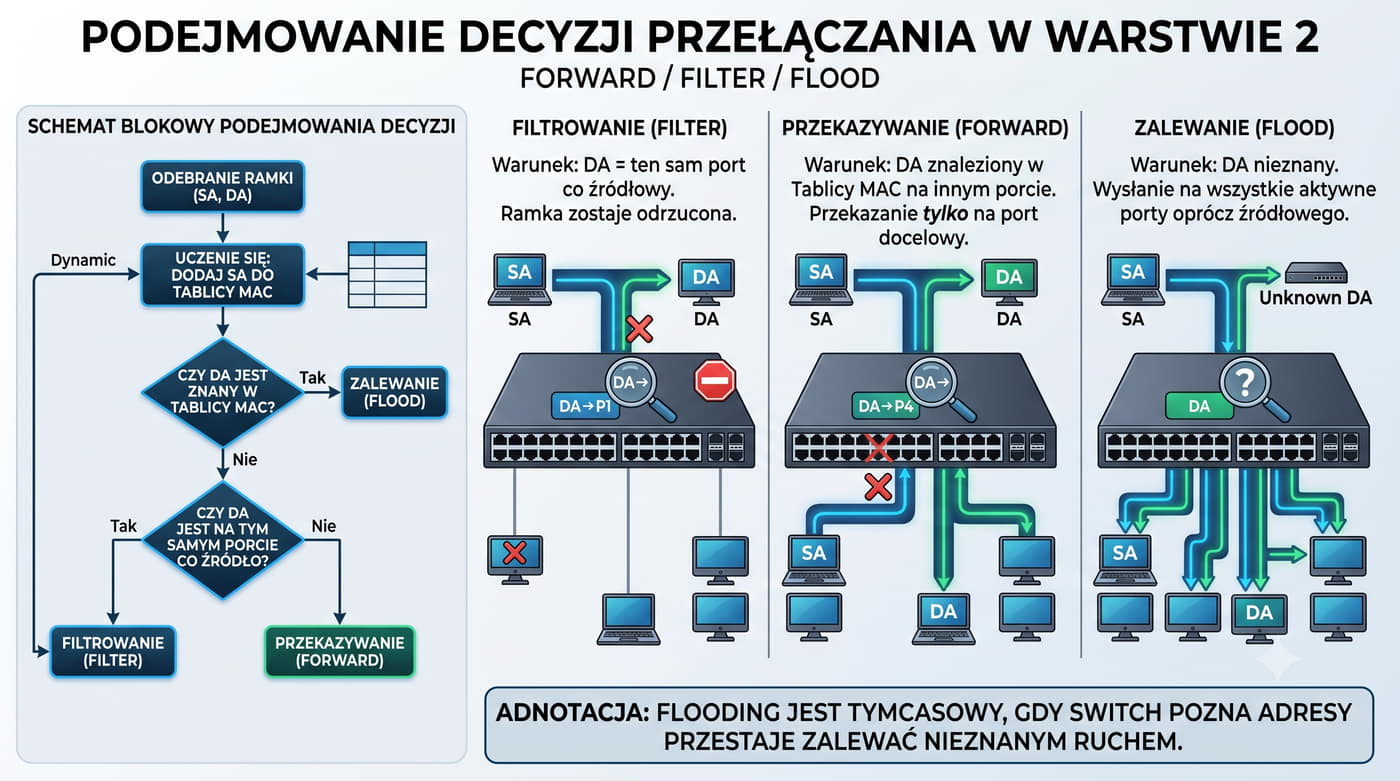
19/55 Decyzja przełączenia – forward/filter/flood

Decyzja o sposobie obsługi ramki jest podejmowana przez przełącznik w czasie rzeczywistym na podstawie adresu docelowego i zawartości tablicy MAC. Trzy możliwe scenariusze określają, co dzieje się z ramką w zależności od tego, czy adres docelowy jest znany i po której stronie przełącznika się znajduje.

Scenariusz 1: Forward (standardowy)

Ramka ma poprawny adres MAC docelowy w tablicy → przekazanie na odpowiedni port. To najczęstszy przypadek w ustabilizowanej sieci – przełącznik zna już położenie wszystkich aktywnych urządzeń i kieruje ramki bezpośrednio do celu, nie angażując pozostałych portów.

Scenariusz 2: Filter (blokowanie)

Ramka pasuje do reguły filtra (np. złośliwy port) → odrzucenie. Filtrowanie zachodzi również wtedy, gdy adres docelowy i źródłowy znajdują się przy tym samym porcie – ramka nie musi być przekazywana nigdzie indziej i zostaje odrzucona, co zapobiega niepotrzebnemu obciążaniu sieci.

Scenariusz 3: Flood (rozgłaszanie)

Ramka typu broadcast/multicast → wysłanie do wszystkich portów (oprócz MAC nadawcy). Zalewanie stosuje się tymczasowo także wtedy, gdy przełącznik nie zna jeszcze adresu docelowego. W stanie ustalonym flooding dotyczy wyłącznie ramek broadcast, multicast oraz rzadkich ramek unicast do urządzeń, które długo milczały.

Decyzja przełączenia (forward, filter lub flood) jest podejmowana przez ASIC w ciągu kilkuset nanosekund od odebrania pierwszych bajtów ramki. Forward (przekazanie) ma miejsce, gdy adres MAC docelowy znajduje się w tablicy CAM i jest przypisany do innego portu niż źródłowy. W tym scenariuszu ramka jest kierowana wyłącznie do portu docelowego, co minimalizuje obciążenie sieci. Filter (odrzucenie) zachodzi wtedy, gdy adres docelowy znajduje się przy tym samym porcie co źródłowy – ramka nie musi opuszczać portu wejściowego i jest natychmiast odrzucana. To przypadek typowy dla ruchu generowanego przez system operacyjny hosta do samego siebie (loopback).

Flood (zalewanie) stosuje się w trzech sytuacjach: gdy adres docelowy jest broadcastem, multicastem (jeśli switch nie stosuje IGMP snooping) lub gdy adresu unicast nie ma w tablicy CAM (unknown unicast). W każdym z tych przypadków ramka jest kopiowana na wszystkie porty należące do tej samej VLAN, z wyjątkiem portu źródłowego. Flooding jest niezbędny dla prawidłowego działania protokołów takich jak ARP czy DHCP, ale w nadmiarze może powodować degradację wydajności. Z tego względu nowoczesne przełączniki implementują mechanizmy ograniczające flooding, takie jak ograniczniki szybkości broadcastu (broadcast storm control).

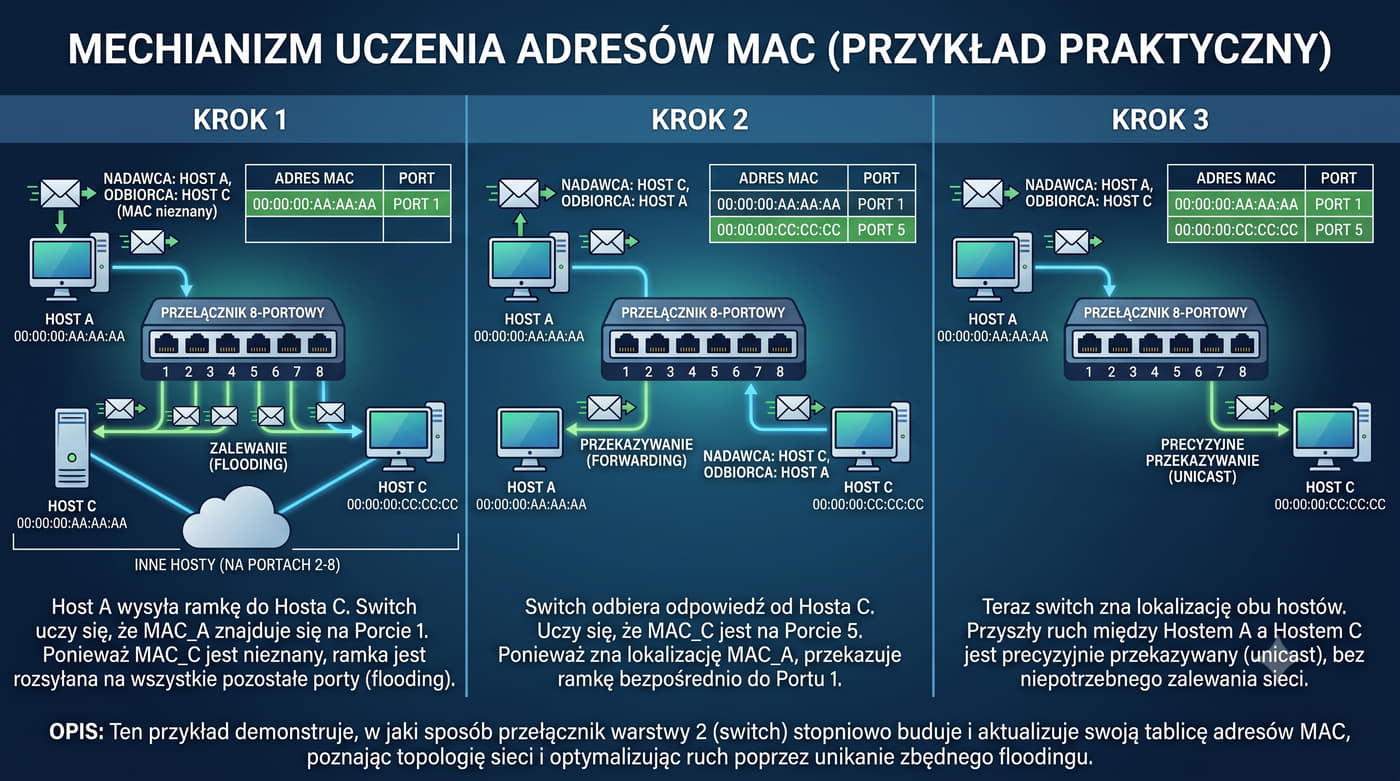
20/55 Mechanizm uczenia – przykład praktyczny

1. Krok 1: ARP Request od Hosta A

Host A wysyła zapytanie ARP (op-code 1) na adres broadcast sieci (FF:FF:FF:FF:FF:FF), aby uzyskać adres MAC Hosta C.

2. Krok 2: Odpowiedź od Hosta C

Tylko Host C (znający swój adres IP) odpowiada pakietem ARP Reply (op-code 2) z własnym adresem MAC.

3. Krok 3: Aktualizacja tablicy adresów MAC przez switch

Switch uczy się powiązania między adresem MAC Hosta C a numerem portu, zapisując wpis w pamięci CAM (Content-Addressable Memory).

4. Krok 4: Przekazywanie ruchu

Przyszłe pakiety do <IP_HostaC> są kierowane bezpośrednio do portu Hosta C (Store and Forward lub Cut-Through, w zależności od konfiguracji switcha).

Uwaga: W przypadku braku odpowiedzi ARP, ruch jest zalewany (BUM - Broadcast Unknown Unicast Multicast).

Proces uczenia adresów MAC w przełączniku najlepiej zilustrować na przykładzie komunikacji dwóch hostów w tej samej sieci LAN. Gdy host A wysyła ramkę do hosta C, przełącznik odczytuje adres źródłowy (MAC_A) i wiąże go z portem, na który ramka weszła (np. port 1). W tym momencie w tablicy CAM pojawia się wpis: MAC_A → port 1. Ponieważ przełącznik nie zna jeszcze adresu docelowego (MAC_C), ramka jest zalewana na wszystkie pozostałe porty. Host C odbiera ramkę i wysyła odpowiedź; wtedy przełącznik uczy się adresu MAC_C i wiąże go z portem hosta C (np. port 3).

Po drugiej wymianie ramek przełącznik zna już lokalizację obu urządzeń i może przekazywać ramki bezpośrednio między portami 1 i 3, bez zalewania pozostałych portów. W praktyce proces uczenia zachodzi w ciągu kilkuset mikrosekund od pierwszej transmisji. W sieciach z setkami urządzeń tablica CAM szybko się wypełnia aktywnymi wpisami. Ważne jest, aby czas starzenia wpisów (aging time) był ustawiony na odpowiednio wysoką wartość – zbyt krótki spowoduje niepotrzebne zalewanie, a zbyt długi może utrzymywać nieaktualne wpisy dla urządzeń, które zmieniły port lub zostały odłączone.

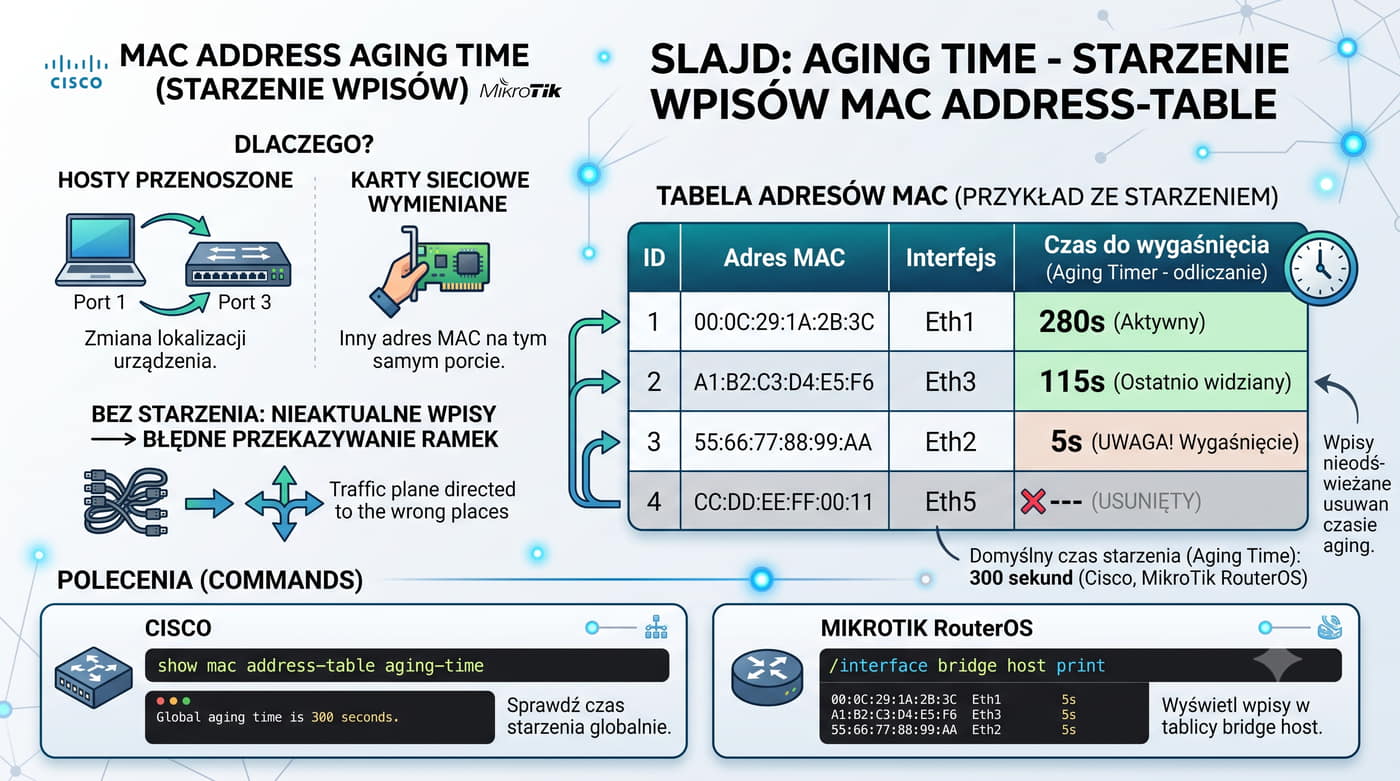
21/55 Aging Time – starzenie wpisów
  • Cel: Zapobieganie przepełnieniu tablicy CAM przez stale nieużywane wpisy.
  • Działanie: Po upływie czasu aging-time (domyślnie 300 sekund) wpisy są automatycznie usuwane, jeśli host nie wyśle nowej ramki z danego adresu MAC.
  • Przykład: Jeśli Host B nie komunikuje się przez 5 minut, jego wpis MAC zostanie usunięty, zwalniając miejsce w CAM.
  • Konfiguracja: Cisco IOS: mac address-table aging-time 300; RouterOS: /interface bridge set [find] aging-time=5m.

Mechanizm starzenia wpisów (Aging Time) zapobiega przepełnieniu tablicy CAM przez adresy urządzeń, które przestały być aktywne w sieci. Domyślna wartość czasu starzenia w większości przełączników wynosi 300 sekund (5 minut), ale może być konfigurowana w zakresie od 10 do 10 000 sekund. Po przekroczeniu tego czasu bez aktywności danego adresu źródłowego wpis jest usuwany, a zwolniona pamięć może zostać wykorzystana dla nowych urządzeń. Reset licznika starzenia następuje przy każdej ramce wysłanej przez dane urządzenie – jeśli host komunikuje się regularnie, jego wpis pozostaje w tablicy przez cały czas.

Wybór odpowiedniego czasu starzenia ma istotny wpływ na wydajność sieci. W sieciach z dużą mobilnością urządzeń (np. sieci Wi-Fi z roamingu) warto skrócić czas starzenia do 60–120 sekund, aby nie utrzymywać nieaktualnych wpisów. Z kolei w stacjonarnych sieciach biurowych można wydłużyć czas do 600 sekund, co zmniejsza częstotliwość zalewania (flooding) w przypadku sporadycznej komunikacji. W przełącznikach MikroTik RouterOS parametr ten konfiguruje się za pomocą polecenia /interface bridge set [find] aging-time=5m, a w Cisco IOS za pomocą polecenia mac address-table aging-time 300.

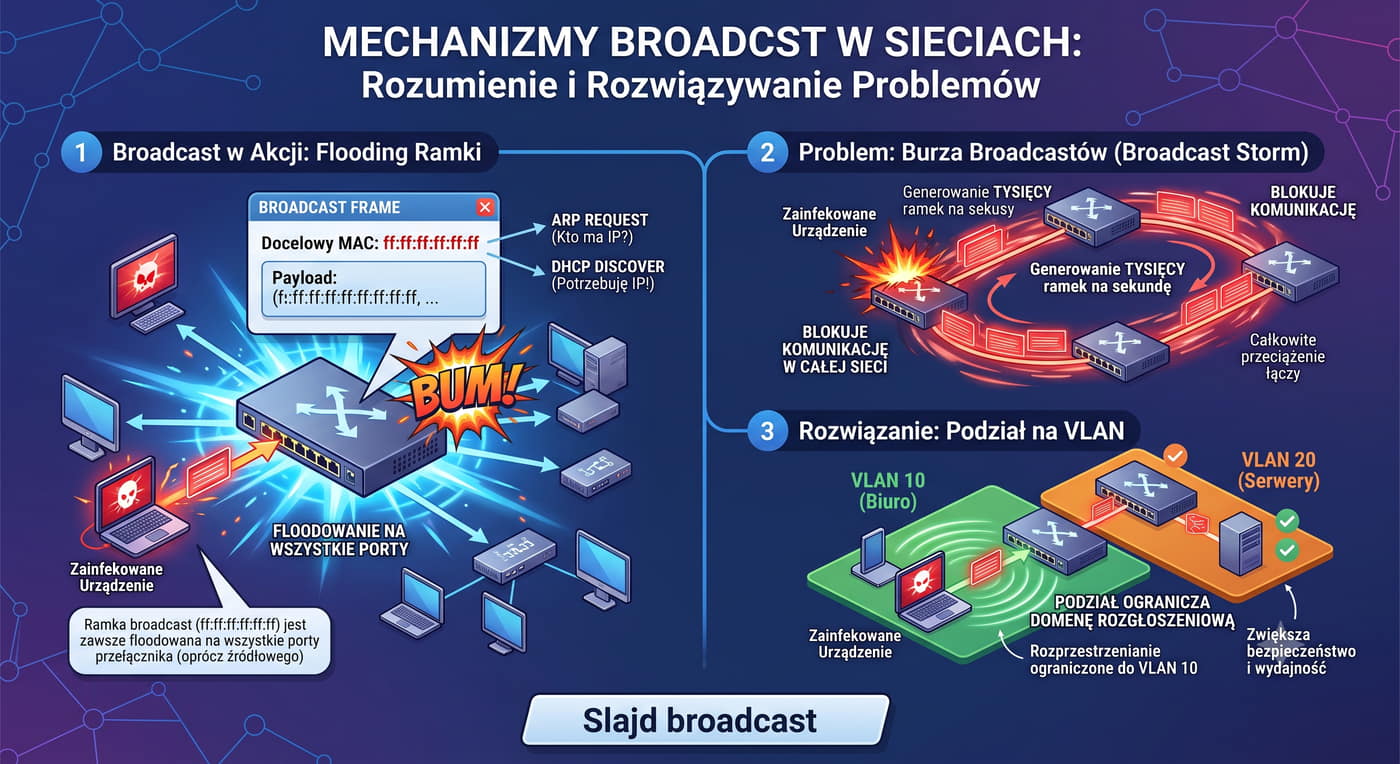
22/55 Ruch BUM – Broadcast
  • Źródła ruchu BUM:
  • Zapytania ARP (ARP Request / ARP Reply).
  • DHCP Discover / DHCP Request.
  • Pakiety broadcast (np. ping broadcast).
  • Adresy rozgłoszeniowe (np. FF:FF:FF:FF:FF:FF dla wszystkich hostów).
  • Zachowanie switcha: Ruch BUM jest domyślnie przekazywany do wszystkich portów w sieci VLAN, co może powodować przeciążenie.
  • Wpływ na wydajność: Zwiększony ruch i obciążenie CPU switcha, szczególnie przy dużej liczbie hostów.

Ruch BUM (Broadcast, Unknown Unicast, Multicast) stanowi wyzwanie dla każdej sieci przełączanej, ponieważ wymusza zalewanie ramek na wszystkie porty w domenie rozgłoszeniowej. Źródłami ruchu broadcast są przede wszystkim zapytania ARP, które hosty wysyłają w celu poznania adresu MAC odpowiadającego danemu adresowi IP. W sieci z 500 hostami każdy ARP request jest powielany do wszystkich 499 pozostałych urządzeń, co przy częstych zapytaniach może generować znaczny ruch. Podobnie zachowują się komunikaty DHCP (Discover, Request, Release) oraz zapytania NetBIOS w sieciach Windows.

Wpływ ruchu broadcast na wydajność sieci jest dwojaki. Po pierwsze, zajmuje pasmo na łączach – każda ramka broadcast jest wysyłana osobno na każdy port. Po drugie, każdy host musi przetworzyć odebraną ramkę broadcast, nawet jeśli nie jest jej adresatem. Proces ten angażuje procesor karty sieciowej i system operacyjny, co w przypadku częstych broadcastów może obniżyć wydajność stacji roboczych. Nowoczesne przełączniki implementują mechanizmy ograniczające skutki ruchu BUM: broadcast storm control (ograniczenie liczby broadcastów na sekundę), IGMP snooping (ograniczenie multicast) oraz blokowanie nieznanego unicastu (unknown-unicast-flood).

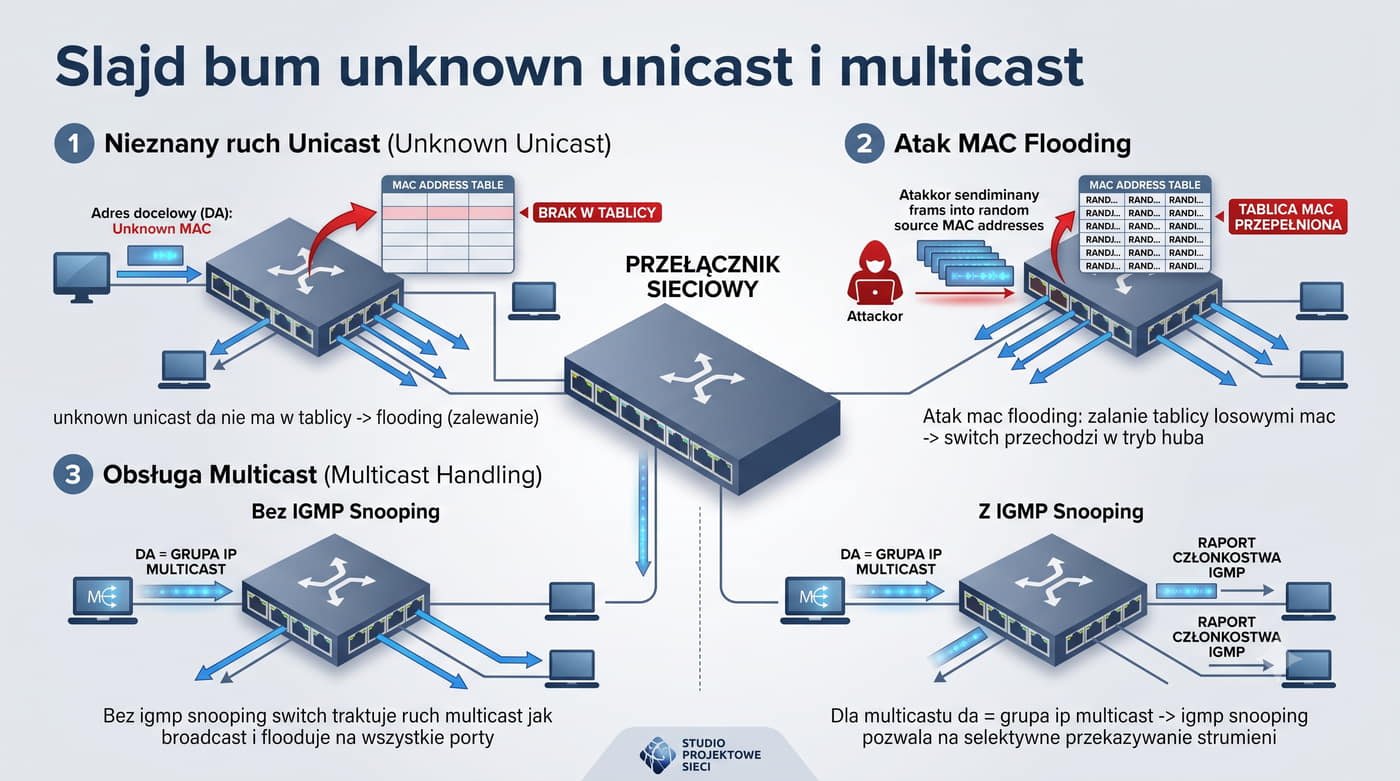
23/55 BUM – Unknown Unicast i Multicast
  • Unknown Unicast:
  • Pakiety wysłane na adres IP, którego MAC nie jest znany switchowi (np. nowy host w sieci).
  • Przekazywane do wszystkich portów w VLAN.
  • Multicast:
  • Ruch grupowy (np. streaming wideo) kierowany na adres multicast (np. 224.0.0.1).
  • Hosty dołączają za pomocą protokołu IGMP (IGMP Membership Report).
  • IGMP Snooping:
  • Switch nasłuchuje zapytań IGMP od hostów i aktualizuje grupy multicastowe.
  • Zmniejsza ruch rozgłoszeniowy, optymalizując przepustowość.

Unknown Unicast to ramka unicast, której adres docelowy nie znajduje się w tablicy CAM przełącznika. Sytuacja taka występuje, gdy urządzenie po raz pierwszy komunikuje się z innym hostem lub gdy wpis dla danego adresu wygasł (aging). W takim przypadku przełącznik traktuje ramkę podobnie jak broadcast – zalewa wszystkie porty w danej VLAN. Po otrzymaniu odpowiedzi od adresata przełącznik uczy się jego lokalizacji i kolejne ramki są już przekazywane bezpośrednio. Problem unknown unicast jest szczególnie dotkliwy w sieciach z dużą liczbą hostów, gdzie częste wygasanie wpisów prowadzi do ciągłego zalewania.

Ruch multicast (grupa adresów od 224.0.0.0 do 239.255.255.255) jest używany przez protokoły strumieniowe, takie jak IPTV, wideokonferencje czy gry sieciowe. Bez odpowiednich mechanizmów przełącznik traktuje multicast jak broadcast i zalewa wszystkie porty. Rozwiązaniem jest protokół IGMP Snooping, który pozwala przełącznikowi nasłuchiwać komunikatów IGMP wymienianych między hostami a routerem multicast. Switch zapamiętuje, które porty są zainteresowane danym strumieniem multicast i przekazuje ramki tylko do tych portów. Znacznie oszczędza to pasmo, szczególnie w sieciach z wieloma strumieniami wideo.

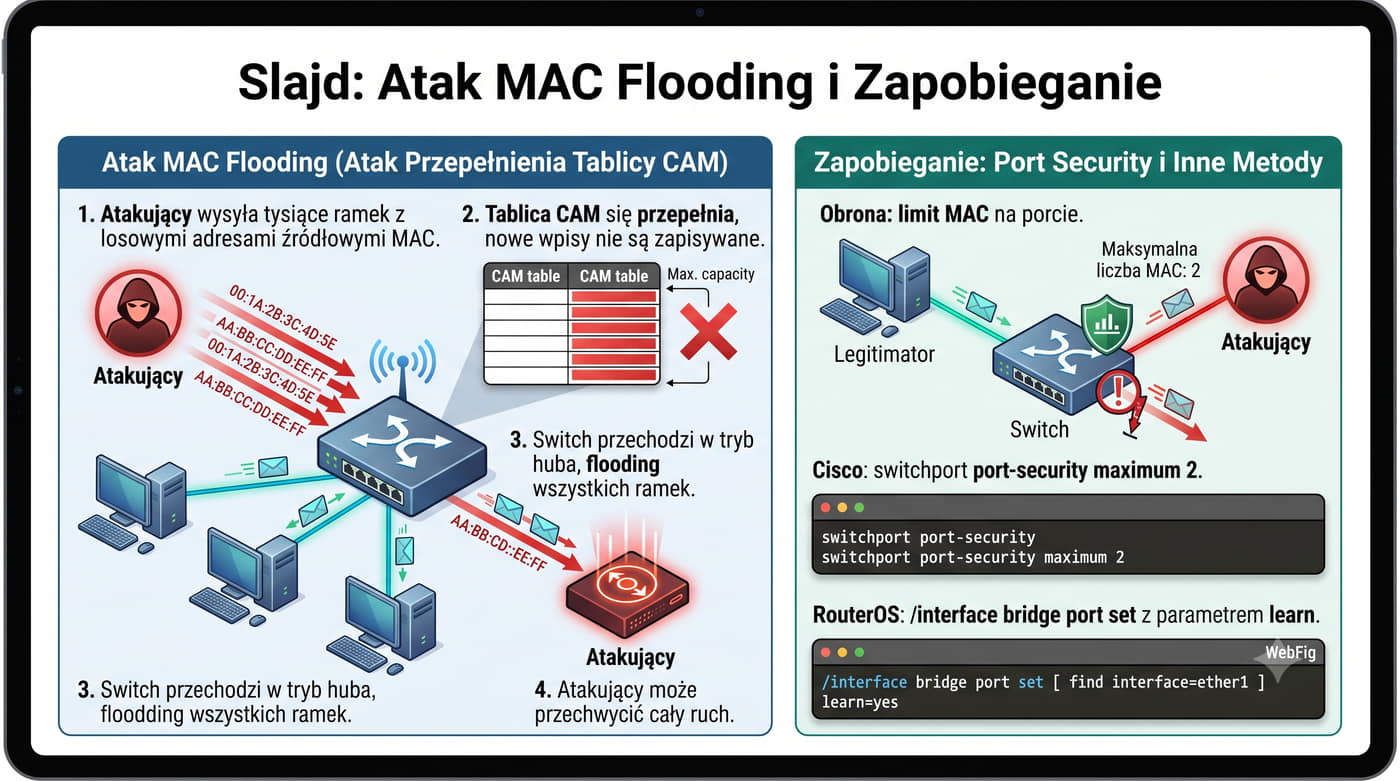
24/55 MAC Flooding – atak i zapobieganie
  • Mechanizm ataku (MAC Flooding):

1. Atakujący wysyła masowo ramki z losowymi, nieistniejącymi adresami MAC źródłowymi dla różnych adresów IP w sieci.

Cisco:
switchport port-security maximum 2
switchport port-security mac-address sticky
RouterOS:
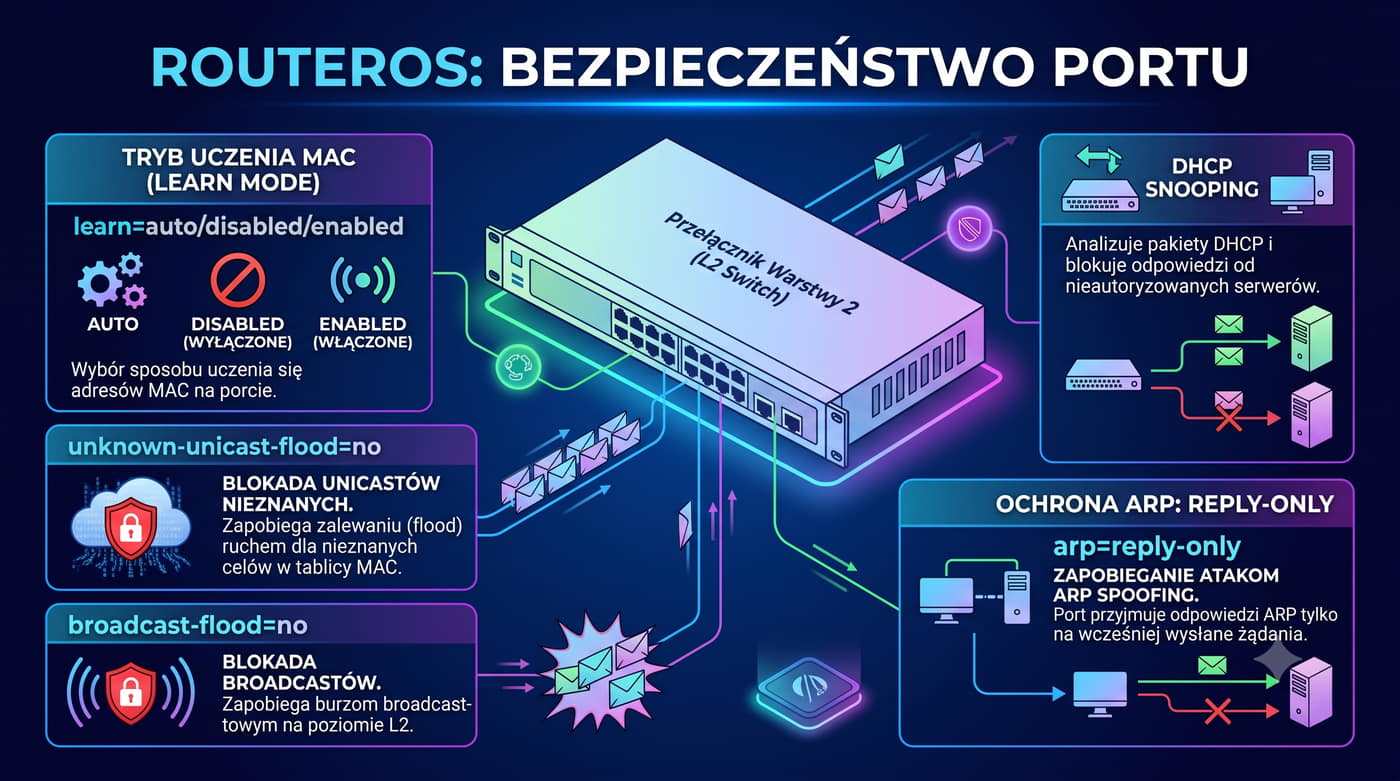
/interface bridge port set [find interface=ether1] learn=no

2. Switch próbuje uczyć się adresów MAC, przepełniając tablicę CAM.

3. Przeciążenie prowadzi do utraty pakietów (odrzucanie ramek), wysokiego obciążenia CPU i niestabilności sieci.

  • Obrona (Port Security):
  • Ogranicza liczbę wpisów MAC na porcie (np. port-security 4 - maks. 4 wpisy).
  • Po przekroczeniu limitu port jest wyłączany lub wymaga ręcznej interwencji.
  • Zapobiega nieautoryzowanym urządzeniom i atakom flood.

Atak MAC Flooding polega na wysłaniu do przełącznika ogromnej liczby ramek z losowymi, nieistniejącymi adresami źródłowymi. Celem ataku jest przepełnienie tablicy CAM, która ma ograniczoną pojemność (np. 8192 wpisów). Po przekroczeniu limitu przełącznik przechodzi w tryb fail-open – przestaje się uczyć nowych adresów i zaczyna traktować wszystkie ramki unicast jak unknown unicast, czyli zalewa je na wszystkie porty. W tym momencie atakujący może przechwycić ruch między innymi hostami za pomocą sniffera, omijając w ten sposób mechanizm izolacji portów. Atak jest łatwy do przeprowadzenia za pomocą narzędzi takich jak macof z pakietu dsniff.

Zabezpieczeniem przed MAC Flooding jest funkcja Port Security, dostępna w zarządzalnych przełącznikach Cisco, MikroTik i innych. Polega ona na ograniczeniu maksymalnej liczby adresów MAC, które mogą być uczone na danym porcie (np. 2 lub 4). Po przekroczeniu limitu switch może zablokować port, wysłać alert (SNMP trap) lub skasować nadmiarowe wpisy. W Cisco IOS konfiguracja wygląda następująco: switchport port-security maximum 2, a w RouterOS: /interface bridge port set [find interface=ether1] learn=no. Dodatkowym zabezpieczeniem jest blokowanie nieznanego unicastu (unknown-unicast-flood=no), co uniemożliwia podsłuchiwanie ruchu nawet po przepełnieniu tablicy CAM.

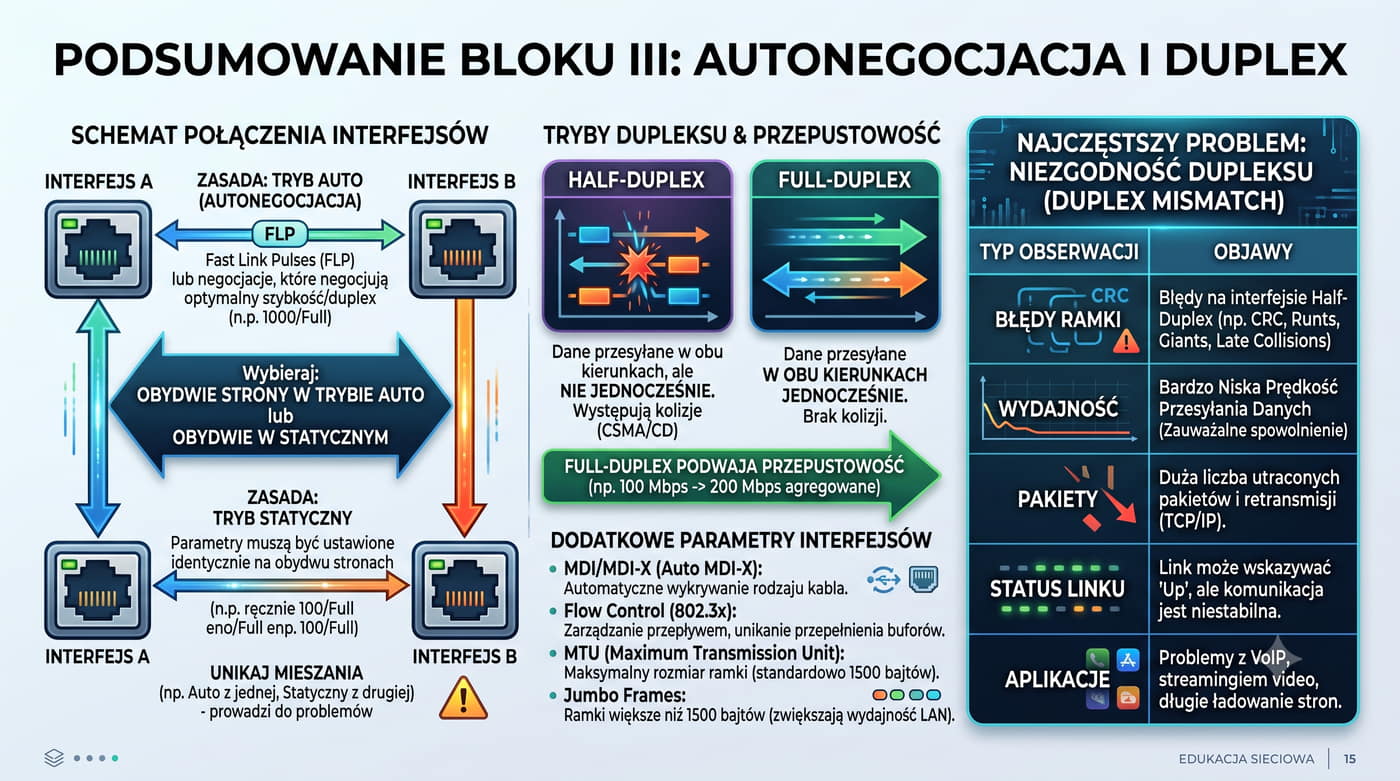
25/55 Autonegocjacja – jak działa

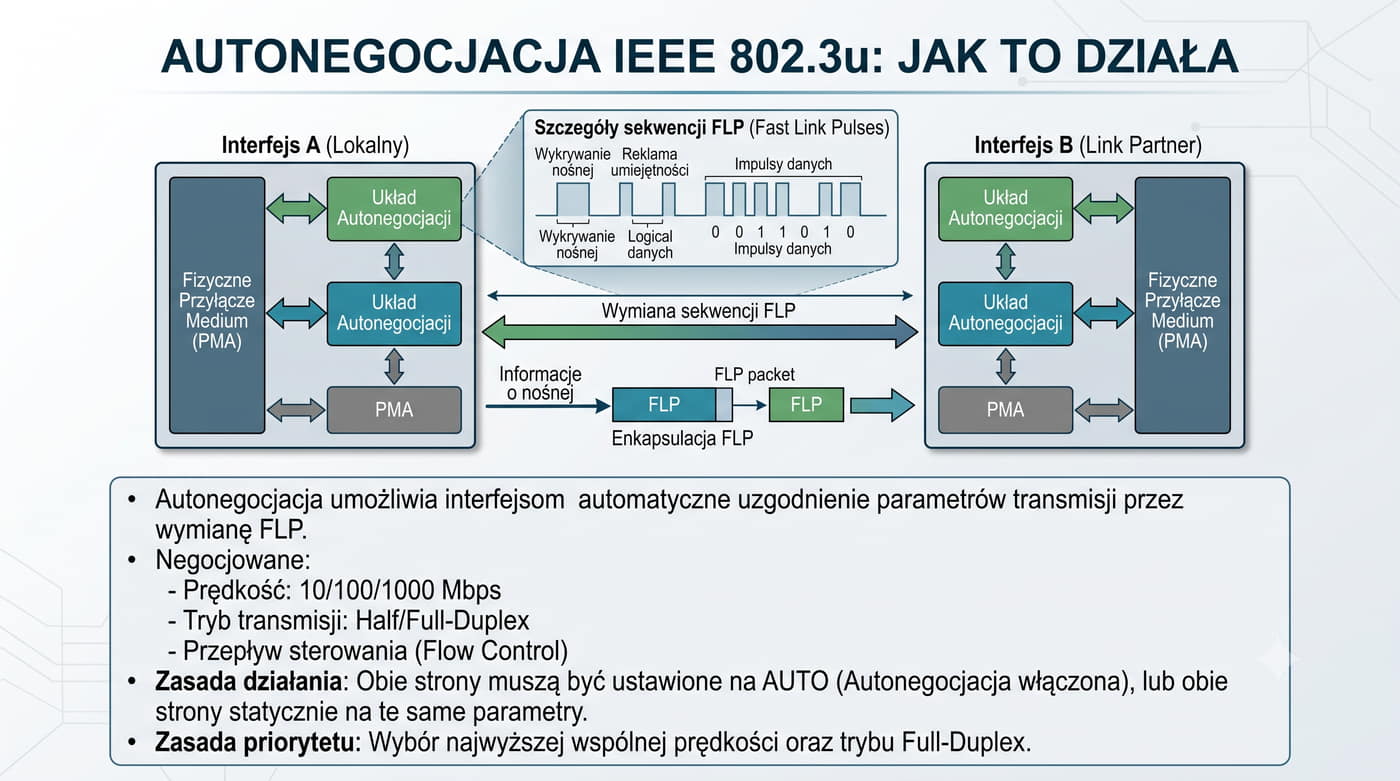
Autonegocjacja to proces automatycznego wykrywania i uzgadniania parametrów transmisji między urządzeniami sieciowymi (np. przełącznikami, komputerami). Obejmuje ustalenie prędkości (10 Mbps, 100 Mbps, 1000 Mbps) oraz trybu duplex (half/full). Proces rozpoczyna się po nawiązaniu połączenia i trwa zazwyczaj od 0,5 do kilku sekund. Urządzenia wybierają najwyższą wspólną prędkość i dupleks, na jaki pozwala okablowanie i możliwości sprzętowe. Jeśli nie ma zgodności, stosowana jest niższa konfiguracja.

Autonegocjacja (auto-negotiation) to mechanizm zdefiniowany w standardzie IEEE 802.3u, który pozwala dwóm urządzeniom Ethernet automatycznie uzgodnić parametry połączenia fizycznego. Proces rozpoczyna się bezpośrednio po nawiązaniu łącza (link up) i trwa zazwyczaj od 0,5 do kilku sekund. Urządzenia wymieniają specjalne impulsy FLP (Fast Link Pulses), w których kodują informacje o swoich możliwościach: obsługiwane prędkości (10/100/1000 Mbps), tryb duplex (half/full) oraz ewentualne funkcje dodatkowe (np. flow control). Negocjacja odbywa się według zasady wspólnego mianownika – wybierana jest najwyższa prędkość i najlepszy tryb duplex obsługiwany przez obie strony.

Jeśli jedno z urządzeń nie wspiera autonegocjacji (np. starsza karta sieciowa z ręcznie ustawionym parametrem), drugie urządzenie musi zastosować mechanizm rozpoznawania (parallel detection). Polega on na wykryciu, jaka prędkość sygnalizacji jest używana, i automatycznym dopasowaniu się do niej. W trybie parallel detection duplex jest zawsze ustawiany na half-duplex, ponieważ nie ma możliwości negocjacji tego parametru. To właśnie prowadzi do najczęstszego problemu z autonegocjacją: niezgodności dupleksu, gdy jedno urządzenie pracuje w full-duplex, a drugie w half-duplex. Taka sytuacja powoduje utratę pakietów i konieczność ręcznej interwencji.

26/55 Problemy z autonegocjacją

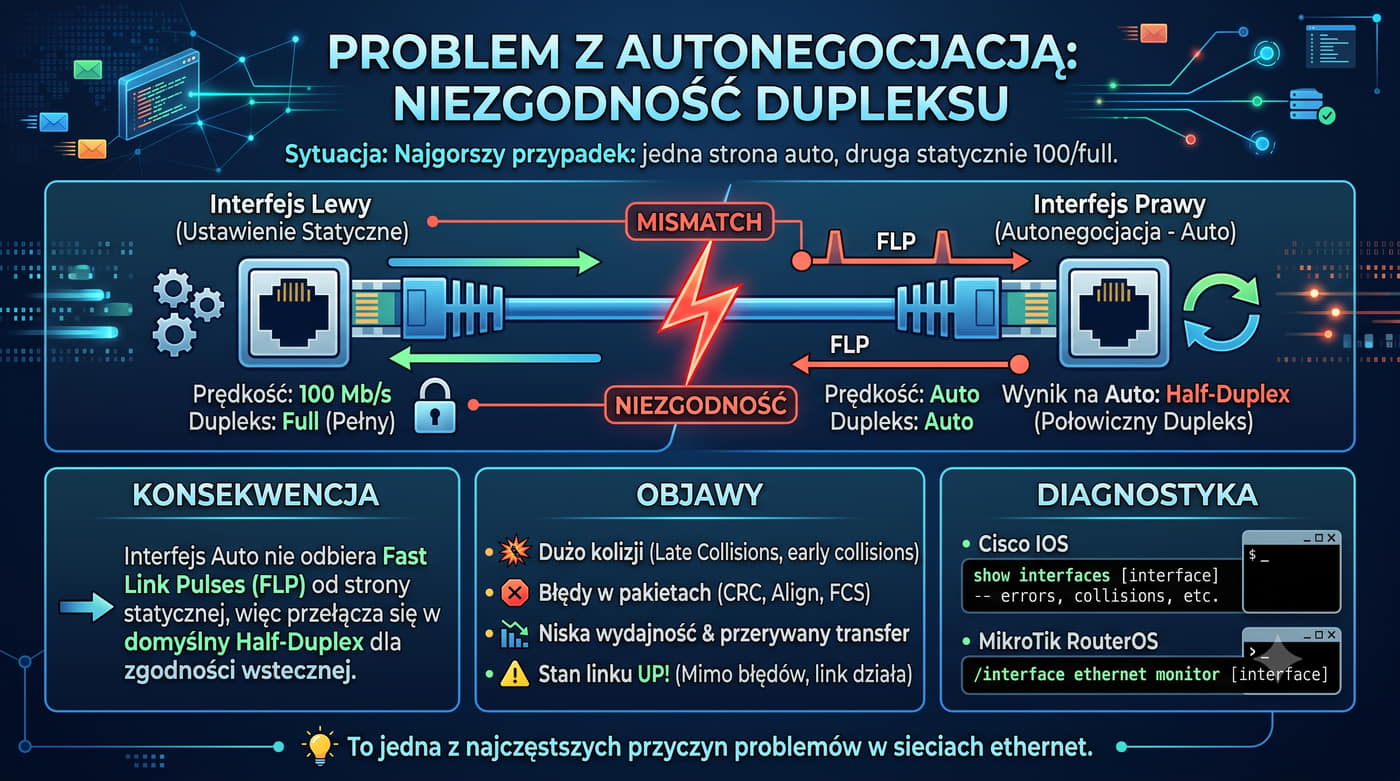
Niezgodność dupleksu występuje, gdy jedno urządzenie ustawia tryb full-duplex, a drugie half-duplex. Skutkuje to: kolizjami ramek (w half-duplex), błędami przepływu i spadkiem wydajności. Przyczyny to: błędna konfiguracja portów, uszkodzone kable, niekompatybilne urządzenia lub starsze standardy (np. 10BASE-T bez wsparcia full-duplex). Rozwiązanie: ręczne wymuszenie tego samego trybu duplex na obu portach (np. ustawienie "half" lub "full").

Najczęstszym problemem związanym z autonegocjacją jest niezgodność dupleksu (duplex mismatch), która powstaje, gdy jedno urządzenie ma włączoną autonegocjację, a drugie ma ręcznie ustawiony tryb full-duplex. W takiej sytuacji urządzenie z autonegocjacją wykrywa prędkość za pomocą parallel detection, ale domyślnie ustawia half-duplex. Drugie urządzenie pracuje w full-duplex, wysyłając ramki bez nasłuchiwania medium. W rezultacie pierwsze urządzenie, pracując w half-duplex, wykrywa kolizje (gdy oba urządzenia nadają jednocześnie) i odrzuca ramki. Objawem problemu są liczne błędy CRC, ramki kolizyjne (collision fragments) oraz drastyczny spadek przepustowości.

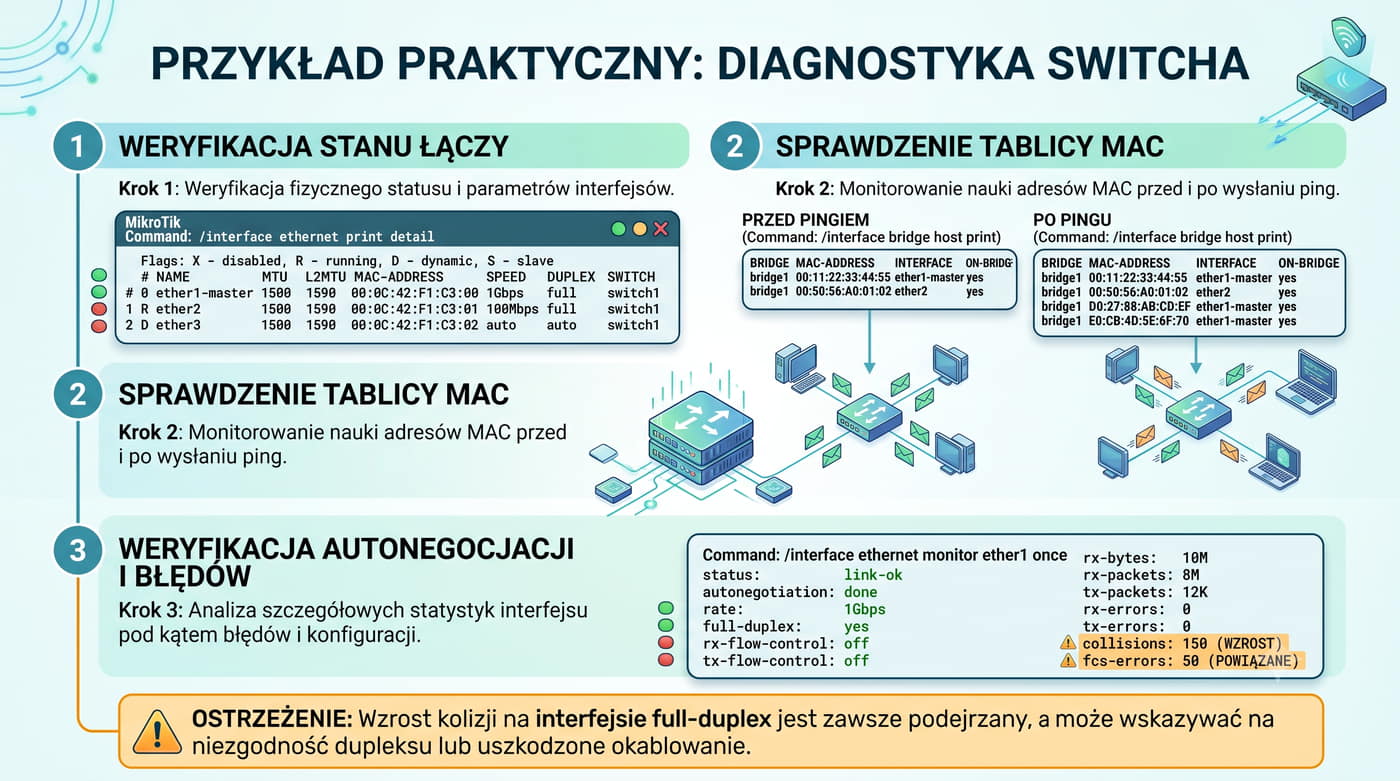
Diagnostyka niezgodności dupleksu wymaga analizy statystyk interfejsu: show interfaces w Cisco IOS lub /interface ethernet monitor w RouterOS. Wskaźnikami problemu są szybko narastające liczniki collisions, late collisions oraz runts. Rozwiązaniem jest ręczne wymuszenie tego samego trybu duplex na obu końcach łącza, najlepiej full-duplex. W sieciach produkcyjnych zaleca się włączenie autonegocjacji na wszystkich portach zarówno po stronie przełącznika, jak i hosta. Problem niezgodności dupleksu występuje najczęściej przy starzejącym się sprzęcie lub po wymianie jednego urządzenia bez odpowiedniej konfiguracji drugiego.

27/55 Duplex – half vs full
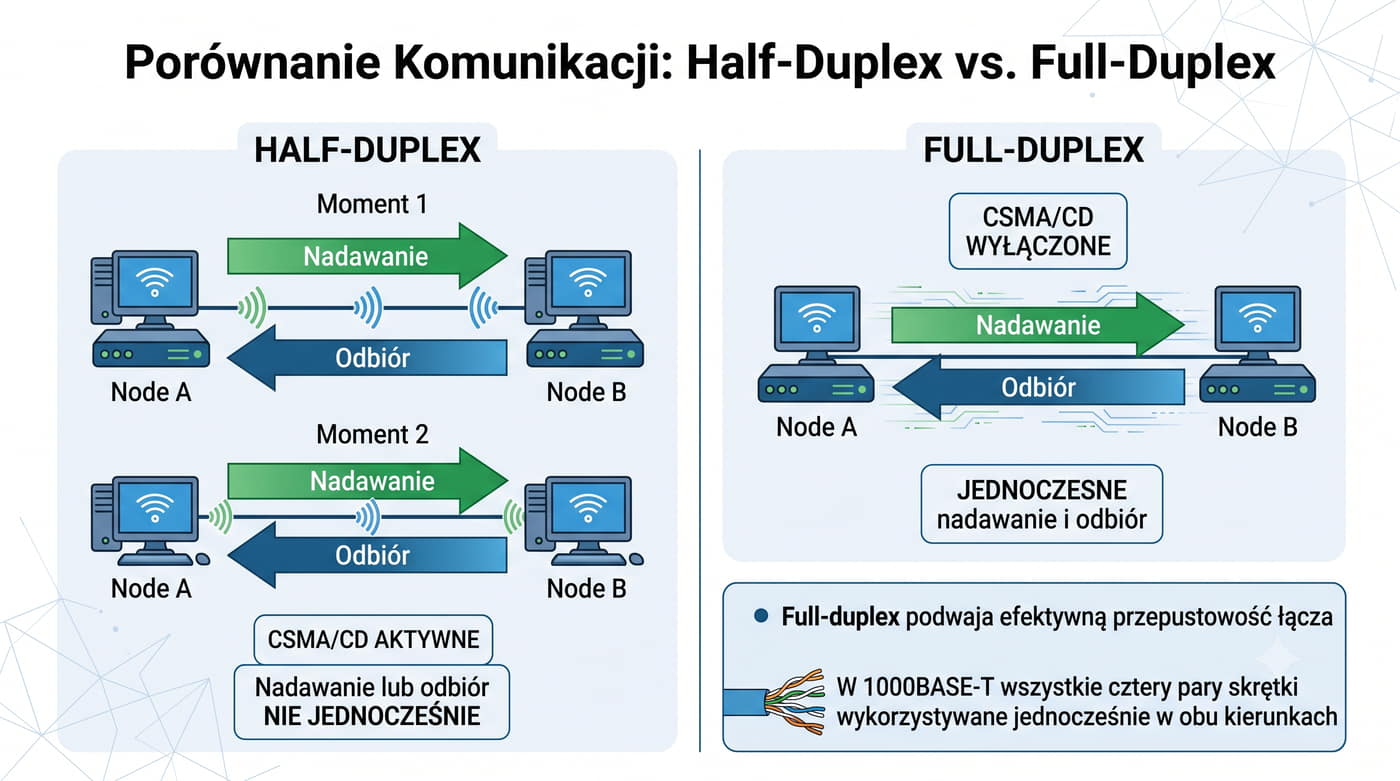
  • Half-duplex: Transmisja naprzemienna (urządzenia na zmianę nadają i odbierają). Ogranicza przepustowość do połowy teoretycznej prędkości. Stosowany w starszych sieciach lub gdy budżet/wydajność nie wymagają pełnego dupleksu.
  • Full-duplex: Transmisja symetryczna (urządzenia mogą nadawać i odbierać jednocześnie). Wykorzystuje oddzielne pary przewodów do nadawania i odbioru, eliminując mechanizm CSMA/CD. Wymaga wsparcia sprzętowego.
Podsumowanie: Half-duplex = oszczędność, Full-duplex = maksymalna wydajność (idealny dla serwerów, przełączników szkieletowych).

W trybie half-duplex urządzenie może w danej chwili nadawać lub odbierać, ale nie obie te czynności jednocześnie. Ramki są przesyłane na przemian, a mechanizm CSMA/CD zapobiega kolizjom przez nasłuchiwanie medium przed rozpoczęciem nadawania. Half-duplex był standardem w erze koncentratorów (hubów), gdzie wszystkie urządzenia współdzieliły to samo pasmo. W praktyce wydajność łącza half-duplex jest ograniczona do około 40–50% teoretycznej przepustowości nominalnej, ponieważ część czasu jest tracona na nasłuchiwanie, oczekiwanie i retransmisje po kolizjach.

Tryb full-duplex pozwala na jednoczesne nadawanie i odbiór danych, co teoretycznie podwaja przepustowość łącza. W Ethernet skrętce dwie pary przewodów służą do nadawania, a dwie do odbioru, więc nie ma ryzyka kolizji własnych ramek. Full-duplex wymaga bezpośredniego połączenia punkt-punkt (switch–host lub switch–switch) bez pośrednictwa huba. Większość nowoczesnych interfejsów Ethernet pracuje domyślnie w trybie full-duplex, a half-duplex jest używany wyłącznie w sprzęcie starszej generacji lub w sytuacjach awaryjnych. W sieciach szkieletowych full-duplex jest standardem, a agregacja łączy (LACP) pozwala na dalsze zwiększanie przepustowości.

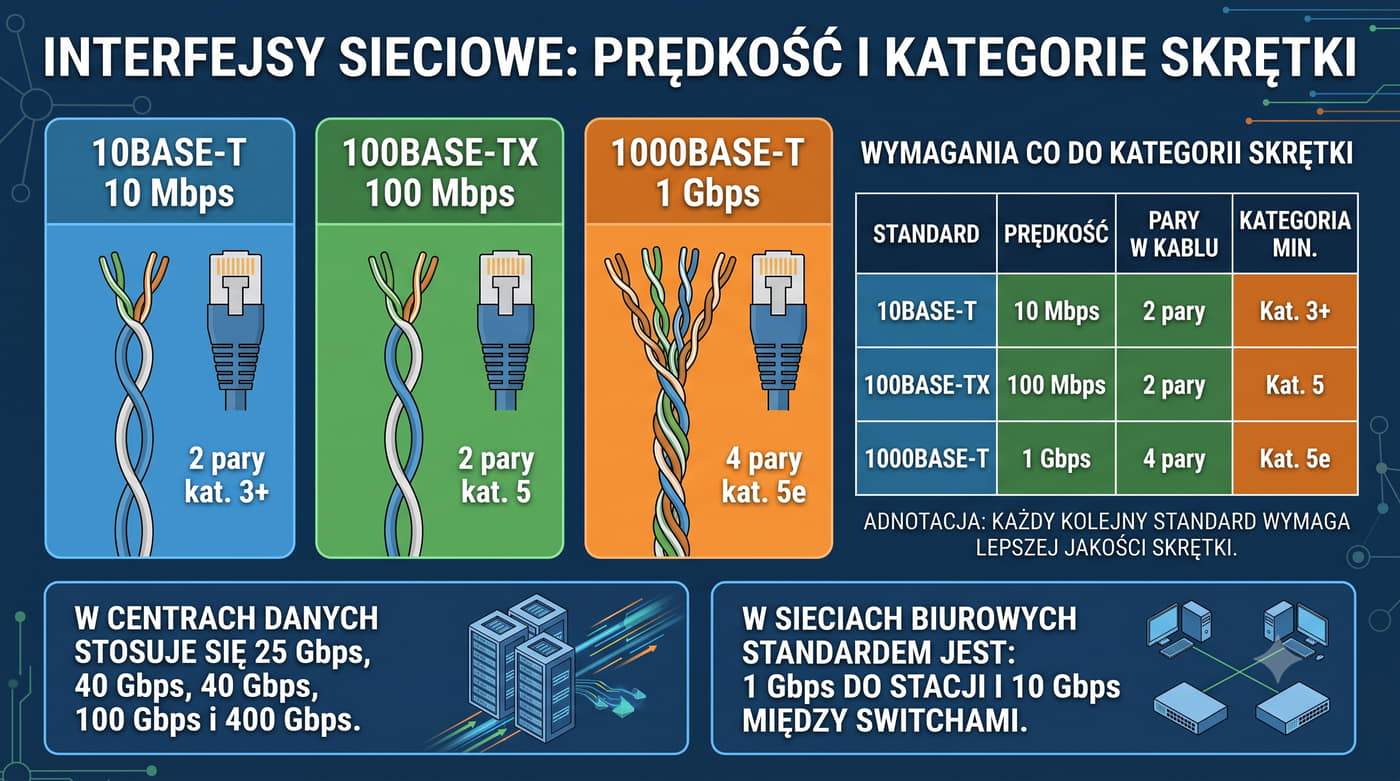
28/55 Prędkość interfejsu – 10/100/1000 Mbps
  • 10BASE-T: 10 Mbps na skrętce UTP (kategoria 3 lub 5), zasięg do 100 m.
  • 100BASE-TX: 100 Mbps, wykorzystuje 2 pary przewodów skrętki (kategoria 5e/6), zasięg do 100 m.
  • 1000BASE-T: 1 Gbps, używa wszystkich 4 par skrętki (kategoria 5e/6/7), zasięg do 100 m.

Autonegocjacja automatycznie wybiera najlepszą prędkość w ramach możliwości kabla i urządzeń.

Standard Ethernet oferuje trzy podstawowe prędkości interfejsów w sieciach przewodowych: 10 Mbps (10BASE-T), 100 Mbps (100BASE-TX) oraz 1000 Mbps (1000BASE-T). Mimo upływu lat te trzy wartości wciąż są powszechnie spotykane, szczególnie w urządzeniach starszej generacji lub w instalacjach, gdzie wyższe przepustowości nie są konieczne. Standard 10BASE-T, zdefiniowany w IEEE 802.3i, wykorzystuje dwie pary skrętki kategorii 3 lub wyższej i zasięg do 100 metrów. 100BASE-TX (IEEE 802.3u) wymaga skrętki kategorii 5 i również dwóch par przewodów, oferując dziesięciokrotnie wyższą przepustowość przy zachowaniu tego samego zasięgu.

Gigabit Ethernet (1000BASE-T, IEEE 802.3ab) stanowi przełom, wykorzystując wszystkie cztery pary skrętki kategorii 5e lub wyższej. Każda para transmituje 250 Mbps, a łączna przepustowość 1000 Mbps osiągana jest dzięki kodowaniu PAM-5. Gigabit Ethernet jest obecnie standardem w sieciach lokalnych – każdy nowy komputer i przełącznik dostępowy obsługuje 1000BASE-T. W sieciach szkieletowych i data center stosuje się coraz częściej 10 Gbps (10GBASE-T) lub włókna światłowodowe, ale 1000BASE-T pozostaje podstawowym interfejsem dla stacji roboczych i serwerów w większości firm.

W sieciach nowej generacji coraz częściej stosuje się standardy 2.5GBASE-T i 5GBASE-T, które pozwalają na osiągnięcie prędkości 2,5 i 5 Gbps na istniejącym okablowaniu kategorii 5e i 6. Jest to szczególnie korzystne w przypadku modernizacji sieci WiFi, gdzie punkt dostępowy 802.11ax (WiFi 6) wymaga łącza o przepustowości co najmniej 2,5 Gbps. Standardy te zachowują kompatybilność wsteczną z 1000BASE-T.

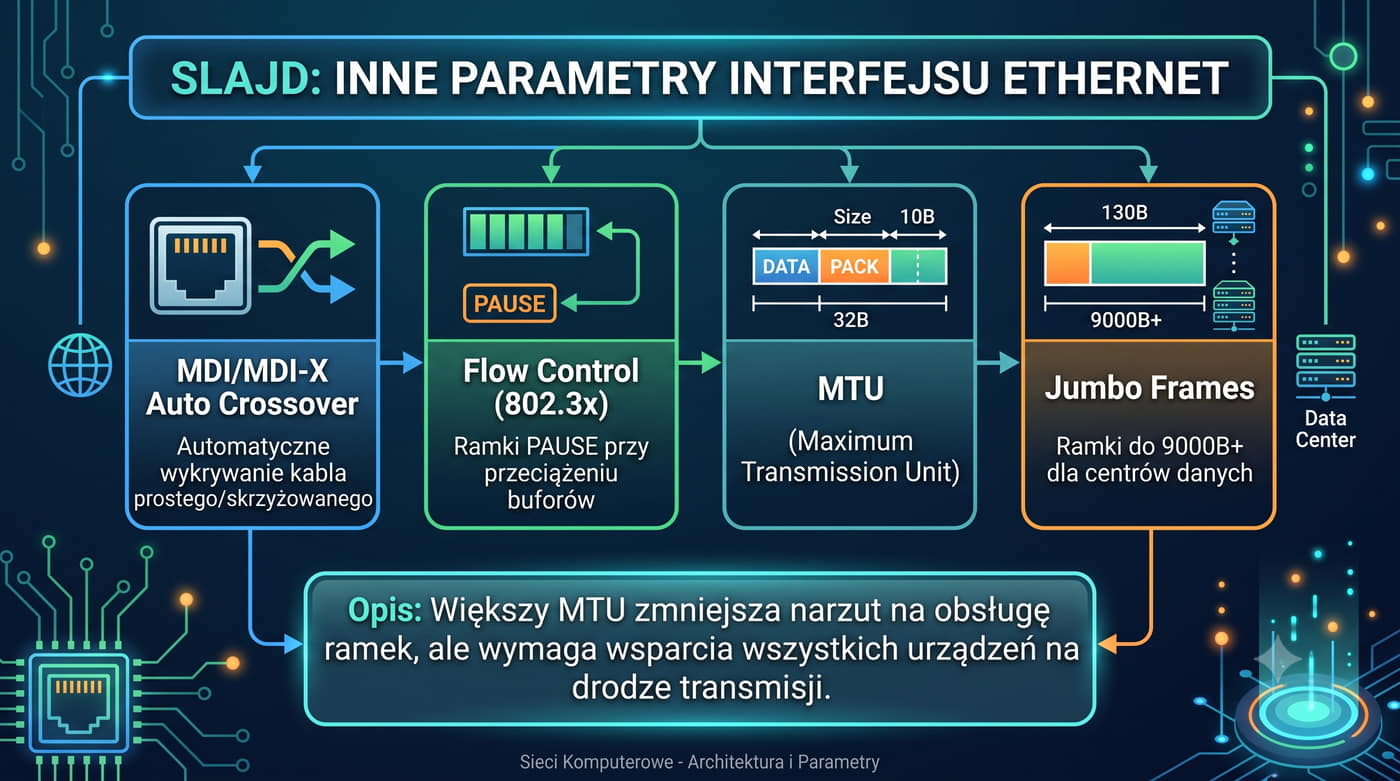
29/55 Inne parametry interfejsu Ethernet
  • MDI (Medium Dependent Interface): Standardowy interfejs dla połączeń typu host-przełącznik (kabel prosty).
  • MDI-X: Automatyczne wykrywanie typu połączenia (eliminuje potrzebę ręcznego ustawiania "crossover").
  • Flow Control: Mechanizm kontroli przepływu danych (rzadko używany w nowoczesnych sieciach).
  • MTU (Maximum Transmission Unit): Domyślnie 1500 B (dla Ethernet), możliwość zwiększenia do 9000 B (Jumbo Frames) – poprawia przepustowość, ale wymaga kompatybilności na całej ścieżce.

Oprócz prędkości i trybu duplex interfejs Ethernet ma wiele innych parametrów konfiguracyjnych, które wpływają na jego działanie. Auto-MDI/MDI-X (Auto Crossover) wykrywa, czy kabel jest prosty (straight-through) czy krosowany (crossover), i automatycznie dostosowuje układ pinów. Eliminuje to konieczność stosowania specjalnych kabli do łączenia przełączników lub kart sieciowych. Wszystkie nowoczesne interfejsy Gigabit Ethernet obsługują Auto MDI/X zgodnie ze standardem IEEE 802.3ab. Kolejnym ważnym parametrem jest kontrola przepływu (Flow Control), zdefiniowana w IEEE 802.3x, która pozwala urządzeniu wysłać ramkę PAUSE, aby zatrzymać nadawanie w przypadku przeciążenia bufora.

MTU (Maximum Transmission Unit) to maksymalny rozmiar ramki Ethernet, która może być przesłana bez fragmentacji. Domyślna wartość to 1500 bajtów, ale w sieciach szkieletowych często stosuje się ramki Jumbo (Jumbo Frames) o MTU 9000 bajtów. Większe ramki zmniejszają narzut na nagłówki i liczbę przerwań procesora na karcie sieciowej, poprawiając wydajność transferów dużych plików. Jumbo Frames wymagają jednak wsparcia na całej ścieżce transmisji – od karty źródłowej, przez przełączniki, aż do karty docelowej. Niespójne ustawienie MTU może prowadzić do ciszy (black hole), gdy ramki są odrzucane bez informacji zwrotnej do nadawcy.

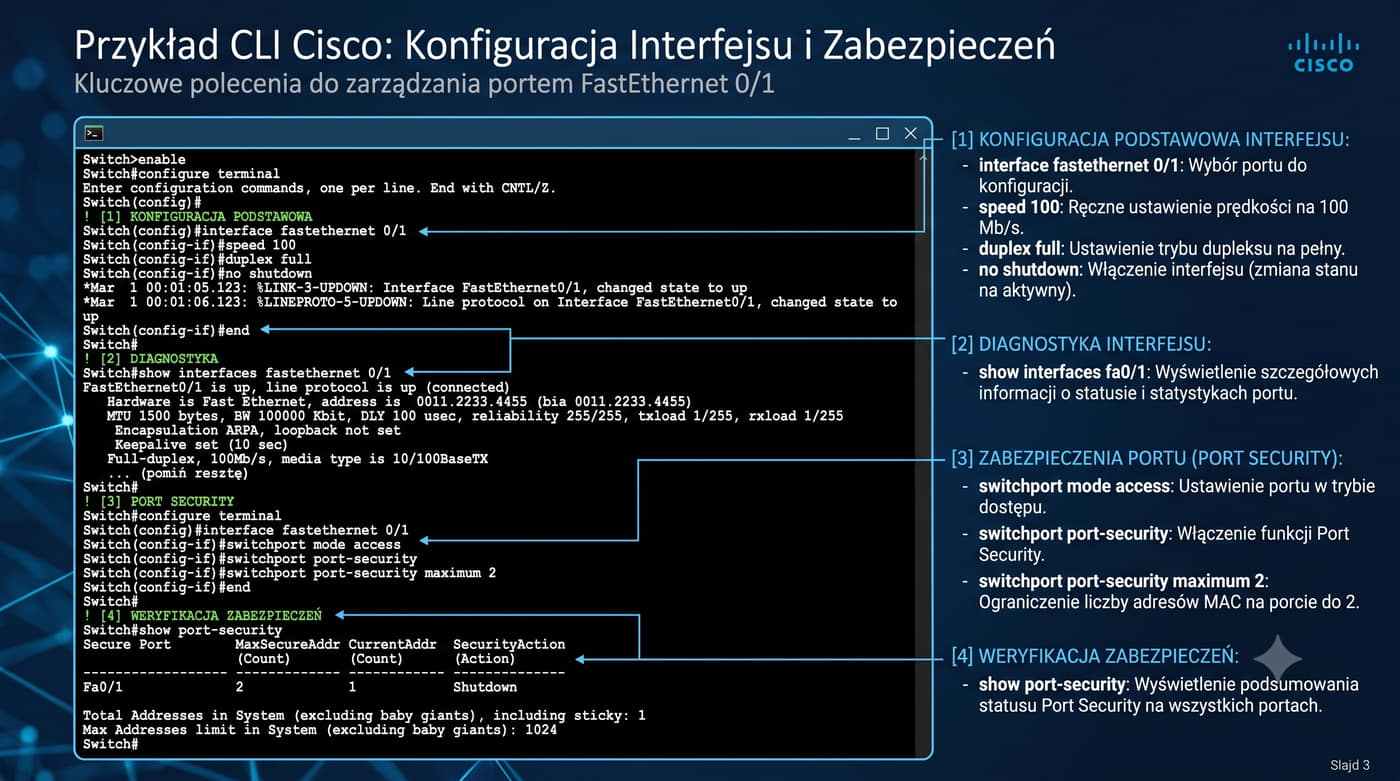
30/55 Przykład CLI Cisco – konfiguracja interfejsu

Konfiguracja interfejsu w Cisco IOS obejmuje ustawienia prędkości (speed), trybu dupleksowego (duplex), opisu (description) oraz stanu aktywności (no shutdown). Przykładowe polecenia:

  • speed: Ustawia prędkość transmisji (np. 10, 100, 1000 Mbps).
  • duplex: Określa tryb pełnego dupleksu lub półdupleksu.
  • description: Dodaje opis interfejsu dla celów dokumentacyjnych.
  • no shutdown: Aktywuje interfejs po wcześniejszym wyłączeniu.
interface FastEthernet0/1
 speed 100
 duplex full
 no shutdown
!
show interfaces FastEthernet0/1
!
switchport port-security maximum 2
show port-security

System Cisco IOS oferuje bogaty zestaw poleceń do konfiguracji interfejsów Ethernet w przełącznikach Catalyst. Konfigurację rozpoczyna się od wejścia w tryb konfiguracji globalnej (configure terminal), a następnie wyboru interfejsu (interface GigabitEthernet0/1). Parametry interfejsu ustawia się za pomocą poleceń takich jak speed (1000), duplex (full) oraz description. Po zmianie parametrów interfejs zostaje aktywowany poleceniem no shutdown. Ważne jest, aby przed zmianą parametrów autonegocjacji sprawdzić aktualny stan interfejsu za pomocą show interfaces status lub show interfaces.

Do diagnostyki interfejsów Cisco IOS oferuje polecenia show interfaces (szczegółowe statystyki), show mac address-table (tablica CAM) oraz show mac address-table count (liczba wpisów). Statystyki interfejsu obejmują liczbę wysłanych i odebranych ramek, licznik błędów CRC, kolizji, ramek runts i giants. Szczególnie ważne są liczniki błędów input errors i output errors, które mogą wskazywać na problemy z okablowaniem, uszkodzone karty sieciowe lub niezgodność dupleksu. W przypadku wykrycia błędów zaleca się wymianę kabla lub sprawdzenie konfiguracji obu końców łącza.

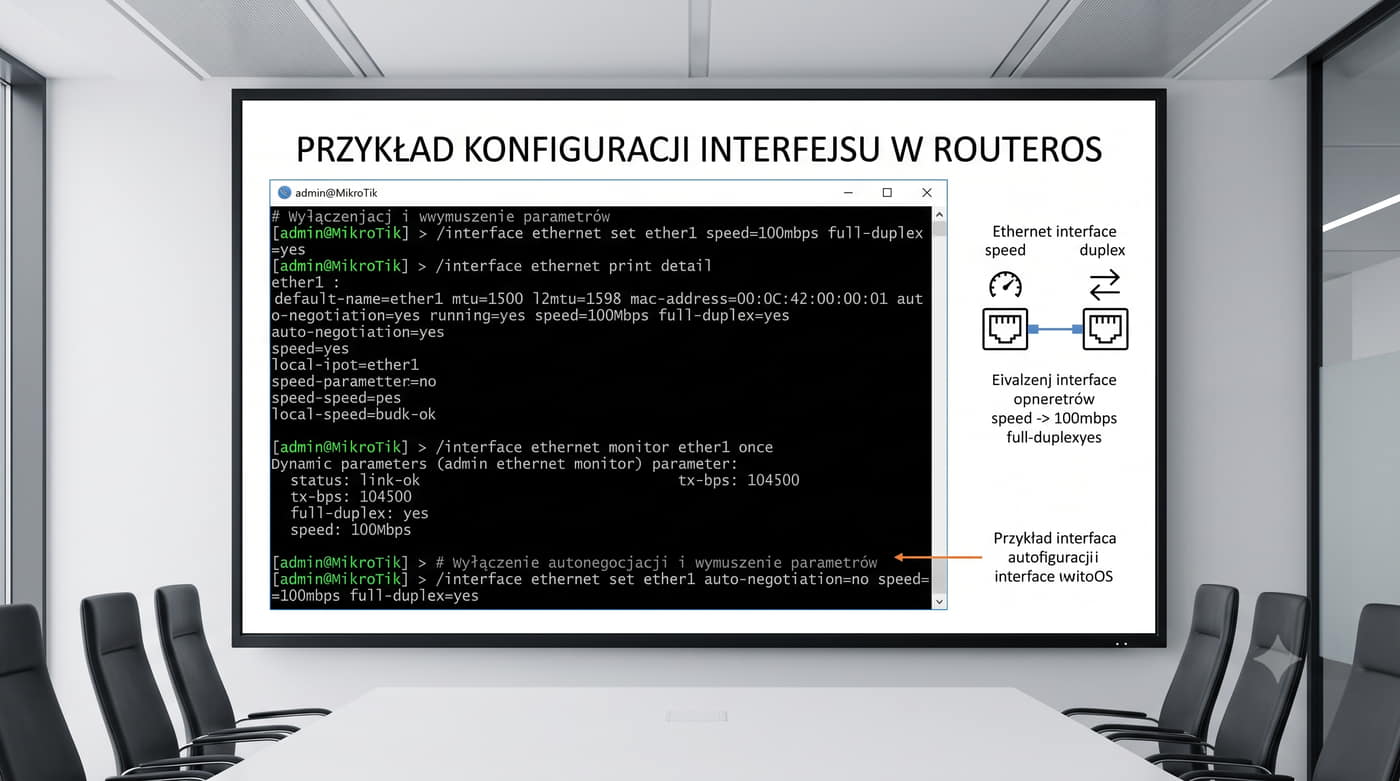
31/55 Przykład RouterOS – konfiguracja interfejsu

Konfiguracja interfejsu Ethernet w MikroTik RouterOS wymaga określenia nazwy interfejsu, adresu IP, maski podsieci oraz ewentualnych ustawień dodatkowych. Przykład:

/interface ethernet set ether1 speed=100Mbps full-duplex=yes
/interface ethernet print detail

Dodatkowe polecenia obejmują konfigurację VLAN, MTU lub trybu mostu (bridge).

MikroTik RouterOS oferuje konfigurację interfejsów Ethernet za pomocą poleceń z poziomu terminala (CLI) lub interfejsu webowego (WebFig). Podstawowa konfiguracja interfejsu obejmuje ustawienie prędkości i dupleksu za pomocą: /interface ethernet set ether1 speed=100Mbps full-duplex=yes. RouterOS wspiera włączanie i wyłączanie interfejsu (disable/enable), zarządzanie adresem MAC (mac-address), a także ustawienie MTU i opisów. Stan interfejsu można sprawdzić poleceniem /interface ethernet print detail, które wyświetla aktualne parametry działającego łącza.

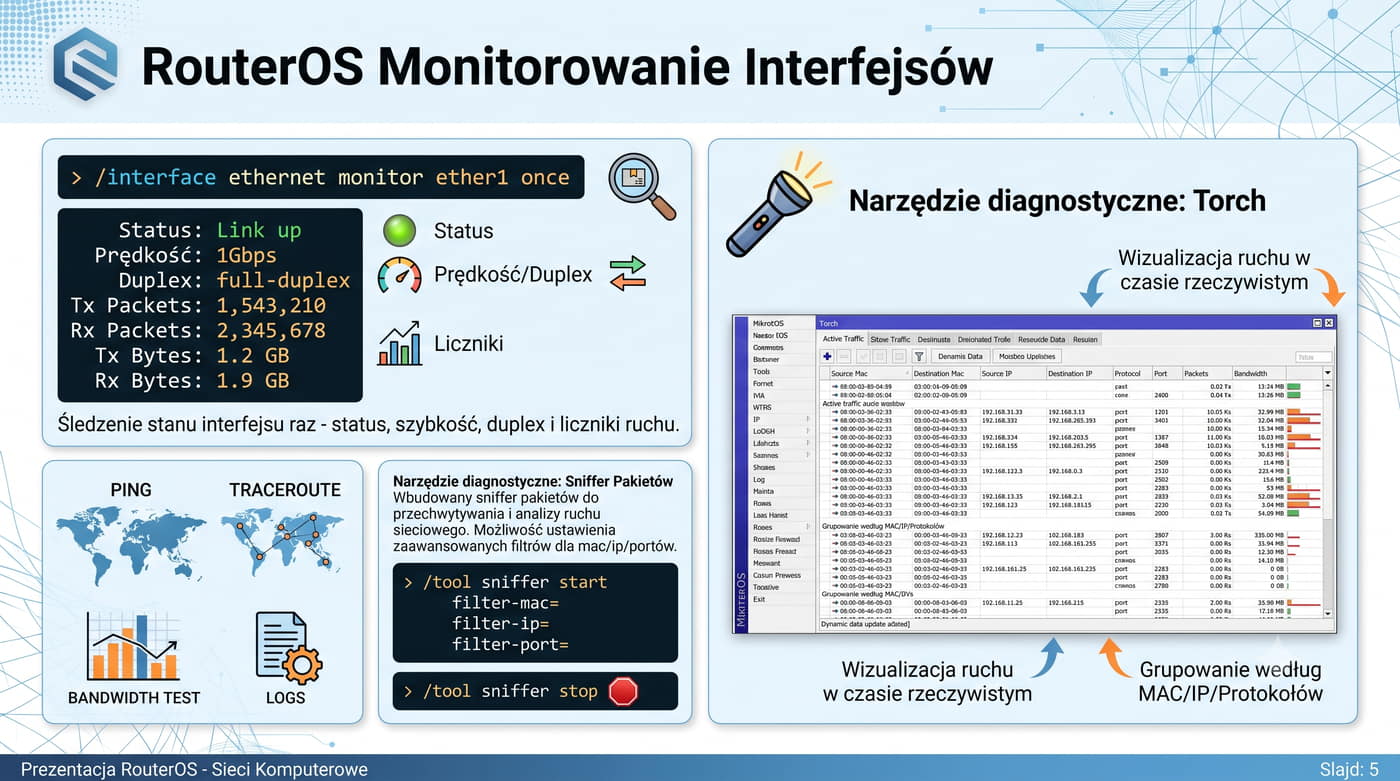
RouterOS rozróżnia interfejsy fizyczne (ether1, ether2 itd.) od logicznych (bridge, VLAN, bonding). Konfiguracja zaawansowanych parametrów, takich jak flow control czy MDI-X, odbywa się przez dodatkowe atrybuty: flow-control=yes, auto-negotiation=yes. W systemach RouterOS w wersji 7.x pojawiła się możliwość konfiguracji interfejsów Ethernet z wykorzystaniem mostowania sprzętowego (HW offload), co znacznie przyspiesza przekazywanie ramek w przełącznikach serii CRS3xx/CRS5xx. Polecenie /interface ethernet monitor ether1 once pozwala na bieżące obserwowanie stanu łącza i błędów.

RouterOS oferuje również zaawansowane funkcje skryptowe, które pozwalają na automatyzację konfiguracji interfejsów i reagowanie na zdarzenia sieciowe. Skrypty mogą być uruchamiane cyklicznie za pomocą wbudowanego narzędzia Scheduler lub w odpowiedzi na określone warunki, takie jak zmiana stanu łącza. Mechanizm ten jest niezwykle przydatny w środowiskach, gdzie wymagane jest szybkie dostosowywanie konfiguracji bez interwencji człowieka.

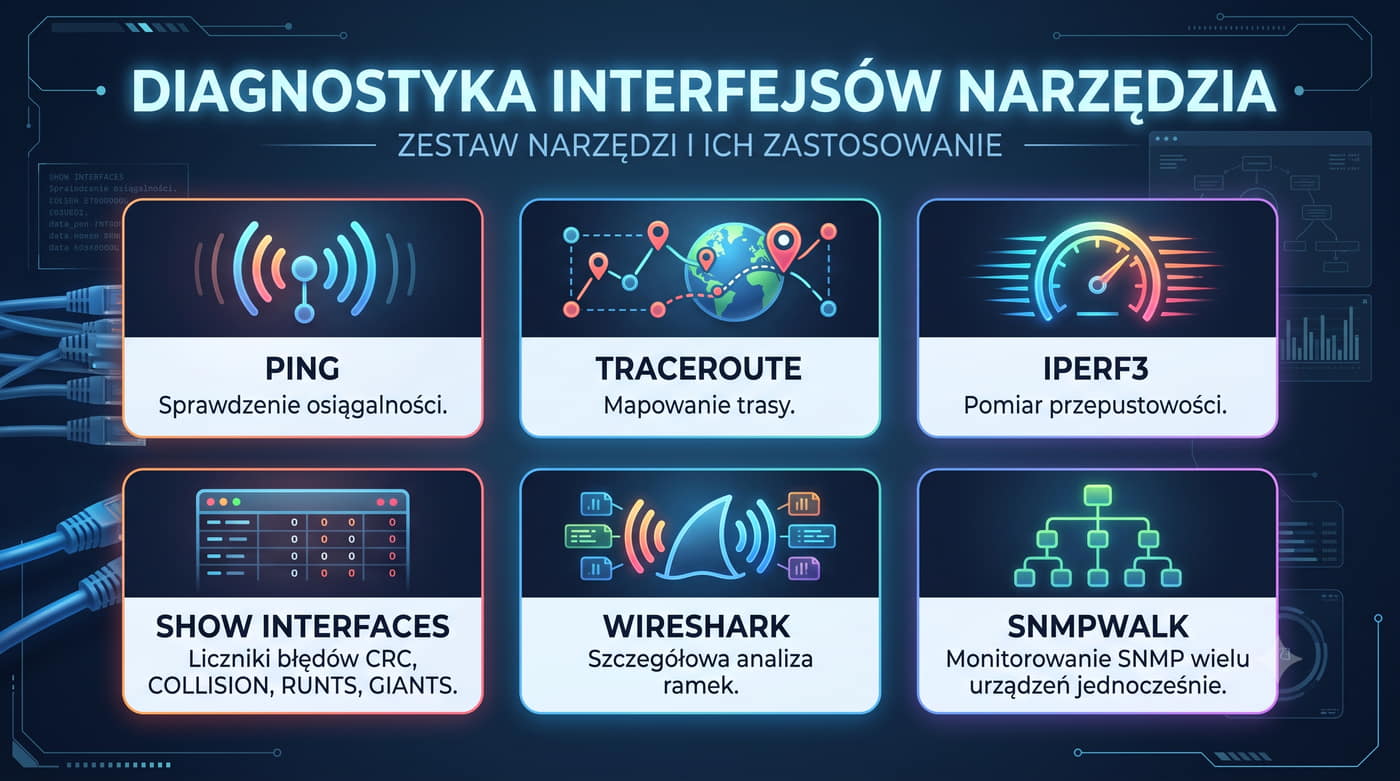
32/55 Diagnostyka interfejsów – narzędzia

Do diagnostyki interfejsów sieciowych wykorzystuje się:

/interface ethernet monitor ether1 once
/tool sniffer start
/tool sniffer stop
  • Ping: Sprawdza osiągalność hosta (ping 192.168.1.1).
  • Traceroute: Śledzi ścieżkę pakietów (traceroute -n 192.168.1.1).
  • Iperf3: Mierzy przepustowość łącza.
  • Wireshark: Analizuje ruch sieciowy na poziomie pakietów.
  • SNMP: Monitoruje parametry interfejsu (np. obciążenie, błędy) za pomocą MIB.

Każde narzędzie służy do identyfikacji problemów takich jak utrata pakietów, opóźnienia lub przeciążenie.

Diagnostyka interfejsów sieciowych opiera się na zestawie narzędzi zarówno wbudowanych w system operacyjny, jak i dostępnych zewnętrznie. Podstawowym narzędziem jest polecenie ping, które wysyła pakiety ICMP Echo Request i mierzy czas odpowiedzi oraz utratę pakietów. Traceroute (tracert w Windows) pozwala zidentyfikować ścieżkę, jaką pokonują pakiety do celu, oraz wskazać miejsce wystąpienia problemu. Więcej informacji o opóźnieniach i zmienności czasu odpowiedzi (jitter) dostarcza narzędzie MTR, które łączy funkcje pinga i traceroute w jednym, ciągle aktualizowanym widoku.

Do pomiaru przepustowości niezbędne jest narzędzie iperf3, które tworzy strumienie danych TCP lub UDP między klientem a serwerem. Wynik pomiaru pozwala ocenić, czy łącze osiąga oczekiwaną przepustowość i czy występują straty pakietów. Wireshark umożliwia szczegółową analizę ruchu na poziomie poszczególnych ramek, identyfikację problemów z retransmisjami TCP, błędami ARP czy anomaliami w działaniu protokołów. W zarządzalnych przełącznikach diagnostykę uzupełniają narzędzia SNMP, które zbierają statystyki interfejsów (obciążenie, błędy, liczniki ramek) i przekazują je do systemów monitorujących, takich jak Zabbix czy Nagios.

W codziennej pracy administratora sieci kluczową umiejętnością jest interpretacja statystyk interfejsów. Liczniki błędów CRC wskazują na problemy z okablowaniem lub zakłócenia elektromagnetyczne, podczas gdy liczniki collisions i late collisions sugerują niezgodność dupleksu. Narzędzia do monitorowania, takie jak MRTG czy Cacti, pozwalają na wizualizację tych statystyk w czasie i szybką identyfikację trendów wskazujących na degradację wydajności sieci.

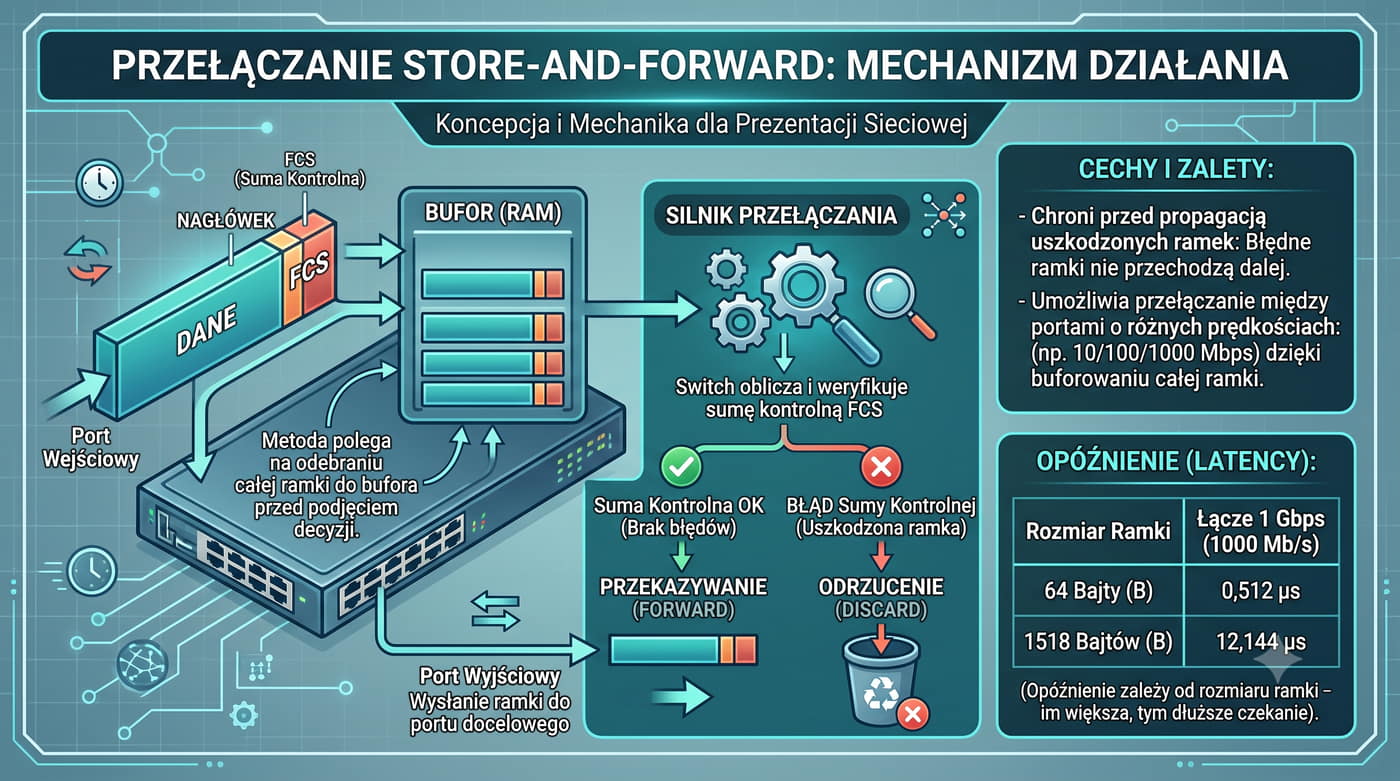
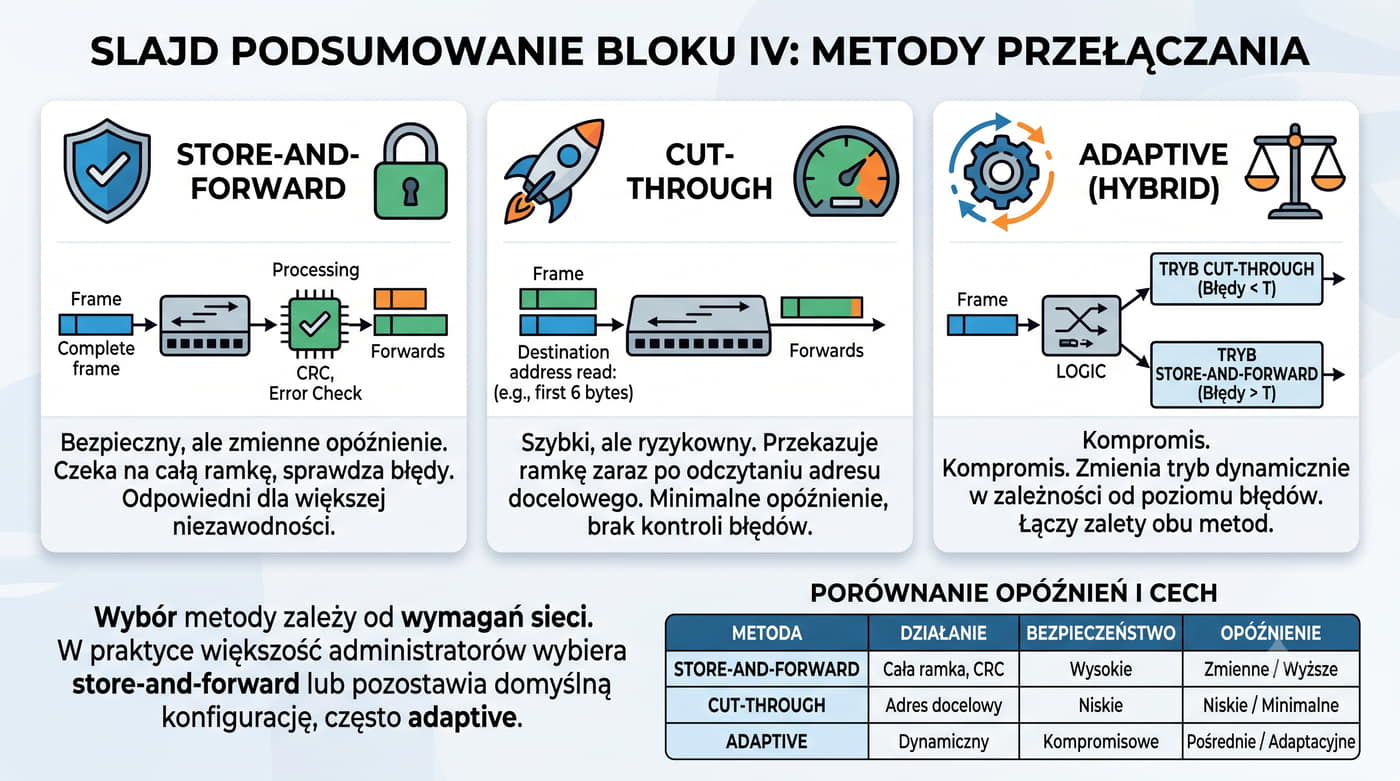
33/55 Store-and-Forward – mechanika

Mechanizm Store-and-Forward polega na:

1. Odebraniu całej ramki Ethernet (bez fragmentacji).

2. Weryfikacji poprawności nagłówka i obliczeniu FCS (Frame Check Sequence).

3. Przekazaniu ramki do odpowiedniego interfejsu wyjściowego po sprawdzeniu adresu MAC.

Stosowany w przełącznikach warstwy 2, gwarantuje integralność danych kosztem większych opóźnień (oczekiwanie na pełną ramkę).

Store-and-Forward to metoda przełączania, w której przełącznik odbiera całą ramkę do wewnętrznego bufora przed podjęciem decyzji o jej przekazaniu. Proces składa się z trzech etapów: odbioru całej ramki (reception), weryfikacji poprawności (validation) i przekazania (forwarding). W trakcie weryfikacji sprawdzana jest długość ramki (min. 64 bajty, max. 1518 bajtów dla standardowego Ethernet), adres MAC docelowy oraz suma kontrolna FCS (Frame Check Sequence). Ramki uszkodzone (błędne CRC, runts, giants) są odrzucane, co zapobiega propagacji błędów w sieci.

Główną zaletą Store-and-Forward jest gwarancja integralności danych – do sieci trafiają tylko ramki w pełni poprawne. Metoda ta jest niezbędna w przypadku łączenia segmentów o różnych prędkościach (np. 100 Mbps z 1 Gbps), ponieważ całe ramki muszą zostać zbuforowane przed wysłaniem z inną szybkością. Wadą jest opóźnienie (latency), które dla ramki 1500 bajtów przy 1 Gbps wynosi około 12 mikrosekund. W sieciach rozległych, gdzie opóźnienia się kumulują, stosuje się metodę Cut-Through. Store-and-Forward jest domyślną metodą przełączania w większości przełączników korporacyjnych ze względu na niezawodność.

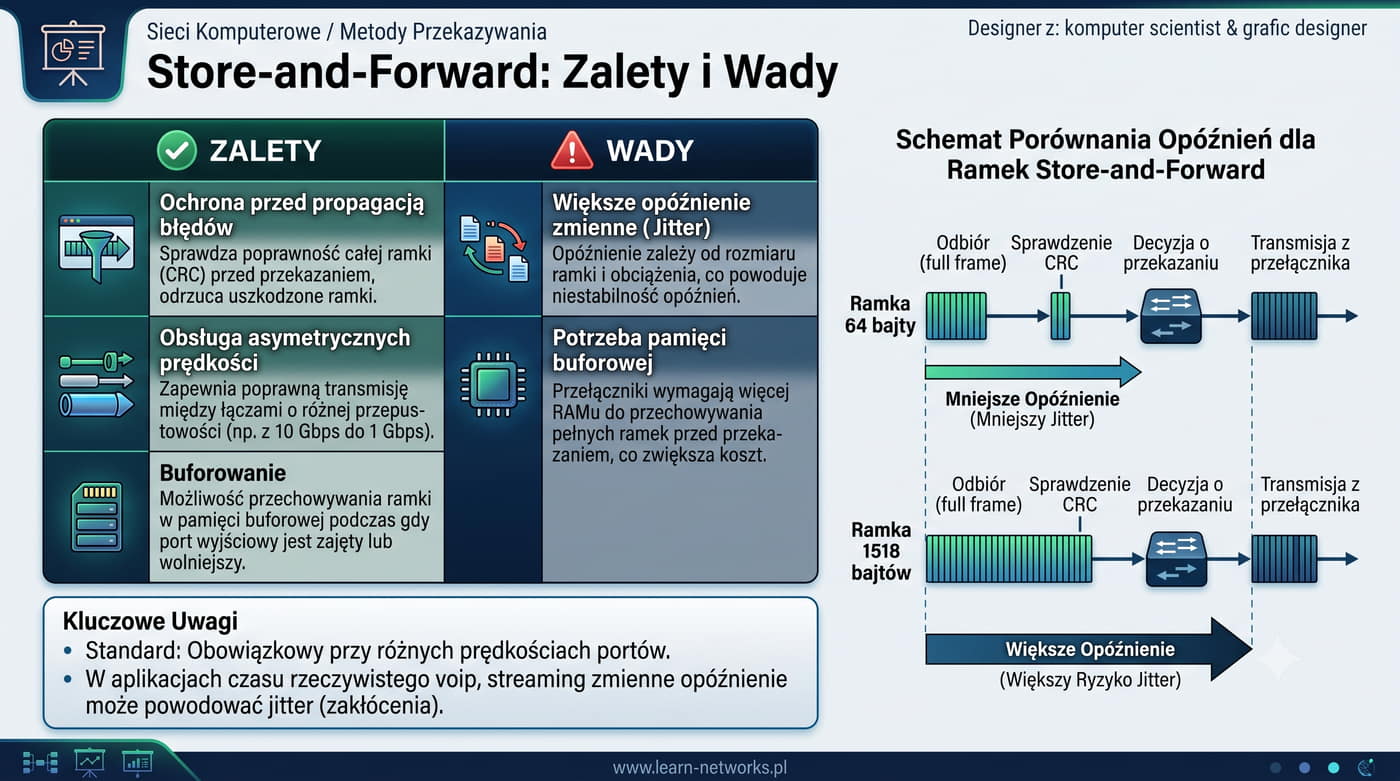
34/55 Store-and-Forward – zalety i wady

Zalety:

  • Weryfikacja integralności ramek (FCS)
  • Obsługa asymetrycznych prędkości transmisji

Wady:

  • Duże opóźnienie (ramki czekają na pełne złożenie)

Metoda Store-and-Forward oferuje kilka istotnych zalet w porównaniu z alternatywnymi metodami przełączania. Przede wszystkim zapewnia całkowitą kontrolę integralności ramek – ramki z uszkodzoną sumą kontrolną (FCS error), ramki zbyt krótkie (runts) lub zbyt długie (giants) są odrzucane i nie trafiają dalej do sieci. Zapobiega to marnowaniu pasma na transmisję błędnych danych i obciążaniu procesorów hostów końcowych. Kolejną zaletą jest możliwość łączenia portów o różnych prędkościach – przełącznik może odebrać ramkę z portu 100 Mbps, zbuforować ją i wysłać przez port 1 Gbps bez ryzyka utraty danych.

Główną wadą Store-and-Forward jest opóźnienie (latency), które rośnie proporcjonalnie do rozmiaru ramki. Dla małych ramek (64 bajty) opóźnienie jest minimalne (ok. 0,5 µs przy 1 Gbps), ale dla ramek Jumbo (9000 bajtów) może sięgnąć nawet 70 mikrosekund. W sieciach o wysokiej częstotliwości transakcji (giełdy, HPC) taki narzut może być nieakceptowalny. Drugą wadą jest konieczność posiadania wystarczająco dużej pamięci buforowej – przy dużym natłoku ramek z wielu portów wejściowych do jednego portu wyjściowego bufor może się szybko zapełnić, prowadząc do odrzucania ramek (tail drop). Rozwiązaniem jest stosowanie mechanizmów QoS i odpowiednio dużych buforów.

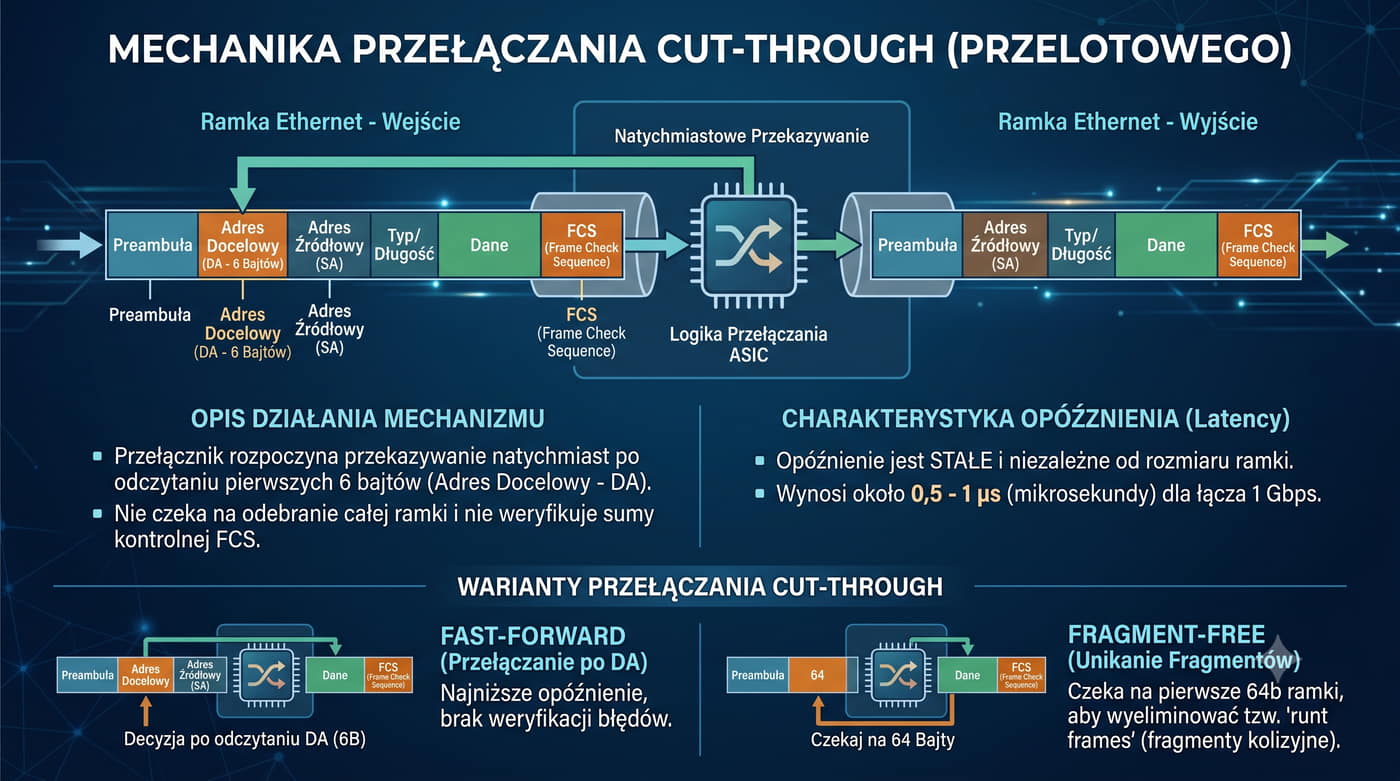
35/55 Cut-Through – mechanika

Forwarding rozpoczyna się natychmiast po odczytaniu adresu docelowego (6 bajtów nagłówka).

Pozostałe bity ramki są przetwarzane w tle.

Cut-Through to metoda przełączania, w której decyzja o przekazaniu ramki jest podejmowana zaraz po odczytaniu adresu MAC docelowego, zanim jeszcze reszta ramki dotrze do przełącznika. Adres MAC docelowy znajduje się w pierwszych 6 bajtach nagłówka Ethernet, więc przełącznik może zacząć przekazywanie ramki natychmiast po odebraniu tych danych. Pozostałe bity ramki są przetwarzane w tle (cut-through forwarding), a przełącznik równocześnie odbiera resztę ramki na porcie wejściowym i wysyła już odebraną część na port wyjściowy. To znacznie skraca opóźnienie w porównaniu z metodą Store-and-Forward.

Cut-Through jest szczególnie korzystne w sieciach o małych opóźnieniach, takich jak klastry obliczeniowe (HPC) czy sieci giełdowe, gdzie każda mikrosekunda ma znaczenie. Typowe opóźnienie dla Cut-Through przy 1 Gbps wynosi około 3–5 mikrosekund, niezależnie od rozmiaru ramki. Wadą metody jest brak weryfikacji poprawności ramki przed rozpoczęciem transmisji – jeśli ramka ma błędną sumę CRC lub jest fragmentem kolizji (runt), zostanie przekazana do sieci, marnując pasmo i obciążając odbiorcę. Z tego względu wiele przełączników implementuje hybrydowe podejście: Cut-Through dla małych ramek i Store-and-Forward dla dużych.

Przełączniki wykorzystujące Cut-Through są szczególnie cenione w środowiskach obliczeń o wysokiej wydajności (HPC) oraz w sieciach pamięci masowej (SAN), gdzie każde opóźnienie przekłada się na spadek wydajności aplikacji. W takich sieciach typowe opóźnienia dla przełącznika cut-through wynoszą poniżej 1 mikrosekundy dla ramek małych rozmiarów. Technologia ta jest również stosowana w przełącznikach InfiniBand, które są powszechnie używane w superkomputerach.

36/55 Cut-Through – Fast-Forward vs Fragment-Free

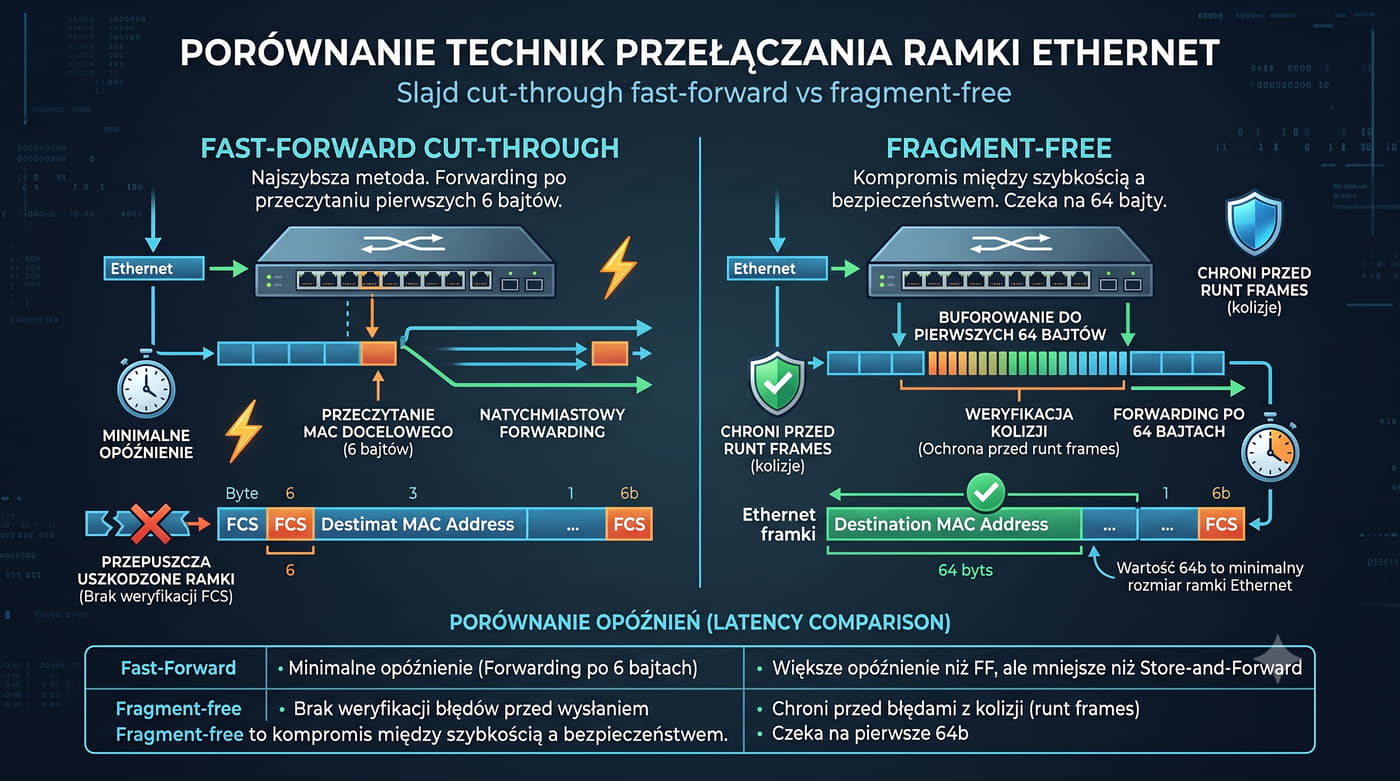
Fast-Forward: Przekazanie ramki rozpoczyna się natychmiast po odebraniu adresu docelowego (pierwsze 6 bajtów) – najniższe opóźnienie, brak weryfikacji błędów.

Fragment-Free (próg 64B): Czeka na odebranie pierwszych 64 bajtów ramki, odrzucając kolizyjne fragmenty (runts) – kompromis między opóźnieniem a kontrolą błędów.

Metoda Cut-Through występuje w dwóch wariantach: Fast-Forward i Fragment-Free. Fast-Forward (nazywany również cut-through) rozpoczyna przekazywanie ramki natychmiast po odczytaniu pierwszych 6 bajtów zawierających adres MAC docelowy. Jest to najszybszy możliwy tryb przełączania, ale jednocześnie najbardziej podatny na błędy – przełącznik nie ma żadnej informacji o poprawności ramki poza samym adresem. Jeśli ramka jest uszkodzona (błędne CRC, kolizja), i tak zostanie przekazana do sieci. Fast-Forward jest stosowany głównie w środowiskach, gdzie najważniejsze jest minimalne opóźnienie, a błędy są korygowane na wyższych warstwach (np. retransmisja TCP).

Fragment-Free (nazywany również cut-through z progiem 64 bajtów) to bezpieczniejszy wariant metody Cut-Through. Przełącznik czeka na odebranie pierwszych 64 bajtów ramki, zanim rozpocznie jej przekazywanie. Dzięki temu może odrzucić ramki będące fragmentami kolizji (runts), które zawsze są krótsze niż 64 bajty. Fragment-Free oferuje kompromis między małym opóźnieniem a pewnym poziomem weryfikacji. Jest to szczególnie przydatne w sieciach o wysokim poziomie kolizji, gdzie wiele uszkodzonych ramek mogłoby marnować pasmo. Wariant ten jest domyślnie stosowany w niektórych przełącznikach Cisco w trybie cut-through.

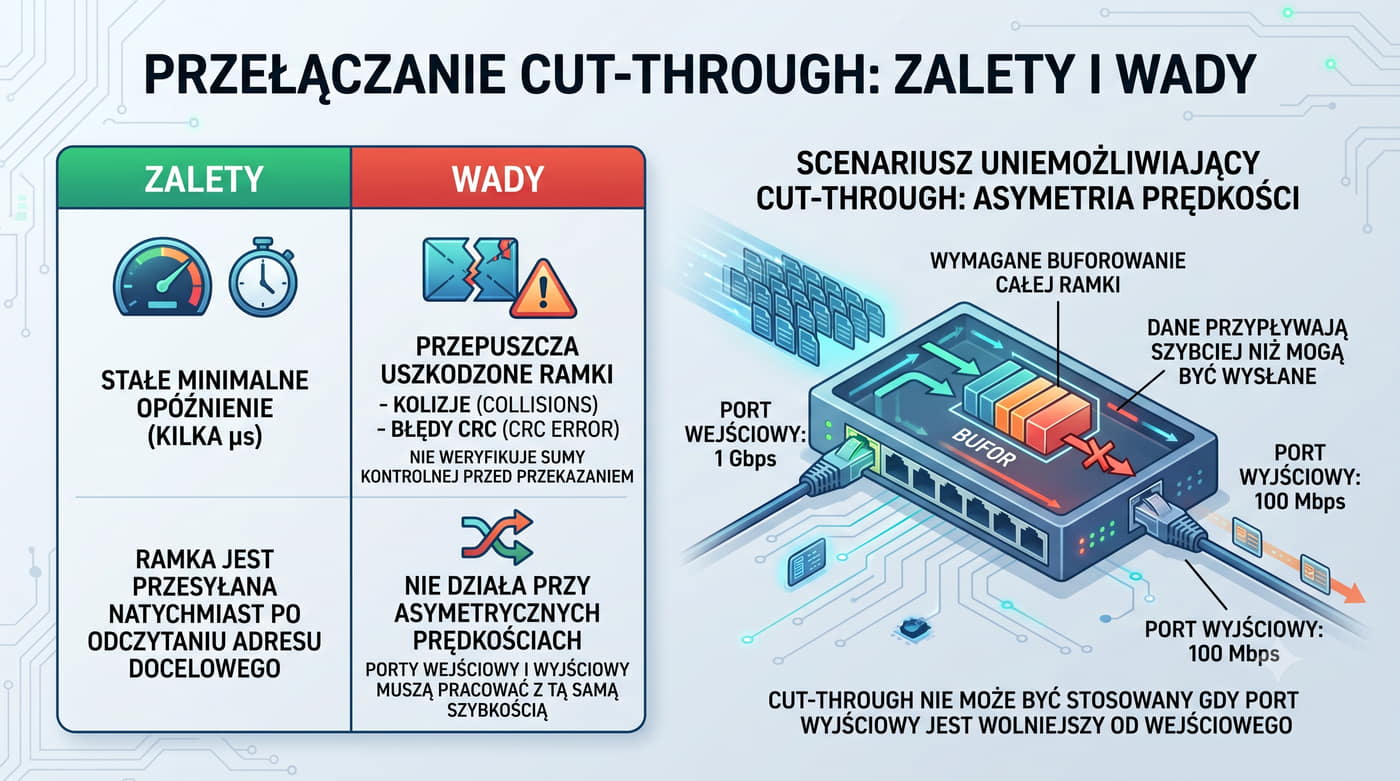
37/55 Cut-Through – zalety i wady

Zalety:

  • Minimalne opóźnienie (brak oczekiwania na całą ramkę)

Wady:

  • Przepuszcza błędne ramki (brak weryfikacji FCS przed przekazaniem)

Podstawową zaletą metody Cut-Through jest minimalne opóźnienie transmisji, które nie zależy od rozmiaru ramki. W przypadku ramek Jumbo (9000 bajtów) opóźnienie w Cut-Through jest około 60 razy mniejsze niż w Store-and-Forward, co ma kluczowe znaczenie w sieciach o dużej przepustowości. Niskie opóźnienie przekłada się na lepszą wydajność aplikacji czasu rzeczywistego, takich jak VoIP, wideokonferencje czy zdalne operacje chirurgiczne. Cut-Through wymaga również mniejszej pamięci buforowej w przełączniku, ponieważ ramki nie są przechowywane w całości przed wysłaniem.

Główną wadą jest przepuszczanie błędnych ramek do sieci. Przełącznik nie sprawdza sumy FCS przed rozpoczęciem transmisji, więc ramki z błędami CRC, runts oraz giants trafiają do odbiorcy, który i tak je odrzuci. To marnuje pasmo i obciąża procesor karty sieciowej hosta docelowego. W sieciach o wysokim poziomie błędów (np. stare okablowanie, zakłócenia elektromagnetyczne) Cut-Through może powodować znaczną degradację wydajności. Dodatkowo metoda ta nie może być stosowana przy łączeniu portów o różnych prędkościach – w takim przypadku przełącznik automatycznie przełącza się na Store-and-Forward. Z tych względów Cut-Through jest rzadko spotykane w przełącznikach dostępowych, a częściej w szkieletowych.

38/55 Adaptive Switching

Automatyczne przełączanie między Store-and-Forward a Cut-Through w zależności od warunków (np. obciążenia sieci).

Adaptive Switching to hybrydowa metoda przełączania, która dynamicznie wybiera między Store-and-Forward a Cut-Through w zależności od bieżących warunków w sieci. Decyzja jest podejmowana na podstawie poziomu błędów obserwowanego na danym porcie – jeśli liczba błędnych ramek (CRC, runts) przekracza określony próg, przełącznik przełącza się na Store-and-Forward, aby nie propagować błędów. Gdy poziom błędów spadnie poniżej progu przez określony czas, przełącznik wraca do Cut-Through, aby zminimalizować opóźnienia. Mechanizm ten zapewnia optymalny balans między wydajnością a niezawodnością.

Adaptive Switching jest szczególnie przydatne w sieciach o zmiennych warunkach transmisji, na przykład w starszych instalacjach z mieszanym okablowaniem lub w środowiskach przemysłowych z zakłóceniami elektromagnetycznymi. Większość zarządzalnych przełączników oferuje możliwość ręcznego wymuszenia metody przełączania (per port lub globalnie), ale tryb adaptacyjny jest zalecany w przypadku sieci, w których warunki mogą się zmieniać w trakcie pracy. W Cisco IOS metoda przełączania jest zwykle automatyczna i zależna od platformy sprzętowej, natomiast w MikroTik RouterOS sposób przełączania zależy od wybranej platformy (np. CRS3xx/CRS5xx przełączają sprzętowo w trybie cut-through lub store-and-forward w zależności od realizacji sprzętowej).

Adaptive Switching sprawdza się najlepiej w środowiskach, w których warunki transmisji są zmienne, na przykład w sieciach z długimi łączami światłowodowymi lub w instalacjach przemysłowych narażonych na zakłócenia. Przełącznik monitoruje liczbę błędów na każdym porcie i automatycznie dostosowuje metodę przełączania, aby zminimalizować zarówno opóźnienia, jak i propagację błędów. W praktyce adaptacyjne przełączanie jest domyślnym trybem pracy w wielu nowoczesnych przełącznikach Cisco.

39/55 Porównanie metod przełączania

Kluczowa różnica: Store-and-Forward gwarantuje poprawność, Cut-Through minimalizuje opóźnienia.

Store-and-Forward Cut-Through
Opóźnienie Wysokie Niskie
Poprawność ramek ❌ (ryzyko błędów)

Store-and-Forward i Cut-Through różnią się przede wszystkim podejściem do weryfikacji ramek i opóźnień. W metodzie Store-and-Forward przełącznik czeka na odebranie całej ramki, sprawdza jej sumę FCS i dopiero wtedy przekazuje ją do portu docelowego. Zapewnia to wysoką niezawodność, ale wprowadza opóźnienie proporcjonalne do rozmiaru ramki. W metodzie Cut-Through przełącznik rozpoczyna transmisję po odczytaniu adresu MAC docelowego, osiągając stałe, niskie opóźnienie kosztem braku weryfikacji integralności. Różnica w opóźnieniu jest szczególnie widoczna przy ramkach Jumbo – Cut-Through może być nawet 60 razy szybszy.
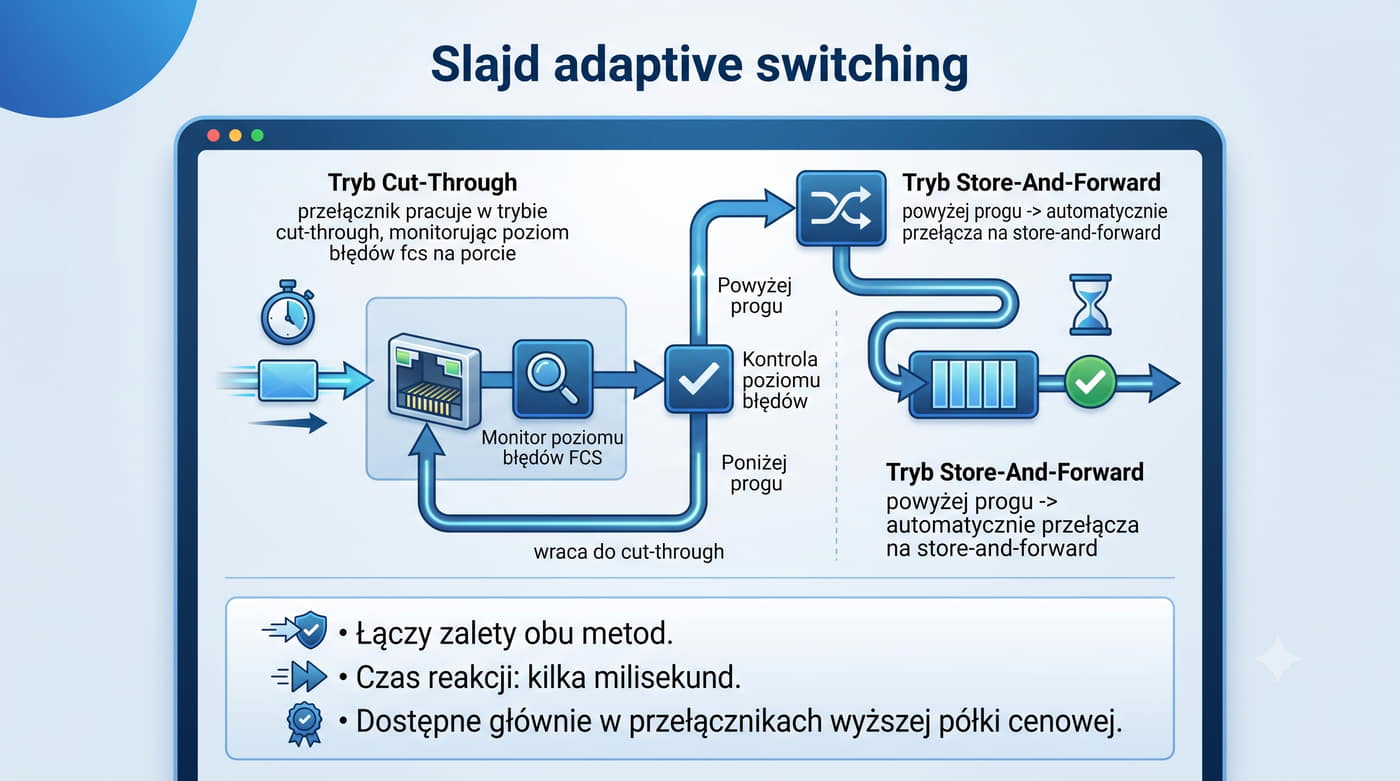
Adaptive Switching łączy zalety obu metod, dynamicznie dostosowując się do warunków panujących w sieci. W praktyce wybór metody przełączania zależy od wymagań aplikacji i charakterystyki ruchu. W sieciach korporacyjnych, gdzie priorytetem jest niezawodność, dominuje Store-and-Forward. W data center i sieciach HPC, gdzie każda mikrosekunda opóźnienia jest krytyczna, stosuje się Cut-Through. Adaptive Switching jest rozwiązaniem uniwersalnym dla sieci o mieszanym ruchu. Współczesne przełączniki Cisco Catalyst i Nexus oferują sprzętowe wsparcie dla wszystkich trzech metod, z możliwością konfiguracji na poziomie pojedynczego portu.

40/55 Przykład – kiedy Cut-Through jest niemożliwe

Asymetryczne prędkości: Gdy nadawca i odbiorca mają bardzo różne przepustowości, Cut-Through może generować kolizje lub utratę danych.

Rozwiązanie: Store-and-Forward lub mechanizmy QoS.

Cut-Through nie może być stosowane w sytuacjach, gdy prędkości portów wejściowego i wyjściowego różnią się od siebie. Na przykład, gdy ramka wchodzi na port 1 Gbps, ale ma być wysłana przez port 100 Mbps, przełącznik musi zbuforować całą ramkę przed rozpoczęciem transmisji na wolniejszym porcie. W przeciwnym razie bufor portu wyjściowego zostałby szybko zapełniony, a ramki zaczynałyby być odrzucane. W takiej sytuacji jedynym prawidłowym rozwiązaniem jest Store-and-Forward – przełącznik automatycznie wykrywa asymetrię prędkości i przełącza się na buforowanie całych ramek.

Innym przypadkiem, w którym Cut-Through jest niemożliwe, jest konieczność modyfikacji zawartości ramki przed jej wysłaniem. Dotyczy to na przykład przełączników warstwy 3, które zmieniają adres MAC źródłowy i docelowy podczas routingu między VLAN, lub urządzeń stosujących NAT. W tych sytuacjach przełącznik musi odebrać całą ramkę, zmodyfikować jej nagłówek i przeliczyć sumę FCS, co jest niemożliwe w trybie Cut-Through. Dodatkowo, niektóre funkcje bezpieczeństwa, takie jak ACL warstwy 2 czy port security oparte na analizie całej ramki, wymuszają stosowanie Store-and-Forward. Z tych powodów nowoczesne przełączniki inteligentnie wybierają metodę przełączania w zależności od konfiguracji i warunków.

41/55 Wprowadzenie do RouterOS (MikroTik)

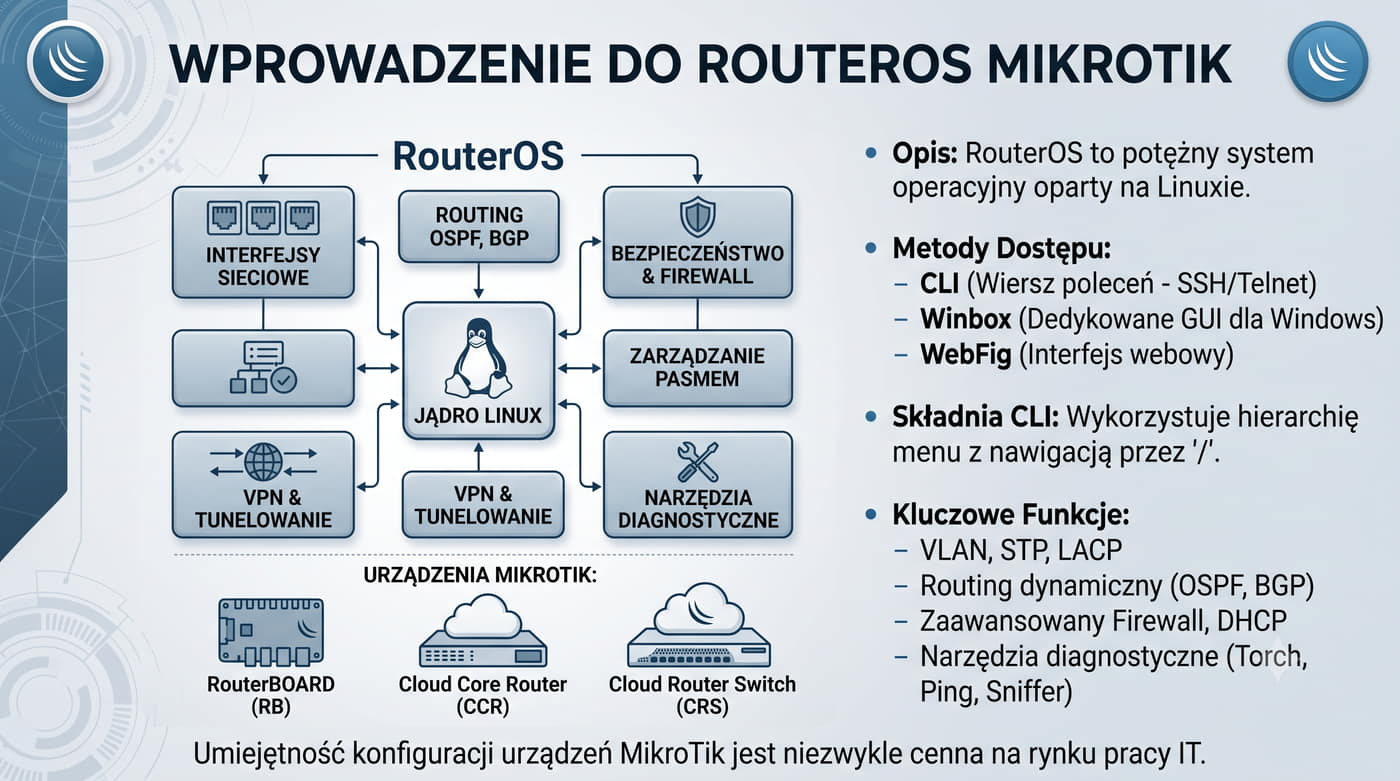
RouterOS to system operacyjny bazujący na jądrze Linux, stworzony specjalnie dla urządzeń sieciowych firmy MikroTik. Łączy stabilność i bezpieczeństwo Linuksa z funkcjonalnościami dedykowanymi routerom, przełącznikom i punktom dostępowym.

Kluczowe cechy RouterOS:

  • Zaawansowane routing (statyczny, dynamiczny, protokoły jak OSPF, BGP)
  • Firewall z filtrowaniem pakietów, translacją adresów NAT
  • Obsługa sieci bezprzewodowych (Wi-Fi w standardach 802.11a/b/g/n/ac)
  • Monitorowanie i diagnostyka sieci
  • Interfejs webowy oraz CLI dla zaawansowanych użytkowników

RouterOS jest powszechnie stosowany w małych i średnich przedsiębiorstwach oraz sieciach ISP ze względu na elastyczność i bogate możliwości konfiguracyjne.

RouterOS to system operacyjny stworzony przez firmę MikroTik dla jej urządzeń sieciowych: routerów, przełączników i punktów dostępowych. System bazuje na zmodyfikowanym jądrze Linux i oferuje bogaty zestaw funkcji sieciowych przy jednoczesnej stabilności i niskich wymaganiach sprzętowych. RouterOS obsługuje protokoły routingu statycznego i dynamicznego (OSPF, BGP, RIP), firewalle z filtrowaniem pakietów, translację adresów NAT, sieci VPN (IPsec, OpenVPN, WireGuard) oraz zaawansowane zarządzanie pasmem (Queue Tree, PCQ). Interfejs użytkownika dostępny jest przez WinBox (aplikację graficzną), WebFig (interfejs webowy) oraz terminal SSH/CLI.

Wśród administratorów RouterOS zyskał popularność dzięki elastyczności i niskiemu kosztowi. Urządzenia MikroTik, szczególnie seria RouterBoard i Cloud Router Switch (CRS), są powszechnie stosowane w małych i średnich przedsiębiorstwach oraz u dostawców usług internetowych (ISP). RouterOS wspiera konfigurację zaawansowanych funkcji przełączania, takich jak VLAN Filtering, mostowanie sprzętowe (HW offload) oraz agregację łączy (bonding). Wersja 7.x systemu wprowadziła wsparcie dla protokołu BGP w pełni, IPv6 z zaawansowaną konfiguracją, a także ulepszenia w wydajności przełączania na platformach CRS3xx/CRS5xx.

RouterOS może być uruchomiony nie tylko na dedykowanych urządzeniach MikroTik, ale również jako maszyna wirtualna (Cloud Hosted Router, CHR) w środowiskach VMware, Hyper-V czy KVM. Pozwala to na testowanie konfiguracji bez konieczności zakupu fizycznego sprzętu. Wersja CHR jest licencjonowana oddzielnie i oferuje pełną funkcjonalność systemu, co czyni ją idealnym narzędziem do nauki i prototypowania rozwiązań sieciowych.

42/55 RouterOS – mostowanie (bridge)

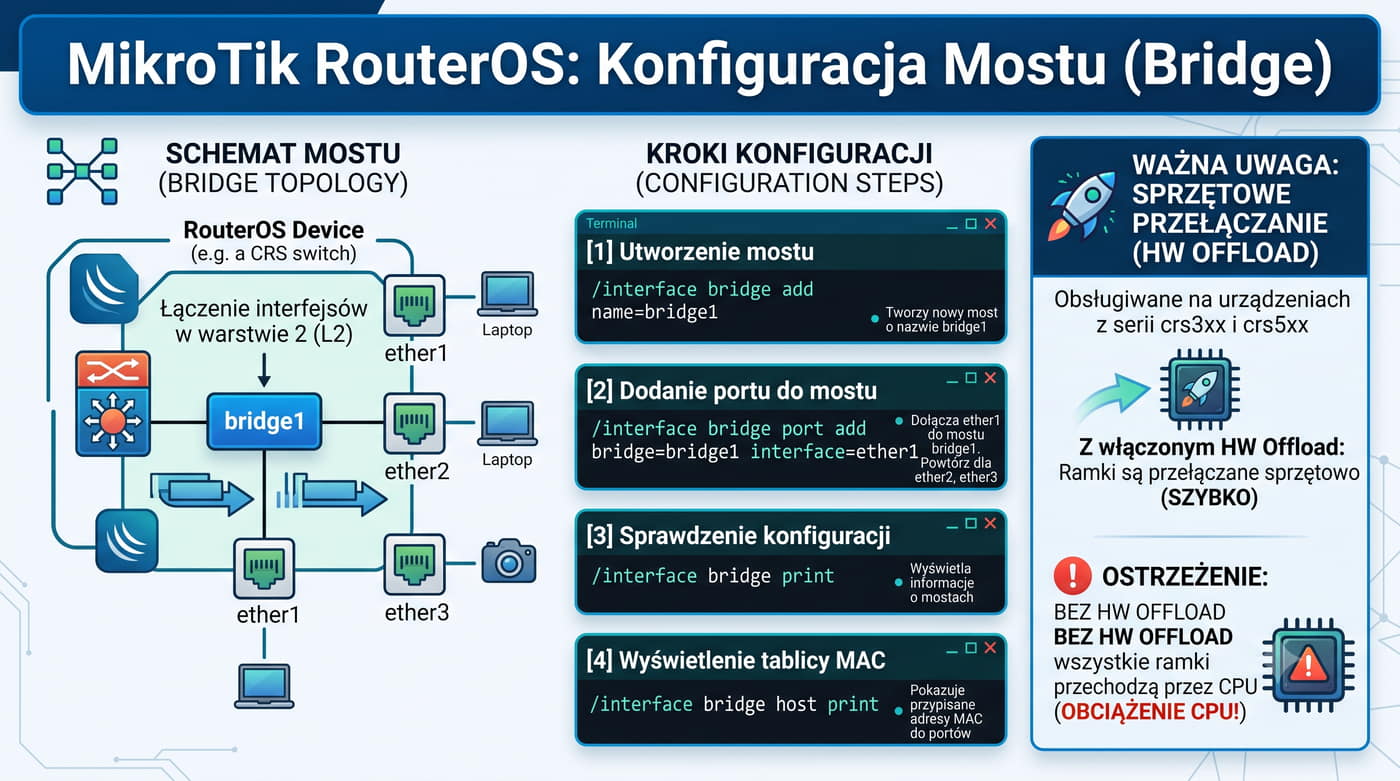
Mostowanie (Bridge) w RouterOS łączy wiele interfejsów fizycznych w jedną domenę rozgłoszeniową, działającą jak przełącznik warstwy 2. Poniżej przykład konfiguracji:

/interface bridge add name=bridge1
/interface bridge port add bridge=bridge1 interface=ether1
/interface bridge port add bridge=bridge1 interface=ether2
/interface bridge print
/interface bridge port print

Korzyści mostowania:

  • Połączenie wielu interfejsów w jedną domenę rozgłoszeniową
  • Możliwość filtrowania VLAN na interfejsach mostu
  • Optymalizacja ruchu między interfejsami w tej samej sieci warstwy 2

Uwaga: Most nie routuje pakietów między różnymi sieciami IP – wymagany jest routing statyczny lub dynamiczny (IP Forwarding).

Mostowanie (bridge) w RouterOS pozwala na połączenie wielu interfejsów fizycznych w jedną domenę rozgłoszeniową, działającą jak wirtualny przełącznik warstwy 2. Most jest konfigurowany poleceniem /interface bridge add name=bridge1, a następnie poszczególne interfejsy fizyczne są do niego dodawane: /interface bridge port add bridge=bridge1 interface=ether1. Po utworzeniu mostu interfejs bridge1 otrzymuje adres IP i staje się logicznym interfejsem dla całej grupy portów. Mostowanie jest niezbędne w przypadku, gdy chcemy połączyć wiele sieci LAN w jedną sieć logiczną lub gdy potrzebujemy segmentacji VLAN na interfejsach fizycznych.

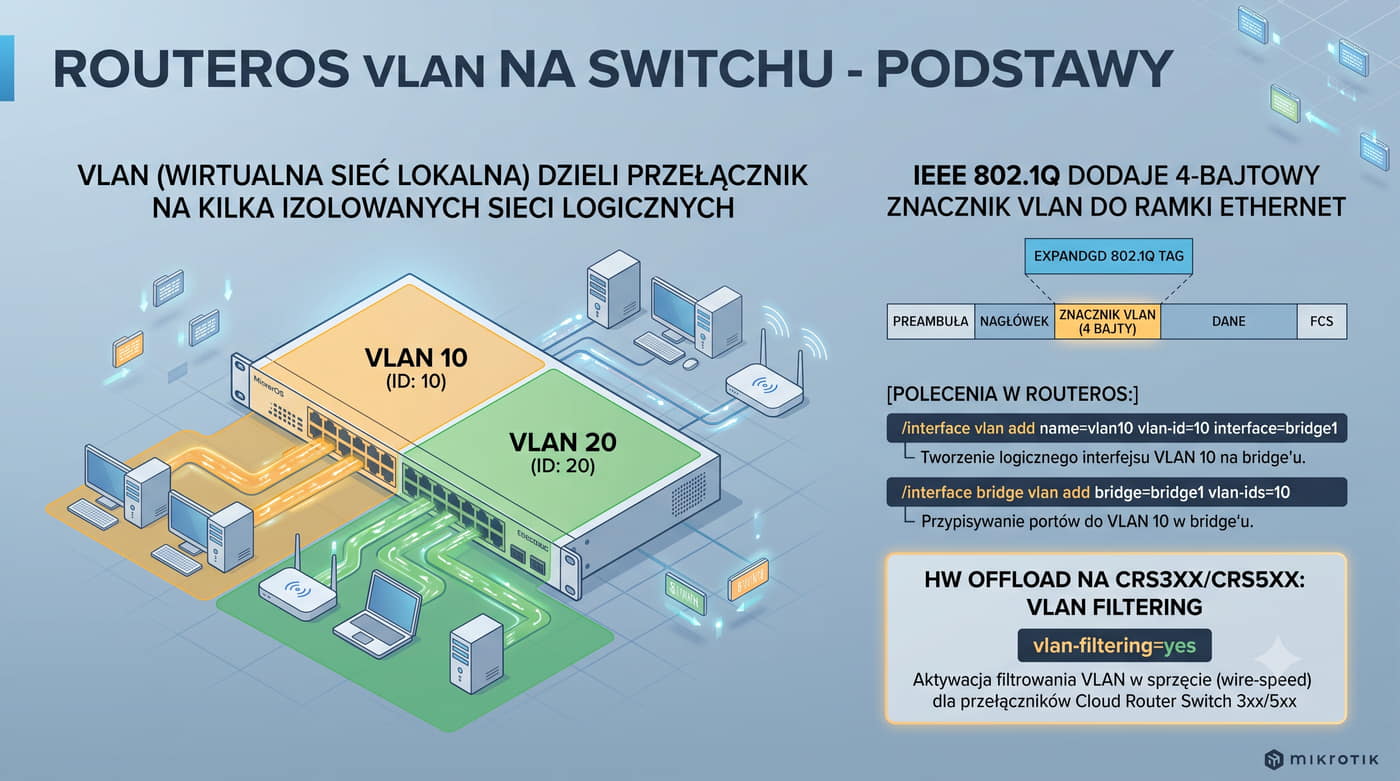
RouterOS obsługuje zaawansowane funkcje mostowania, takie jak filtrowanie VLAN (bridge VLAN filtering), które pozwala na tworzenie wielu VLAN na jednym moście bez konieczności stosowania osobnych interfejsów VLAN. W przełącznikach serii CRS3xx/CRS5xx mostowanie może być realizowane sprzętowo (HW offload), co zapewnia prędkość porównywalną z dedykowanymi przełącznikami warstwy 2. Mosty w RouterOS wspierają również protokół STP/RSTP do zapobiegania pętlom oraz IGMP snooping do optymalizacji ruchu multicast. Ważne jest, aby pamiętać, że most nie routuje pakietów – komunikacja między różnymi podsieciami wymaga dodania tras statycznych lub skonfigurowania routingu dynamicznego na interfejsie mostu.

W praktyce mostowanie w RouterOS jest często wykorzystywane do łączenia interfejsów Ethernet z interfejsami bezprzewodowymi (WiFi) w jedną spójną sieć LAN. Most obsługuje również protokół STP/RSTP, który zapobiega pętlom w topologiach z wieloma przełącznikami. W mostach sprzętowo wspieranych (HW offload) cały ruch przełączany jest w układzie ASIC, co zapewnia wydajność porównywalną z dedykowanymi przełącznikami.

43/55 RouterOS – tablica MAC (host table)

RouterOS przechowuje tablicę adresów MAC wykrytych na interfejsach mostu (bridge). Służy ona do diagnostyki i weryfikacji połączeń w warstwie 2:

/interface bridge host print
/interface bridge host remove [find]
/interface bridge host add bridge=bridge1 mac-address=XX:XX:XX:XX:XX:XX interface=ether2

Funkcje tablicy hostów:

  • Diagnostyka połączeń między hostami w sieci mostowanej
  • Weryfikacja poprawności adresów MAC na poszczególnych interfejsach
  • Ręczne dodawanie/usuwanie statycznych wpisów MAC

Tablica MAC (host table) w RouterOS przechowuje informacje o adresach MAC wykrytych na interfejsach mostu. Jest to odpowiednik tablicy CAM w tradycyjnych przełącznikach – dla każdego adresu MAC przechowywany jest numer interfejsu i znacznik czasu ostatniej aktywności. Tablicę można przeglądać poleceniem /interface bridge host print, które wyświetla adres MAC, interfejs oraz status wpisu (dynamiczny lub statyczny). RouterOS pozwala również na ręczne dodawanie statycznych wpisów MAC za pomocą /interface bridge host add, co przydaje się w przypadku urządzeń o stałych adresach, takich jak serwery czy drukarki.

Tablica hostów jest kluczowym narzędziem diagnostycznym w sieciach mostowanych. Administrator może szybko sprawdzić, czy dane urządzenie jest widoczne na odpowiednim interfejsie i czy nie występują problemy z łącznością. W przypadku podejrzenia ataku MAC flooding można przejrzeć liczbę wpisów na każdym interfejsie i zidentyfikować potencjalnie zainfekowany port. RouterOS umożliwia również ograniczenie uczenia się adresów MAC za pomocą parametru learn=no na wybranych portach, co zapobiega nieautoryzowanemu dodawaniu nowych urządzeń do sieci. Statyczne wpisy MAC są szczególnie przydatne w sieciach o zaostrzonych wymaganiach bezpieczeństwa.

44/55 BPDU – budowa ramki STP

BPDU (Bridge Protocol Data Unit) – ramka STP wymieniana między przełącznikami w celu wykrywania pętli.

Pole BPDUOpis
Protocol IdentifierIdentyfikator protokołu (zawsze 0 dla STP/RSTP/MSTP)
Protocol VersionWersja STP (0 = STP, 2 = RSTP, 3 = MSTP)
BPDU Type0x00 = Configuration BPDU, 0x80 = TCN BPDU
Root Bridge IDPriorytet + adres MAC mostu głównego (8 bajtów)
Root Path CostKoszt ścieżki do mostu głównego (4 bajty)
Bridge IDPriorytet + adres MAC mostu nadawcy (8 bajtów)
Port IDNumer portu nadawcy (2 bajty: priorytet + numer)
Message AgeCzas życia BPDU w sekundach
Max AgeMaksymalny czas przechowywania BPDU (domyślnie 20 s)
Hello TimeInterwał wysyłania BPDU (domyślnie 2 s)
Forward DelayCzas oczekiwania przed zmianą stanu portu (domyślnie 15 s)

BPDU wysyłane są na adres MAC 01:80:C2:00:00:00 – wszystkie przełączniki odbierają je i na ich podstawie budują bezzapętloną topologię drzewa.

Ramka BPDU (Bridge Protocol Data Unit) jest jednostką danych wymienianą między przełącznikami realizującymi protokół Spanning Tree (STP). Jej zadaniem jest przekazywanie informacji o topologii sieci, takich jak identyfikator mostu głównego (Root Bridge), koszt ścieżki do mostu głównego oraz stan poszczególnych portów. Ramki BPDU są wysyłane na adres multicast 01:80:C2:00:00:00, który jest zarezerwowany dla protokołów warstwy 2 (STP, RSTP, MSTP). Każdy przełącznik odbiera BPDU od swoich sąsiadów i na podstawie zawartych w nich informacji podejmuje decyzje o blokowaniu lub odblokowywaniu portów.

Struktura ramki BPDU obejmuje wiele pól, z których najważniejsze to: Root Bridge ID (8 bajtów: priorytet + adres MAC), Root Path Cost (koszt ścieżki), Bridge ID (identyfikator nadawcy), Port ID oraz znaczniki czasowe (Message Age, Max Age, Hello Time, Forward Delay). Domyślne wartości czasów w standardzie STP to: Hello Time 2 sekundy, Max Age 20 sekund, Forward Delay 15 sekund. W RSTP (Rapid Spanning Tree) czasy te są skrócone, a mechanizm uzgadniania portów jest szybszy, co pozwala na wykrycie i usunięcie pętli w ciągu kilkuset milisekund. Znajomość budowy BPDU jest niezbędna przy diagnostyce problemów z nadmiarowością w sieciach przełączanych.

BPDU są wysyłane w regularnych odstępach czasu (Hello Time) i zawierają informacje niezbędne do wyboru mostu głównego (Root Bridge) w topologii sieci. Każdy przełącznik porównuje odebrane BPDU z własnymi parametrami i na tej podstawie określa, czy ma stać się mostem głównym, czy pozostać mostem podrzędnym. W standardzie RSTP (802.1w) mechanizm ten został przyspieszony, co pozwala na detekcję awarii w czasie poniżej sekundy.
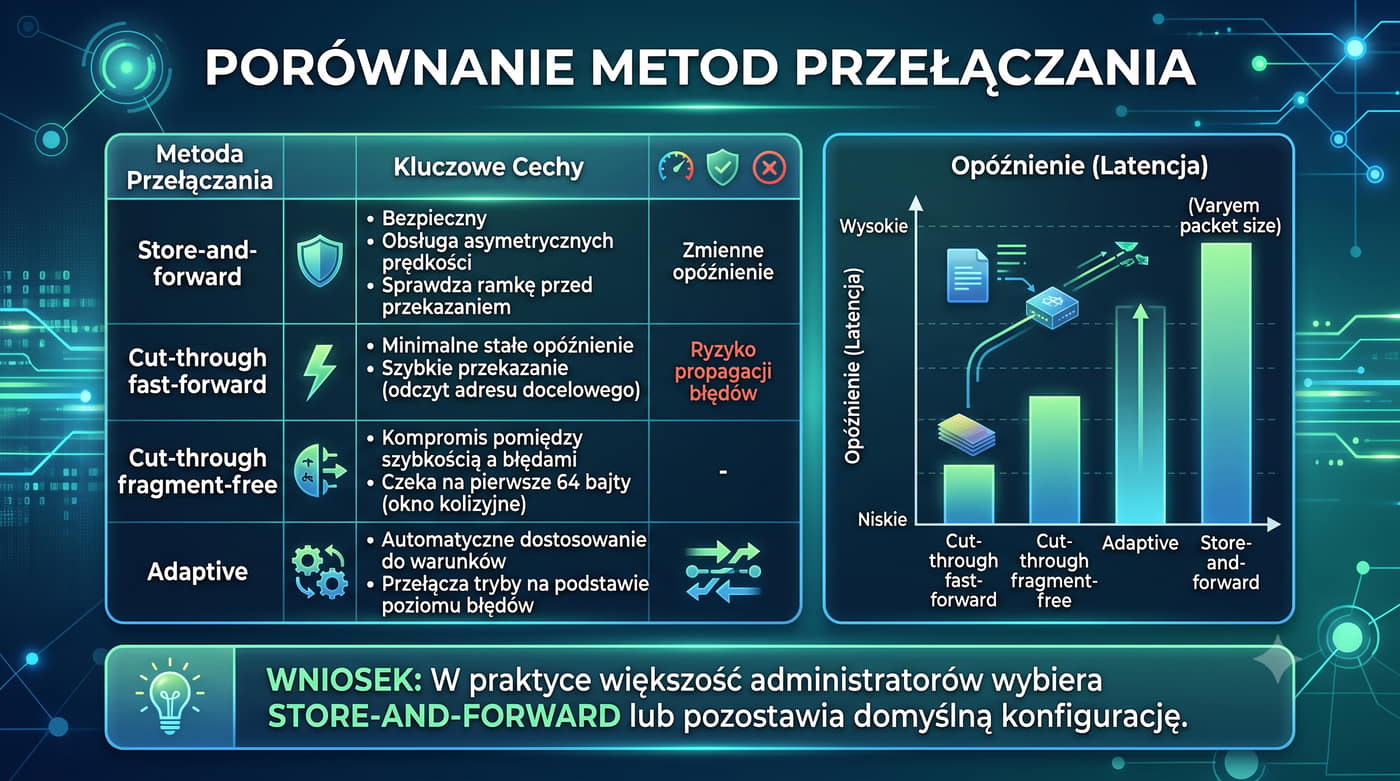
45/55 RouterOS – monitorowanie interfejsów

Narzędzia monitorujące w RouterOS:

Torch

Podgląd ruchu w czasie rzeczywistym na wybranym interfejsie. Przykład: /tool torch interface=ether1.
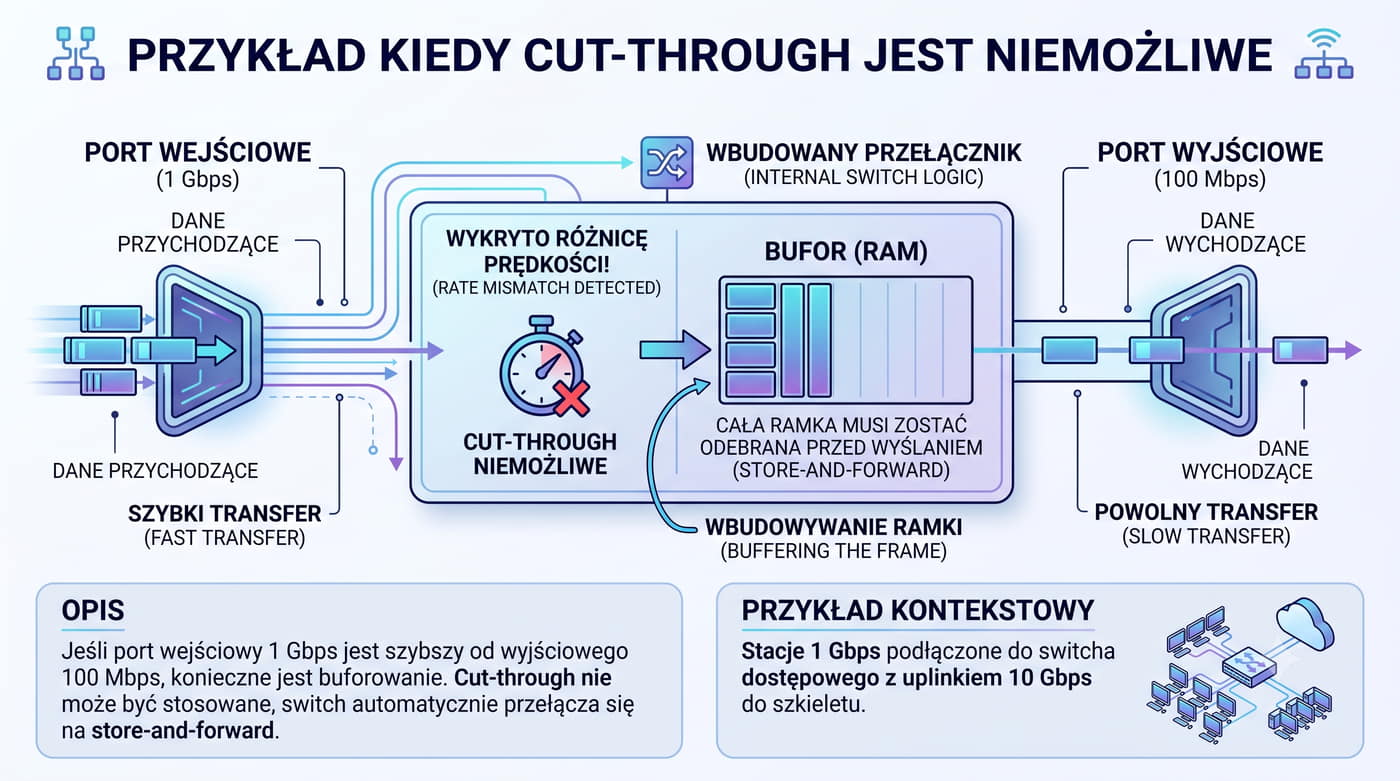
Sniffer

Przechwytywanie ruchu sieciowego do analizy. Konfiguracja: /tool sniffer start interface=ether1.

Profiler

Monitorowanie wydajności systemu (utylizacja CPU, pamięć). Polecenie: /tool profile.

Zastosowania:

  • Diagnostyka problemów z łącznością
  • Analiza ruchu w celu optymalizacji sieci
  • Monitorowanie obciążenia urządzeń

RouterOS oferuje kilka wbudowanych narzędzi do monitorowania interfejsów i ruchu sieciowego. Narzędzie Torch umożliwia bieżący podgląd ruchu na wybranym interfejsie – wyświetla adresy MAC źródłowe i docelowe, protokoły, rozmiary pakietów oraz szybkość transmisji. Torch jest uruchamiany poleceniem /tool torch interface=ether1, a wyniki są aktualizowane w czasie rzeczywistym. Narzędzie to jest szczególnie przydatne przy identyfikacji nadmiernego ruchu broadcast lub ataku DoS. Z kolei Sniffer (analizator ruchu) pozwala na przechwytywanie i zapis ramek do pliku PCAP, który można potem analizować w Wiresharku.

Profiler w RouterOS monitoruje wykorzystanie zasobów systemowych: obciążenie CPU, zużycie pamięci RAM oraz przepustowość poszczególnych interfejsów. Komenda /interface ethernet monitor ether1 once wyświetla aktualne statystyki interfejsu, w tym liczbę wysłanych i odebranych ramek, błędy CRC, kolizje oraz stan łącza (link status). Do kompleksowego monitorowania sieci RouterOS wspiera protokół SNMP (Simple Network Management Protocol), który umożliwia zbieranie statystyk z urządzenia przez zewnętrzne systemy monitorujące (Zabbix, PRTG). Konfiguracja SNMP polega na ustawieniu community string i zezwoleniu na dostęp z wybranych adresów IP.

46/55 RouterOS – VLAN na switchu (podstawy)

RouterOS - VLAN na switchu: VLAN Filtering, HW offload na CRS3xx/CRS5xx

/interface vlan add name=vlan10 vlan-id=10 interface=bridge1
/interface bridge vlan add bridge=bridge1 vlan-ids=10

1. VLAN Filtering

  • Filtrowanie ruchu VLAN na podstawie adresów MAC i portów.
  • Konfiguracja za pomocą komend: /interface vlan add, /interface bridge vlan add.

2. HW offload

  • Sprzętowe przełączanie ramek (L2 forwarding) w układzie ASIC, bez angażowania CPU.
  • Obsługiwane na urządzeniach CRS3xx/CRS5xx z procesorami ASIC.

RouterOS oferuje pełne wsparcie dla technologii VLAN (Virtual LAN) zgodnie ze standardem IEEE 802.1Q. VLAN-y są tworzone za pomocą interfejsów VLAN dodawanych do mostu: /interface vlan add name=vlan10 vlan-id=10 interface=bridge1. Każdy VLAN tworzy oddzielną domenę rozgłoszeniową, co pozwala na logiczną segmentację sieci bez konieczności stosowania dodatkowych przełączników. RouterOS wspiera również filtrowanie VLAN (bridge VLAN filtering), które umożliwia precyzyjne określenie, które porty mają należeć do których VLAN oraz jakie ramki mają być przekazywane z otagowaniem (tagged) lub bez (untagged).

W przełącznikach serii CRS3xx/CRS5xx filtrowanie VLAN może być realizowane sprzętowo (HW offload), co pozwala na przetwarzanie ramek VLAN z prędkością linii bez obciążania procesora. Funkcja ta jest szczególnie ważna w sieciach ISP, gdzie konieczne jest dostarczenie wielu VLAN do różnych klientów za pomocą jednego łącza (trunk). RouterOS umożliwia również konfigurację VLAN na interfejsach mostu z wykorzystaniem mostowania (bridge VLAN filtering) lub na interfejsach fizycznych (interface VLAN). Wybór metody zależy od architektury sieci i wymagań dotyczących wydajności.

W RouterOS konfiguracja VLAN wymaga zrozumienia różnicy między portem access (tagowanym lub untagged) a trunk (z wieloma VLAN). Port access należy do jednej VLAN i ramki wychodzą z niego bez znacznika (untagged), natomiast port trunk przesyła ramki z widocznym znacznikiem VLAN (tagged). Błędne zrozumienie tych koncepcji jest najczęstszą przyczyną problemów z łącznością między przełącznikami różnych producentów.

47/55 RouterOS – bezpieczeństwo portu

RouterOS umożliwia ograniczenie liczby adresów MAC na porcie oraz kontrolę nieznanego ruchu unicast:

/interface bridge port set [find interface=ether1] learn=auto
/interface bridge port set [find interface=ether2] learn=no
/interface bridge port set [find interface=ether1] unknown-unicast-flood=no
/interface bridge port print detail

Parametry:

  • learn=auto – dynamiczne uczenie się adresów MAC (domyślnie)
  • learn=no – blokada uczenia się nowych adresów MAC
  • unknown-unicast-flood=no – blokowanie nieznanego ruchu unicast

Bezpieczeństwo portu w RouterOS opiera się na mechanizmach kontroli uczenia się adresów MAC i blokowania nieznanego ruchu unicast. Parametr learn=auto (domyślny) pozwala na dynamiczne uczenie się adresów MAC podłączonych urządzeń. Ustawienie learn=no całkowicie blokuje uczenie się nowych adresów na danym interfejsie – switch będzie przekazywał ramki tylko do urządzeń, których adresy MAC zostały dodane ręcznie jako statyczne wpisy w tablicy hostów.

Dodatkowym mechanizmem bezpieczeństwa jest parametr unknown-unicast-flood=no, który blokuje zalewanie nieznanego ruchu unicast na dany port. Gdy przełącznik otrzyma ramkę do nieznanego adresu MAC, zamiast wysłać ją na wszystkie porty, po prostu ją odrzuca. Zapobiega to sytuacji, w której atakujący mógłby przechwycić ruch przez podsłuchiwanie podczas zalewania. W RouterOS można również skonfigurować listy dostępu (ACL) warstwy 2, które blokują ruch na podstawie adresów MAC źródłowych lub docelowych. Te mechanizmy, w połączeniu z ograniczeniem uczenia się MAC, stanowią podstawę bezpieczeństwa portu w sieciach opartych na RouterOS.

48/55 Przykład praktyczny – diagnostyka switcha

Przykład praktyczny – diagnostyka switcha krok po kroku

1. Krok 1: Sprawdź status urządzenia

show interfaces status

2. Krok 2: Zweryfikuj tablicę MAC

show mac address-table

3. Krok 3: Sprawdź ruch na porcie

show interfaces

show interfaces counters errors

4. Krok 4: Analiza błędów

  • show interfaces counters errors - liczniki błędów (CRC, runts, giants).
  • show log - przeszukaj dzienniki systemowe.

Diagnostyka przełącznika rozpoczyna się od sprawdzenia stanu interfejsów – które porty są aktywne (link up), jaka jest ich prędkość i tryb duplex. W systemie Cisco IOS używa się polecenia show interfaces status, które w przejrzystej tabeli przedstawia stan wszystkich portów. W RouterOS odpowiednikiem jest /interface ethernet print detail. Kolejnym krokiem jest weryfikacja tablicy MAC (show mac address-table w Cisco, /interface bridge host print w RouterOS) w celu potwierdzenia, że przełącznik prawidłowo uczy się adresów urządzeń podłączonych do poszczególnych portów. Jeśli adres MAC nie pojawia się w tablicy, może to wskazywać na problem z okablowaniem lub konfiguracją portu.

Analiza błędów interfejsu obejmuje sprawdzenie liczników CRC, kolizji, runts i giants. Wzrost liczby błędów CRC świadczy najczęściej o uszkodzonym kablu, zakłóceniach elektromagnetycznych lub niezgodności dupleksu. Kolizje (collisions) na porcie pracującym w full-duplex są zawsze anomalią i wskazują na poważny problem konfiguracyjny. W przypadku podejrzenia ataku MAC flooding należy przejrzeć liczbę wpisów w tablicy CAM i sprawdzić, czy nie pochodzą one z jednego portu. Systemy zarządzania siecią (Zabbix, PRTG) umożliwiają automatyczne monitorowanie tych parametrów i wysyłanie alertów w przypadku przekroczenia progów.

49/55 Podsumowanie bloku I

1. Hub vs Switch

2. Domeny kolizyjne

3. Full-duplex

Switch = wiele domen kolizyjnych, full-duplex, brak CSMA/CD. Hub vs switch – różnica jakościowa (L1 vs L2). Segmentacja domeny kolizyjnej była przełomem porównywalnym do przejścia z łączności radiowej na przewodową.

Podsumowanie bloku I skupia się na fundamentalnej różnicy między hubem a switchem oraz konsekwencjach wynikających z segmentacji domen kolizyjnych. Hub, działając w warstwie fizycznej, tworzy jedną domenę kolizyjną dla wszystkich podłączonych urządzeń, co przy większej liczbie hostów prowadzi do degradacji wydajności z powodu częstych kolizji i retransmisji. Przełącznik natomiast tworzy oddzielną domenę kolizyjną dla każdego portu, co umożliwia pracę w trybie full-duplex i eliminuje mechanizm CSMA/CD. Dzięki temu każde łącze może pracować z pełną prędkością nominalną w obu kierunkach jednocześnie.

Drugim kluczowym wnioskiem jest zrozumienie, że przełącznik nie eliminuje domeny rozgłoszeniowej – ramki broadcast wciąż są dostarczane do wszystkich urządzeń w tej samej sieci logicznej. Ograniczenie zasięgu broadcastu wymaga stosowania VLAN lub routerów, które blokują ruch rozgłoszeniowy na granicach podsieci. Blok I wprowadził również pojęcia wirespeed i non-blocking, które określają zdolność przełącznika do przetwarzania ramek z prędkością linii na wszystkich portach jednocześnie. Te parametry są kluczowe przy wyborze przełącznika do sieci o wysokich wymaganiach przepustowości, takich jak data center czy sieci szkieletowe.

Pierwszy blok prezentacji stanowił wprowadzenie do przełączania Ethernet i mechanizmów, które umożliwiły budowę skalowalnych sieci lokalnych. Wiedza ta jest fundamentem dla zrozumienia bardziej zaawansowanych zagadnień, takich jak VLAN, STP czy routing między sieciami. Bez solidnego opanowania tych podstaw dalsza nauka sieci komputerowych byłaby znacznie utrudniona.

50/55 Podsumowanie bloku II

W sercu nowoczesnego przełącznika sieciowego znajduje się złożona architektura, w której kluczowe elementy współpracują, aby efektywnie przetwarzać ruch sieciowy. Centralnym punktem jest układ ASIC (Application-Specific Integrated Circuit), który odpowiada za fizyczne przekazywanie ramek między portami przełącznika. ASIC zapewnia szybkie i wydajne przekazywanie ramek, minimalizując opóźnienia w sieci.

CPU przełącznika pełni rolę mózgu urządzenia – wykonuje złożone zadania kontrolne, takie jak obsługa protokołów STP (Spanning Tree Protocol), negocjacja VLAN Trunking (DTP) czy diagnostyka. W odróżnieniu od ASIC, który przekazuje ramki w sprzęcie, CPU działa w oprogramowaniu i jest wolniejszy, ale niezbędny do zarządzania przełącznikiem.

Kluczowymi elementami pamięci są TCAM i CAM. CAM (Content-Addressable Memory) przechowuje tablicę adresów MAC, mapując każdy adres MAC na numer portu – pozwala to ASIC-owi błyskawicznie podjąć decyzję o przekazaniu ramki. TCAM (Ternary CAM) działa na wartościach trójstanowych (0, 1, „dowolne”) i jest używany do przechowywania list ACL oraz wpisów tablicy routingu, umożliwiając szybkie dopasowanie wzorców bitowych.

Podsumowanie bloku II dotyczy architektury sprzętowej przełącznika i roli poszczególnych komponentów w procesie przełączania. Centralnym elementem jest układ ASIC (Switch Fabric), który wykonuje operacje przekazywania ramek w sprzęcie z szybkością rzędu mikrosekund. ASIC zawiera matrycę krzyżową łączącą porty oraz silniki wyszukiwania adresów w pamięci CAM. Procesor zarządzający (CPU) obsługuje zadania kontrolne, takie jak protokoły STP, konfiguracja VLAN i diagnostyka, ale nie uczestniczy bezpośrednio w przekazywaniu ramek. Właściwe zrozumienie podziału zadań między ASIC a CPU jest kluczowe dla projektowania wydajnych sieci.

Pamięć CAM i TCAM stanowią kolejny istotny element architektury przełącznika. CAM zapewnia błyskawiczne wyszukiwanie adresów MAC w tablicy przekazywania, podczas gdy TCAM umożliwia przechowywanie reguł ACL i wpisów routingu z obsługą wzorców (wildcards). Pamięć buforowa (packet buffer) pełni rolę bufora wyrównawczego przy przeciążeniach i przy łączeniu portów o różnych prędkościach. Wszystkie te komponenty współpracują ze sobą, aby zapewnić szybkie i niezawodne przekazywanie ramek, co jest fundamentem działania nowoczesnych sieci Ethernet.

51/55 Podsumowanie bloku III

Podsumowanie bloku III: Autonegocjacja, Duplex, Parametry interfejsu

Najczęstszy problem: niezgodność dupleksu. Half-duplex vs full-duplex – full-duplex podwaja przepustowość. MDI/MDI-X, Flow Control, MTU, Jumbo Frames – dodatkowe parametry interfejsów.

Podsumowanie bloku III obejmuje zagadnienia autonegocjacji, trybów duplex oraz parametrów interfejsów Ethernet. Autonegocjacja jest mechanizmem automatycznego uzgadniania prędkości i dupleksu między urządzeniami, który działa poprzez wymianę impulsów FLP. Mimo swojej użyteczności autonegocjacja może prowadzić do problemów, szczególnie gdy jedno z urządzeń ma ręcznie ustawione parametry. Najczęstszym problemem jest niezgodność dupleksu (duplex mismatch), która objawia się licznymi błędami CRC i kolizjami, a jej diagnostyka wymaga analizy statystyk interfejsu.

Tryb full-duplex jest standardem w nowoczesnych sieciach, oferując jednoczesne nadawanie i odbiór danych na tym samym łączu. Half-duplex, wymagający mechanizmu CSMA/CD, jest używany wyłącznie w starszych instalacjach. Dodatkowe parametry interfejsów, takie jak MDI/MDI-X, Flow Control, MTU i Jumbo Frames, pozwalają na optymalizację działania sieci pod kątem konkretnych zastosowań. Przykłady konfiguracji w Cisco IOS i RouterOS pokazują praktyczne aspekty zarządzania interfejsami, a narzędzia diagnostyczne (ping, traceroute, iperf3, Wireshark) umożliwiają weryfikację poprawności działania sieci.

Zrozumienie mechanizmów autonegocjacji i dupleksu jest niezbędne dla każdego administratora sieci, ponieważ nieprawidłowa konfiguracja tych parametrów jest jedną z najczęstszych przyczyn problemów z wydajnością sieci Ethernet. Nawet w nowoczesnych sieciach, gdzie autonegocjacja jest domyślnie włączona, mogą wystąpić sytuacje wymagające ręcznej interwencji. Dlatego każdy inżynier sieciowy powinien umieć diagnozować i rozwiązywać problemy związane z tymi parametrami.

52/55 Podsumowanie bloku IV

Podsumowanie bloku IV: Metody przełączania

1. Store-and-Forward:

  • Przetwarza całe ramki przed przekazaniem.
  • Wykrywa błędy (CRC) i odrzuca ramki uszkodzone.
  • Wolniejszy, ale bardziej niezawodny.

2. Cut-Through:

  • Przekazywanie rozpoczyna się po odczytaniu adresu docelowego, bez weryfikacji FCS.
  • Szybszy, przepuszcza ramki z błędami.

3. Adaptive (przełączanie adaptacyjne):

  • Łączy cechy obu metod, dynamicznie dostosowując się do poziomu błędów na porcie.
  • Optymalizuje opóźnienia i przepustowość w zmiennych warunkach.

Podsumowanie bloku IV dotyczy metod przełączania ramek w przełącznikach Ethernet. Store-and-Forward odbiera całą ramkę przed podjęciem decyzji o przekazaniu, co pozwala na weryfikację integralności (FCS) i odrzucenie uszkodzonych ramek. Metoda ta jest niezawodna i niezbędna przy łączeniu portów o różnych prędkościach, ale wprowadza opóźnienie proporcjonalne do rozmiaru ramki. Cut-Through rozpoczyna przekazywanie natychmiast po odczytaniu adresu MAC docelowego, osiągając minimalne opóźnienie kosztem braku weryfikacji poprawności ramki. Jest to metoda preferowana w sieciach o niskich opóźnieniach, takich jak klastry HPC czy sieci giełdowe.

Adaptive Switching łączy zalety obu metod, dynamicznie dostosowując sposób przełączania do bieżącego poziomu błędów na porcie. Gdy liczba błędnych ramek jest niska, przełącznik pracuje w trybie Cut-Through; gdy wzrasta, przełącza się na Store-and-Forward. Wybór metody przełączania zależy od wymagań aplikacji i charakterystyki sieci. Większość nowoczesnych przełączników oferuje sprzętowe wsparcie dla wszystkich metod, a administrator może skonfigurować tryb przełączania na poziomie pojedynczego portu lub globalnie dla całego urządzenia. Zrozumienie różnic między tymi metodami jest kluczowe przy projektowaniu sieci o określonych wymaganiach wydajnościowych.

53/55 Pytania kontrolne

Pytania kontrolne

Blok III:

1. Jak działa proces autonegocjacji w sieci Ethernet?

2. Jaka jest różnica między half-duplex a full-duplex?

3. Wymień trzy parametry interfejsu fizycznego i opisz ich znaczenie.

Blok IV:

1. Porównaj Store-and-Forward i Cut-Through pod kątem wydajności i błędów.

2. W jakich sytuacjach stosuje się przełączanie Adaptive?

3. Dlaczego w sieciach z dużym ruchem preferuje się full-duplex?

Pytania kontrolne pozwalają na samodzielne sprawdzenie wiedzy zdobytej podczas prezentacji. Blok III koncentruje się na autonegocjacji, trybach duplex i parametrach interfejsów. Aby odpowiedzieć na pytanie o działanie autonegocjacji, należy opisać proces wymiany impulsów FLP i wybór najwyższej wspólnej prędkości. Różnica między half-duplex a full-duplex polega na możliwości jednoczesnego nadawania i odbioru – w half-duplex transmisja jest naprzemienna, co ogranicza przepustowość. Trzy parametry interfejsu fizycznego to prędkość (10/100/1000 Mbps), tryb duplex oraz MTU, które wpływają na przepustowość i niezawodność łącza.

Pytania z bloku IV dotyczą metod przełączania. Store-and-Forward zapewnia weryfikację integralności ramek kosztem większego opóźnienia, natomiast Cut-Through minimalizuje opóźnienia, ale nie sprawdza poprawności ramek przed przekazaniem. Przełączanie Adaptive stosuje się w sieciach o zmiennych warunkach transmisji, gdzie poziom błędów może się okresowo zmieniać. Full-duplex jest preferowany w sieciach z dużym ruchem, ponieważ eliminuje kolizje i umożliwia jednoczesną transmisję w obu kierunkach, podwajając efektywną przepustowość łącza w porównaniu z half-duplex. Odpowiedzi na te pytania wymagają zrozumienia zarówno teorii, jak i praktycznych aspektów konfiguracji przełączników.

54/55 Najważniejsze wnioski

Najważniejsze wnioski

1. Autonegocjacja eliminuje ręczną konfigurację parametrów połączenia.

2. Full-Duplex jest standardem w nowoczesnych sieciach ze względu na wydajność.

3. Store-and-Forward gwarantuje brak błędów, ale kosztem opóźnień.

4. Przełączanie Adaptive optymalizuje działanie w heterogenicznych środowiskach sieciowych.

5. Parametry interfejsu (np. prędkość) muszą być spójne dla obu urządzeń końcowych.

Najważniejsze wnioski z prezentacji podkreślają kluczowe aspekty przełączania Ethernet. Autonegocjacja znacznie upraszcza konfigurację sieci, eliminując konieczność ręcznego ustawiania prędkości i dupleksu na każdym interfejsie. Należy jednak pamiętać, że nieprawidłowe działanie autonegocjacji może prowadzić do poważnych problemów wydajnościowych, szczególnie w przypadku niezgodności dupleksu. Tryb full-duplex jest standardem w nowoczesnych sieciach Ethernet, ponieważ podwaja przepustowość łącza i eliminuje kolizje, co jest niezbędne dla aplikacji wymagających wysokiej wydajności.

Store-and-Forward gwarantuje integralność danych poprzez weryfikację sumy FCS, ale kosztem większych opóźnień. Cut-Through oferuje minimalne opóźnienie, ale nie sprawdza poprawności ramek, co może prowadzić do marnowania pasma na błędne transmisje. Adaptive Switching stanowi kompromis między tymi dwoma podejściami, dynamicznie dostosowując metodę przełączania do warunków sieciowych. Podstawową zasadą konfiguracji interfejsów jest zapewnienie spójności parametrów (prędkość, duplex, MTU) na obu końcach łącza. Znajomość tych zagadnień jest niezbędna dla każdego administratora sieci odpowiedzialnego za projektowanie i utrzymanie infrastruktury LAN.

55/55 Koniec prezentacji

Ethernet przełączany stanowi obecnie fundament nowoczesnych sieci komputerowych. Dzięki zastosowaniu przełączników, każdy port urządzenia stanowi osobną domenę kolizyjną, co eliminuje problemy związane z CSMA/CD i umożliwia pracę w trybie full-duplex z pełną przepustowością łącza.

Prezentacja przedstawiła kompleksową wiedzę na temat budowy i działania przełączników Ethernet – od architektury sprzętowej (ASIC, CPU, TCAM/CAM), przez mechanizmy przetwarzania ramek (learning, forwarding, filtering), metody przełączania (Store-and-Forward, Cut-Through, Adaptive), aż po praktyczną konfigurację w systemach Cisco IOS i MikroTik RouterOS.

Zachęcamy do samodzielnego eksperymentowania w środowisku wirtualnym (GNS3, EVE-NG, VirtualBox z RouterOS CHR). Praktyczne doświadczenie zdobyte w laboratorium jest nieocenione w utrwaleniu wiedzy teoretycznej i przygotowaniu do pracy z rzeczywistą infrastrukturą sieciową. Kolejne wykłady rozwiną tematykę o zagadnienia VLAN, STP, routing dynamiczny i bezpieczeństwo sieci.

Prezentacja "Ethernet przełączany – przełączniki sieciowe" stanowi kompleksowe omówienie architektury, działania i konfiguracji współczesnych przełączników Ethernet. Przedstawione zagadnienia obejmują zarówno podstawy teoretyczne (model OSI, domeny kolizyjne i rozgłoszeniowe), jak i praktyczne aspekty sprzętowe (ASIC, CPU, CAM/TCAM) oraz konfiguracyjne (Cisco IOS, MikroTik RouterOS). Szczególny nacisk położono na zrozumienie mechanizmów uczenia adresów MAC, przekazywania ramek oraz metod przełączania, które decydują o wydajności i niezawodności sieci.

Kolejne wykłady rozwiną tematykę o zagadnienia VLAN, protokołów Spanning Tree, routingu dynamicznego i bezpieczeństwa sieci. Zachęcamy do samodzielnego eksperymentowania w środowiskach wirtualnych (GNS3, EVE-NG, VirtualBox z RouterOS CHR), które pozwalają na bezpieczne testowanie konfiguracji bez ryzyka zakłócenia działania produkcyjnej sieci. Praktyczne doświadczenie zdobyte w laboratorium jest nieocenione w utrwaleniu wiedzy teoretycznej i przygotowaniu do pracy z rzeczywistą infrastrukturą sieciową. Dziękujemy za uwagę i zapraszamy do dalszego zgłębiania tajników sieci komputerowych.

Prezentacja ta stanowi kompleksowe wprowadzenie do tematyki przełączania Ethernet, łącząc wiedzę teoretyczną z praktycznymi przykładami konfiguracji. Studenci, którzy opanują przedstawione zagadnienia, będą przygotowani do samodzielnej pracy z przełącznikami w środowisku laboratoryjnym i produkcyjnym. Kolejne wykłady rozszerzą tę wiedzę o zaawansowane funkcje, takie jak VLAN, STP oraz bezpieczeństwo warstwy drugiej.