Wprowadzenie do sieci komputerowych i historii Ethernetu
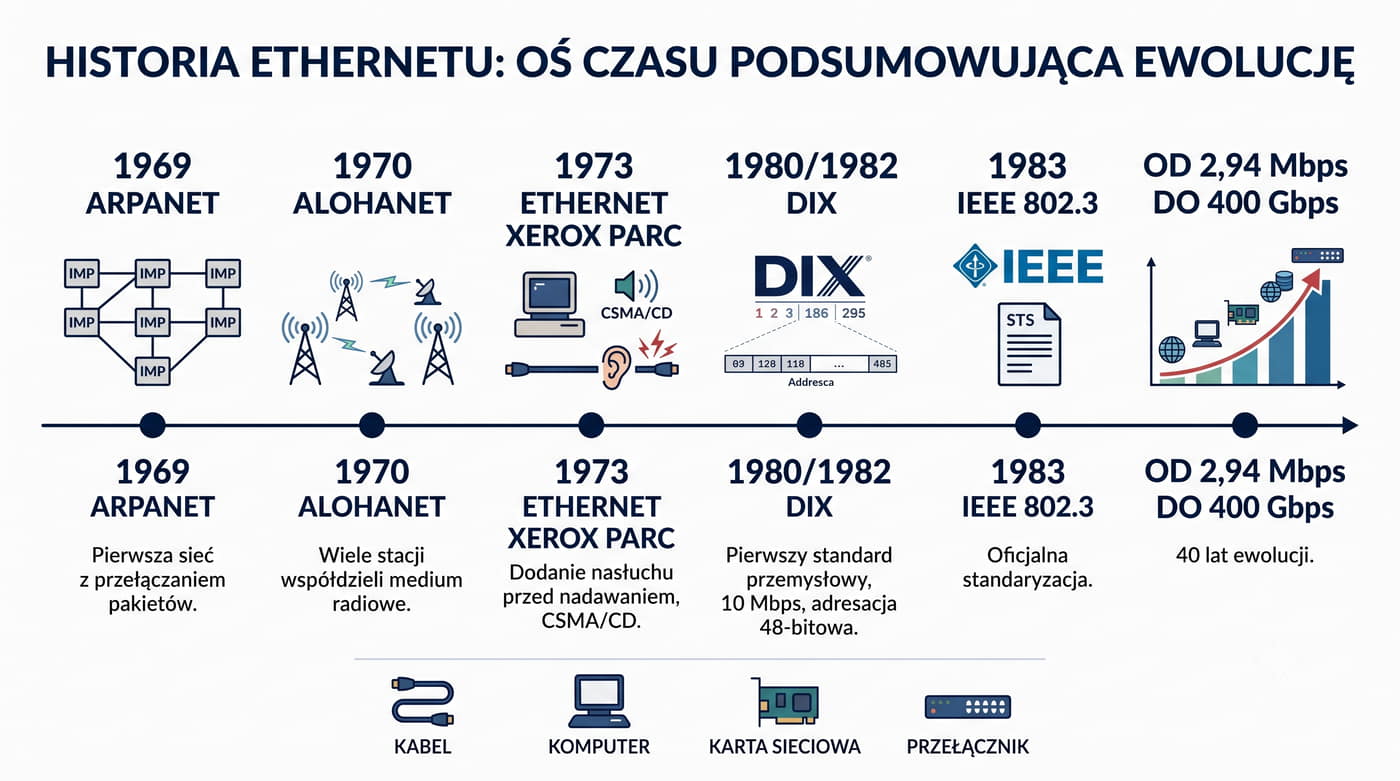
Prezentacja obejmuje historię sieci od ARPANET i ALOHAnet, przez narodziny Ethernetu w Xerox PARC, po standaryzację IEEE 802.3.
Ethernet jest dziś dominującą technologią sieci lokalnych na świecie, a jego znajomość stanowi absolutną podstawę wykształcenia każdego inżyniera sieciowego.
Zrozumienie ewolucji Ethernetu od współdzielonego kabla koncentrycznego do nowoczesnych sieci przełączanych o przepustowości 400 Gbps i więcej pozwala docenić, jak daleko zaszła technologia w ciągu pięciu dekad.
Szczególnie istotne jest przyswojenie koncepcji CSMA/CD, która choć została wyparta przez przełączanie full-duplex, stanowi klucz do zrozumienia fundamentalnych ograniczeń fizycznych sieci współdzielonych.
Wiedza ta jest niezbędna przy projektowaniu niezawodnych i skalowalnych infrastruktur sieciowych.
Prezentacja kładzie nacisk na praktyczne aspekty działania sieci, łącząc teorię z przykładami konfiguracji i diagnostyki.
Student po opanowaniu materiału powinien swobodnie posługiwać się pojęciami takimi jak domena kolizyjna, CSMA/CD, adresacja MAC i IPv4 oraz protokół ARP.
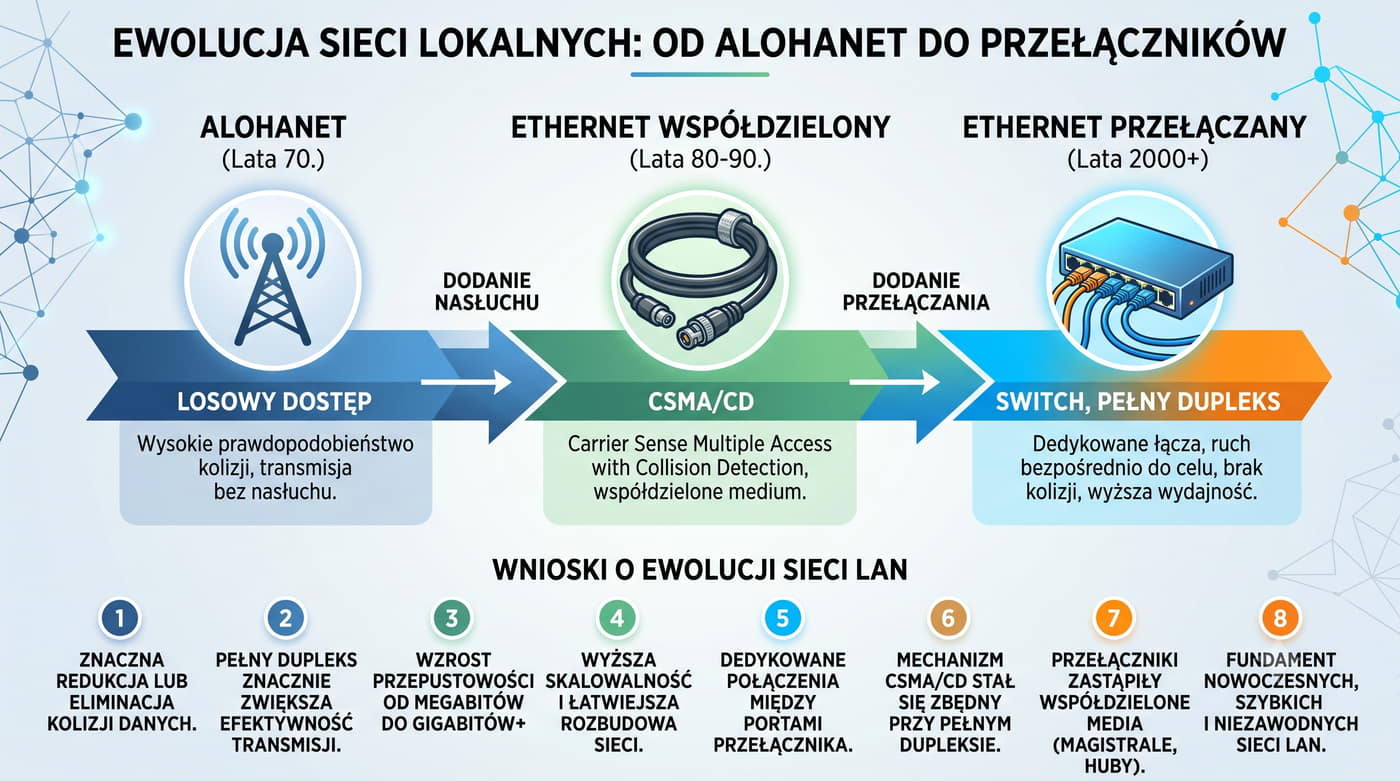
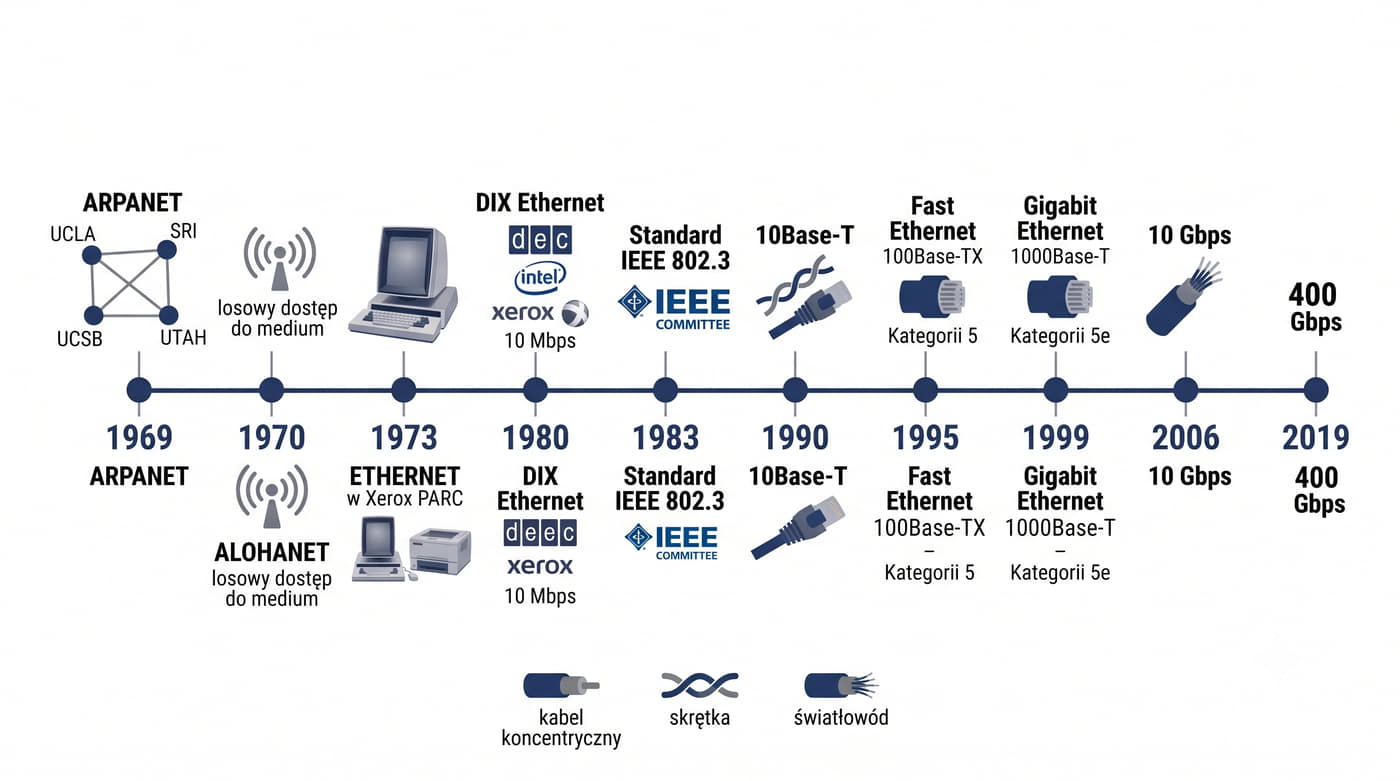
Ethernet narodził się w 1973 roku w Xerox PARC jako ulepszenie protokołu ALOHA.
Przez dekady ewoluował od szybkości 2,94 Mbps do dzisiejszych 400 Gbps.
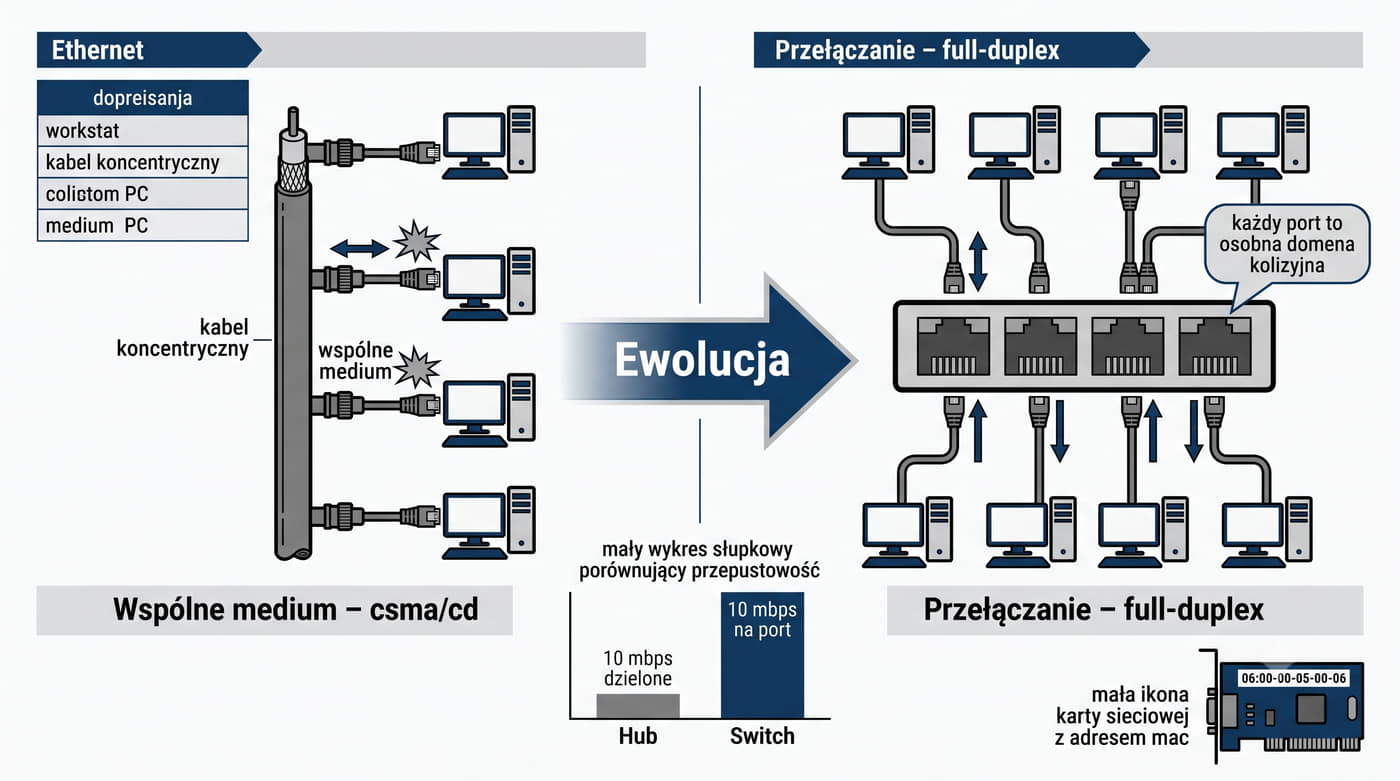
W swojej pierwotnej formie Ethernet był siecią współdzielonego medium – wszystkie stacje podłączone do jednego kabla koncentrycznego dzieliły przepustowość i rywalizowały o dostęp za pomocą protokołu CSMA/CD.
Ethernet przeszedł niezwykłą drogę od eksperymentalnej sieci w Xerox PARC pracującej z szybkością 2,94 Mbps do dzisiejszych standardów IEEE 802.3 oferujących 400 Gbps.
Kluczowym momentem tej ewolucji było przejście od modelu współdzielonego medium z protokołem CSMA/CD do architektury przełączanej z izolowanymi domenami kolizyjnymi.
Wczesny Ethernet oparty na kablu koncentrycznym i protokole CSMA/CD stanowił rewolucję w komunikacji lokalnej, ale jego skalowalność była poważnie ograniczona przez mechanizm kolizji i wykładniczego algorytmu opóźniania (backoff).
Przejście do topologii przełączanej z izolowanymi domenami kolizyjnymi stanowiło moment przełomowy w historii sieci komputerowych.
Równie istotna była standaryzacja IEEE 802.3, która przekształciła Ethernet z laboratoryjnego eksperymentu w otwarty standard dostępny dla wszystkich producentów.
Bez współpracy takich firm jak DEC, Intel i Xerox oraz prac komitetu IEEE 802, Ethernet mógłby pozostać jedynie ciekawostką akademicką.
Podręcznik Tanenbauma i Wetheralla od lat stanowi światowy standard akademicki w dziedzinie sieci komputerowych, łącząc głębię teoretyczną z praktycznymi przykładami.
Jest to pozycja obowiązkowa dla każdego studenta informatyki, szczególnie w zakresie warstwowych modeli sieci i protokołów komunikacyjnych.
Książka Spurgeona poświęcona wyłącznie Ethernetowi to nieocenione źródło wiedzy dla administratorów sieci, zawierające szczegółowe informacje o implementacji, diagnostyce i optymalizacji sieci Ethernet.
Z kolei podręcznik Kurose i Rossa oferuje współczesne ujęcie tematyki z naciskiem na protokoły internetowe i architekturę TCP/IP.
Studenci powinni aktywnie korzystać z narzędzi takich jak Wireshark do przechwytywania i analizy rzeczywistego ruchu sieciowego, co pozwala praktycznie zweryfikować poznane koncepcje teoretyczne.
Szczególnie polecane jest przechwytywanie ramek ARP i analiza budowy ramki Ethernet w środowisku laboratoryjnym.
W latach 60. i 70.
XX wieku komputery mainframe obsługiwały wiele terminali, ale nie komunikowały się między sobą.
Potrzeba wymiany danych i współdzielenia zasobów doprowadziła do powstania pierwszych sieci komputerowych.
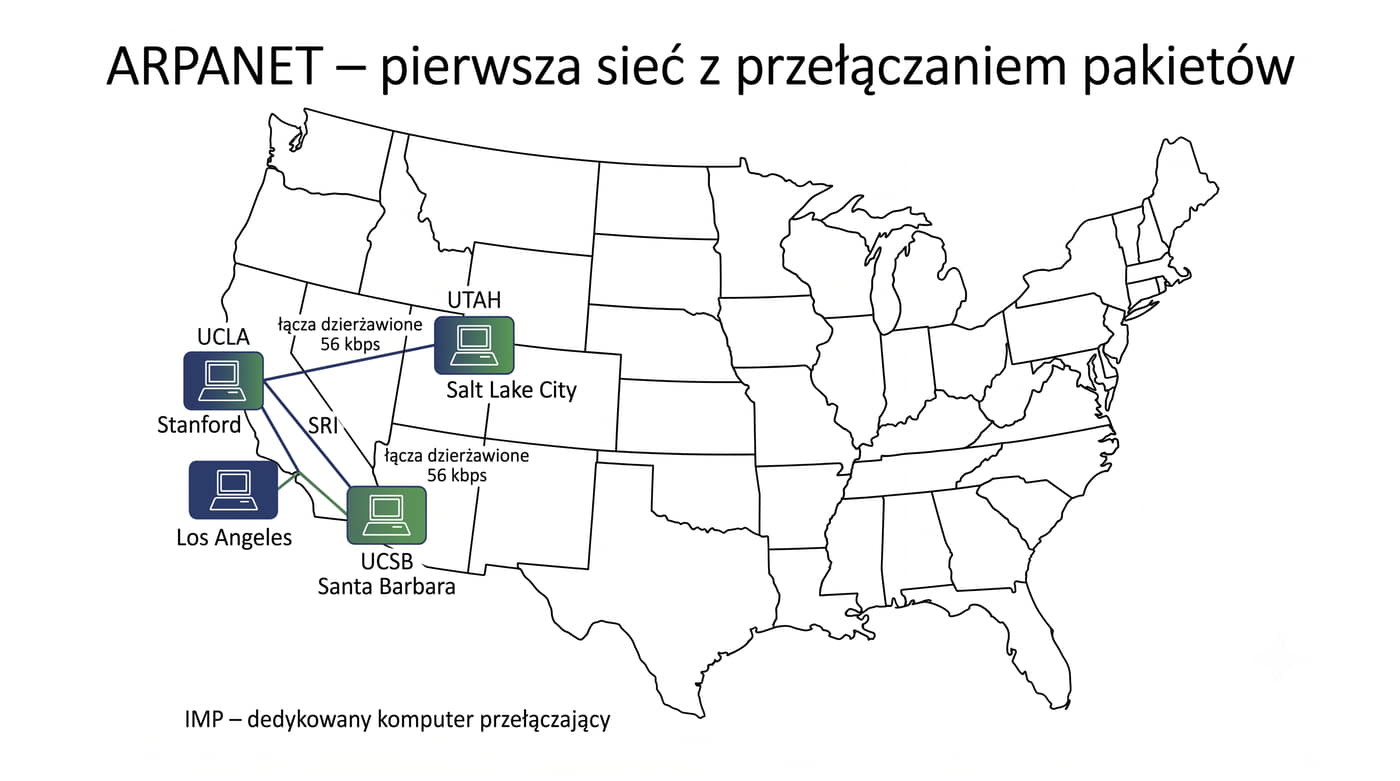
ARPANET, utworzony w 1969 roku przez ARPA (Advanced Research Projects Agency), był pierwszą siecią z przełączaniem pakietów. Łączył cztery węzły: UCLA, Stanford Research Institute, UC Santa Barbara i University of Utah.
Koncepcja przełączania pakietów, opracowana niezależnie przez Paula Barana i Donalda Daviesa, polegała na dzieleniu danych na małe pakiety przesyłane niezależnie przez sieć.
Przełączanie pakietów, opracowane niezależnie przez Paula Barana w RAND Corporation i Donalda Daviesa w National Physical Laboratory, stanowiło fundamentalne odejście od dominującej wówczas komutacji łączy.
Baran zaproponował koncepcję sieci rozproszonej odpornej na uszkodzenia, w której dane są dzielone na bloki i przesyłane przez wiele alternatywnych ścieżek.
ARPANET był pierwszą realizacją tych idei na skalę ogólnokrajową, wykorzystując komputery IMP (Interface Message Processor) firmy Honeywell jako dedykowane węzły przełączające.
IMP-y były prekursorami współczesnych routerów i komunikowały się za pomocą protokołu NCP (Network Control Protocol), poprzednika dzisiejszego TCP/IP.
Z perspektywy inżynierskiej kluczową zaletą przełączania pakietów jest efektywne wykorzystanie pasma poprzez statystyczną multipleksację strumieni danych.
W odróżnieniu od komutacji łączy, gdzie pasmo jest rezerwowane na stałe nawet podczas ciszy w transmisji, przełączanie pakietów pozwala na dynamiczne przydzielanie zasobów transmisyjnych w zależności od bieżącego zapotrzebowania poszczególnych strumieni danych.
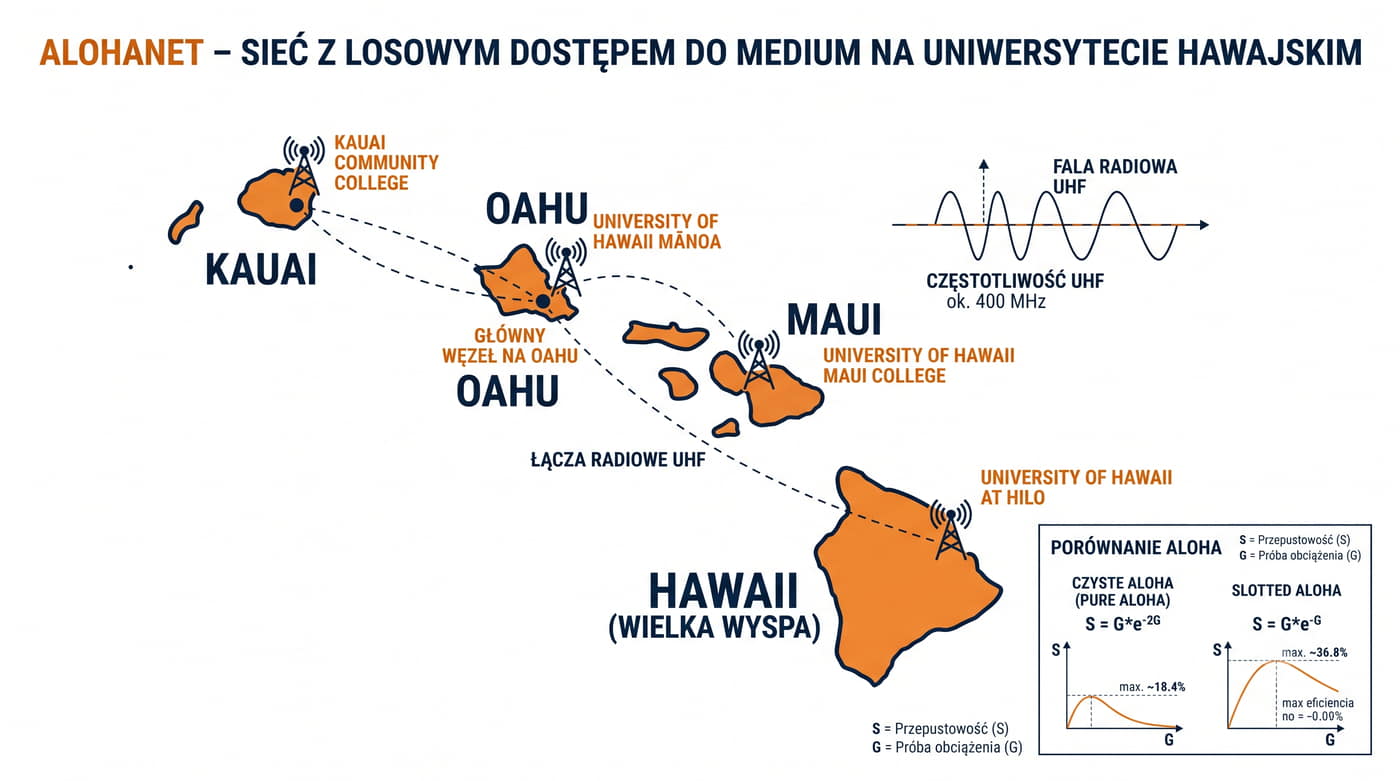
ALOHAnet powstał na Uniwersytecie Hawajskim jako sieć radiowa UHF.
Była to odpowiedź na potrzebę komunikacji między kampusami rozrzuconymi po różnych wyspach.
Protokół ALOHA działał w ten sposób, że stacje nadawały dane natychmiast po ich pojawieniu się.
Gdy dwie stacje nadawały jednocześnie, dochodziło do kolizji, a uszkodzone ramki były retransmitowane po losowym czasie.
To proste, ale rewolucyjne podejście stało się inspiracją dla późniejszych protokołów dostępu do medium.
ALOHAnet, zaprojektowany pod kierownictwem Normana Abramsona na Uniwersytecie Hawajskim, rozwiązywał unikalny problem geograficzny połączenia kampusów rozrzuconych po czterech głównych wyspach archipelagu.
Wykorzystanie transmisji radiowej UHF eliminowało konieczność kosztownego okablowania podmorskiego i stanowiło pierwsze na dużą skalę wdrożenie sieci z losowym dostępem do medium.
Protokół ALOHA w wersji podstawowej, zwanej czystym ALOHA, charakteryzował się ekstremalną prostotą: stacja nadawała natychmiast po pojawieniu się danych w buforze, bez jakiegokolwiek mechanizmu koordynacji z innymi stacjami.
Prawdopodobieństwo kolizji rosło proporcjonalnie do obciążenia sieci, a analiza matematyczna pokazuje, że maksymalna przepustowość czystego ALOHA wynosi zaledwie 1/(2e), czyli około 18,4% teoretycznej przepustowości łącza.
Wersja Slotted ALOHA, wprowadzająca synchronizację czasową i podział czasu na szczeliny o długości równej czasowi transmisji ramki, zwiększała maksymalną przepustowość do 1/e, czyli około 36,8%.
Mimo tych ograniczeń ALOHAnet udowodnił praktyczną wykonalność koncepcji losowego dostępu do współdzielonego medium i dostarczył bezcennych danych eksperymentalnych, które posłużyły później projektantom Ethernetu.
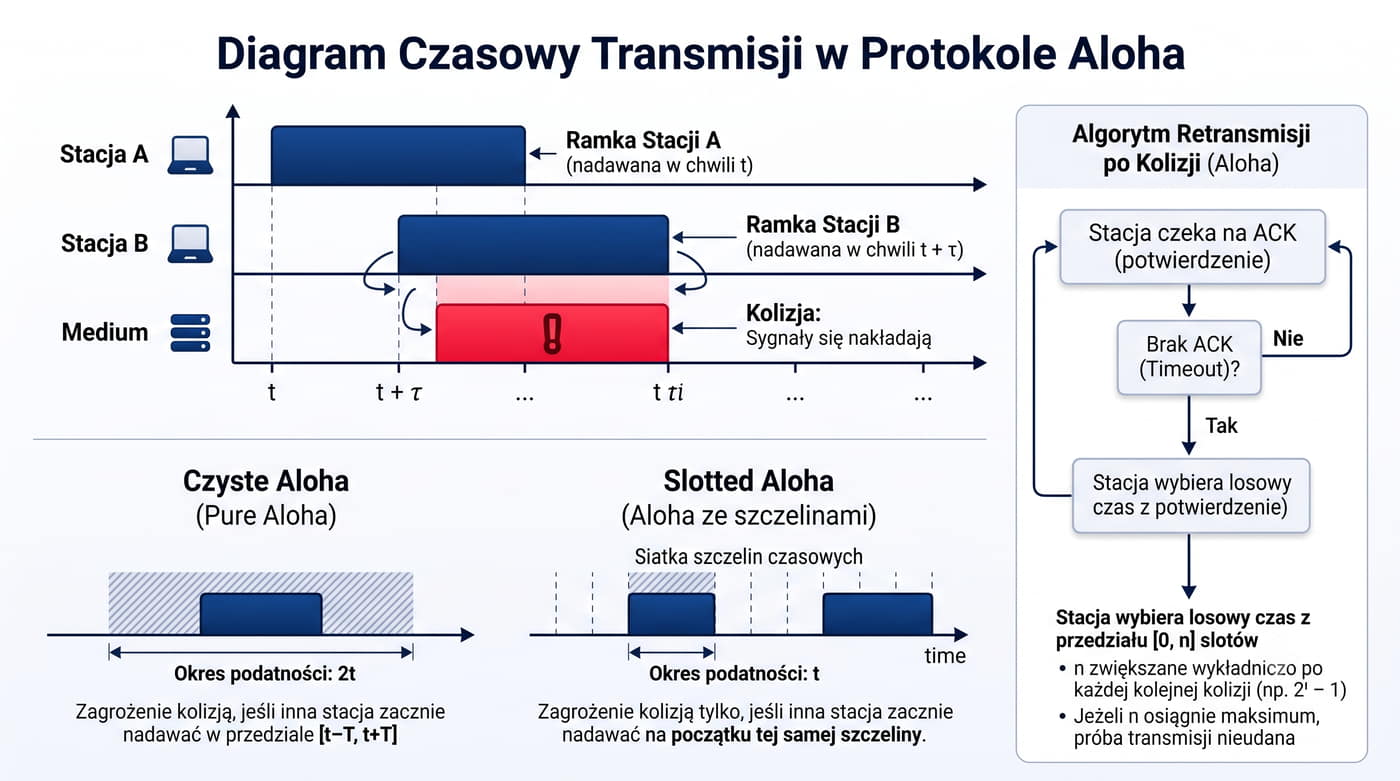
Przykład: Stacja A nadaje w chwili t, stacja B w chwili t + tau.
Do kolizji dochodzi, jeśli tau jest krótszy niż czas transmisji całej ramki.
W czystym ALOHA stacja nadawała ramkę natychmiast po pojawieniu się danych.
Czas propagacji między wyspami wynosił około 10 mikrosekund dla fal radiowych UHF.
Jeśli w tym czasie inna stacja również nadawała, dochodziło do kolizji – obie ramki ulegały uszkodzeniu.
Mechanizm retransmisji działał następująco: stacja oczekiwała potwierdzenia (ACK) od odbiorcy.
Jeśli ACK nie nadszedł w ustalonym czasie, nadawca zakładał kolizję, czekał losowy czas z przedziału od 0 do N slotów i ponawiał transmisję.
N zwiększano wykładniczo do maksymalnej wartości.
W czystym ALOHA okres podatności na kolizje wynosi dwukrotność czasu transmisji ramki T, co oznacza, że każda ramka jest zagrożona kolizją przez 2T czasu.
Matematycznie przepustowość S czystego ALOHA wyraża się wzorem S = G * e^(-2G), gdzie G oznacza całkowite obciążenie sieci wyrażone jako liczba ramek przypadająca na czas transmisji jednej ramki.
Maksimum tej funkcji występuje dla G = 0,5 i wynosi S_max = 1/(2e) ≈ 0,184.
Dla Slotted ALOHA wzór przyjmuje postać S = G * e^(-G), z maksimum S_max = 1/e ≈ 0,368 dla G = 1.
Algorytm retransmisji w ALOHA, przewidujący wykładniczy wzrost okna opóźnienia po kolejnych kolizjach, był bezpośrednim prekursorem algorytmu wykładniczego backoff stosowanego później w Ethernetowym CSMA/CD.
Mimo że czyste ALOHA jest obecnie rzadko używane jako samodzielny protokół dostępu do medium, jego zmodyfikowane warianty znajdują zastosowanie w sieciach satelitarnych, systemach RFID oraz w protokole dostępu do kanału w sieciach LoRaWAN.
Ethernet został stworzony w 1973 roku w Xerox Palo Alto Research Center przez Roberta Metcalfe'a i Davida Boggsa.
Inspiracją był protokół ALOHA, do którego dodano kluczowy mechanizm nasłuchu nośnej przed transmisją (Carrier Sense) oraz wykrywanie kolizji w trakcie nadawania (Collision Detection) – tak narodził się CSMA/CD.
Pierwsza implementacja Ethernetu łączyła komputery Xerox Alto z drukarką laserową i serwerami plików z szybkością 2,94 Mbps.
Wykorzystywano kabel koncentryczny jako wspólne medium transmisyjne, do którego podłączano do 100 stacji na odcinku do 1 km.
Nazwa Ethernet pochodzi od koncepcji eteru świetlnego (luminiferous ether) jako uniwersalnego nośnika fal elektromagnetycznych.
Xerox Palo Alto Research Center stanowił wyjątkowe środowisko badawcze, w którym interdyscyplinarny zespół naukowców miał swobodę realizacji przełomowych projektów.
Ethernet powstał w kontekście prac nad komputerem osobistym Xerox Alto, który jako pierwszy na świecie wykorzystywał graficzny interfejs użytkownika i wymagał szybkiej sieci do komunikacji z drukarką laserową oraz serwerami plików.
Robert Metcalfe, po zapoznaniu się z protokołem ALOHA podczas wizyty na Uniwersytecie Hawajskim, zaproponował dodanie mechanizmu nasłuchu nośnej przed rozpoczęciem transmisji.
Ta pozornie drobna modyfikacja redukowała liczbę kolizji o kilka rzędów wielkości, ponieważ stacje nie rozpoczynały nadawania, gdy medium było już zajęte.
Nazwa Ethernet pochodzi od terminu luminiferous ether, czyli eteru świetlnego, który w fizyce klasycznej miał być ośrodkiem rozchodzenia się fal elektromagnetycznych.
Metcalfe uznał, że kabel koncentryczny pełni analogiczną rolę w sieci komputerowej.
Pierwsza implementacja Ethernetu pracowała z szybkością 2,94 Mbps, co wynikało z częstotliwości zegara użytego w układzie interfejsu sieciowego komputera Alto.
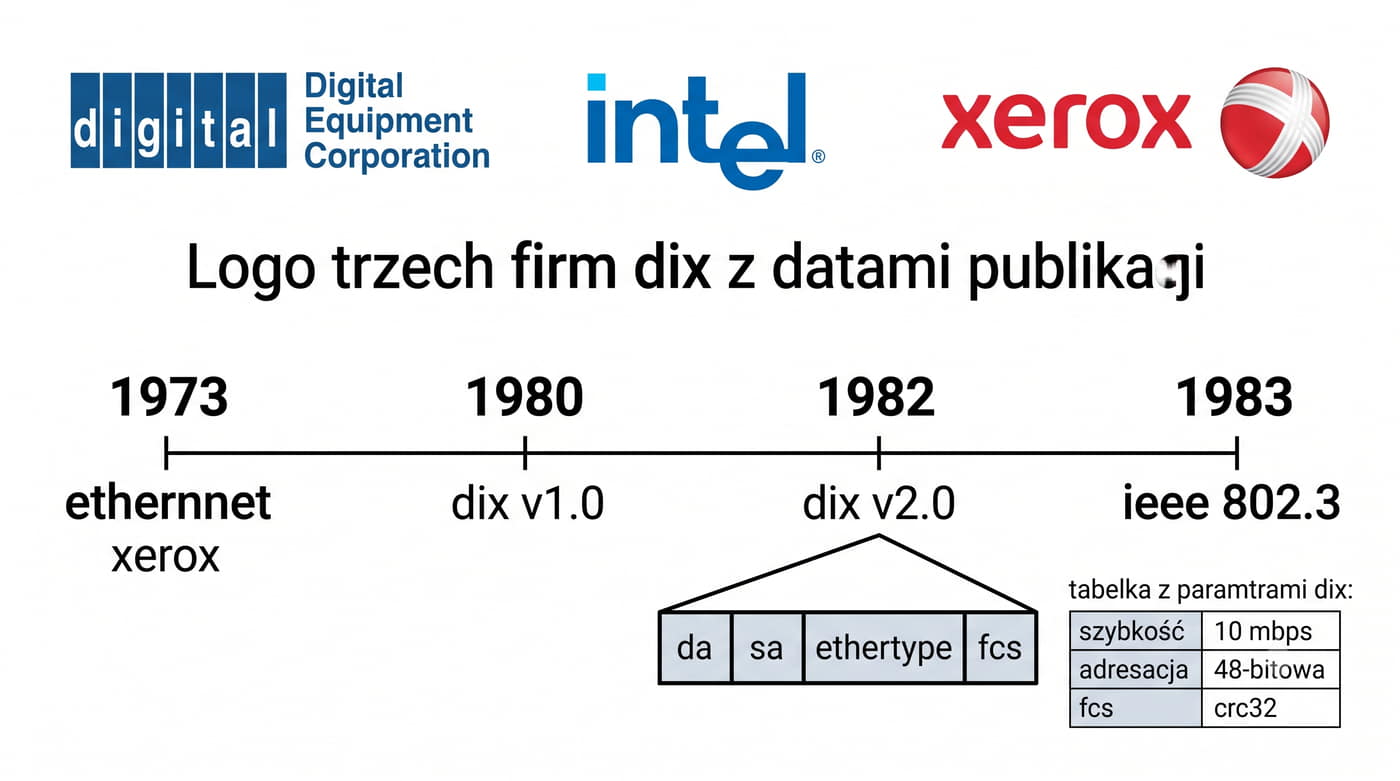
W 1980 roku trzy firmy – Digital Equipment Corporation (DEC), Intel i Xerox – połączyły siły, aby stworzyć pierwszy przemysłowy standard Ethernetu.
Powstały standard DIX v1.0, a dwa lata później DIX v2.0 (1982).
DIX Ethernet wprowadził szybkość 10 Mbps, 48-bitową adresację MAC oraz pole FCS (Frame Check Sequence) w ramce do weryfikacji integralności danych.
Był to moment, w którym Ethernet przestał być eksperymentem laboratoryjnym, a stał się realną technologią sieciową.
Standard DIX Ethernet z 1980 roku był wynikiem strategicznego sojuszu trzech firm: Digital Equipment Corporation wnosiła doświadczenie w sieciach DECnet, Intel był liderem w produkcji układów scalonych i kontrolerów sieciowych, a Xerox był właścicielem oryginalnych patentów na Ethernet z PARC.
Specyfikacja DIX v2.0 z 1982 roku zdefiniowała szybkość transmisji 10 Mbps oraz 48-bitowe adresy MAC, które pozostają w użyciu do dziś.
Kluczowym elementem było również wprowadzenie pola Frame Check Sequence z algorytmem CRC32, które zapewniało skuteczną detekcję błędów transmisji.
DIX Ethernet stał się de facto standardem przemysłowym jeszcze przed formalną standaryzacją IEEE, co było możliwe dzięki szerokiej akceptacji rynkowej i wsparciu trzech potentatów branży komputerowej.
Sukces DIX otworzył drogę do masowej komercjalizacji Ethernetu, który w ciągu kilku lat zaczął wypierać konkurencyjne technologie sieci lokalnych, takie jak Token Ring IBM czy ARCNET firmy Datapoint.
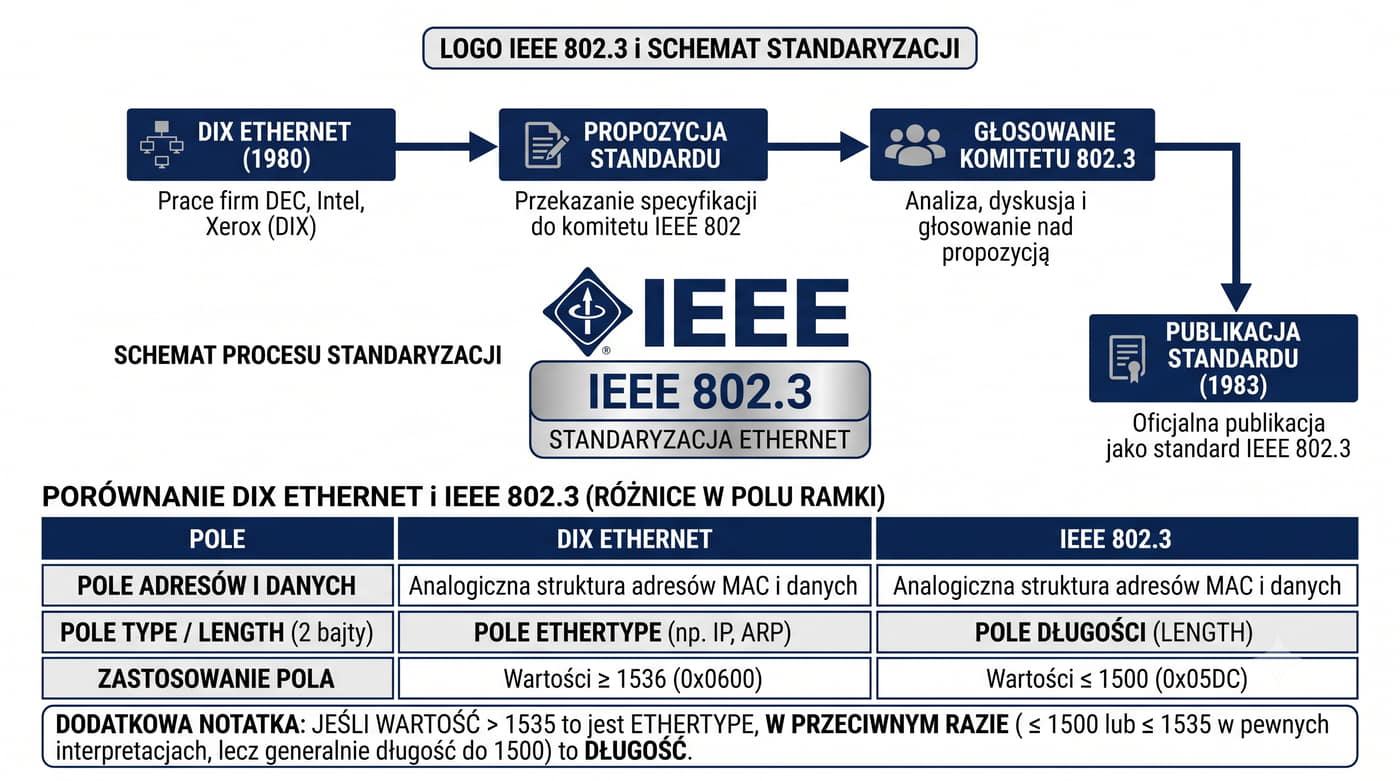
Komitet IEEE 802 został powołany w 1980 roku do standaryzacji sieci lokalnych (LAN).
W 1983 roku opublikowano standard IEEE 802.3, który był bardzo zbliżony do DIX v2.0.
Główna różnica dotyczyła interpretacji pola EtherType/Length.
Od 1983 roku nazwa Ethernet stała się synonimem rodziny standardów IEEE 802.3.
Standard ten był wielokrotnie nowelizowany – dodawano kolejne szybkości, media transmisyjne i funkcje.
Dziś IEEE 802.3 obejmuje kilkadziesiąt podstandardów, od 10 Mbps do 400 Gbps.
Komitet IEEE 802 został powołany w lutym 1980 roku przez Institute of Electrical and Electronics Engineers w celu opracowania standardów dla sieci lokalnych i miejskich.
Projekt 802.3, którym kierował Robert Metcalfe, miał za zadanie przekształcić specyfikację DIX w oficjalny standard międzynarodowy.
Główna różnica między DIX a IEEE 802.3 dotyczyła interpretacji dwubajtowego pola po adresie źródłowym.
W DIX pole to służyło jako EtherType do identyfikacji protokołu warstwy sieciowej, natomiast IEEE pierwotnie zdefiniował je jako pole długości danych.
Problem kompatybilności rozwiązano przez wprowadzenie progu 1536: jeśli wartość pola przekracza 1535, jest interpretowana jako EtherType, w przeciwnym razie jako długość ramki.
Publikacja standardu IEEE 802.3 w 1983 roku była momentem przełomowym, ponieważ Ethernet stał się otwartym standardem dostępnym dla wszystkich producentów na niedyskryminacyjnych warunkach licencyjnych.
Doprowadziło to do gwałtownego wzrostu konkurencji na rynku kart sieciowych i koncentratorów, co spowodowało spadek cen i masową adopcję technologii.
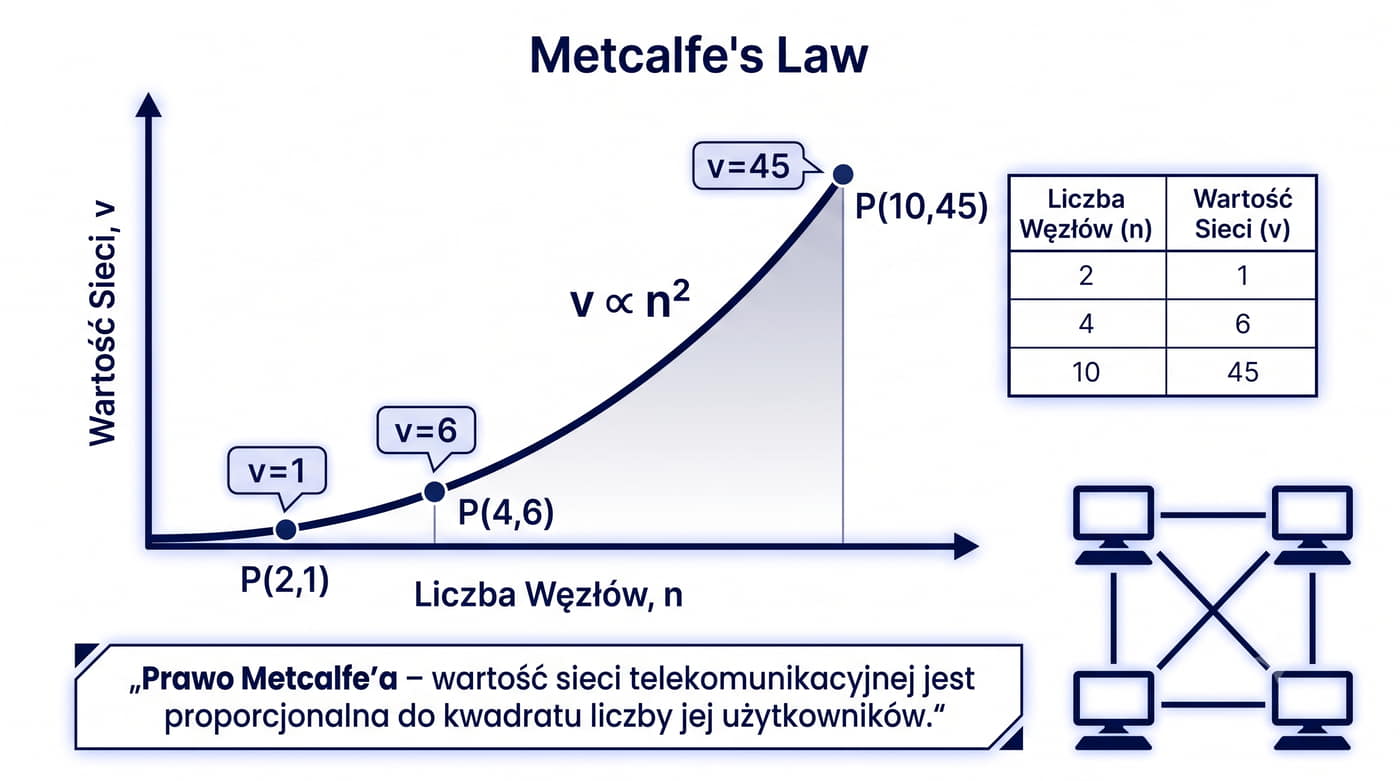
Dla 4 węzłów jest ich już 6.
Dla 10 węzłów mamy 45 połączeń.
Robert Metcalfe sformułował prawo, zgodnie z którym wartość sieci telekomunikacyjnej rośnie proporcjonalnie do kwadratu liczby jej węzłów.
Matematycznie: V proporcjonalne do n^2, gdzie n to liczba użytkowników.
Dla sieci z 2 węzłami istnieje 1 potencjalne połączenie.
Prawo Metcalfe'a doskonale wyjaśnia gwałtowny rozwój Internetu – im więcej użytkowników dołącza, tym większą wartość ma sieć dla każdego z nich.
Prawo Metcalfe'a, sformułowane przez twórcę Ethernetu w 1980 roku, głosi, że wartość sieci telekomunikacyjnej jest proporcjonalna do kwadratu liczby jej użytkowników.
Formalnie V = k * n^2, gdzie V to wartość sieci, n liczba węzłów, a k stała proporcjonalności.
U podstaw prawa leży prosty fakt kombinatoryczny: liczba możliwych połączeń między n węzłami wynosi n(n-1)/2, czyli dla dużych n rośnie proporcjonalnie do n^2.
Metcalfe wykorzystywał tę zależność do przekonania producentów i klientów, że inwestycja w Ethernet przyniesie rosnące korzyści wraz z jego upowszechnieniem.
Prawo doskonale wyjaśnia zjawisko efektów sieciowych obserwowane w przypadku platform społecznościowych, komunikatorów internetowych i giełd elektronicznych.
Współczesna krytyka prawa Metcalfe'a wskazuje, że nie wszystkie połączenia w sieci mają jednakową wartość, a rzeczywisty wzrost użyteczności może być wolniejszy niż kwadratowy.
Mimo tych zastrzeżeń prawo pozostaje użytecznym narzędziem heurystycznym do analizy rynków sieciowych.
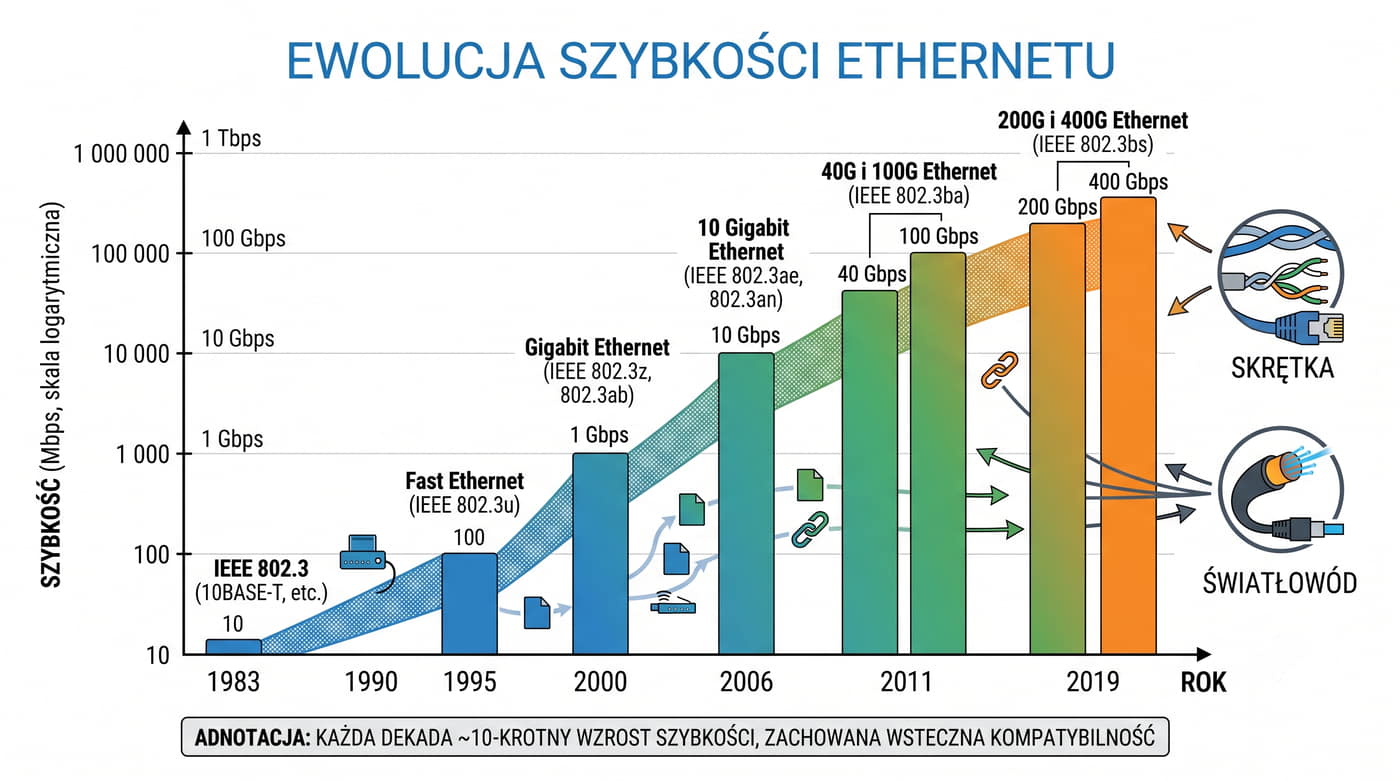
Ethernet przeszedł imponującą ewolucję szybkości w ciągu czterech dekad.
Startując od 10 Mbps w 1983 roku, kolejne przełomy to: 100 Mbps (Fast Ethernet, 1995), 1 Gbps (Gigabit Ethernet, 1999), 10 Gbps (2006), 40 i 100 Gbps (2011) oraz 200 i 400 Gbps (2019).
Każda dekada przynosiła około dziesięciokrotny wzrost szybkości transmisji.
Co istotne, zachowano wsteczną kompatybilność – nowe standardy potrafią negocjować szybkość z urządzeniami starszej generacji.
Ewolucja szybkości Ethernetu od 10 Mbps do 400 Gbps w ciągu czterech dekad stanowi imponujące osiągnięcie inżynierii telekomunikacyjnej.
Każda kolejna generacja wymagała przezwyciężenia fundamentalnych ograniczeń fizycznych związanych z tłumieniem sygnału, przesłuchami między parami oraz integralnością sygnału przy rosnących częstotliwościach taktowania.
Przejście z 10BASE-T do 100BASE-TX wymagało zastosowania skrętek kategorii 5 i kodowania 4B5B z mechanizmem MLT-3.
Gigabit Ethernet na skrętce miedzianej (1000BASE-T) stanowił jeszcze większe wyzwanie techniczne, wykorzystując kodowanie PAM-5 na wszystkich czterech parach jednocześnie, z zaawansowanymi technikami eliminacji ech i przesłuchów realizowanymi w cyfrowym procesorze sygnałowym.
Standardy 10 Gbps i wyższe wymagają już światłowodów jednomodowych lub wysokiej jakości skrętek kategorii 6A i 7.
W centrach danych coraz powszechniejsze stają się standardy 200 Gbps i 400 Gbps oparte na technologii równoległych transmisji światłowodowych z wieloma kanałami.
Niezależnie od szybkości, każda nowa generacja Ethernetu zachowuje wsteczną kompatybilność poprzez mechanizm autonegocjacji.
Historyczny rozwój Ethernetu ilustruje fundamentalną prawidłowość w ewolucji technologii sieciowych: każda kolejna generacja powstawała w odpowiedzi na ograniczenia poprzedniej.
ARPANET udowodnił praktyczność przełączania pakietów, ALOHAnet zademonstrował możliwość współdzielenia medium przez wiele stacji, a Ethernet dodał kluczowy mechanizm nasłuchu nośnej zwiększający efektywność.
Standaryzacja DIX, a następnie IEEE 802.3, była momentem zwrotnym, który przekształcił Ethernet z laboratoryjnego prototypu w technologię komercyjną.
Otwarty charakter standardu, w połączeniu z agresywną polityką licencyjną Metcalfe'a, doprowadził do szybkiej dominacji Ethernetu nad konkurencyjnymi rozwiązaniami, takimi jak Token Ring, FDDI czy ARCNET.
Najważniejszym wnioskiem dla studentów jest zrozumienie, że współczesne sieci przełączane są wynikiem stopniowego odchodzenia od modelu współdzielonego medium na rzecz dedykowanych połączeń punkt-punkt, co całkowicie wyeliminowało problem kolizji i zrewolucjonizowało wydajność sieci Ethernet.
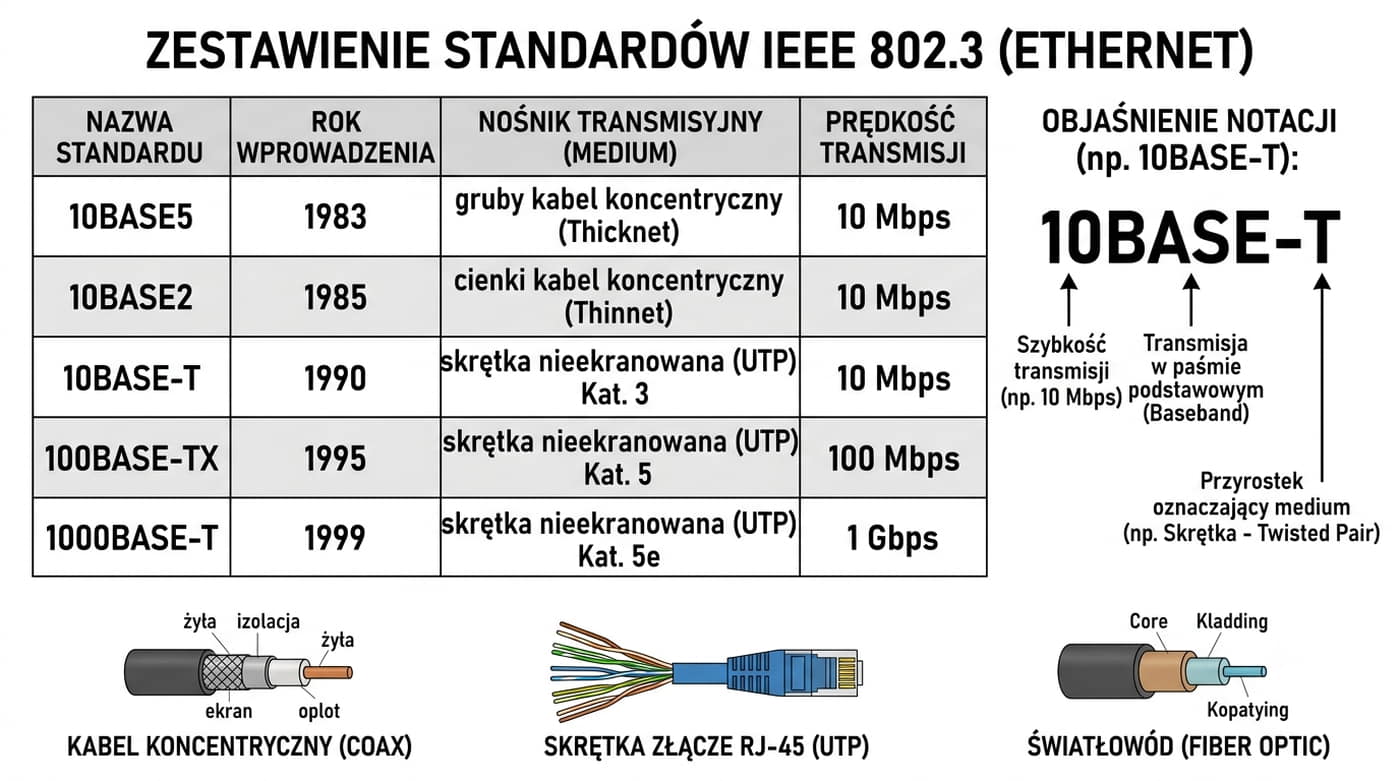
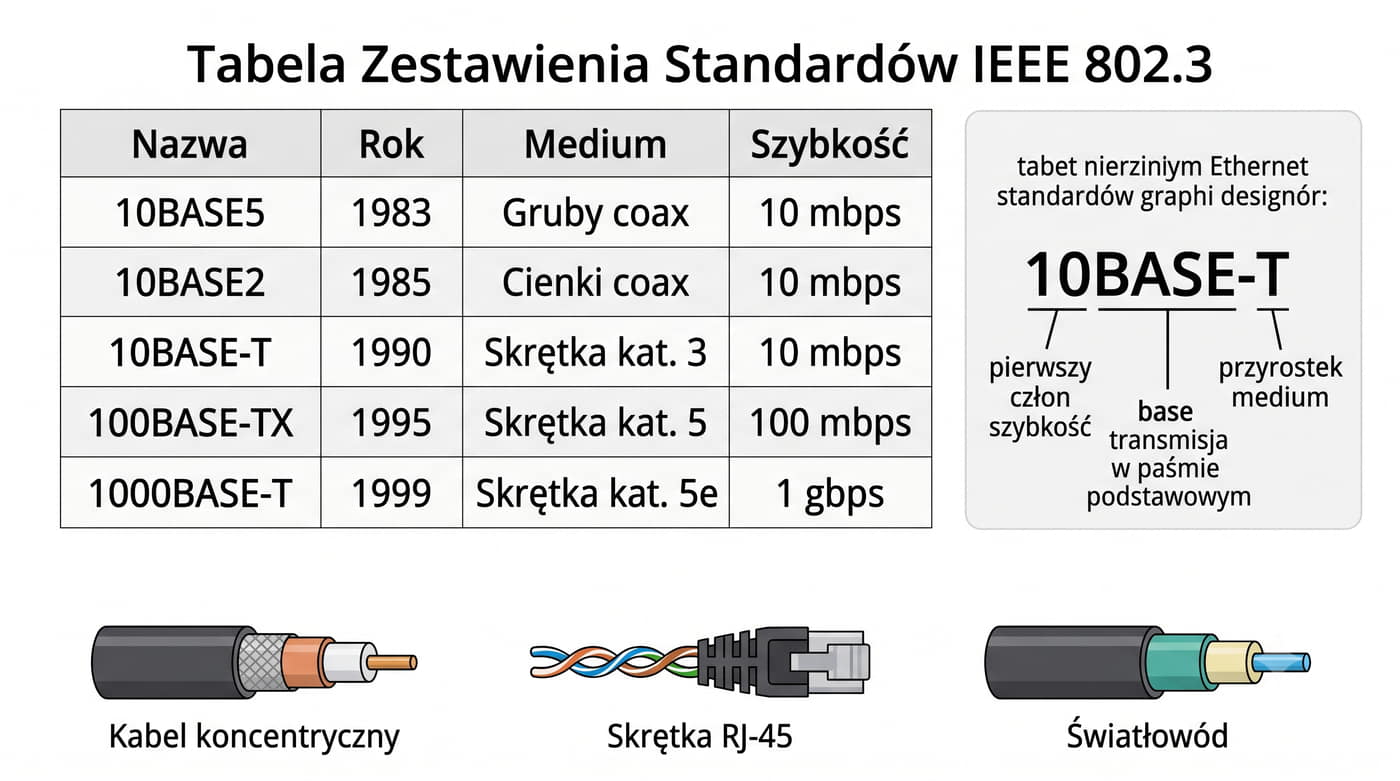
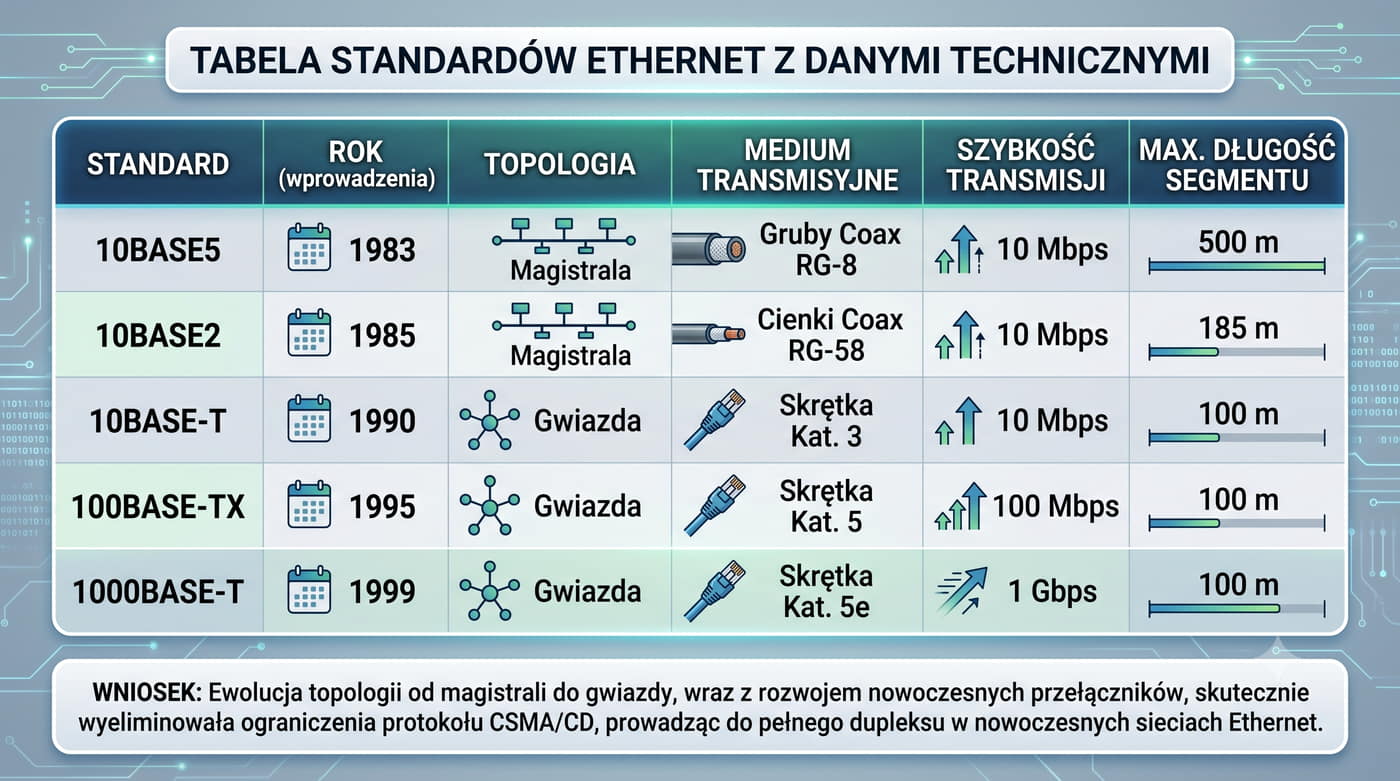
| Nazwa | Rok | Medium | Szybkość |
|---|---|---|---|
| 10BASE5 | 1983 | gruby coax | 10 Mbps |
| 10BASE2 | 1985 | cienki coax | 10 Mbps |
| 10BASE-T | 1990 | skrętka kat. 3 | 10 Mbps |
| 100BASE-TX | 1995 | skrętka kat. 5 | 100 Mbps |
| 1000BASE-T | 1999 | skrętka kat. 5e | 1 Gbps |
Standardy IEEE 802.3 różnią się szybkością, typem medium i topologią.
Notacja standardu oznacza: szybkość transmisji (w Mbps lub Gbps) + BASE (transmisja w paśmie podstawowym) + przyrostek medium (T – skrętka, F – światłowód, S – krótki zasięg, L – długi zasięg).
Pierwszy człon oznacza szybkość transmisji, słowo BASE wskazuje na transmisję w paśmie podstawowym, a przyrostek identyfikuje rodzaj medium transmisyjnego oraz zasięg.
Standard 10BASE5, pierwszy oficjalnie zatwierdzony przez IEEE w 1983 roku, wykorzystywał gruby kabel koncentryczny o impedancji 50 omów i średnicy około 10 milimetrów.
Przyłączenie stacji wymagało specjalnych łączników przebijających izolację kabla (vampire taps), wbijanych w kabel.
Maksymalna długość pojedynczego segmentu wynosiła 500 metrów, a maksymalna liczba stacji na segmencie to 100.
Prawdziwą rewolucją okazał się 10BASE-T z 1990 roku, który zastąpił kabel koncentryczny tańszą i bardziej elastyczną skrętką miedzianą z ośmiopinowymi złączami RJ-45.
Standardy światłowodowe, takie jak 10GBASE-SR dla krótkich zasięgów do 300 metrów i 10GBASE-LR dla długich zasięgów do 10 kilometrów, umożliwiły budowę szybkich łącz między budynkami i w szkieletach sieci operatorskich.
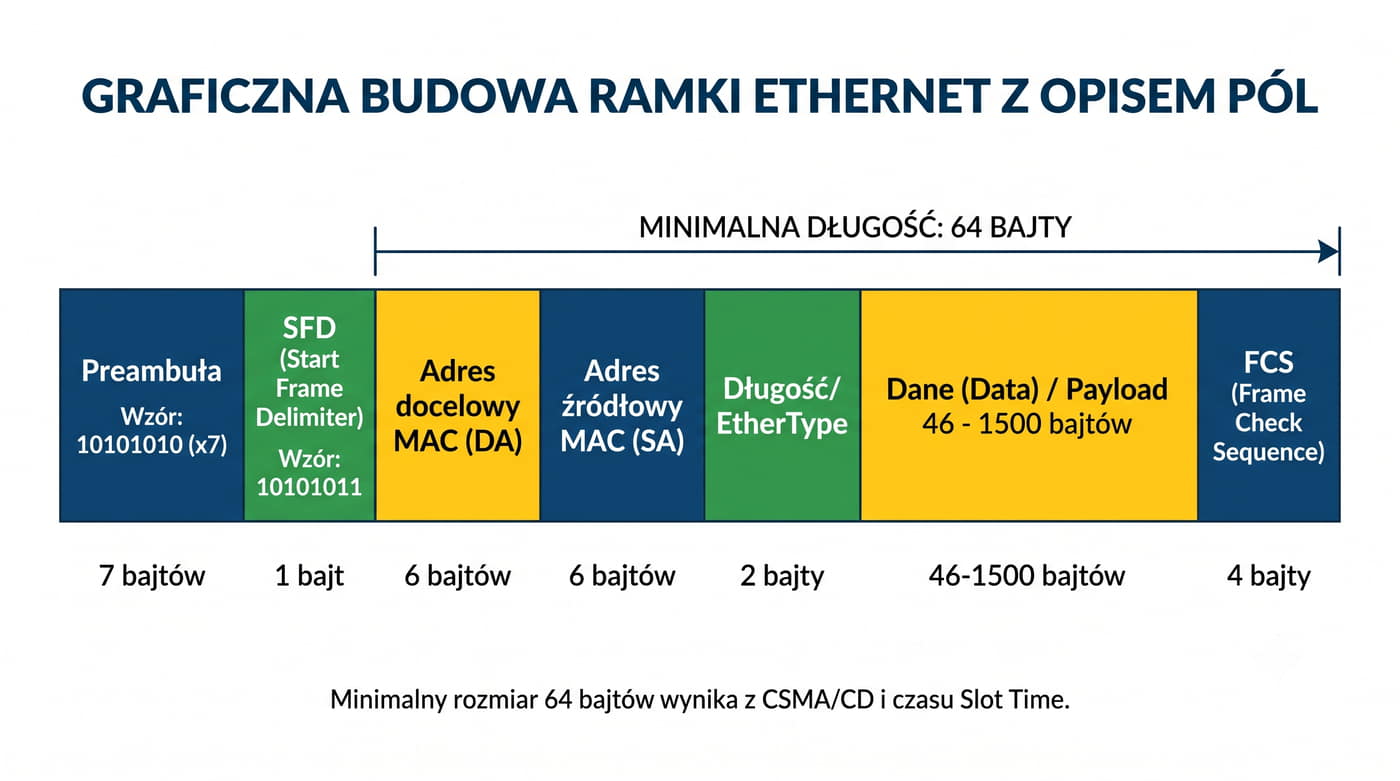
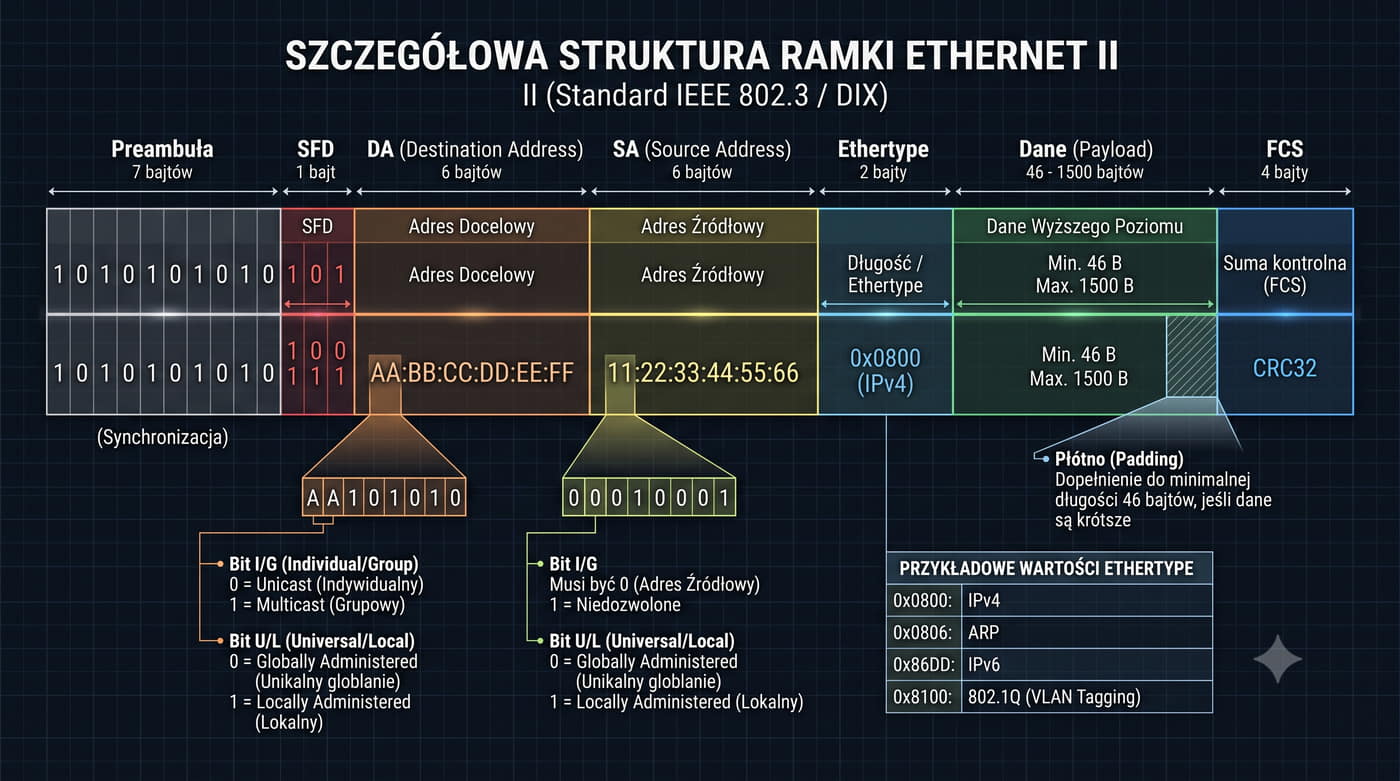
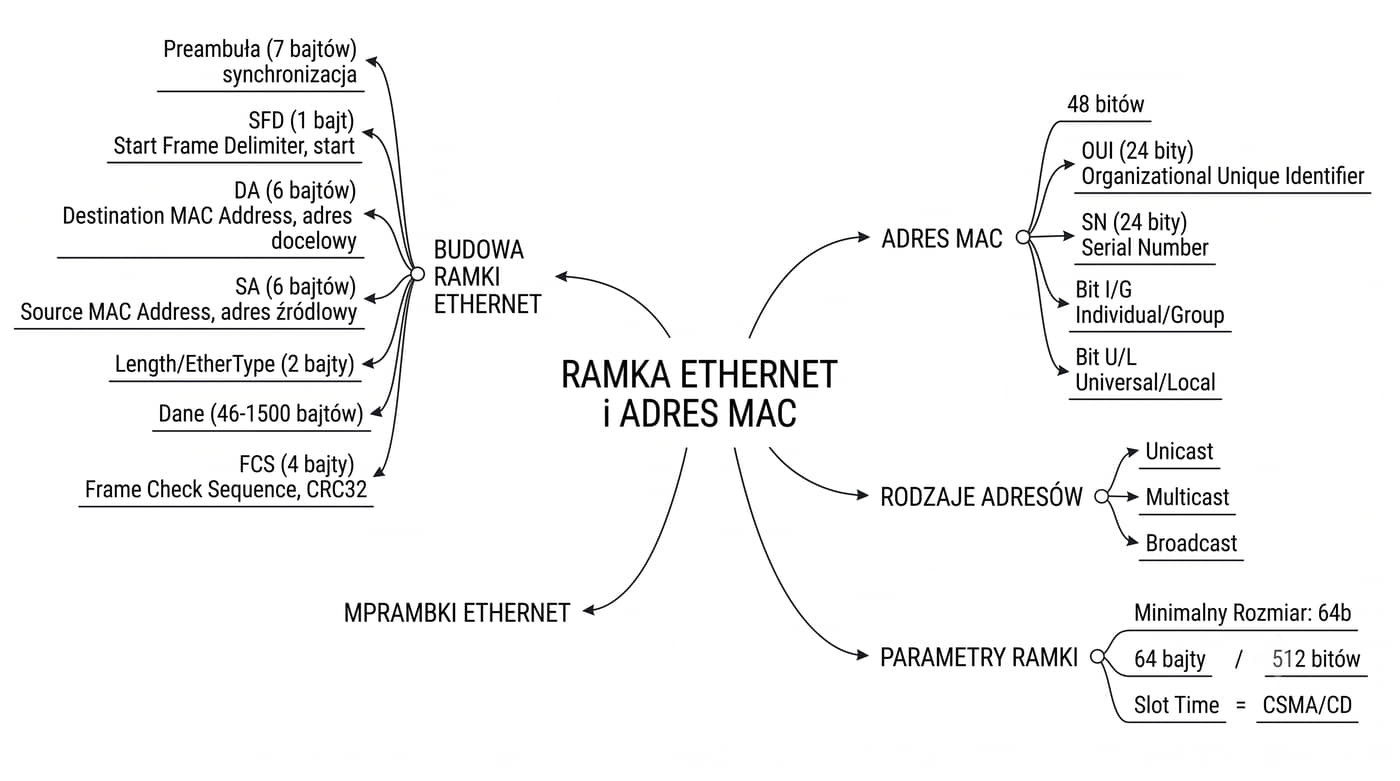
Ramka Ethernet w standardzie IEEE 802.3 składa się z następujących pól: preambuła (7 bajtów synchronizacji), SFD (1 bajt – Start Frame Delimiter), adres docelowy DA (6 bajtów), adres źródłowy SA (6 bajtów), pole Length/EtherType (2 bajty), dane (46–1500 bajtów) oraz FCS (4 bajty – suma kontrolna).
Minimalny rozmiar ramki wynosi 64 bajty (licząc od adresu docelowego do FCS).
Maksymalny standardowy rozmiar to 1518 bajtów, a z tagiem 802.1Q – 1522 bajty.
Format ramki Ethernet został zaprojektowany tak, aby zapewnić niezawodną transmisję danych w warstwie łącza przy jednoczesnym zachowaniu prostoty implementacji sprzętowej.
Preambuła składająca się z 7 bajtów naprzemiennego wzorca 10101010 służy do synchronizacji generatora zegarowego odbiorcy z nadawcą, ponieważ nawet niewielkie różnice częstotliwości mogłyby prowadzić do błędnego odczytu bitów.
Pole Length lub EtherType, w zależności od interpretacji, określa odpowiednio długość danych lub typ protokołu wyższej warstwy.
Pole danych o zmiennej długości od 46 do 1500 bajtów zawiera właściwy pakiet wyższej warstwy, a w przypadku krótszych danych stosowane jest wypełnienie zerami do minimalnej długości 46 bajtów.
Suma kontrolna FCS obliczana algorytmem CRC32 z wielomianem generującym 0x04C11DB7 obejmuje swym zasięgiem pola od adresu docelowego do danych włącznie i pozwala na wykrycie wszystkich błędów seryjnych (burst) o długości do 32 bitów oraz wszystkich błędów o nieparzystej liczbie uszkodzonych bitów.
Preambuła i SFD, choć często traktowane pobieżnie, pełnią krytyczną funkcję w procesie synchronizacji warstwy fizycznej.
Preambuła dostarcza odbiornikowi wzorca bitowego umożliwiającego dostrojenie pętli synchronizacji zegara, podczas gdy SFD oznacza koniec sekwencji synchronizacyjnej i początek właściwych danych ramki.
Adresy MAC o długości 48 bitów tworzą przestrzeń adresową liczącą ponad 281 bilionów możliwych wartości.
Pierwszy bit najstarszego oktetu, zwany bitem I/G, określa, czy adres jest indywidualny (unicast) czy grupowy (multicast).
Drugi bit, oznaczany jako U/L, informuje o globalnym lub lokalnym charakterze adresu.
Wartość EtherType 0x0800 oznacza IPv4, 0x0806 ARP, 0x86DD IPv6, a 0x8100 ramkę z tagiem VLAN 802.1Q.
Dolną granicę rozmiaru danych 46 bajtów wyznacza konieczność zachowania minimalnej długości ramki 64 bajtów narzuconej przez protokół CSMA/CD.
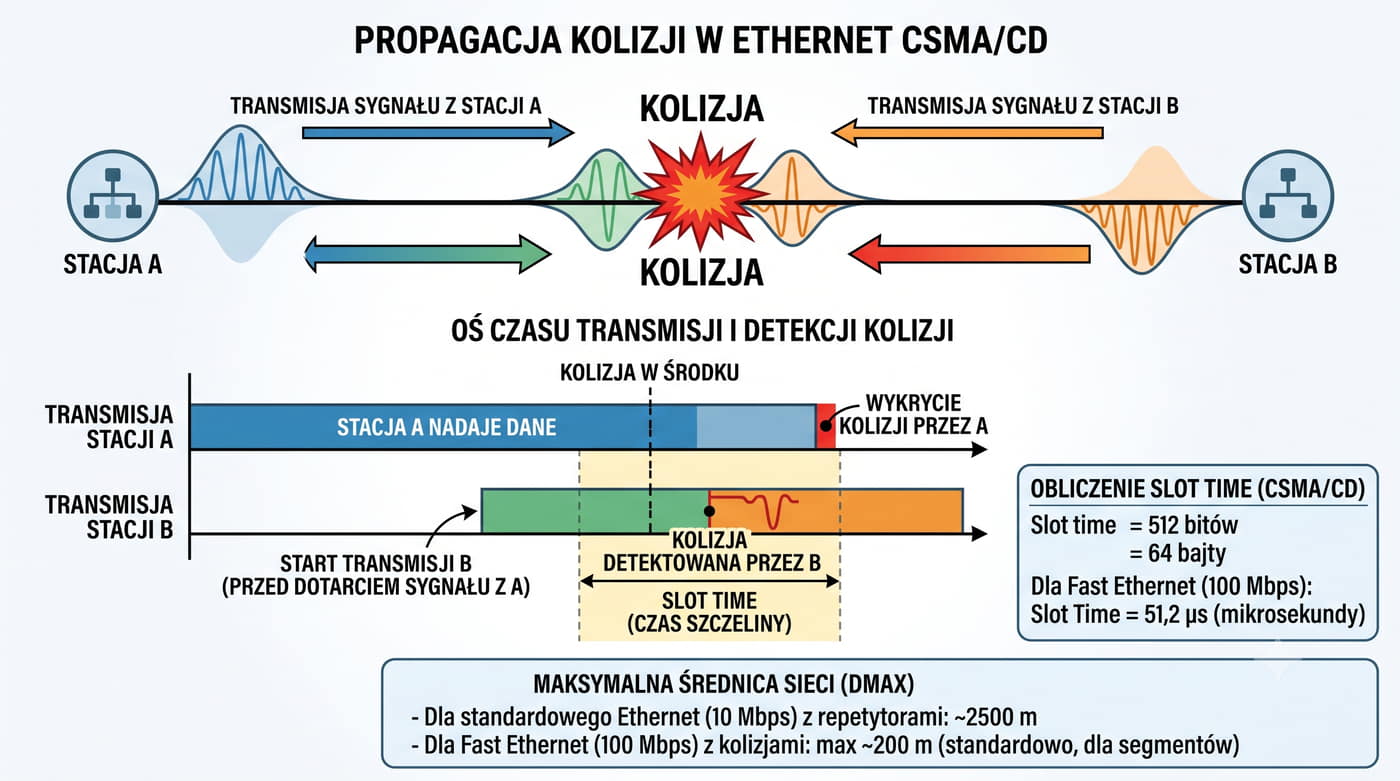
Protokół CSMA/CD wymaga, aby nadawca wykrył kolizję zanim zakończy nadawanie ramki.
Gdyby ramka była zbyt krótka, nadawca mógłby zakończyć transmisję przed dotarciem sygnału kolizji z drugiego końca segmentu.
Slot time to czas potrzebny na wykrycie kolizji na najdalszym końcu segmentu.
Dla Ethernetu 10 Mbps slot time wynosi 512 bitów = 64 bajty = 51,2 mikrosekundy.
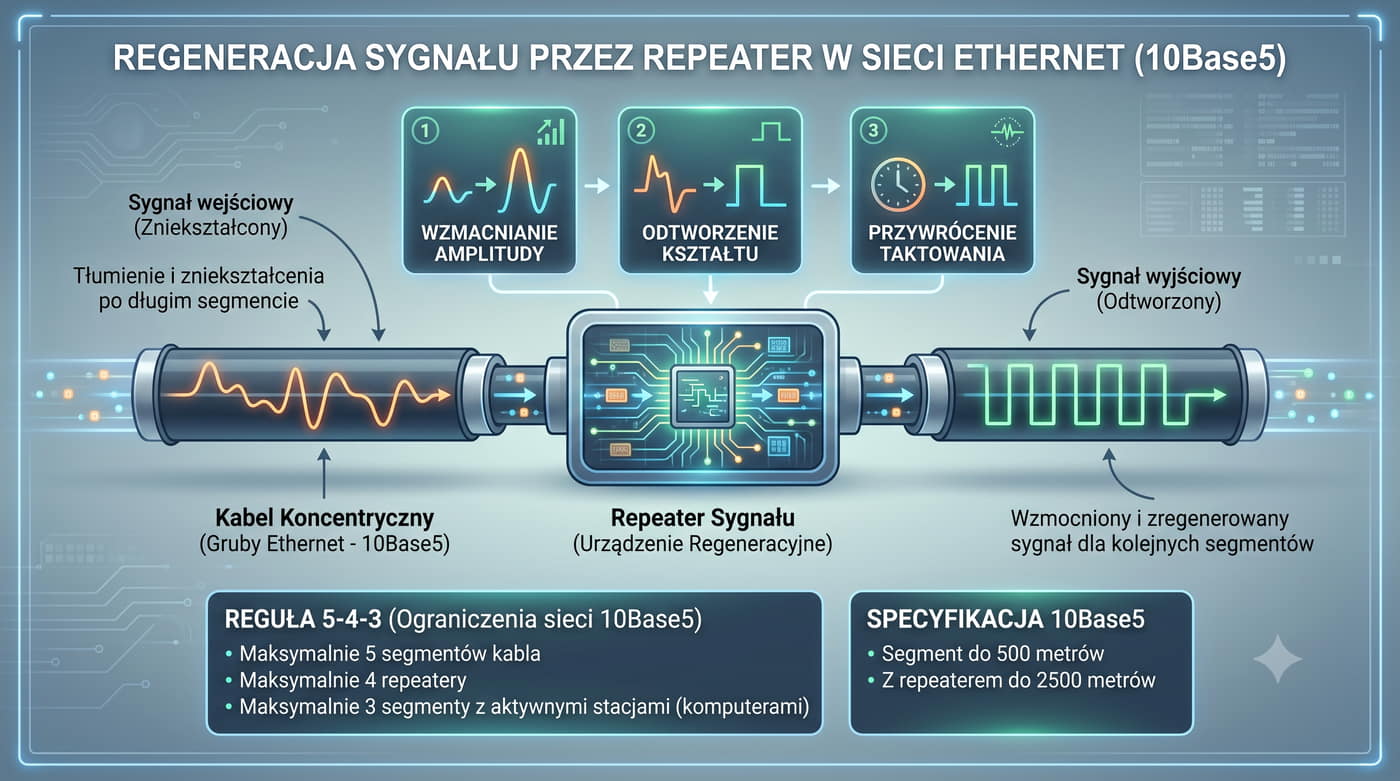
Wynika stąd maksymalna średnica sieci około 2500 metrów (z repeaterami).
Koncepcja slot time, definiowanego jako maksymalny czas wykrycia kolizji w segmencie, obejmuje dwukrotność czasu propagacji między najdalszymi stacjami plus czas wykrycia kolizji przez sprzęt sieciowy.
Dla slot time 512 bitów przy szybkości 10 Mbps, czyli 51,2 mikrosekundy, oraz prędkości propagacji 231 metrów na mikrosekundę, maksymalna odległość między stacjami wynosi około 2500 metrów po uwzględnieniu czterech repeaterów.
Wraz ze wzrostem szybkości transmisji slot time w bitach pozostawał niezmieniony, ale jego wartość w sekundach malała proporcjonalnie.
Dla Fast Ethernet przy 100 Mbps slot time wynosił już tylko 5,12 mikrosekundy, co wymusiło redukcję maksymalnej średnicy segmentu do około 200 metrów.
Przy Gigabit Ethernet konieczne było wprowadzenie modyfikacji w protokole CSMA/CD w postaci rozszerzenia nośnej (carrier extension), które sztucznie wydłużało krótkie ramki do 512 bajtów.
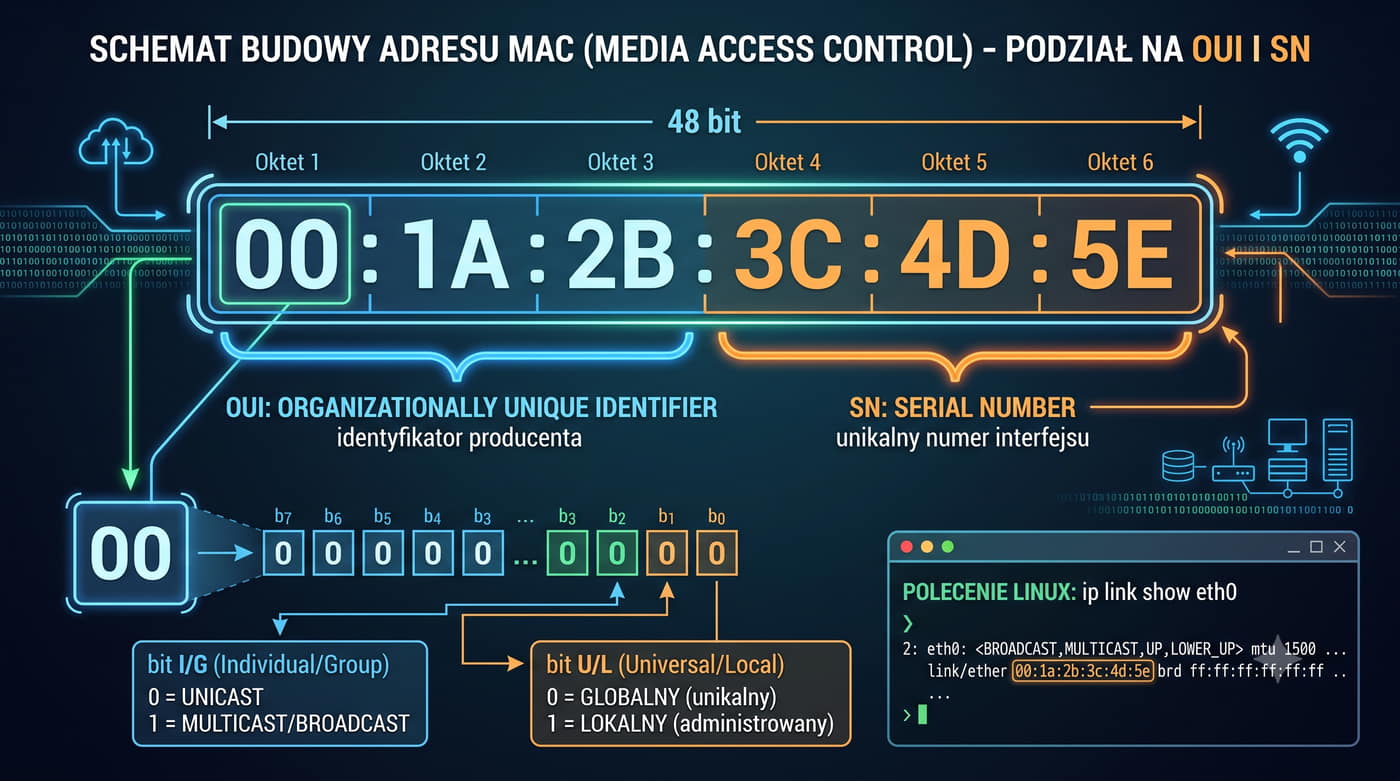
Adres MAC (Media Access Control) ma 48 bitów, co odpowiada 6 oktetom.
Zapisuje się go heksadecymalnie, zwykle w formacie xx:xx:xx:xx:xx:xx.
Pierwsze 3 oktety (24 bity) to OUI – Organizationally Unique Identifier, czyli identyfikator producenta.
Ostatnie 3 oktety to unikalny numer nadany przez producenta dla danego interfejsu.
Adres MAC o długości 48 bitów jest fundamentalnym identyfikatorem w warstwie łącza danych i podlega ścisłemu systemowi zarządzania nadzorowanemu przez IEEE Registration Authority.
Bit I/G (Individual/Group) o wadze 0x01 określa, czy adres jest unicastem, czy multicastem, natomiast bit U/L (Universal/Local) o wadze 0x02 informuje o globalnym lub lokalnie administrowanym charakterze adresu.
W praktyce administracyjnej adres MAC można podejrzeć i zmodyfikować na poziomie systemu operacyjnego.
W systemie Linux polecenie ip link show wyświetla aktualny adres MAC interfejsu, a polecenie ip link set dev eth0 address XX:XX:XX:XX:XX:XX umożliwia jego tymczasową zmianę.
Mechanizm zmiany adresu, zwany MAC spoofingiem, jest wykorzystywany zarówno w celach diagnostycznych, jak i w kontekście zachowania anonimowości w sieciach publicznych.
Adresy MAC dzielą się na trzy typy. Unicast (bit I/G = 0) identyfikuje pojedynczy interfejs sieciowy – ramka trafia tylko do jednego odbiorcy. Multicast (bit I/G = 1) oznacza adres grupowy – ramka jest odbierana przez stacje należące do danej grupy. Broadcast (FF:FF:FF:FF:FF:FF) to adres specjalny, w którym wszystkie bity są ustawione na 1 – ramka trafia do każdej karty sieciowej w segmencie.
Podział ten określa pierwszy bit najstarszego oktetu adresu (bit I/G).
Gdy bit I/G = 0, adres jest indywidualny (unicast).
Gdy I/G = 1, adres jest grupowy (multicast lub broadcast).
Karta sieciowa filtruje ramki na podstawie tych bitów, zanim przekaże je do systemu operacyjnego.
Adres unicast, identyfikowany przez bit I/G równy 0, jest przypisany do pojedynczego interfejsu sieciowego i stanowi podstawę komunikacji bezpośredniej między dwoma urządzeniami.
Adres multicast, z bitem I/G ustawionym na 1, pozwala na transmisję do wybranej grupy odbiorców, co jest szeroko wykorzystywane przez protokoły routingu, takie jak OSPF (224.0.0.5 i 224.0.0.6).
Szczególnym przypadkiem adresu multicast jest adres broadcast FF:FF:FF:FF:FF:FF, w którym wszystkie bity mają wartość 1.
Ramka broadcast jest odbierana przez wszystkie karty sieciowe w segmencie i przekazywana do systemów operacyjnych do dalszego przetwarzania.
Adres z bitem U/L równym 0 jest adresem globalnie unikalnym nadanym przez IEEE w ramach oficjalnego OUI.
Adres z bitem U/L równym 1 jest adresem lokalnie administrowanym, który może być dowolnie przypisany przez administratora sieci.
Adresy lokalne są szczególnie przydatne w środowiskach wirtualizacyjnych, gdzie wiele maszyn wirtualnych współdzieli jeden fizyczny interfejs sieciowy.
Przykładowe OUI znanych producentów:
| Producent | Przykładowe OUI |
|---|---|
| Cisco Systems | 00:00:0C, 00:01:42 |
| Intel Corporation | 00:07:E9, 00:AA:00 |
| MikroTik | 4C:5E:0C, 64:D1:54 |
| Realtek | 00:E0:4C, FC:93:4E |
| TP-Link | 50:C7:BF, B0:BE:76 |
ip link show wyświetla adres MAC interfejsu. Na stronie standards-oui.ieee.org można sprawdzić producenta dla dowolnego OUI.OUI (Organizationally Unique Identifier) to pierwsze 24 bity adresu, które jednoznacznie identyfikują producenta karty sieciowej.
Baza OUI jest prowadzona przez IEEE Registration Authority i zawiera dziesiątki tysięcy przypisanych prefiksów.
Znajomość OUI pozwala szybko zidentyfikować producenta nieznanego urządzenia w sieci.
Baza danych OUI (Organizationally Unique Identifier) prowadzona przez IEEE Registration Authority stanowi publicznie dostępne źródło wiedzy umożliwiające identyfikację producenta interfejsu sieciowego na podstawie pierwszych 24 bitów adresu MAC.
Jest to niezwykle przydatne narzędzie w codziennej pracy administratora sieci, pozwalające na szybką identyfikację nieznanych urządzeń pojawiających się w sieci.
Firma Cisco Systems posiada jeden z największych zestawów prefiksów OUI, między innymi 00:00:0C, 00:01:42 i wiele innych.
MikroTik ma przypisane prefiksy 4C:5E:0C i 64:D1:54.
Intel posiada OUI 00:AA:00 i 00:07:E9.
Należy jednak pamiętać o ograniczeniach identyfikacji na podstawie OUI.
Producenci chipsetów sieciowych, tacy jak Realtek czy Broadcom, sprzedają swoje układy scalone wielu producentom OEM, którzy mogą umieszczać je w swoich urządzeniach pod własną marką.
Ponadto niektóre karty sieciowe umożliwiają zmianę adresu MAC w oprogramowaniu, co całkowicie unieważnia identyfikację producenta na podstawie prefiksu OUI.
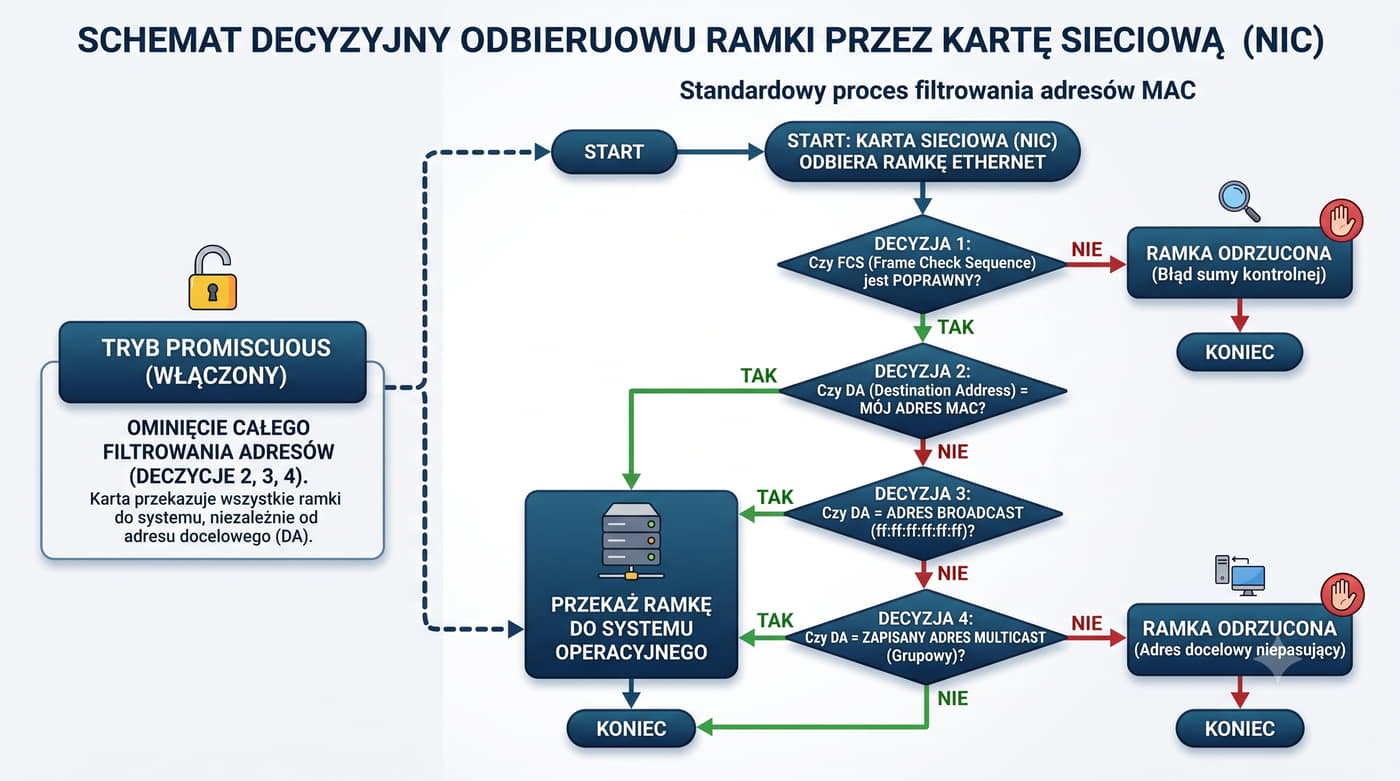
Karta sieciowa (NIC) w trybie normalnym odbiera wszystkie ramki krążące w segmencie sieci.
Dla każdej odebranej ramki sprawdza pole adresu docelowego DA.
Jeśli adres DA jest zgodny z jej adresem MAC lub jest adresem broadcast (FF:FF:FF:FF:FF:FF), karta przekazuje ramkę do systemu operacyjnego.
W przeciwnym razie ramka jest odrzucana milcząco.
Proces odbioru ramki przez kartę sieciową NIC rozpoczyna się od warstwy fizycznej, gdzie sygnał elektryczny lub optyczny jest przekształcany na postać cyfrową.
Karta sieciowa pracująca w trybie normalnym nasłuchuje medium transmisyjnego, a każda odebrana ramka przechodzi przez sekwencję testów weryfikacyjnych, zanim zostanie zaakceptowana lub odrzucona.
Pierwszym etapem jest kontrola integralności ramki za pomocą pola FCS, która pozwala wykryć uszkodzenia powstałe podczas transmisji.
Jeśli suma kontrolna nie zgadza się z obliczeniami karty odbiorczej, ramka jest natychmiast odrzucana.
Następnie karta porównuje docelowy adres MAC z własnym adresem, adresem broadcast FF:FF:FF:FF:FF:FF oraz zapisanymi adresami multicast.
W trybie promiscuous, który jest niezbędny do działania analizatorów protokołów takich jak Wireshark, filtrowanie adresowe jest całkowicie wyłączone na poziomie sprzętowym.
Oznacza to, że każda ramka krążąca w segmencie sieci jest przekazywana do stosu sieciowego systemu operacyjnego.
Blok drugi stanowi fundament wiedzy o sieciach Ethernet, obejmując standard IEEE 802.3, który definiuje nie tylko budowę ramki, ale także parametry fizyczne medium transmisyjnego, szybkości transmisji oraz mechanizmy dostępu do nośnika.
Standard ten ewoluował od wersji 10BASE5 przez 10BASE2, 10BASE-T aż do dzisiejszych standardów 100 i 400 Gbps (realizowanych przez światłowody i kable miedziane twinaxial, a na skrętce do 10GBASE-T i 40GBASE-T), zachowując przy tym kompatybilność wsteczną na poziomie ramki.
Każdy inżynier sieciowy musi biegle znać strukturę ramki Ethernet, ponieważ analiza nagłówków w programach takich jak tcpdump czy Wireshark wymaga rozumienia znaczenia poszczególnych pól.
Pole EtherType określa protokół wyższej warstwy i może przyjmować wartości takie jak 0x0800 (IPv4), 0x0806 (ARP) czy 0x86DD (IPv6), co determinuje sposób dalszej dekapsulacji.
Minimalny rozmiar ramki 64 bajtów nie jest przypadkowy i wynika z konieczności zapewnienia poprawnego działania mechanizmu CSMA/CD.
Jeśli ramka jest krótsza niż 64 bajty, nadajnik może zakończyć transmisję zanim sygnał kolizji zdąży dotrzeć z najdalszego końca sieci.
Dlatego stosuje się padding, który uzupełnia ramkę do wymaganego minimum.
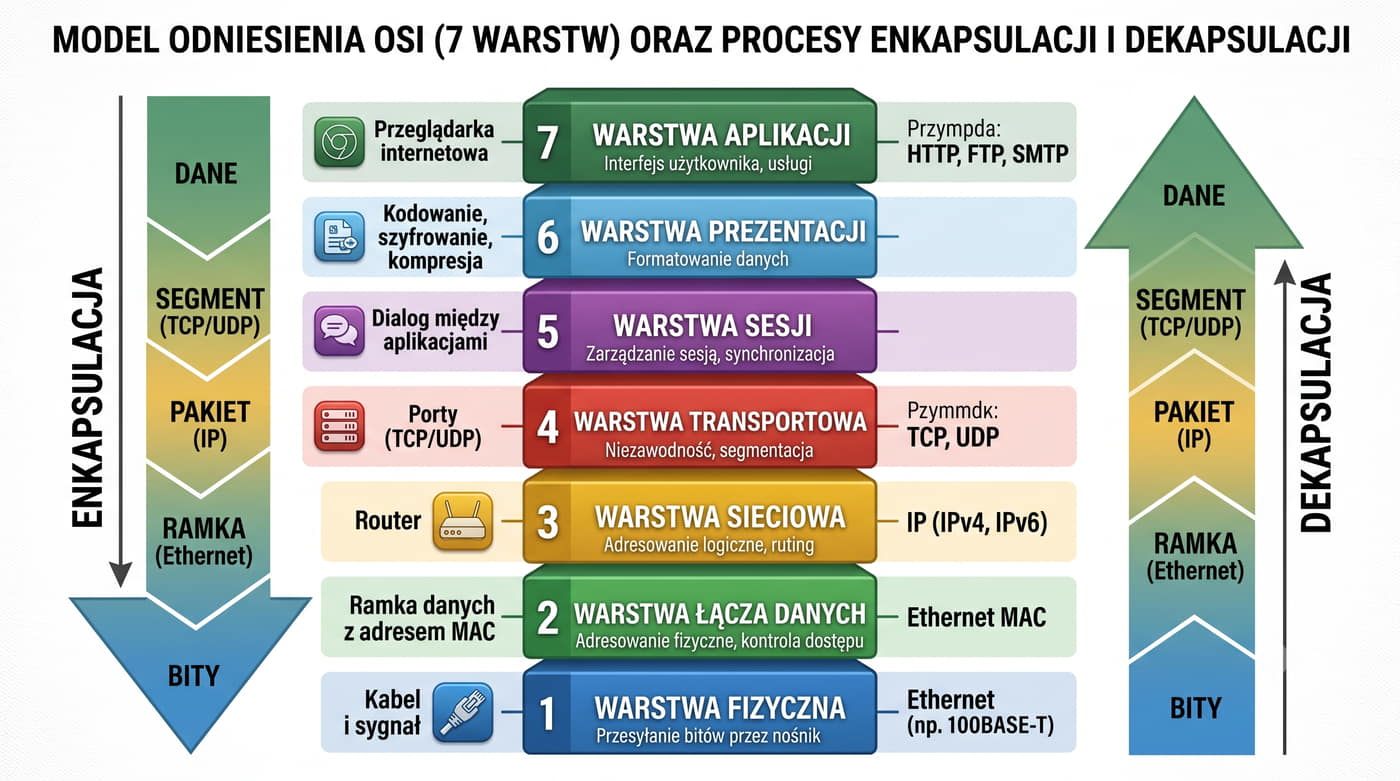
Model (Open Systems Interconnection) został opracowany przez ISO w 1984 roku jako teoretyczny wzorzec komunikacji sieciowej.
Dzieli proces komunikacji na siedem warstw: fizyczną (1), łącza danych (2), sieciową (3), transportową (4), sesji (5), prezentacji (6) i aplikacji (7).
Każda warstwa świadczy usługi warstwie wyższej i korzysta z usług warstwy niższej.
Enkapsulacja polega na dodawaniu nagłówka (i ewentualnie stopki) przez każdą warstwę.
Dzięki temu zmiany w jednej warstwie nie wpływają na pozostałe.
Każda z siedmiu warstw modelu OSI ma przypisaną określoną jednostkę danych (PDU): warstwa fizyczna operuje na bitach, warstwa łącza danych na ramkach (frames), warstwa sieciowa na pakietach, a warstwa transportowa na segmentach.
Warstwy sesji, prezentacji i aplikacji posługują się danymi (data) w formacie zrozumiałym dla aplikacji użytkownika.
To precyzyjne nazewnictwo ułatwia komunikację między inżynierami i diagnostykę problemów sieciowych.
Warstwa fizyczna definiuje parametry elektryczne, mechaniczne i proceduralne interfejsu sieciowego, w tym rodzaj złącza, napięcie sygnału oraz kodowanie linii.
Warstwa łącza danych odpowiada za adresację MAC, wykrywanie i korekcję błędów transmisji oraz kontrolę dostępu do medium.
Warstwa sieciowa realizuje routing, czyli wybór optymalnej ścieżki przez połączone sieci, oraz adresację logiczną.
Warstwa transportowa gwarantuje niezawodność dostarczenia danych poprzez mechanizmy potwierdzeń, retransmisji i kontroli przepływu.
Praktyczne znaczenie modelu OSI przejawia się w procesie dekapsulacji podczas analizy ruchu sieciowego w programach takich jak Wireshark.
Każdy nagłówek dodany przez kolejną warstwę jest widoczny jako osobna sekcja w przechwyconym pakiecie.
Zrozumienie tej struktury pozwala precyzyjnie określić, na której warstwie występuje problem sieciowy – czy jest to uszkodzenie fizyczne (warstwa 1), błąd adresacji MAC (warstwa 2), czy problem z routingiem (warstwa 3).
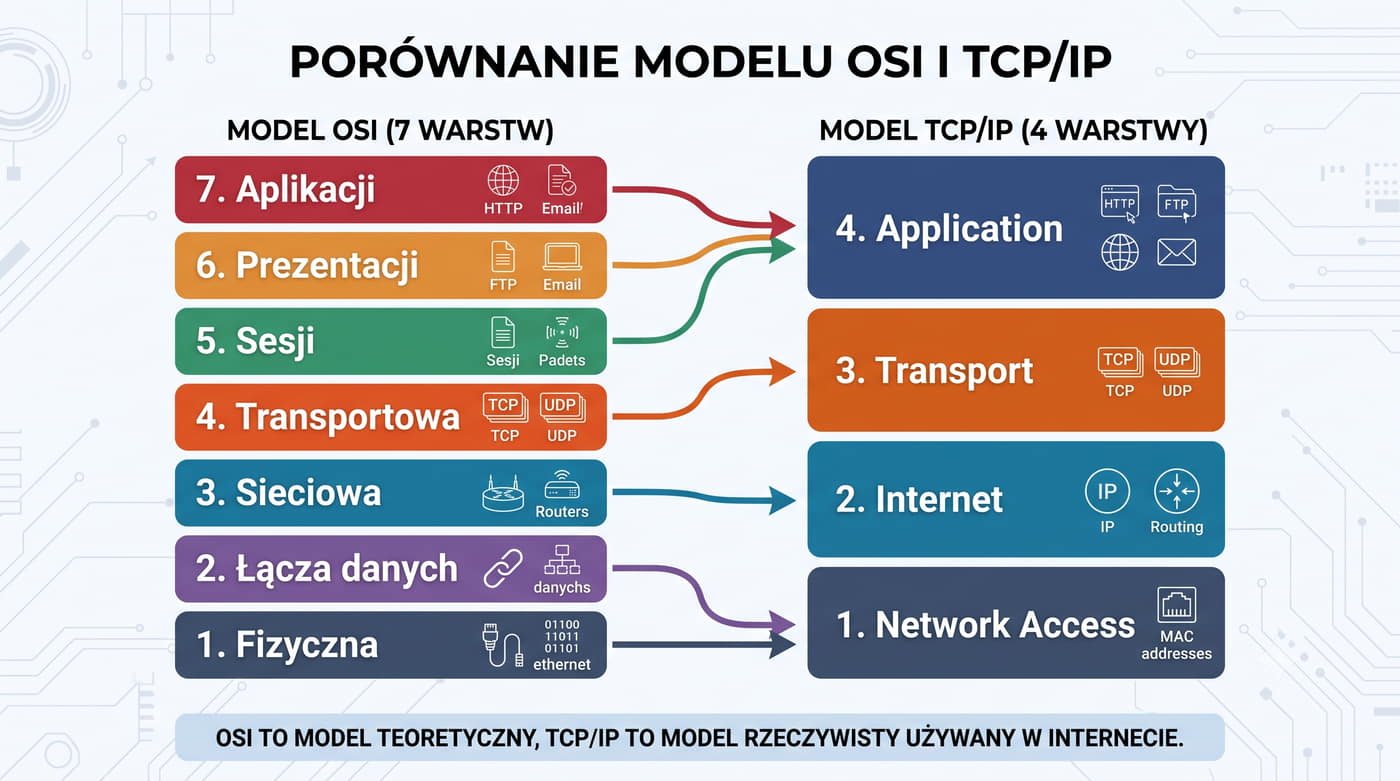
Składa się z czterech warstw.
Model TCP/IP jest modelem rzeczywistym, używanym w Internecie.
Warstwa dostępu do sieci (Network Access) odpowiada fizycznej i łącza danych z modelu OSI.
Warstwa Internetu (Internet) odpowiada warstwie sieciowej OSI i realizuje protokół IP.
Warstwa transportowa (Transport) zapewnia komunikację między procesami (TCP, UDP).
Warstwa aplikacji (Application) skupia protokoły używane przez aplikacje (HTTP, FTP, SMTP).
Model TCP/IP wyróżnia się pragmatycznym podejściem do projektowania protokołów.
Warstwa dostępu do sieci (Network Access) obejmuje zarówno warstwę fizyczną, jak i łącza danych z modelu OSI, ponieważ w praktyce te dwa poziomy są ze sobą ściśle powiązane i często implementowane w jednym urządzeniu lub sterowniku.
Protokół IP w warstwie Internetu jest bezpołączeniowy i zawodny z założenia – nie gwarantuje dostarczenia pakietu, zachowania kolejności ani eliminacji duplikatów, co czyni go prostym i wydajnym.
Niezawodność komunikacji jest realizowana w warstwie transportowej przez protokół TCP, który wprowadza numery sekwencyjne, potwierdzenia, okno przesuwne oraz mechanizm retransmisji po upływie czasu oczekiwania (RTO).
Alternatywnie protokół UDP rezygnuje z tych mechanizmów na rzecz minimalnego narzutu i małego opóźnienia, co jest korzystne dla transmisji strumieniowych i aplikacji czasu rzeczywistego.
Wybór między TCP a UDP należy do twórcy aplikacji i zależy od wymagań dotyczących niezawodności i opóźnień.
Warstwa aplikacji w modelu TCP/IP integruje funkcje trzech najwyższych warstw modelu OSI (sesji, prezentacji i aplikacji).
Protokoły takie jak HTTP, SMTP, FTP i DNS korzystają z warstwy transportowej poprzez mechanizm portów.
Każdej usłudze sieciowej przypisany jest standardowy numer portu – na przykład HTTP używa portu 80, a DNS portu 53 – co umożliwia jednoczesną obsługę wielu usług na jednym hoście bez wzajemnych zakłóceń.
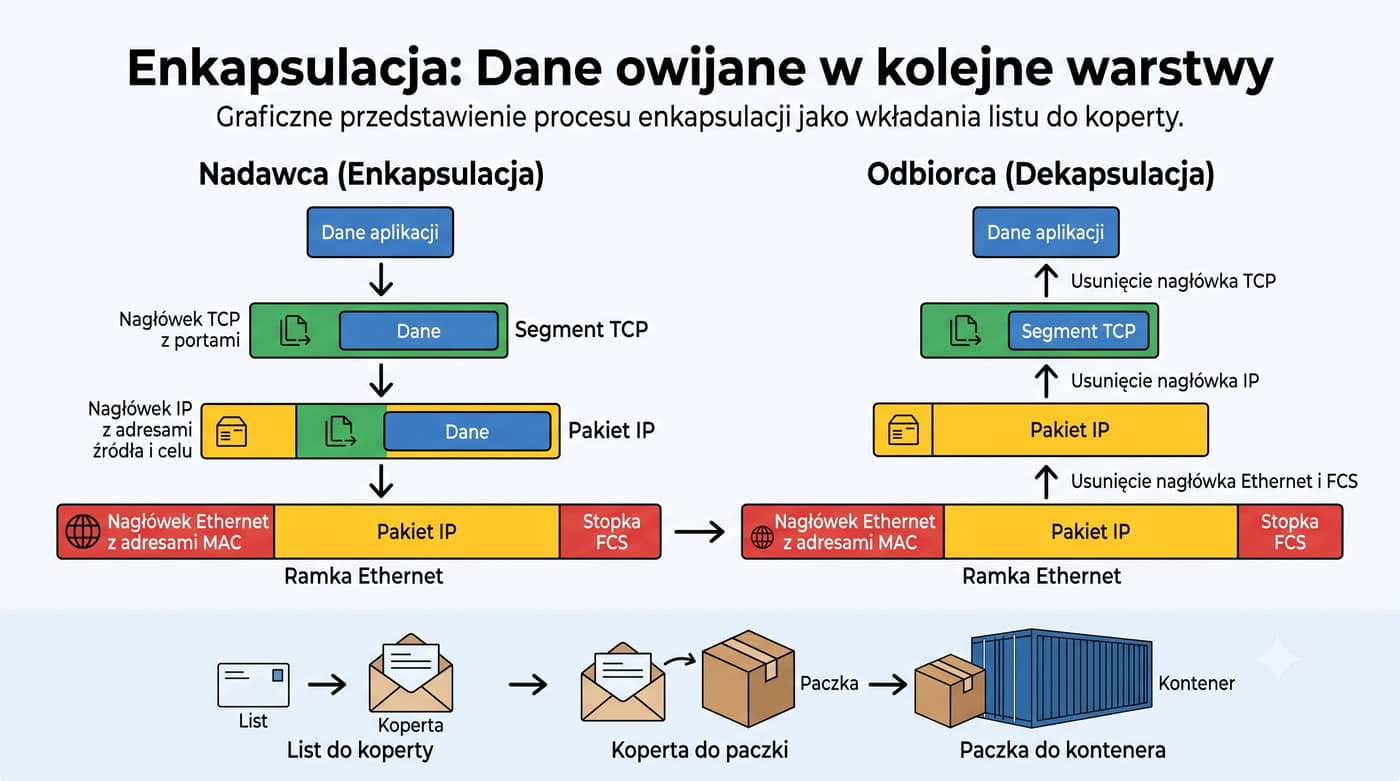
Enkapsulacja to proces dodawania nagłówków na kolejnych warstwach stosu protokołów.
Dane aplikacji są najpierw opakowywane w segment TCP (z numerami portów), następnie w pakiet IP (z adresami IP źródła i celu), a na końcu w ramkę Ethernet (z adresami MAC).
Każda warstwa dodaje własny nagłówek, a warstwa łącza danych dodaje również stopkę (FCS).
Odbiorca wykonuje proces odwrotny – dekapsulację – kolejno usuwając nagłówki.
Można to porównać do wkładania listu do koperty, potem do paczki, a na końcu do kontenera transportowego.
Proces enkapsulacji można prześledzić na konkretnym przykładzie: gdy użytkownik wysyła zapytanie HTTP do serwera WWW, przeglądarka generuje dane, które są przekazywane do warstwy transportowej.
TCP dodaje nagłówek segmentu z numerem portu źródłowego (np. 49152) i docelowego (80), numerem sekwencyjnym oraz sumą kontrolną segmentu.
Następnie warstwa sieciowa enkapsuluje ten segment w pakiet IP, dodając adresy źródłowy i docelowy oraz wartość protokołu (6 dla TCP).
Warstwa łącza danych tworzy ramkę Ethernet, uzupełniając ją o adresy MAC nadawcy i odbiorcy, pole EtherType (0x0800 dla IPv4) oraz sekwencję FCS (Frame Check Sequence) na końcu ramki.
FCS jest obliczana za pomocą algorytmu CRC-32 i służy do wykrywania błędów transmisji.
Jeśli obliczona suma kontrolna po stronie odbiorcy nie zgadza się z wartością w polu FCS, ramka jest odrzucana.
Dekapsulacja po stronie serwera przebiega w odwrotnej kolejności: warstwa łącza danych weryfikuje FCS i usuwa nagłówek Ethernet, warstwa sieciowa odrzuca nagłówek IP, a warstwa transportowa weryfikuje sumę kontrolną segmentu TCP i dopiero wtedy przekazuje oryginalne dane do aplikacji HTTP.
Każda warstwa działa niezależnie, co umożliwia wymianę technologii na dowolnym poziomie bez wpływu na pozostałe warstwy.
Każdy oktet ma zakres 0–255.
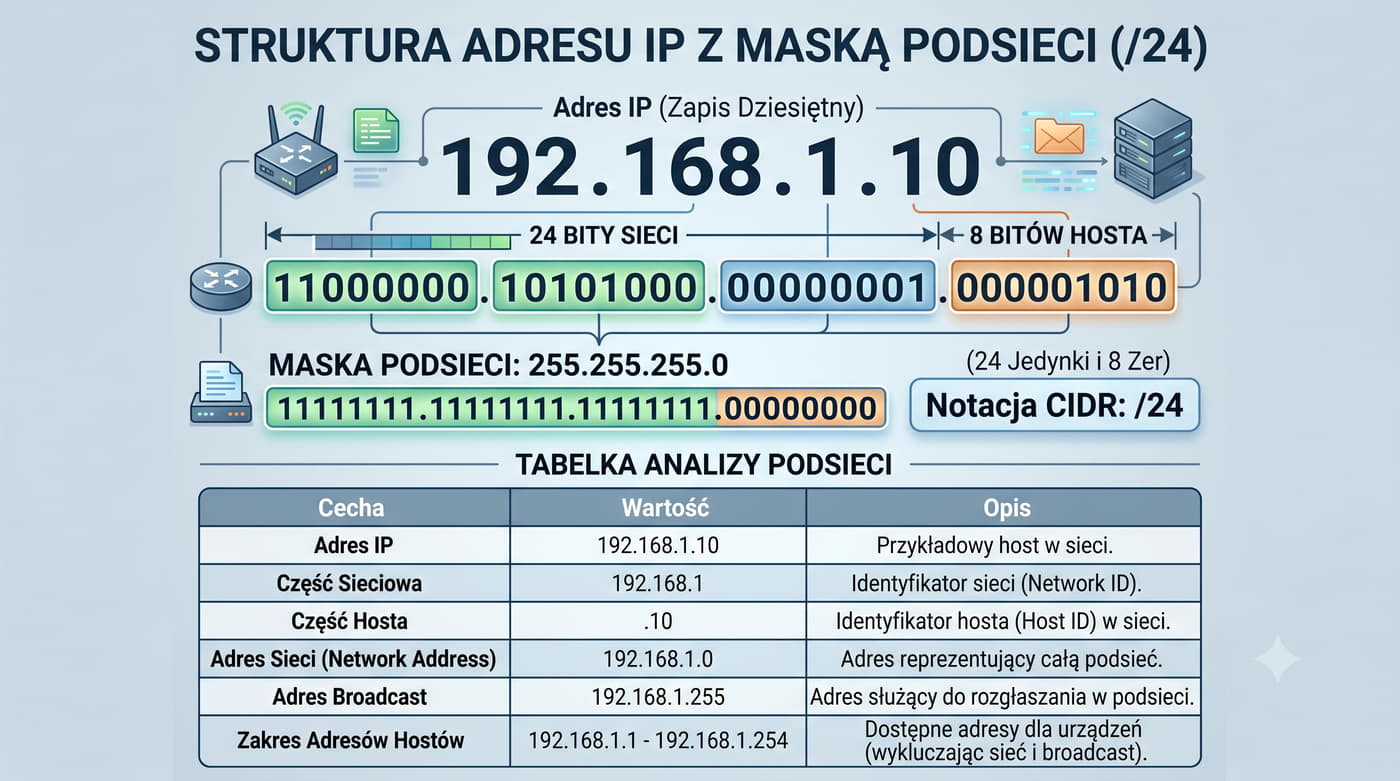
Adres IPv4 ma 32 bity (4 oktety) i jest zapisywany w notacji dziesiętnej z kropkami, na przykład 192.168.1.10.
Adres dzieli się na część sieciową (network ID) i część hosta (host ID).
Granicę między nimi wyznacza maska podsieci.
Maska podsieci to 32-bitowa liczba, w której bity sieciowe są ustawione na 1, a bity hosta na 0.
Na przykład maska /24 (255.255.255.0) oznacza, że pierwsze 24 bity to część sieciowa, a ostatnie 8 bitów to część hosta.
Budowa adresu IPv4 wymaga zrozumienia dwóch kluczowych pojęć: adres sieci (network ID) oraz adres rozgłoszeniowy (broadcast).
Adres sieci to pierwszy adres w danej podsieci, w którym wszystkie bity hosta są wyzerowane – służy on do jednoznacznej identyfikacji całej podsieci w tablicach routingu.
Adres rozgłoszeniowy to ostatni adres w podsieci, w którym wszystkie bity hosta są ustawione na 1 – jest on używany do transmisji ramki broadcast do wszystkich hostów w tej podsieci.
Obliczanie adresu sieci i broadcastu wykonuje się poprzez logiczną koniunkcję (AND) adresu IP z maską podsieci.
Dla przykładu, adres 192.168.1.130 z maską /25 (255.255.255.128) daje adres sieci 192.168.1.128 i adres broadcast 192.168.1.255, co pozostawia 126 użytecznych adresów dla hostów z zakresu 192.168.1.129–192.168.1.254.
Prawidłowe wyznaczenie tych adresów jest niezbędne przy konfiguracji interfejsów i dodawaniu tras statycznych.
W notacji CIDR (Classless Inter-Domain Routing) maskę zapisuje się jako prefiks po ukośniku, co jest standardem we współczesnych systemach operacyjnych i urządzeniach sieciowych.
Prefiks /24 odpowiada masce 255.255.255.0 i jest najczęściej spotykany w sieciach lokalnych.
Im dłuższy prefiks, tym mniejsza podsieć – na przykład /30 daje zaledwie 2 użyteczne adresy i jest typowo stosowany w łączach typu point-to-point między routerami.
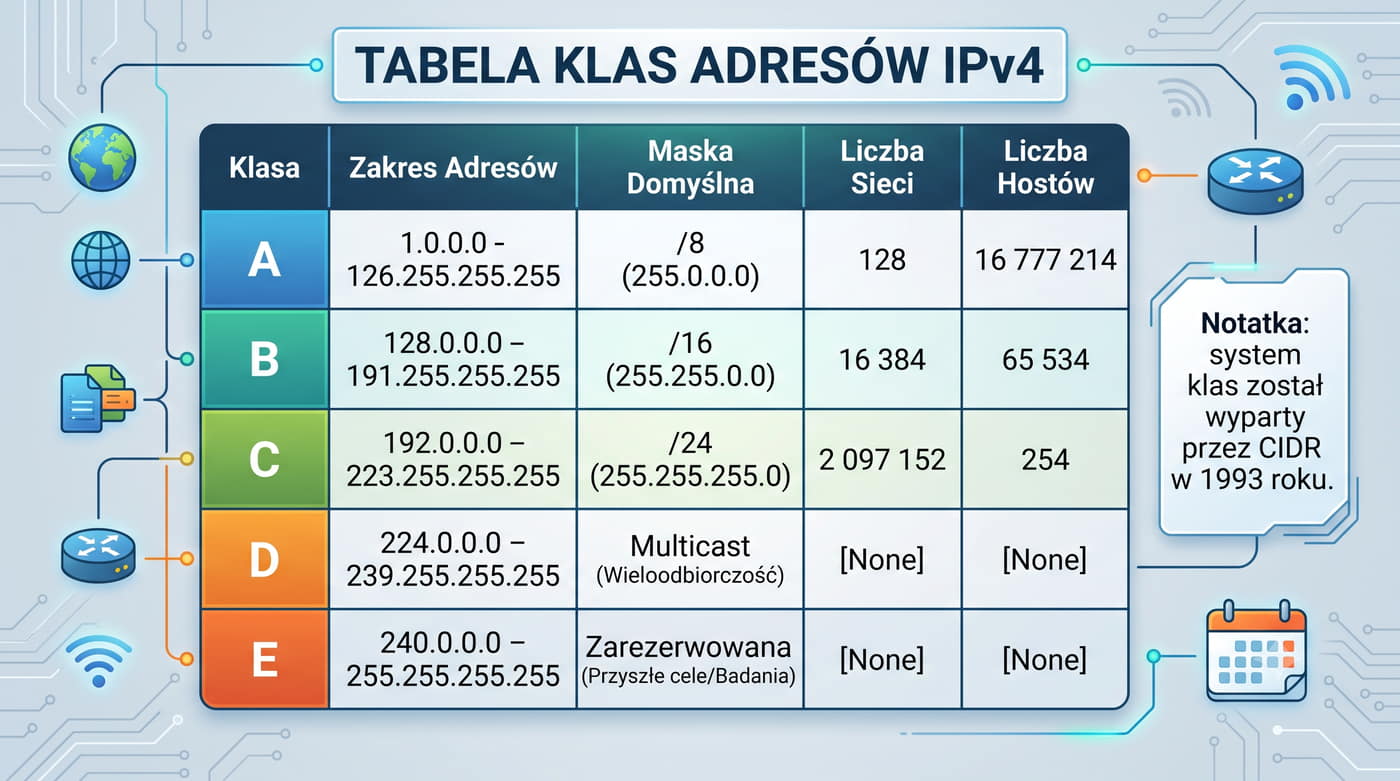
Historycznie adresy IPv4 dzielono na klasy.
Klasa A (1.0.0.0 – 126.255.255.255, maska /8) dla dużych sieci.
Klasa B (128.0.0.0 – 191.255.255.255, maska /16) dla średnich sieci.
Klasa C (192.0.0.0 – 223.255.255.255, maska /24) dla małych sieci.
Klasa D (224.0.0.0 – 239.255.255.255) dla multicastu.
Klasa E (240.0.0.0 – 255.255.255.255) zarezerwowana.
System klas został w dużej mierze wyparty przez CIDR (Classless Inter-Domain Routing), który pozwala na dowolny podział bitów sieci/hosta, ale znajomość klas jest wciąż przydatna do zrozumienia historycznego podziału adresów.
System klas adresów IPv4 był pierwszą metodą porządkowania przestrzeni adresowej Internetu, ale szybko okazał się niewystarczająco elastyczny.
Klasyfikacja odbywała się na podstawie pierwszych bitów adresu: jeśli pierwszy bit miał wartość 0, był to adres klasy A; jeśli pierwsze dwa bity to 10 – klasa B; jeśli trzy bity to 110 – klasa C.
Identyfikacja klasy była możliwa przez routery w czasie stałym, bez konieczności odczytywania całego adresu.
Głównym problemem systemu klasowego było rażące marnotrawstwo adresów.
Organizacja potrzebująca 300 adresów IP musiała otrzymać całą klasę B, która oferowała 65 534 adresy – pozostałe 65 234 adresy pozostawały niewykorzystane.
W skali globalnej prowadziło to do szybkiego wyczerpywania się puli dostępnych adresów IPv4.
Ponadto klasa A oferowała zaledwie 128 sieci, które zostały przydzielone wczesnym użytkownikom Internetu, głównie amerykańskim uniwersytetom i instytucjom rządowym.
Wprowadzenie CIDR (Classless Inter-Domain Routing) w 1993 roku całkowicie zlikwidowało sztywny podział na klasy.
CIDR pozwala na dzielenie przestrzeni adresowej na podsieci o dowolnej wielkości, z maską o długości od /1 do /32.
Przykładowo maska /23 daje 510 użytecznych adresów, co jest idealne dla organizacji potrzebującej około 300 adresów.
CIDR umożliwił również agregację tras (route summarization), co znacząco zmniejszyło rozmiar tablic routingu w routerach rdzeniowych Internetu.
RFC 1918 definiuje trzy zakresy adresów prywatnych:
| Zakres | Maska | Liczba adresów | Typowe zastosowanie |
|---|---|---|---|
| 10.0.0.0 – 10.255.255.255 | /8 | 16 777 216 | duże sieci korporacyjne |
| 172.16.0.0 – 172.31.255.255 | /12 | 1 048 576 | średnie sieci firmowe |
| 192.168.0.0 – 192.168.255.255 | /16 | 65 536 | sieci domowe i małe biura |
Adresy publiczne są globalnie unikalne i routowane w Internecie – przydziela je IANA regionalnym rejestrom (RIPE dla Europy, ARIN dla Ameryki Północnej, APNIC dla Azji i Pacyfiku).
Adresy prywatne, zdefiniowane w RFC 1918, są przeznaczone wyłącznie do użytku w sieciach lokalnych i nie mogą być routowane w publicznym Internecie.
Podział na adresy publiczne i prywatne, zdefiniowany w RFC 1918, stanowi kluczowy mechanizm opóźniający wyczerpanie puli adresów IPv4.
Adresy publiczne są globalnie unikalne i przydzielane przez regionalne rejestry internetowe (RIR): RIPE NCC dla Europy, ARIN dla Ameryki Północnej, APNIC dla Azji i Pacyfiku, LACNIC dla Ameryki Łacińskiej i AfriNIC dla Afryki.
Każdy RIR zarządza pulą adresów w swoim regionie i przydziela je dostawcom usług internetowych (ISP) oraz dużym organizacjom.
Adresy prywatne mogą być swobodnie używane w sieciach lokalnych, ale nie są routowane w publicznym Internecie.
Routery brzegowe ISP są skonfigurowane do odrzucania pakietów z prywatnymi adresami źródłowymi.
Największy zakres 10.0.0.0/8 oferuje ponad 16 milionów adresów i jest powszechnie stosowany w dużych sieciach korporacyjnych oraz w chmurze obliczeniowej AWS, Azure i Google Cloud do adresacji maszyn wirtualnych i kontenerów.
Translacja adresów sieciowych NAT na routerze brzegowym umożliwia hostom z adresami prywatnymi dostęp do Internetu.
Najpopularniejszym wariantem jest NAT overload (PAT), który mapuje wiele prywatnych adresów IP na jeden publiczny adres IP przy użyciu różnych numerów portów TCP lub UDP.
Mechanizm ten, choć powszechnie stosowany, wprowadza dodatkowe opóźnienia i komplikuje działanie protokołów wymagających inicjacji połączenia z zewnątrz.
Docelowym rozwiązaniem problemu wyczerpania adresów pozostaje migracja do IPv6, która oferuje 128-bitową przestrzeń adresową.
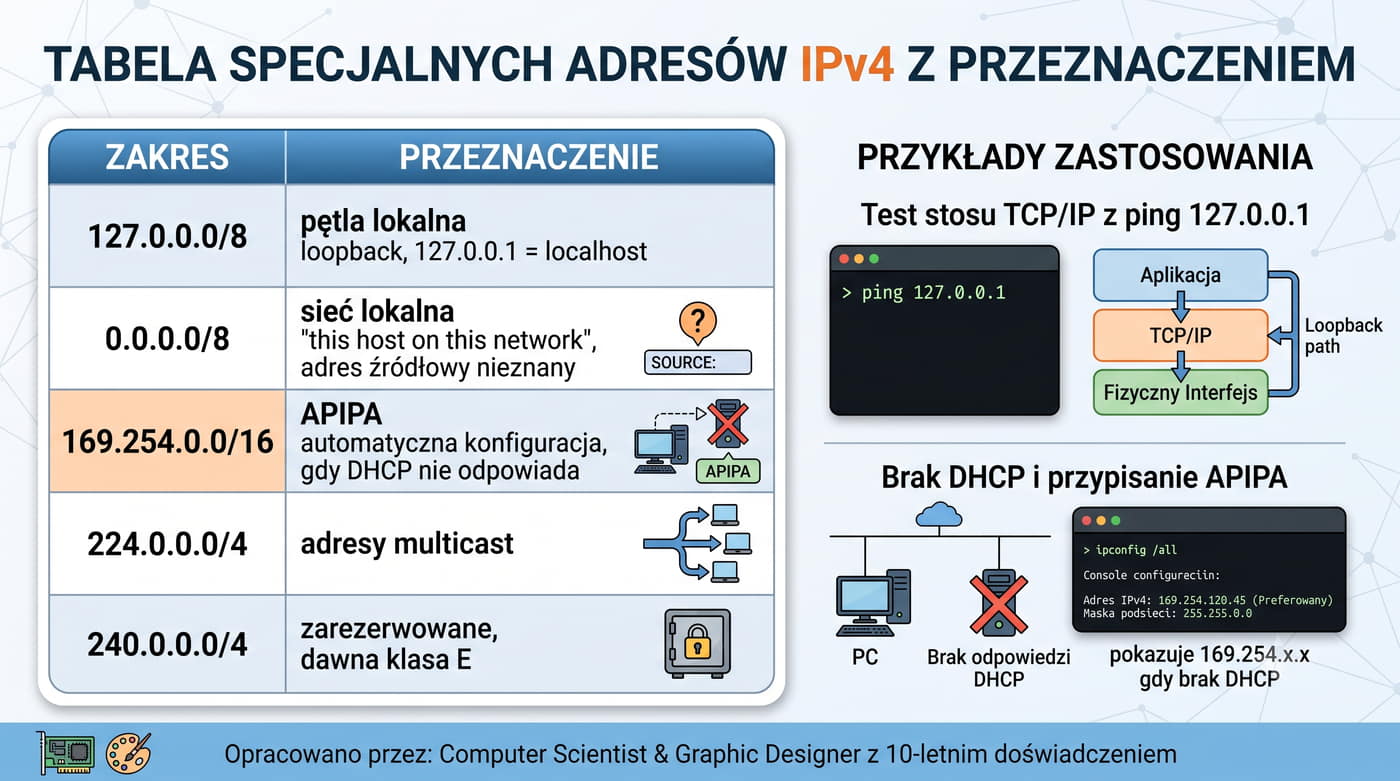
| Zakres | Przeznaczenie |
|---|---|
| 127.0.0.0/8 | pętla lokalna (loopback) – 127.0.0.1 = localhost |
| 0.0.0.0/8 | sieć lokalna (this host on this network) – adres źródłowy nieznany |
| 169.254.0.0/16 | APIPA – automatyczna konfiguracja, gdy DHCP nie odpowiada |
| 224.0.0.0/4 | adresy multicast |
| 240.0.0.0/4 | zarezerwowane (kiedyś klasa E) |
Adres 127.0.0.1 jest używany do testowania stosu TCP/IP na lokalnym hoście.
APIPA (169.254.x.x) pojawia się, gdy host nie może uzyskać adresu z serwera DHCP.
Adresy specjalne IPv4 pełnią ściśle określone funkcje pomocnicze i nie mogą być przydzielane interfejsom sieciowym jako adresy unicast.
Pętla lokalna 127.0.0.0/8, a w szczególności adres 127.0.0.1 (localhost), jest wykorzystywana do testowania lokalnego stosu TCP/IP.
Pakiety wysłane na ten adres nie opuszczają karty sieciowej – są kierowane bezpośrednio do warstwy transportowej tego samego hosta.
Jest to niezbędne do diagnostyki, ponieważ ping 127.0.0.1 weryfikuje poprawność działania stosu TCP/IP niezależnie od fizycznego okablowania.
Adres 0.0.0.0 ma dwa różne znaczenia w zależności od kontekstu.
W konfiguracji interfejsu sieciowego oznacza adres nieokreślony (any address) i jest używany przez protokół DHCP w fazie uzyskiwania adresu, gdy host nie zna jeszcze swojego adresu IP.
W tablicach routingu wpis 0.0.0.0/0 definiuje domyślną trasę (default gateway), która jest używana dla wszystkich pakietów, dla których nie znaleziono bardziej specyficznej trasy w tablicy routingu.
Zakres 169.254.0.0/16, zdefiniowany w RFC 3927, jest wykorzystywany przez mechanizm Automatic Private IP Addressing (APIPA) w systemach Windows.
Gdy serwer DHCP nie odpowiada, host samodzielnie wybiera losowy adres z tego zakresu i weryfikuje jego unikalność za pomocą protokołu ARP przed przypisaniem go do interfejsu.
Adresy APIPA nie są routowane i umożliwiają komunikację wyłącznie w obrębie jednego segmentu sieci, co jest przydatne w sytuacjach awaryjnych, gdy serwer DHCP jest niedostępny.
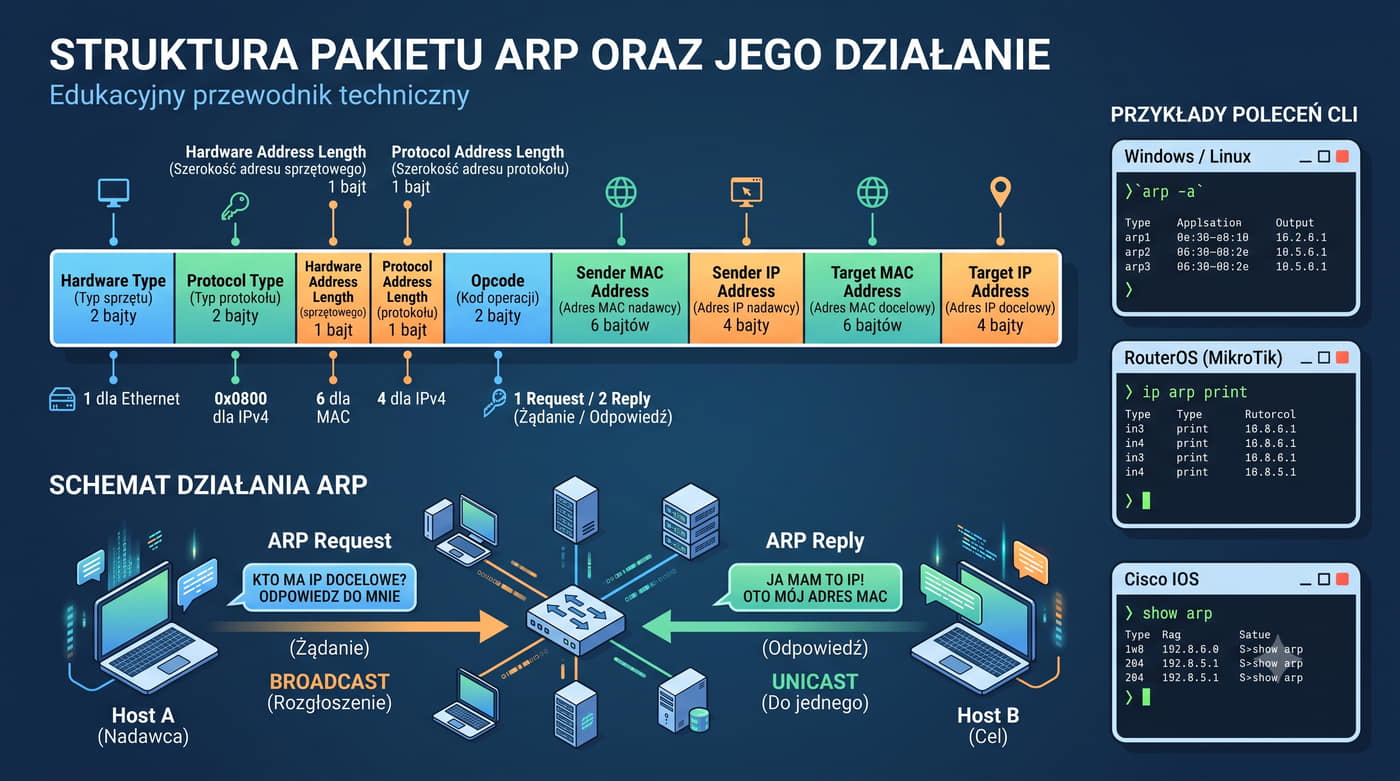
arp -a (Windows) lub ip neigh show (Linux) wyświetla tablicę ARP. Brak wpisu ARP oznacza, że pierwszy pakiet do danego hosta będzie opóźniony o czas wykonania zapytania ARP.Protokół ARP (Address Resolution Protocol) jest łącznikiem między warstwą sieciową (adresy IP) a warstwą łącza danych (adresy MAC).
Gdy host zna adres IP odbiorcy w tej samej sieci lokalnej, ale nie zna jego adresu MAC, wysyła zapytanie ARP Request jako ramkę broadcast – dociera do wszystkich urządzeń w segmencie z pytaniem: „kto ma adres IP X.X.X.X?"
Wszystkie hosty odbierają zapytanie, ale odpowiada tylko ten, którego adres IP jest zgodny z poszukiwanym.
Odpowiedź ARP Reply jest ramką unicast skierowaną bezpośrednio do nadawcy, zawierającą żądany adres MAC.
Otrzymana para IP-MAC jest zapisywana w lokalnej tablicy ARP (cache) na określony czas TTL – w systemie Linux oraz we współczesnych wersjach Windows (Vista i nowszych) czas życia wpisu wynosi zazwyczaj od 15 do 45 sekund (losowany), przy czym starsze wersje Windows utrzymywały wpisy około 2 minut.
Protokół ARP (Address Resolution Protocol), zdefiniowany w RFC 826 z 1982 roku, jest niezbędnym elementem komunikacji w sieciach IPv4 opartych na Ethernecie.
Jego fundamentalnym zadaniem jest dynamiczne odwzorowywanie 32-bitowych adresów IP na 48-bitowe adresy MAC, ponieważ ramka Ethernet wymaga znajomości docelowego adresu MAC do poprawnego dostarczenia danych w segmencie lokalnym.
Bez ARP każda para komunikujących się hostów musiałaby mieć ręcznie skonfigurowane odwzorowania adresów, co byłoby całkowicie niepraktyczne.
Proces rozwiązywania adresów rozpoczyna się od sprawdzenia lokalnej tablicy ARP (cache ARP), która przechowuje pary IP-MAC wraz z informacją o typie wpisu (dynamiczny lub statyczny) i czasie życia.
W systemie Linux domyślny czas życia niepotwierdzonego wpisu wynosi od 15 do 45 sekund (losowany na podstawie bazy 30 sekund), a we współczesnych wersjach Windows obowiązuje zbliżony zakres losowania 15–45 sekund; starsze systemy (do Windows XP/2003) utrzymywały wpisy około 2 minut.
Jeśli wymagane odwzorowanie nie istnieje w cache, host generuje ramkę ARP Request z adresem docelowym MAC FF:FF:FF:FF:FF:FF (broadcast) i adresem IP, którego poszukuje.
Ramka ta jest przetwarzana przez wszystkie karty sieciowe w segmencie.
Host, który rozpozna swój adres IP w zapytaniu ARP, odpowiada ramką ARP Reply typu unicast, zawierającą jego adres MAC.
Odpowiedź ta jest wykorzystywana przez nadawcę do zaktualizowania tablicy ARP i skonstruowania ramki Ethernet z poprawnym adresem docelowym.
Warto zaznaczyć, że protokół ARP nie zawiera mechanizmów uwierzytelniania, co czyni go podatnym na ataki typu ARP spoofing, w których atakujący wysyła sfałszowane odpowiedzi ARP w celu przechwycenia ruchu sieciowego.
Przykład CLI:
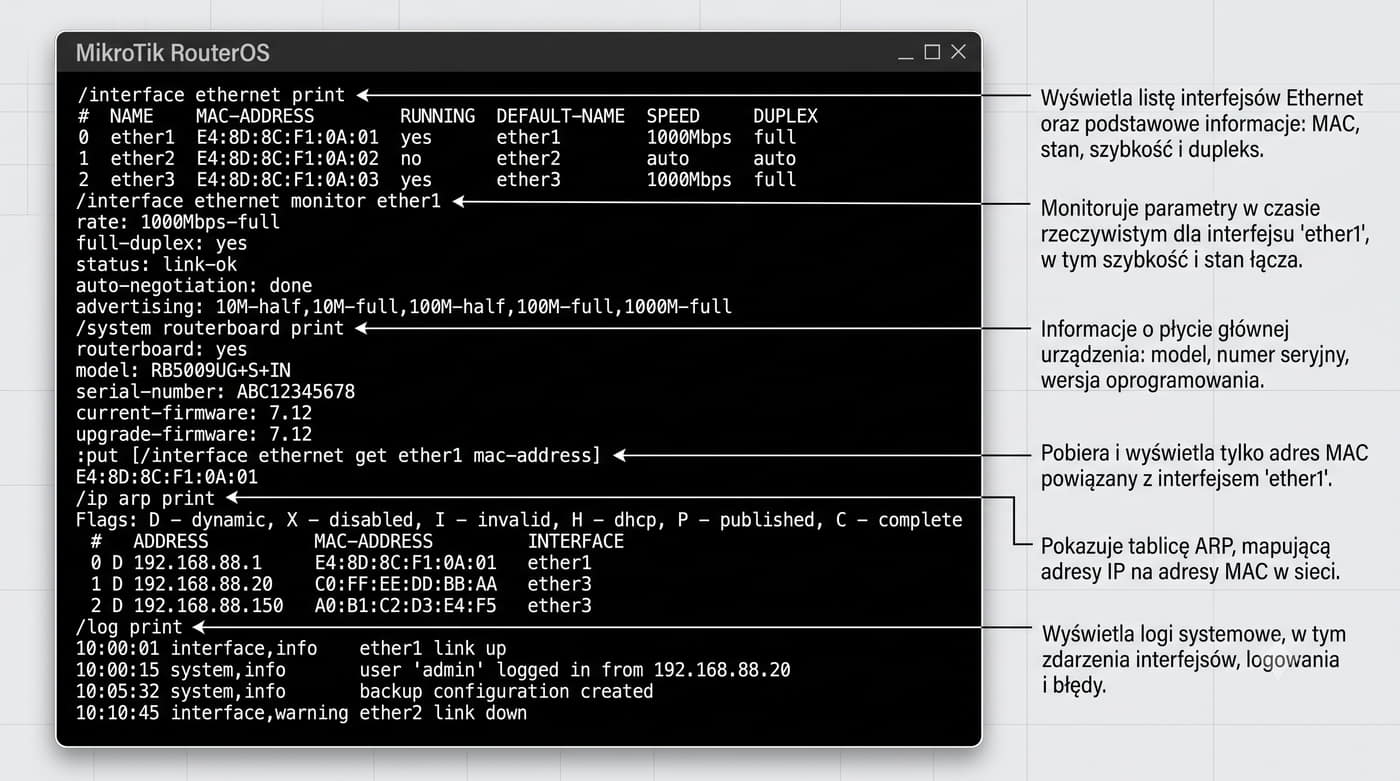
arp -a (Windows) / w Linux: ip neigh show – wyświetlenie tablicy ARP /ip arp print (RouterOS) – lista wpisów ARP show arp (Cisco IOS) – tablica ARP
Pakiet ARP składa się z następujących pól: Hardware Type (2B, dla Ethernet = 1), Protocol Type (2B, dla IPv4 = 0x0800), Hardware Size (1B, dla MAC = 6), Protocol Size (1B, dla IPv4 = 4), Opcode (2B, 1 = Request, 2 = Reply), Sender MAC (6B), Sender IP (4B), Target MAC (6B), Target IP (4B).
W systemach Windows polecenie arp -a pokazuje wszystkie aktualne wpisy w cache ARP wraz z adresami IP i MAC oraz typem wpisu (dynamiczny/statyczny); w Linux polecenie arp bywa dostępne po instalacji pakietu net-tools, a standardowo tablicę ARP wyświetla polecenie ip neigh show.
Struktura pakietu ARP dla pary Ethernet-IPv4 ma stałą długość 28 bajtów, nie licząc nagłówka ramki Ethernet.
Pole Hardware Type o wartości 1 identyfikuje Ethernet jako technologię warstwy łącza danych, a Protocol Type o wartości 0x0800 wskazuje IPv4 jako protokół warstwy sieciowej.
Pola Hardware Size (6 bajtów) i Protocol Size (4 bajty) określają długości odpowiednich adresów, co czyni ARP elastycznym i teoretycznie zdolnym do obsługi różnych technologii, choć w praktyce zdecydowana większość implementacji dotyczy Ethernetu i IPv4.
Pole Opcode (operacja) przyjmuje wartość 1 dla zapytania ARP Request i 2 dla odpowiedzi ARP Reply.
W zapytaniu pole Target MAC jest wypełnione zerami, ponieważ właśnie ten adres jest przedmiotem zapytania.
W odpowiedzi wszystkie cztery pola adresowe są wypełnione: Sender MAC i Sender IP zawierają adres odpowiadającego hosta, a Target MAC i Target IP zawierają adres nadawcy zapytania, co pozwala mu na natychmiastową aktualizację tablicy ARP po odebraniu odpowiedzi.
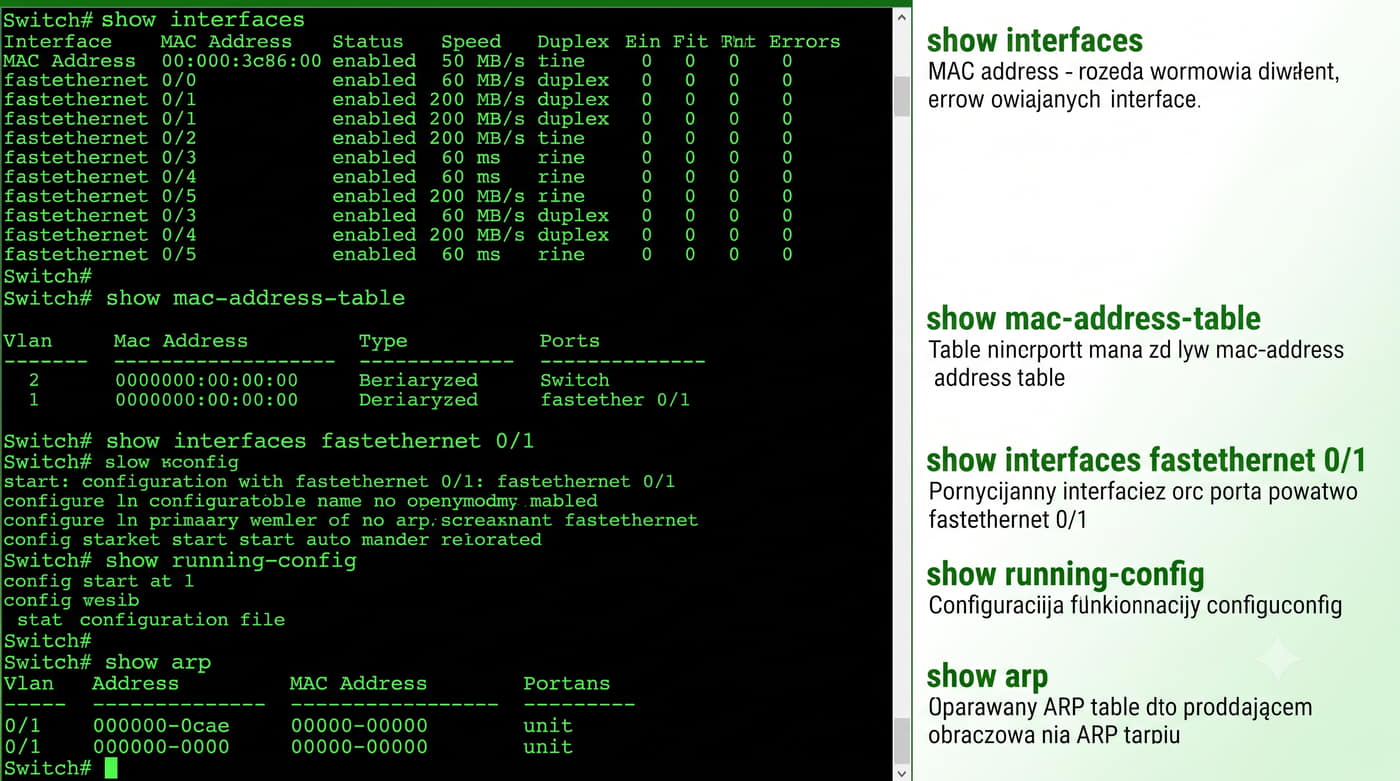
Do diagnostyki tablicy ARP w systemach operacyjnych służą polecenia: arp -a w Windows, ip neigh show w Linux oraz show ip arp w Cisco IOS.
W systemie RouterOS MikroTik odpowiednikiem jest /ip arp print.
Wszystkie te narzędzia wyświetlają aktualne wpisy ARP wraz z adresami IP i MAC, typem wpisu (dynamiczny lub statyczny) oraz interfejsem, przez który dany host jest osiągalny.
Regularne monitorowanie tablicy ARP jest ważnym elementem diagnostyki sieciowej i wykrywania potencjalnych ataków ARP spoofing.
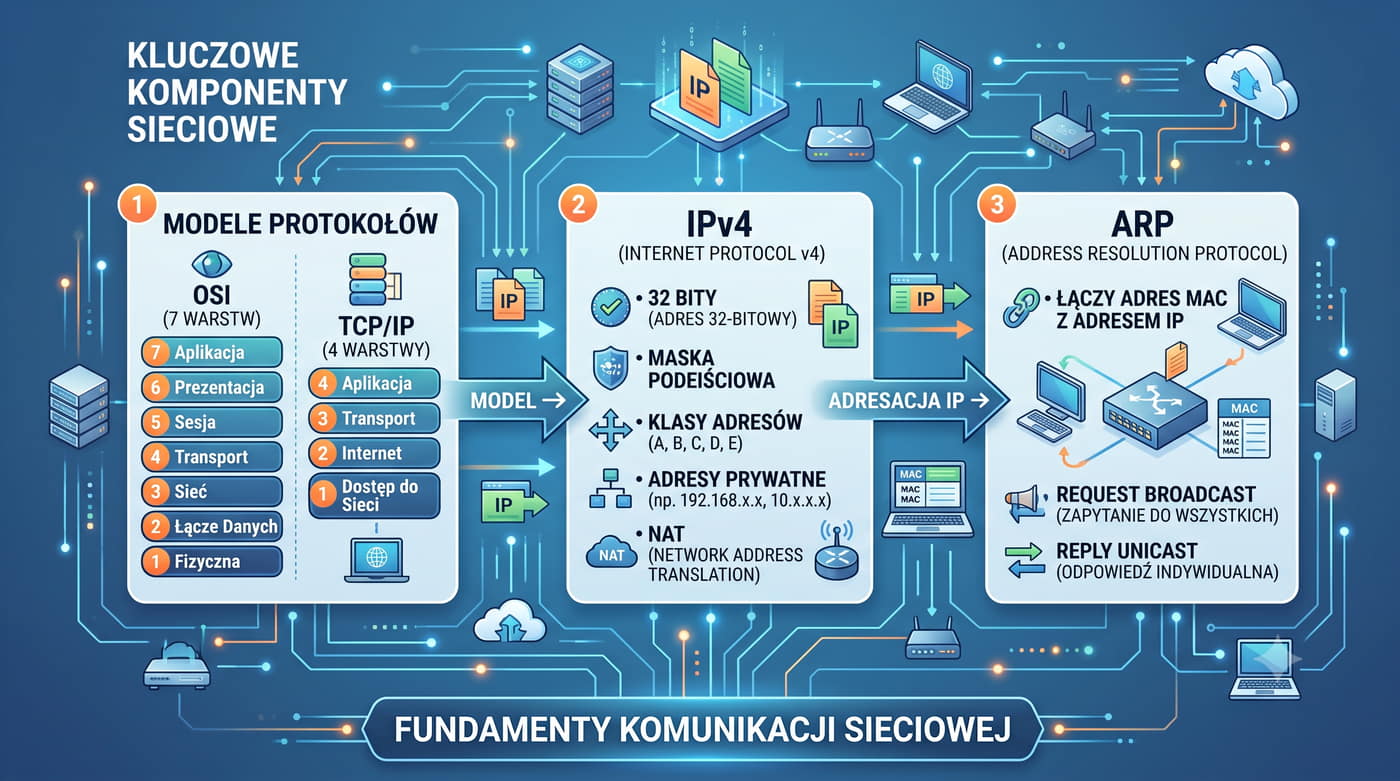
Blok trzeci łączy trzy fundamentalne obszary wiedzy sieciowej: modele referencyjne OSI i TCP/IP, adresację IPv4 oraz protokół ARP.
Modele dostarczają ram teoretycznych do zrozumienia architektury komunikacji, określając, jakie funkcje są realizowane na poszczególnych warstwach i w jaki sposób dane są enkapsulowane.
Adresacja IPv4 zapewnia logiczny system identyfikacji hostów w globalnej sieci, umożliwiając routing pakietów między połączonymi sieciami.
Protokół ARP stanowi krytyczny łącznik między adresacją logiczną (IP) a fizyczną (MAC).
Bez poprawnego odwzorowania ARP nawet poprawnie skonfigurowany adres IP i maska podsieci nie pozwolą na wysłanie ramki Ethernet, ponieważ warstwa łącza danych wymaga znajomości docelowego adresu MAC.
Każda transmisja danych w sieci lokalnej wymaga sekwencyjnego działania wszystkich tych elementów: od enkapsulacji danych w segmencie TCP, przez dodanie nagłówka IP, aż po odwzorowanie ARP w warstwie łącza danych.
Umiejętność diagnozowania problemów w tych obszarach jest kluczowa w praktyce administracyjnej.
Błędnie skonfigurowana maska podsieci może uniemożliwić komunikację między hostami w tej samej sieci fizycznej, wyczerpana tablica ARP może powodować okresowe przerwy w komunikacji, a nieprawidłowa trasa domyślna uniemożliwia dostęp do Internetu.
Narzędzia takie jak ipconfig, ping, tracert, arp i netstat pozwalają na szybką weryfikację każdej z tych warstw stosu TCP/IP.
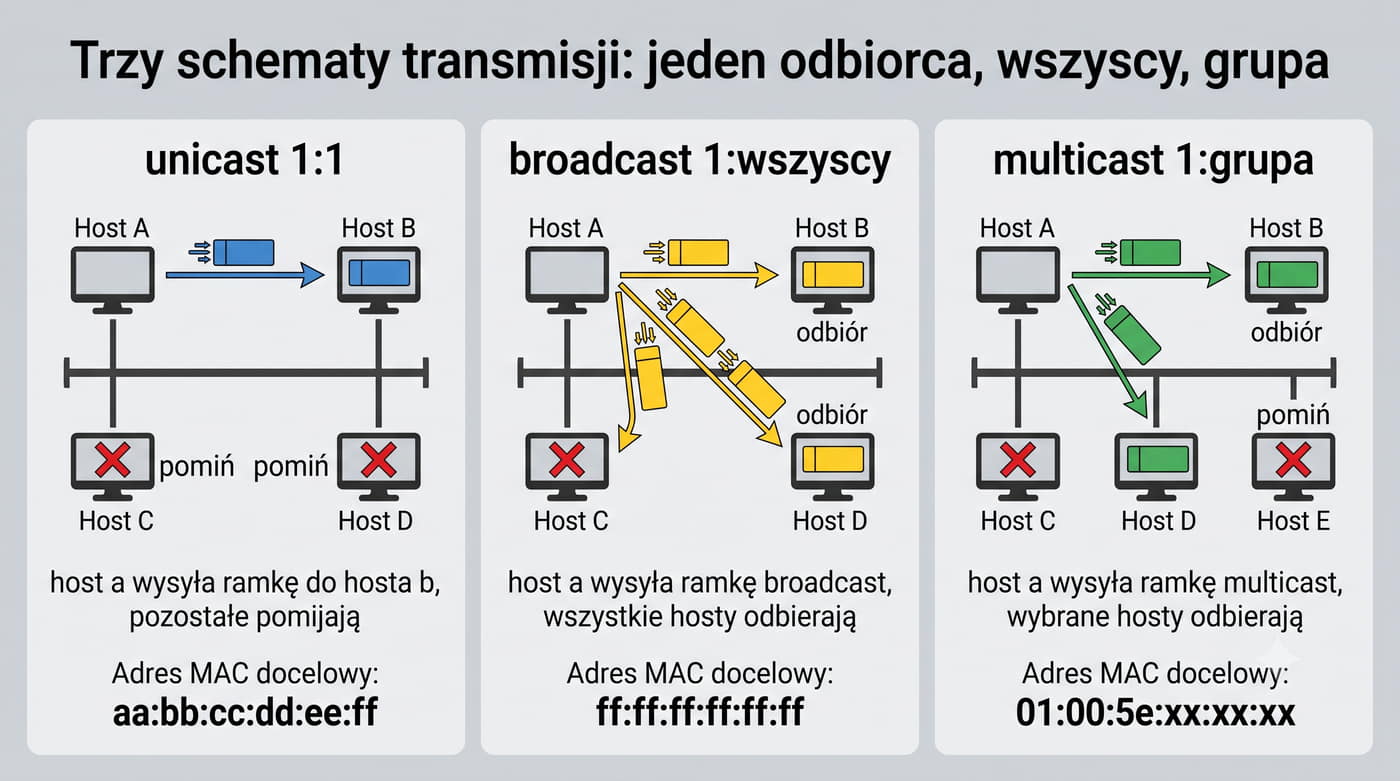
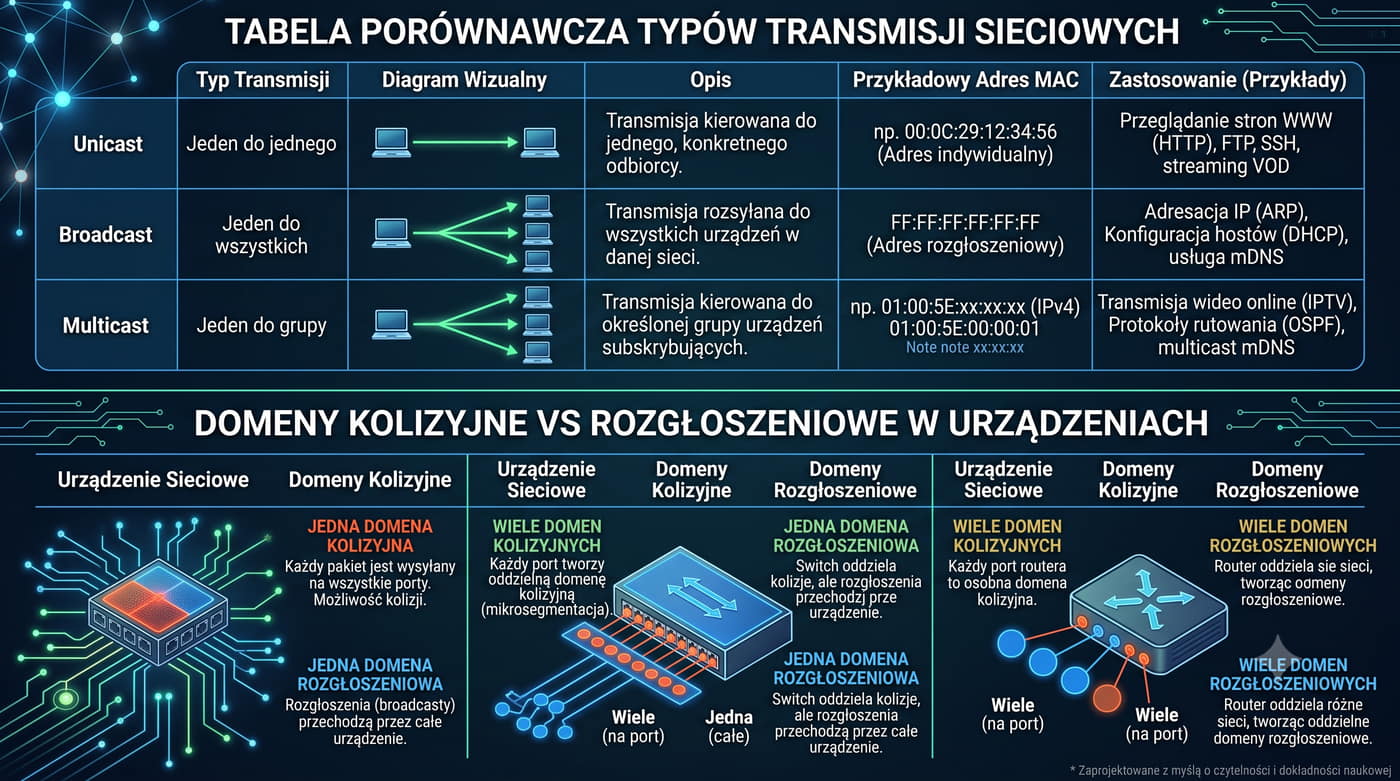
W sieci Ethernet wyróżnia się trzy podstawowe typy transmisji.
Unicast to transmisja typu jeden do jednego – ramka jest adresowana do konkretnego odbiorcy (określonego adresem MAC).
Broadcast to transmisja jeden do wszystkich – ramka z adresem docelowym FF:FF:FF:FF:FF:FF jest odbierana przez wszystkie stacje w segmencie.
Multicast to transmisja jeden do grupy – ramka trafia do wybranej grupy odbiorców.
W przypadku multicastu IPv4 używa się adresów MAC z zakresu 01:00:5E:xx:xx:xx.
Karta sieciowa może filtrować ramki multicast, jeśli system operacyjny nie zadeklarował zainteresowania daną grupą.
Trzy typy transmisji Ethernet różnią się przede wszystkim zakresem adresowania i wpływem na wydajność sieci.
Unicast, w którym ramka adresowana jest do pojedynczego adresu MAC odbiorcy, stanowi podstawę komunikacji w sieciach IP.
Większość ruchu sieciowego, od przeglądania stron WWW po transfer plików FTP i komunikację SSH, odbywa się właśnie w trybie unicast.
W sieci przełączanej ramka unicast jest przekazywana wyłącznie na port, do którego podłączony jest odbiorca, co optymalizuje wykorzystanie pasma.
Broadcast z adresem docelowym FF:FF:FF:FF:FF:FF jest niezbędny do działania kluczowych protokołów warstwy sieciowej.
Protokół ARP wykorzystuje broadcast do znajdowania adresu MAC odpowiadającego danemu adresowi IP, a protokół DHCP używa broadcastu do lokalizacji serwera DHCP podczas automatycznej konfiguracji adresacji.
Każdy broadcast jest jednak przetwarzany przez wszystkie karty sieciowe w segmencie, co przy setkach hostów generuje znaczący narzut obliczeniowy i może prowadzić do degradacji wydajności całej sieci.
Multicast zajmuje pozycję pośrednią między unicastem a broadcastem.
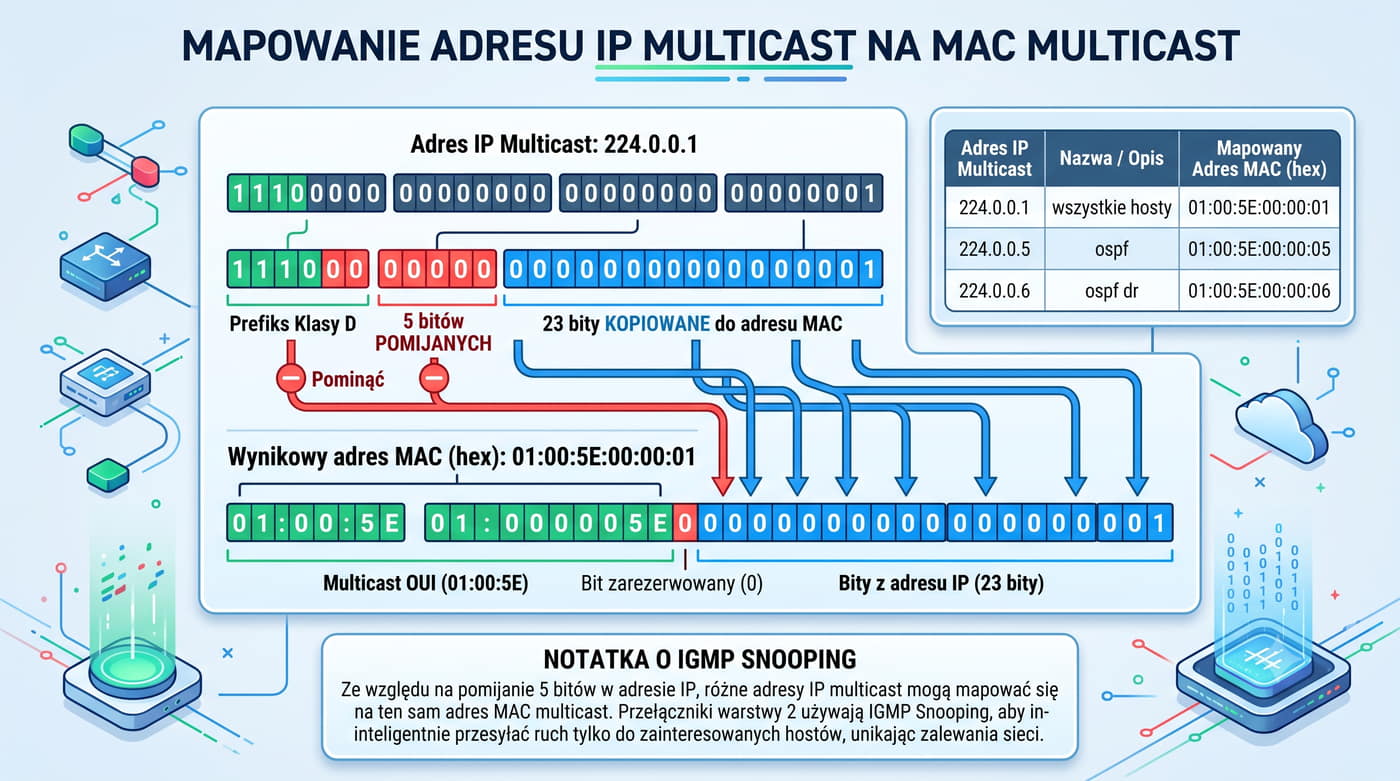
Adres MAC multicast jest identyfikowany przez bit I/G ustawiony na 1 w pierwszym oktecie, a dla IPv4 jest odwzorowywany z zakresu 01:00:5E przy użyciu 23 najmłodszych bitów adresu IP multicast.
Karty sieciowe mogą filtrować ramki multicast na poziomie sprzętowym, jeśli system operacyjny przez protokół IGMP nie zadeklarował uczestnictwa w danej grupie.
Multicast jest szeroko stosowany w IPTV, wideokonferencjach oraz protokołach routingu dynamicznego takich jak OSPF.
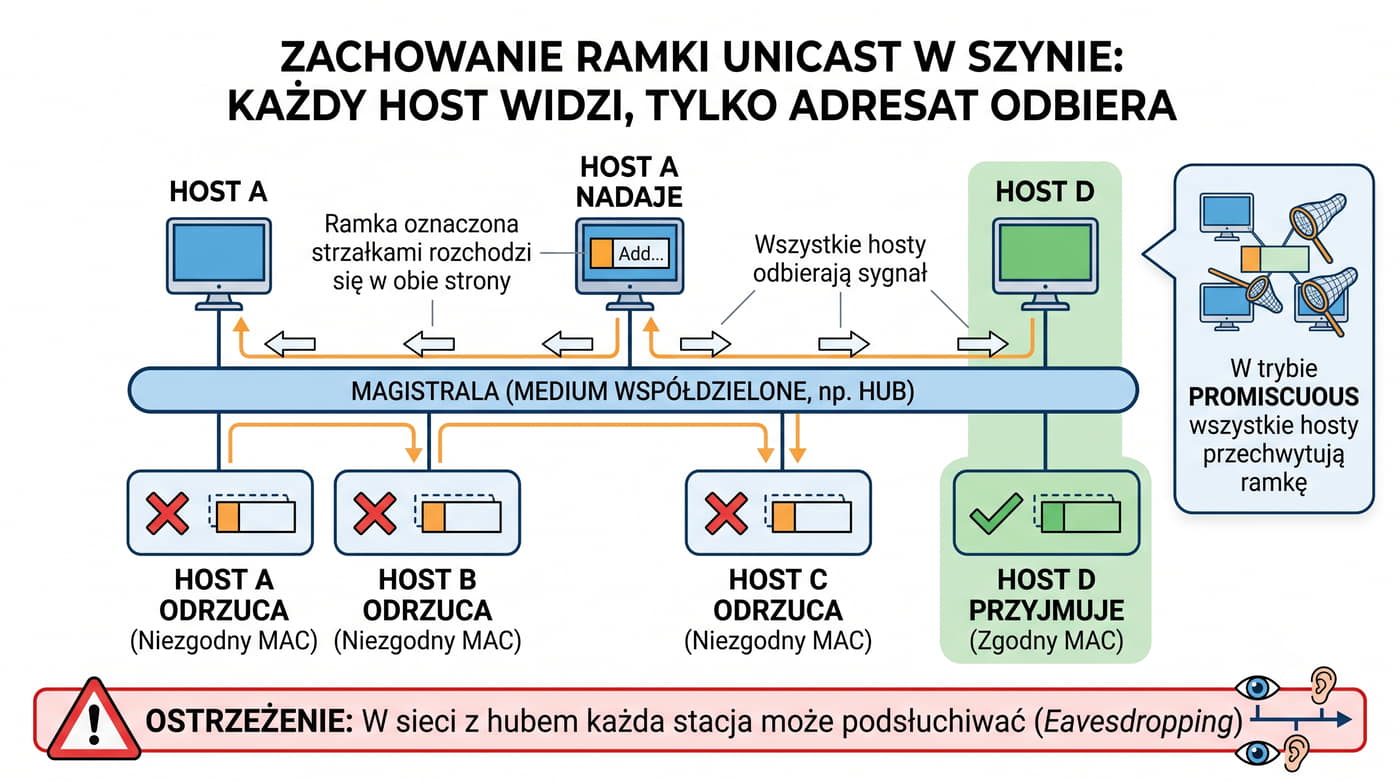
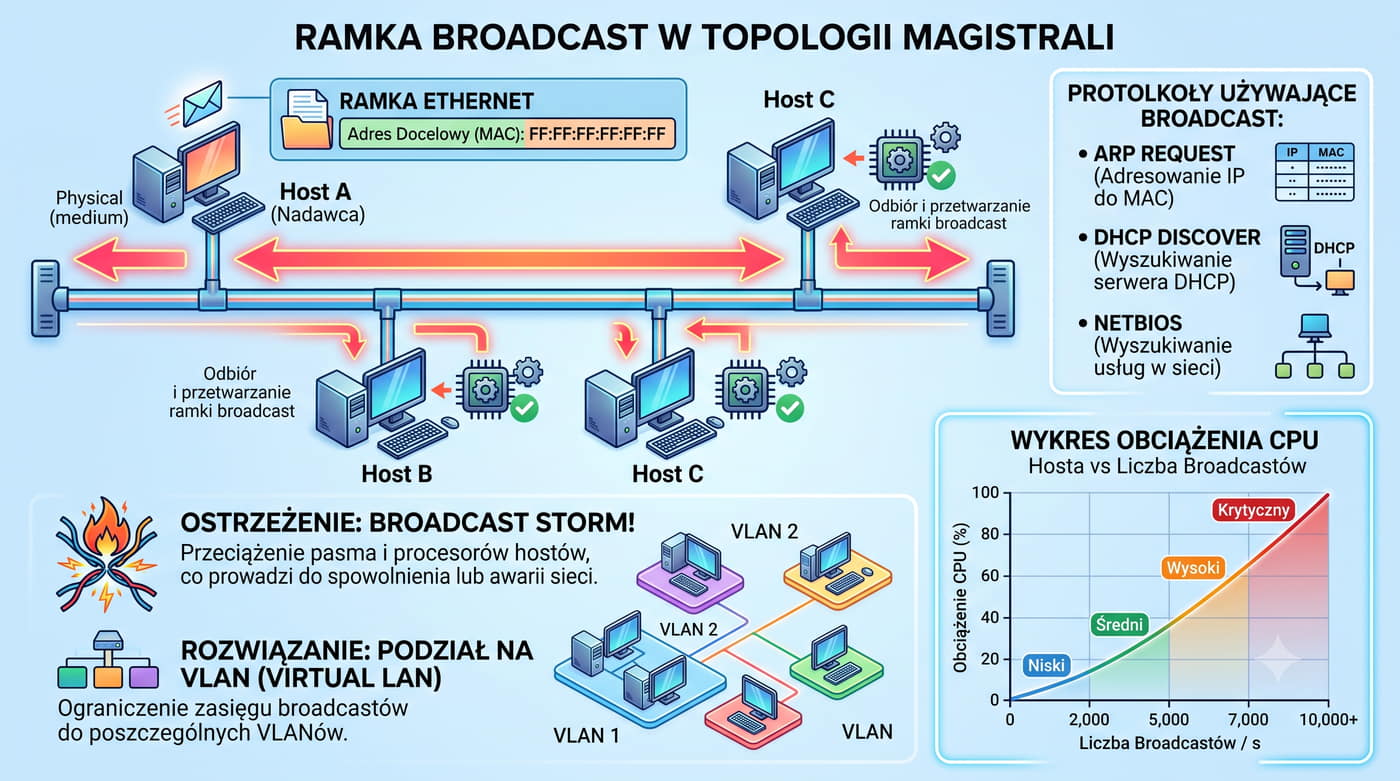
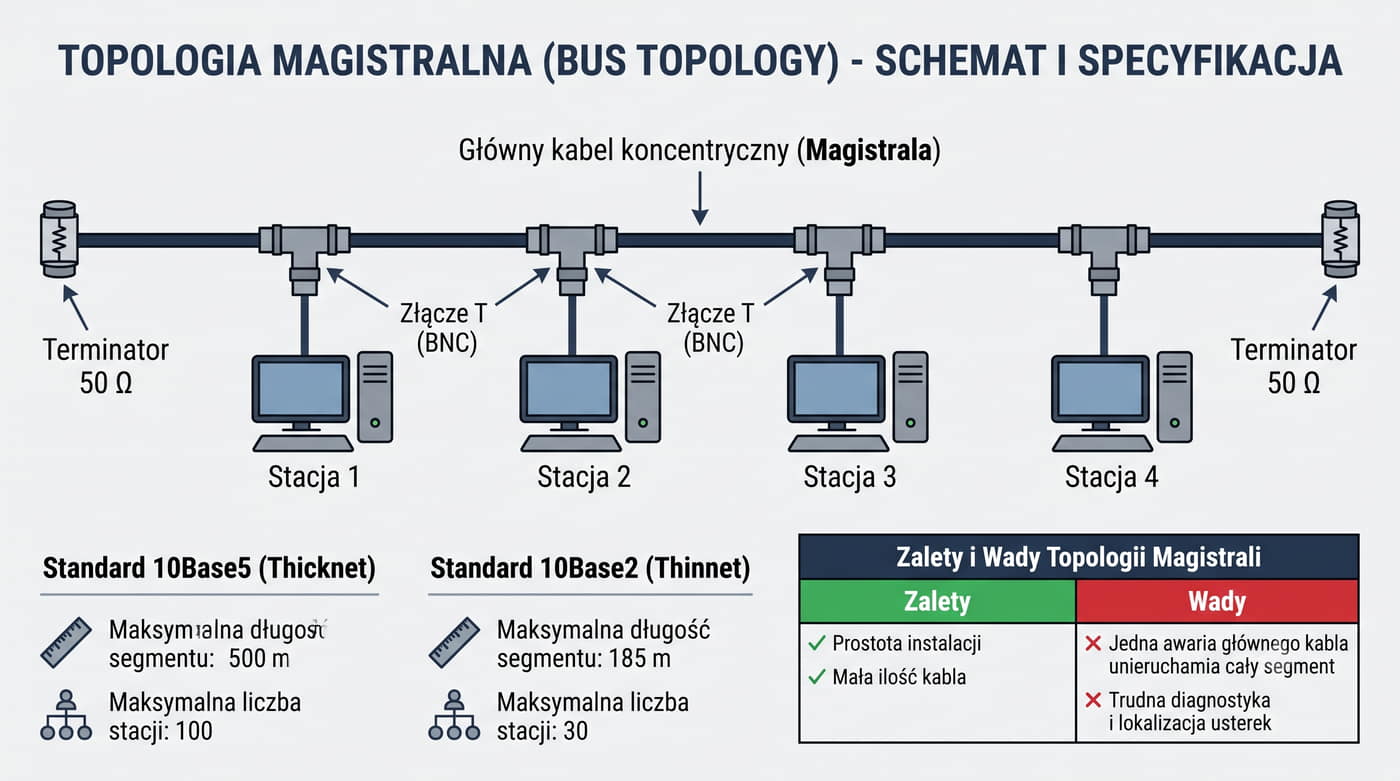
W sieci o wspólnym medium (magistrala) ramka unicast – mimo że adresowana do jednego hosta – fizycznie dociera do wszystkich stacji w segmencie.
Dzieje się tak, ponieważ sygnał elektryczny rozchodzi się w obie strony kabla koncentrycznego.
Każda karta sieciowa odbiera ramkę i sprawdza adres docelowy.
Większość kart odrzuca ramki nieadresowane do siebie.
Jednak w trybie promiscuous wszystkie ramki są przechwytywane i przekazywane do systemu operacyjnego, co umożliwia przechwytywanie ruchu sieciowego (sniffing).
W sieci o topologii magistrali, gdzie wszystkie stacje współdzielą jeden kabel koncentryczny, transmisja unicast ma fundamentalną właściwość wynikającą z fizyki propagacji sygnału.
Ramka wysłana przez nadawcę rozchodzi się elektrycznie w obie strony szyny i jest fizycznie odbierana przez wszystkie karty sieciowe w segmencie, niezależnie od tego, do którego hosta jest formalnie adresowana.
Jest to naturalna konsekwencja współdzielonego medium – sygnał elektryczny nie ma możliwości ominięcia pośrednich stacji.
Każda karta sieciowa po odebraniu ramki dokonuje na poziomie sprzętowym porównania docelowego adresu MAC z własnym adresem, zapisanym w pamięci EEPROM.
Jeśli adresy nie są zgodne, ramka jest odrzucana bez angażowania procesora głównego i systemu operacyjnego – proces ten jest realizowany w kontrolerze MAC i trwa zaledwie kilka cykli zegarowych.
Jedynie stacja, której adres MAC jest zgodny z adresem docelowym, przekazuje ramkę przez magistralę PCIe do pamięci systemowej i dalej do stosu sieciowego.
Tryb promiscuous na karcie sieciowej wyłącza sprzętowe filtrowanie adresów MAC, powodując przekazywanie wszystkich odebranych ramek do systemu operacyjnego.
Z tego powodu współczesne sieci korporacyjne stosują przełączniki, które izolują ruch między portami i uniemożliwiają nieautoryzowany podsłuch.
Ramka broadcast (adres docelowy FF:FF:FF:FF:FF:FF) jest odbierana i przetwarzana przez wszystkie karty sieciowe w segmencie.
Broadcasty są niezbędne do działania podstawowych protokołów, takich jak ARP (zapytanie o adres MAC), DHCP Discover (poszukiwanie serwera DHCP) czy NetBIOS.
Problem pojawia się, gdy w sieci jest zbyt wiele broadcastów – mówimy wtedy o burzy rozgłoszeniowej (broadcast storm).
Nadmiar broadcastów obciąża wszystkie stacje, zmuszając je do niepotrzebnego przetwarzania ramek.
W skrajnych przypadkach może to prowadzić do znacznego spadku wydajności całej sieci.
Ramka broadcast z adresem docelowym FF:FF:FF:FF:FF:FF jest celowym mechanizmem umożliwiającym komunikację typu jeden do wszystkich w segmencie sieci.
Każda karta sieciowa odbiera taką ramkę i przekazuje ją do systemu operacyjnego do dalszego przetworzenia, ponieważ adres broadcast jest zarezerwowany i rozpoznawany sprzętowo przez kontroler MAC.
Ten mechanizm jest fundamentalny dla działania protokołu ARP, który w ten sposób lokalizuje adres MAC odpowiadający danemu adresowi IP, oraz dla protokołu DHCP, gdzie klient wysyła broadcast DHCP Discover w poszukiwaniu serwera DHCP.
Nadmiar broadcastów w sieci prowadzi do zjawiska burzy rozgłoszeniowej (broadcast storm), które objawia się lawinowym wzrostem liczby ramek broadcast powodującym znaczne obciążenie procesorów wszystkich stacji.
Każdy broadcast wymusza przerwanie sprzętowe na karcie sieciowej i przekazanie ramki do systemu operacyjnego, który musi ją zinterpretować i odrzucić, jeśli nie dotyczy żadnego lokalnego procesu.
Przy setkach broadcastów na sekundę obciążenie procesora może osiągnąć 100%, uniemożliwiając normalną pracę hostów.
Burza rozgłoszeniowa może być wywołana przez uszkodzoną kartę sieciową transmitującą ciągłe broadcasty, pętle w topologii przełączanej (przed wprowadzeniem protokołu Spanning Tree) lub celowe ataki DDoS z wykorzystaniem techniki broadcast amplification.
Ograniczenie negatywnego wpływu broadcastów osiąga się przez podział sieci na mniejsze domeny rozgłoszeniowe za pomocą routerów, które domyślnie blokują propagację broadcastów między interfejsami, lub poprzez konfigurację VLAN na przełącznikach, co pozwala na logiczną izolację domen rozgłoszeniowych w ramach jednego urządzenia.
Adres MAC multicast charakteryzuje się tym, że pierwszy bit najstarszego oktetu (bit I/G) jest ustawiony na 1, co oznacza adres grupowy.
Dla IPv4 adres MAC multicast tworzy się poprzez połączenie prefiksu 01:00:5E z ostatnimi 23 bitami adresu IP multicast.
Na przykład adres IP multicast 224.0.0.1 (wszystkie hosty w segmencie) mapuje się na adres MAC 01:00:5E:00:00:01.
Karta sieciowa może filtrować ramki multicast, jeśli system operacyjny nie zadeklarował zainteresowania daną grupą za pomocą protokołu IGMP.
Multicast jest techniką transmisji grupowej zaprojektowaną w celu efektywnego dostarczania tych samych danych do wybranej grupy odbiorców.
W odróżnieniu od broadcastu, który obciąża wszystkie stacje w segmencie, multicast kieruje dane wyłącznie do hostów, które zadeklarowały zainteresowanie daną grupą.
W warstwie MAC adres multicast jest identyfikowany przez bit Individual/Group (I/G) ustawiony na 1 w pierwszym oktecie, co odróżnia go zarówno od adresów unicast, jak i od adresu broadcast.
Mapowanie adresów IP multicast na adresy MAC Ethernet polega na skopiowaniu 23 najmłodszych bitów adresu IP multicast do prefiksu 01:00:5E.
Oznacza to, że 5 bitów adresu IP multicast jest pomijanych w tym mapowaniu, co prowadzi do sytuacji, w której 32 różne adresy IP multicast (2^5) mogą być odwzorowane na ten sam adres MAC.
Powoduje to niejednoznaczność na poziomie warstwy łącza danych – karta sieciowa może odebrać ramkę multicast adresowaną do grupy, w której host nie uczestniczy, i musi dodatkowo zweryfikować adres IP w warstwie sieciowej.
Zarządzanie uczestnictwem w grupach multicast odbywa się za pomocą protokołu IGMP (Internet Group Management Protocol), który umożliwia hostom dołączanie i opuszczanie grup oraz informuje przełączniki o potrzebie przekazywania ruchu multicast na odpowiednie porty.
W sieciach rozległych routing multicast jest realizowany przez protokoły takie jak PIM (Protocol Independent Multicast), który buduje drzewa dystrybucji od źródła do wszystkich odbiorców.
Multicast jest powszechnie stosowany w transmisji IPTV, systemach wideokonferencyjnych oraz w protokołach routingu dynamicznego takich jak OSPF i EIGRP do wysyłania pakietów Hello i aktualizacji stanu łączy.
Proces transmisji ramki Ethernet we wspólnym medium składa się z kilku precyzyjnie zdefiniowanych faz.
Po otrzymaniu danych z warstwy sieciowej kontroler MAC karty sieciowej formuje ramkę, dodając adresy MAC źródła i celu, pole EtherType (0x0800 dla IPv4, 0x0806 dla ARP) oraz sekwencję FCS (Frame Check Sequence) obliczaną algorytmem CRC-32.
Ramka jest buforowana w pamięci karty i przygotowywana do transmisji na medium.
Przed rozpoczęciem nadawania karta implementuje mechanizm Carrier Sense, nasłuchując aktywności na kablu przez okres czasu odpowiadający czasowi propagacji sygnału.
Jeśli medium jest zajęte, karta czeka na zakończenie transmisji i dodatkowy czas międzyramkowy Inter-Packet Gap (IPG) wynoszący 96 bitów, co dla Ethernetu 10 Mbps odpowiada 9,6 mikrosekundy.
Po zwolnieniu medium karta rozpoczyna transmisję od preambuły (7 bajtów naprzemiennych bitów 10101010) i ogranicznika początku ramki SFD (10101011), które służą synchronizacji zegara odbiornika.
W trakcie nadawania karta nieprzerwanie monitoruje sygnał na medium, porównując nadawane bity z odbieranymi.
Wykrycie rozbieżności oznacza kolizję, w odpowiedzi na którą karta przerywa nadawanie i transmituje 32-bitowy sygnał JAM, aby upewnić się, że wszystkie stacje w domenie kolizyjnej wykryły kolizję.
Po stronie odbiorczej karta sieciowa weryfikuje sumę FCS, sprawdza adres docelowy i przy zgodności przekazuje ramkę przez magistralę PCI Express do pamięci systemowej, generując przerwanie do sterownika karty sieciowej.
Segment sieci to fizycznie lub logicznie wydzielona część sieci.
W Ethernecie współdzielonym segment oznacza pojedynczy kabel koncentryczny wraz ze wszystkimi podłączonymi do niego stacjami.
Segment może być ograniczony przez repeatery, mosty lub przełączniki.
Segment sieci w kontekście Ethernetu współdzielonego to fizycznie wydzielona część sieci, w której wszystkie urządzenia współdzielą to samo medium transmisyjne.
W standardzie 10BASE2 segment stanowi pojedynczy odcinek kabla koncentrycznego RG-58 o maksymalnej długości 185 metrów, do którego podłączonych może być maksymalnie 30 stacji za pomocą złączy BNC w układzie T.
Wszystkie stacje w takim segmencie tworzą jedną domenę kolizyjną, co oznacza, że w danej chwili tylko jedna może transmitować dane bez ryzyka kolizji.
Standard IEEE 802.3 definiuje ścisłe ograniczenia dla poszczególnych typów segmentów.
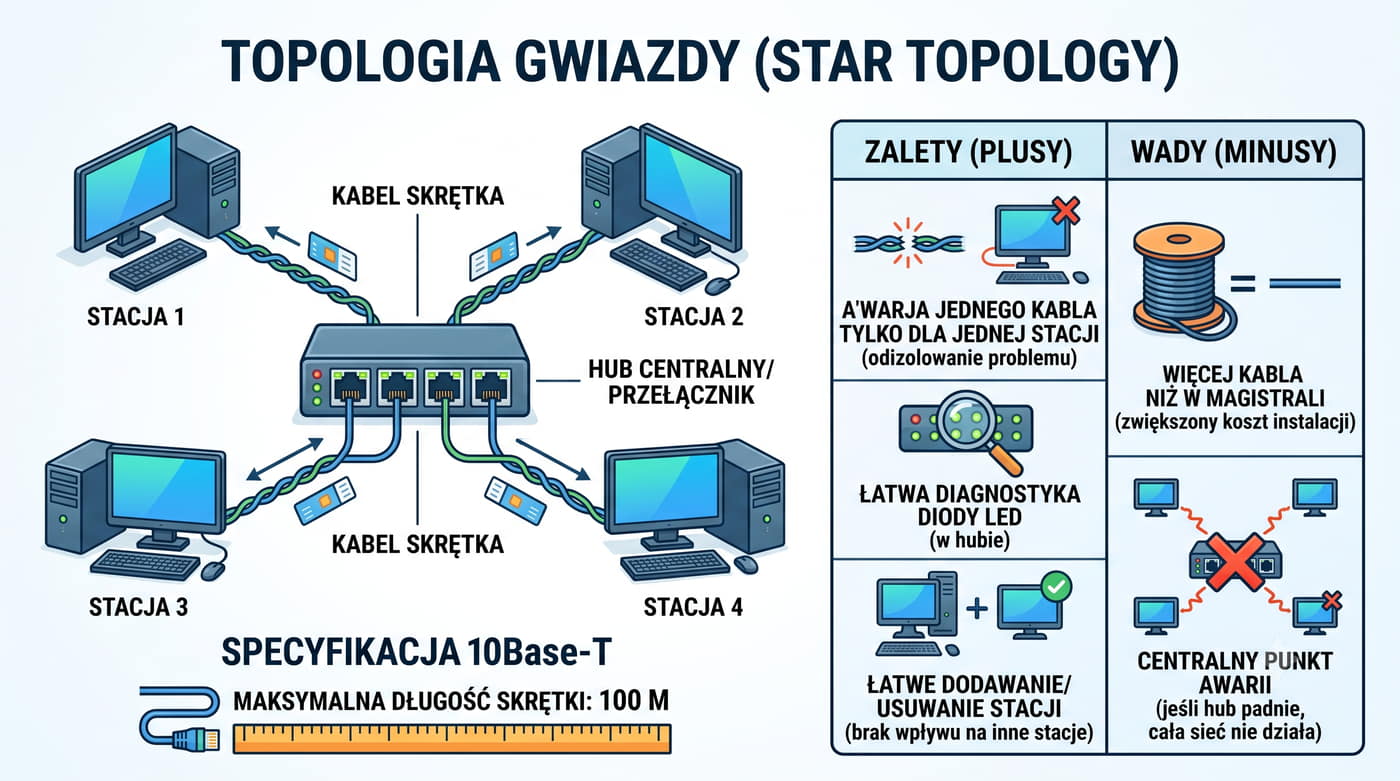
Dla 10BASE5 maksymalna długość wynosi 500 metrów przy maksymalnie 100 stacjach, dla 10BASE2 odpowiednio 185 metrów i 30 stacji, a dla 10BASE-T maksymalna długość skrętki to 100 metrów przy jednej stacji na port huba.
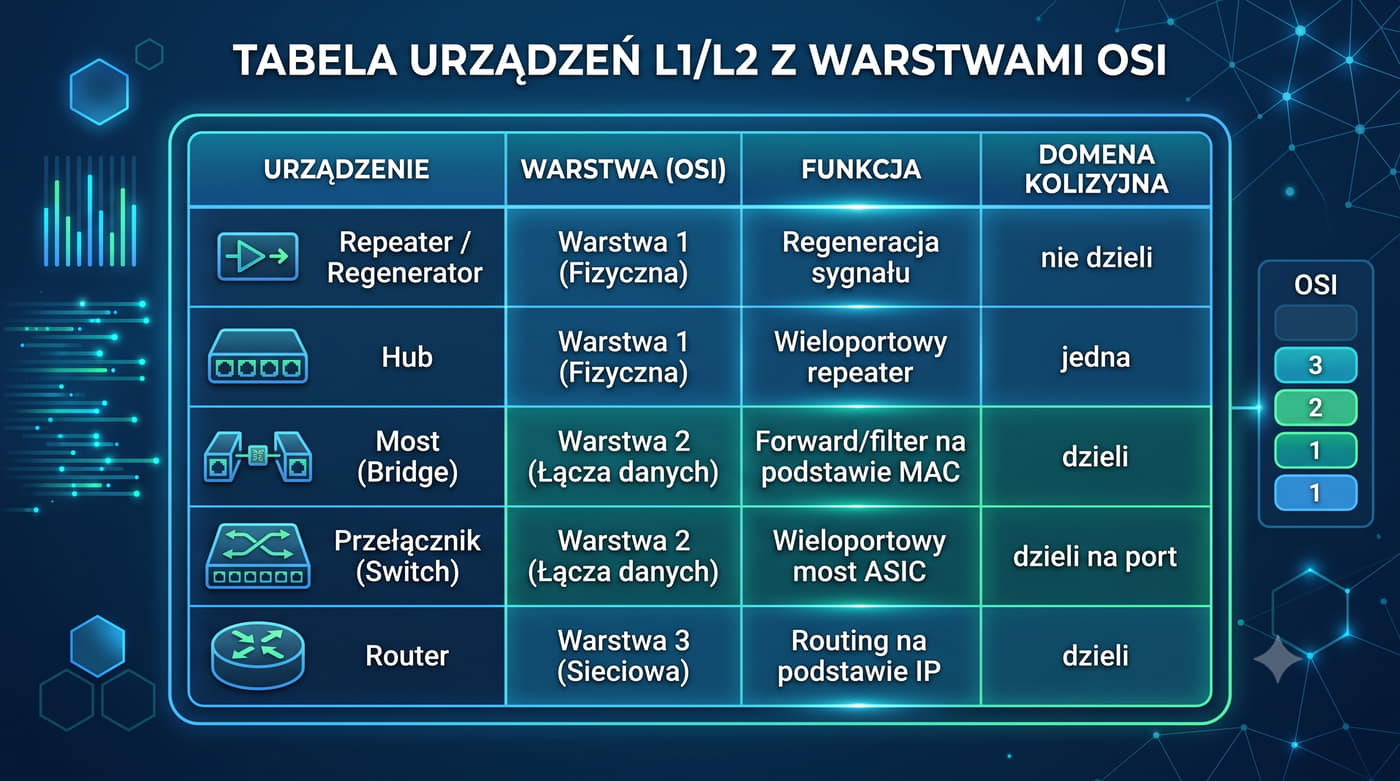
Segmenty mogą być łączone repeaterami, które regenerują sygnał i wydłużają zasięg sieci, ale nie dzielą domeny kolizyjnej – połączone segmenty wciąż stanowią jedną domenę kolizyjną.
Przełomem w architekturze sieci było wprowadzenie mostów (bridge), a później przełączników (switch), które izolują domeny kolizyjne na każdym porcie, umożliwiając jednoczesną transmisję między wieloma parami stacji.
Współcześnie termin segment sieci jest używany przede wszystkim w znaczeniu logicznym, odnosząc się do podsieci IP lub sieci VLAN.
Zrozumienie fizycznego znaczenia segmentu jest jednak niezbędne do prawidłowego projektowania sieci i diagnozowania problemów związanych z propagacją sygnału i kolizjami.
Wspólne medium transmisyjne ma zarówno zalety, jak i wady.
Do zalet należą: prostota konstrukcji, niski koszt (jeden kabel zamiast wielu), łatwość dodania nowej stacji (wystarczy wpiąć się w szynę).
Wady są jednak znaczące: kolizje przy jednoczesnym nadawaniu, ograniczona przepustowość dzielona między wszystkie stacje, brak izolacji między urządzeniami oraz problemy z bezpieczeństwem (każda stacja może potencjalnie przechwytywać ruch innych).
Wspólne medium transmisyjne w postaci kabla koncentrycznego miało niewątpliwe zalety, które zadecydowały o gwałtownym rozwoju Ethernetu w latach osiemdziesiątych.
Niski koszt instalacji – jeden kabel koncentryczny mógł obsłużyć do 30 stacji w standardzie 10BASE2 – oraz prostota topologii magistrali sprawiały, że sieć można było wdrożyć szybko, bez konieczności zakupu drogich urządzeń centralnych.
Dodawanie nowej stacji polegało na wpięciu złącza BNC T w dowolnym miejscu kabla bez przerywania pracy pozostałych urządzeń, co było ogromną zaletą w dynamicznie rozwijających się firmach.
Kolizje przy jednoczesnych transmisjach powodowały, że rzeczywista przepustowość sieci przy obciążeniu przekraczającym 30–40% nominalnej szybkości spadała dramatycznie z powodu retransmisji i algorytmu backoff.
W praktyce oznaczało to, że w segmencie 10 Mbps z 30 aktywnymi stacjami średnia przepustowość na stację wynosiła poniżej 0,3 Mbps.
Dodatkowo awaria jednej karty sieciowej w trybie generowania ciągłych ramek mogła zablokować cały segment.
Każda stacja w segmencie mogła włączyć tryb promiscuous i przechwytywać cały ruch sieciowy, w tym hasła i dane poufne transmitowane w otwartym tekście.
Te fundamentalne ograniczenia wydajnościowe i bezpieczeństwa doprowadziły do powstania przełączników Ethernet, które zrewolucjonizowały architekturę sieci lokalnych, tworząc dedykowane domeny kolizyjne na każdym porcie i umożliwiając pracę w trybie full-duplex.
Broadcasty są niezbędne do komunikacji typu jeden do wszystkich.
Najczęściej spotykane zastosowania to zapytania ARP ("kto ma adres IP 192.168.1.20?"), DHCP Discover (poszukiwanie serwera DHCP) oraz protokoły routingu.
Przy dużej liczbie hostów (setki lub tysiące) broadcasty stanowią znaczący narzut obliczeniowy.
Dlatego projektanci sieci starają się ograniczać rozmiar domen rozgłoszeniowych, stosując routery lub VLAN-y.
Celem rozgłoszeń (broadcastów) w sieci Ethernet jest dostarczenie tej samej informacji do wszystkich urządzeń w danym segmencie sieci, co jest realizowane przez ustawienie docelowego adresu MAC na wartość FF:FF:FF:FF:FF:FF.
Każda karta sieciowa odbiera i przekazuje taką ramkę do systemu operacyjnego, ponieważ adres broadcast jest rozpoznawany sprzętowo przez kontroler MAC jako adres, który zawsze ma być przyjęty.
Ten mechanizm jest niezbędny dla działania protokołów, które muszą odnaleźć adresata bez wcześniejszej znajomości jego adresu MAC.
Podstawowym protokołem korzystającym z broadcastów jest ARP, który rozgłasza zapytanie o adres MAC odpowiadający danemu adresowi IP.
Kolejnym ważnym zastosowaniem jest protokół DHCP, gdzie klient wysyła broadcast DHCP Discover w poszukiwaniu serwera DHCP, nie znając jego adresu IP ani MAC.
Protokoły routingu dynamicznego, takie jak RIPv1, również wykorzystują rozgłoszenia do okresowej wymiany tablic routingu między sąsiednimi routerami.
Każdy z tych broadcastów jest jednak przetwarzany przez wszystkie hosty w segmencie, nawet jeśli ich nie dotyczy.
Każdy broadcast wymusza przerwanie sprzętowe na procesorze hosta i przekazanie ramki przez cały stos sieciowy aż do warstwy aplikacji, co przy częstotliwości setek broadcastów na sekundę może doprowadzić do 100% obciążenia procesora.
Aby ograniczyć ten problem, stosuje się podział sieci na mniejsze domeny rozgłoszeniowe za pomocą routerów, które domyślnie blokują propagację broadcastów, lub poprzez konfigurację VLAN na przełącznikach, co umożliwia logiczną izolację domen rozgłoszeniowych.
Kolizja w sieci Ethernet występuje, gdy dwie lub więcej stacji rozpoczyna nadawanie w tym samym czasie.
Sygnały elektryczne nakładają się na siebie, powodując uszkodzenie ramek wszystkich nadających stacji.
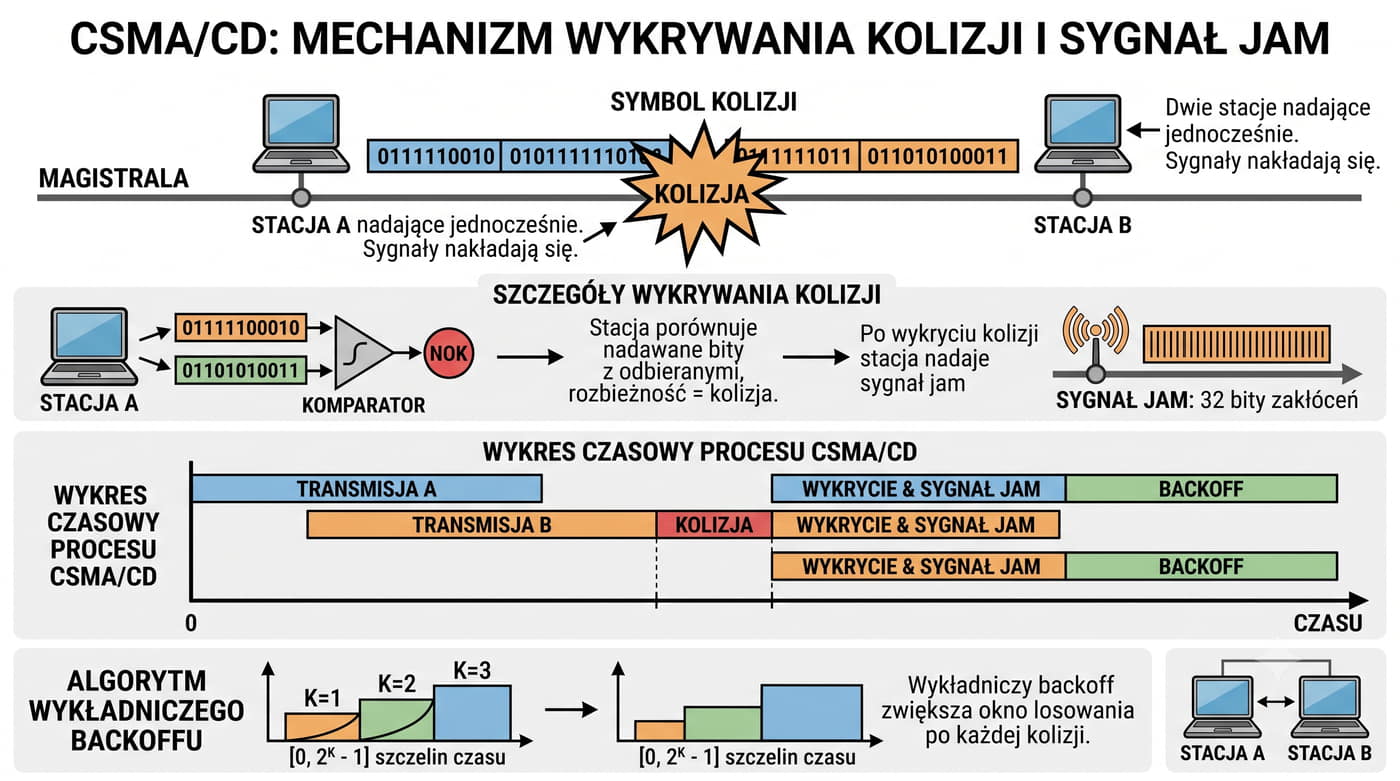
Wykrycie kolizji polega na tym, że stacja nadaje i jednocześnie nasłuchuje sygnału na kablu.
Porównuje wysłane bity z odebranymi – w przypadku rozbieżności oznacza to kolizję.
Po wykryciu kolizji stacja nadaje sygnał JAM (32 bity zakłóceń), aby upewnić się, że wszystkie inne stacje również wykryją kolizję.
Kolizja w sieci Ethernet jest naturalnym zjawiskiem w modelu współdzielonego medium, do którego dochodzi, gdy co najmniej dwie stacje rozpoczną nadawanie w odstępie czasu krótszym niż czas propagacji sygnału między nimi.
W efekcie nakładające się sygnały elektryczne powodują zniekształcenie ramek wszystkich uczestniczących nadawców, uniemożliwiając ich poprawne odebranie.
Prawdopodobieństwo kolizji rośnie wraz z liczbą aktywnych stacji w segmencie oraz z długością medium transmisyjnego, ponieważ dłuższy czas propagacji zwiększa okno podatności na kolizje.
Mechanizm wykrywania kolizji (Collision Detection) opiera się na zasadzie nasłuchu podczas nadawania.
Karta sieciowa porównuje bieżący stan nadawanego sygnału z sygnałem odbieranym z medium – każda rozbieżność jest interpretowana jako kolizja.
Po jej wykryciu karta natychmiast transmituje 32-bitowy sygnał JAM składający się z samych logicznych jedynek (111111...), który celowo narusza kodowanie Manchester, aby zagwarantować, że wszystkie stacje w domenie kolizyjnej wykryją zajście kolizji.
Po zakończeniu sygnału JAM stacja przerywa nadawanie uszkodzonej ramki.
Po wykryciu kolizji stacja wchodzi w fazę wykładniczego opóźniania (truncated binary exponential backoff).
Stacja losuje liczbę całkowitą k z zakresu od 0 do 2^n - 1, gdzie n to numer kolejnej próby retransmisji (maksymalnie 10), a następnie odczekuje k jednostek slot time (512 bitów dla Ethernetu 10 Mbps) przed ponowną próbą transmisji.
Po 16 nieudanych próbach stacja odrzuca ramkę i raportuje błąd do protokołu wyższej warstwy.
Ten algorytm zapewnia sprawiedliwy rozkład szans dostępu do medium, ale przy dużym obciążeniu czas bezproduktywnego oczekiwania wydłuża się wykładniczo, a przepustowość użyteczna dramatycznie spada.
CSMA/CD (Carrier Sense Multiple Access with Collision Detection) to protokół dostępu do współdzielonego medium w Ethernet.
Składa się z kilku etapów: Carrier Sense (nasłuch przed nadawaniem i w trakcie), Multiple Access (wiele stacji na wspólnym medium), Collision Detection (wykrywanie kolizji przez porównanie nadawanego z odbieranym).
Po wykryciu kolizji stosuje się algorytm backoff: stacja czeka losowy czas z zakresu [0, 2^k-1] slotów, gdzie k to numer próby, ograniczony do wartości maksymalnej 10 (zakres nie rośnie już dalej aż do 16. próby).
Po 16 nieudanych próbach generowany jest błąd dla wyższych warstw.
Mechanizm ten zapobiega ciągłym kolizjom przy dużym obciążeniu sieci.
Protokół CSMA/CD składa się z czterech ściśle określonych faz, które realizują dostęp do współdzielonego medium bez centralnego koordynatora.
Faza Carrier Sense polega na nasłuchiwaniu nośnej na kablu przed rozpoczęciem transmisji.
Stacja odczekuje czas międzyramkowy Inter-Packet Gap (IPG) wynoszący 96 bitów, co dla Ethernetu 10 Mbps stanowi 9,6 mikrosekundy, a następnie sprawdza, czy medium jest wolne.
Jeśli inna stacja transmituje, karta kontynuuje nasłuch aż do momentu zwolnienia medium i ponownie odczekuje IPG.
Multiple Access oznacza, że wszystkie stacje w segmencie mają równe prawa do rozpoczynania transmisji, co eliminuje potrzebę istnienia centralnego koordynatora dostępu.
W fazie Collision Detection nadawca nieprzerwanie monitoruje sygnał na kablu, porównując nadawane bity z odbieranymi.
Każda rozbieżność jest natychmiast interpretowana jako kolizja, co powoduje przerwanie transmisji i wysłanie 32-bitowego sygnału JAM.
Długość sygnału JAM jest wystarczająca, aby dotarł do wszystkich stacji w domenie kolizyjnej, nawet tych znajdujących się w maksymalnej odległości.
Algorytm wykładniczego backoff stanowi kluczowy element stabilizujący protokół przy rosnącym obciążeniu.
Zakres losowania jest określony wzorem 2^k - 1, gdzie k oznacza numer kolejnej próby retransmisji, nie większy niż 10.
Oznacza to, że przy pierwszej kolizji stacja losuje z zakresu 0–1 (2^1-1), przy drugiej 0–3 (2^2-1), przy trzeciej 0–7 (2^3-1) i tak dalej, aż do maksymalnego zakresu 0–1023 (2^10-1).
Po 10 próbach zakres pozostaje stały na poziomie 1023 slotów aż do 16. próby, po której stacja odrzuca ramkę i raportuje błąd do protokołu wyższej warstwy.
Taka konstrukcja zapewnia sprawiedliwy rozkład szans dostępu do medium i zapobiega zjawisku zagłodzenia którejkolwiek stacji.
Domena kolizyjna to zbiór urządzeń sieciowych, których transmisje mogą ze sobą kolidować.
Jeśli dowolne dwa urządzenia w tej samej domenie kolizyjnej nadadzą jednocześnie, dojdzie do kolizji.
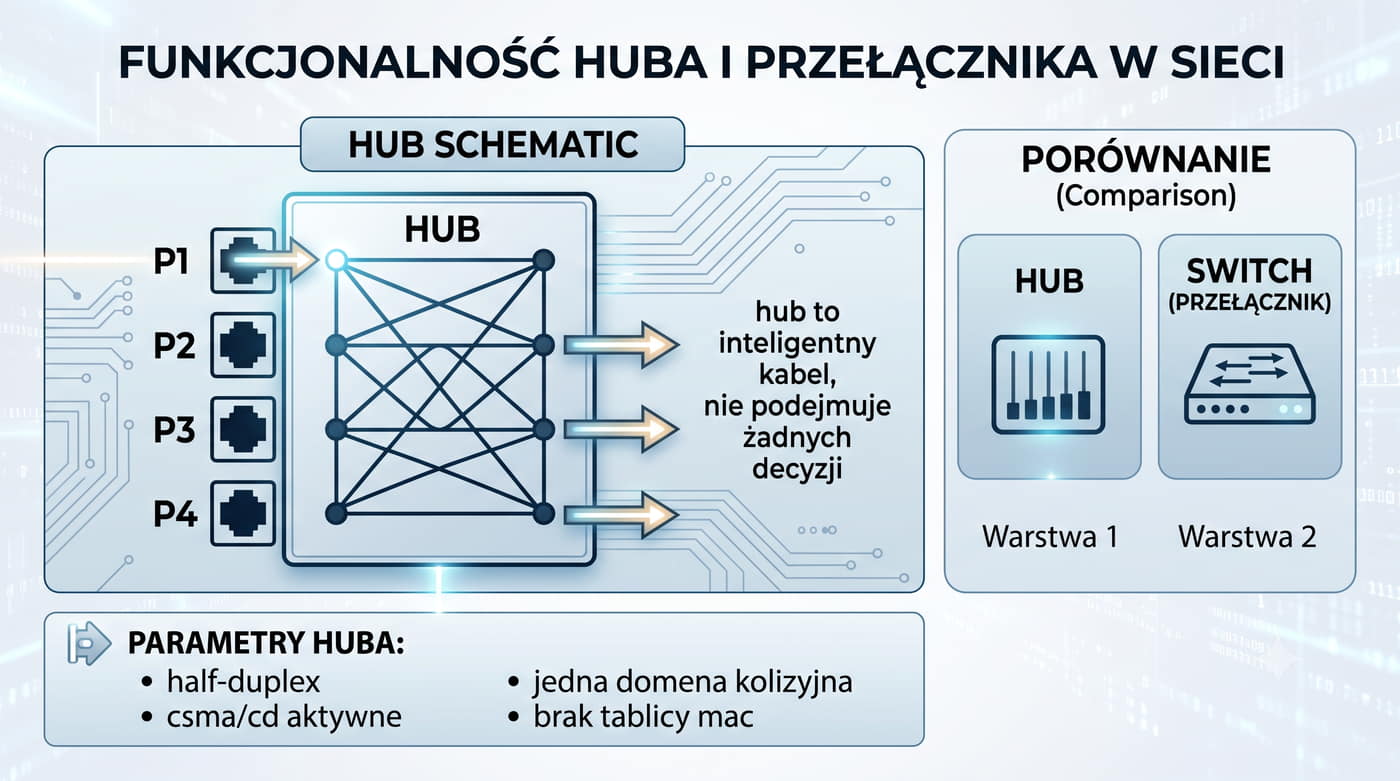
W sieci z hubem (koncentratorem) wszystkie porty należą do jednej domeny kolizyjnej – cała sieć to jedna wielka domena.
W sieci z przełącznikiem (switchem) każdy port stanowi oddzielną, izolowaną domenę kolizyjną, co eliminuje kolizje.
W praktyce rozmiar domeny kolizyjnej determinuje maksymalną średnicę sieci, ponieważ czas propagacji sygnału od jednego końca domeny do drugiego musi być krótszy niż minimalny czas transmisji ramki (slot time) wynoszący 512 bitów.
Dla Ethernetu 10 Mbps slot time wynosi 51,2 mikrosekundy, co przy prędkości propagacji sygnału w kablu koncentrycznym wynoszącej około 0,77c ogranicza maksymalną średnicę sieci do około 2500 metrów przy zastosowaniu czterech repeaterów.
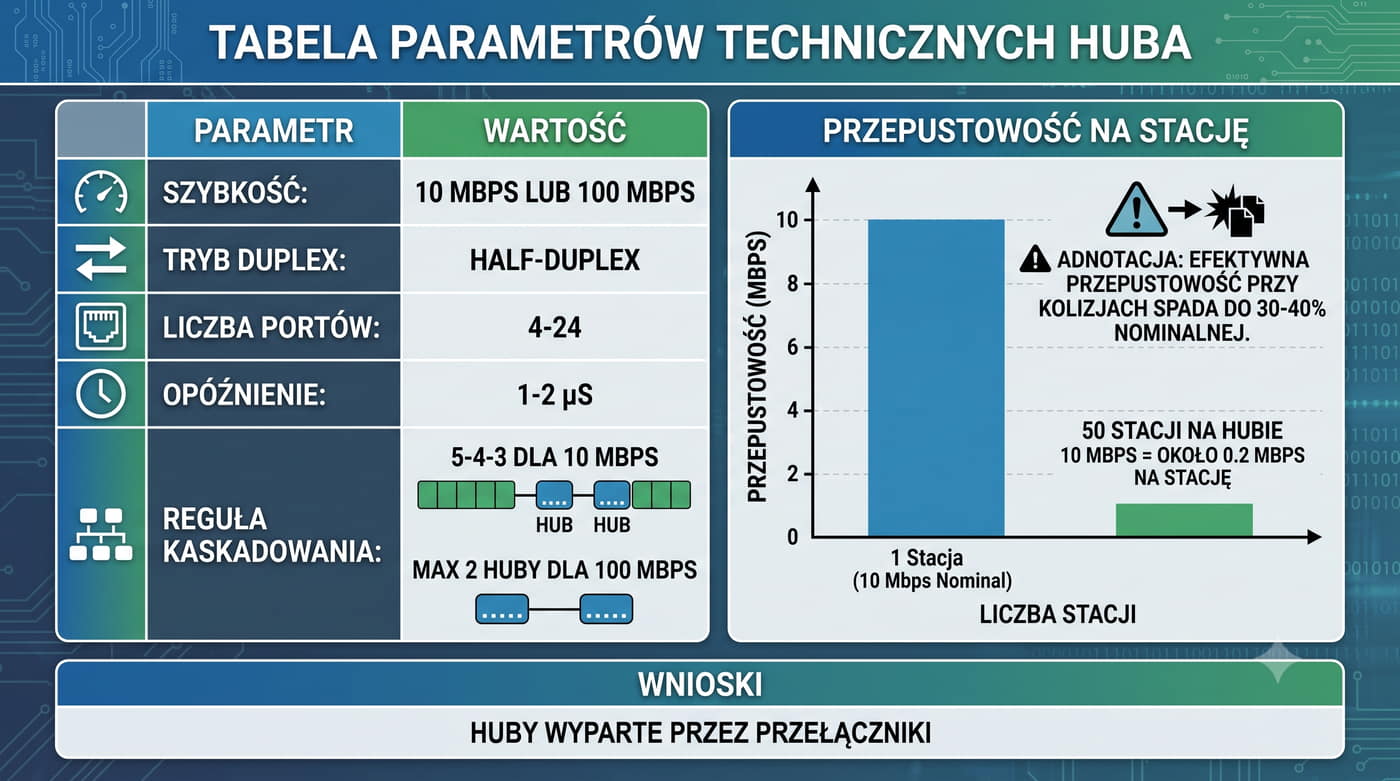
W sieci opartej na hubie wszystkie porty współdzielą jedną domenę kolizyjną, co oznacza, że przepustowość jest dzielona liniowo między wszystkie aktywne stacje.
W sieci 10 Mbps z dziesięcioma aktywnymi stacjami średnia przepustowość na stację wynosi zaledwie około 1 Mbps, a przy uwzględnieniu retransmisji po kolizjach wartość ta spada do 30–40% nominalnej przepustowości.
Oznacza to, że w praktyce sieć 10 Mbps z 30 stacjami oferuje zaledwie około 0,1–0,15 Mbps na stację przy ciągłej transmisji.
Przełącznik Ethernet diametralnie zmienia tę zależność, tworząc na każdym porcie osobną domenę kolizyjną.
Stacje podłączone do różnych portów mogą transmitować jednocześnie bez zakłóceń, a całkowita przepustowość przełącznika jest sumą przepustowości wszystkich portów.
Dodatkowo przełączniki obsługują tryb full-duplex, który całkowicie eliminuje kolizje poprzez jednoczesne nadawanie i odbiór na dwóch oddzielnych parach przewodów w skrętce.
W nowoczesnych sieciach przełączanych kolizje praktycznie nie występują, chyba że wystąpi uszkodzenie okablowania lub nieprawidłowa konfiguracja trybu duplex.
Domena rozgłoszeniowa (broadcast domain) to zbiór urządzeń, które odbierają ramki broadcast wysłane przez dowolne urządzenie w tej domenie.
W sieci z hubem wszystkie stacje są w jednej domenie rozgłoszeniowej.
Przełącznik (nawet nowoczesny) nie dzieli domen rozgłoszeniowych – wszystkie porty przełącznika należą do jednej domeny, chyba że zastosowano VLAN-y.
Router blokuje broadcasty – jest to naturalna granica domeny rozgłoszeniowej.
Domena rozgłoszeniowa (broadcast domain) różni się fundamentalnie od domeny kolizyjnej – nie jest związana z ryzykiem fizycznej kolizji sygnałów, lecz z zasięgiem propagacji ramek broadcast w sieci.
W sieci Ethernet adres broadcast FF:FF:FF:FF:FF:FF jest rozpoznawany sprzętowo przez każdą kartę sieciową jako adres, który zawsze ma być przyjęty.
Przełącznik Ethernet, mimo że izoluje domeny kolizyjne na każdym porcie, nie dzieli domeny rozgłoszeniowej.
Ramki broadcast są domyślnie przekazywane na wszystkie porty przełącznika z wyjątkiem portu źródłowego.
Oznacza to, że w sieci złożonej z wielu przełączników połączonych kaskadowo wszystkie urządzenia znajdują się w jednej domenie rozgłoszeniowej.
W praktyce oznacza to, że broadcast ARP wysłany przez dowolny host w sieci korporacyjnej dotrze do wszystkich tysięcy urządzeń, co przy dużej skali generuje znaczący narzut obliczeniowy.
Naturalną granicą domeny rozgłoszeniowej jest router, który domyślnie nie przekazuje ramek broadcast między swoimi interfejsami.
Technologia VLAN (Virtual LAN) umożliwia tworzenie wielu izolowanych domen rozgłoszeniowych w ramach jednego przełącznika fizycznego.
Każdy VLAN stanowi odrębną domenę rozgłoszeniową, a ruch między VLAN-ami wymaga routingu przez warstwę 3.
Blok czwarty integruje zagadnienia związane z rodzajami ruchu sieciowego oraz koncepcją domen kolizyjnych i rozgłoszeniowych.
Unicast zapewnia bezpośrednią komunikację między dwoma urządzeniami, broadcast umożliwia transmisję do wszystkich hostów w segmencie, a multicast optymalizuje wykorzystanie pasma poprzez kierowanie danych wyłącznie do wybranej grupy odbiorców.
Protokół CSMA/CD z wykładniczym algorytmem backoff zapewnia zdecentralizowany, sprawiedliwy dostęp do medium, jednak jego wydajność gwałtownie spada przy obciążeniu przekraczającym około 30–40% nominalnej przepustowości.
Dzieje się tak, ponieważ wraz ze wzrostem liczby kolizji wydłuża się czas oczekiwania w algorytmie backoff, a stacje spędzają coraz więcej czasu na bezproduktywnym oczekiwaniu.
To podstawowe ograniczenie Ethernetu współdzielonego było głównym motorem rozwoju technologii przełączanej.
Domena kolizyjna i domena rozgłoszeniowa to dwa odrębne pojęcia, których pomylenie może prowadzić do błędnych decyzji projektowych.
Hub utrzymuje jedną domenę kolizyjną i jedną rozgłoszeniową.
Przełącznik dzieli domeny kolizyjne na poszczególne porty, ale nie ingeruje w domenę rozgłoszeniową bez konfiguracji VLAN.
Router jest jedynym urządzeniem, które domyślnie dzieli zarówno domeny kolizyjne, jak i rozgłoszeniowe, co czyni go naturalnym narzędziem segmentacji sieci.
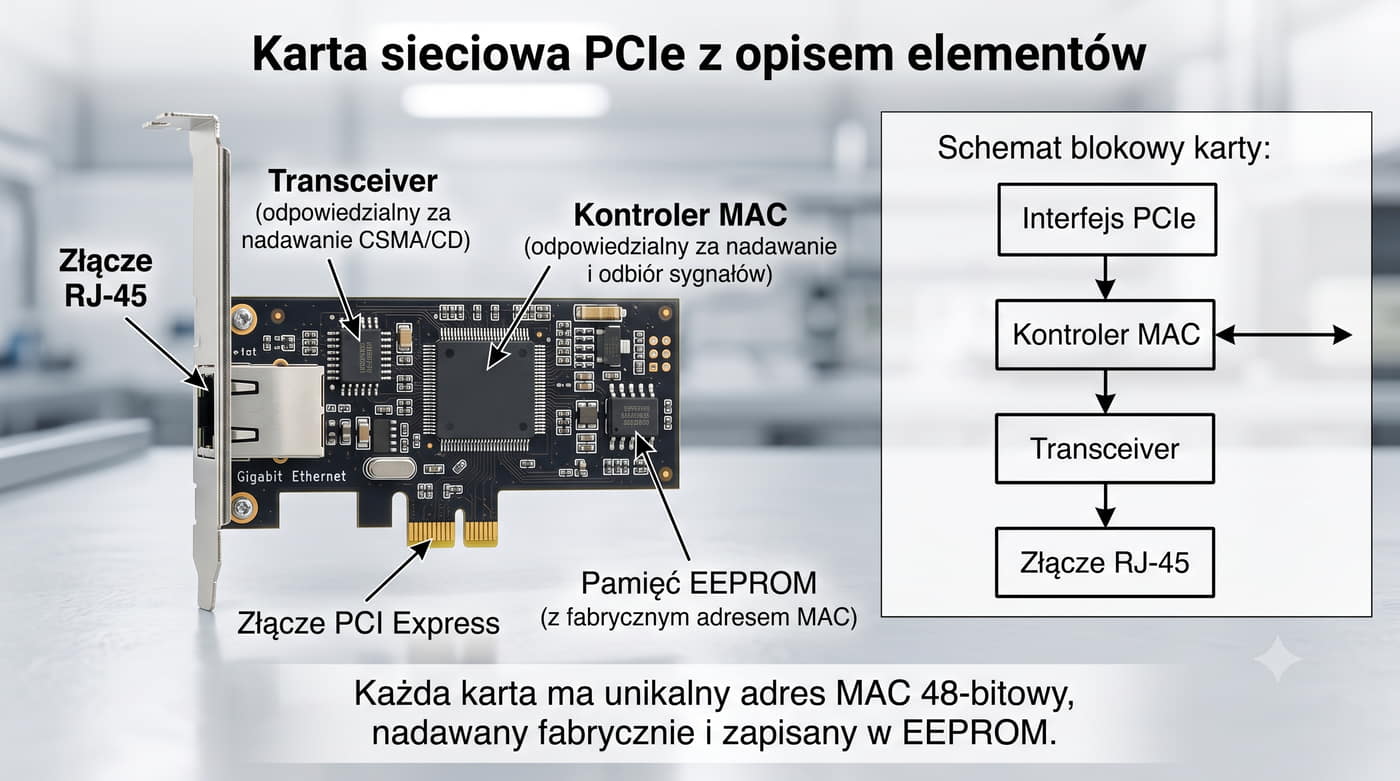
Karta sieciowa (NIC) to urządzenie stanowiące interfejs między komputerem a medium sieciowym.
Główne elementy to: kontroler MAC (realizujący protokół CSMA/CD), transceiver (odpowiedzialny za nadawanie i odbiór sygnałów), złącze fizyczne (RJ-45, BNC, AUI) oraz pamięć EEPROM z fabrycznie zapisanym adresem MAC.
Karta sieciowa NIC (Network Interface Card) jest kluczowym elementem każdego urządzenia końcowego, odpowiedzialnym za przygotowanie danych do transmisji oraz odbiór ramek z medium.
Centralnym układem karty jest kontroler MAC (Media Access Control), który implementuje w sprzęcie cały protokół CSMA/CD obejmujący nasłuch nośnej, wykrywanie kolizji, generowanie sygnału JAM oraz algorytm wykładniczego backoff.
Odciążenie procesora głównego od tych zadań jest krytyczne dla wydajności systemu, ponieważ obsługa kolizji w oprogramowaniu byłaby zbyt wolna i obciążająca.
Transceiver, zintegrowany z kontrolerem MAC w nowoczesnych kartach lub wykonany jako osobny układ w starszych konstrukcjach, odpowiada za konwersję sygnału cyfrowego na analogowy i odwrotnie, a także za izolację galwaniczną między komputerem a medium sieciowym.
Współczesne karty sieciowe oferują zaawansowane funkcje odciążania (offload), takie jak sprzętowe obliczanie sum kontrolnych TCP i UDP (TCP/IP Checksum Offload), co znacząco redukuje obciążenie procesora podczas intensywnej transmisji danych.
Karty serwerowe obsługują również Large Send Offload (LSO) i Large Receive Offload (LRO), które zmniejszają liczbę przerwań generowanych przez kartę.
Pamięć EEPROM na karcie przechowuje nie tylko 48-bitowy adres MAC, ale również parametry konfiguracyjne, takie jak ustawienia zarządzania energią Wake-on-LAN (WoL), które umożliwiają zdalne włączanie komputera przez wysłanie specjalnej ramki magic packet.
W nowoczesnych kartach serwerowych stosuje się interfejs PCI Express (PCIe), zwykle w konfiguracji x8 lub x16 – dla szybkości 40 Gbps wystarcza PCIe 3.0 x8, natomiast 100 Gbps wymaga już PCIe 3.0 x16 lub PCIe 4.0 x8.
Technologia SR-IOV (Single Root I/O Virtualization) umożliwia bezpośrednie mapowanie funkcji karty do maszyn wirtualnych w środowiskach wirtualizacyjnych, eliminując narzut związany z emulacją urządzeń sieciowych.
Repeater (wzmacniak) to urządzenie działające w warstwie fizycznej (warstwa 1) modelu OSI.
Jego podstawową funkcją jest regeneracja sygnału elektrycznego lub optycznego – wzmacnia go, odtwarza kształt przebiegu (reshaping) i przywraca prawidłowy timing (retiming).
Repeater pozwala przedłużyć zasięg segmentu sieci.
Nie przetwarza ramek ani nie podejmuje decyzji – działa wyłącznie na poziomie bitów.
W Ethernet 10BASE5 maksymalna długość pojedynczego segmentu wynosiła 500 m, a z repeaterem można było osiągnąć do 2500 m.
Repeater jest najprostszym aktywnym urządzeniem sieciowym, działającym wyłącznie w warstwie fizycznej modelu OSI, co oznacza, że nie dokonuje żadnej analizy przesyłanych danych, adresów MAC ani ramek.
Jego jedynym zadaniem jest regeneracja sygnału elektrycznego, który ulega tłumieniu i zniekształceniom podczas propagacji w kablu.
Proces regeneracji obejmuje trzy podstawowe operacje: wzmocnienie amplitudy sygnału (amplification), odtworzenie kształtu przebiegu (reshaping) oraz przywrócenie prawidłowego taktowania zegarowego (retiming).
Zastosowanie repeatera pozwala przedłużyć maksymalny zasięg segmentu sieci.
W standardzie 10BASE5 pojedynczy segment ma maksymalnie 500 metrów, a z zastosowaniem repeaterów można osiągnąć do 2500 metrów zgodnie z regułą 5-4-3.
Pozostałe dwa segmenty służą wyłącznie do połączenia między repeaterami (link segments) i nie mogą zawierać stacji.
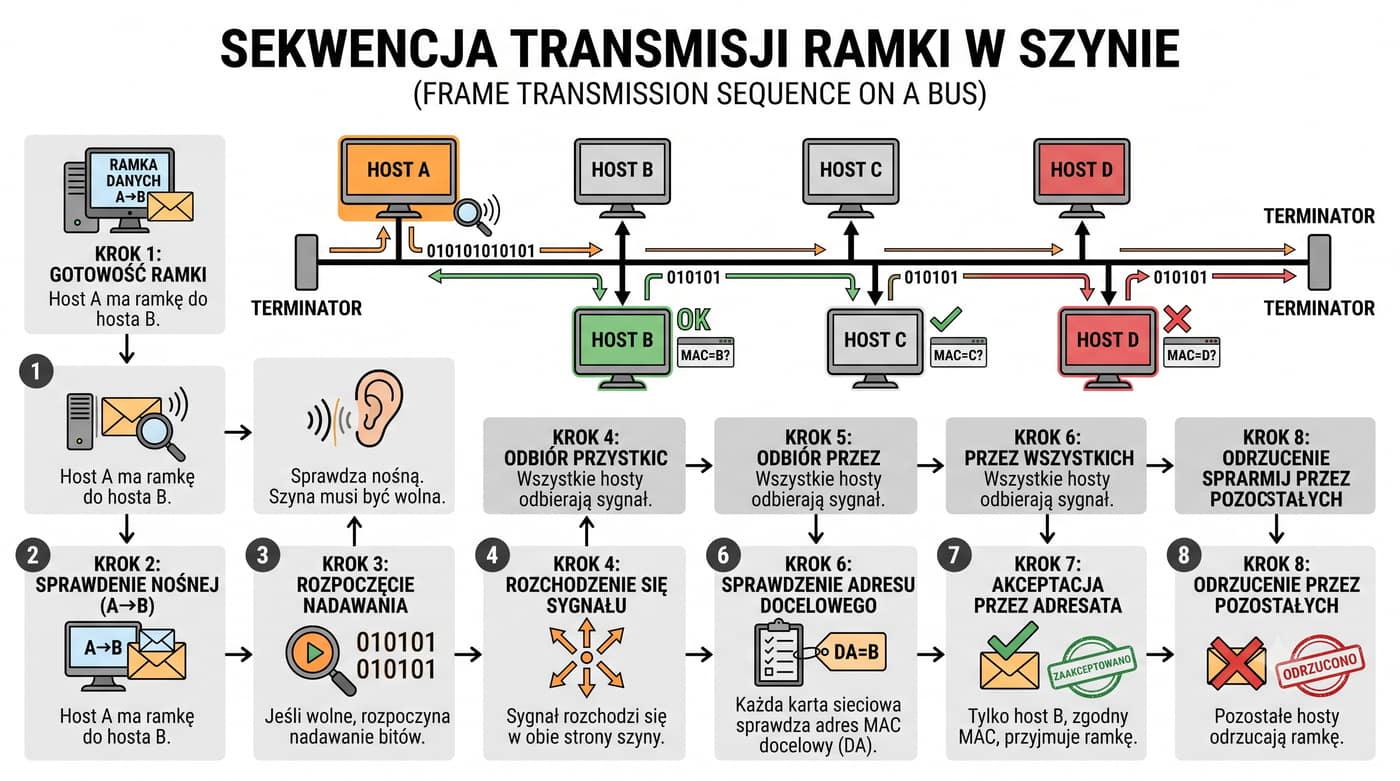
Należy podkreślić, że repeater nie dzieli domeny kolizyjnej – każdy odebrany sygnał jest natychmiast regenerowany i przesyłany dalej, bez buforowania ani analizy.
Opóźnienie propagacyjne pojedynczego repeatera wynosi około 1–2 mikrosekund, co przy kaskadowym łączeniu czterech urządzeń może znacząco wpłynąć na maksymalną średnicę sieci.
Mimo że klasyczne repeatery są dziś rzadkością, ich funkcjonalność jest wbudowana w każdy hub i przełącznik – każdy port nowoczesnego przełącznika zawiera układ regeneracji sygnału, który odtwarza przebieg przed retransmisją.
Regenerator to bardziej zaawansowana wersja repeatera.
Odtwarza nie tylko amplitudę sygnału, ale także jego pełny kształt przebiegu i timing zegarowy.
W sieciach światłowodowych stosuje się regeneratory optyczne, które konwertują sygnał optyczny na elektryczny, odtwarzają go i ponownie zamieniają na optyczny.
Różnica między repeaterem a regeneratorem polega na stopniu odtworzenia sygnału.
Repeater wzmacnia i częściowo odtwarza, podczas gdy regenerator wykonuje pełną rekonstrukcję sygnału, eliminując szumy i zniekształcenia nagromadzone na drodze transmisji.
Regenerator stanowi bardziej zaawansowaną wersję repeatera, realizującą pełną rekonstrukcję sygnału według standardu 3R: Reamplification (ponowne wzmocnienie), Reshaping (odtworzenie kształtu przebiegu) oraz Retiming (przywrócenie taktowania zegarowego).
Podczas gdy prosty repeater wzmacnia amplitudę sygnału wraz z zakłóceniami, regenerator odtwarza od nowa cały przebieg czasowy, eliminując szumy i zniekształcenia nagromadzone na drodze transmisji.
Różnica ta jest szczególnie istotna w sieciach o dużych odległościach, gdzie kumulacja szumów może uniemożliwić poprawną dekodację sygnału.
W sieciach światłowodowych proces regeneracji wymaga konwersji sygnału optycznego na elektryczny (O/E), przeprowadzenia pełnej rekonstrukcji 3R w układach elektronicznych, a następnie ponownej konwersji na postać optyczną (E/O).
Taka podwójna konwersja wprowadza dodatkowe opóźnienie rzędu mikrosekund, ale jest niezbędna do utrzymania jakości sygnału na dystansach kilkudziesięciu kilometrów w sieciach szkieletowych.
W nowoczesnych sieciach optycznych coraz częściej stosuje się regeneratory optyczne 3R zdolne do pracy z szybkościami 100 Gbps i wyższymi, które wykorzystują zaawansowane techniki modulacji, takie jak DP-QPSK czy 16-QAM.
W sieciach miedzianych Ethernet funkcje regeneracji sygnału są zintegrowane w układach transceiverów każdego portu przełącznika lub karty sieciowej.
Proces ten obejmuje korekcję zniekształceń powstałych na skutek tłumienia sygnału i przesłuchów (crosstalk) w skrętce miedzianej, realizowaną przez układy DSP (Digital Signal Processing).
Dzięki regeneracji możliwe jest zachowanie integralności danych na dystansie 100 metrów dla standardów 10BASE-T, 100BASE-TX i 1000BASE-T.
W standardzie 10GBASE-T odległość ta jest ograniczona do 55 metrów przy użyciu kabla kategorii 6 i do 100 metrów przy kategorii 6A ze względu na większe tłumienie sygnału przy wyższych częstotliwościach.
Zalety: prostota, mała ilość kabla. Wady: jedna awaria (przerwanie kabla) unieruchamia cały segment, trudna diagnostyka usterek.
W topologii magistrali (bus) wszystkie urządzenia są podłączone do jednej linii transmisyjnej – szyny.
Sygnał nadany przez jedną stację rozchodzi się w obie strony szyny, docierając do wszystkich pozostałych stacji.
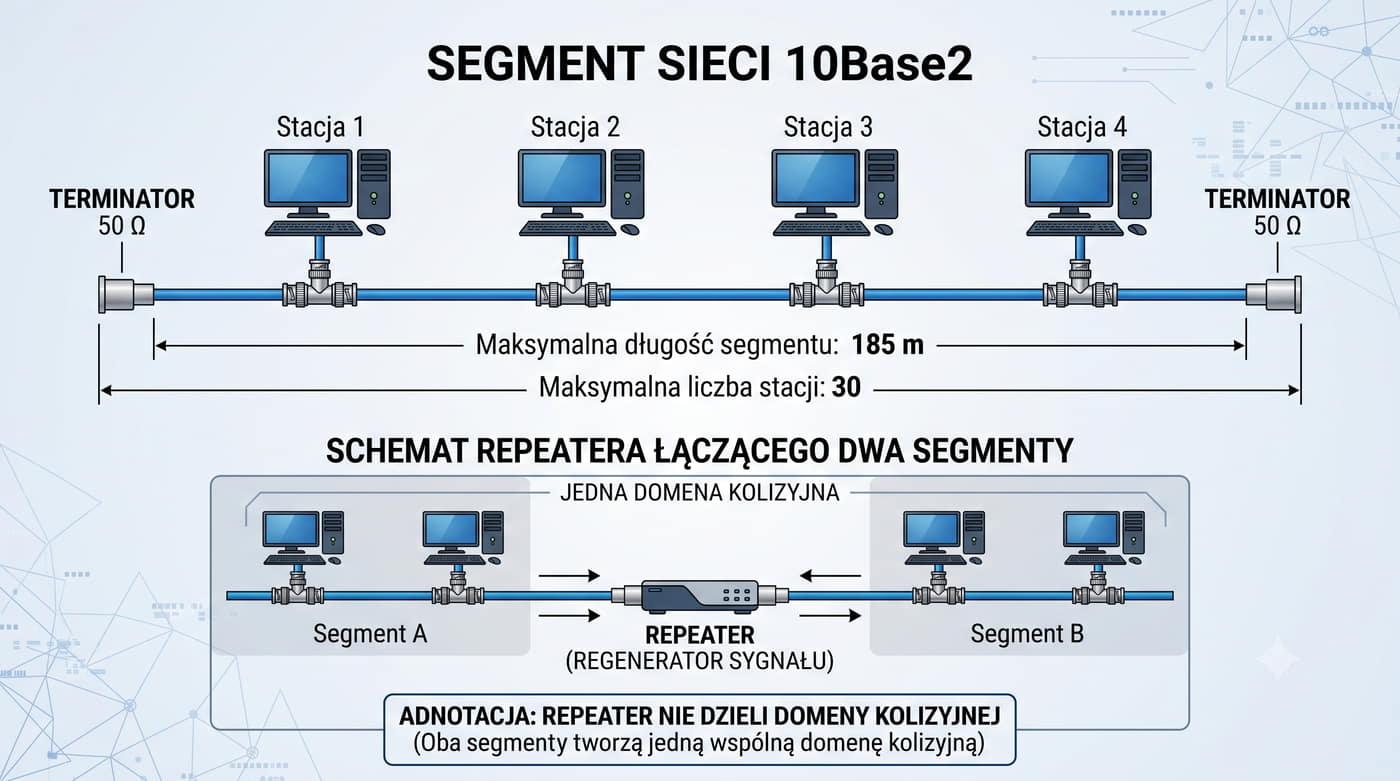
Na obu końcach szyny znajdują się terminatory, które pochłaniają sygnał i zapobiegają jego odbiciom.
Przykłady: 10BASE5 (gruby kabel koncentryczny, segment do 500 m) i 10BASE2 (cienki kabel koncentryczny, segment do 185 m).
Maksymalnie 30 stacji na segment dla 10BASE2.
Topologia magistrali (bus topology) była pierwszą topologią stosowaną w sieciach Ethernet, polegającą na podłączeniu wszystkich urządzeń do jednej linii transmisyjnej – kabla koncentrycznego.
Sygnał nadany przez dowolną stację rozchodzi się w obie strony szyny, docierając do wszystkich podłączonych urządzeń, co realizuje zasadę wspólnego medium transmisyjnego.
Na obu końcach kabla koncentrycznego muszą być zainstalowane terminatory o impedancji 50 omów, których zadaniem jest pochłanianie energii sygnału i zapobieganie jego odbiciom, które mogłyby powodować interferencje z nowymi transmisjami.
Standard 10BASE5 (Thick Ethernet) wykorzystywał gruby kabel koncentryczny RG-8 o średnicy około 10 mm, z maksymalną długością segmentu 500 metrów i maksymalnie 100 stacjami.
Standard 10BASE2 (Thin Ethernet) używał cieńszego i bardziej elastycznego kabla RG-58 o średnicy około 5 mm, z segmentem do 185 metrów i maksymalnie 30 stacjami.
Instalacja 10BASE2 była prostsza i tańsza dzięki złączom BNC, które umożliwiały szybkie łączenie odcinków kabla i podłączanie stacji za pomocą złączy T.
Najpoważniejszą wadą topologii magistrali była podatność na całkowitą awarię segmentu w przypadku przerwania kabla w dowolnym punkcie – uszkodzenie mechaniczne lub zwarcie unieruchamiało wszystkie stacje w segmencie.
Diagnostyka uszkodzeń wymagała specjalistycznych narzędzi pomiarowych, takich jak reflektometr TDR (Time Domain Reflectometer), który mierzy czas powrotu odbitego sygnału w celu zlokalizowania miejsca przerwania kabla.
Ponieważ wszystkie stacje współdzielą to samo pasmo, przepustowość dostępna dla pojedynczej stacji maleje liniowo wraz ze wzrostem liczby urządzeń, co przy 30 stacjach na segmencie 10 Mbps daje średnio około 0,33 Mbps na stację.
Zalety: awaria jednego kabla powoduje utratę łączności tylko dla jednej stacji, łatwa diagnostyka (można śledzić diody LED na hubie), łatwe dodawanie/usuwanie stacji. Wady: więcej kabla niż w magistrali, centralny punkt awarii (awaria huba unieruchamia całą sieć).
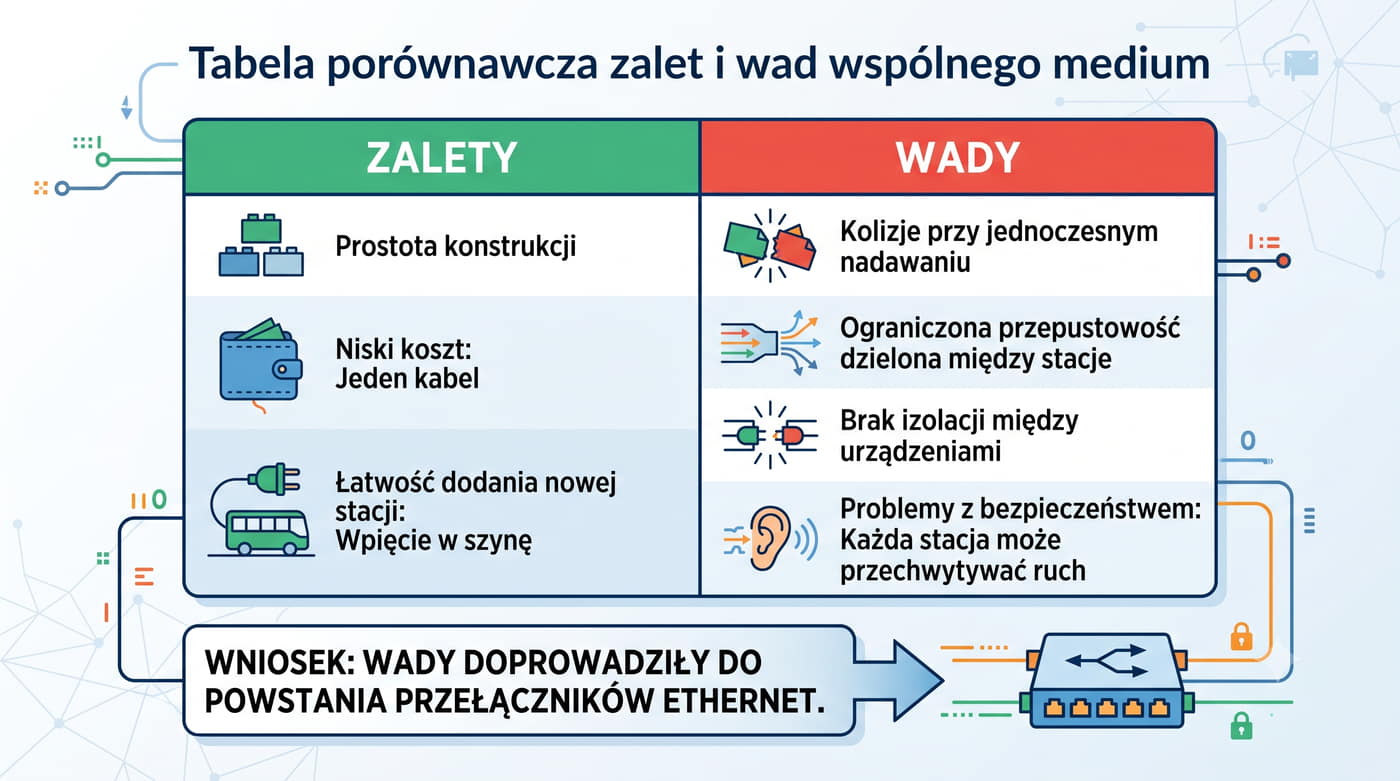
W topologii gwiazdy (star) wszystkie urządzenia są podłączone do centralnego punktu – huba lub switcha.
Każda stacja ma własne, dedykowane połączenie z centralnym urządzeniem.
Przykładem jest 10BASE-T z hubem, gdzie każda stacja łączy się za pomocą skrętki z koncentratorem.
Topologia gwiazdy (star topology), wprowadzona wraz ze standardem 10BASE-T w 1990 roku, stanowiła fundamentalną zmianę w projektowaniu sieci Ethernet.
W tej topologii każde urządzenie końcowe jest połączone dedykowanym odcinkiem kabla z centralnym punktem dystrybucji – hubem lub przełącznikiem.
Długość każdego odcinka skrętki miedzianej jest ograniczona do 100 metrów ze względu na tłumienie sygnału, które dla standardu 10BASE-T przy kablu kategorii 3 wynosi maksymalnie 11,5 dB na dystansie 100 metrów.
Zaletą topologii gwiazdy jest izolacja awarii – uszkodzenie kabla łączącego jedną stację z centralnym urządzeniem nie wpływa na działanie pozostałych hostów w sieci.
Diagnostyka usterek jest znacznie prostsza niż w magistrali, ponieważ diody LED na porcie huba lub przełącznika wskazują stan połączenia (link), aktywność (activity) i ewentualne kolizje.
Problemy można lokalizować per-portowo bez specjalistycznych przyrządów pomiarowych – wystarczy prześledzić diody na panelu czołowym urządzenia centralnego.
Wadą topologii gwiazdy jest większe zużycie kabla w porównaniu do magistrali, ponieważ każda stacja wymaga własnego okablowania strukturalnego prowadzonego do centralnego punktu dystrybucji.
Centralny punkt dystrybucji stanowi pojedynczy punkt awarii – jego uszkodzenie unieruchamia całą sieć.
W praktyce problem ten rozwiązuje się przez zastosowanie redundantnych urządzeń centralnych z protokołem Spanning Tree (STP), który automatycznie przełącza ruch na zapasowe urządzenie w przypadku awarii podstawowego.
Mimo tych ograniczeń topologia gwiazdy jest dominującym standardem we współczesnych sieciach lokalnych, a okablowanie strukturalne w standardzie TIA/EIA-568 jest projektowane właśnie w tej topologii.
Hub (koncentrator) to wieloportowy repeater działający w warstwie 1 modelu OSI.
Sygnał odebrany na jednym porcie jest regenerowany i rozsyłany na wszystkie pozostałe porty (z wyjątkiem portu źródłowego).
Hub nie ma tablicy adresów MAC – nie podejmuje żadnych decyzji dotyczących przekazywania ramek.
Wszystkie porty huba pracują w trybie half-duplex, a obowiązkowy jest protokół CSMA/CD.
Hub jest często nazywany "inteligentnym kablem", ponieważ wyłącznie powiela sygnał, nie dodając żadnej inteligencji.
Koncentrator sieciowy (hub) jest wieloportowym repeaterem działającym wyłącznie w warstwie fizycznej modelu OSI, co oznacza, że nie dokonuje żadnej analizy przesyłanych ramek ani adresów MAC.
Jego podstawową funkcją jest regeneracja sygnału odebranego na jednym porcie i retransmisja go na wszystkie pozostałe porty z wyjątkiem portu źródłowego.
Hub nie posiada tablicy adresów MAC ani pamięci buforowej do przechowywania ramek, co czyni go urządzeniem całkowicie pasywnym z punktu widzenia logicznego przetwarzania danych – każda ramka jest natychmiast rozsyłana na wszystkie porty, niezależnie od adresu docelowego.
Wszystkie porty huba pracują wyłącznie w trybie half-duplex, co oznacza, że w danej chwili mogą tylko nadawać lub tylko odbierać dane.
Protokół CSMA/CD jest zatem obowiązkowy, a każda kolizja dotyczy wszystkich stacji w sieci, ponieważ cała sieć oparta na hubie stanowi jedną domenę kolizyjną i jedną domenę rozgłoszeniową.
Typowy hub ma od 4 do 24 portów i pracuje z szybkością 10 lub 100 Mbps w przypadku Fast Ethernet.
Opóźnienie propagacyjne huba wynosi od 1 do 2 mikrosekund na port.
Huby można kaskadowo łączyć w celu zwiększenia liczby dostępnych portów, jednak należy przestrzegać reguły 5-4-3 dla Ethernetu 10 Mbps.
Ze względu na ograniczoną skalowalność, dzielenie przepustowości między wszystkie stacje oraz brak izolacji domen kolizyjnych huby zostały całkowicie wyparte przez przełączniki, które oferują dedykowaną przepustowość na port i izolację domen kolizyjnych.
Przykład: 50 stacji na hubie 10 Mbps – około 0,2 Mbps na stację.
Sieć staje się praktycznie nieużyteczna przy ciągłym ruchu.
Huby Ethernet występowały w wersjach 10 Mbps i 100 Mbps (Fast Ethernet hub).
Opóźnienie wprowadzane przez hub wynosi około 1–2 mikrosekund.
Maksymalna kaskada hubów podlega regule 5-4-3: maksymalnie 5 segmentów, 4 repeatery, 3 segmenty ze stacjami (dla 10 Mbps).
Największym ograniczeniem huba jest jedna domena kolizyjna.
Wszystkie podłączone stacje dzielą przepustowość.
Przykładowo, 30 stacji na hubie 10 Mbps uzyskuje średnio około 0,33 Mbps na stację przy ciągłej transmisji, a kolizje dodatkowo zmniejszają efektywną przepustowość do 30–40% nominalnej.
Parametry techniczne hubów mają bezpośredni wpływ na wydajność i ograniczenia projektowe całej sieci Ethernet.
Podstawowym parametrem jest szybkość transmisji, która dla hubów występuje w wariantach 10 Mbps (Ethernet) oraz 100 Mbps (Fast Ethernet).
Huby 10/100 Mbps mogą automatycznie negocjować szybkość z podłączonymi urządzeniami, ale pracują z najniższą wspólną szybkością wszystkich podłączonych stacji.
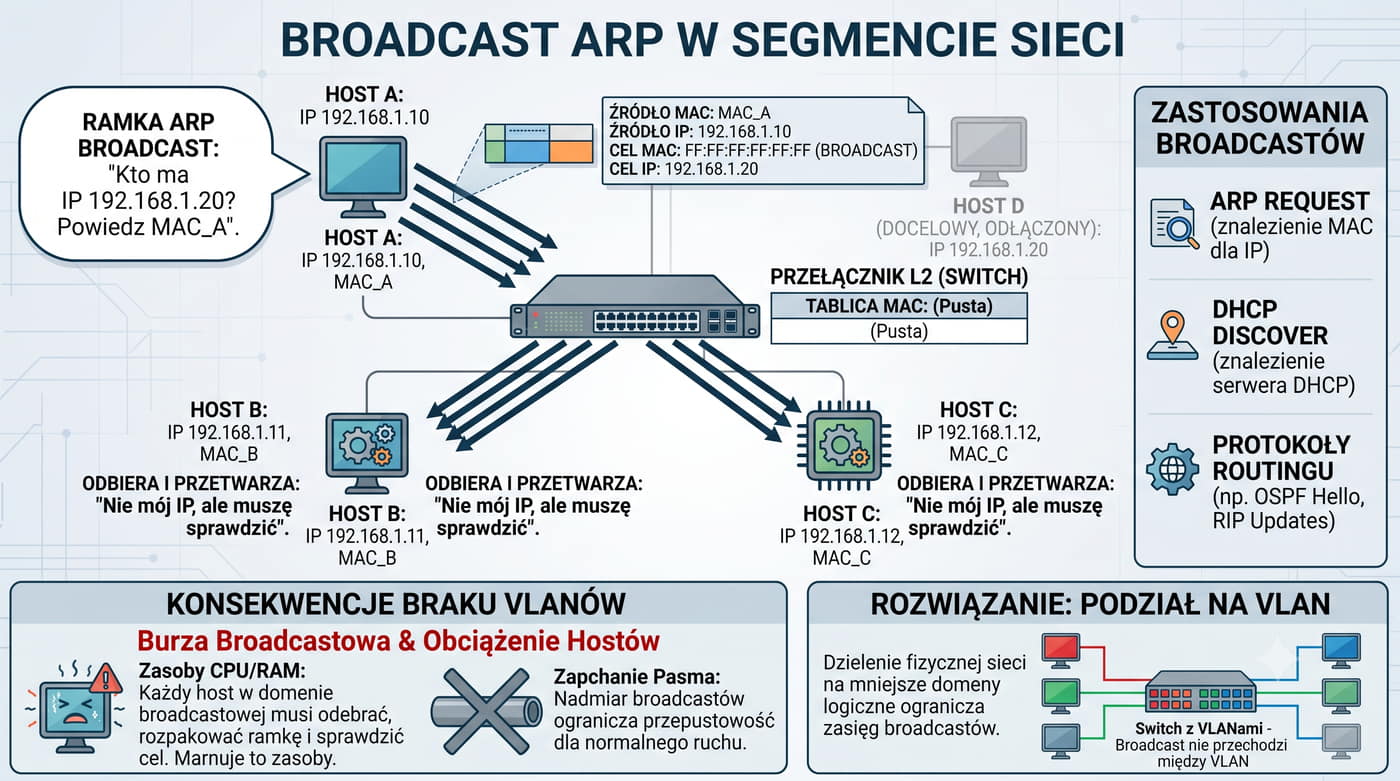
Każdy hub wprowadza opóźnienie propagacyjne rzędu 1–2 mikrosekund na port, co przy kaskadowym łączeniu czterech urządzeń może wydłużyć całkowity czas propagacji nawet o 8 mikrosekund.
Przekroczenie tych limitów uniemożliwia poprawne wykrywanie kolizji.
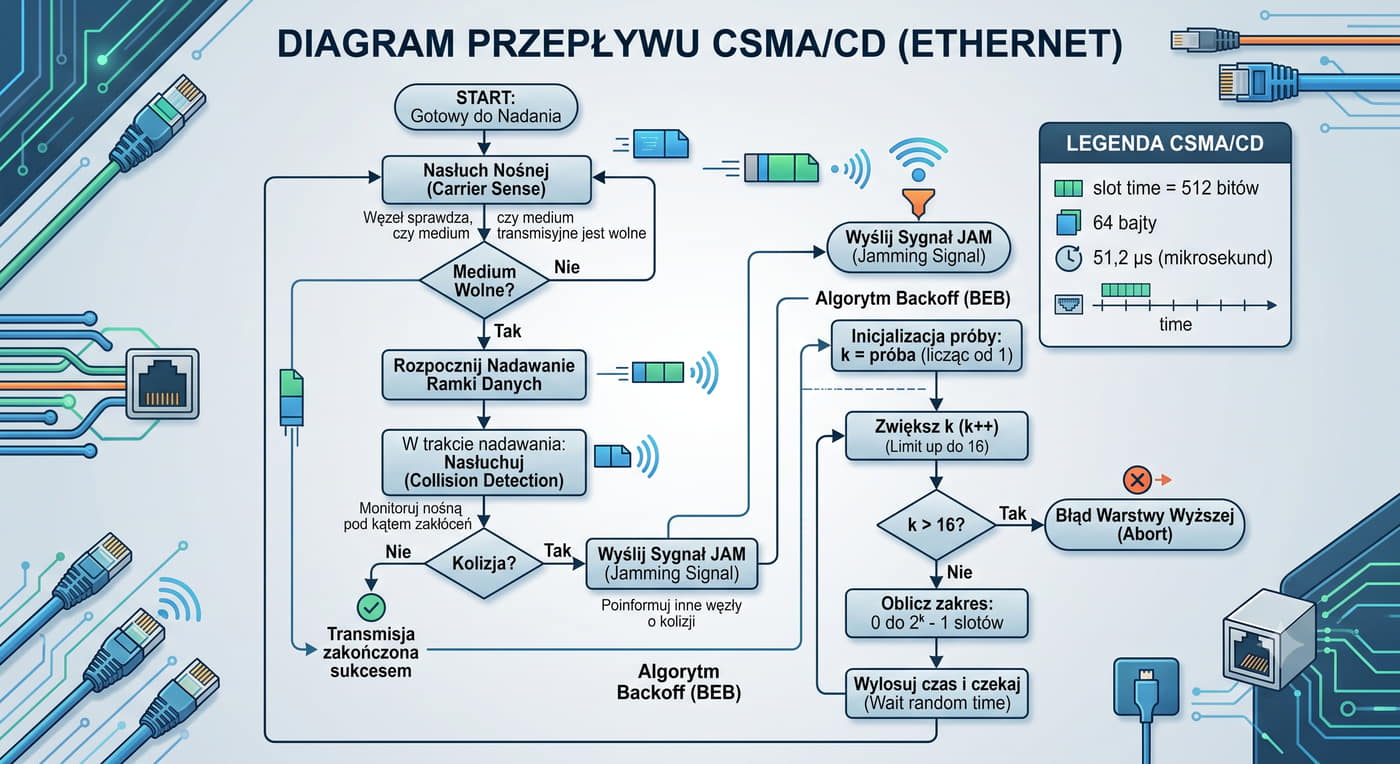
Przepustowość huba jest dzielona między wszystkie aktywne stacje, co przy obciążeniu przekraczającym 30–40% nominalnej szybkości powoduje gwałtowny wzrost liczby kolizji i retransmisji.
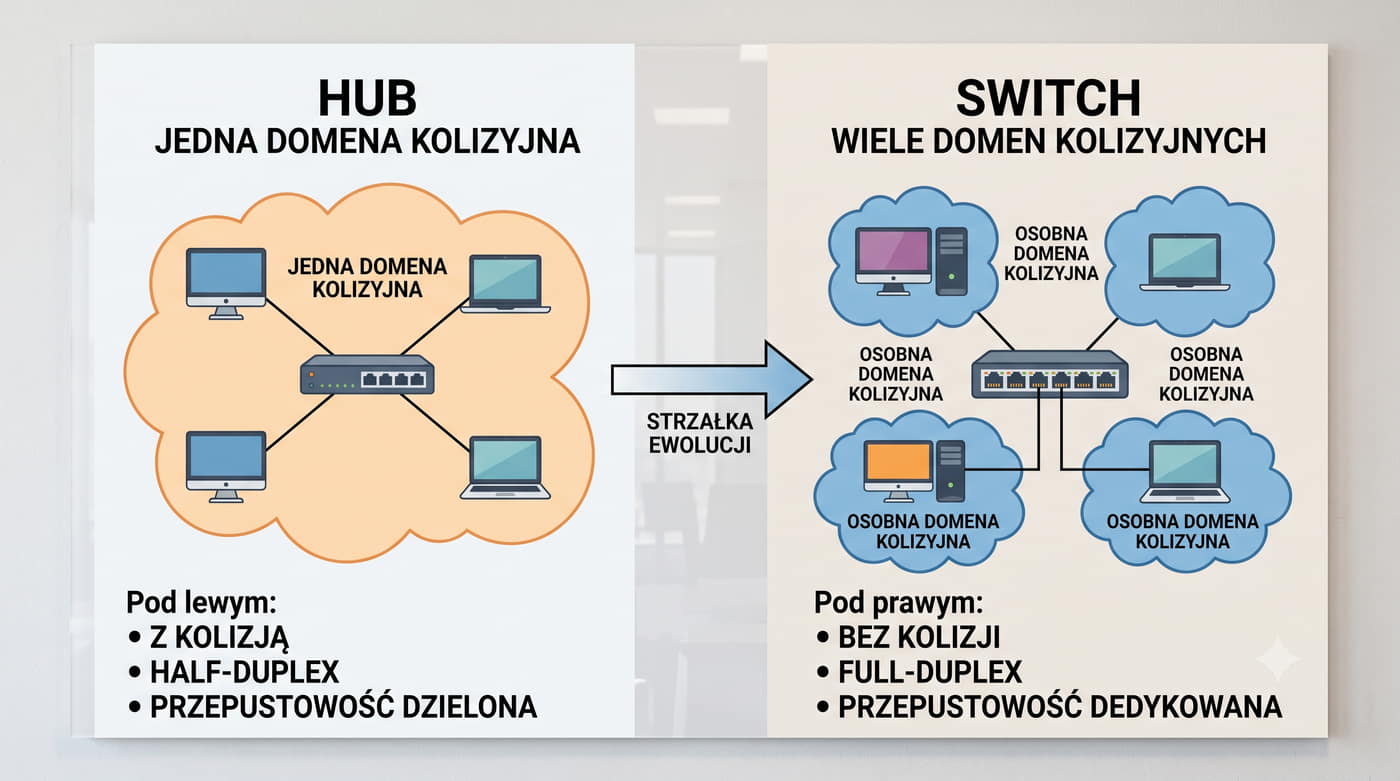
W sieci 10 Mbps z 30 stacjami średnia przepustowość na stację wynosi około 0,33 Mbps, a efektywna przepustowość po uwzględnieniu kolizji i wykładniczego backoff spada nawet do 30% wartości nominalnej (około 3 Mbps dla całego segmentu).
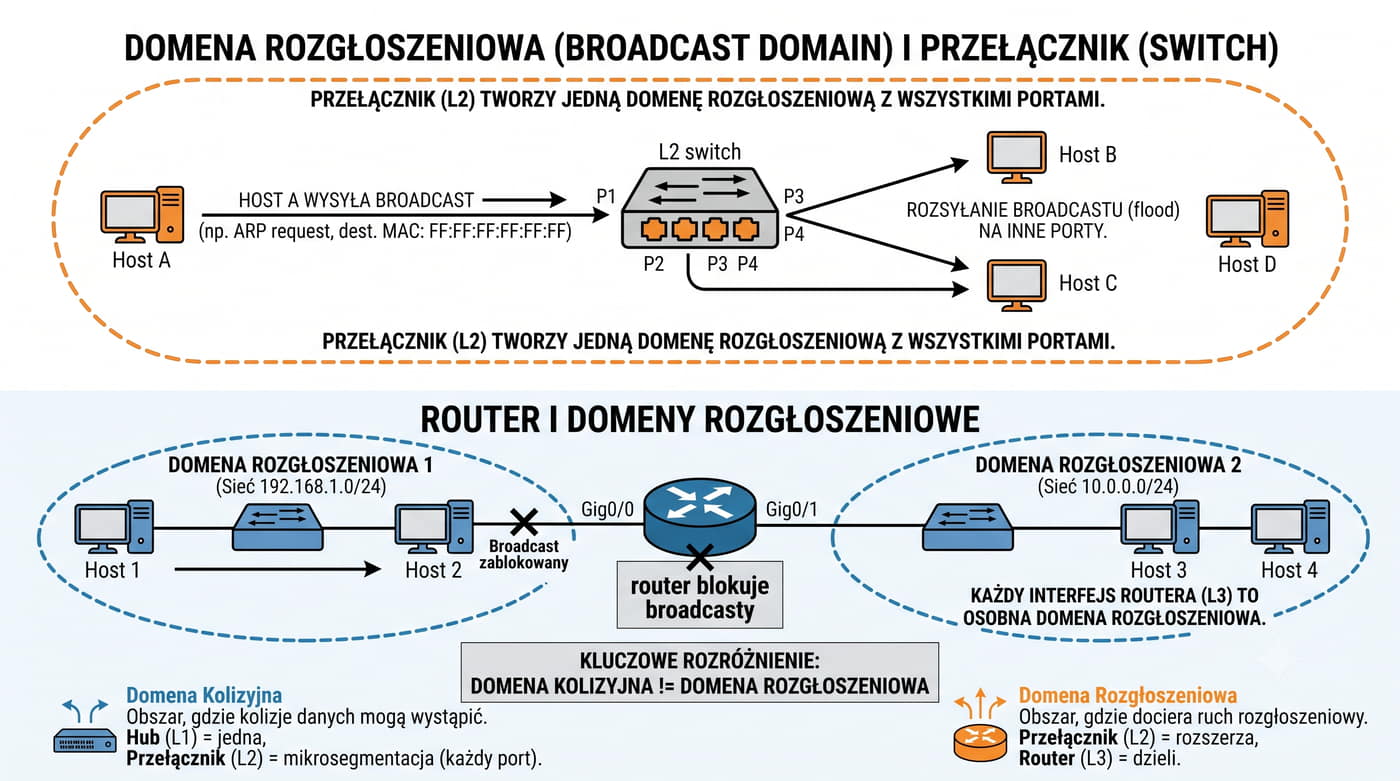
Te ograniczenia sprawiły, że huby zostały całkowicie wyparte przez przełączniki, które oferują dedykowaną przepustowość na każdym porcie i nie wymagają stosowania reguły 5-4-3.
show interfaces ! Wyświetla stan wszystkich interfejsów, adresy MAC i liczniki błędów show mac address-table ! Wyświetla tablicę adresów MAC (na przełączniku) show interfaces fastEthernet 0/1 ! Szczegółowe informacje o jednym interfejsie show running-config ! Bieżąca konfiguracja urządzenia
Przykład: Sprawdzenie adresu MAC interfejsu: show interface fastEthernet 0/1 | include address
Polecenia Cisco IOS przydatne do diagnostyki interfejsów i adresacji:
System operacyjny Cisco IOS (Internetwork Operating System) jest jednym z najpopularniejszych systemów dla urządzeń sieciowych klasy korporacyjnej.
Jego znajomość jest niezbędna w codziennej pracy administratora sieci, szczególnie w środowiskach wykorzystujących sprzęt Cisco Systems.
Dostęp do IOS odbywa się przez interfejs konsolowy (port konsoli RS-232), przez Telnet lub SSH (dostęp zdalny) oraz przez port AUX (dostęp modemowy).
IOS obsługuje trzy główne tryby: tryb użytkownika (User EXEC, prompt >), tryb uprzywilejowany (Privileged EXEC, prompt #) oraz tryb konfiguracji globalnej (Global Configuration, prompt (config)#).
Polecenie show interfaces wyświetla szczegółowe informacje o wszystkich interfejsach, w tym adres MAC przypisany do interfejsu, aktualną szybkość transmisji, tryb duplex oraz liczniki błędów takie jak collisions, CRC errors i runts.
Na przełączniku Cisco kluczowym poleceniem jest show mac address-table, które prezentuje tablicę adresów MAC wraz z przypisanymi portami i typem wpisu (dynamiczny, statyczny lub secure).
Polecenie show running-config umożliwia podgląd bieżącej konfiguracji urządzenia w pamięci RAM, co jest niezbędne przed planowanymi zmianami konfiguracyjnymi.
Do testowania łączności sieciowej w Cisco IOS służą polecenia ping (test warstwy 3 z opcjami rozszerzonymi, takimi jak źródłowy adres IP i liczba wysłanych pakietów) oraz traceroute (śledzenie trasy pakietu z adresami IP kolejnych routerów).
Polecenie show ip arp wyświetla tablicę ARP łączącą adresy IP z adresami MAC w lokalnym segmencie.
Wyniki wszystkich poleceń show można filtrować za pomocą operatora begin, include, exclude i section, co pozwala na szybkie znajdowanie konkretnych informacji w obszernych listingach bez konieczności przewijania całego wyjścia.
/interface ethernet print # Lista interfejsów z adresami MAC i statusem /interface ethernet monitor ether1 # Monitorowanie parametrów interfejsu w czasie rzeczywistym /system routerboard print # Informacje o sprzęcie i wersji RouterOS :put [/interface ethernet get ether1 mac-address] # Wyświetlenie adresu MAC konkretnego interfejsu
RouterOS oferuje również polecenie /ip arp print do wyświetlenia tablicy ARP oraz /log print do podglądu logów systemowych.
Polecenia RouterOS (MikroTik) do diagnostyki interfejsów i adresów:
System RouterOS firmy MikroTik stanowi popularną alternatywę dla Cisco IOS, szczególnie w sieciach małych i średnich przedsiębiorstw oraz w środowiskach ISP, oferując bogaty zestaw funkcji w przystępnej cenie.
RouterOS jest systemem operacyjnym typu Linux, który może być instalowany na dedykowanym sprzęcie MikroTik (RouterBoard) lub na standardowych komputerach PC jako x86.
System obsługuje interfejs konsolowy, SSH, Telnet oraz graficzny WinBox i narzędzie webfig.
Polecenia RouterOS mają składnię hierarchiczną z użyciem ukośników, podobną do systemu plików Unix.
Polecenie /interface ethernet print wyświetla listę wszystkich interfejsów fizycznych wraz z adresami MAC, szybkością negocjowaną z urządzeniem po drugiej stronie łącza (auto-negotiation) oraz stanem administracyjnym (enabled/disabled) i operacyjnym (running/not running) interfejsu.
Monitorowanie parametrów w czasie rzeczywistym realizuje polecenie /interface ethernet monitor ether1, które prezentuje aktualną szybkość transmisji w bitach na sekundę (tx/rx bps), liczbę odebranych i wysłanych pakietów oraz statystyki błędów, takie jak CRC errors i collisions.
Polecenie /system routerboard print dostarcza informacji o wersji RouterBoard, typie procesora (np. ARM, MIPS), ilości pamięci RAM oraz wersji zainstalowanego RouterOS.
Do zaawansowanej diagnostyki RouterOS oferuje narzędzie Torch (dostępne z poziomu interfejsu WinBox lub przez polecenie /tool torch), które umożliwia podgląd pakietów w czasie rzeczywistym z możliwością filtrowania według adresów IP, portów TCP/UDP i protokołów.
Polecenie /ip arp print wyświetla tablicę ARP, /ip route print prezentuje tablicę routingu, a /log print umożliwia podgląd logów systemowych.
Dla administratorów preferujących graficzny interfejs dostępny jest program WinBox, który umożliwia zarządzanie wszystkimi funkcjami RouterOS bez znajomości składni poleceń konsolowych, oferując jednocześnie zaawansowane narzędzia do monitorowania ruchu i konfiguracji zapór ogniowych.
Blok piąty podsumowuje wiedzę o fizycznych urządzeniach sieciowych stosowanych w sieciach Ethernet współdzielonego medium.
Karta sieciowa NIC jest podstawowym interfejsem łączącym komputer z siecią, wyposażonym w kontroler MAC implementujący protokół CSMA/CD oraz pamięć EEPROM z fabrycznie nadanym 48-bitowym adresem MAC.
Repeater i regenerator stanowią urządzenia warstwy fizycznej służące do przedłużania zasięgu sieci poprzez regenerację sygnału, przy czym regenerator wykonuje pełną rekonstrukcję 3R (wzmocnienie, odtworzenie kształtu i taktowania).
Hub jako wieloportowy repeater umożliwił przejście z topologii magistrali na gwiazdę, zachowując jednak wszystkie ograniczenia wspólnego medium: jedną domenę kolizyjną, konieczność stosowania CSMA/CD i dzielenie przepustowości między wszystkie stacje.
Topologia magistrali oferowała prostotę i oszczędność kabla kosztem niskiej niezawodności i trudnej diagnostyki, podczas gdy topologia gwiazdy zapewniła izolację awarii i łatwiejsze lokalizowanie problemów kosztem większego zużycia okablowania strukturalnego.
Przykłady poleceń diagnostycznych Cisco IOS i RouterOS ilustrują praktyczne aspekty zarządzania urządzeniami sieciowymi.
W RouterOS analogiczne funkcje realizują /interface ethernet print, /ip arp print i /ip route print.
Znajomość tych narzędzi jest niezbędna do projektowania, konfiguracji i utrzymania niezawodnej infrastruktury sieciowej, a także do szybkiej diagnostyki i rozwiązywania problemów w środowiskach produkcyjnych.
Pytania kontrolne zostały zaprojektowane tak, aby zweryfikować zrozumienie kluczowych koncepcji przedstawionych podczas wykładu.
Odpowiedź na pierwsze pytanie powinna uwzględniać, że ALOHA pozwalała na transmisję w dowolnym momencie bez nasłuchu, co przy większym obciążeniu prowadziło do bardzo dużej liczby kolizji i gwałtownego spadku przepustowości (maksymalnie około 18% dla czystej ALOHA).
Dodanie nasłuchu nośnej (Carrier Sense) w CSMA/CD radykalnie zmniejsza prawdopodobieństwo kolizji, ponieważ stacje nie rozpoczynają transmisji, gdy medium jest już zajęte, co zwiększa maksymalną przepustowość do około 30–40% nominalnej.
Drugie pytanie wymaga porównania standardów 10BASE5, 10BASE2 i 10BASE-T.
Należy wskazać różnice w topologii (magistrala vs gwiazda), medium transmisyjnym (gruby kabel koncentryczny RG-8 vs cienki RG-58 vs skrętka kat. 3), maksymalnej długości segmentu (500 m vs 185 m vs 100 m) oraz maksymalnej liczbie stacji (100 vs 30 vs 1 na port).
Trzecie pytanie weryfikuje znajomość wszystkich pól ramki Ethernet: preambuły (7B), SFD (1B), adresów MAC DA i SA (po 6B), EtherType/Length (2B), danych (46–1500B) i FCS (4B).
Czwarte pytanie dotyczy zależności między minimalnym rozmiarem ramki 64 bajtów a slot time.
Slot time dla Ethernetu 10 Mbps wynosi 512 bitów (51,2 mikrosekundy) i odpowiada czasowi potrzebnemu na wykrycie kolizji w segmencie o maksymalnej średnicy.
Ramka musi być nadawana przez co najmniej slot time, aby nadawca mógł wykryć kolizję zanim zakończy nadawanie.
Piąte pytanie sprawdza rozróżnienie domeny kolizyjnej (urządzenia L2 – przełącznik dzieli) od rozgłoszeniowej (urządzenia L3 – router dzieli).
Szóste pytanie wymaga opisu CSMA/CD z fazami nasłuchu, dostępu, detekcji kolizji i backoff.
Ostatnie pytanie weryfikuje, że hub nie może pracować w full-duplex, ponieważ wszystkie porty huba są w jednej domenie kolizyjnej i muszą używać CSMA/CD.
| Standard | Rok | Topologia | Medium | Szybkość | Max długość |
|---|---|---|---|---|---|
| 10BASE5 | 1983 | magistrala | gruby coax (RG-8) | 10 Mbps | 500 m |
| 10BASE2 | 1985 | magistrala | cienki coax (RG-58) | 10 Mbps | 185 m |
| 10BASE-T | 1990 | gwiazda | skrętka kat. 3 | 10 Mbps | 100 m |
| 100BASE-TX | 1995 | gwiazda | skrętka kat. 5 | 100 Mbps | 100 m |
| 1000BASE-T | 1999 | gwiazda | skrętka kat. 5e | 1 Gbps | 100 m |
Tabela porównawcza standardów Ethernetu obrazuje technologiczną ewolucję na przestrzeni szesnastu lat, od 10BASE5 (1983) do 1000BASE-T (1999).
Wyraźnie widoczne jest systematyczne przejście od topologii magistrali z kablem koncentrycznym, gdzie wszystkie stacje współdzielą to samo medium i rywalizują o dostęp za pomocą CSMA/CD, do topologii gwiazdy z dedykowanymi połączeniami za pomocą skrętki miedzianej, co umożliwiło późniejsze przejście na przełączniki i tryb full-duplex.
Standard 10BASE5 (Thick Ethernet) z 1983 roku wykorzystywał gruby kabel koncentryczny RG-8 o średnicy około 10 mm i impedancji 50 omów.
Instalacja wymagała precyzyjnego nawiercania kabla i montażu specjalnych wampirków (vampire taps), które przebijały izolację i stykały się z żyłą miedzianą.
Każdy wampirek był połączony z transceiverem (MAU) za pomocą kabla AUI o długości do 50 metrów.
Standard 10BASE2 (Thin Ethernet) z 1985 roku uprościł instalację dzięki cieńszemu i bardziej elastycznemu kablowi RG-58 oraz złączom BNC, eliminując potrzebę wampirków – stacje łączono bezpośrednio za pomocą złączy T.
Przełomem był standard 10BASE-T z 1990 roku, który wprowadził topologię gwiazdy z centralnym hubem i skrętką miedzianą kategorii 3 z ośmioma żyłami w czterech parach.
Kolejne standardy 100BASE-TX (1995) i 1000BASE-T (1999) utrzymały tę samą topologię przy dziesięciokrotnym i stukrotnym wzroście przepustowości.
Wszystkie standardy zachowują wsteczną kompatybilność dzięki mechanizmowi autonegocjacji (auto-negotiation) zdefiniowanemu w IEEE 802.3u, który automatycznie ustala najwyższą wspólną szybkość i tryb duplex między dwoma urządzeniami.
Dzięki temu możliwa jest stopniowa modernizacja infrastruktury bez wymiany wszystkich urządzeń jednocześnie.
Najważniejszym wnioskiem płynącym z całego wykładu jest zrozumienie, że Ethernet ewoluował od prostego systemu współdzielonego medium z przypadkowym dostępem i protokołem CSMA/CD do zaawansowanej technologii przełączanej, która stanowi kręgosłup współczesnego Internetu.
Kluczowym momentem tej ewolucji było przejście od topologii magistrali z kablem koncentrycznym do topologii gwiazdy z dedykowanymi połączeniami, co wyeliminowało fundamentalne ograniczenia związane z kolizjami, dzieleniem pasma i skalowalnością.
Współczesne sieci Ethernet pracują w trybie full-duplex z przełącznikami, gdzie CSMA/CD jest wyłączone, a przepustowość rośnie od 10 Mbps do 400 Gbps.
Zrozumienie historycznych ograniczeń Ethernetu współdzielonego jest niezbędne do właściwego projektowania współczesnych sieci i docenienia zalet nowoczesnych technologii.
Protokół CSMA/CD, choć dziś praktycznie nieużywany w sieciach przełączanych, pozostaje ważnym elementem edukacji inżynierskiej, ponieważ uczy fundamentalnych zasad dostępu do współdzielonego medium i mechanizmów wykrywania kolizji.
Adresacja MAC (48 bitów) i IPv4 (32 bity) wraz z protokołem ARP pozostają fundamentalnymi elementami komunikacji sieciowej, które każdy administrator musi doskonale znać.
Wiedza zdobyta podczas tego wykładu stanowi solidną podstawę do zgłębiania bardziej zaawansowanych tematów z zakresu przełączania Ethernet, routingu dynamicznego (OSPF, EIGRP, BGP), wirtualnych sieci lokalnych (VLAN), protokołu Spanning Tree (STP/RSTP) oraz bezpieczeństwa sieciowego.
Studentów zachęca się do praktycznego eksperymentowania z konfiguracją urządzeń sieciowych w programach symulacyjnych takich jak Cisco Packet Tracer lub GNS3 oraz do korzystania z narzędzi analitycznych takich jak Wireshark w celu weryfikacji i utrwalenia przedstawionych koncepcji w praktyce.