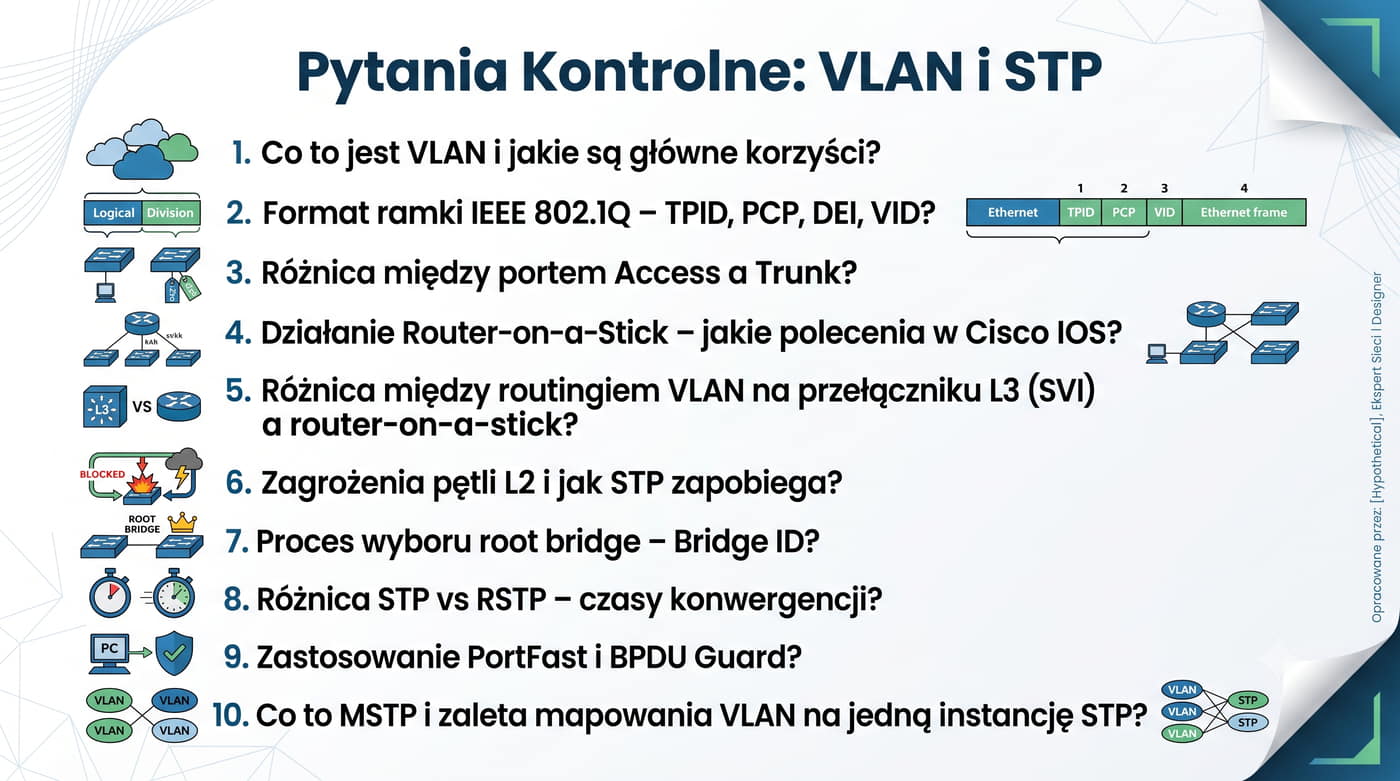
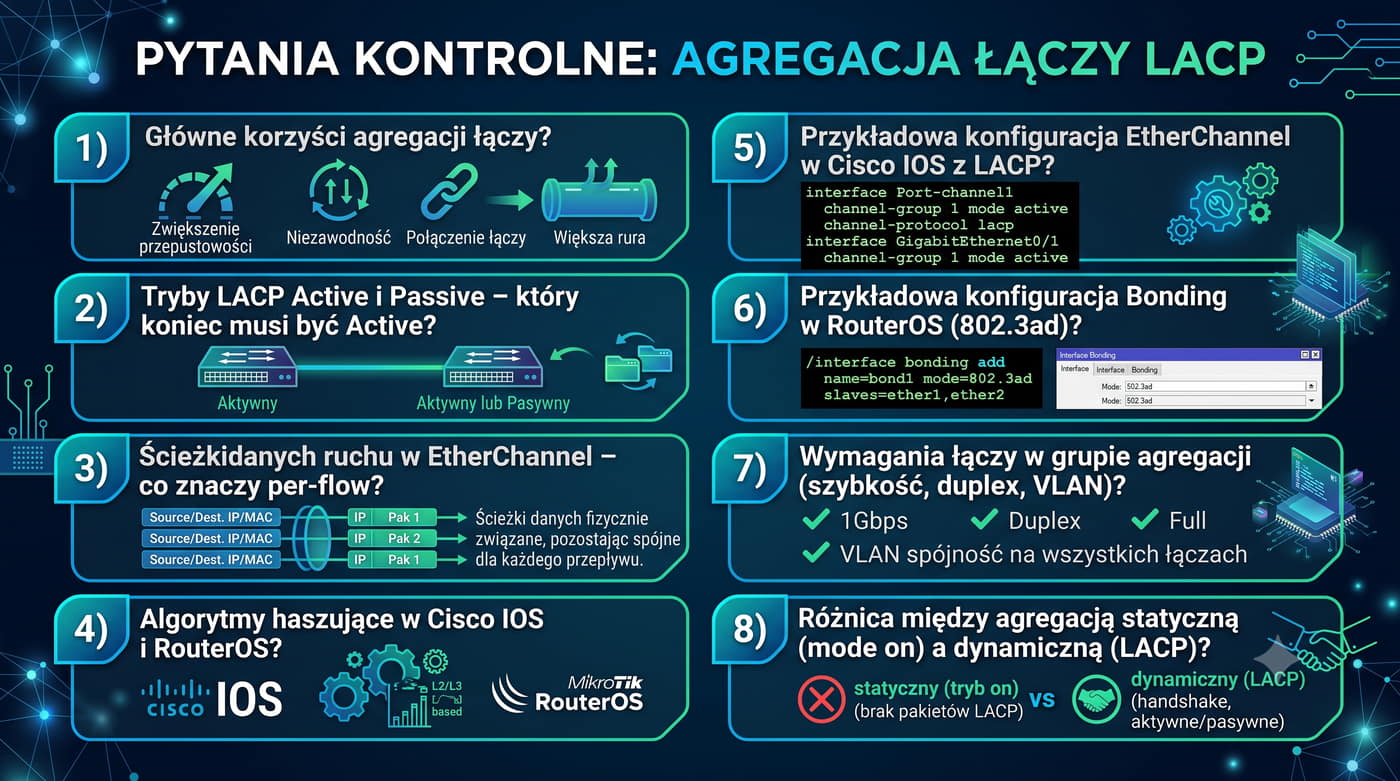
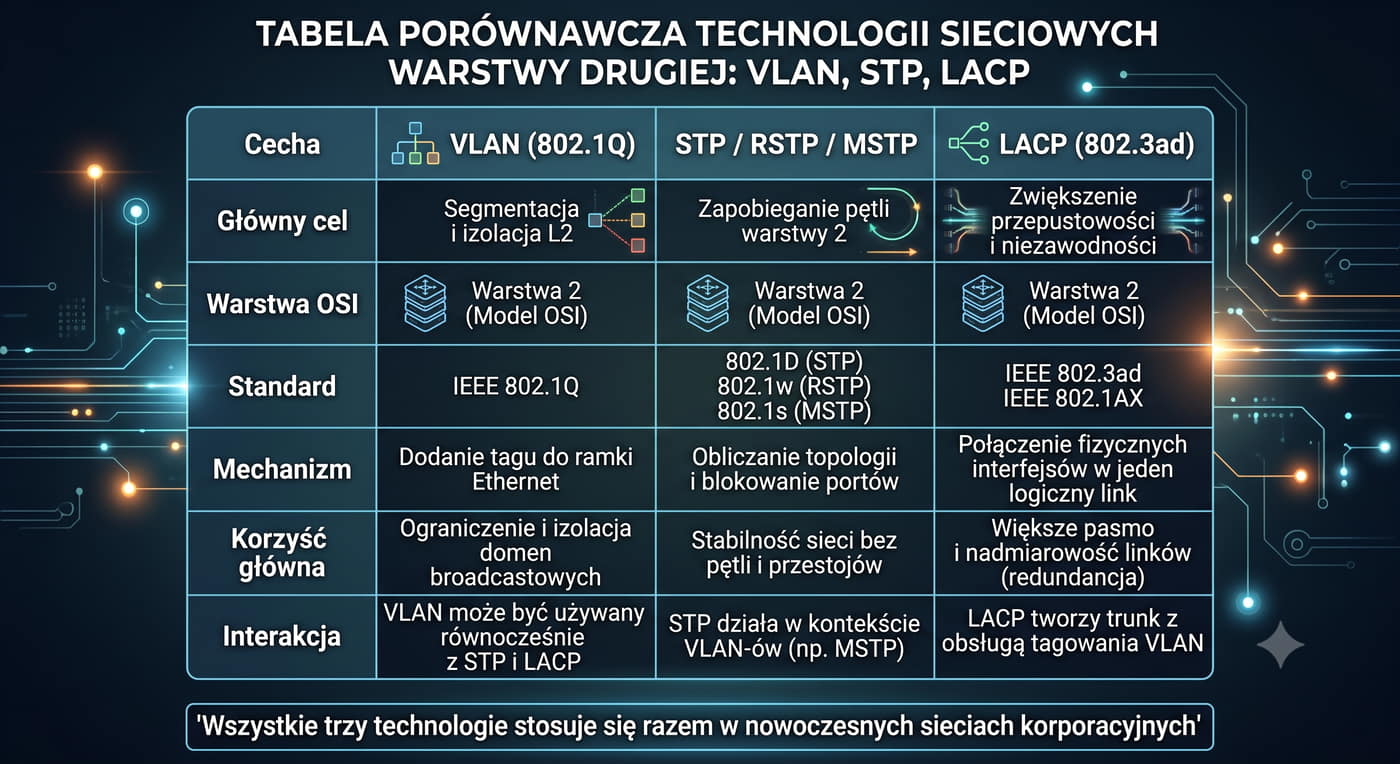
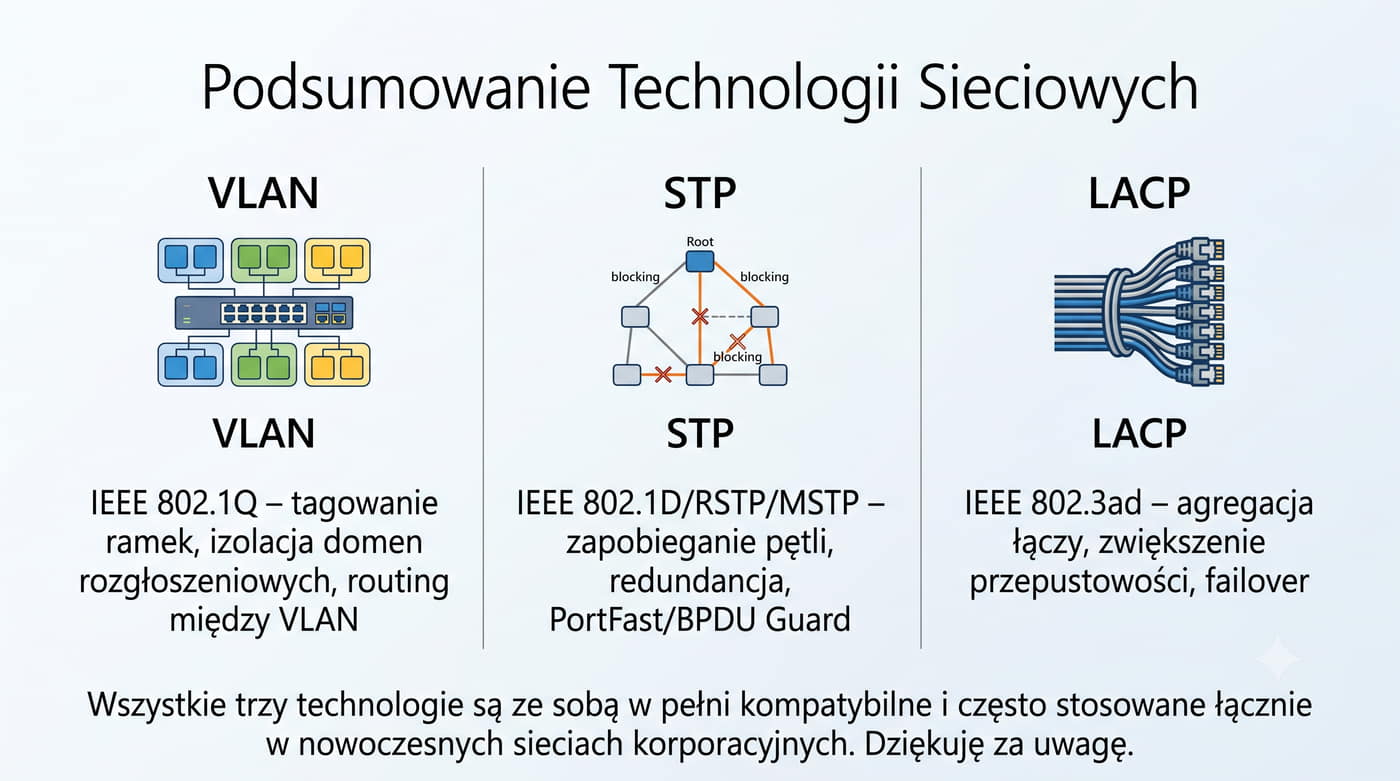
1/55 VLAN, STP i agregacja łączy

Segmentacja sieci, redundancja i wydajność warstwy 2

Przedmiot: Sieci komputerowe – wykład 5

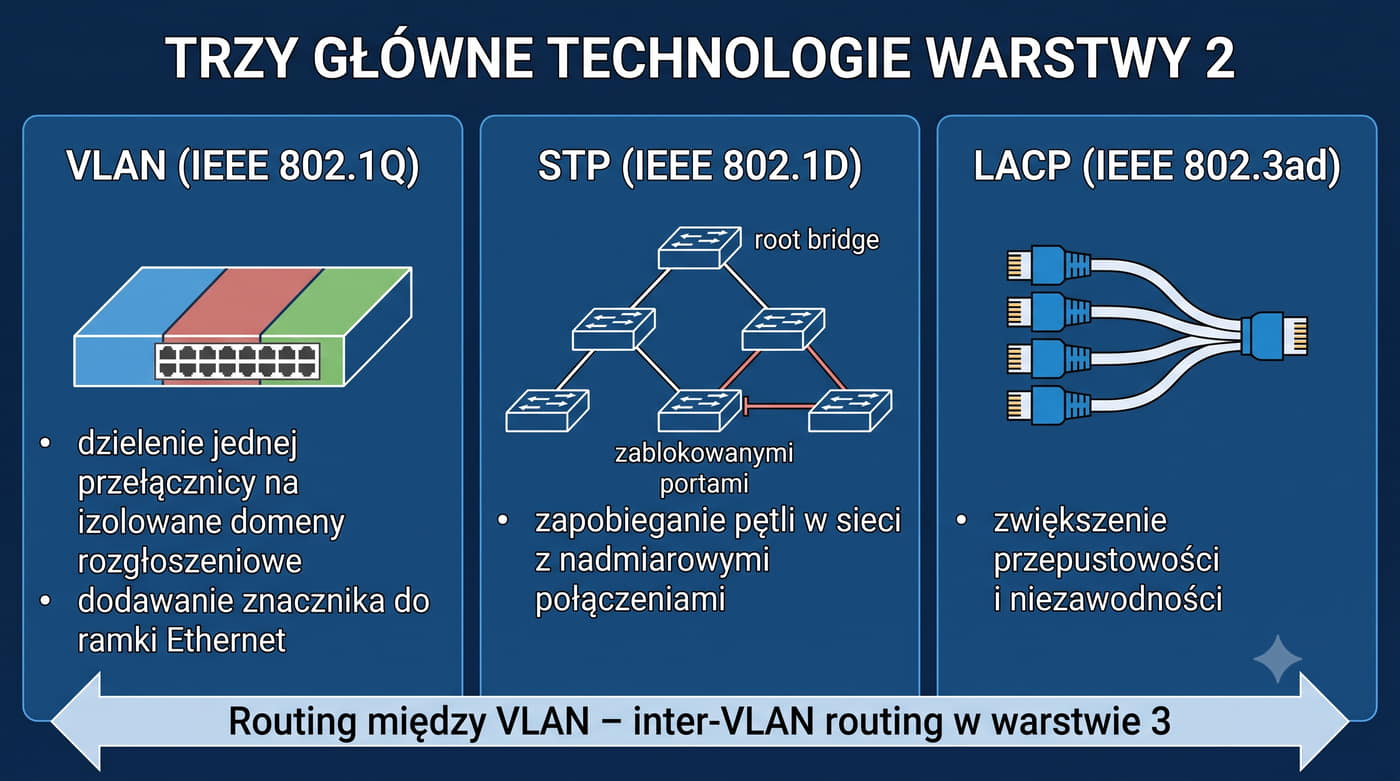
Prezentacja omawia trzy kluczowe technologie warstwy 2 w sieciach Ethernet.

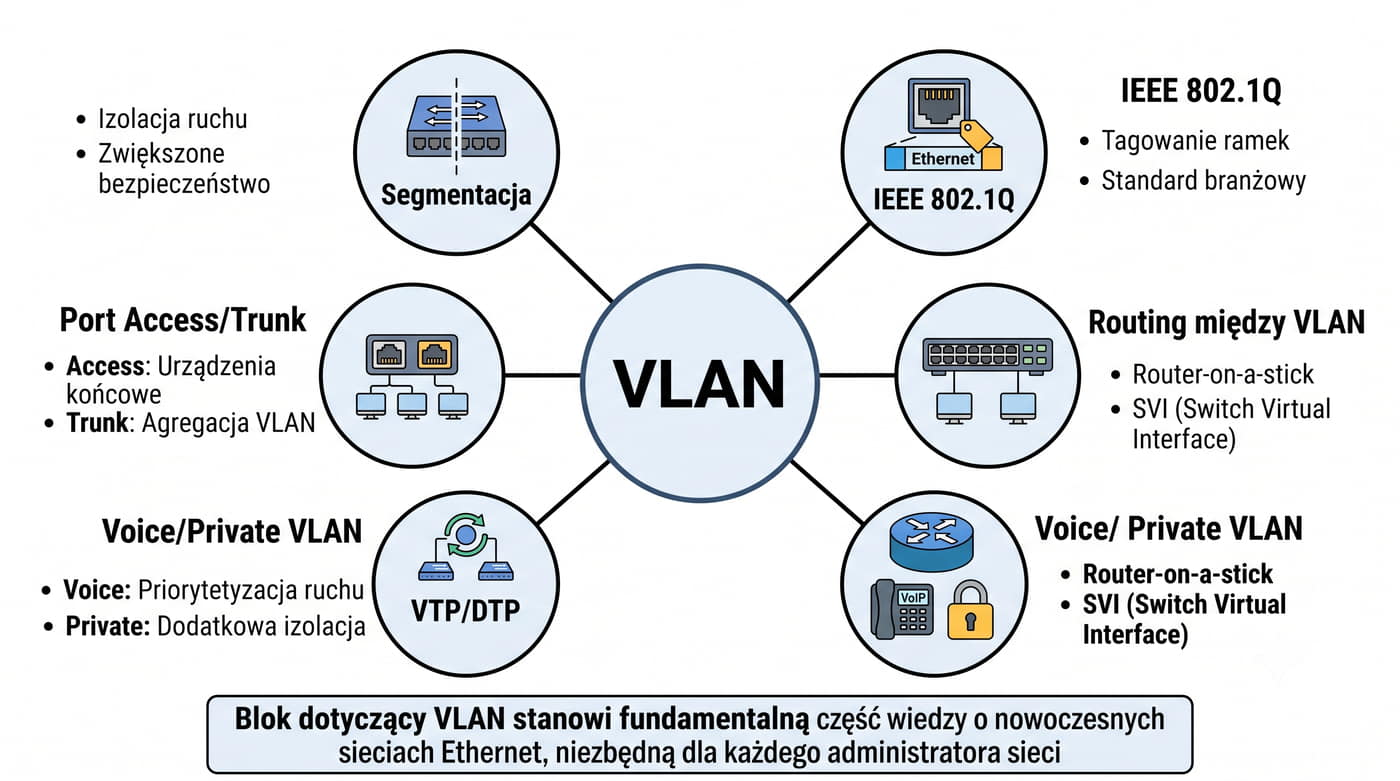
Wirtualne sieci (IEEE 802.1Q) pozwalają na logiczny podział sieci fizycznej na izolowane domeny rozgłoszeniowe.

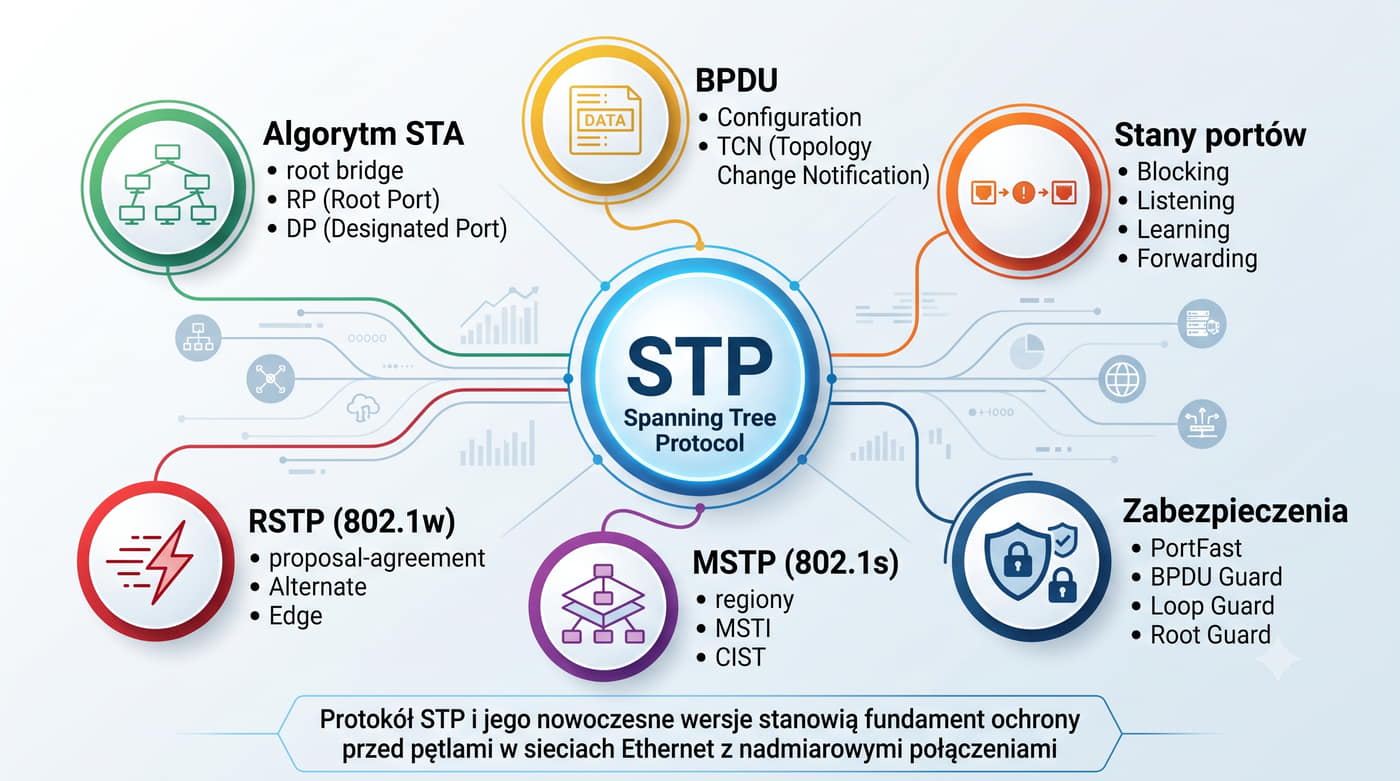
Protokół STP (Spanning Tree Protocol) zapobiega pętlom w sieci z nadmiarowymi połączeniami.

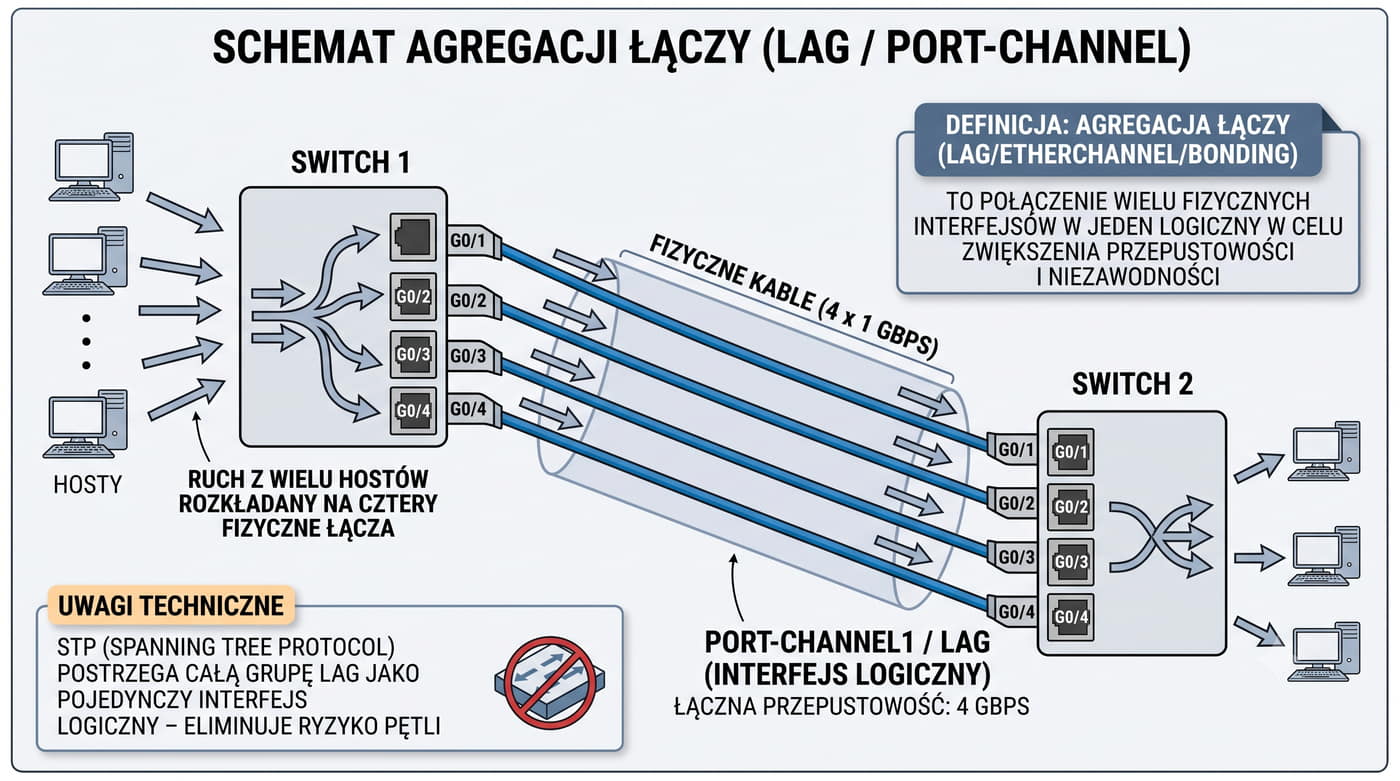
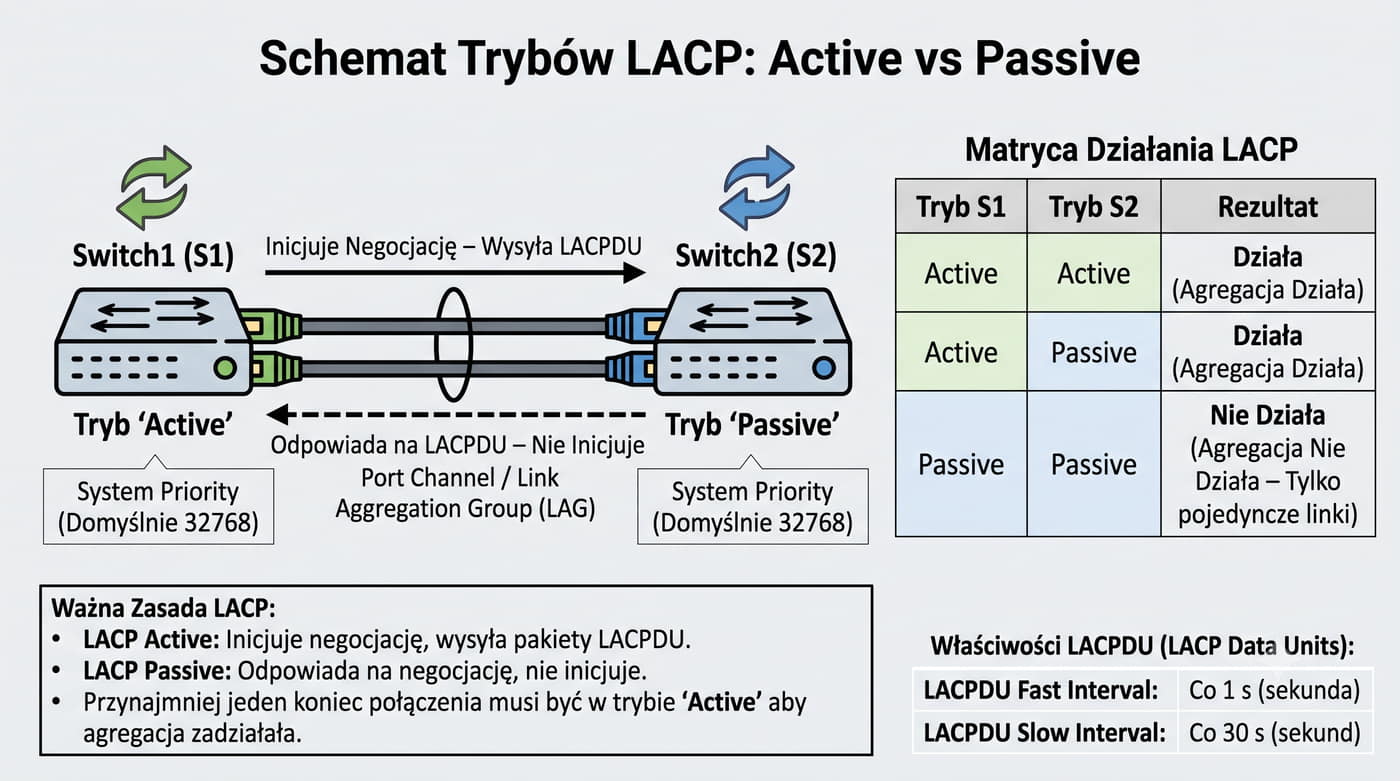
Agregacja łączy (LACP) zwiększa przepustowość i niezawodność przez łączenie wielu fizycznych interfejsów w jeden logiczny.

Wszystkie technologie ilustrowane są przykładami w Cisco IOS i RouterOS.
Wirtualne sieci lokalne (VLAN) to technologia umożliwiająca logiczny podział fizycznej infrastruktury sieciowej na mniejsze, izolowane segmenty. Dzięki standardowi IEEE 802.1Q, każdy VLAN jest oznaczany unikalnym identyfikatorem (VID), co pozwala urządzeniom na filtrowanie ruchu tylko do odpowiednich grup. To rozwiązanie nie wymaga fizycznego przepinania kabli, a jedynie konfiguracji przełączników, co znacznie upraszcza zarządzanie siecią i umożliwia elastyczne dostosowywanie jej do potrzeb użytkowników. VLAN-y są szczególnie przydatne w dużych organizacjach, gdzie konieczne jest oddzielenie ruchu gości od ruchu wewnętrznego lub segmentacja sieci ze względów bezpieczeństwa.

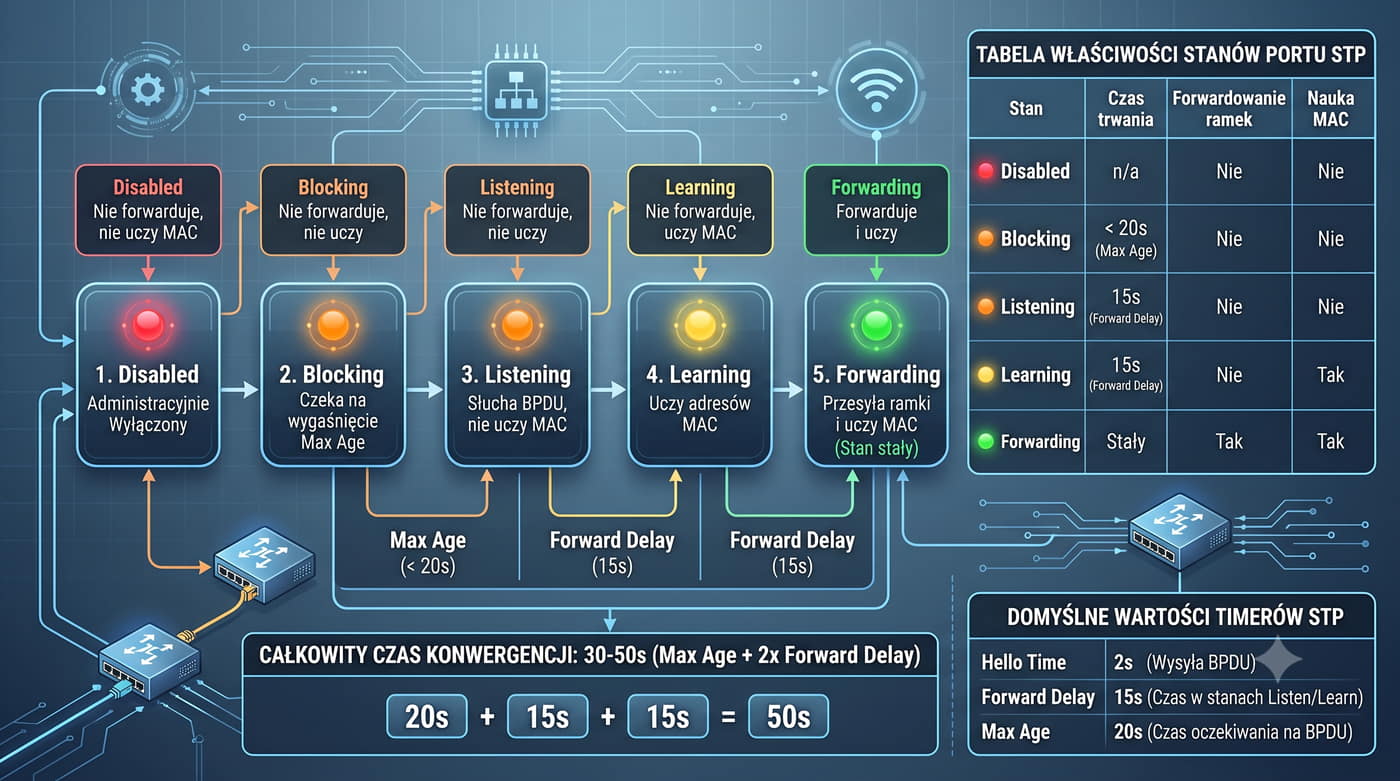
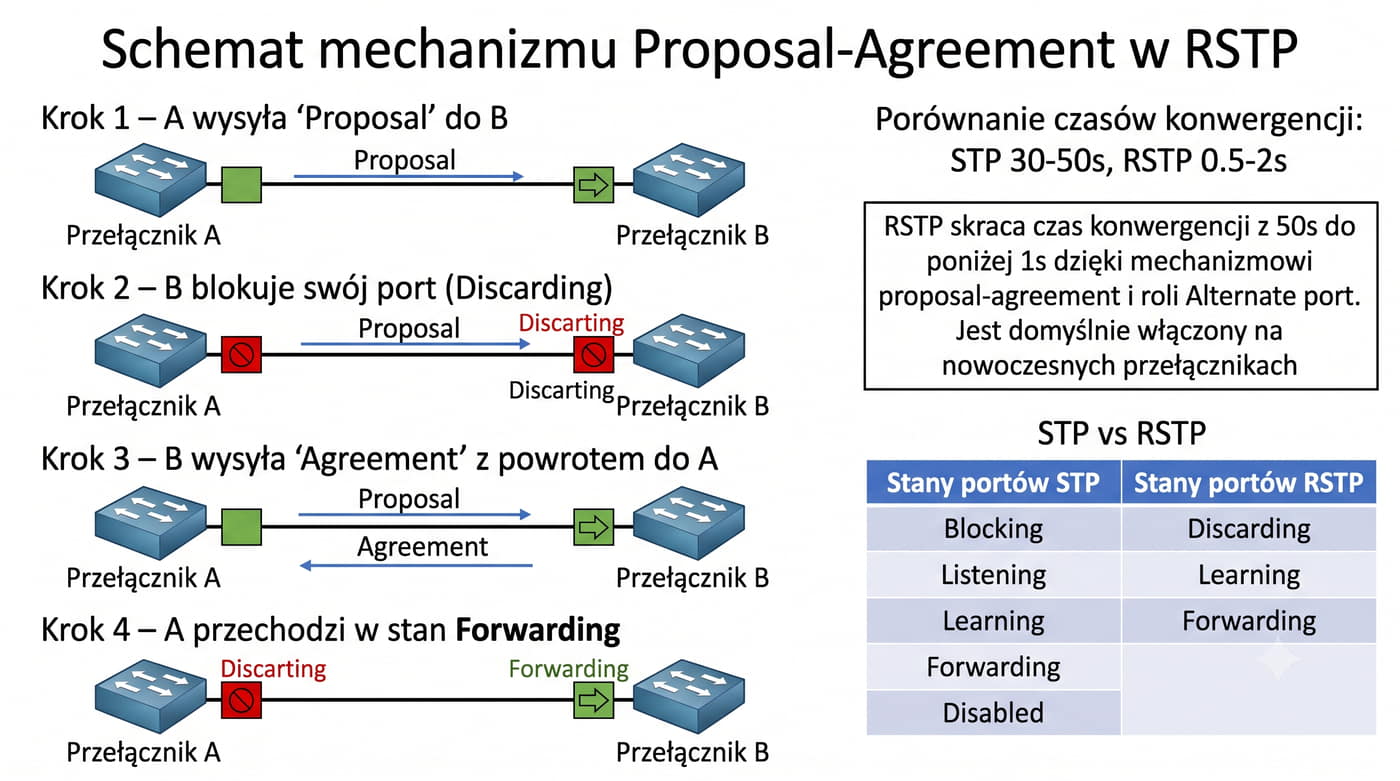
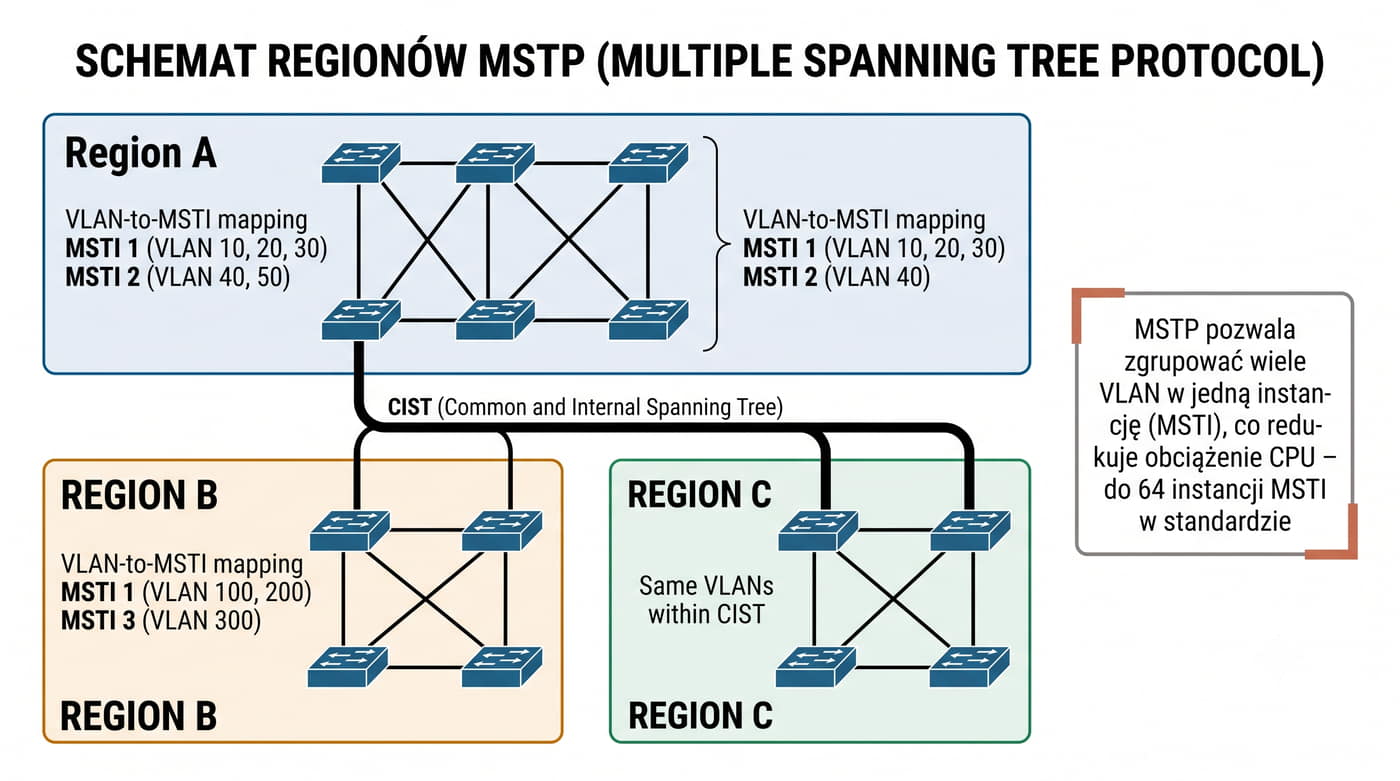
Protokół Spanning Tree Protocol (STP) został zaprojektowany, aby zapobiegać pętlom w sieciach Ethernet, które mogłyby prowadzić do nieskończonej retransmisji ramek i degradacji wydajności. STP działa na warstwie 2 modelu OSI i wybiera jedną ścieżkę (tzw. "path of least cost") między przełącznikami, ignorując pozostałe połączenia. W sieciach z redundancją, takich jak te z wieloma fizycznymi łączami między urządzeniami, STP blokuje nadmiarowe porty, co minimalizuje ryzyko awarii. Istnieje kilka odmian protokołu, np. Rapid Spanning Tree (RSTP) i Multiple Spanning Tree (MST), które oferują szybszą konwergencję lub obsługę sieci pierścieniowych.

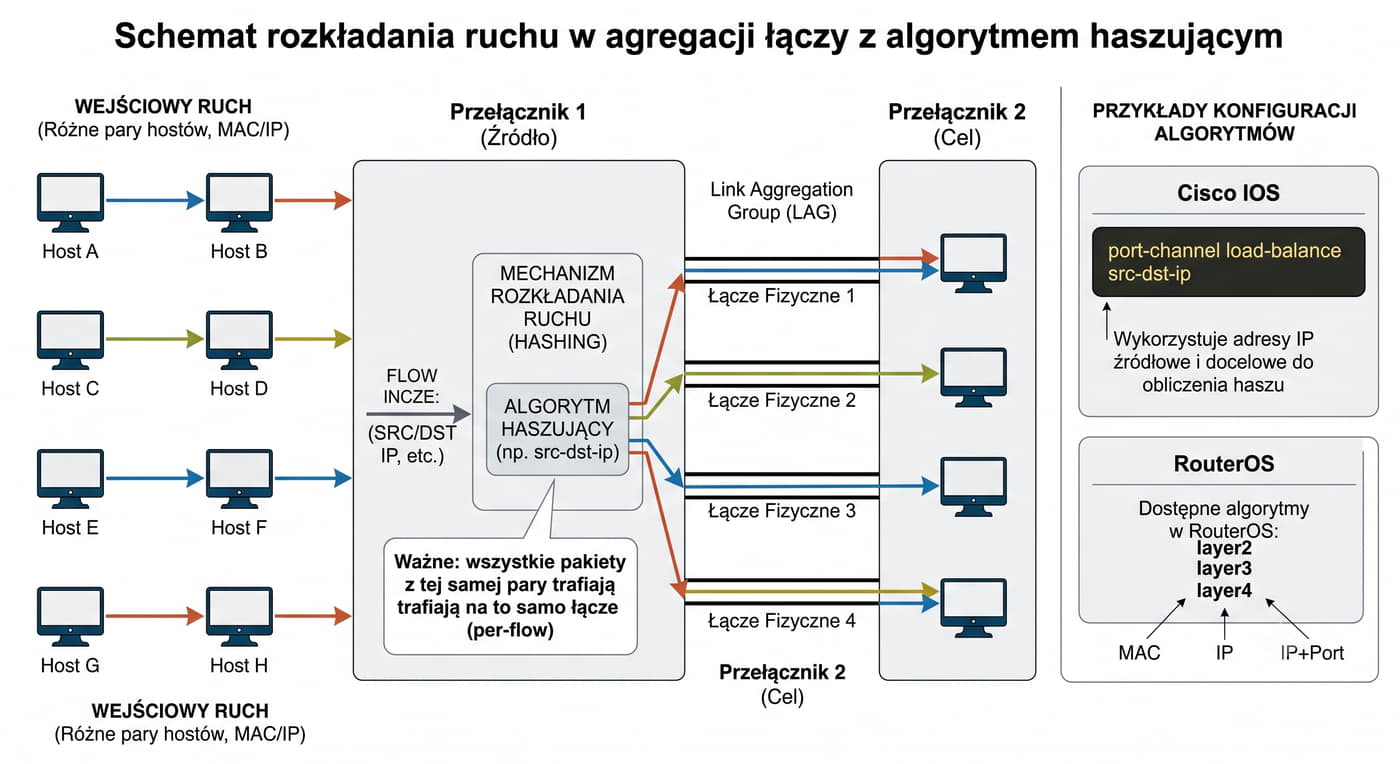
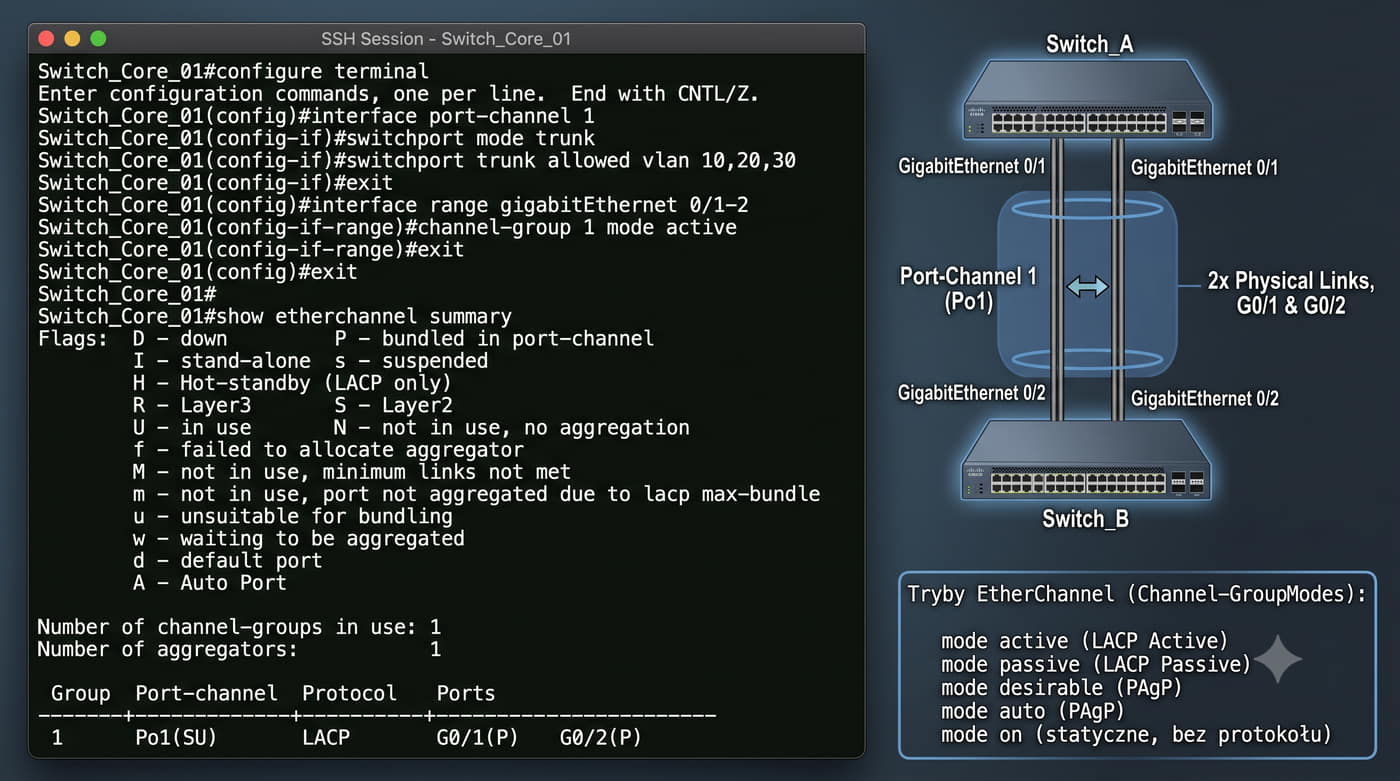
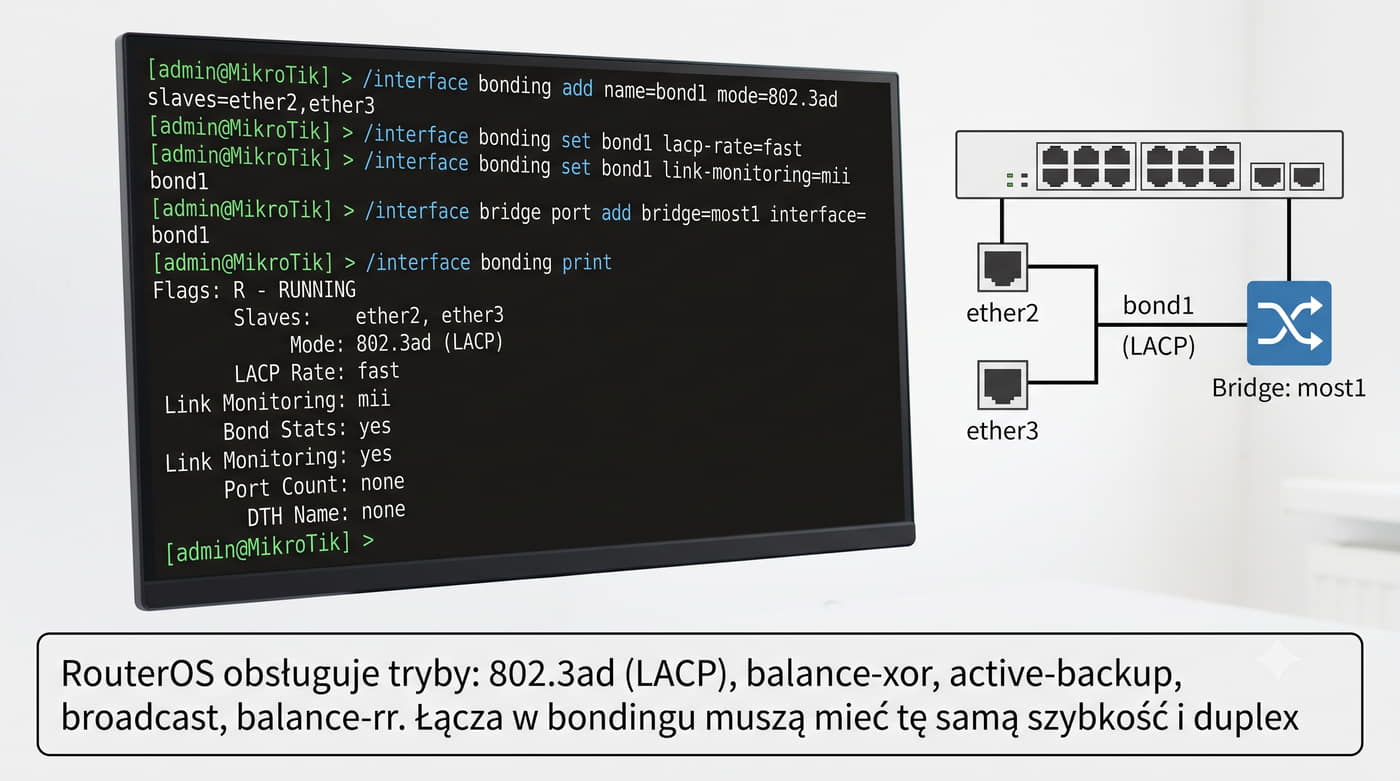
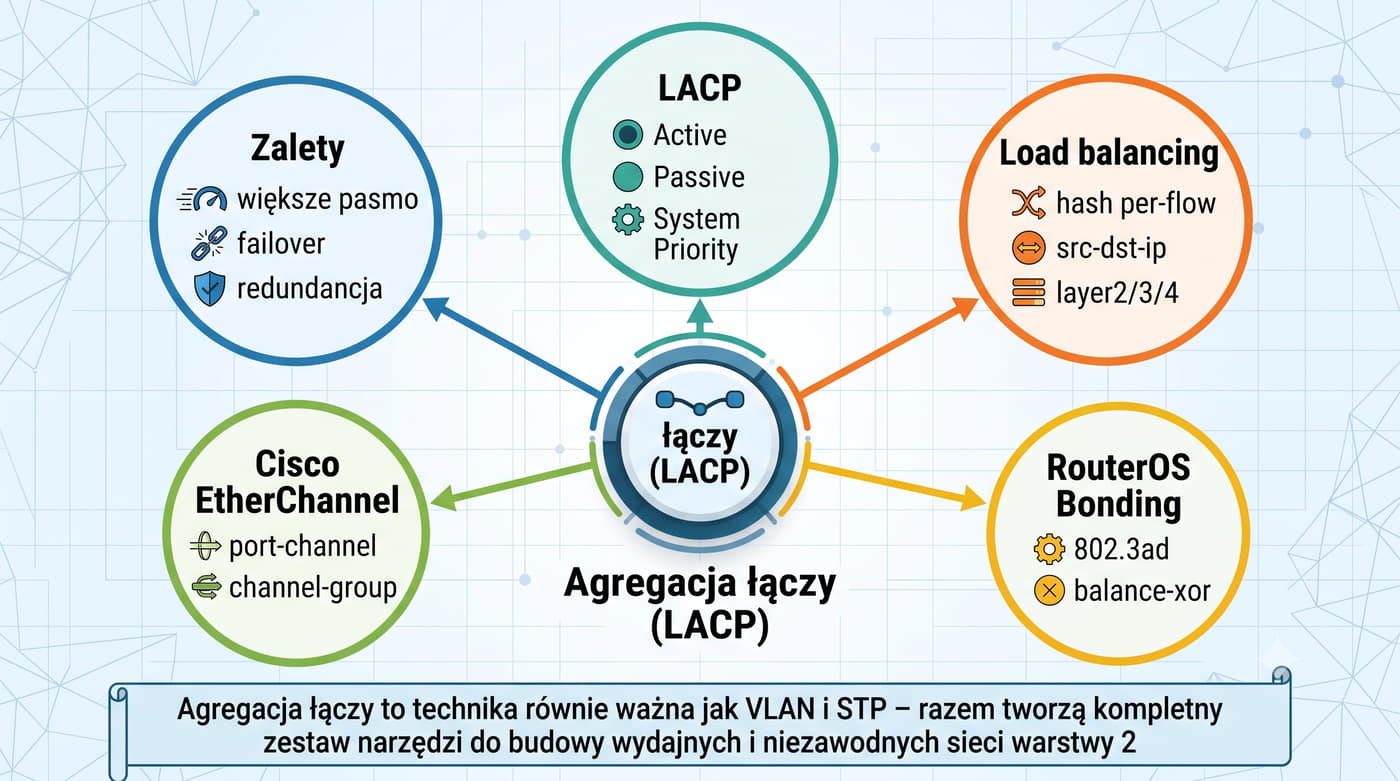
Agregacja łączy (link aggregation) to technika łączenia wielu fizycznych portów w jedno logiczne połączenie, co zwiększa przepustowość i niezawodność sieci. Dzięki niej ruch jest dzielony między kilka portów (zwykle 2-8), a protokół Link Aggregation Control Protocol (LACP) lub 802.3ad zarządza dystrybucją danych i wykrywaniem awarii pojedynczych łączy. Agregacja jest szczególnie użyteczna w środowiskach wymagających dużej przepustowości, takich jak centra danych czy sieci korporacyjne, gdzie zapewnia równoważenie obciążenia i odporność na uszkodzenia. W połączeniu z VLAN-ami i STP tworzy kompleksowe rozwiązanie dla nowoczesnych sieci warstwy 2.

2/55 Streszczenie

VLAN (Virtual LAN) umożliwiają dzielenie jednego przełącznika na izolowane domeny rozgłoszeniowe bez zmiany fizycznej topologii.

Protokół IEEE 802.1Q dodaje znacznik (tag) do ramki Ethernet.

Protokół STP (IEEE 802.1D) zapobiega pętlom w sieci z nadmiarowymi połączeniami.

Agregacja łączy (LACP, IEEE 802.3ad) zwiększa przepustowość i zapewnia niezawodność.

Routing między sieciami VLAN (inter-VLAN routing) odbywa się w warstwie 3 (router-on-a-stick, inter-VLAN routing przełącznika L3).

VLAN (Virtual Local Area Network) to technologia sieciowa, która umożliwia logiczne dzielenie fizycznej sieci lokalnej na mniejsze segmenty, zwane sieciami wirtualnymi. Dzięki temu można zarządzać ruchem sieciowym bardziej efektywnie, izolować ruch między różnymi grupami urządzeń oraz poprawiać bezpieczeństwo i wydajność sieci. VLAN-y są szczególnie przydatne w dużych sieciach korporacyjnych, gdzie konieczne jest zarządzanie ruchem generowanym przez różne działy lub typy urządzeń.

Protokół IEEE 802.1Q jest standardem, który umożliwia implementację VLAN-ów w sieciach Ethernet. Działa on poprzez dodawanie tzw. tagu (znacznika) do każdej ramki Ethernet. Tag ten zawiera informacje o przynależności ramki do konkretnego VLAN-u. Dzięki temu przełączniki mogą filtrować ruch na podstawie tych tagów, kierując go wyłącznie do odpowiednich portów lub interfejsów. To rozwiązanie pozwala na elastyczne zarządzanie siecią bez konieczności fizycznego przepinania kabli.

Protokół STP (Spanning Tree Protocol), a dokładniej jego wersja IEEE 802.1D, jest kluczowym mechanizmem zapobiegającym powstawaniu pętli w sieciach z nadmiarowymi połączeniami (redundant links). STP wybiera jedną ścieżkę jako aktywną (root path), a pozostałe porty przechodzą w stan blokady lub nasłuchu, co zapobiega jednoczesnemu przesyłaniu ramek przez wiele ścieżek i potencjalnym pętlom. W nowocześniejszych sieciach często stosuje się rozszerzenia STP, takie jak Rapid Spanning Tree Protocol (RSTP) czy Multiple Spanning Tree (MST), które oferują szybszą konwergencję i lepsze zarządzanie redundancją.

Agregacja łączy (Link Aggregation Control Protocol, LACP) to technologia umożliwiająca połączenie wielu fizycznych portów w jedno logiczne połączenie, co zwiększa przepustowość i niezawodność transmisji danych. Standard IEEE 802.3ad definiuje zasady tworzenia takich agregacji, które mogą być dynamicznie konfigurowane w zależności od potrzeb sieci. Agregacja łączy jest szczególnie przydatna w środowiskach wymagających dużej przepustowości, takich jak centra danych czy sieci korporacyjne, gdzie wiele serwerów lub urządzeń musi komunikować się z przełącznikami o wysokiej wydajności.

3/55 Literatura

Książki

  1. Sieci komputerowe – Andrew S. Tanenbaum, David J. Wetherall, wyd. Rebis
  2. Routing i switching w sieciach Cisco – Krzysztof Pytel, wyd. WSIP
  3. VLAN, STP, routing – Jarosław Szymanek, wyd. Helion
  4. Sieci Ethernet. Przełączniki i routing – Wojciech Kabaciński, wyd. Wydawnictwo Politechniki Poznańskiej

Źródła internetowe

  1. Dokumentacja Cisco – Konfiguracja i STP – www.cisco.com
  2. MikroTik Wiki – VLAN, Bridge, STP – wiki.mikrotik.com
  3. IEEE 802.1Q – standard tagowania – www.ieee.org
  4. Materiały dydaktyczne Katedry Sieci Telekomunikacyjnych PŁ – www.kst.pl

Literatura dotycząca sieci komputerowych jest niezwykle bogata i różnorodna, co pozwala studentom IT na dogłębne zrozumienie tej dziedziny. Jedną z klasycznych pozycji jest książka "Sieci komputerowe" autorstwa Andrew S. Tanenbauma i Davida J. Wetheralla, wydana przez Rebis. Ta publikacja stanowi fundament wiedzy na temat projektowania, działania i zarządzania sieciami, oferując zarówno teoretyczne podstawy, jak i praktyczne przykłady. Dla osób zainteresowanych technologiami Cisco, nieocenionym źródłem wiedzy jest "Routing i switching w sieciach Cisco" Krzysztofa Pytla (WSIP), która szczegółowo omawia konfigurację urządzeń oraz protokoły routingu.

Warto również zwrócić uwagę na "VLAN, STP, routing" Jarosława Szymanka (Helion), która skupia się na zaawansowanych aspektach sieci lokalnych i protokołach drzewa opinającego. Dla tych, którzy chcą zgłębić temat technologii Ethernet oraz działania przełączników i routerów, polecam "Sieci Ethernet. Przełączniki i routing" Wojciecha Kabacińskiego (Wydawnictwo Politechniki Poznańskiej). Ta książka dostarcza szczegółowych informacji na temat architektury sieci oraz praktycznych aspektów ich wdrażania.

Każda z tych pozycji oferuje unikalne spojrzenie na różne aspekty sieci komputerowych, co czyni je niezbędnymi narzędziami dla każdego studenta IT pragnącego pogłębić swoją wiedzę i umiejętności. Warto korzystać z nich równolegle, aby uzyskać kompleksowe zrozumienie tej dynamicznie rozwijającej się dziedziny.

4/55 Wirtualne sieci LAN – wprowadzenie
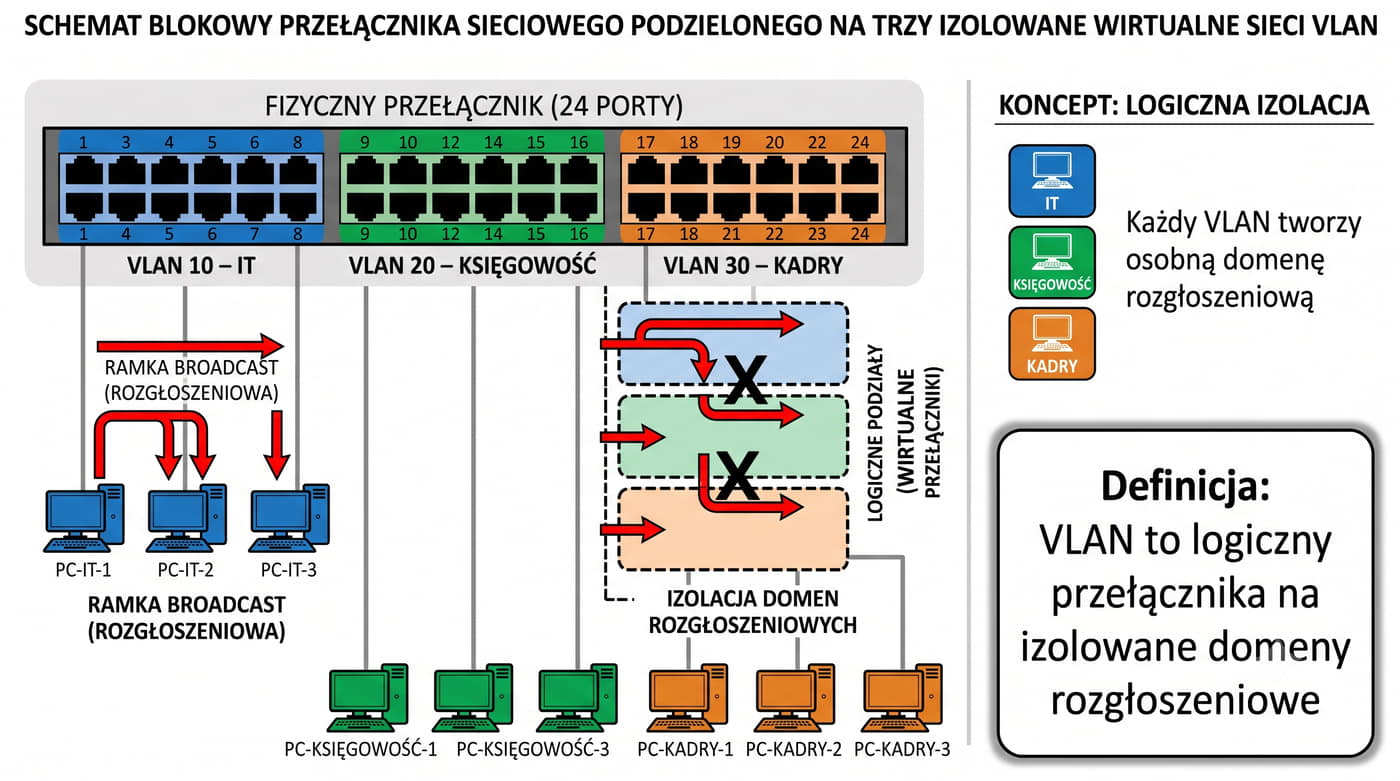
VLAN to logiczny podział przełącznika na izolowane domeny rozgłoszeniowe. Hosty w różnych VLAN-ach nie widzą się wzajemnie na poziomie warstwy 2.

VLAN – przełącznik z obsługą VLAN może jednocześnie obsługiwać kilka izolowanych sieci, nawet jeśli wszystkie urządzenia są podłączone do tego samego sprzętu.

Celem stosowania VLAN jest poprawa bezpieczeństwa (izolacja ruchu między działami), zmniejszenie ruchu broadcast (mniejsza domena rozgłoszeniowa) oraz uproszczenie zarządzania (przeniesienie hosta do innej sieci VLAN bez zmiany fizycznego okablowania).

Wirtualne sieci LAN (VLAN) to zaawansowane narzędzie stosowane w nowoczesnych sieciach komputerowych, które umożliwia logiczny podział fizycznej infrastruktury przełącznika na izolowane segmenty. Dzięki VLAN-om można efektywnie zarządzać ruchem sieciowym i poprawić bezpieczeństwo, uniemożliwiając nieautoryzowany dostęp między różnymi grupami urządzeń. Każdy VLAN działa jak odrębna sieć lokalna (LAN), mimo że wszystkie hosty mogą być fizycznie podłączone do tego samego przełącznika. Izolacja na poziomie warstwy 2 modelu OSI oznacza, że urządzenia z różnych VLAN-ów nie widzą się nawzajem w kontekście adresów MAC i nie mogą bezpośrednio komunikować się ze sobą.

Implementacja VLAN-ów opiera się na przypisaniu portom przełącznika odpowiednich identyfikatorów sieci wirtualnych (VLAN ID). Przełącznik analizuje ramki Ethernet i na podstawie tych identyfikatorów kieruje je wyłącznie do urządzeń znajdujących się w tym samym VLAN-ie. Dzięki temu można tworzyć segmenty sieci dostosowane do konkretnych potrzeb, np. oddzielając ruch gości od ruchu pracowników w sieci korporacyjnej lub izolując urządzenia IoT od krytycznej infrastruktury IT. Współczesne przełączniki oferują zaawansowane funkcje, takie jak trunking (możliwość przesyłania ruchu z wielu VLAN-ów przez jeden port) czy 802.1Q tagging, które ułatwiają zarządzanie złożonymi konfiguracjami.

Zastosowanie VLAN-ów przynosi wiele korzyści, w tym lepsze wykorzystanie pasma (ograniczenie rozgłaszania ramek tylko do odpowiednich segmentów), zwiększenie bezpieczeństwa (izolacja krytycznych systemów) oraz elastyczność w zarządzaniu siecią. Przykładowo, w dużych organizacjach można tworzyć VLAN-y dla różnych działów, co ułatwia monitorowanie i kontrolę ruchu. Warto jednak pamiętać, że izolacja na poziomie warstwy 2 nie zastępuje mechanizmów bezpieczeństwa warstwy 3 (np. firewalli), a jedynie uzupełnia je. Prawidłowa konfiguracja VLAN-ów wymaga zrozumienia topologii sieci oraz potrzeb użytkowników, aby maksymalnie wykorzystać ich potencjał przy minimalnych kosztach infrastrukturalnych.

5/55 VLAN i domena rozgłoszeniowa
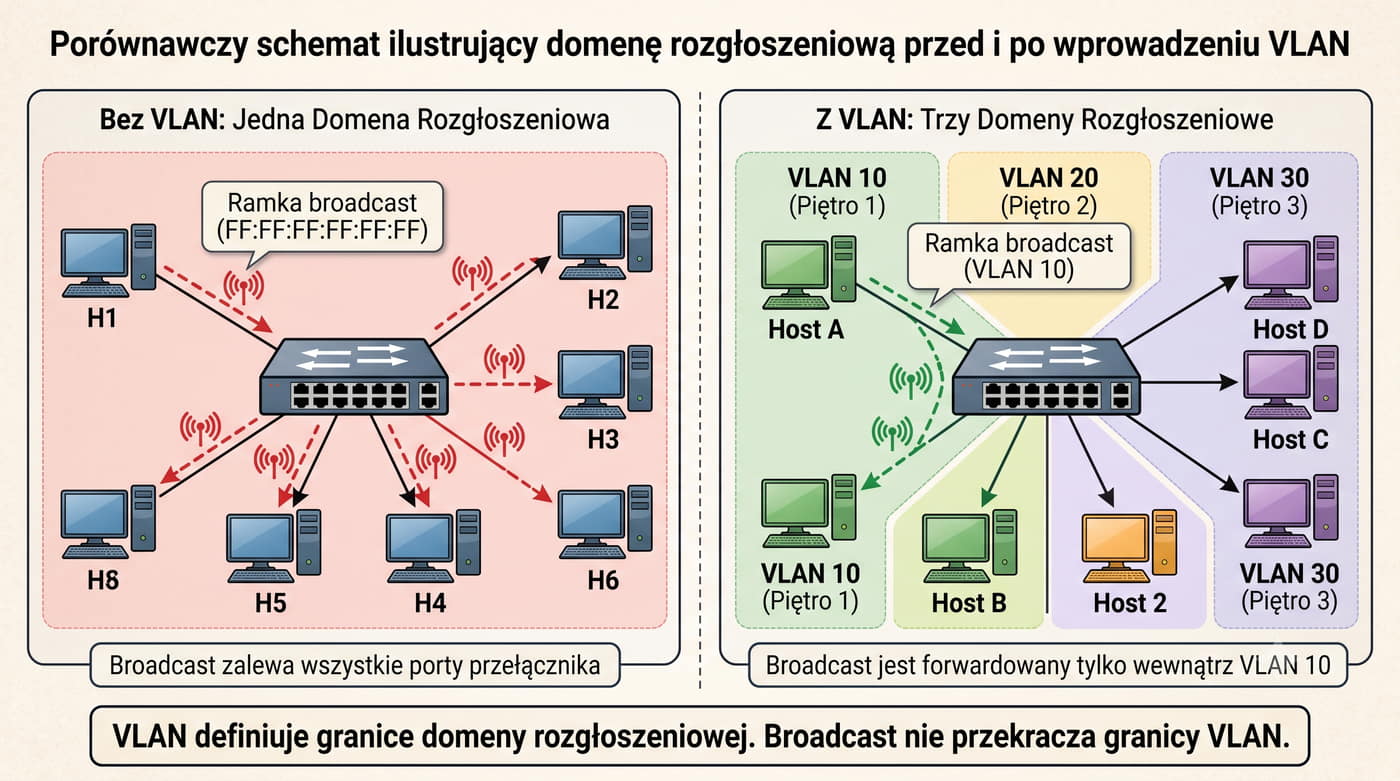
VLAN definiuje granice domeny rozgłoszeniowej. Broadcast nie przekracza granicy VLAN – jest to podstawowa funkcja izolująca.

W tradycyjnej sieci przełączanej bez VLAN wszystkie porty należą do jednej domeny rozgłoszeniowej.

Gdy jakiekolwiek urządzenie wysyła ramkę broadcast (FF:FF:FF:FF:FF:FF), ramka ta jest forwardowana na wszystkie porty przełącznika (poza portem źródłowym), co powoduje niepotrzebne obciążenie wszystkich hostów i ogranicza przepustowość.

Po wprowadzeniu VLAN każda taka sieć wirtualna stanowi odrębną domenę rozgłoszeniową.

VLAN 10 trafia tylko do portów należących do VLAN 10, a nie do VLAN 20 czy 30.

W efekcie zmniejsza się ruch broadcast w sieci, poprawia się wydajność i bezpieczeństwo.

Domena rozgłoszeniowa zostaje zawężona do granic VLAN.

VLAN (Virtual Local Area Network) to technologia sieciowa, która umożliwia logiczne grupowanie urządzeń w sieci lokalnej, tworząc wirtualne podsieci bez fizycznego oddzielenia. Jedną z kluczowych funkcji VLAN jest definiowanie granic domeny rozgłoszeniowej, co oznacza, że ruch rozgłoszeniowy (broadcast) nie opuszcza granic danego VLAN-u. W tradycyjnej sieci przełączanej bez segmentacji na VLAN wszystkie porty switcha należą do jednej domeny rozgłoszeniowej, co może prowadzić do niepożądanego ruchu i obciążenia sieci.

Dzięki VLAN-om możliwe jest ograniczenie zasięgu ramek broadcast, multicast i unknown unicast tylko do urządzeń znajdujących się w tym samym VLAN-ie. To nie tylko poprawia wydajność sieci, ale także zwiększa jej bezpieczeństwo, ponieważ ogranicza możliwość nieautoryzowanego dostępu do innych segmentów sieci. W praktyce oznacza to, że jeśli dwa urządzenia znajdują się w różnych VLAN-ach, ramka broadcast wysłana przez jedno z nich nie dotrze do drugiego.

Konfiguracja VLAN-ów obejmuje przypisanie portów switcha do określonych sieci VLAN oraz ustawienie odpowiednich parametrów, takich jak identyfikator VLAN (VLAN ID) czy trunk protocol. W nowoczesnych przełącznikach można również stosować bardziej zaawansowane mechanizmy, takie jak segmentacja oparta na protokołach (np. IPv6) czy control-plane ACL, co pozwala na jeszcze lepszą kontrolę nad ruchem sieciowym. Warto również wspomnieć o roli portów trunk, które umożliwiają przesyłanie ruchu z wielu VLAN-ów przez jeden fizyczny interfejs switcha.

6/55 VLAN
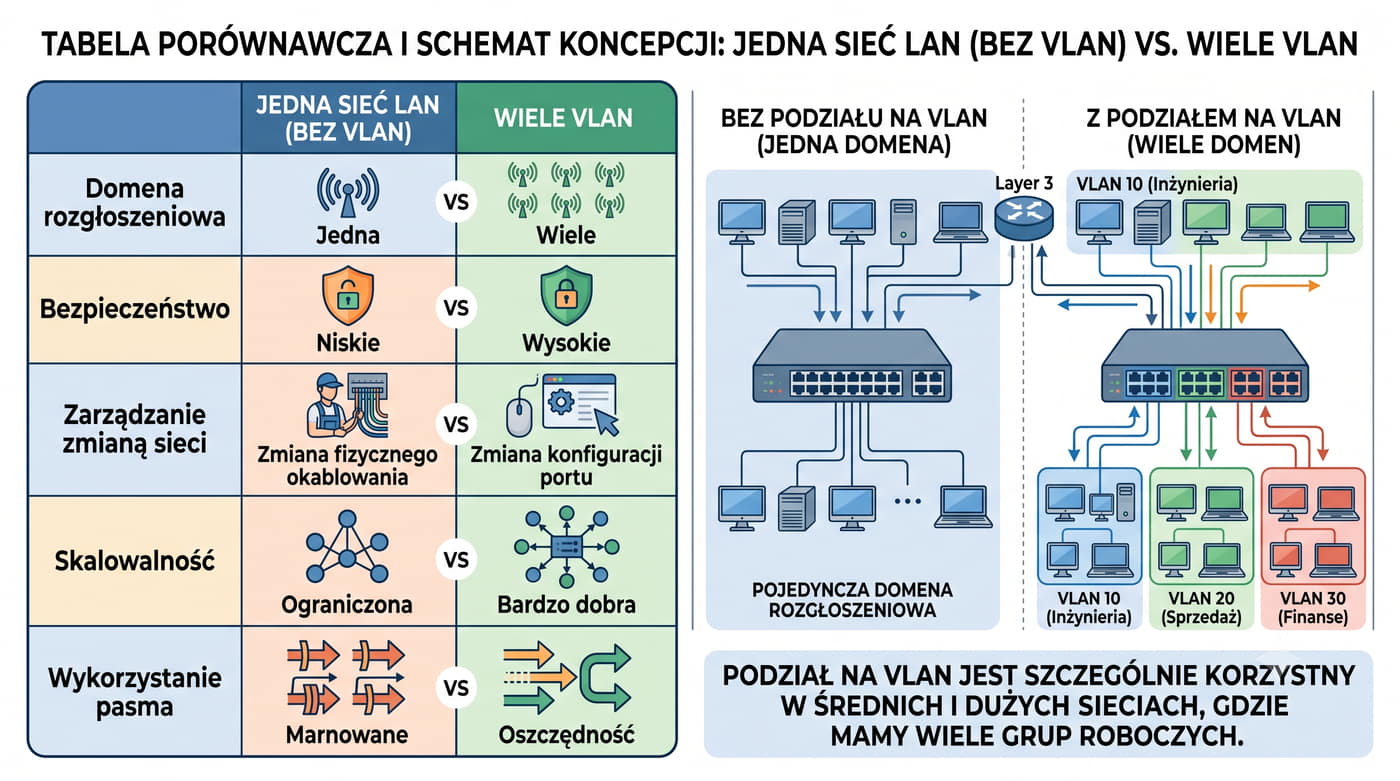
CechaJedna sieć LAN (bez VLAN)Wiele VLAN
Domena rozgłoszeniowaJedna – wszyscy widzą broadcastWiele – broadcast ograniczony do VLAN
BezpieczeństwoNiskie – każdy host może komunikować się z każdymWysokie – domyślnie brak komunikacji między VLAN
Zarządzanie zmianą sieciZmiana fizycznego okablowaniaZmiana konfiguracji portu (przypisanie do VLAN)
SkalowalnośćOgraniczona (duża domena broadcast)Bardzo dobra (segmentacja VLAN)
Wykorzystanie pasmaMarnowane na broadcast w całej sieciOszczędność – broadcast tylko w obrębie źródła VLAN

Podział na VLAN jest szczególnie korzystny w średnich i dużych sieciach, gdzie mamy wiele grup roboczych (działy: księgowość, IT, kadry).

Zamiast kupować osobny przełącznik dla każdego działu, wystarczy jeden przełącznik z VLAN-ami.

VLAN, czyli Virtual Local Area Network, to technologia umożliwiająca logiczne dzielenie fizycznej sieci LAN na mniejsze podsieci. Dzięki temu można zarządzać ruchem sieciowym bardziej efektywnie, poprawiać bezpieczeństwo i segmentować sieć w sposób odpowiadający potrzebom organizacji. W przeciwieństwie do tradycyjnej sieci LAN, gdzie cały ruch jest widoczny dla wszystkich urządzeń, VLAN-y ograniczają broadcast do konkretnych grup, co zmniejsza obciążenie sieci i zwiększa jej wydajność.

Tworzenie VLAN-ów jest szczególnie przydatne w dużych organizacjach, gdzie różne działy lub grupy użytkowników mają odmienne wymagania dotyczące bezpieczeństwa i przepustowości. Na przykład, dział IT może mieć osobny VLAN od działu księgowości, co zapobiega nieautoryzowanemu dostępowi do wrażliwych danych finansowych. Ponadto, VLAN-y mogą być używane do izolowania ruchu gościnnego od ruchu wewnętrznego, co dodatkowo zwiększa bezpieczeństwo sieci.

Zarządzanie zmianami w konfiguracji VLAN-ów jest stosunkowo proste dzięki nowoczesnym przełącznikom sieciowym, które oferują zaawansowane funkcje takie jak dynamiczne przypisywanie portów do VLAN-ów czy automatyczne negocjowanie ustawień. W przeszłości zmiana fizycznego okablowania była konieczna, ale obecnie większość zmian można wprowadzić zdalnie przez interfejs zarządzania przełącznikiem. To sprawia, że VLAN-y są elastycznym narzędziem do zarządzania siecią, które może być dostosowane do zmieniających się potrzeb organizacji.

7/55 Tagowanie ramek – IEEE 802.1Q
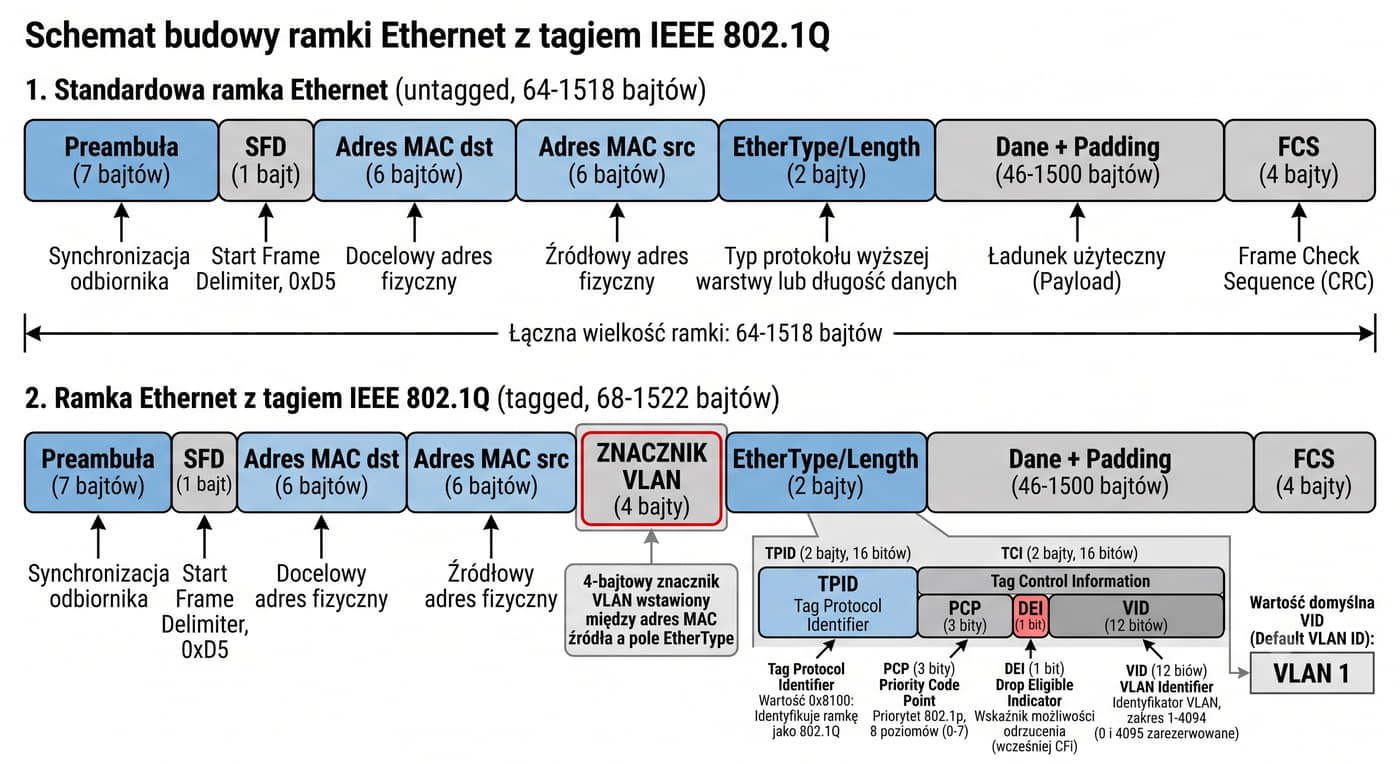
IEEE 802.1Q dodaje do ramki Ethernet 4-bajtowy znacznik zawierający 12-bitowy identyfikator VLAN (VID) i 3-bitowy priorytet (PCP).

Standard IEEE 802.1Q definiuje sposób dodawania znacznika (tag) do ramki Ethernet.

Znacznik ma długość 4 bajtów i jest wstawiany pomiędzy adres źródłowy MAC a pole EtherType/Length.

W jego skład wchodzą dwa pola: Tag Protocol Identifier (TPID) – 2 bajty o wartości 0x8100, informujące, że ramka zawiera tag, oraz Tag Control Information (TCI) – 2 bajty.

TCI dzieli się na trzy części: PCP (Priority Code Point) – 3 bity, określa priorytet IEEE 802.1p (0-7); DEI (Drop Eligible Indicator) – 1 bit, wskazuje czy ramkę można odrzucić przy przeciążeniu; VID (Identifier) – 12 bitów, identyfikator (1-4094).

Format ramki po dodaniu tagu zwiększa jej długość z 64-1518 bajtów do 68-1522 bajtów.

IEEE 802.1Q to standard, który wprowadza technologię VLAN (Virtual Local Area Network) do sieci Ethernet, umożliwiając logiczne grupowanie portów lub urządzeń w segmenty bez fizycznego dzielenia infrastruktury. Dzięki temu można zarządzać ruchem sieciowym bardziej efektywnie, izolując ruch między określonymi grupami urządzeń lub aplikacji. VLAN jest identyfikowany za pomocą 12-bitowego identyfikatora VID (VLAN Identifier), który jest umieszczany w znaczniku ramki Ethernet.

Znacznik IEEE 802.1Q ma długość czterech bajtów i składa się z dwóch pól: TPID (2 bajty o wartości 0x8100) oraz TCI (2 bajty). Pole TCI zawiera: 3-bitowy PCP (Priority Code Point) określający priorytet IEEE 802.1p (0-7), 1-bitowy DEI (Drop Eligible Indicator) oraz 12-bitowy VID (VLAN Identifier) o wartości 1-4094. TPID o wartości 0x8100 informuje, że ramka zawiera tag 802.1Q.

Implementacja IEEE 802.1Q pozwala na tworzenie tysięcy unikalnych VLANów (dopuszczalne identyfikatory 1-4094), co daje ogromne możliwości konfiguracyjne w dużych sieciach korporacyjnych. Dzięki temu standardowi można np. wydzielić ruch związany z głosowymi usługami VoIP do osobnego VLAN, co gwarantuje odpowiedni priorytet i jakość transmisji. Ponadto, mostkowanie (switching) między portami należącymi do tego samego VLAN odbywa się bez udziału przełączników rdzennych, co zmniejsza obciążenie sieci szkieletowej. Warto również wspomnieć, że IEEE 802.1Q jest kompatybilny wstecz z klasycznymi ramkami Ethernet, co ułatwia migrację do nowych rozwiązań.

8/55 Porty Access i Trunk
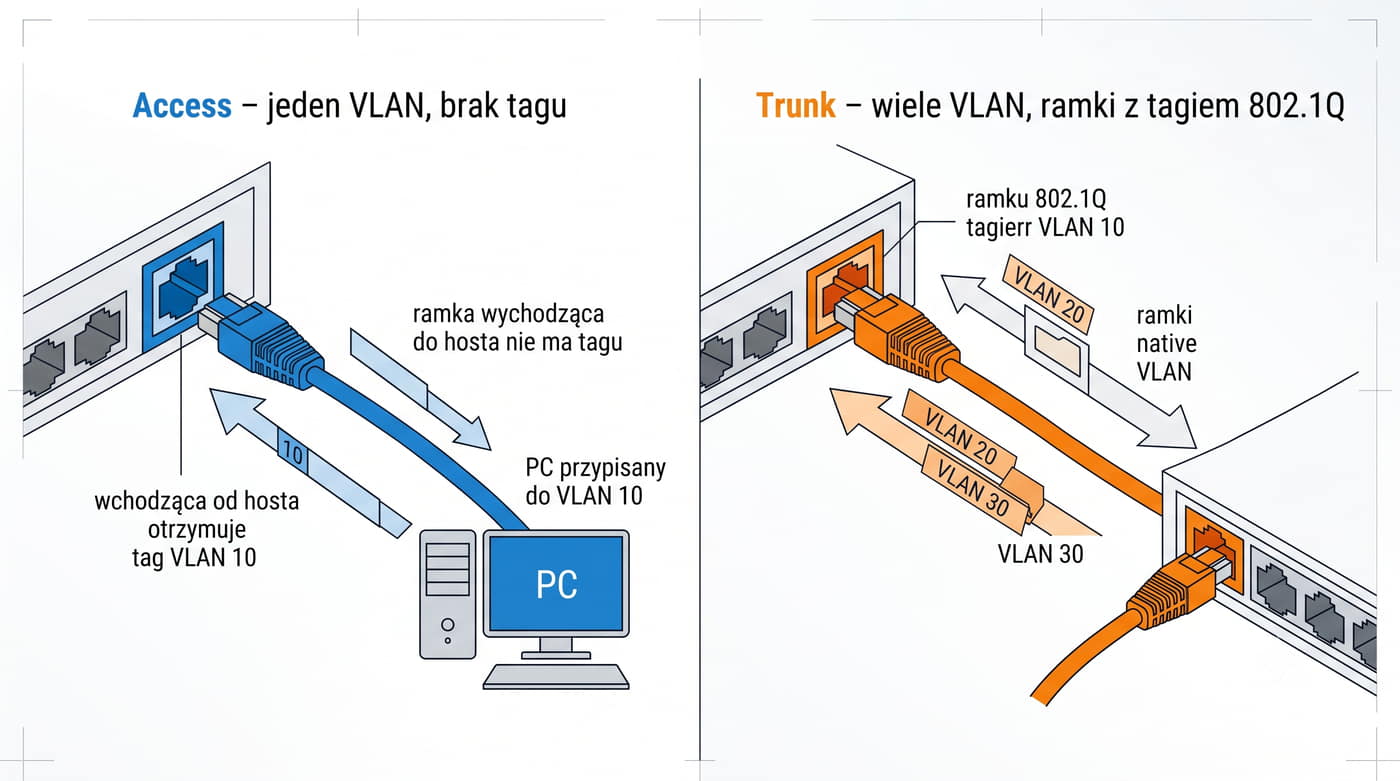
Port Access – jeden VLAN, brak tagu. Port Trunk – wiele VLAN, ramki z tagiem 802.1Q.

Host nie jest świadomy istnienia VLAN.

W kontekście VLAN porty przełącznika dzielą się na dwa typy: Access i Trunk.

Port Access należy do jednego VLAN (ID 1) i przesyła ramki bez tagu.

Gdy host (PC, drukarka) wysyła ramkę, przełącznik dodaje tag przypisanego do portu przed przekazaniem ramki do innych portów.

Gdy ramka jest wysyłana do hosta, tag jest usuwany.

Port Trunk przesyła ramki z zachowaniem tagów 802.1Q i może obsługiwać wiele VLAN jednocześnie.

Trunk łączy dwa przełączniki lub przełącznik z routerem.

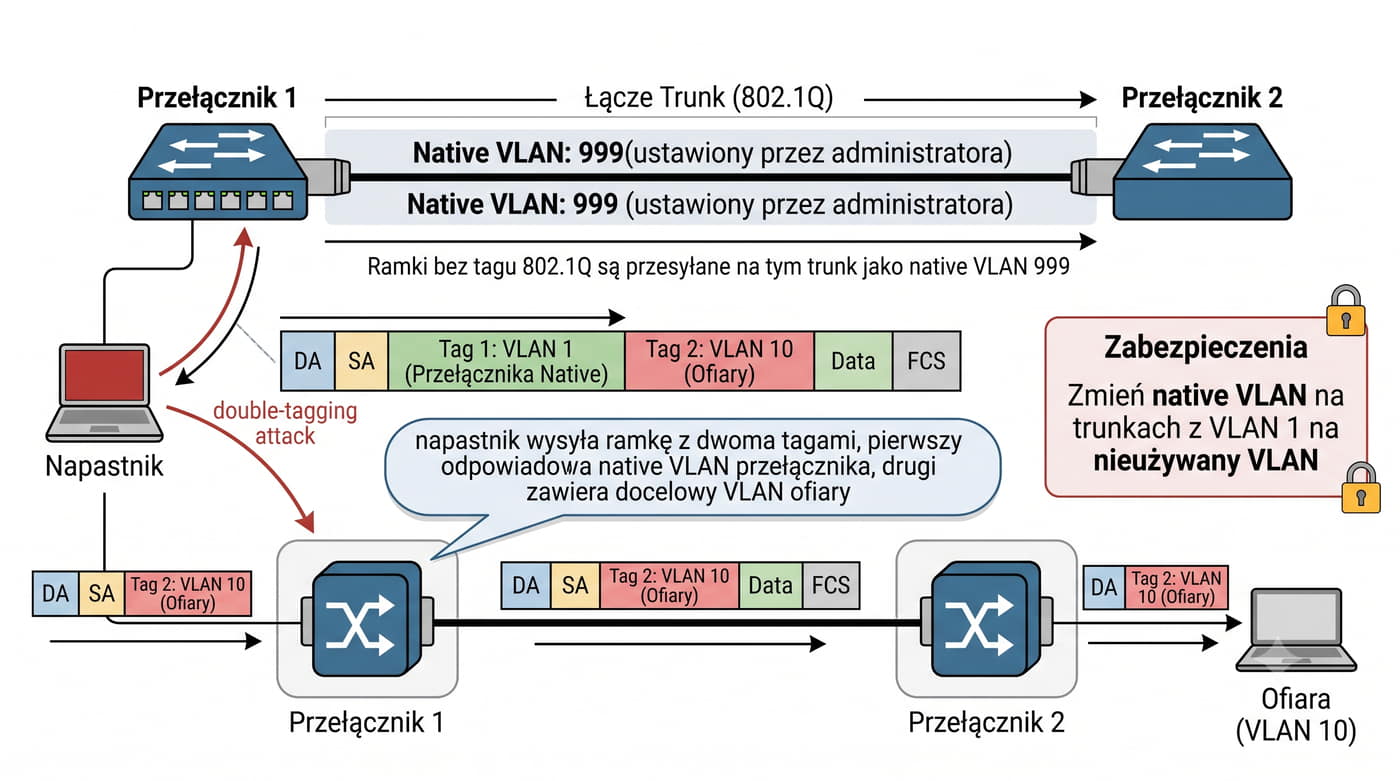
VLAN native (domyślnie 1) to VLAN, którego ramki są przesyłane bez tagu po stronie trunk.

Porty Access i Trunk są kluczowymi elementami w architekturze sieci opartej na VLAN (Virtual Local Area Network). Port Access jest przypisany do jednego konkretnego VLAN, zazwyczaj o ID równym 1, co oznacza, że wszystkie ramki przesyłane przez ten port są bez tagu 802.1Q. Jest to standardowe rozwiązanie dla urządzeń końcowych, takich jak komputery PC czy drukarki, które nie muszą być świadome istnienia VLAN - po prostu działają w ramach jednej sieci wirtualnej.

Z kolei port Trunk jest bardziej zaawansowany i umożliwia przesyłanie ramek z tagiem 802.1Q, co oznacza, że może obsługiwać wiele VLAN jednocześnie. Jest to szczególnie przydatne w dużych sieciach, gdzie konieczne jest segmentowanie ruchu na różne grupy urządzeń lub aplikacji bez fizycznego przewodowego podziału sieci. Port Trunk łączy się z innymi przełącznikami, tworząc tzw. trunk lines, które mogą przenosić ruch z wielu VLAN między segmentami sieci.

Ważnym aspektem jest to, że host podłączony do portu Access nie jest świadomy istnienia VLAN - działa tak, jakby był podłączony bezpośrednio do przełącznika w jednej sieci. Natomiast ruch między VLAN odbywa się na poziomie przełączników, które muszą być skonfigurowane do obsługi trunkingu i wymiany ramek z tagami. Dzięki temu możliwe jest efektywne zarządzanie siecią, izolowanie ruchu krytycznego oraz optymalizacja wykorzystania pasma.

9/55 VLAN 1
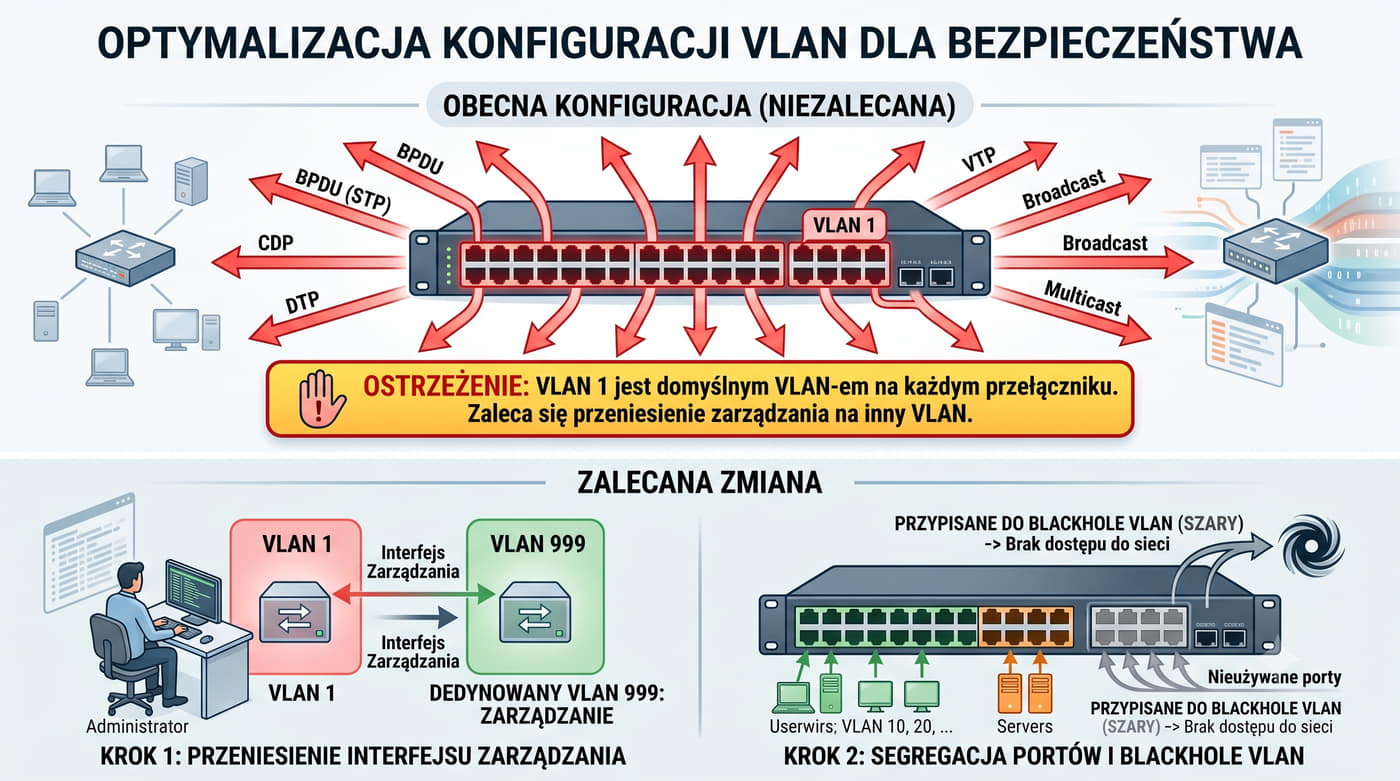
VLAN 1 jest domyślnym VLAN-em na każdym przełączniku. Zaleca się przeniesienie zarządzania na inny VLAN i wyłączenie nieużywanych portów z VLAN 1.

VLAN 1 odpowiada za ramki zarządcze, takie jak BPDU (STP), CDP (Cisco Discovery Protocol), DTP, VTP oraz ruch broadcast.

VLAN 1 jest często nazywany VLAN-em zarządczym.

Ze względów bezpieczeństwa zaleca się przeniesienie ruchu zarządczego do innego, dedykowanego VLAN (np. VLAN 999).

Używanie VLAN 1 jako domyślnego dla wszystkich portów stanowi potencjalne ryzyko, ponieważ atakujący może wykorzystać ruch zarządczy do przeprowadzenia ataku na przełącznik.

Nie używaj VLAN 1 do ruchu danych.

VLAN 1 jest domyślnym siecią wirtualną (VLAN) dostępną na każdym przełączniku, co oznacza, że urządzenia podłączone do portów nieprzypisanych do żadnego innego VLAN automatycznie znajdują się w VLAN 1. Ta sieć pełni kluczową rolę w zarządzaniu ruchem związanym z protokołami takimi jak BPDU (Bridge Protocol Data Unit) używanym w Spanning Tree Protocol, CDP (Cisco Discovery Protocol), DTP (Dynamic Port Mode Protocol) oraz VTP (VLAN Trunking Protocol). Ponadto, VLAN 1 obsługuje ruch broadcast, czyli ramki rozgłoszeniowe, które są wysyłane do wszystkich urządzeń w sieci.

Ze względu na swoje szerokie zastosowanie, VLAN 1 jest często wykorzystywany przez różne mechanizmy diagnostyczne i konfiguracyjne przełączników. Dlatego też zaleca się przeniesienie ruchu związanego z zarządzaniem na dedykowany VLAN, co pozwala uniknąć potencjalnych zakłóceń w komunikacji między urządzeniami. Dodatkowo, wyłączenie nieużywanych portów z VLAN 1 może przyczynić się do poprawy bezpieczeństwa i wydajności sieci, minimalizując ryzyko nieautoryzowanego dostępu oraz zmniejszając obciążenie przełącznika.

W praktyce, zarządzanie VLAN 1 wymaga szczególnej uwagi, ponieważ błędna konfiguracja może prowadzić do problemów z dostępnością usług sieciowych lub naruszenia integralności danych. Warto również pamiętać, że niektóre urządzenia mogą wymagać specjalnych ustawień, aby poprawnie funkcjonować w ramach VLAN 1, co dodatkowo podkreśla znaczenie dokładnego planowania i testowania konfiguracji sieciowej. W związku z tym, dobre praktyki zalecają regularne przeglądy i aktualizacje ustawień VLAN 1, aby zapewnić optymalną pracę całej infrastruktury sieciowej.

10/55 VLAN native na interfejsie trunk

VLAN native to VLAN 1 domyślnie na każdym interfejsie trunk.

W Cisco IOS zmienia się go poleceniem switchport trunk native vlan <numer>.

Native VLAN po obu stronach trunk musi być taki sam – w przeciwnym razie ramki bez tagu (np. BPDU, CDP) będą kierowane do różnych VLAN, co może spowodować problemy z komunikacją i bezpieczeństwem.

W szczególności atak double-tagging (VLAN hopping) wykorzystuje niezgodność native VLAN do przenikania między VLAN.

Native VLAN – jest to VLAN, dla którego ramki są przesyłane bez tagu 802.1Q.

Jest przypisany do danego interfejsu.

Mechanizm ten zapewnia kompatybilność ze starszymi urządzeniami, które nie obsługują tagowania.

VLAN native to koncepcja stosowana w sieciach opartych na protokole 802.1Q, gdzie każdy interfejs trunk (czyli taki, który może przenosić wiele sieci VLAN) ma przypisany jeden domyślny VLAN, zwany właśnie native VLAN. Ten VLAN jest używany do transmisji ramek bez oznaczenia VLAN (czyli tzw. ramek natywnych), takich jak ramki BPDU (Bridge Protocol Data Unit) czy CDP (Cisco Discovery Protocol). Ustawienie native VLAN jest kluczowe dla poprawnego działania mechanizmów zarządzania i diagnostyki sieci.

W systemach Cisco IOS, ustawienie native VLAN na interfejsie trunk można zmienić za pomocą polecenia switchport trunk native vlan <numer>. Numer VLAN musi być taki sam po obu stronach łącza trunk (np. na switchu A i switchu B), aby ramki natywne były poprawnie kierowane. Jeśli numery różnią się, może to prowadzić do nieprawidłowego przesyłania ważnych informacji diagnostycznych lub zarządzających, co potencjalnie utrudnia monitorowanie i rozwiązywanie problemów sieciowych.

Warto również wspomnieć, że niektóre urządzenia mogą mieć domyślnie ustawiony native VLAN na wartość 1 (VLAN natywny), co jest zgodne ze standardem IEEE 802.1Q. Jednak w praktyce, szczególnie w dużych sieciach korporacyjnych, często stosuje się inne numery VLAN dla celów zarządzania i segmentacji ruchu. Dlatego ważne jest, aby administratorzy sieci dokładnie planowali konfigurację native VLAN, uwzględniając potrzeby monitoringu, bezpieczeństwa oraz wydajności sieci.

11/55 VLAN na przełączniku Cisco
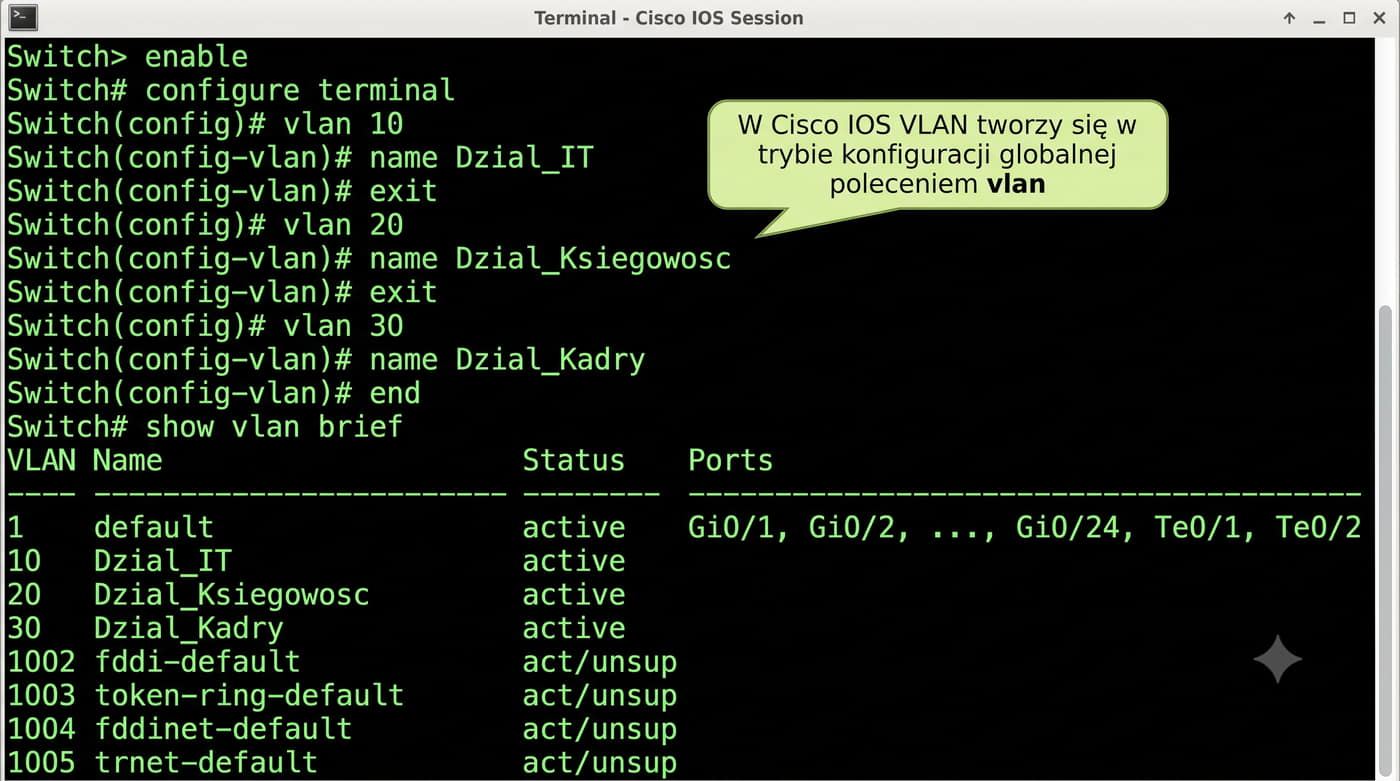
enable
configure terminal
vlan 10
 name Dzial_IT
exit
vlan 20
 name Dzial_Ksiegowosc
exit
vlan 30
 name Dzial_Kadry
end
show vlan brief
! Wyświetlenie wszystkich VLAN i przypisanych portów

W Cisco IOS VLAN tworzy się w trybie konfiguracji globalnej poleceniem vlan.

Każdy VLAN ma numer (1-4094) oraz opcjonalną nazwę tekstową.

Po utworzeniu VLAN jest dostępny na przełączniku i można do niego przypisywać porty.

Polecenie show vlan brief wyświetla tabelę z numerem, nazwą, statusem oraz portami przypisanymi do każdego VLAN.

VLAN nieaktywny (nieprzypisany do żadnego portu) widnieje jako inactive.

VLAN (Virtual Local Area Network) to technologia sieciowa umożliwiająca logiczne segmentowanie ruchu w obrębie jednej fizycznej sieci lokalnej, co pozwala na zarządzanie ruchem i poprawę wydajności oraz bezpieczeństwa. Na przełącznikach Cisco konfiguracja VLAN odbywa się za pomocą polecenia vlan w trybie globalnym. Każdy VLAN jest identyfikowany unikalnym numerem z zakresu 1-4094, a dodatkowo może być opatrzony nazwą (np. name Dzial_IT) dla lepszej identyfikacji i zarządzania. Przykładowa konfiguracja pokazana na slajdzie tworzy trzy VLAN-y: 10, 20 i 30, każdy z przypisaną nazwą odpowiadającą działom firmy.

Po utworzeniu VLAN-ów konieczne jest przypisanie portów przełącznika do odpowiednich sieci VLAN za pomocą polecenia switchport access vlan <numer>. Na przykład, aby port FastEthernet 0/1 należał do VLAN 10, używa się komendy switchport access vlan 10. Dzięki temu urządzenia podłączone do tego portu będą częścią sieci VLAN 10. Można również tworzyć tzw. trunki, czyli porty przenoszące ruch z wielu VLAN-ów jednocześnie, co jest przydatne w większych sieciach korporacyjnych.

Zarządzanie VLAN-ami ułatwia polecenie show vlan brief, które wyświetla listę wszystkich skonfigurowanych sieci VLAN wraz z informacjami takimi jak numer, nazwa, liczba portów i urządzeń należących do danego VLAN. Dodatkowo, zaawansowane opcje konfiguracji obejmują ustawienia jakości usług (QoS), izolację ruchu czy tworzenie sieci VTP (VLAN Trunking Protocol) dla centralnego zarządzania VLAN-ami w dużych środowiskach. Dzięki tym funkcjom przełączniki Cisco oferują elastyczne i skalowalne rozwiązania do segmentacji sieci.

12/55 VLAN w RouterOS
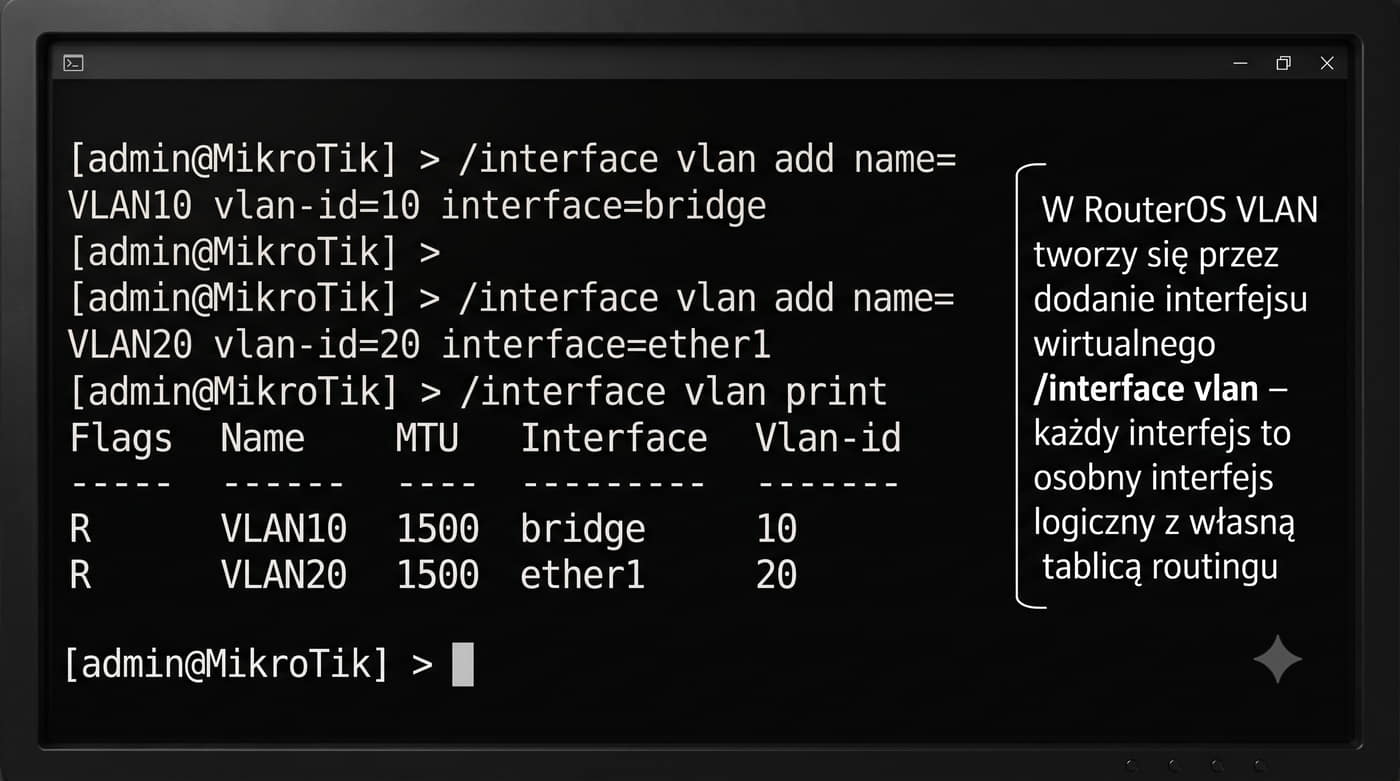
/interface vlan add name=VLAN10 vlan-id=10 interface=bridge
 10 na moście

/interface vlan add name=VLAN20 vlan-id=20 interface=ether1
 20 na interfejsie fizycznym ether1

/interface print
# Wyświetlenie wszystkich interfejsów 

W RouterOS (MikroTik) tworzy się przez dodanie interfejsu wirtualnego /interface.

Interfejs jest tworzony na konkretnym interfejsie fizycznym (most lub ethernet) i otrzymuje identyfikator (VID).

Do takiego interfejsu można przypisać adres IP lub dodać go do mostu.

W RouterOS każdy interfejs to osobny interfejs logiczny z własną tablicą routingu i możliwością przypisania reguł firewalla.

W przeciwieństwie do klasycznego modelu przełącznika Cisco, RouterOS nie ma globalnej bazy VLAN – istnieje jako interfejs, a nie wpis w bazie danych.

VLAN (Virtual Local Area Network) to technologia umożliwiająca logiczne grupowanie urządzeń w sieci lokalnej, co pozwala na segmentację ruchu i zarządzanie nim niezależnie od fizycznego połączenia. W systemie RouterOS firmy MikroTik konfiguracja VLAN jest realizowana poprzez tworzenie wirtualnych interfejsów sieciowych. Przykładowo, aby dodać nowy VLAN na moście (bridge), używa się polecenia /interface vlan add name=VLAN10 vlan-id=10 interface=bridge. To tworzy wirtualny interfejs o identyfikatorze 10, przypisany do mostka. Jeśli chcemy utworzyć VLAN na fizycznym interfejsie, np. ether1, używamy /interface vlan add name=VLAN20 vlan-id=20 interface=ether1. Po dodaniu VLAN można sprawdzić wszystkie skonfigurowane interfejsy za pomocą polecenia /interface print, co jest przydatne do weryfikacji ustawień.

Konfiguracja VLAN w RouterOS pozwala na efektywne zarządzanie siecią, umożliwiając izolację ruchu między różnymi segmentami sieci. Dzięki temu można np. oddzielić ruch gości od ruchu wewnętrznego firmy lub zapewnić QoS (Quality of Service) dla określonych usług. Ważne jest, aby pamiętać o poprawnym przypisaniu portów do VLAN na przełącznikach i routerach. W RouterOS ruch między VLAN-ami jest realizowany przez router lub interfejsy wirtualne VLAN (VLAN-interface) przypisane do mostu. Warto również zwrócić uwagę na konfigurację routingu między VLANami, co może wymagać dodatkowych ustawień, takich jak tagowanie ramek (802.1Q) i odpowiednie reguły routingu.

W praktyce, konfiguracja VLAN w RouterOS jest kluczowa dla zaawansowanego zarządzania siecią. Pozwala na tworzenie logicznych segmentów sieci bez konieczności fizycznego dzielenia infrastruktury. Przykładowo, w małej firmie można utworzyć osobne VLAN dla działu IT, księgowości i produkcji, co ułatwia zarządzanie dostępem i bezpieczeństwem. Warto również pamiętać o konfiguracji firewalli i innych mechanizmów bezpieczeństwa na poziomie VLAN, aby dodatkowo zwiększyć ochronę sieci. MikroTik oferuje elastyczne narzędzia do zarządzania VLAN, co czyni go popularnym wyborem wśród administratorów sieciowych. Dzięki temu można łatwo dostosować konfigurację do specyficznych wymagań organizacji, zapewniając optymalną wydajność i bezpieczeństwo.

13/55 Przypisanie portów access w Cisco IOS
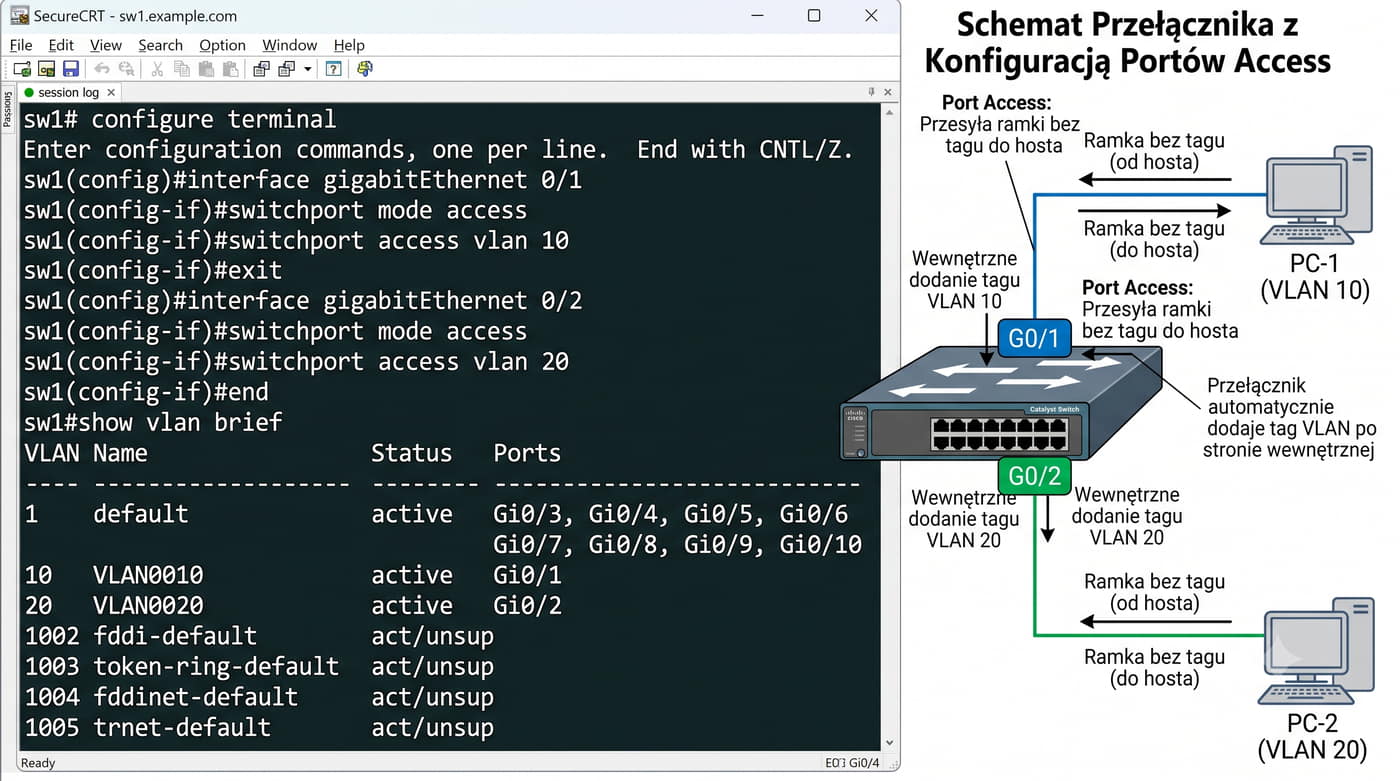
interface GigabitEthernet0/1
 switchport mode access
 switchport access vlan 10
exit
VLAN 10 w trybie access

interface GigabitEthernet0/2
 switchport mode access
 switchport access vlan 20
end
VLAN 20 w trybie access

Po skonfigurowaniu portów polecenie show vlan brief pokaże, które porty należą do którego VLAN.

Port nieprzypisany do żadnego VLAN należy do VLAN 1.

Aby zmienić VLAN portu, wystarczy ponownie wydać polecenie switchport access vlan.

W Cisco IOS port przełącznika konfiguruje się jako access mode i przypisuje do konkretnego VLAN.

Port access przesyła ramki bez tagu do hosta, a przełącznik automatycznie dodaje tag po stronie wewnętrznej.

Przypisanie portów w trybie access w Cisco IOS jest kluczowym elementem konfiguracji sieci VLAN. Porty w trybie access są używane do podłączania urządzeń końcowych, takich jak komputery czy drukarki, i muszą być przypisane do odpowiedniego VLAN, aby zapewnić prawidłową segmentację ruchu sieciowego. W przykładzie na slajdzie pokazano, jak skonfigurować dwa porty gigabitEthernet: pierwszy do VLAN 10, a drugi do VLAN 20. Polecenie switchport mode access ustawia interfejs w tryb access, co oznacza, że będzie on działał jako punkt dostępowy dla urządzeń końcowych. Następnie polecenie switchport access vlan przypisuje port do określonego VLAN. Ważne jest, aby po konfiguracji sprawdzić przynależność portów do VLAN za pomocą polecenia show vlan brief, co pozwala zweryfikować poprawność ustawień. Port nieprzypisany do żadnego VLAN należy do tzw. VLAN default, który zazwyczaj ma numer 1.

Konfiguracja portów w trybie access jest istotna dla zarządzania ruchem sieciowym i bezpieczeństwem. Przypisanie portów do różnych VLAN umożliwia izolację ruchu między różnymi segmentami sieci, co jest szczególnie ważne w dużych organizacjach, gdzie różne działy lub usługi mogą wymagać oddzielnych sieci VLAN. Na przykład, VLAN 10 może być używany dla serwerów, podczas gdy VLAN 20 dla stacji roboczych. Dzięki temu ruch między tymi segmentami jest ograniczony tylko do potrzebnych połączeń, co zwiększa bezpieczeństwo i wydajność sieci. Warto również pamiętać, że porty w trybie access nie mogą być używane jako trunki, co oznacza, że nie mogą przenosić wielu VLAN jednocześnie - są przeznaczone wyłącznie do przypisania do jednego VLAN.

W zaawansowanych konfiguracjach sieciowych można spotkać się z potrzebą dynamicznego przypisywania portów do VLAN, co jest realizowane za pomocą mechanizmów takich jak 802.1X czy VMPS (VLAN Membership Policy Server) w sieciach Cisco. Te technologie umożliwiają automatyczne dostosowywanie przynależności portów do VLAN w zależności od typu urządzenia końcowego. Jest to szczególnie przydatne w środowiskach o dużej dynamice zmian. Ponadto, w nowoczesnych przełącznikach Cisco można korzystać z funkcji takich jak VLAN policies, które pozwalają na bardziej elastyczne i zaawansowane zarządzanie przypisaniem portów do VLAN. Wszystkie te mechanizmy mają na celu uproszczenie zarządzania siecią i zwiększenie jej niezawodności oraz bezpieczeństwa.

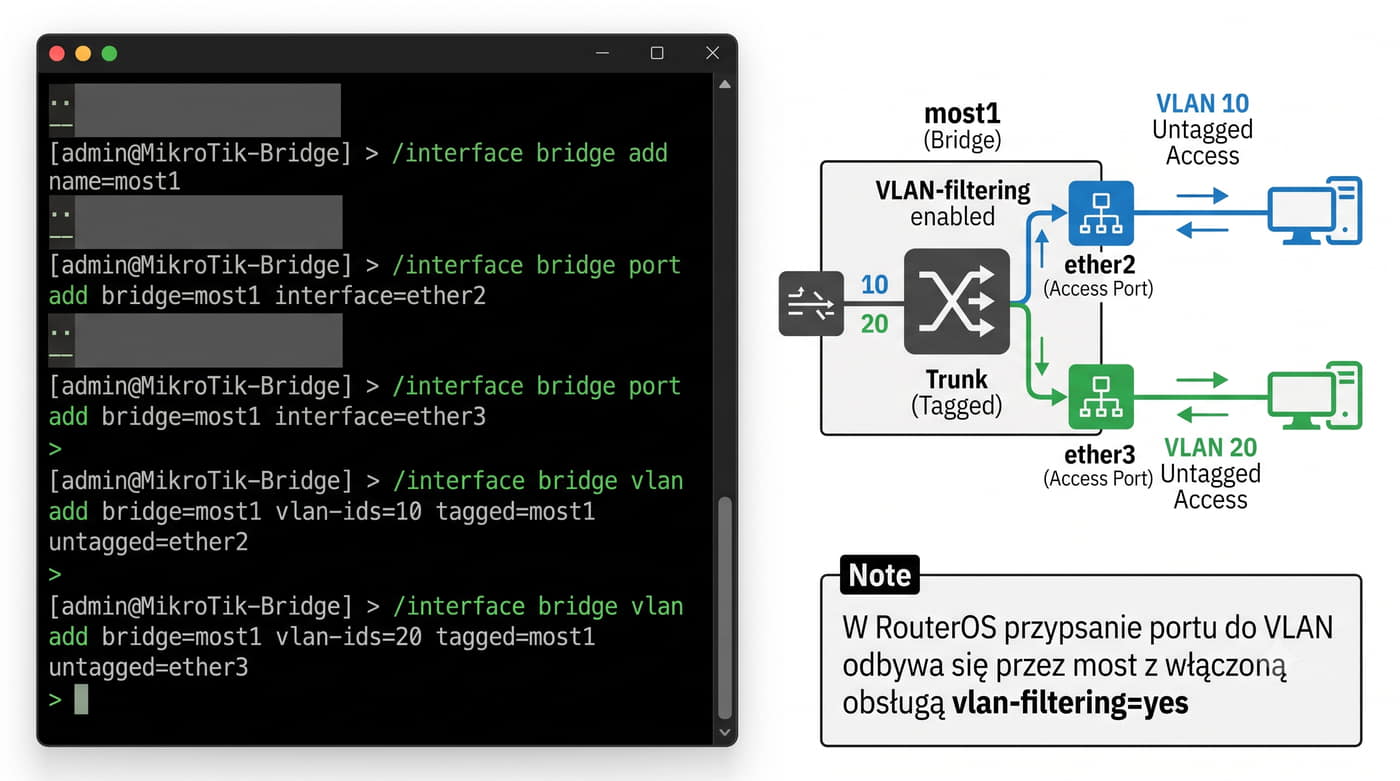
14/55 VLAN w RouterOS (bridge)
/interface bridge add name=most1
# Utworzenie mostu

/interface bridge port add bridge=most1 interface=ether2
/interface bridge port add bridge=most1 interface=ether3
# Dodanie portów fizycznych do mostu

/interface bridge vlan add bridge=most1 vlan-ids=10 tagged=most1 untagged=ether2
# VLAN 10 – port ether2 jako access (untagged), bridge jako trunk

/interface bridge vlan add bridge=most1 vlan-ids=20 tagged=most1 untagged=ether3
# VLAN 20 – port ether3 jako access (untagged)

W RouterOS VLAN-y na moście działają w oparciu o filtrowanie (vlan-filtering).

Należy włączyć tę opcję: /interface bridge set most1 vlan-filtering=yes.

Bez niej most zachowuje się jak klasyczny przełącznik bez VLAN.

W RouterOS przypisanie portu do VLAN odbywa się przez most (bridge) z włączoną obsługą vlan-filtering.

Najpierw tworzymy most, dodajemy do niego porty fizyczne, a następnie definiujemy, które porty są access dla konkretnego VLAN.

VLAN (Virtual Local Area Network) to technologia umożliwiająca logiczne grupowanie urządzeń w sieci, co pozwala na segmentację ruchu i zwiększenie bezpieczeństwa oraz wydajności. W systemie RouterOS konfiguracja VLAN opiera się na mechanizmie bridge'a, który łączy porty fizyczne w jedną logiczną całość. Aby utworzyć most (bridge), używamy polecenia /interface bridge add name=most1, co inicjuje nowy most o nazwie "most1". Następnie dodajemy do niego porty fizyczne za pomocą komend /interface bridge port add bridge=most1 interface=ether2 oraz /interface bridge port add bridge=most1 interface=ether3, gdzie "ether2" i "ether3" to przykładowe interfejsy fizyczne.

Po utworzeniu mostu możemy skonfigurować VLAN, używając polecenia vlan add bridge=most1 vlan-ids=10 tagged=most1 untagged=ether2. W tym przypadku tworzymy sieć VLAN 10, gdzie port "ether2" działa jako access port (untagged), czyli port dostępowy dla urządzeń końcowych, a most "most1" jest oznaczony jako tagged, co oznacza, że ruch VLAN będzie przechodził przez ten most. Dzięki temu możemy kontrolować przepływ danych między różnymi segmentami sieci, izolując ruch w ramach poszczególnych VLAN-ów. Konfiguracja ta jest szczególnie przydatna w środowiskach, gdzie wymagana jest segmentacja ruchu lub izolacja krytycznych usług.

Warto zauważyć, że konfiguracja VLAN w RouterOS może być rozszerzona o dodatkowe opcje, takie jak przypisywanie tagów VLAN do poszczególnych portów, co umożliwia bardziej zaawansowaną segmentację. Ponadto, mosty w RouterOS mogą być zarządzane dynamicznie, co pozwala na automatyczne dostosowywanie konfiguracji do zmieniających się potrzeb sieci. Zrozumienie mechanizmu bridge'a i VLAN jest kluczowe dla efektywnego zarządzania siecią, szczególnie w przypadku dużych lub złożonych infrastruktur, gdzie kontrola nad ruchem sieciowym ma istotne znaczenie dla wydajności i bezpieczeństwa.

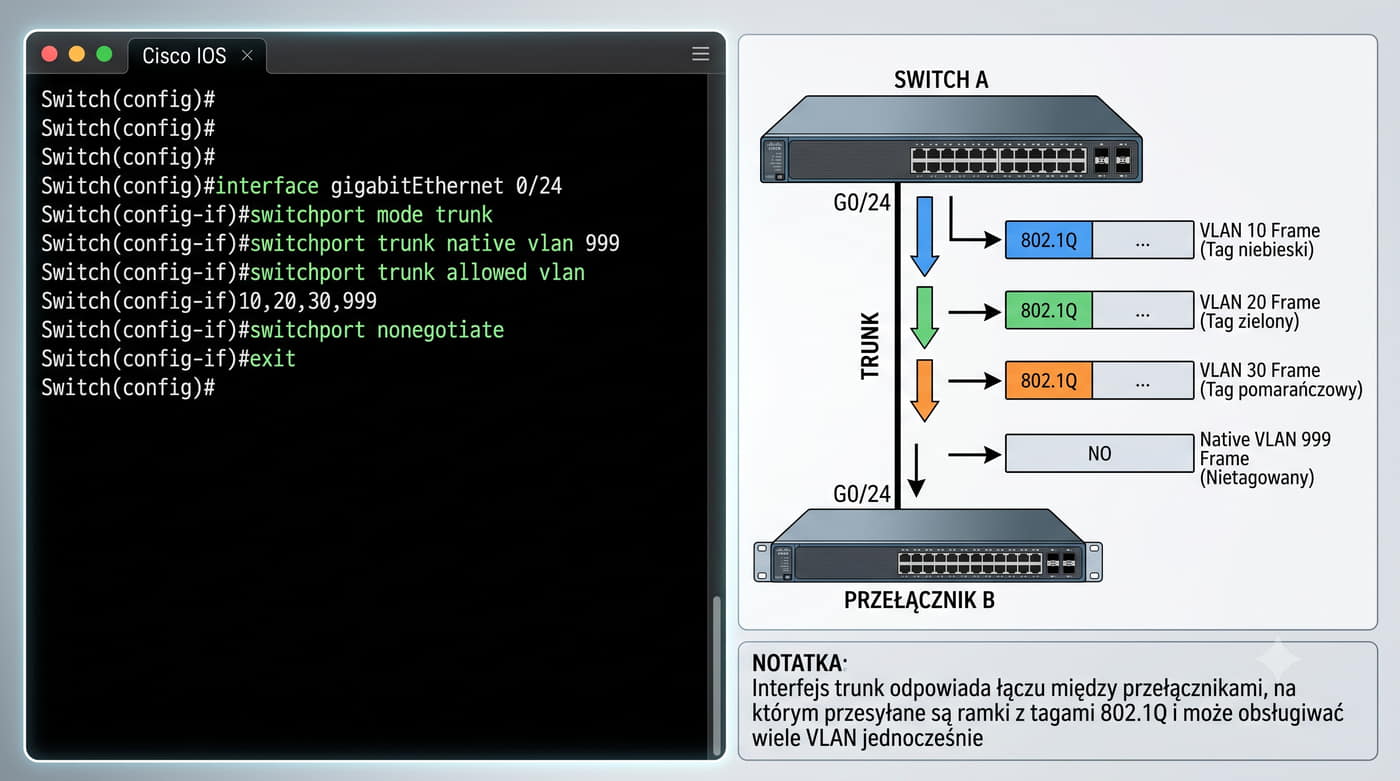
15/55 Konfiguracja trunk w Cisco IOS
interface GigabitEthernet0/24
 switchport mode trunk
 switchport trunk native vlan 999
 switchport trunk allowed vlan 10,20,30,999
 switchport nonegotiate
end
! Trunk: native VLAN 999, dozwolone 10,20,30,999, wyłączenie DTP

Polecenie switchport trunk allowed vlan określa, które VLAN mogą być przesyłane przez trunk.

Domyślnie wszystkie VLAN są dozwolone (1-4094).

Zawężenie listy dozwolonych VLAN zwiększa bezpieczeństwo i zmniejsza niepotrzebne obciążenie łącza.

Interfejs trunk w Cisco IOS odpowiada łączu między przełącznikami lub przełącznikiem a routerem, na którym przesyłane są ramki z tagami 802.1Q.

Trunk może obsługiwać wiele VLAN jednocześnie.

Konfiguracja trunk w Cisco IOS jest kluczowym elementem zarządzania siecią, umożliwiającym przesyłanie ruchu z wielu VLAN-ów przez jedno fizyczne łącze. W przykładzie podanym na slajdzie, interfejs interfejs GigabitEthernet0/24 jest skonfigurowany jako trunk z VLAN-ami 10, 20, 30 oraz 999 (native). Polecenie switchport mode trunk aktywuje tryb trunk na interfejsie, a switchport trunk allowed vlan 10,20,30,999 określa dozwolone VLAN-y. VLAN 999 jest ustawiony jako native, co oznacza, że ruch z tego VLAN-u będzie przesyłany bez enkapsulacji.

Ważnym aspektem konfiguracji trunk jest kontrola negocjacji DTP (Dynamic Trunk Partner). Polecenie switchport nonegotiate wyłącza negocjację, co zapobiega automatycznemu ustawianiu parametrów trunk przez urządzenia. Jest to przydatne w środowiskach, gdzie wymagana jest precyzyjna kontrola nad przesyłanymi VLAN-ami. Dodatkowo, end kończy tryb konfiguracyjny, a ! rozpoczyna wiersz komentarza. W praktyce, takie ustawienie zapewnia, że tylko określone VLAN-y będą przesyłane przez łącze trunk, co jest istotne dla segmentacji sieci i zarządzania ruchem.

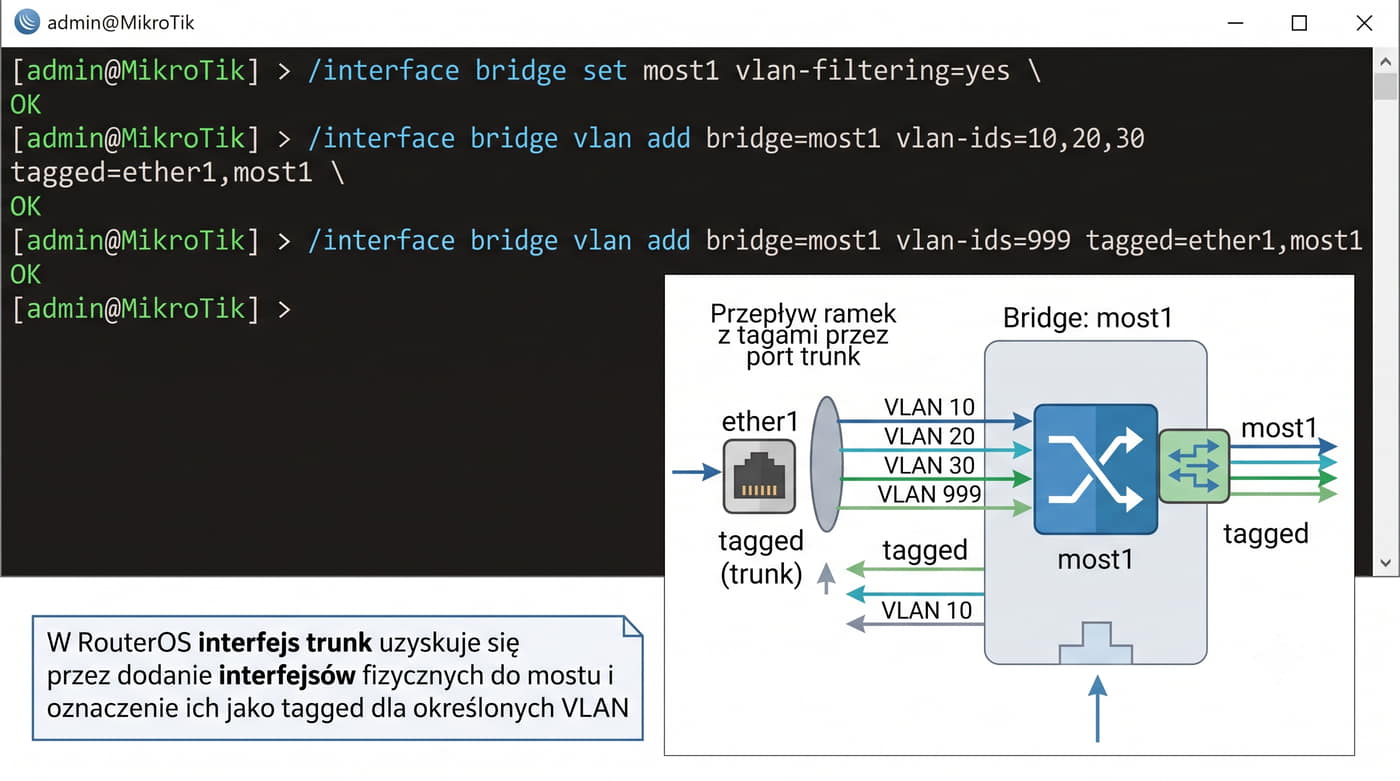
16/55 Konfiguracja trunk w RouterOS
/interface bridge set most1 vlan-filtering=yes
# Włączenie filtrowania VLAN na moście

/interface bridge vlan add bridge=most1 vlan-ids=10,20,30 tagged=ether1,most1
# VLAN 10,20,30 jako trunk (tagged) na ether1 i moście

/interface bridge port set [find interface=ether1] pvid=999
# VLAN 999 jako natywny na ether1 (ramki bez tagu)

/interface bridge vlan add bridge=most1 vlan-ids=999 tagged=most1 untagged=ether1
# VLAN 999 w tabeli VLAN mostu – untagged na ether1

W RouterOS interfejs trunk uzyskuje się przez dodanie interfejsów fizycznych do mostu i oznaczenie ich jako tagged dla określonych VLAN.

Most pełni rolę przełącznika obsługującego wiele VLAN.

W konfiguracji RouterOS interfejs oznaczony jako tagged dla danego VLAN przesyła ramki z tagiem (trunk).

Interfejs untagged przesyła ramki bez tagu (access).

VLAN natywny (np. 999) na trunk w RouterOS uzyskuje się, ustawiając pvid portu na numer tego VLAN i dodając go do tabeli VLAN mostu z flagą untagged na tym porcie.

Most (interfejs mostu) również może być tagged, co jest przydatne przy tworzeniu interfejsów na moście dla routingu.

Konfiguracja trunk w RouterOS jest kluczowym elementem zarządzania siecią, umożliwiającym efektywne wykorzystanie VLAN-ów na interfejsach fizycznych. Aby skonfigurować trunk, należy najpierw włączyć filtrowanie VLAN za pomocą polecenia vlan-filtering=yes, co zapewnia kontrolę nad ruchem przesyłanym przez most VLAN. Następnie, używając polecenia vlan add bridge=most1 vlan-ids=10,20,30 tagged=ether1,most1, dodajemy określone VLAN-y (w tym przypadku 10, 20 i 30) do mostu o nazwie most1, przypisując je do interfejsu fizycznego ether1. Ważne jest, aby zrozumieć różnicę między tagowaniem a natywnym przesyłaniem VLAN-ów. Tagowanie oznacza, że ramki z danego VLAN-u są oznaczane etykietą (tagiem 802.1Q), natomiast ramki VLAN-u natywnego (jak 999 w przykładzie) są przesyłane bez tagu. W RouterOS nie istnieje osobna opcja native – VLAN natywny na interfejsie trunk uzyskuje się, dodając dany VLAN do tabeli VLAN mostu z flagą untagged na tym porcie oraz ustawiając pvid tego portu na numer VLAN-u natywnego.

Konfiguracja trunk w RouterOS wymaga również zrozumienia roli portów trunk i ich relacji z mostami VLAN. Interfejs trunk jest tworzony poprzez dodanie interfejsów fizycznych do mostu VLAN, co pozwala na przesyłanie ruchu z wielu VLAN-ów przez jeden fizyczny port. W przykładzie pokazanym na slajdzie, interfejs ether1 przesyła tagowane ramki VLAN-ów 10, 20 i 30, natomiast ramki VLAN-u 999 są przesyłane natywnie (bez tagu) zgodnie z ustawieniem pvid=999 i flagi untagged w tabeli VLAN mostu. To podejście jest szczególnie przydatne w scenariuszach, gdzie potrzebna jest elastyczność w zarządzaniu ruchem sieciowym, na przykład w dużych sieciach korporacyjnych lub centrach danych, gdzie różne usługi i aplikacje mogą wymagać izolacji na poziomie VLAN.

Warto również zwrócić uwagę na aspekty bezpieczeństwa i wydajności związane z konfiguracją trunk. Poprawne skonfigurowanie filtrowania VLAN i przypisanie odpowiednich tagów lub ustawień natywnych może znacząco wpłynąć na bezpieczeństwo sieci, zapobiegając nieautoryzowanemu dostępowi do określonych segmentów sieci. Ponadto, efektywne zarządzanie VLAN-ami na interfejsach trunk może poprawić wydajność sieci, redukując ruch broadcast i multicast w całej sieci. Dlatego też, projektując konfigurację trunk w RouterOS, należy dokładnie rozważyć potrzeby sieci, zapewniając jednocześnie, że konfiguracja jest zgodna z najlepszymi praktykami i standardami branżowymi.

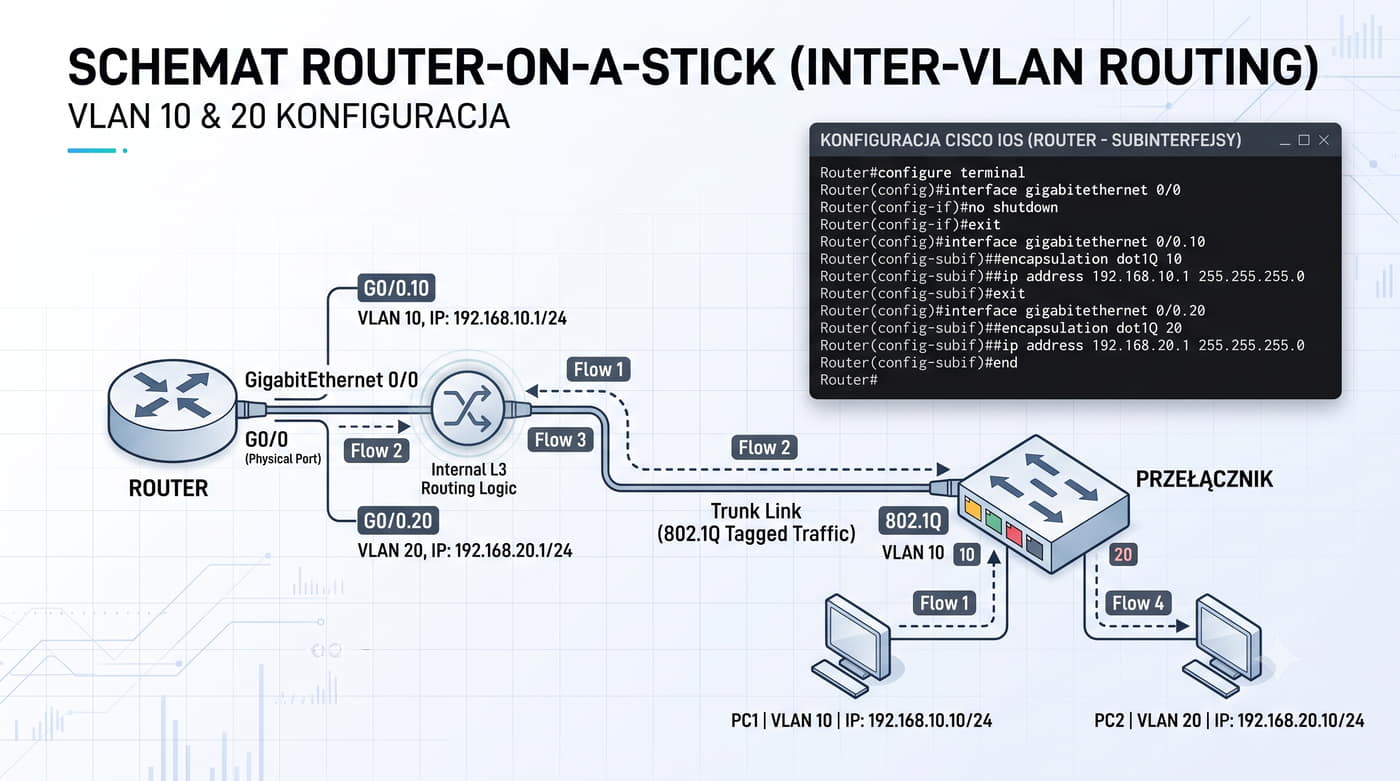
17/55 VLAN – Router-on-a-Stick
interface GigabitEthernet0/0.10
 encapsulation dot1Q 10
 ip address 192.168.10.1 255.255.255.0
exit
interface GigabitEthernet0/0.20
 encapsulation dot1Q 20
 ip address 192.168.20.1 255.255.255.0
exit
interface GigabitEthernet0/0
 no shutdown
! Interfejs fizyczny – subinterfejsy dla VLAN 10 i 20
Router-on-a-Stick to ekonomiczne rozwiązanie dla małych sieci z wieloma VLAN. Wymaga skonfigurowania interfejsu trunk (802.1Q) między routerem a przełącznikiem.

Interfejs fizyczny dzielony jest na subinterfejsy logiczne, z których każdy obsługuje inny VLAN za pomocą enkapsulacji 802.1Q.

Router odbiera ramki z tagiem, rozpoznaje i przekierowuje pakiet do odpowiedniego subinterfejsu.

Router-on-a-Stick (RoS) to koncepcja, która pozwala przekształcić standardowy przełącznik sieciowy w zaawansowany router poprzez dodanie funkcji routingu i segmentacji sieci. W praktyce oznacza to możliwość tworzenia VLAN-ów (Virtual Local Area Networks) na urządzeniu, które pierwotnie nie było do tego przeznaczone. Dzięki temu organizacje mogą oszczędzać na kosztach zakupu dedykowanych routerów, jednocześnie zyskując elastyczność w zarządzaniu siecią.

W przykładzie przedstawionym na slajdzie widzimy konfigurację dwóch interfejsów gigabitEthernet 0/0.10 i 0/0.20, które są używane do tworzenia oddzielnych sieci VLAN o identyfikatorach 10 i 20 odpowiednio. Każdy z tych interfejsów ma przypisany własny adres IP (192.168.10.1 dla VLAN 10 i 192.168.20.1 dla VLAN 20) oraz podsieć, co umożliwia ich niezależne zarządzanie. Dzięki temu urządzenie działa jak miniaturowy router, który może kierować ruchem między różnymi segmentami sieci bez potrzeby fizycznego przełączania kabli.

Router-on-a-Stick jest szczególnie przydatny w małych i średnich przedsiębiorstwach oraz w miejscach, gdzie infrastruktura sieciowa jest ograniczona. Pozwala na szybkie i efektywne tworzenie izolowanych stref sieciowych, co zwiększa bezpieczeństwo i ułatwia zarządzanie zasobami. Warto jednak pamiętać, że choć RoS oferuje wiele korzyści, to nie zastąpi w pełni funkcjonalności profesjonalnego routera w dużych, złożonych sieciach.

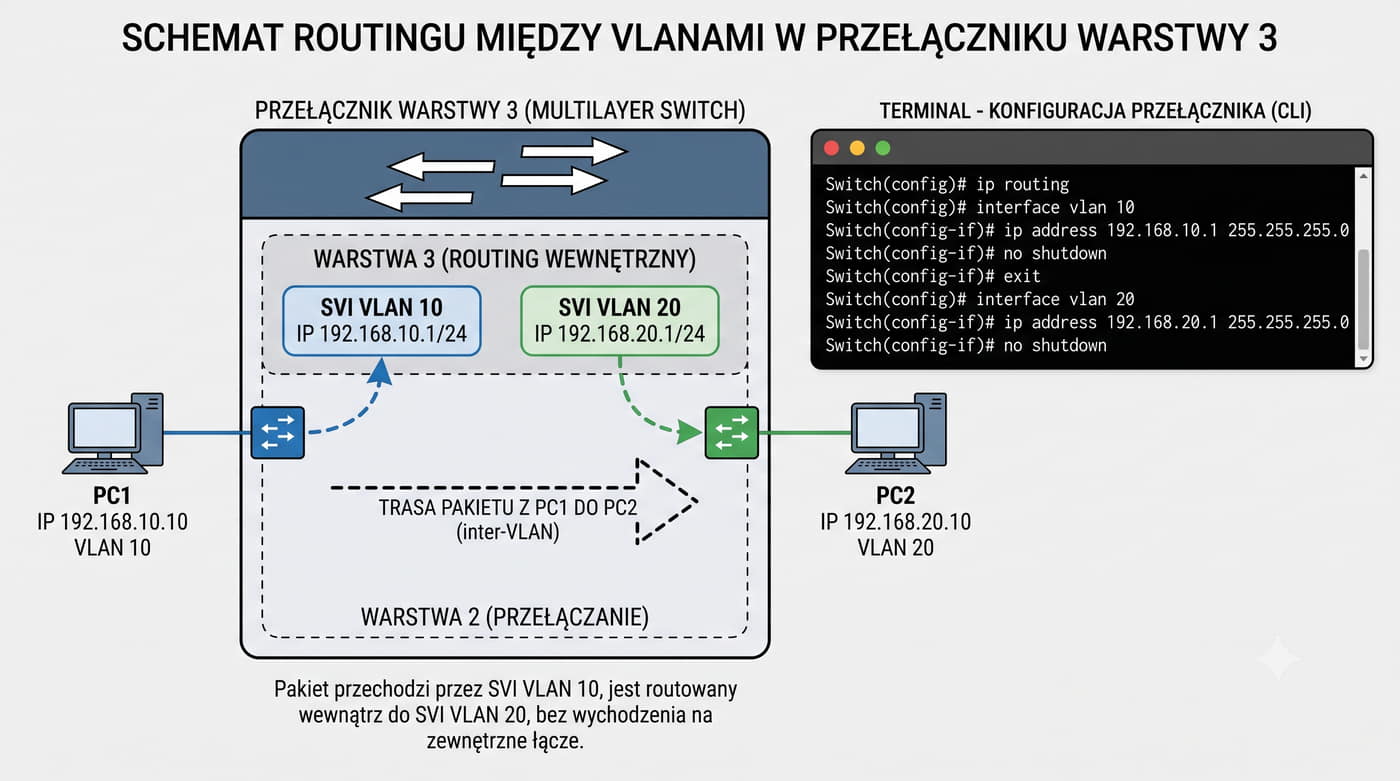
18/55 VLAN – przełącznik L3 (SVI)
ip routing
! Włączenie routingu na przełączniku L3

interface vlan 10
 ip address 192.168.10.1 255.255.255.0
 no shutdown
exit
interface vlan 20
 ip address 192.168.20.1 255.255.255.0
 no shutdown
end
! SVI dla VLAN 10 i 20 na przełączniku L3

Przełącznik warstwy 3 (multilayer switch) może wykonywać routing między VLAN bez zewnętrznego routera.

Służą do tego SVI (Switch Virtual Interfaces) – interfejsy wirtualne utworzone dla konkretnego VLAN, które otrzymują adres IP i działają jak bramy dla hostów w tym VLAN.

Routing między VLAN na przełączniku L3 jest znacznie szybszy niż router-on-a-stick, ponieważ pakiety są przekazywane w sprzęcie (hardware switching) w obrębie tego samego urządzenia, bez konieczności przesyłania przez zewnętrzne łącze.

Przełącznik warstwy 3 (L3) to zaawansowane urządzenie sieciowe, które oprócz funkcji przełączania pakietów w obrębie pojedynczego VLAN-u potrafi również wykonywać routing między różnymi sieciami VLAN. Dzięki temu może pełnić rolę zarówno przełącznika, jak i routera w jednym urządzeniu, eliminując potrzebę stosowania oddzielnego routera w mniejszych sieciach.

Kluczowym elementem umożliwiającym routing między VLAN-ami na przełączniku L3 jest tzw. SVI (Switch Virtual Interface). SVI to interfejs wirtualny przypisany do konkretnego VLAN-u (a nie do portu fizycznego), który reprezentuje ten VLAN w tablicy routingu urządzenia. Na przykład, jeśli mamy dwa VLAN-y (10 i 20) z odpowiednimi adresacjami IP (192.168.10.1/24 i 192.168.20.1/24), przełącznik L3 będzie w stanie routować pakiety między nimi, pełniąc rolę bramy (gateway) dla hostów w tych VLAN-ach.

Konfiguracja SVI wymaga przypisania adresu IP do interfejsu wirtualnego VLAN-u oraz włączenia routingu. Przełącznik L3 tworzy wirtualne interfejsy dla każdego VLAN-u, co pozwala na efektywne zarządzanie ruchem i routingiem w całej sieci. Dzięki temu możliwe jest tworzenie bardziej złożonych topologii sieciowych bez konieczności stosowania dodatkowych urządzeń routujących, co upraszcza architekturę sieci i zmniejsza koszty.

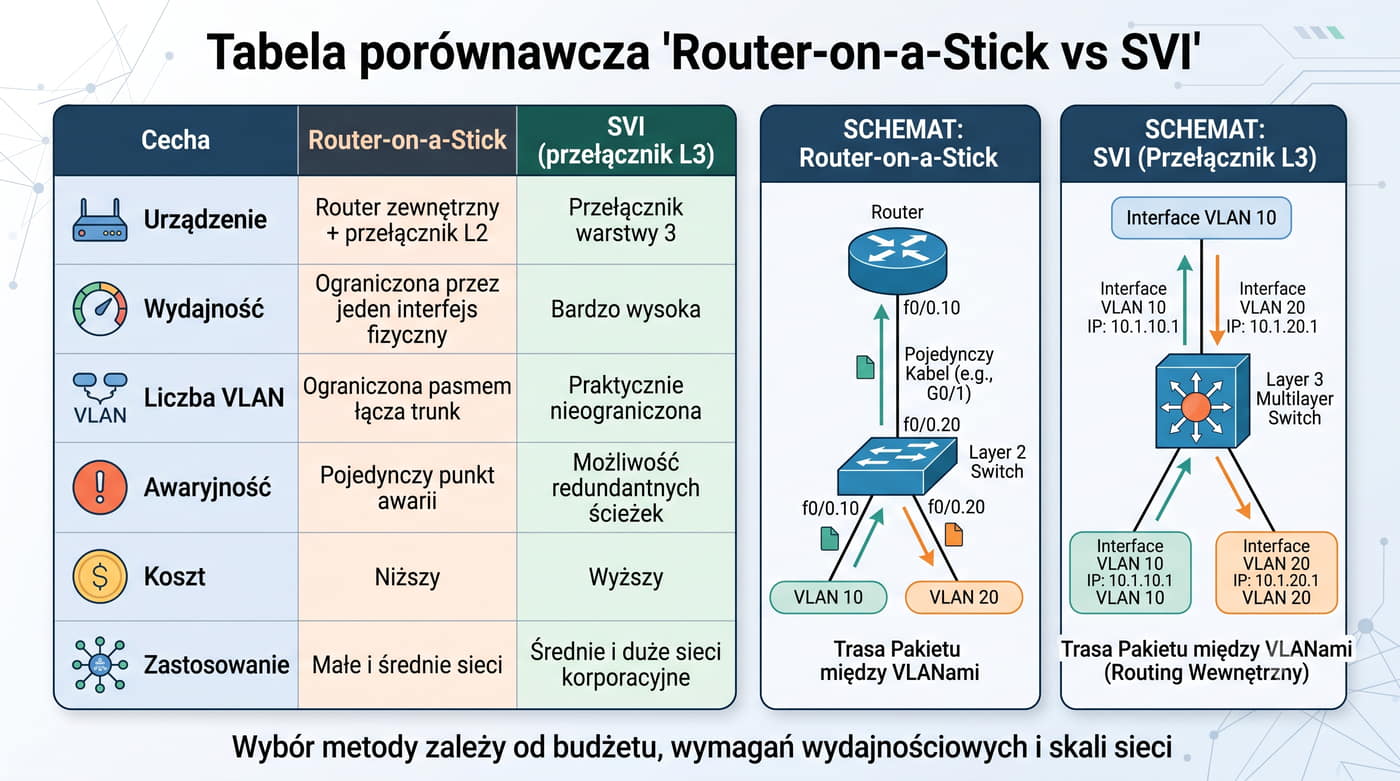
19/55 Porównanie: Router-on-a-Stick vs SVI
CechaRouter-on-a-StickSVI (przełącznik L3)
UrządzenieRouter zewnętrzny + przełącznik L2Przełącznik warstwy 3 (multi-layer)
WydajnośćOgraniczona przez jeden interfejs fizycznyBardzo wysoka – routing sprzętowy
Liczba VLANOgraniczona pasmem łącza trunkPraktycznie nieograniczona
AwaryjnośćPojedynczy punkt awarii (jeden kabel)Możliwość redundantnych ścieżek
KosztNiższy (router L3 + switch L2)Wyższy (switch L3)
ZastosowanieMałe i średnie sieciŚrednie i duże sieci korporacyjne

Wybór metody zależy od budżetu, wymagań wydajnościowych i skali sieci.

W małych firmach router-on-a-stick jest wystarczający.

W sieciach z setkami VLAN zaleca się przełączniki L3 z SVI.

Router-on-a-Stick (RoAS) i SVI (Switch Virtual Interface) to dwa różne podejścia do implementacji funkcji routingu w sieciach komputerowych, które mają swoje unikalne cechy i zastosowania. Router-on-a-Stick to rozwiązanie, w którym router jest fizycznie połączony z przełącznikiem za pomocą jednego interfejsu fizycznego, co ogranicza jego wydajność do przepustowości tego łącza. Jest to rozwiązanie stosunkowo proste i tanie, ale ma swoje ograniczenia, szczególnie w dużych sieciach, gdzie wymagana jest wysoka wydajność i niezawodność.

Z kolei SVI to bardziej zaawansowane rozwiązanie, które wykorzystuje przełącznik warstwy 3 (L3) do realizacji funkcji routingu. Przełączniki L3 są w stanie obsługiwać wiele interfejsów fizycznych jednocześnie, co pozwala na osiągnięcie bardzo wysokiej wydajności dzięki routingowi sprzętowemu. SVI umożliwia również tworzenie VLAN-ów z praktycznie nieograniczoną pasmem, co jest niemożliwe w przypadku RoAS, gdzie wydajność jest ograniczona przez pojedyncze łącze trunk. Ponadto, SVI oferuje lepszą skalowalność i elastyczność w zarządzaniu siecią.

Pod względem awaryjności, RoAS jest bardziej podatny na problemy, ponieważ cała funkcjonalność routingu opiera się na jednym interfejsie fizycznym. W przypadku awarii tego łącza, cała sieć może zostać odcięta od Internetu lub innych segmentów sieci. Natomiast SVI, dzięki wykorzystaniu przełącznika L3, oferuje większą niezawodność i możliwość szybkiego przełączenia na zapasowe łącze w przypadku awarii. W związku z tym, wybór między RoAS a SVI zależy od specyficznych wymagań sieci, takich jak wymagana przepustowość, niezawodność i budżet.

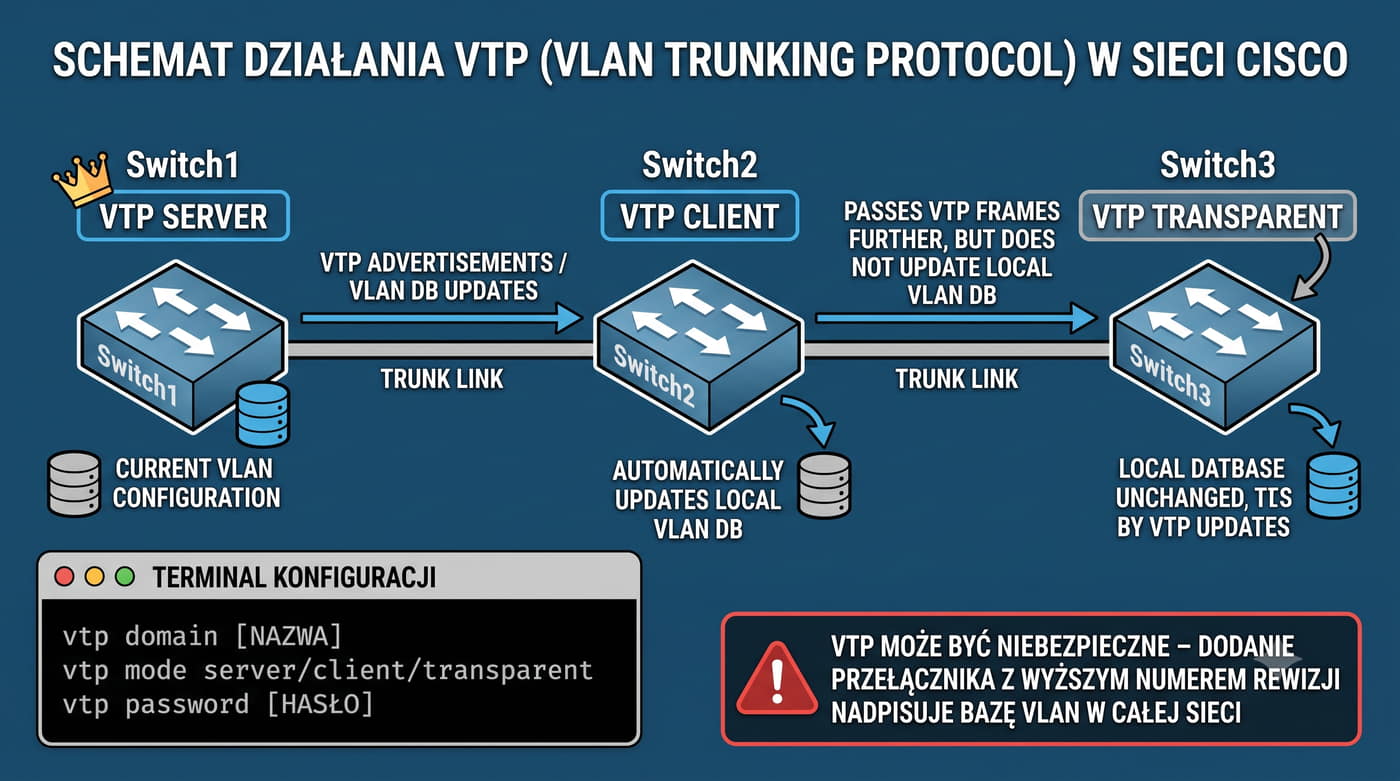
20/55 VLAN Trunking Protocol
VTP może być niebezpieczny – dodanie przełącznika z wyższym numerem rewizji (revision number) nadpisuje bazę w całej sieci. W praktyce często używa się trybu transparent.

VTP ma trzy tryby pracy.

VTP (VLAN Trunking Protocol) to protokół Cisco służący do dystrybucji bazy VLAN między przełącznikami w sieci.

Dzięki VTP administrator tworzy VLAN na jednym przełączniku (serwer VTP), a pozostałe przełączniki (klienty VTP) automatycznie otrzymują te same informacje.

Domyślnym VLAN na przełączniku jest VLAN 1.

Serwer (Server) – przechowuje bazę VLAN, może ją modyfikować i rozgłasza zmiany.

Klient (Client) – przechowuje bazę, ale nie może jej modyfikować – otrzymuje aktualizacje od serwera.

Transparent – nie uczestniczy w VTP (przekazuje ramki VTP dalej, ale nie aktualizuje własnej bazy).

VTP ma też wersję: VTPv1, VTPv2 i VTPv3.

Nowsze wersje obsługują więcej funkcji, w tym rozszerzone identyfikatory (1006-4094).

VLAN Trunking Protocol (VTP) to protokół opracowany przez Cisco, który umożliwia dystrybucję informacji o sieciach VLAN między przełącznikami w sieci. Jego głównym celem jest zapewnienie spójności konfiguracji VLAN w całej domenie broadcastowej, co ułatwia zarządzanie segmentacją ruchu i poprawia wydajność sieci. Protokół ten działa na warstwie drugiej modelu OSI i jest szczególnie przydatny w dużych sieciach, gdzie konieczne jest dynamiczne zarządzanie VLANami.

VTP ma trzy tryby pracy: Server, Client i Transparent. Tryb Server pozwala przełącznikowi na tworzenie, modyfikowanie i rozgłaszanie bazy VLAN do innych urządzeń w domenie VTP. Tryb Client przyjmuje bazę VLAN od serwera i nie może jej modyfikować. Tryb Transparent nie uczestniczy w synchronizacji VTP, ale przekazuje ramki VTP dalej – działa z własną lokalną bazą VLAN.

Ze względu na potencjalne ryzyko związane z przypadkowym nadpisaniem bazy VLAN (przez przełącznik z wyższym numerem rewizji), w praktyce często stosuje się tryb Transparent. Ważne jest monitorowanie numerów rewizji VTP na przełącznikach, ponieważ urządzenie z wyższym numerem może nadpisać ustawienia innych przełączników, co może prowadzić do problemów z łącznością. W nowoczesnych sieciach często wykorzystuje się VTPv3, który oferuje większą elastyczność i bezpieczeństwo w zarządzaniu VLAN-ami, w tym obsługę rozszerzonych identyfikatorów VLAN (1006-4094) oraz uwierzytelnianie.

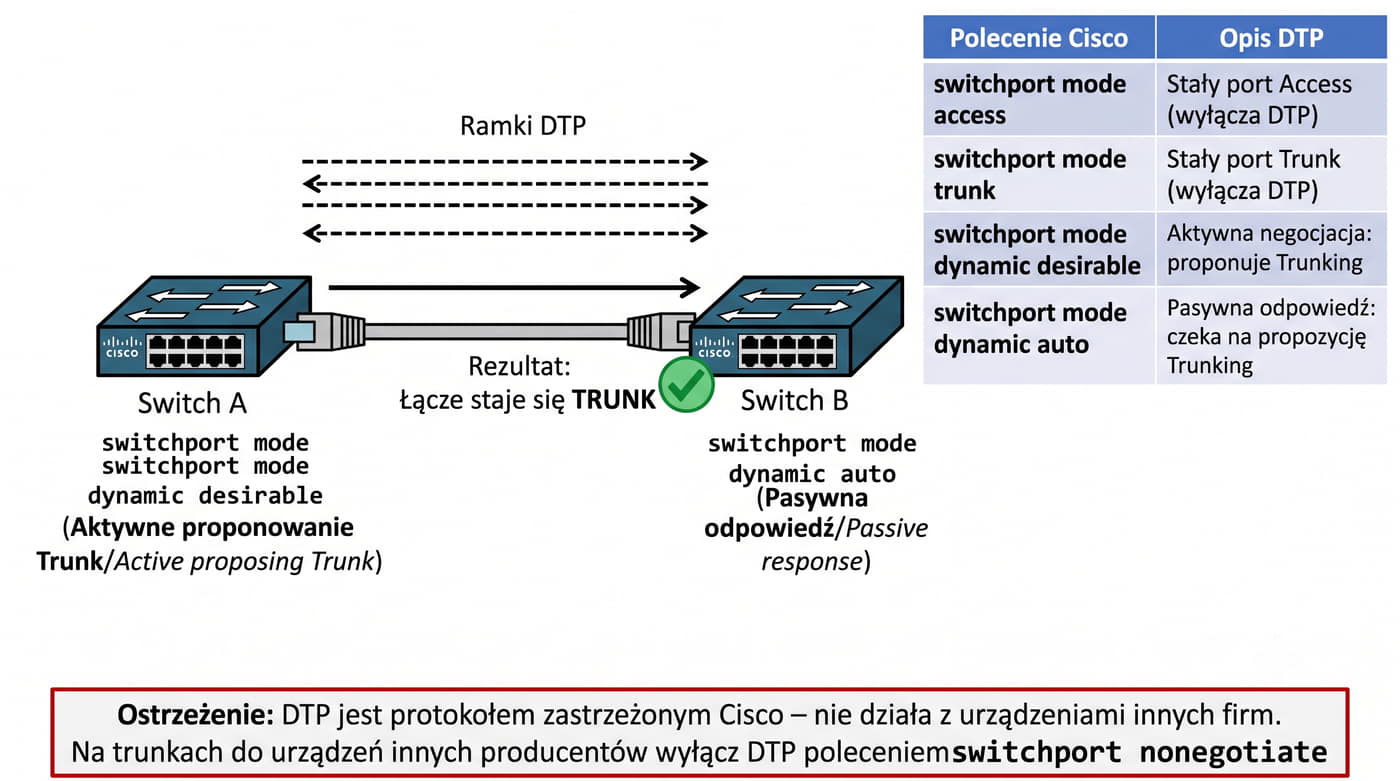
21/55 DTP – Dynamic Trunking Protocol

Interfejs Cisco może być skonfigurowany w jednym z trybów DTP: switchport mode access – stały tryb access, nie negocjuje trunk; switchport mode trunk – stały tryb trunk, nie negocjuje; switchport mode dynamic desirable – aktywnie proponuje trunk; switchport mode dynamic auto – odpowiada na propozycje trunk, ale nie inicjuje negocjacji.

DTP jest protokołem zastrzeżonym (Cisco) i nie działa z urządzeniami innych firm.

Z tego powodu na trunkach do urządzeń innych producentów wyłącza się DTP poleceniem switchport nonegotiate.

DTP (Dynamic Trunking Protocol) to protokół Cisco służący do automatycznej negocjacji trybu pracy interfejsu (access lub trunk) między dwoma przełącznikami.

Ramki DTP są wysyłane na każdy interfejs, informując sąsiednie urządzenie o trybie pracy i proponując negocjację.

Dynamic Trunking Protocol (DTP) to protokół opracowany przez Cisco, który umożliwia automatyczne negocjowanie i konfigurowanie połączeń trunk między urządzeniami sieciowymi. Jego głównym celem jest uproszczenie zarządzania siecią poprzez eliminację ręcznej konfiguracji dla każdego połączenia trunk. DTP działa na warstwie 2 modelu OSI i jest implementowany w przełącznikach Cisco, umożliwiając im dynamiczne dostosowywanie się do potrzeb sieci.

Protokół DTP oferuje różne tryby konfiguracji interfejsów, które pozwalają na elastyczne zarządzanie ruchem w sieci. Tryb switchport mode access ustawia interfejs jako stały tryb access, co oznacza, że nie będzie on negocjował połączenia trunk. Jest to przydatne, gdy chcemy uniknąć przypadkowego utworzenia połączenia trunk na interfejsie, który nie jest do tego przeznaczony. Z kolei switchport mode trunk ustawia interfejs jako stały tryb trunk, co również wyklucza negocjację. Ten tryb jest użyteczny, gdy chcemy mieć pewność, że dany interfejs zawsze będzie działał jako trunk, bez względu na urządzenie po drugiej stronie.

Bardziej zaawansowane tryby to switchport mode dynamic desirable i switchport mode dynamic auto. Tryb dynamic desirable aktywnie proponuje utworzenie połączenia trunk, jeśli druga strona jest skłonna do negocjacji. Jest to przydatne w scenariuszach, gdzie chcemy zainicjować połączenie trunk, ale nie jesteśmy pewni, czy urządzenie po drugiej stronie jest na to gotowe. Natomiast tryb dynamic auto odpowiada na propozycje utworzenia połączenia trunk tylko wtedy, gdy jest to możliwe i bezpieczne dla sieci. Ten tryb zapewnia maksymalną elastyczność, pozwalając na automatyczne dostosowanie się do zmieniających się warunków w sieci, jednocześnie minimalizując ryzyko błędów konfiguracyjnych.

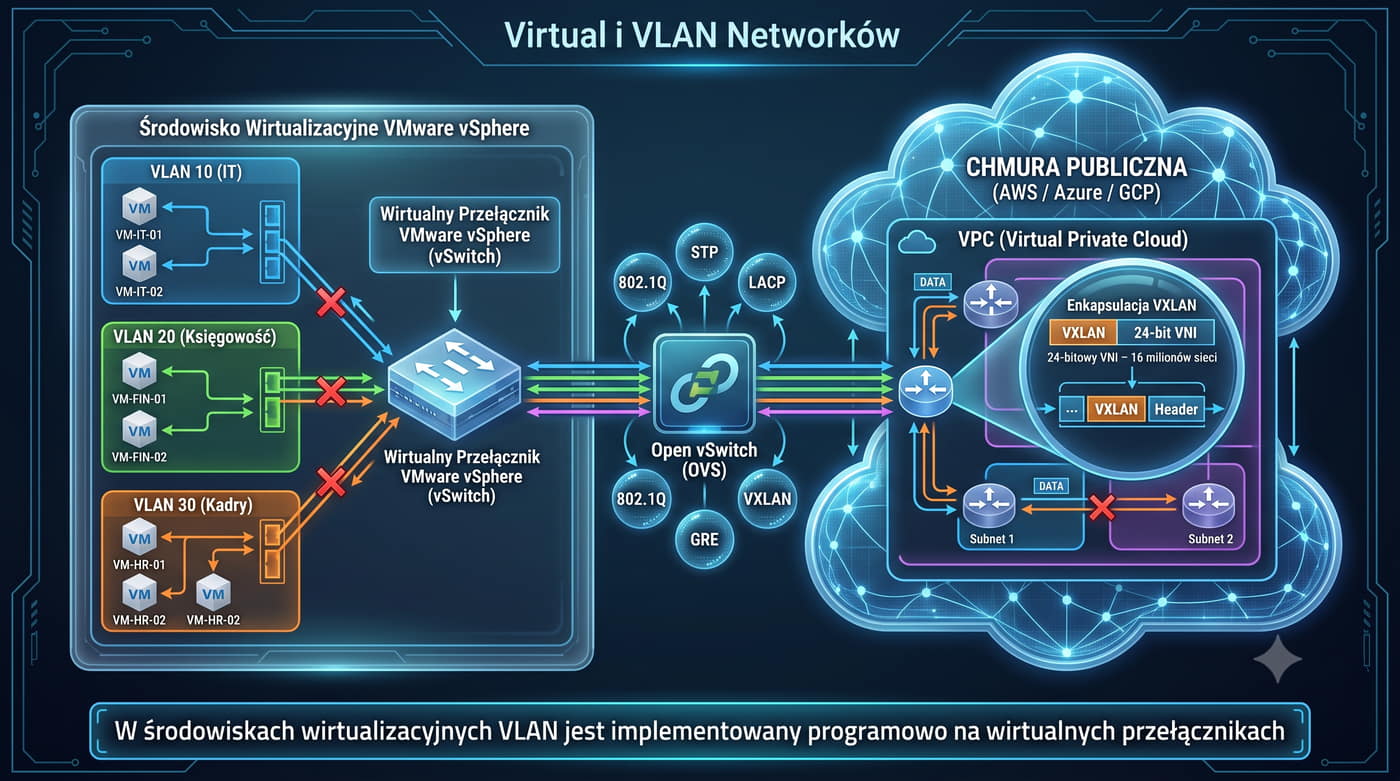
22/55 VLAN w środowisku wirtualnym i chmurze

W środowiskach wirtualizacyjnych (VMware vSphere, Open vSwitch) VLAN jest implementowany programowo na wirtualnych przełącznikach.

VMware vSphere oferuje wirtualny przełącznik standardowy (vSwitch) i rozproszony (dvSwitch), które obsługują tagowanie 802.1Q.

Administrator może przypisać do portu grupy wirtualnych maszyn, co izoluje ruch między VM bez konieczności konfiguracji fizycznego przełącznika.

Open vSwitch (OVS) to open-source'owy wirtualny przełącznik używany w platformach takich jak OpenStack, KVM i Docker.

OVS obsługuje 802.1Q, STP, LACP i tunelowanie (VXLAN, GRE).

W chmurze publicznej (AWS, Azure, GCP) koncepcja jest realizowana przez wirtualne sieci prywatne (VPC), które zapewniają izolację na poziomie warstwy 3 z użyciem enkapsulacji (VXLAN, GENEVE).

Model sieci definiowanej programowo (SDN) umożliwia automatyczne zarządzanie sieciami wirtualnymi na dużą skalę.

W środowiskach wirtualnych i chmurowych technologia VLAN (Virtual Local Area Network) odgrywa kluczową rolę w segmentacji sieci, umożliwiając efektywniejsze zarządzanie ruchem oraz poprawę bezpieczeństwa. W przeciwieństwie do tradycyjnych rozwiązań sprzętowych, gdzie VLAN jest realizowany za pomocą fizycznych przełączników, w środowiskach zwirtualizowanych wykorzystuje się oprogramowanie. Przykładem są platformy takie jak VMware vSphere z wbudowanymi wirtualnymi przełącznikami (vSwitch i dvSwitch), które obsługują standard 802.1Q do tagowania ramek Ethernet. Dzięki temu administratorzy mogą tworzyć logiczne segmenty sieci bez konieczności fizycznej rekonfiguracji infrastruktury, co znacząco upraszcza zarządzanie złożonymi środowiskami.

Open vSwitch to kolejny przykład oprogramowania sieciowego, które umożliwia implementację VLAN w sposób elastyczny i skalowalny. Jego architektura oparta na kontrolerze i agentach pozwala na dynamiczne dostosowywanie konfiguracji sieciowych w czasie rzeczywistym, co jest szczególnie przydatne w środowiskach chmurowych o zmiennym obciążeniu. Wirtualne przełączniki obsługują zaawansowane funkcje, takie jak routing między VLAN-ami czy izolacja ruchu, co minimalizuje ryzyko przypadkowego dostępu do wrażliwych zasobów. Ponadto integracja z narzędziami do automatyzacji (np. Ansible, Terraform) umożliwia szybkie wdrażanie i skalowanie konfiguracji sieciowych zgodnie z potrzebami biznesowymi.

W chmurze publicznej (AWS, Azure) dostawcy oferują własne rozwiązania oparte na koncepcji VLAN, takie jak Amazon VPC (Virtual Private Cloud) czy Azure Virtual Network. Te usługi pozwalają użytkownikom tworzyć izolowane podsieci z precyzyjną kontrolą dostępu, co jest kluczowe dla bezpieczeństwa i zgodności z regulacjami (np. GDPR). W przeciwieństwie do tradycyjnych VLAN, rozwiązania chmurowe często oferują dodatkowe funkcje, takie jak integracja z usługami tożsamości czy automatyczne skalowanie przepustowości. Dla organizacji korzystających z hybrydowych środowisk sieciowych (on-premise + chmura) istotna jest możliwość łączenia tych technologii za pomocą dedykowanych połączeń (np. AWS Direct Connect), co zapewnia spójność zarządzania siecią niezależnie od lokalizacji zasobów.

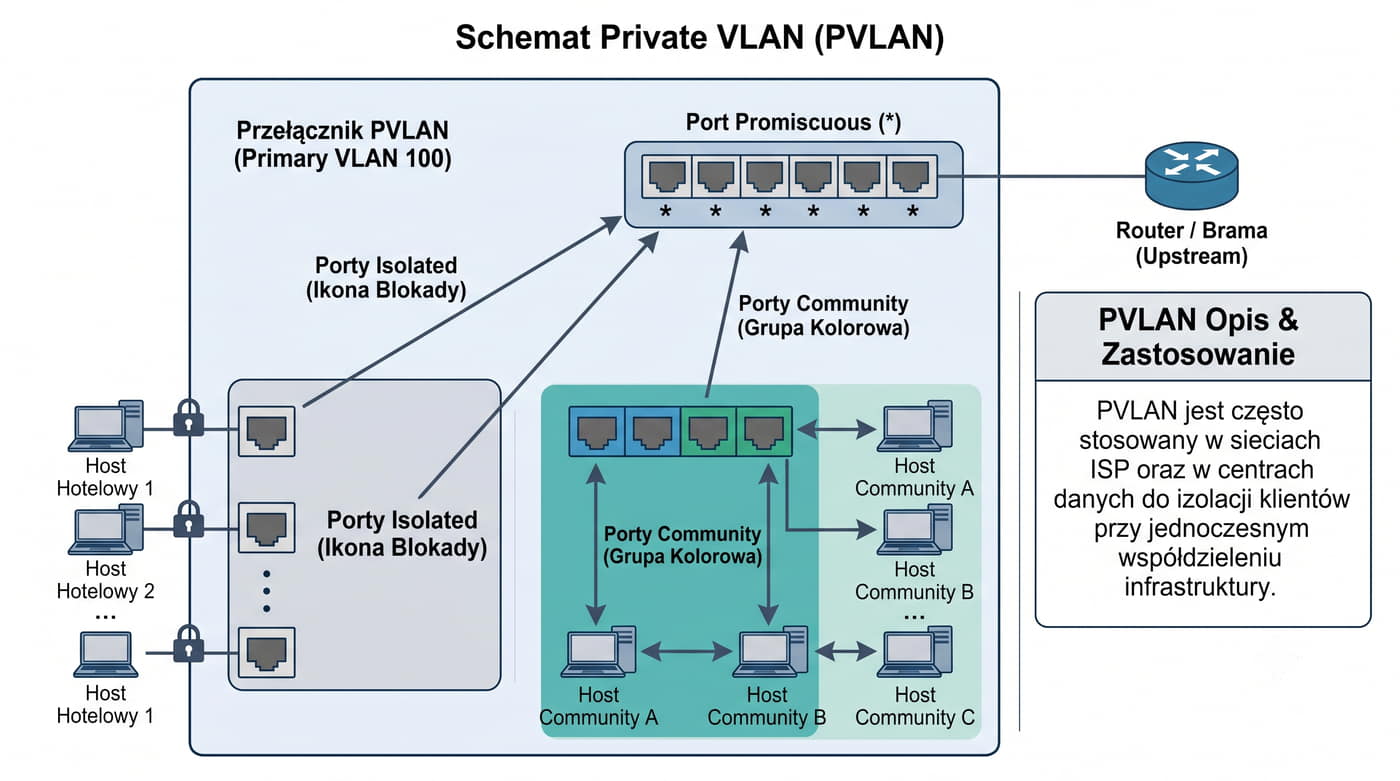
23/55 VLAN – Private VLAN

Istnieją trzy typy portów w PVLAN.

Private VLAN (PVLAN) to rozszerzenie standardu VLAN umożliwiające dalszą izolację hostów w obrębie jednej sieci.

W klasycznym VLAN wszystkie hosty widzą się nawzajem (mogą komunikować się na poziomie L2).

W PVLAN jeden VLAN (Primary) dzieli się na mniejsze podsieci VLAN (Secondary) o różnych poziomach izolacji.

Promiscuous – może komunikować się ze wszystkimi portami w PVLAN (zazwyczaj port bramy/routera).

Isolated – może komunikować się tylko z portem promiscuous (idealny dla hostów, które nie powinny komunikować się między sobą, np. w sieci hotelowej).

Community – porty w tej samej grupie community mogą komunikować się między sobą oraz z portem promiscuous, ale nie z innymi grupami community.

PVLAN jest często stosowany w sieciach dostawców usług internetowych (ISP) oraz w centrach danych do izolacji klientów.

Private VLAN (PVLAN) to zaawansowana technologia rozszerzająca możliwości standardowego VLAN, umożliwiająca jeszcze większą segmentację ruchu sieciowego i izolację hostów. W przeciwieństwie do klasycznego VLAN, gdzie wszystkie urządzenia w tej samej sieci widzą się nawzajem na poziomie drugiej warstwy modelu OSI (warstwa danych), PVLAN wprowadza dodatkową warstwę segmentacji. Główny VLAN, nazywany Primary VLAN, jest dzielony na mniejsze podsieci zwane Private VLANs (PVLANs). Każdy z tych PVLANów działa jak oddzielna sieć wirtualna, co pozwala na bardziej precyzyjne zarządzanie ruchem i zwiększenie bezpieczeństwa.

W PVLAN istnieją trzy główne typy portów role: Promiscuous, Isolated oraz Community. Port Promiscuous może komunikować się ze wszystkimi portami w PVLAN i jest przeznaczony dla bramy lub routera między sieciami. Port Isolated może komunikować się wyłącznie z portem promiscuous, co sprawdza się w przypadkach wymagających pełnej izolacji hostów. Porty Community należące do tej samej grupy mogą komunikować się między sobą oraz z portem promiscuous, ale nie z portami z innych grup community. Ta struktura pozwala na efektywne zarządzanie segmentacją sieci, minimalizując ryzyko nieautoryzowanego dostępu między różnymi grupami urządzeń.

Implementacja PVLAN przynosi wiele korzyści, takich jak zwiększone bezpieczeństwo poprzez ograniczenie widoczności między hostami w różnych podsieciach, lepsza kontrola nad ruchem sieciowym oraz łatwiejsze zarządzanie dużymi sieciami. Dzięki PVLAN administratorzy mogą tworzyć logiczne grupy urządzeń bez konieczności fizycznego segmentowania sieci, co jest szczególnie przydatne w środowiskach korporacyjnych i data center. Technologia ta jest wspierana przez wiele nowoczesnych przełączników warstwy drugiej i trzeciej, co czyni ją popularnym wyborem dla organizacji dążących do optymalizacji swojej infrastruktury sieciowej.

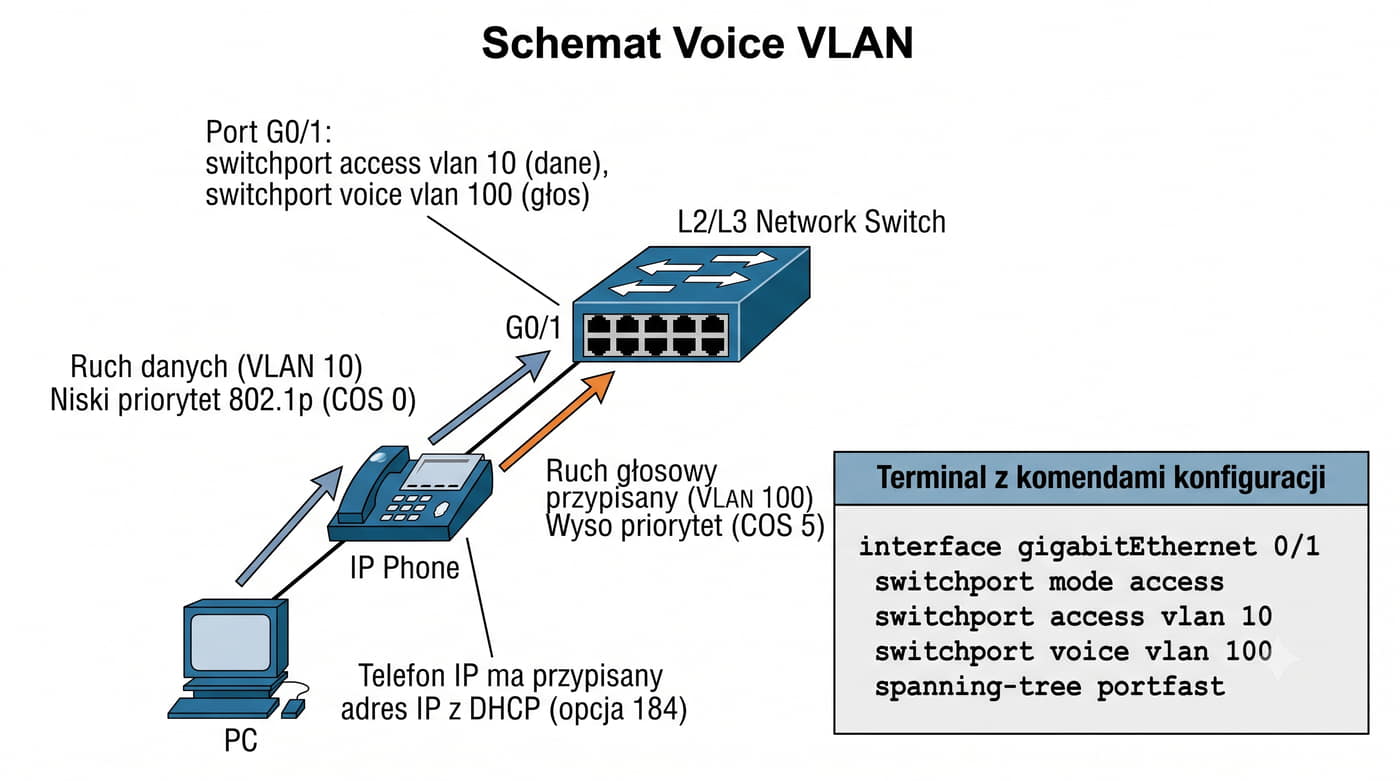
24/55 Voice VLAN
interface GigabitEthernet0/1
 switchport mode access
 switchport access vlan 10
 switchport voice vlan 100
 spanning-tree portfast
exit
! VLAN 10 dla danych i VLAN 100 dla głosu (VoIP)

Voice VLAN to specjalna funkcja przełączników umożliwiająca oddzielenie ruchu głosowego (VoIP) od danych na tym samym porcie fizycznym.

Telefon IP jest podłączony do portu przełącznika, a za telefonem znajduje się komputer PC.

Port jest skonfigurowany jako access dla danych i jednocześnie jako voice dla telefonu.

Telefon IP (VLAN 100) rozpoznaje VLAN głosowy dzięki protokołowi CDP (Cisco Discovery Protocol) lub LLDP-MED, a adres serwera TFTP/CUCM może otrzymać z DHCP (opcja 150), po czym taguje swoje ramki znacznikiem 802.1Q z priorytetem 802.1p (CoS 5).

Ruch danych (VLAN 10) pozostaje w niższym priorytecie.

Voice VLAN zapewnia jakość usług (QoS) dla komunikacji głosowej.

Voice VLAN to zaawansowana funkcja stosowana w przełącznikach sieciowych, która umożliwia fizyczne i logiczne oddzielenie ruchu głosowego (VoIP) od ruchu danych na tym samym porcie fizycznym. Dzięki temu możliwe jest zapewnienie wysokiej jakości transmisji głosu, nawet gdy port jest współdzielony z innymi urządzeniami. W praktyce oznacza to, że telefon IP podłączony do tego samego portu co komputer będzie miał priorytet w transmisji danych głosowych, co minimalizuje opóźnienia i utratę pakietów.

Konfiguracja Voice VLAN wymaga przypisania dwóch różnych sieci VLAN do jednego portu fizycznego - na przykład VLAN 10 dla danych i VLAN 100 dla głosu. Przełącznik nie analizuje zawartości ramek – telefon oznacza swoją ramkę tagiem 802.1Q (VLAN 100), natomiast ramki danych z komputera PC są przesyłane bez tagu (VLAN 10). Dodatkowo, mechanizmy takie jak QoS (Quality of Service) mogą być stosowane w obrębie Voice VLAN, aby jeszcze bardziej poprawić jakość transmisji głosu. Dzięki temu rozwiązaniu sieci VoIP są bardziej niezawodne i odporne na zakłócenia spowodowane ruchem danych.

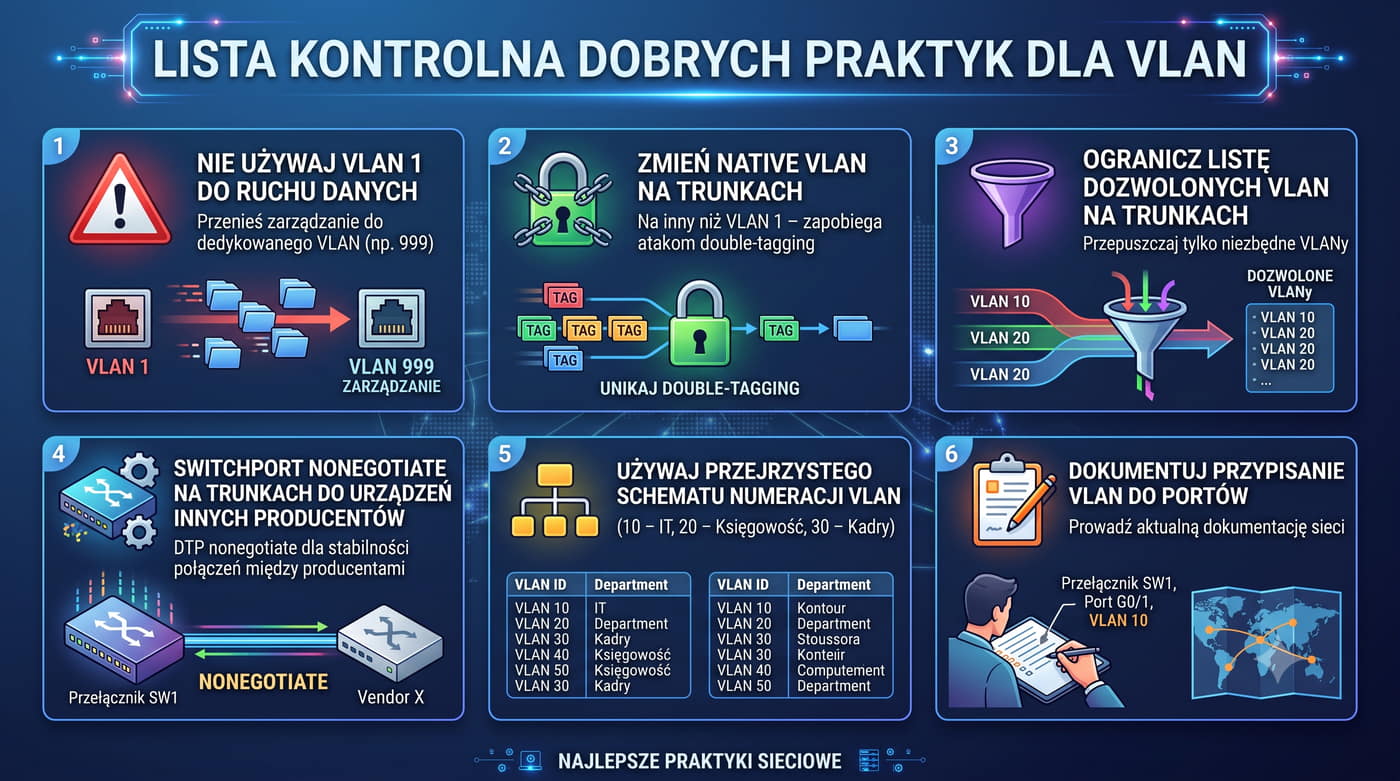
25/55 Dobre praktyki dla VLAN
  • VLAN 1 do ruchu danych – przenieś zarządzanie do dedykowanego VLAN (np. VLAN 999) i wyłącz nieużywane porty z VLAN 1.
  • Zmień native VLAN na trunkach na inny niż VLAN 1 – zapobiega to atakom double-tagging (VLAN hopping).
  • Ogranicz listę dozwolonych VLAN na trunkach – używaj switchport trunk allowed vlan z listą tylko niezbędnych.
  • Zawsze ustawiaj switchport nonegotiate na trunkach do urządzeń innych producentów – DTP jest protokołem Cisco.
  • Używaj przejrzystego schematu numeracji VLAN (np. VLAN 10 – IT, 20 – Księgowość, 30 – Kadry, 100 – Głos, 999 – Zarządzanie).
  • Dokumentuj przypisanie VLAN do portów i oznaczenia trunk – ułatwia to diagnostykę i audyt.

Poniżej zestawienie dobrych praktyk dotyczących konfiguracji i zarządzania VLAN w sieciach produkcyjnych.

Dobre praktyki konfiguracji VLAN są kluczowe dla bezpieczeństwa i efektywności sieci korporacyjnych. Jednym z podstawowych zaleceń jest dedykowanie osobnego VLAN (np. VLAN 999) wyłącznie do celów zarządzania urządzeniami sieciowymi, takimi jak przełączniki czy routery. Takie podejście minimalizuje ryzyko przypadkowego dostępu do interfejsów konfiguracyjnych przez użytkowników z innych segmentów sieci. Dodatkowo, wyłączenie nieużywanych portów z VLAN 1 zmniejsza powierzchnię ataku i upraszcza zarządzanie ruchem w sieci.

Kolejną ważną praktyką jest ustawienie native VLAN na trunkach innego niż VLAN 1. Domyślnie, gdy urządzenie odbiera ramkę z tagiem VLAN, automatycznie usuwa ten tag i przesyła ją w natywnym VLAN. Jeśli native VLAN jest ustawiony na 1, atakujący może wykorzystać tę lukę do przeskakiwania między sieciami VLAN (tzw. double-tagging lub VLAN hopping). Zmiana natywnego VLAN na inny niż 1 skutecznie blokuje takie ataki, wymuszając ręczne przełączanie między sieciami VLAN przez administratora.

Ograniczenie listy dozwolonych VLAN na trunkach to kolejny istotny element bezpieczeństwa. Używając polecenia switchport trunk allowed vlan z listą konkretnych identyfikatorów VLAN, administrator może precyzyjnie kontrolować, które segmenty sieci mogą komunikować się ze sobą przez dany port trunk. To zapobiega nieautoryzowanemu ruchowi między sieciami VLAN i ogranicza potencjalne ścieżki ataku. W połączeniu z innymi praktykami, takimi jak segmentacja sieci czy stosowanie list kontroli dostępu (ACL), te działania znacząco podnoszą ogólny poziom bezpieczeństwa infrastruktury sieciowej.

26/55 Podsumowanie bloku I – VLAN
  • VLAN dzieli przełącznik na izolowane domeny rozgłoszeniowe – poprawia bezpieczeństwo i wydajność.
  • Standard IEEE 802.1Q dodaje 4-bajtowy tag z 12-bitowym VID do ramki Ethernet.
  • Port Access – jeden VLAN bez tagu; Port Trunk – wiele VLAN z tagami 802.1Q.
  • Routing między VLAN – router-on-a-stick (subinterfejsy) lub przełącznik L3 (SVI).
  • VTP synchronizuje bazę VLAN, DTP negocjuje trunk – oba są protokołami Cisco.
  • Voice VLAN, Private VLAN – zaawansowane funkcje izolacji.

VLAN (Virtual Local Area Network) to technologia sieciowa, która umożliwia logiczne grupowanie urządzeń w ramach jednej fizycznej sieci lokalnej, tworząc izolowane domeny rozgłoszeniowe. Dzięki temu można zwiększyć bezpieczeństwo i wydajność sieci, ograniczając ruch do określonych grup urządzeń. Standard IEEE 802.1Q jest podstawą implementacji VLANów, dodając 4-bajtowy tag do każdej ramki Ethernet, zawierający 12-bitowy identyfikator sieci wirtualnej (VID). Port Access służy do obsługi pojedynczego VLANu bez użycia tagów, co jest wygodne dla prostych konfiguracji. Z kolei Port Trunk umożliwia przesyłanie ramek z wieloma tagami 802.1Q, co jest niezbędne w bardziej złożonych architekturach sieciowych.

Routing między VLANami stanowi kluczowy aspekt zarządzania siecią, ponieważ domyślnie ruch między różnymi VLANami jest blokowany. Aby umożliwić komunikację między nimi, stosuje się mechanizmy takie jak router-on-a-stick (subinterfejs routujący) lub przełączniki z funkcjonalnością routingu między VLANami. Router-on-a-stick to technika, w której router łączy się z przełącznikiem jednym łączem trunk (802.1Q), a na routerze tworzone są subinterfejsy po jednym dla każdego VLAN, umożliwiając routowanie ruchu IP między VLAN-ami. Dzięki temu można zachować izolację domen rozgłoszeniowych, jednocześnie zapewniając niezbędną komunikację między różnymi segmentami sieci.

W praktyce implementacja VLANów wymaga starannego planowania i konfiguracji, aby uniknąć problemów związanych z bezpieczeństwem i wydajnością. Należy odpowiednio dobrać numer VID dla każdej sieci wirtualnej, uwzględniając identyfikatory PVID (Port VLAN Identifier) przypisane do portów oraz zasady dostępu. Ponadto ważne jest monitorowanie i zarządzanie portami trunk, aby uniknąć przeciążeń i konfliktów w transmisji tagowanych ramek. Współczesne przełączniki oferują zaawansowane funkcje, takie jak VLAN policing, segmentacja ruchu czy integracja z systemami NAC (Network Access Control), co dodatkowo zwiększa elastyczność i bezpieczeństwo sieci opartej na technologii VLAN.

27/55 STP – wprowadzenie. Pętle w sieci L2
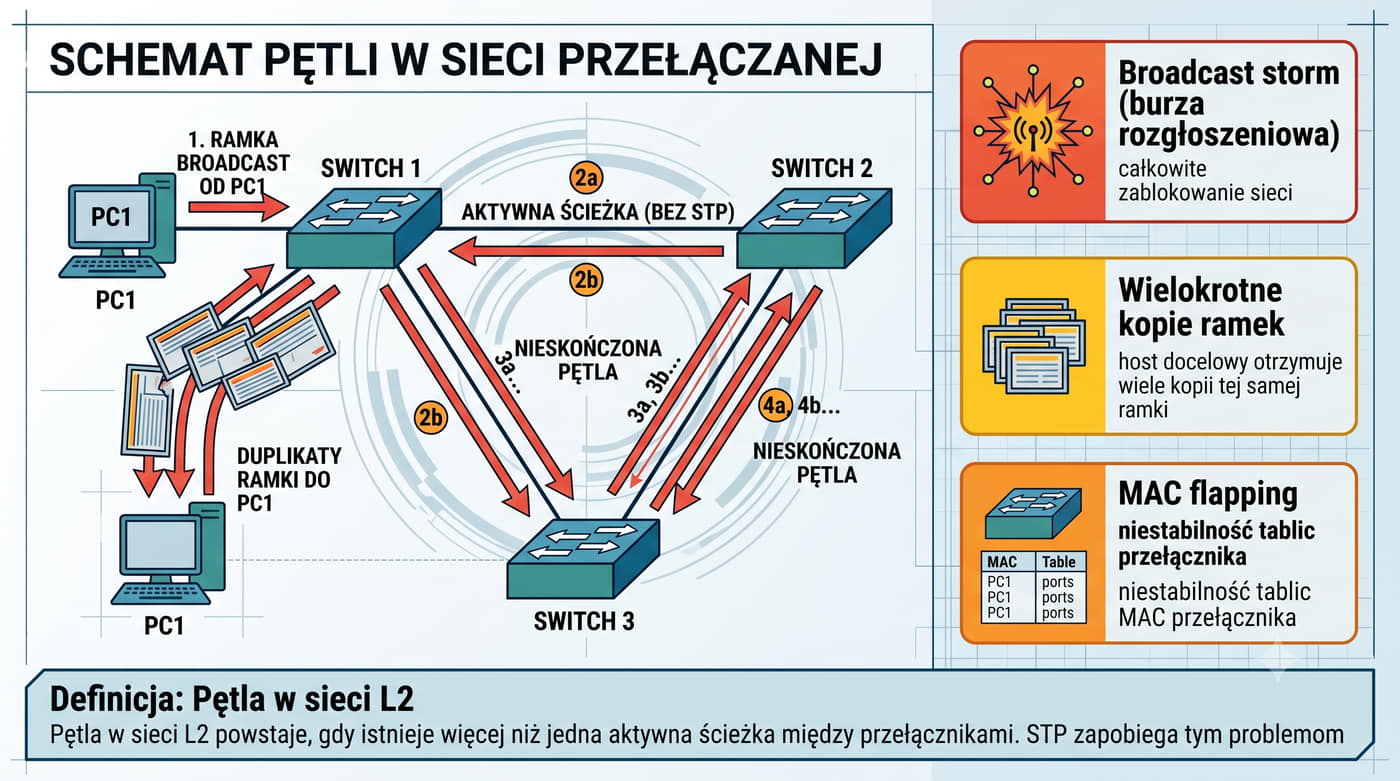
Pętla w sieci L2 powstaje, gdy istnieje więcej niż jedna aktywna ścieżka między przełącznikami. Skutki: broadcast storm, MAC flapping, duplikacja ramek.

MAC flapping

W sieciach Ethernet warstwy 2 nadmiarowe połączenia (redundancja) są konieczne do zapewnienia niezawodności – gdy jedno łącze ulegnie awarii, ruch może być przekierowany przez inne.

Jednak nadmiarowe łącza w sieci przełączanej bez zabezpieczenia powodują pętle (loops), które prowadzą do poważnych problemów.

Trzy główne zagrożenia wynikające z pętli L2.

Broadcast storm (burza rozgłoszeniowa) – ramki broadcast są bez końca retransmitowane przez przełączniki, powodując całkowite zablokowanie sieci.

Wielokrotne kopie ramek – host docelowy otrzymuje wiele kopii tej samej ramki, co powoduje błędy w protokołach wyższych warstw.

STP (Spanning Tree Protocol, IEEE 802.1D) został zaprojektowany, aby zapobiegać tym problemom.

Pętle w sieci L2, czyli pętle warstwy drugiej modelu OSI (Data Link Layer), występują, gdy istnieje więcej niż jedna ścieżka transmisji między dwoma urządzeniami sieciowymi, takimi jak przełączniki lub routery. W kontekście sieci opartych na protokole Spanning Tree Protocol (STP), pętle są niepożądanym zjawiskiem, które może prowadzić do poważnych problemów operacyjnych. STP został opracowany w celu eliminacji pętli i wyznaczenia jednej, najbardziej optymalnej ścieżki między urządzeniami, co zapobiega niepotrzebnemu ruchowi i potencjalnym awariom sieci.

Skutki istnienia pętli w sieci L2 są wielorakie i mogą znacząco wpłynąć na wydajność oraz stabilność sieci. Jednym z najbardziej widocznych efektów jest tzw. broadcast storm, czyli gwałtowny wzrost ruchu broadcastowego, który może przeciążyć łącza i spowodować degradację jakości usług (QoS). Innym problemem jest MAC flapping, czyli ciągła zmiana wpisu w tablicy adresów MAC przełącznika dla tej samej ramki – te same ramki docierają na różne porty, przez co przełącznik nieustannie aktualizuje przypisanie adresu MAC do portu, co prowadzi do niepotrzebnego zużycia zasobów procesora. Dodatkowo, duplikacja ramek (frame duplication) jest kolejnym skutkiem pętli, gdzie te same ramki są przesyłane wielokrotnie, co zwiększa obciążenie sieci i może prowadzić do błędów w aplikacjach końcowych.

W sieciach Ethernet redundancja połączeń jest często stosowana w celu zapewnienia nadmiarowości i niezawodności. Jednak bez odpowiedniego zarządzania, takiego jak STP, redundantne łącza mogą stać się źródłem pętli. Protokół STP działa na zasadzie wykluczania portów (wyłączania ich z użytku), aby zapobiec tworzeniu się pętli, jednocześnie zapewniając alternatywne ścieżki w przypadku awarii. Istnieją różne odmiany STP, takie jak Rapid Spanning Tree Protocol (RSTP) i Multiple Spanning Tree (MST), które oferują bardziej zaawansowane funkcje, takie jak szybsza konwergencja sieci i lepsze zarządzanie ruchem w dużych domenach broadcastowych. Właściwa konfiguracja STP jest kluczowa dla utrzymania wydajności i niezawodności nowoczesnych sieci komputerowych.

28/55 Algorytm STA – Spanning Tree Algorithm
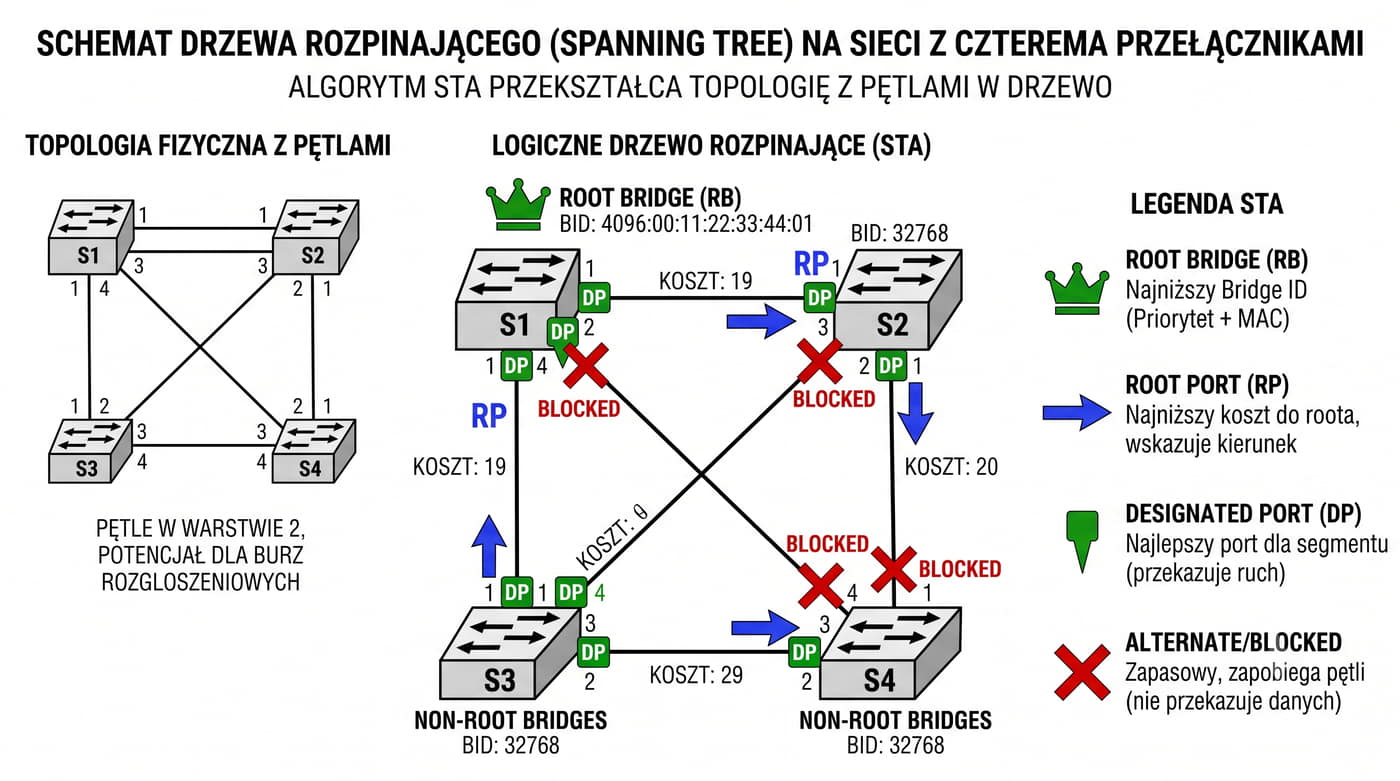
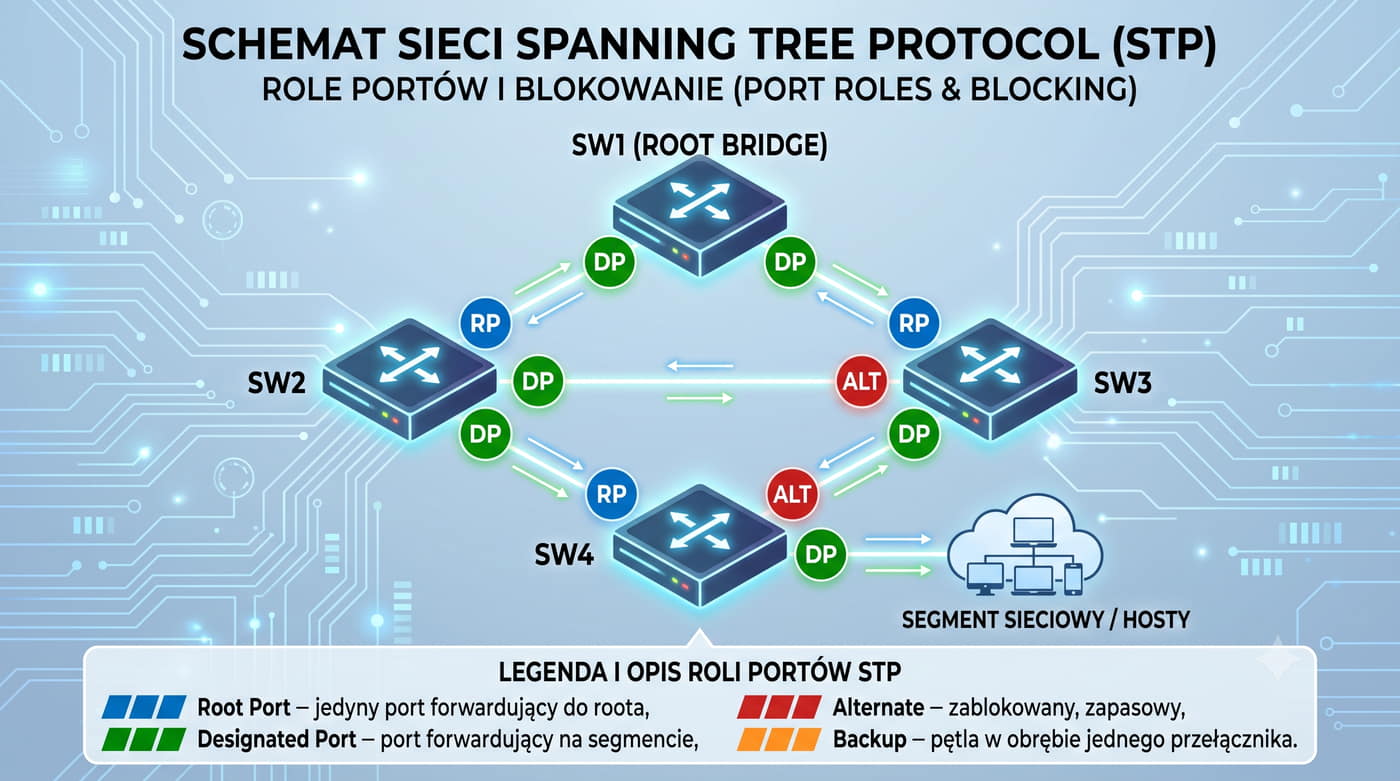
STA przekształca sieć z pętlami w drzewo rozpinające przez wybór: jednego root bridge, root portu na każdym non-root bridge i designated portu na każdym segmencie.

Spanning Tree Algorithm (STA) to algorytm leżący u podstaw STP.

Jego celem jest przekształcenie fizycznej sieci z pętlami w logiczne drzewo (spanning tree) bez pętli, poprzez zablokowanie niektórych portów.

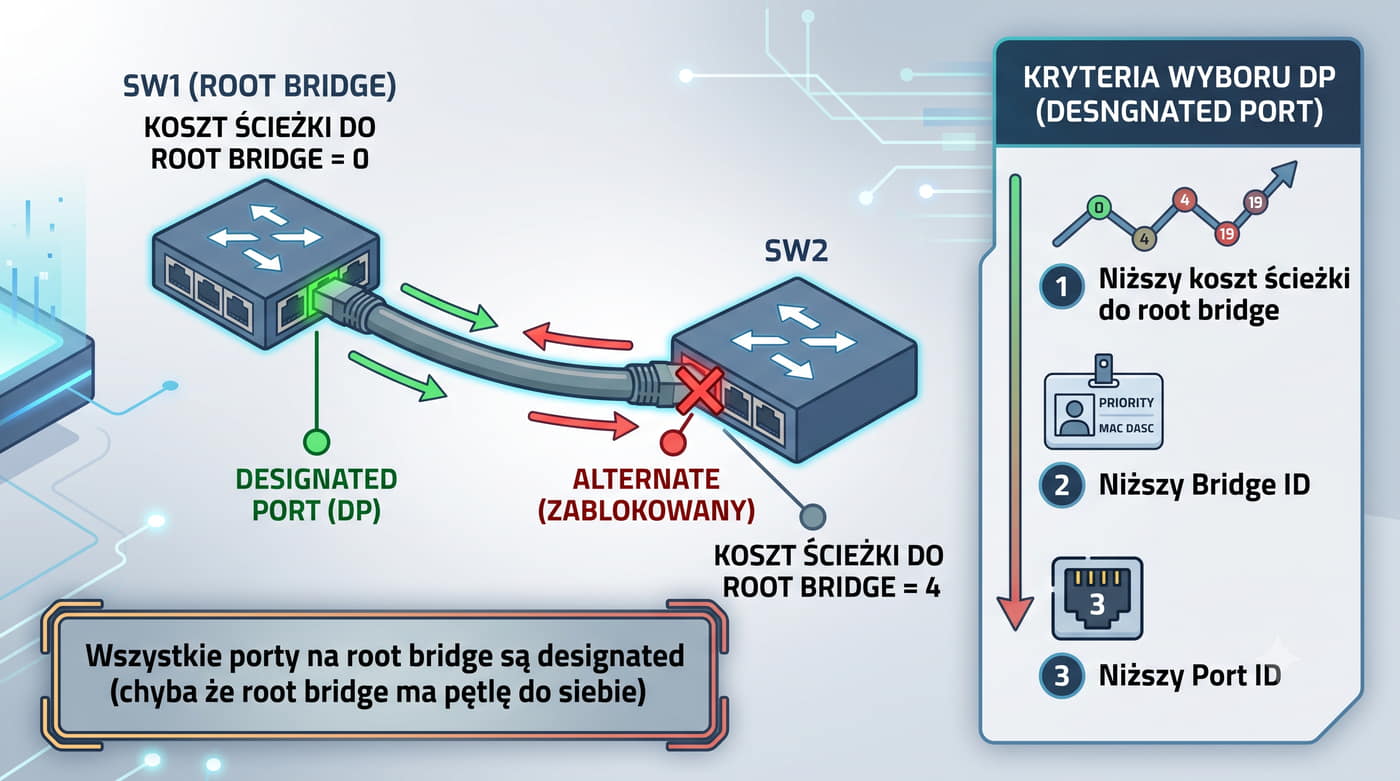
Algorytm wybiera jeden root bridge (most główny) i dla każdego przełącznika (non-root bridge) wyznacza jeden root port, a dla każdego segmentu sieci jeden designated port.

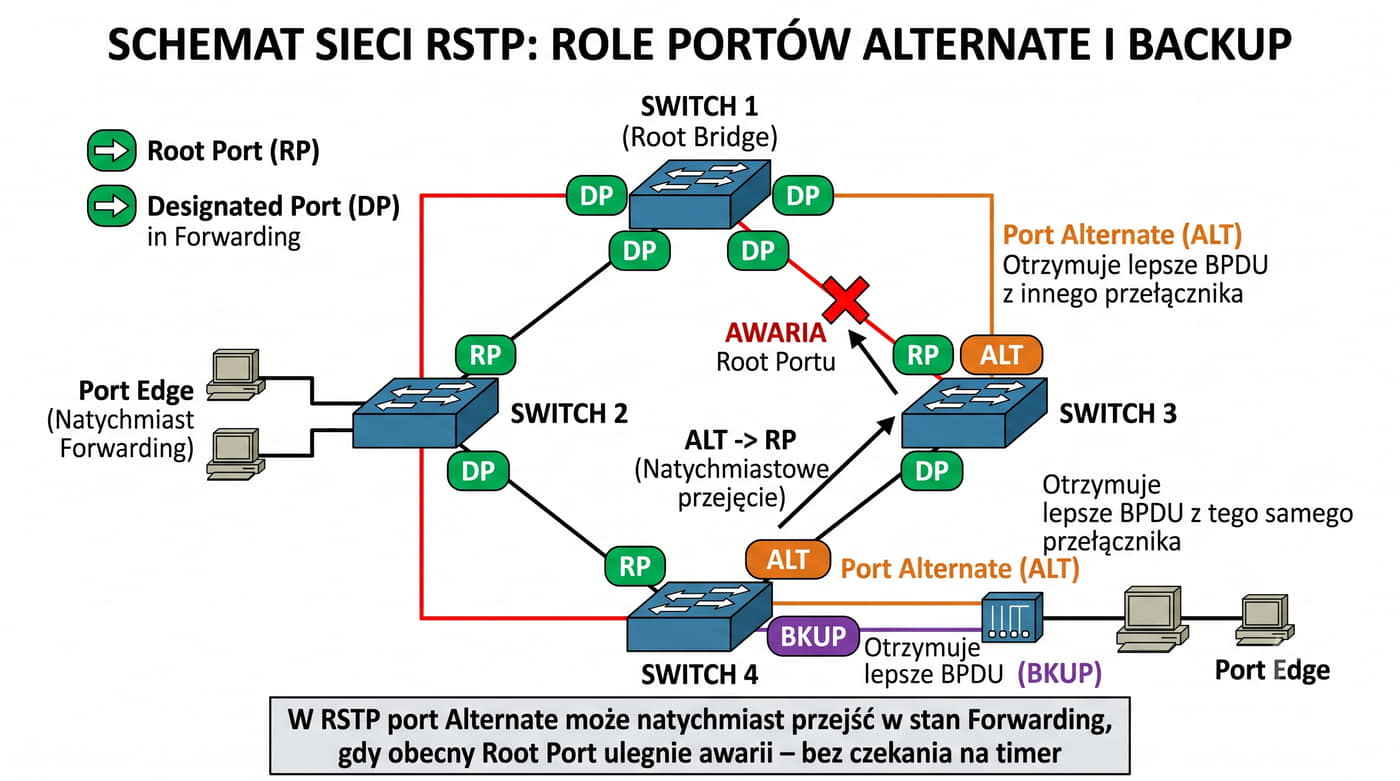
Pozostałe porty zostają zablokowane (alternate/backup).

Proces wyboru opiera się na wymianie ramek BPDU (Bridge Protocol Data Units) między przełącznikami.

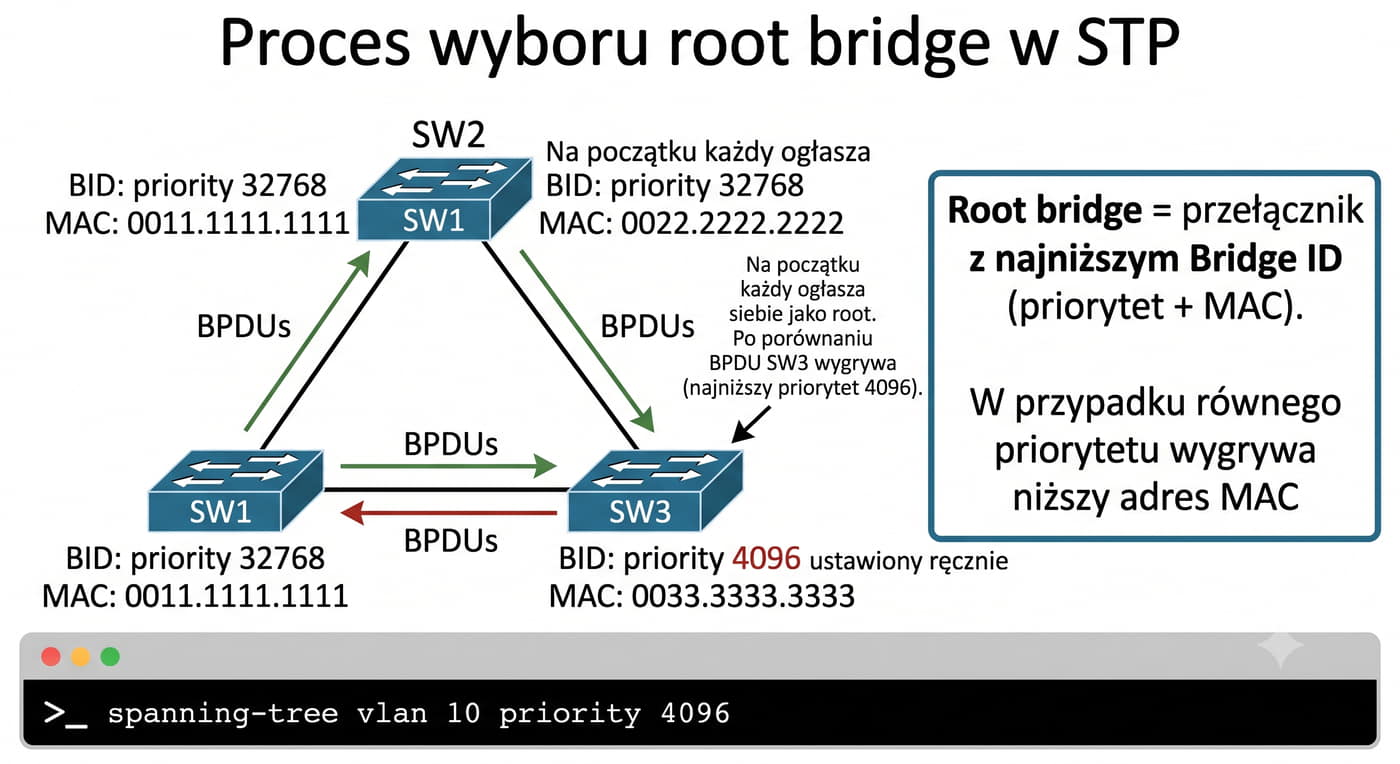
Każdy przełącznik początkowo ogłasza siebie jako root bridge, ale po otrzymaniu BPDU z niższym Bridge ID przyjmuje cudze zwycięstwo.

Ostatecznie root bridge staje się przełącznik z najniższym Bridge ID (priorytet + adres MAC).

Po wyborze root bridge, algorytm wyznacza root porty (najkrótsza ścieżka do root bridge) i designated porty (najlepszy przełącznik dla każdego segmentu).

Spanning Tree Algorithm (STA) to fundamentalny algorytm stosowany w sieciach komputerowych, którego głównym celem jest eliminacja pętli i zapewnienie jednej ścieżki komunikacyjnej między urządzeniami w sieci. Działa on na podstawie protokołu Spanning Tree Protocol (STP) lub jego rozszerzeń, takich jak Rapid Spanning Tree Protocol (RSTP). STA przekształca fizyczną topologię sieci z możliwymi pętlami w logiczną strukturę drzewa rozpinającego. W tej strukturze każdy segment sieci ma tylko jeden port dostępowy (designated port), co zapobiega przesyłaniu ramek przez wiele ścieżek i potencjalnym kolizjom lub pętlom transmisyjnym.

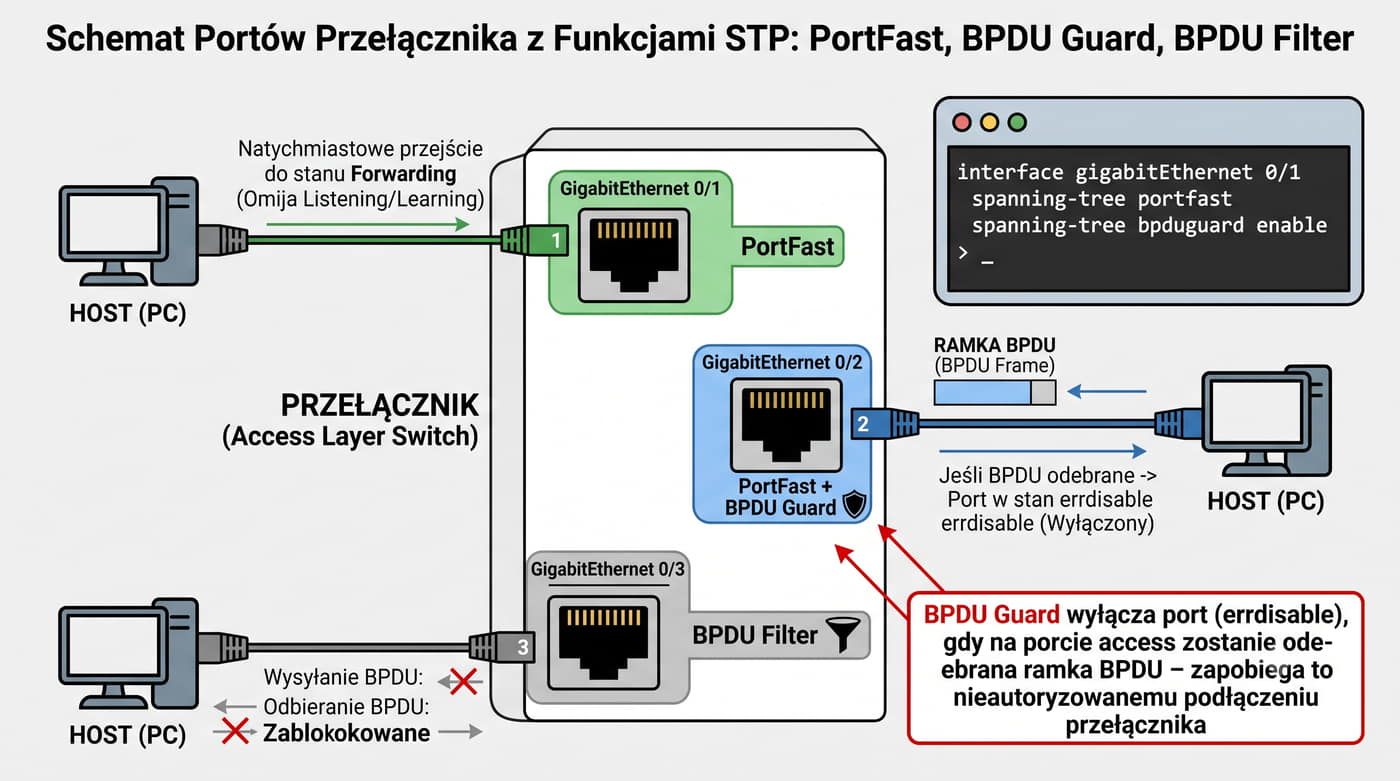
Kluczowym elementem działania STA jest wybór tzw. root bridge, czyli głównego mostu (przełącznika) w sieci, który staje się centralnym punktem zarządzającym drzewem rozpinającym. Każdy inny przełącznik w sieci musi wybrać jeden port jako root port, przez który będzie komunikował się z root bridge. Proces ten odbywa się poprzez wymianę informacji między urządzeniami, takich jak priorytety mostów i koszty ścieżek, aby określić najbardziej optymalną ścieżkę. Algorytm wykorzystuje ramki Bridge Protocol Data Unit (BPDU), a funkcje bezpieczeństwa takie jak BPDU Guard chronią przed nieautoryzowanymi przełącznikami w warstwie drugiej modelu OSI.

STA jest niezbędny w sieciach z przełączaniem, szczególnie tam, gdzie występuje wiele połączeń między urządzeniami. Jego działanie opiera się na iteracyjnym procesie, w którym przełączniki uczą się topologii sieci i dynamicznie dostosowują swoje konfiguracje portów. W przypadku zmian w topologii, takich jak dodanie lub usunięcie segmentu sieci, STA automatycznie rekonfiguruje drzewo rozpinające, minimalizując czas przestoju i zapewniając ciągłość komunikacji. Dzięki temu algorytmowi sieci przełączane mogą działać wydajnie i niezawodnie, nawet w złożonych konfiguracjach fizycznych.

29/55 BPDU – budowa i typy

Istnieją dwa typy BPDU.

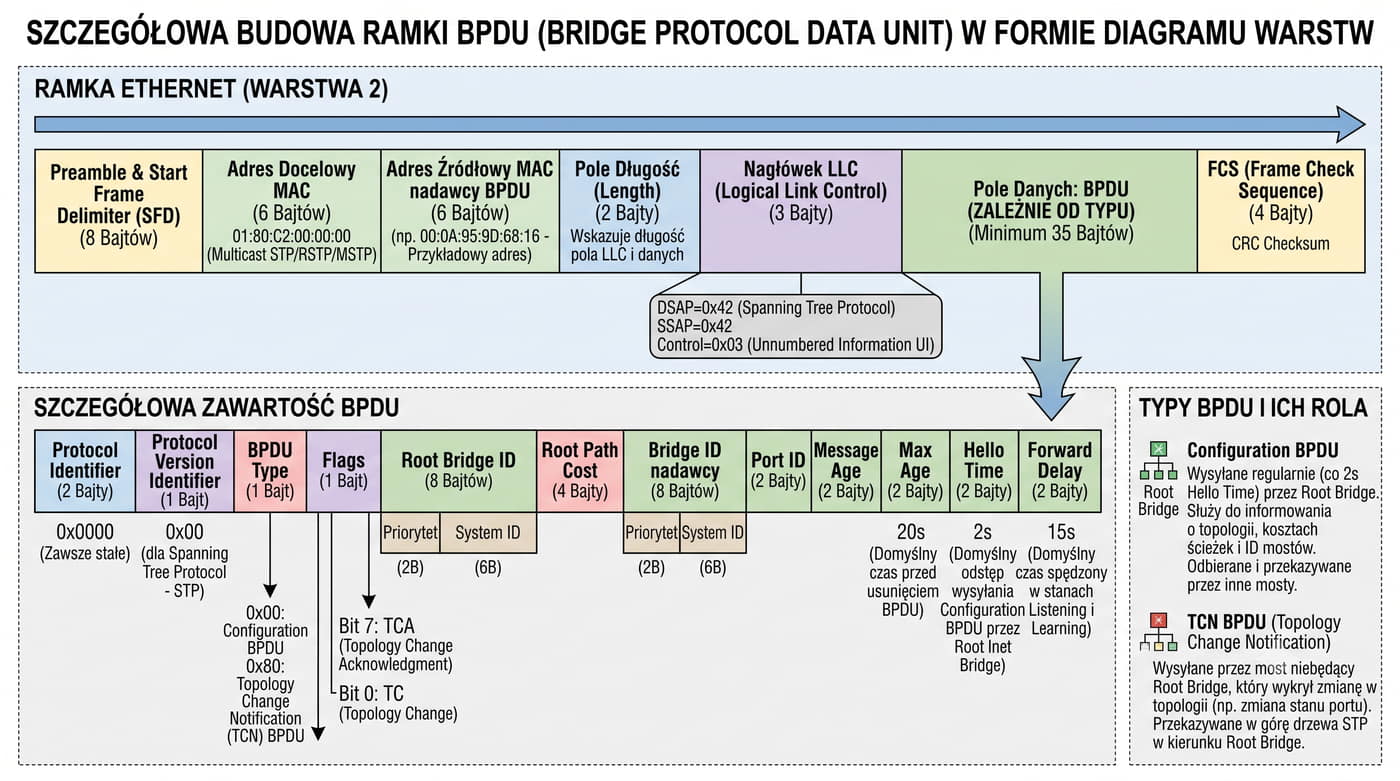
BPDU (Bridge Protocol Data Unit) to ramka zarządzająca STP, wysyłana przez przełączniki w celu wymiany informacji o topologii.

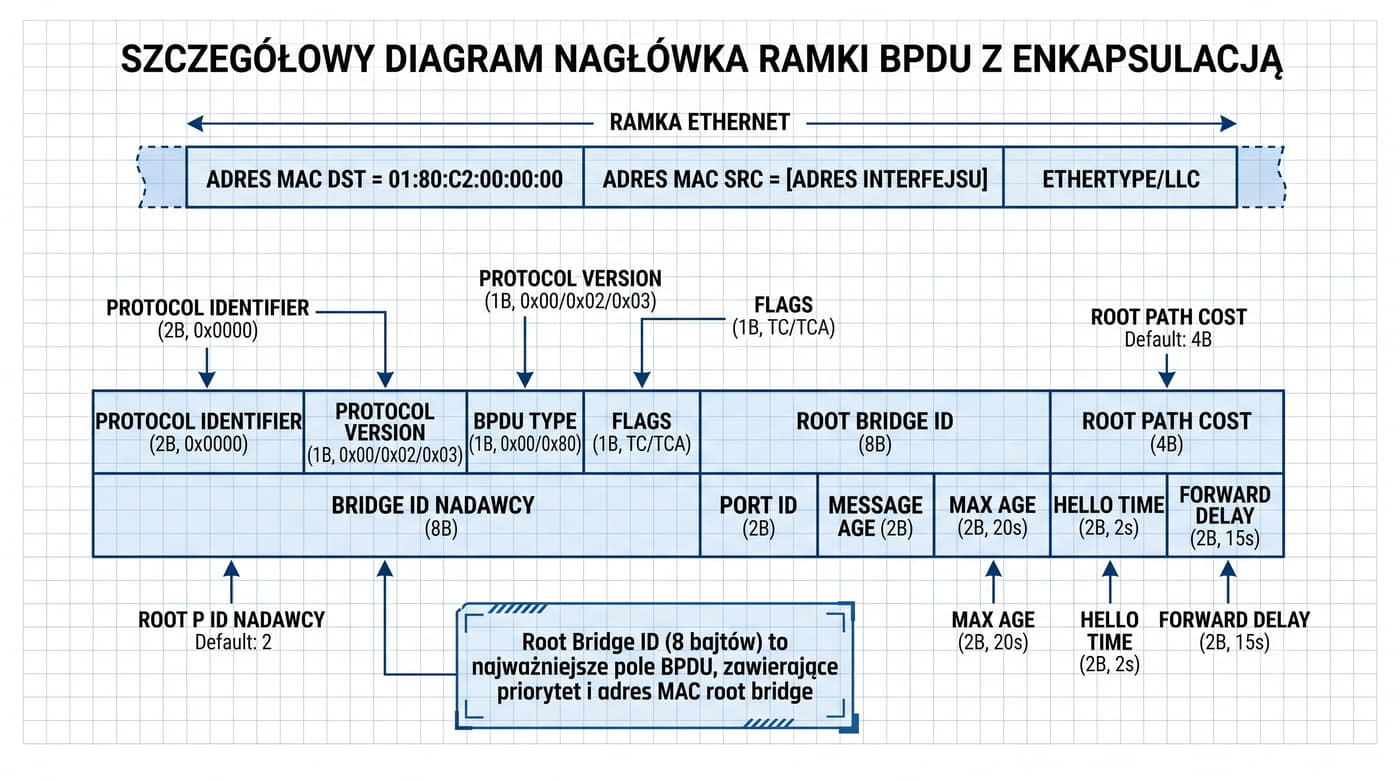
BPDU jest enkapsulowany bezpośrednio w ramce Ethernet z adresem docelowym grupy mostów 01:80:C2:00:00:00.

Standardowy STP (802.1D) używa enkapsulacji LLC z DSAP=SSAP=0x42, natomiast Cisco PVST+ używa ethertype 0x010B w enkapsulacji SNAP (RSTP i MSTP również używają enkapsulacji LLC, z innym identyfikatorem wersji).

Configuration BPDU – wysyłany przez root bridge co Hello Time (domyślnie 2 s).

Zawiera: Bridge ID roota, koszt ścieżki do roota, Bridge ID nadawcy, identyfikator portu, Hello Time, Max Age, Forward Delay.

TCN (Topology Change Notification) BPDU – wysyłany przez przełącznik, który wykrył zmianę topologii (np. awaria łącza).

TCN jest potwierdzany przez najbliższy designated bridge, który przekazuje informację do root bridge.

Root bridge po otrzymaniu TCN wysyła Configuration BPDU z flagą Topology Change, wymuszając skrócenie czasu starzenia wpisów MAC (Forward Delay zamiast Max Age).

BPDU (Bridge Protocol Data Unit) to kluczowy element w działaniu protokołu STP (Spanning Tree Protocol), który zapobiega pętlom w sieciach komputerowych. W klasycznym STP (IEEE 802.1D) występują dwa rodzaje ramek BPDU: Configuration BPDU oraz TCN BPDU (Topology Change Notification). Configuration BPDU jest wysyłany cyklicznie przez root bridge (domyślnie co 2 sekundy – Hello Time) i zawiera identyfikator mostu wysyłającego (priorytet i adres MAC), koszt ścieżki do root bridge, identyfikatory portu oraz parametry czasowe. Ramki te są wysyłane na adres grupowy mostów (01:80:C2:00:00:00) i enkapsulowane bezpośrednio w ramce Ethernet, co umożliwia ich propagację przez sieć.

TCN BPDU jest wysyłany przez przełącznik, który wykryje zmianę topologii (np. awarię lub dodanie łącza), i informuje root bridge o konieczności odświeżenia tablic adresów MAC. Z kolei nowsze wersje protokołu – RSTP (802.1w) i MSTP (802.1s) – wykorzystują rozszerzony format BPDU przenoszący dodatkowe informacje (takie jak role i stany portów oraz flagi agreement/proposal), dzięki czemu umożliwiają znacznie szybszą konwergencję. Warto zauważyć, że BPDU są ramkami zarządzającymi i nie powinny być przesyłane w normalnym ruchu użytkowników, dlatego wiele przełączników oferuje możliwość ich blokowania na określonych portach.

W praktyce, zarówno Configuration BPDU, jak i TCN BPDU odgrywają kluczową rolę w utrzymaniu spójności topologii sieciowej. Protokół STP wykorzystuje te ramki do negocjacji hierarchii (drzewa rozpinającego), co zapobiega powstawaniu pętli i zapewnia jedną ścieżkę dla ruchu między segmentami sieci. Zrozumienie budowy i typów BPDU jest niezbędne dla administratorów sieci, aby efektywnie konfigurować przełączniki i zapewniać stabilność oraz bezpieczeństwo sieci. W nowoczesnych sieciach, gdzie stosuje się zaawansowane mechanizmy, takie jak RSTP, MSTP czy PVST+, znajomość tych ramek pozwala na lepszą optymalizację działania protokołu.

30/55 Wybór root bridge
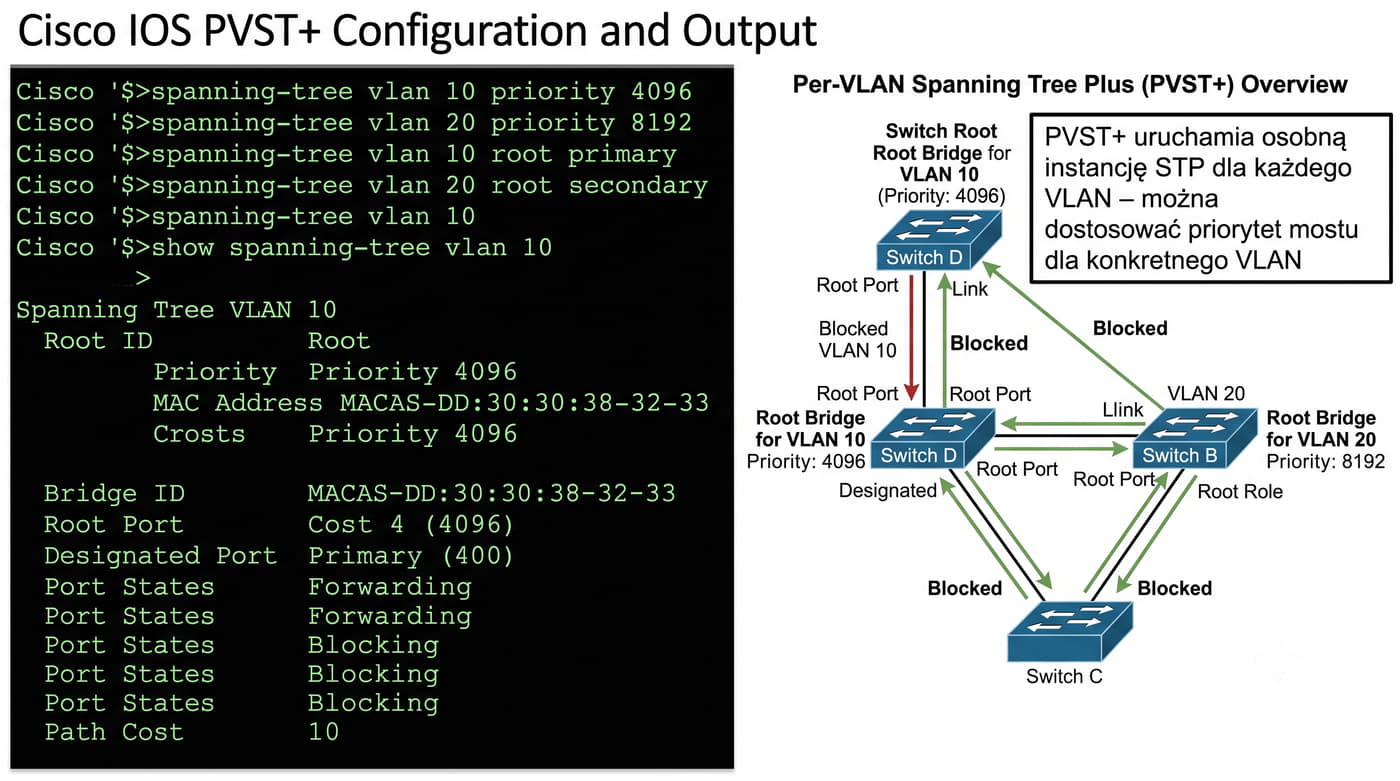
W rozszerzonym systemie ID (PVST+) niższe 12 bitów priorytetu przechowuje numer VLAN, co pozwala na niezależną instancję STP dla każdego VLAN.

Wybór root bridge to pierwszy krok algorytmu STA.

Każdy przełącznik na starcie uważa się za root bridge i wysyła BPDU z własnym Bridge ID w polu Root Bridge ID.

Gdy otrzyma BPDU z niższym (lepszym) Bridge ID, przestaje uważać się za root i zaczyna propagować BPDU z cudzym Bridge ID.

Bridge ID (BID) to 8-bajtowa wartość składająca się z dwóch części: priorytetu (2 bajty, wartość 0-65535, domyślnie 32768) i adresu MAC (6 bajtów).

W przypadku równego priorytetu decyduje niższy adres MAC.

W rozszerzonym systemie ID (PVST+) niższe 12 bitów priorytetu przechowuje numer VLAN, co pozwala na niezależne drzewo rozpinające dla każdego VLAN.

Wtedy priorytet jest wielokrotnością 4096.

Wybór root bridge jest kluczowym elementem w działaniu sieci VLAN opartych na protokole Spanning Tree Protocol (STP). Algorytm STA, będący częścią STP, ma za zadanie zapobiegać pętlom i wyznaczać jeden root bridge dla całej domeny rozgłoszeniowej. Każdy przełącznik w sieci początkowo uważa się za potencjalny root bridge i wysyła Bridge Protocol Data Units (BPDU) z własnym identyfikatorem Bridge ID. BPDU zawierają informacje o priorytecie przełącznika oraz jego adresie MAC, co pozwala innym urządzeniom ocenić, który przełącznik powinien pełnić rolę root bridge.

Proces wyboru root bridge opiera się na porównywaniu wartości Bridge ID. Przełącznik z najniższym (najlepszym) identyfikatorem Bridge ID zostaje uznany za root bridge, a pozostałe przełączniki stają się mostami podrzędnymi (ang. descendant bridges). Wartość Bridge ID jest zazwyczaj kombinacją priorytetu przełącznika i adresu MAC, gdzie niższa wartość priorytetu oraz niższy (mniejszy) adres MAC dają lepszy identyfikator. Gdy przełącznik otrzyma BPDU z niższym Bridge ID, przestaje uważać się za root i zaczyna propagować BPDU z nowym root bridge, co prowadzi do konwergencji całej domeny.

W praktyce, wybór root bridge może być również kontrolowany przez administratora poprzez ustawienie priorytetu przełącznika (niższa wartość oznacza większą szansę na bycie root). Dzięki temu można zapewnić, że wybrany przełącznik będzie pełnił rolę centralnego punktu drzewa rozpinającego. Prawidłowe skonfigurowanie root bridge jest niezbędne dla stabilności i bezpieczeństwa sieci, ponieważ zapobiega niepożądanym pętlom i zapewnia spójność topologii w obrębie domeny rozgłoszeniowej.

31/55 Wybór root portu (Root Port)

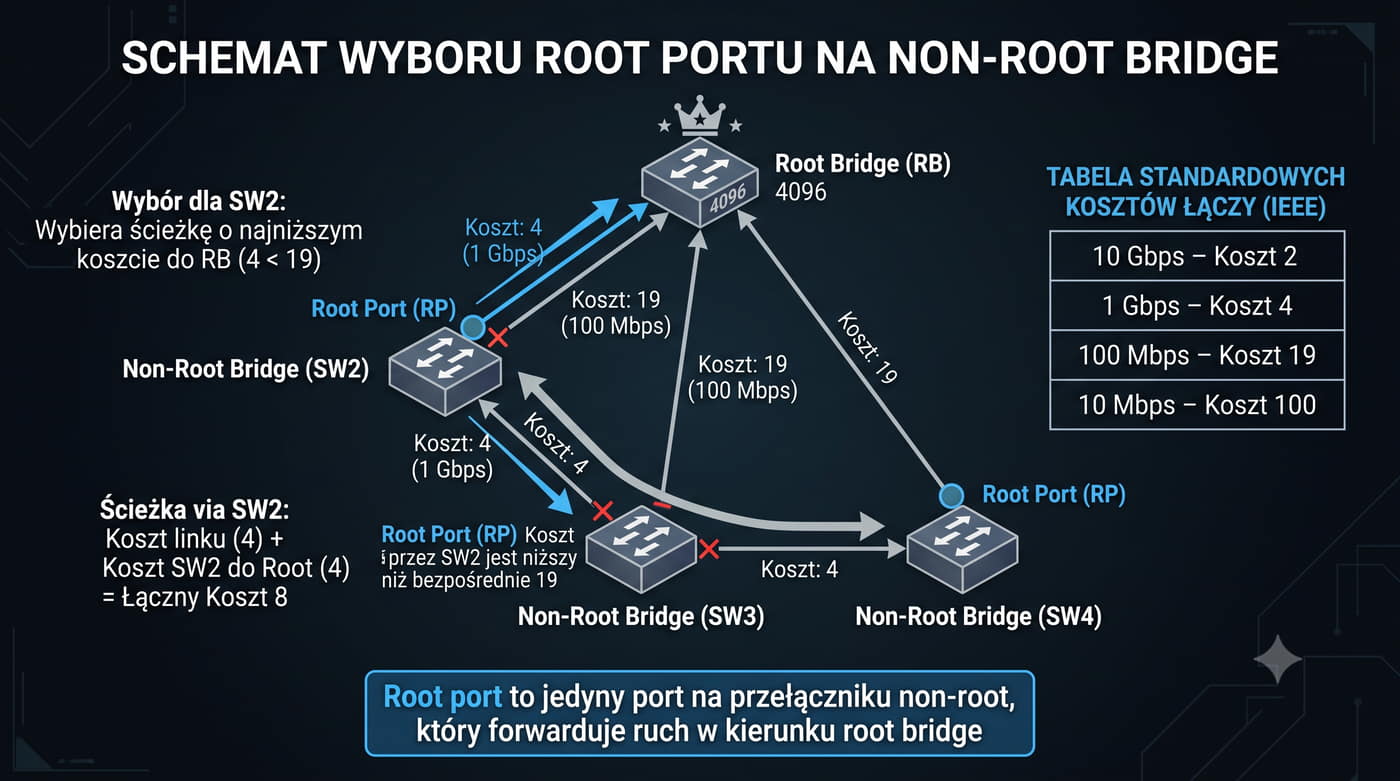
Po wyborze root bridge każdy przełącznik niebędący root (non-root bridge) wybiera jeden root port (RP) – port z najniższym kosztem ścieżki do root bridge.

Koszt ścieżki (path cost) jest sumą kosztów wszystkich łączy na drodze do root bridge.

Koszt łącza zależy od jego prędkości: 10 Mbps – 100, 100 Mbps – 19, 1 Gbps – 4, 10 Gbps – 2, 40 Gbps – 1, 100 Gbps – 1.

Jeśli dwa porty mają ten sam koszt ścieżki, decydują kolejne kryteria: niższy Bridge ID sąsiedniego przełącznika (na który wskazuje port), a następnie niższy identyfikator portu (Port ID).

Port ID składa się z priorytetu portu (1 bajt, domyślnie 128) i numeru portu (1 bajt).

Root port to jedyny port na przełączniku non-root, który forwarduje ruch w kierunku root bridge.

Pozostałe porty mogą być zablokowane lub designated.

Wybór root portu (Root Port, RP) jest kluczowym elementem w działaniu protokołu Spanning Tree Protocol (STP), który zapobiega pętlom i zapewnia pojedynczą ścieżkę komunikacyjną między przełącznikami w sieci. Po wybraniu root bridge, każdy inny przełącznik musi określić swój root port jako ten o najniższym koszcie ścieżki do root bridge. Koszt ścieżki jest sumą kosztów poszczególnych łączy na drodze do root bridge, a te z kolei są przypisywane w oparciu o prędkość połączenia - im wyższa prędkość (np. 1 Gbps), tym niższy koszt liczbowy jest mu przypisany.

Proces ten ma na celu zapewnienie, że ruch sieciowy będzie przesyłany przez najbardziej efektywne i niezawodne ścieżki w sieci. W praktyce oznacza to preferowanie szybszych połączeń (o niższym koszcie) do przesyłania ruchu, co jest szczególnie ważne w dużych i złożonych sieciach korporacyjnych. Warto zauważyć, że root port nie tylko minimalizuje opóźnienia (latencję) ale także może wpływać na redundancję ścieżek w przypadku awarii jednego z łączy - dzięki mechanizmom takim jak Rapid Spanning Tree Protocol (RSTP), sieć jest w stanie szybko przełączać się na alternatywne ścieżki.

Dodatkowo, wybór root portu wpływa na zarządzanie ruchem w sieciach z PVST+/PVST – każdy VLAN ma wówczas własne drzewo rozpinające i odpowiednio dobrany root port dla optymalizacji ruchu wewnątrz tego VLAN. W kontekście bezpieczeństwa, poprawna konfiguracja root portów jest istotna, aby uniknąć nieautoryzowanego dostępu do segmentów sieci. W nowoczesnych rozwiązaniach, takich jak Link Aggregation Control Protocol (LACP), root port może być również częścią agregacji łączy, co dodatkowo zwiększa przepustowość i niezawodność połączeń.

32/55 Wybór designated portu (Designated Port)

Designated port (DP) to port na każdym segmencie sieci (łączu między przełącznikami), który ma najniższy koszt ścieżki do root bridge.

Każdy segment sieci ma dokładnie jeden designated port – jeśli dwa przełączniki łączą się tym samym kablem, jeden z nich będzie miał designated port, a drugi (z wyższym kosztem) będzie miał port zablokowany (alternate).

Proces wyboru designated port przebiega następująco.

Dla danego segmentu porównuje się koszty ścieżki do root bridge obu przełączników.

Niższy koszt wygrywa – ten przełącznik ma designated port na tym segmencie.

Jeśli koszty są równe, decyduje niższy Bridge ID przełącznika.

Jeśli Bridge ID są równe (ten sam przełącznik), decyduje niższy Port ID.

Wszystkie porty na root bridge są designated (chyba że root bridge ma pętlę do siebie).

Wybór designated portu (DP) jest kluczowym elementem w działaniu protokołu Spanning Tree Protocol (STP), który zapobiega pętlom i zapewnia pojedynczą ścieżkę komunikacyjną między segmentami sieci. Designated port to jedyny aktywny port na przełączniku, przez który dany segment sieci jest podłączony do domeny rozgłoszeniowej. Jego wybór opiera się na kryterium najkrótszej (najtańszej) ścieżki do root bridge'a - głównego przełącznika w danej sieci, który inicjuje proces STP.

Proces wyboru designated portu rozpoczyna się od analizy topologii sieci przez każdy przełącznik. Przełączniki porównują koszty ścieżek do root bridge'a, które są określane na podstawie szybkości łączy na danej ścieżce – im szybsze łącze, tym niższy koszt liczbony jest mu przypisany. Port o najniższym koszcie staje się designated portem, a pozostałe przechodzą w stan blokady (blocking state), aby uniknąć konfliktów i pętli. W przypadku równych kosztów, przełącznik wybiera port o niższym numerze identyfikacyjnym (lower port ID).

Designated port odgrywa istotną rolę w zapewnieniu spójności domeny rozgłoszeniowej. Umożliwia on komunikację między segmentami sieci, jednocześnie blokując niepotrzebne połączenia. W sieciach kampusowych, gdzie występuje wiele przełączników i łączy, poprawny wybór designated portów jest niezbędny dla efektywnego zarządzania ruchem i utrzymania stabilności sieci. Administratorzy mogą ręcznie zmieniać priorytety portów, aby wpływać na wybór designated portu w przypadku równych kosztów ścieżek, co jest szczególnie przydatne w złożonych topologiach sieciowych.

33/55 Role portów w STP
  • Root Port (RP) – jedyny port na non-root bridge, który forwarduje ruch w kierunku root bridge. Wybierany na podstawie najniższego kosztu ścieżki do roota.
  • Designated Port (DP) – port, który forwarduje ruch na danym segmencie sieci. Każdy segment ma jeden DP. Wszystkie porty root bridge są DP.
  • Alternate Port (ALT) – port zablokowany, który otrzymuje lepsze BPDU z innego przełącznika (alternatywna ścieżka do roota). Stanowi kopię zapasową dla root portu.
  • Backup Port (BKUP) – port zablokowany, który otrzymuje lepsze BPDU z tego samego przełącznika (dwa porty tego samego przełącznika w tym samym segmencie, np. dwa kable między tymi samymi urządzeniami). Rzadko spotykany.
  • Disabled – port administracyjnie wyłączony (shutdown) lub nieuczestniczący w STP.

W standardowym STP (802.1D) każdy port przełącznika pełni jedną z pięciu ról.

Role portów w STP (Spanning Tree Protocol) są kluczowe dla prawidłowego funkcjonowania sieci opartych na mostach i przełącznikach. Root Port (RP) to jedyny port na niekorzeniowym moście lub przełączaczu, który przekazuje ruch w kierunku root bridge'a. Jego wybór odbywa się na podstawie najniższego kosztu ścieżki do korzenia, co zapewnia optymalną komunikację między urządzeniami. Designated Port (DP) to port, który jest odpowiedzialny za przekazywanie ruchu na danym segmencie sieci; każdy segment ma tylko jeden DP. Wszystkie porty root bridge'a są automatycznie uznawane za DP, co umożliwia efektywną dystrybucję ruchu w całej domenie STP. Porty, które nie otrzymują roli Root Port ani Designated Port, przechodzą w stan blokady – pełnią one rolę rezerwową (Alternate otrzymuje lepsze BPDU z innego przełącznika, a Backup z tego samego przełącznika). Zrozumienie tych ról jest niezbędne dla konfiguracji i diagnostyki sieci opartych na STP, gwarantując brak pętli i optymalną komunikację między urządzeniami.

W praktyce, wybór Root Porta jest procesem dynamicznym, który może się zmieniać w odpowiedzi na zmiany topologii sieci, takie jak dodanie nowego urządzenia lub awaria łącza. Algorytm STA wykorzystuje ramki BPDU (Bridge Protocol Data Unit) do wykrywania i zapobiegania pętlom w sieci. Porty, które nie są Root Portami ani Designated Portami na danym segmencie, są blokowane (blocked), aby uniknąć niepotrzebnego ruchu i potencjalnych problemów z wydajnością. W zaawansowanych konfiguracjach sieciowych administratorzy mogą wpływać na wybór ścieżek, zmieniając priorytety mostów i portów, co jest szczególnie przydatne w dużych domenach STP, gdzie automatyczny wybór może prowadzić do nieoptymalnych ścieżek. Ważne jest również zrozumienie, że STP działa na warstwie drugiej modelu OSI, co oznacza, że jego funkcjonowanie jest niezależne od protokołów warstwy trzeciej, takich jak IP.

Współczesne implementacje STP często wykorzystują rozszerzenia, takie jak Rapid Spanning Tree Protocol (RSTP), który przyspiesza proces konwergencji sieci po zmianach topologii. RSTP skraca czas konwergencji oraz wprowadza nowe role portów (Alternate, Backup); dodatkowo parametr portfast pozwala portowi dostępowemu natychmiast przejść do stanu Forwarding. Ponadto, niektóre przełączniki obsługują funkcje takie jak Root Guard, które zapobiegają przypadkowemu staniu się root bridge'em przez urządzenie, co mogłoby zakłócić działanie całej domeny STP. Znajomość tych mechanizmów jest niezbędna dla efektywnego zarządzania siecią i minimalizacji przestojów. W konkluzji, role portów w STP - Root Port, Designated Port i alternatywne porty - są fundamentem dla utrzymania spójności i wydajności sieci opartych na technologii mostkowania.

34/55 Stany portów w STP
StanCzas trwaniaForwardowanie ramekNauka MAC
Blockingdo 20 s (Max Age)NieNie
Listening15 s (Forward Delay)NieNie
Learning15 s (Forward Delay)NieTak
ForwardingStałyTakTak
DisabledNieNie

W STP (IEEE 802.1D) port przechodzi przez pięć stanów.

Czas przejścia między stanami jest kontrolowany przez trzy timery: Hello Time (2 s, odstęp między BPDU), Forward Delay (15 s, czas w stanie Learning i Listening) oraz Max Age (20 s, czas przechowywania BPDU bez aktualizacji).

Całkowity czas konwergencji STP wynosi od 30 do 50 s (Max Age + 2 x Forward Delay).

To bardzo długo w porównaniu do nowoczesnych protokołów (RSTP – sekundy, MSTP – sekundy).

W tym czasie sieć nie przekazuje ruchu użytkownika na danych łączach.

Stany portów w STP (Spanning Tree Protocol) są kluczowym elementem zarządzania siecią, szczególnie w kontekście unikania pętli i zapewnienia jednej ścieżki transmisji danych między urządzeniami. STP działa na podstawie standardu IEEE 802.1D i jest niezbędny w sieciach opartych na przełącznikach, gdzie wiele portów może być połączonych z tym samym segmentem sieci. Protokół ten przypisuje każdemu portowi jeden z pięciu stanów: Blocking, Listening, Learning, Forwarding i Disabled. Każdy stan ma określone cechy i czas trwania, które determinują zachowanie portu w sieci.

W stanie Blocking (Blokowania) port nie przekazuje ramek danych ani nie uczy się adresów MAC; pozostaje w tym stanie maksymalnie przez czas Max Age (domyślnie 20 sekund). Jest to początkowy stan, w którym port nie wie jeszcze, czy jest częścią pętli. W stanie Listening (Nasłuchiwania) port nasłuchuje BPDU (Bridge Protocol Data Unit), aby ustalić położenie w drzewie rozpinającym; trwa to 15 sekund (Forward Delay), po czym port przechodzi do stanu Learning. W stanie Learning port uczy się adresów MAC urządzeń w swoim segmencie, ale nie przekazuje jeszcze ramek danych; po upływie kolejnego Forward Delay (15 sekund) przechodzi do stanu Forwarding.

Stan Forwarding (Przekazywania) jest aktywnym stanem, w którym port staje się częścią drzewa rozgłoszeniowego: przekazuje ramki danych oraz dalej uczy się adresów MAC. Jest to stan docelowy dla większości portów w sieci. Stan Disabled (Wyłączony) oznacza port administracyjnie wyłączony (polecenie shutdown) lub nieuczestniczący w STP – taki port nie przekazuje ramek ani nie przetwarza BPDU. Zrozumienie tych stanów jest kluczowe dla efektywnego zarządzania siecią i diagnozowania problemów związanych z pętlami w sieci.

35/55 RSTP – Rapid Spanning Tree (IEEE 802.1w)
RSTP skraca czas konwergencji z 30-50 s do ok. 1 s (typowo 0,5-2 s) dzięki mechanizmowi proposal-agreement i roli Alternate. Jest domyślnie włączony na nowoczesnych przełącznikach.

RSTP (Rapid Spanning Tree Protocol, IEEE 802.1w) to udoskonalona wersja STP, która zapewnia znacznie szybszą konwergencję (1-3 s zamiast 30-50 s).

RSTP jest kompatybilny wstecz z STP 802.1D i automatycznie dostosowuje się do starszych przełączników.

Został włączony do standardu IEEE 802.1D-2004.

RSTP wprowadza kilka kluczowych usprawnień.

Zmniejsza liczbę stanów portów do trzech: Discarding (odpowiednik Blocking + Disabled), Learning, Forwarding.

Wprowadza nowe role portów: Alternate (gorsza ścieżka do roota, szybsze przejęcie po awarii RP) i Backup (gorsza ścieżka do tego samego segmentu).

Port Edge (odpowiednik PortFast) – port podłączony do hosta, natychmiast przechodzi w stan Forwarding bez procesu STP.

Mechanizm proposal-agreement – przełącznik może wysłać propozycję i uzyskać zgodę od sąsiada, co pozwala na błyskawiczne przejście portu w stan Forwarding.

RSTP (Rapid Spanning Tree Protocol, IEEE 802.1w) to zaawansowana wersja protokołu STP, zaprojektowana w celu znacznego skrócenia czasu konwergencji sieci. W przeciwieństwie do tradycyjnego STP, który może potrzebować nawet 50 sekund na pełną konwergencję drzewa rozpinającego, RSTP osiąga ten sam efekt znacznie szybciej (typowy czas konwergencji to około 1 sekundy, często od 0,5 do 2 sekund). Jest to możliwe dzięki wykorzystaniu mechanizmu proposal-agreement, który umożliwia szybkie rozgłaszanie informacji o topologii sieci oraz natychmiastowe przełączanie na porty alternatywne (role Alternate) w przypadku awarii.

Kluczową cechą RSTP jest jego zdolność do dynamicznego dostosowywania się do zmian w topologii sieci bez konieczności przechodzenia przez pełny cykl konwergencji STP. Proces ten rozpoczyna się od fazy Root Port Selection, gdzie wybierany jest główny port (root port) dla każdego urządzenia w sieci. Następnie, w fazie proposal-agreement, przełączniki wymieniają informacje o swoich propozycjach dotyczących ról portów (designated, alternate, blocking), co pozwala na szybkie uzgodnienie optymalnej konfiguracji. W przypadku awarii łącza, RSTP automatycznie aktywuje wcześniej skonfigurowane porty alternatywne, minimalizując czas niedostępności usług.

Warto zaznaczyć, że RSTP jest domyślnie włączony na większości nowoczesnych przełącznikach warstwy drugiej i trzeciej, co ułatwia jego implementację w sieciach przedsiębiorstw. Jednakże, aby zapewnić pełną kompatybilność i uniknąć potencjalnych problemów z urządzeniami starszej generacji, administratorzy powinni dokładnie sprawdzić konfigurację swoich sieci. RSTP jest szczególnie przydatny w środowiskach wymagających wysokiej dostępności i szybkiego przełączania awaryjnego, takich jak centra danych czy sieci korporacyjne o dużej skali. Dzięki RSTP, przedsiębiorstwa mogą liczyć na niezawodną i wydajną infrastrukturę sieciową, zdolną do szybkiego reagowania na zmiany i awarie.

36/55 RSTP – role Alternate i Backup

Nowe role to Alternate i Backup.

W RSTP role portów są rozszerzone w porównaniu do klasycznego STP.

Role Root, Designated i Disabled pozostają bez zmian.

Port Alternate to port, który otrzymuje lepsze BPDU z innego przełącznika (alternatywna ścieżka do root bridge).

W STP był to po prostu zablokowany port.

W RSTP port Alternate może natychmiast przejść w stan Forwarding, gdy obecny Root Port ulegnie awarii – bez czekania na timer.

Port Backup to port, który otrzymuje lepsze BPDU z tego samego przełącznika (to samo urządzenie), co wskazuje na pętlę w obrębie jednego przełącznika.

Port Backup jest mniej przydatny, ale również może szybko przejąć funkcje portu Designated w razie potrzeby.

RSTP definiuje również typ portu Edge (brzegowy) – port podłączony do hosta końcowego, który od razu przechodzi do stanu Forwarding bez wykonywania algorytmu STP.

Jeśli na porcie Edge pojawi się BPDU, traci on status Edge i staje się zwykłym portem STP.

RSTP (Rapid Spanning Tree Protocol) wprowadza dwie nowe role portów w porównaniu do klasycznego STP: Alternate i Backup. Te role zostały dodane, aby zapewnić szybszą konwergencję sieci oraz lepsze wykorzystanie redundancji łączy. W przeciwieństwie do klasycznych ról Root Port i Designated Port (oraz stanów takich jak Forwarding czy Disabled), role Alternate i Backup są bardziej zaawansowane i pozwalają na dynamiczne dostosowywanie się sieci do zmieniających się warunków.

Port w roli Alternate otrzymuje lepsze BPDU (Bridge Protocol Data Unit) z innego przełącznika, co oznacza, że staje się alternatywną ścieżką do root bridge. W klasycznym STP taki port byłby po prostu zablokowany i nie brałby udziału w przesyłaniu ruchu. W RSTP port Alternate może przejąć funkcję portu Root w przypadku awarii, co znacznie skraca czas konwergencji sieci. Dzięki temu redundancja łączy jest lepiej wykorzystywana, a sieć staje się bardziej odporna na uszkodzenia.

Port w roli Backup otrzymuje lepsze BPDU z tego samego przełącznika, a jego głównym zadaniem jest zapewnienie dodatkowej ścieżki zapasowej w obrębie jednego segmentu. W przeciwieństwie do portu Alternate, port Backup nie czeka na awarię zewnętrznego łącza, lecz przejmuje rolę Designated automatycznie w przypadku awarii swojego bliskiego sąsiada w segmencie. Role Alternate i Backup są szczególnie przydatne w sieciach, gdzie wymagana jest wysoka dostępność i szybka rekonfiguracja po wystąpieniu błędów. Dzięki nim RSTP oferuje bardziej elastyczne i efektywne zarządzanie topologią sieci w porównaniu do starszego protokołu STP.

37/55 PortFast, BPDU Guard i BPDU Filter
interface GigabitEthernet0/1
 spanning-tree portfast
 spanning-tree bpduguard enable
exit
! PortFast + BPDU Guard na porcie access

PortFast to funkcja Cisco (obecnie standard RSTP – Edge Port), która pozwala portowi przełącznika natychmiast przejść w stan Forwarding zamiast czekać przez Listening i Learning (30 s).

Stosuje się ją na portach access podłączonych do hostów końcowych, gdzie nie ma ryzyka pętli.

Jeśli na porcie z PortFast pojawi się BPDU, port może utracić ten status i zacząć normalnie uczestniczyć w STP.

BPDU Guard to mechanizm bezpieczeństwa, który wyłącza port (errdisable), gdy na porcie access zostanie odebrana ramka BPDU.

Zapobiega to sytuacji, w której ktoś podłączy przełącznik do portu access, co mogłoby zakłócić topologię STP.

BPDU Filter z kolei blokuje wysyłanie i odbieranie BPDU na danym porcie.

Może być stosowany na portach, gdzie wiemy na pewno, że nie ma innych przełączników, ale jest ryzykowny – może ukryć nieautoryzowane podłączenie urządzenia sieciowego.

PortFast to funkcja wprowadzona przez Cisco, która pozwala portowi przełącznika natychmiast przejść w stan Forwarding (przekazywania ruchu) z pominięciem faz Listening i Learning, charakterystycznych dla protokołu Spanning Tree Protocol (STP). Dzięki temu urządzenia podłączone do takiego portu mogą niemal natychmiast rozpocząć transmisję danych. W nowszych wersjach standardu IEEE 802.1D funkcja ta została zintegrowana jako Edge Port, co oznacza, że porty na krawędzi sieci (np. accessowe) mogą być skonfigurowane do szybkiego przejścia w stan Forwarding bez konieczności używania polecenia portfast.

BPDU Guard to mechanizm zabezpieczający porty edge (accessowe) przed nieuprawnionymi ramkami BPDU. Po włączeniu funkcji (polecenie spanning-tree bpduguard enable) w momencie otrzymania ramki BPDU na porcie przełącznik przenosi ten port w stan errdisable (wyłącza go), co uniemożliwia podłączonemu urządzeniu próbę przejęcia roli root bridge lub zaburzenia topologii STP. Port musi zostać ręcznie wznowiony po usunięciu przyczyny.

Połączenie funkcji PortFast (lub Edge Port) z BPDU Guard jest szczególnie przydatne na portach accessowych, gdzie urządzenia końcowe mogą generować nieoczekiwane ramki BPDU. Dzięki temu sieć jest zabezpieczona przed błędami konwergencji, a jednocześnie zapewniona jest szybka dostępność portu dla ruchu użytkowników. Warto jednak pamiętać, że nieostrożne stosowanie PortFast może ukryć przypadkowe pętle, ponieważ port przechodzi od razu do stanu Forwarding, z pominięciem etapów diagnostycznych STP. Dlatego zaleca się ostrożne i przemyślane używanie tej funkcji, zwłaszcza w dużych sieciach korporacyjnych.

38/55 MSTP – Multiple Spanning Tree (IEEE 802.1s)

Mapowanie VLAN na jedną instancję drzewa rozpinającego.

PVST+ (Per VLAN Spanning Tree) każdy VLAN ma osobne drzewo, co dla 1000 oznacza 1000 instancji STP – duże obciążenie CPU i pamięci.

MSTP pozwala zgrupować wiele VLAN w jedną instancję (MSTI – Multiple Spanning Tree Instance).

MSTP dzieli sieć na regiony MST (MST Region).

W obrębie regionu przełączniki muszą mieć tę samą konfigurację: nazwę regionu, numer wersji i mapowanie na MSTI.

Między regionami MSTP używa wspólnego drzewa CIST (Common and Internal Spanning Tree), które integruje wszystkie regiony w jeden spanning tree.

MSTI 0 (CIST) jest zawsze obecna i domyślnie obsługuje wszystkie VLAN, które nie są przypisane do innych MSTI.

Liczba MSTI jest ograniczona do 64 w standardzie IEEE 802.1s; w IOS klasycznym (Cisco) liczba instancji wynosi 16 (15 MSTI + CIST), a na nowszych platformach 65 (64 MSTI + CIST).

MSTP (Multiple Spanning Tree Protocol) to rozszerzenie standardu IEEE 802.1s, które pozwala na efektywne zarządzanie wieloma sieciami VLAN w kontekście drzew rozpinających. W przeciwieństwie do PVST+ (Per VLAN Spanning Tree Plus), gdzie każdy VLAN ma osobną instancję STP, MSTP umożliwia grupowanie wielu VLAN-ów w jedną instancję drzewa rozpinającego. To znacząco redukuje obciążenie procesora i pamięci urządzeń sieciowych, co jest szczególnie istotne w dużych sieciach z setkami VLAN-ów.

MSTP dzieli całą domenę broadcastową na segmenty logiczne zwane MSTI (Multiple Spanning Tree Instance). Każda instancja może obejmować wiele VLAN-ów, co pozwala na bardziej efektywne wykorzystanie zasobów. Dzięki temu mechanizmowi urządzenia mogą dynamicznie dostosowywać konfigurację drzewa rozpinającego w zależności od potrzeb, minimalizując jednocześnie liczbę operacji związanych z utrzymaniem spójności sieci. MSTP jest szczególnie przydatny w środowiskach, gdzie występuje duża liczba VLAN-ów i konieczne jest zapewnienie redundancji oraz szybkiej rekonfiguracji po awarii.

Implementacja MSTP wymaga współpracy między przełącznikami w obrębie regionu MST, które muszą mieć identyczną konfigurację (nazwę regionu, wersję i mapowanie VLAN na instancje). Konfiguracja obejmuje określenie priorytetów dla poszczególnych MSTI oraz przypisanie VLAN-ów do instancji. Dzięki temu możliwe jest tworzenie bardziej złożonych topologii sieciowych, które są jednocześnie wydajne i odporne na uszkodzenia. MSTP stanowi ważny krok w ewolucji technologii STP, oferując lepszą skalowalność i elastyczność w zarządzaniu współczesnymi sieciami korporacyjnymi.

39/55 Konfiguracja PVST+ w Cisco IOS
spanning-tree vlan 10 priority 4096
! VLAN 10 – ten przełącznik będzie root

spanning-tree vlan 20 priority 8192
! VLAN 20 – backup root

spanning-tree vlan 10 root primary
! Alternatywny zapis – automatycznie ustawia priorytet na 4096

spanning-tree vlan 20 root secondary
! Ustawia priorytet na 8192 (backup dla roota)

show spanning-tree vlan 10
! Sprawdzenie drzewa dla VLAN 10

Polecenie show spanning-tree wyświetla: root bridge (adres MAC, priorytet), root port, designated port, stany portów oraz koszty.

Użyteczne przy diagnostyce topologii STP.

PVST+ (Per VLAN Spanning Tree Plus) uruchamia osobną instancję STP dla każdego VLAN.

Można dostosować priorytet mostu dla konkretnego VLAN, co pozwala sterować, który przełącznik będzie root bridge dla danego VLAN.

Konfiguracja PVST+ (Per VLAN Spanning Tree Plus) w Cisco IOS jest kluczowym elementem zarządzania siecią VLAN, szczególnie w dużych i rozproszonych środowiskach. W przeciwieństwie do klasycznego spanning-tree (STP), PVST+ tworzy niezależną instancję drzewa rozpinającego dla każdego VLAN, co pozwala na równoważenie obciążenia między łączami trunk. W sieci PVST+ można wskazać, który przełącznik ma być root bridge dla danego VLAN: polecenie spanning-tree vlan 10 priority 4096 nadaje mostowi najniższy (najlepszy) priorytet dla VLAN 10, a polecenie root secondary (używane w trybie konfiguracji mostu dla danego VLAN) wyznacza most zapasowy.

Poprawna konfiguracja polega na wydaniu poleceń spanning-tree vlan 10 root primary (lub spanning-tree vlan 10 priority 4096) oraz spanning-tree vlan 20 root secondary. Stan drzewa dla konkretnego VLAN sprawdza się poleceniem show spanning-tree vlan 10, które wyświetla identyfikator root bridge, root port, designated porty oraz stany portów.

Konfiguracja PVST+ wymaga starannego planowania, aby uniknąć pętli w sieci VLAN. Wartości priorytetów muszą być odpowiednio dobrane, aby zapewnić logiczną hierarchię drzew. W przypadku awarii głównego root (VLAN 10), PVST+ automatycznie przełączy się na root secondary (VLAN 20), minimalizując czas przestoju.

40/55 Konfiguracja RSTP w RouterOS
/interface bridge set most1 protocol-mode=rstp
# Włączenie RSTP na moście (domyślnie rstp)

/interface bridge set most1 priority=0x4000
# Ustawienie priorytetu mostu (0x4000 = 16384)

/interface bridge port set [find interface=ether2] edge=yes
# Oznaczenie portu ether2 jako edge (PortFast – host końcowy)

/interface bridge port print
# Wyświetlenie stanu portów i ich roli STP

W RouterOS każdy port mostu może być skonfigurowany jako edge (PortFast) lub nie.

Rola portu (root, designated, alternate, backup) jest widoczna w kolumnie role w /interface bridge port print.

Status (disabled, learning, forwarding) znajduje się w kolumnie status.

RouterOS (MikroTik) obsługuje RSTP na mostach (bridge).

Domyślnie most używa RSTP, ale można to zmienić na STP lub MSTP.

Konfiguracja sprowadza się do włączenia protokołu na moście i ustawienia priorytetu mostu dla kontroli wyboru root bridge.

Konfiguracja RSTP (Rapid Spanning Tree Protocol) w systemie RouterOS jest kluczowym elementem zarządzania siecią, szczególnie w środowiskach, gdzie niezawodność i szybkość konwergencji są priorytetowe. RSTP to protokół warstwy drugiej (Data Link Layer), który zapobiega pętlom w sieciach Ethernet poprzez dynamiczne ustalanie ścieżek rozgłoszeniowych i blokowanie niepotrzebnych portów. W RouterOS konfiguracja RSTP odbywa się za pomocą poleceń interfejsu mostka (bridge).

Aby włączyć RSTP na moście, używamy polecenia /interface bridge set most1 protocol-mode=rstp. W nowszych wersjach RouterOS tryb RSTP jest domyślny, ale jawna konfiguracja zapewnia przejrzystość i kontrolę. Kolejnym krokiem jest ustawienie priorytetu mostu za pomocą polecenia /interface bridge set most1 priority=0x4000, gdzie wartość 0x4000 (16384) określa pozycję mostu w hierarchii drzewa rozgłoszeniowego. Niższa wartość priorytetu oznacza większą szansę na bycie root bridge.

Ważnym aspektem konfiguracji RSTP jest identyfikacja portów krańcowych (edge ports), które łączą się bezpośrednio z hostami końcowymi. Aby oznaczyć port ether2 jako edge, używamy polecenia /interface bridge port set [find interface=ether2] edge=yes. Dzięki temu port ten będzie działał w trybie PortFast, co przyspiesza konwergencję sieci poprzez natychmiastowe przejście do stanu forwarding. Konfiguracja RSTP wymaga starannego planowania, aby zapewnić optymalną wydajność i niezawodność sieci.

41/55 Konfiguracja MSTP w Cisco IOS
spanning-tree mode mst
! Przełączenie z PVST+ na MST

spanning-tree mst configuration
 name REGION_GLOWNY
 revision 1
instance 1 vlan 10,20,30
instance 2 vlan 40,50
exit
! Definicja regionu MST i mapowanie VLAN na MSTI 1 i 2

spanning-tree mst 1 priority 4096
! Ustawienie priorytetu dla MSTI 1

show spanning-tree mst
! Wyświetlenie informacji o MSTP

W Cisco IOS MSTP konfiguruje się w trybie konfiguracji spanning-tree mst.

Najpierw przełączamy tryb STP na MST (przełącznik musi być w trybie MST, a nie PVST+).

Następnie definiujemy region MST: nazwę, numer wersji i mapowanie na instancje MSTI.

MSTP wymaga spójnej konfiguracji regionu na wszystkich przełącznikach w obrębie regionu.

Różnice w nazwie regionu lub mapowaniu powodują, że przełączniki będą traktować siebie jako osobne regiony, co może prowadzić do nieoptymalnej topologii.

Konfiguracja MSTP (Multiple Spanning Tree Protocol) w Cisco IOS jest kluczowym elementem zarządzania siecią, szczególnie w dużych i rozproszonych środowiskach. Protokół ten zapobiega pętlom w warstwie drugiej (Data Link Layer) poprzez wybór jednej ścieżki dla każdego segmentu sieci, co zapewnia spójność i niezawodność transmisji. W przeciwieństwie do tradycyjnego protokołu STP (Spanning Tree Protocol), MSTP obsługuje wiele instancji drzewa rozpinającego, co jest niezbędne w sieciach z wieloma domenami broadcastowymi lub VLAN-ami.

Aby skonfigurować MSTP, należy najpierw przełączyć tryb STP na MST za pomocą polecenia spanning-tree mode mst. Następnie definiuje się regiony MST, które grupują przełączniki w logiczne segmenty. Każdy region może mieć przypisane różne priorytety i nazwy, co ułatwia zarządzanie i diagnostykę. Na przykład, polecenie spanning-tree mst configuration name REGION_GLOWNY revision 1 tworzy region MST o nazwie REGION_GLOWNY z numerem wersji 1, a mapowanie VLAN-ów na instancje wykonuje się komendami instance 1 vlan 10,20,30 oraz instance 2 vlan 40,50. Mapowanie VLAN-ów na instancje musi być identyczne na wszystkich przełącznikach w obrębie regionu.

Ważnym aspektem konfiguracji MSTP jest ustawienie priorytetów dla poszczególnych MSTI, które decydują o tym, który most będzie root dla danej instancji. Na przykład, spanning-tree mst 1 priority 4096 ustawia priorytet MSTI 1 na najniższą (najlepszą) wartość, zwiększając szansę mostu na bycie rootem tej instancji. Monitorowanie stanu drzewa rozpinającego umożliwia polecenie show spanning-tree mst, które dostarcza szczegółowych informacji o konfiguracji i stanie poszczególnych instancji.

42/55 Porównanie STP vs RSTP vs MSTP
CechaSTP (802.1D)RSTP (802.1w)MSTP (802.1s)
StandardIEEE 802.1D (1990)IEEE 802.1w (2001)IEEE 802.1s (2002)
Konwergencja30-50 s (timery)Poniżej 1 s (proposal-agreement)1-3 s (jak RSTP)
Stany portów5 (Blocking, Listening, Learning, Forwarding, Disabled)3 (Discarding, Learning, Forwarding)3 (jak RSTP)
Role portówRoot, Designated, (Blocked), DisabledRoot, Designated, Alternate, Backup, Disabled, EdgeJak RSTP
Liczba instancji1 (dla całej sieci)1 (dla całej sieci)Wiele (MSTI) + CIST
VLANBrak (1 drzewo dla wszystkich)Brak (1 drzewo dla wszystkich)Tak (mapowanie VLAN na MSTI)
ZastosowanieSieci starsze, legacyWiększość nowych sieciDuże sieci z wieloma VLAN

RSTP jest domyślnym protokołem na nowoczesnych przełącznikach.

MSTP jest zalecany w sieciach z setkami VLAN dla optymalizacji zasobów.

Porównanie protokołów STP, RSTP i MSTP jest kluczowe dla zrozumienia ewolucji technologii sieciowych w standardzie IEEE 802.1D. Protokół STP (Spanning Tree Protocol), wprowadzony w 1990 roku, był pierwszym mechanizmem umożliwiającym przełącznikom dynamiczną konfigurację topologii sieciowej i zapobieganie pętlom. Jego główną cechą było wykorzystanie timerów do osiągnięcia konwergencji, co zajmowało od 30 do 50 sekund w zależności od rozmiaru sieci. STP definiował pięć stanów portów: Blocking, Listening, Learning, Forwarding i Disabled, które określały kolejność uczenia się adresów MAC przez przełącznik.

RSTP (Rapid Spanning Tree Protocol), opracowany w 2001 roku jako część standardu IEEE 802.1w, znacząco poprawił wydajność STP poprzez skrócenie czasu konwergencji do mniej niż jednej sekundy. RSTP wykorzystuje mechanizm proposal-agreement, w którym przełączniki proponują i uzgadniają zmiany topologii bez potrzeby oczekiwania na timery. Protokół ten uprościł również stany portów do trzech: Discarding, Learning i Forwarding, co ułatwiło zarządzanie siecią. RSTP jest szczególnie przydatny w środowiskach wymagających szybkiej rekonfiguracji, takich jak centra danych czy sieci korporacyjne.

MSTP (Multiple Spanning Tree Protocol), zatwierdzony w 2002 roku jako część standardu IEEE 802.1s, rozszerza możliwości RSTP o obsługę wielu instancji drzewa rozpinającego w jednej sieci fizycznej. MSTP umożliwia segmentację ruchu poprzez przypisanie różnych VLAN-ów do oddzielnych drzew, co zwiększa elastyczność i bezpieczeństwo sieci. Czas konwergencji MSTP wynosi od 1 do 3 sekund, podobnie jak w przypadku RSTP, ale jego główną zaletą jest możliwość zarządzania bardziej złożonymi topologiami. Dzięki temu MSTP stał się standardem w nowoczesnych sieciach, gdzie wymagana jest zaawansowana kontrola ruchu i segmentacja VLAN.

43/55 Wykrywanie pętli w sieci L2

W praktyce pętle często powstają przez przypadkowe połączenie dwóch portów tym samym kablem (loopback), podłączenie nowego przełącznika bez STP, lub nieprawidłową konfigurację STP (np. wyłączenie STP na porcie trunk).

Wykrywanie pętli w Cisco IOS: polecenie show spanning-tree pokazuje role i stany portów; show interfaces z licznikiem broadcast; debug spanning-tree events (ostrożnie w produkcji).

W RouterOS: /interface bridge monitor most1 i /interface bridge port print.

Niektóre przełączniki obsługują Loop Guard i Root Guard – funkcje zabezpieczające przed pętlami i niespodziewaną zmianą root bridge.

Objawy pętli w sieci warstwy 2 są łatwo rozpoznawalne.

Broadcast storm powoduje, że wszystkie diody aktywności na przełącznikach migają jednocześnie, a sieć staje się praktycznie nieużywalna.

Narzędzia diagnostyczne (ping, traceroute) pokazują ekstremalnie wysokie opóźnienia lub całkowity brak odpowiedzi.

Monitorowanie obciążenia interfejsów (show interface) może pokazać bardzo wysoki poziom broadcast (ponad 50% całego ruchu).

Wykrywanie pętli w sieci L2 jest kluczowym mechanizmem zapobiegającym awariom i utracie danych, szczególnie w dużych sieciach korporacyjnych lub centrach danych. Pętle (loopback) mogą powstawać na różne sposoby: przez przypadkowe połączenie dwóch portów tym samym kablem, podłączenie nowego przełącznika bez włączonego protokołu STP (Spanning Tree Protocol) lub błędną konfigurację STP na porcie trunk. W praktyce administratorzy często spotykają się z takimi sytuacjami podczas wdrażania nowych urządzeń lub rozbudowy sieci.

Protokół STP odgrywa kluczową rolę w wykrywaniu i zapobieganiu pętlom poprzez zarządzanie stanami portów (np. Blocking, Listening, Learning, Forwarding) oraz ustalanie drzewa rozpinającego. W systemie Cisco IOS polecenie show spanning-tree dostarcza szczegółowych informacji o rolach i stanach portów, co pozwala na szybką identyfikację problemów. Na przykład, jeśli port znajduje się w stanie Blokowania (Blocking, skrót BLK) zamiast Forwarding, może to wskazywać na wykrytą pętlę lub odciętą ścieżkę. Dodatkowo, analiza informacji takich jak Root Port czy koszt ścieżki pomaga w diagnozowaniu przyczyn problemów.

W nowoczesnych sieciach stosuje się również rozszerzenia STP, takie jak Rapid Spanning Tree (RSTP) i Per-VLAN Spanning Tree (PVST+), które zapewniają szybszą konwergencję i lepszą skalowalność. RSTP redukuje czas wykrywania pętli do kilku sekund, co jest kluczowe w środowiskach wymagających wysokiej dostępności. PVST+ pozwala na niezależne zarządzanie drzewem rozpinającym dla każdej sieci VLAN, co upraszcza konfigurację w złożonych topologiach. Monitorowanie tych mechanizmów za pomocą narzędzi takich jak show spanning-tree jest niezbędne do utrzymania stabilności i wydajności sieci L2.

44/55 Nagłówek ramki STP (BPDU)

Ramka BPDU jest enkapsulowany bezpośrednio w ramce Ethernet.

Nagłówek Ethernet zawiera adres docelowy MAC = 01:80:C2:00:00:00 (adres grupy mostów), adres źródłowy MAC = adres MAC interfejsu nadawcy.

Ramka BPDU używa enkapsulacji LLC z DSAP=SSAP=0x42 dla STP, RSTP i MSTP; Cisco PVST+ używa enkapsulacji SNAP z PID=0x010B.

Zawartość BPDU składa się z następujących pól (w kolejności):

PoleDługośćOpis
Protocol Identifier2 B0x0000 – identyfikator protokołu STP
Protocol Version Identifier1 B0x00 (STP), 0x02 (RSTP), 0x03 (MSTP)
BPDU Type1 B0x00 – Configuration BPDU, 0x80 – TCN BPDU
Flags1 BTopology Change, Topology Change Acknowledgment
Root Bridge ID8 BPriorytet (2 B) + adres MAC (6 B) mostu głównego
Root Path Cost4 BKoszt ścieżki do root bridge
Bridge ID nadawcy8 BPriorytet (2 B) + adres MAC (6 B) przełącznika wysyłającego BPDU
Port ID2 BPriorytet portu (1 B) + numer portu (1 B)
Message Age2 BCzas życia BPDU (sekundy), inkrementowany na każdym przełączniku
Max Age2 BMaksymalny czas przechowywania BPDU (domyślnie 20 s)
Hello Time2 BOdstęp między BPDU (domyślnie 2 s)
Forward Delay2 BCzas w stanach Listening i Learning (domyślnie 15 s)

W RSTP/MSTP w bajcie flag występują dodatkowe flagi (proposal, agreement, learning, forwarding) oraz zmienia się wartość pola Protocol Version Identifier.

Nagłówek ramki STP (BPDU) jest kluczowym elementem w działaniu protokołu Spanning Tree Protocol, który zapobiega pętlom w sieciach Ethernet i zapewnia jedną ścieżkę transmisji między urządzeniami. Ramka BPDU (Bridge Protocol Data Unit) jest specjalnym typem ramki używanym do komunikacji między przełącznikami w celu koordynacji topologii sieci. Jest ona enkapsulowana bezpośrednio w standardowej ramce Ethernet, co oznacza, że nagłówek Ethernet zawiera specyficzne adresy MAC: docelowy (01:80:C2:00:00:00) i źródłowy (adres interfejsu nadawcy).

W przypadku protokołów takich jak STP, RSTP i MSTP, ramka BPDU używa enkapsulacji LLC (Logical Link Control) z wartościami DSAP=SSAP=0x42, co jest standardem dla komunikacji Spanning Tree. Ta enkapsulacja pozwala na identyfikację ramek BPDU i ich przetwarzanie przez przełączniki zgodnie z protokołem. Cisco PVST+ (Per-VLAN Spanning Tree) wprowadza dodatkową warstwę enkapsulacji, umożliwiając bardziej zaawansowane zarządzanie topologią na poziomie poszczególnych sieci VLAN. Dzięki temu możliwe jest lepsze dostosowanie działania protokołu do specyficznych wymagań sieciowych, co zwiększa efektywność i niezawodność komunikacji między urządzeniami.

Ważnym aspektem działania ramki BPDU jest jej rola w procesie konwergencji sieci, czyli ustalania optymalnej ścieżki transmisji po zmianie topologii (np. dodaniu nowego przełącznika lub łącza). Ramki BPDU są wysyłane cyklicznie przez przełączniki, co pozwala na aktualizację informacji o stanie sieci i wykrywanie błędów. W przypadku wykrycia pętli lub innych nieprawidłowości, protokół STP automatycznie blokuje problematyczne łącza, zapewniając stabilność i bezpieczeństwo transmisji danych. Zrozumienie struktury i funkcji nagłówka BPDU jest niezbędne dla administratorów sieciowych, aby efektywnie zarządzać i diagnozować problemy w dużych sieciach Ethernet.

45/55 Podsumowanie bloku II – STP
  • STP (IEEE 802.1D) zapobiega pętlom w sieci L2 z redundancją poprzez blokowanie wybranych portów.
  • Algorytm STA wybiera: root bridge (najniższy BID), root port (najniższy koszt do roota), designated port (najlepszy dla segmentu).
  • BPDU to ramki zarządcze STP przesyłane na adres 01:80:C2:00:00:00.
  • RSTP (802.1w) skraca konwergencję do ok. 1 s (typowo 0,5-2 s) dzięki proposal-agreement.
  • Grupowanie VLAN w instancje (MSTI) dla oszczędności zasobów.
  • PortFast, BPDU Guard, Loop Guard – mechanizmy ochrony i przyspieszenia STP.

STP (IEEE 802.1D) to kluczowy mechanizm w sieciach Layer 2, który zapobiega powstawaniu pętli w topologii sieci z redundancją portów lub przełączników. Działanie STP opiera się na blokowaniu wybranych portów, co pozwala uniknąć niepożądanych pętli logicznych i fizycznych w warstwie drugiej modelu OSI. Algorytm ten jest szczególnie istotny w środowiskach, gdzie występuje nadmiarowość połączeń, np. w sieciach kampusowych lub centrach danych.

W ramach STP działa algorytm Spanning Tree Algorithm (STA), który wykorzystuje mechanizm wyboru mostu nadrzędnego (root bridge) oraz odpowiednich portów: root port, designated port i portów zablokowanych (alternatywnych). Most nadrzędny jest wybierany na podstawie najniższego identyfikatora BID (Bridge Identifier), co zapewnia spójność topologii w całej sieci. Root port to port na przełączniku niebędącym root bridge, przez który przełącznik ten komunikuje się z root bridge, a designated port to port wybrany dla konkretnego segmentu sieciowego, aby uniknąć pętli. Porty alternatywne pozostają w blokadzie i są aktywowane tylko w przypadku awarii ścieżki przez root port, co zapewnia ciągłość działania sieci.

BPDU (Bridge Protocol Data Unit) to specjalne ramki zarządcze używane przez STP do komunikacji między urządzeniami. Są one wysyłane na adres rozgłoszeniowy 01:80:C2:00:00:00 i zawierają informacje niezbędne do konfiguracji topologii sieciowej. W nowoczesnych implementacjach stosuje się również RSTP (Rapid Spanning Tree Protocol), który przyspiesza proces zbieżności sieci, minimalizując czas potrzebny na ustalenie poprawnej topologii po awarii lub dodaniu nowego urządzenia. Dzięki temu sieć szybciej wraca do pełnej funkcjonalności, co jest kluczowe w środowiskach wymagających wysokiej dostępności.

46/55 Agregacja łączy – wprowadzenie
Agregacja łączy (LAG/EtherChannel/Bonding) to połączenie wielu fizycznych interfejsów w jeden logiczny w celu zwiększenia przepustowości i niezawodności.

Agregacja łączy (Link Aggregation) to technika łączenia wielu fizycznych interfejsów sieciowych w jeden logiczny interfejs.

Celem jest zwiększenie przepustowości (aggregate bandwidth) oraz zapewnienie niezawodności (redundancja) – jeśli jedno z łączy fizycznych ulegnie awarii, ruch jest automatycznie przekierowywany na pozostałe, bez przerwy w działaniu.

Standardem agregacji łączy jest IEEE 802.3ad (później włączony do IEEE 802.1AX).

W Cisco technika ta nosi nazwę EtherChannel, w RouterOS – Bonding, w standardzie IEEE – Link Aggregation Group (LAG).

Agregacja łączy działa w warstwie 2 (agregacja interfejsów przełącznika) lub w warstwie 3 (agregacja interfejsów routera).

Warunkiem poprawnego działania jest spójna konfiguracja na obu końcach łącza (ten sam protokół, te same parametry).

Agregacja łączy, znana również jako LAG (Link Aggregation Group), EtherChannel lub bonding, to technologia sieciowa umożliwiająca połączenie wielu fizycznych interfejsów sieciowych w jeden logiczny interfejs. Głównym celem agregacji łączy jest zwiększenie przepustowości oraz poprawa niezawodności transmisji danych. Dzięki tej technice, ruch sieciowy jest dzielony i transmitowany jednocześnie przez wszystkie połączone interfejsy, co skutkuje wyższą wydajnością niż w przypadku korzystania z pojedynczego łącza.

Agregacja łączy działa na warstwie drugiej (Data Link Layer) modelu OSI, co oznacza, że jest to rozwiązanie czysto sprzętowe lub programowe, nie wymagające dodatkowych protokołów sieciowych. W praktyce, interfejsy fizyczne muszą obsługiwać standard IEEE 802.3ad, który definiuje mechanizmy negocjacji i zarządzania grupą LAG. Proces tworzenia grupy LAG obejmuje wykrywanie aktywnych portów, ustalanie priorytetów oraz dynamiczne dostosowywanie przepustowości w zależności od liczby aktywnych łączy.

Oprócz zwiększenia przepustowości, agregacja łączy oferuje również korzyści związane z niezawodnością. W przypadku awarii jednego z interfejsów fizycznych, ruch jest automatycznie przekierowywany na pozostałe aktywne łącza, co minimalizuje przerwy w transmisji danych. Dzięki temu rozwiązaniu, systemy sieciowe mogą działać bardziej stabilnie i niezawodnie, co jest szczególnie ważne w środowiskach wymagających wysokiej dostępności, takich jak centra danych czy sieci korporacyjne.

47/55 LACP – Link Aggregation Control Protocol
LACP Active – inicjuje negocjację. LACP Passive – odpowiada na negocjację. Przynajmniej jeden koniec musi być Active. System Priority decyduje o priorytecie w negocjacji.

LACP ma dwa tryby pracy.

LACP (Link Aggregation Control Protocol, IEEE 802.3ad / 802.1AX) to protokół służący do automatycznej negocjacji i zarządzania agregacją łączy.

LACP zapewnia zgodność konfiguracji VLAN na łączu trunk między urządzeniami.

LACP wymienia ramki LACPDU między urządzeniami na każdym interfejsie w grupie.

Active – interfejs aktywnie inicjuje negocjację i wysyła LACPDU (ramki LACP).

Passive – interfejs odpowiada na LACPDU, ale nie inicjuje negocjacji (czeka, aż drugi koniec wyśle pierwszy pakiet).

Aby agregacja zadziałała, przynajmniej jeden koniec musi być w trybie Active.

Oba końce powinny mieć tę samą konfigurację szybkości i duplexu na wszystkich łączach w grupie.

Parametr System Priority (domyślnie 32768) decyduje, które urządzenie steruje agregacją w przypadku konfliktu.

Link Aggregation Control Protocol (LACP) to protokół służący do agregacji wielu fizycznych łączy Ethernet w jedno logiczne połączenie, co zwiększa przepustowość i poprawia niezawodność transmisji danych. LACP działa na podstawie standardów IEEE 802.3ad oraz IEEE 802.1AX i jest szeroko stosowany w sieciach korporacyjnych, centrach danych oraz infrastrukturze telekomunikacyjnej. Protokół ten umożliwia dynamiczne zarządzanie grupami portów (link groups), które mogą być konfigurowane w trybie active-passive lub active-active, w zależności od potrzeb i możliwości urządzeń sieciowych.

W negocjacji LACP kluczową rolę odgrywa mechanizm System Priority, który decyduje, które urządzenie jest uprawnione do wyboru interfejsów wchodzących w skład agregacji (aktor systemu). System o niższej wartości priorytetu jest bardziej uprzywilejowany. System Priority jest wartością konfigurowaną ręcznie (domyślnie 32768) i nie jest wyznaczany na podstawie adresu MAC.

LACP oferuje również mechanizmy failover i recovery, które zapewniają ciągłość działania agregowanych łączy nawet w przypadku awarii pojedynczych portów. Protokół automatycznie wykrywa i usuwa uszkodzone łącza z agregacji, a następnie przesyła ruch po pozostałych sprawnych portach, zachowując maksymalną dostępną przepustowość. LACP wymaga, aby wszystkie porty wchodzące w skład agregacji działały w trybie full-duplex. Dzięki tym funkcjom LACP jest niezastąpionym narzędziem w budowie wydajnych i niezawodnych sieci opartych na technologii Ethernet.

48/55 Rozkładanie ruchu w agregacji (load balancing)
port-channel load-balance src-dst-ip
! Zmiana algorytmu haszowania na src-dst-ip w Cisco IOS
Ważne: rozkładanie ruchu odbywa się per-flow, a nie per-packet – wszystkie pakiety należące do jednej sesji (tej samej pary źródło-cel) trafiają na to samo łącze fizyczne, co gwarantuje zachowanie kolejności pakietów.

W agregacji łączy ruch jest rozkładany na poszczególne łącza fizyczne na podstawie algorytmu haszującego (hash).

Przełącznik oblicza wartość skrótu z wybranych pól ramki/pakietu i na jego podstawie wybiera konkretne łącze w grupie.

Algorytmy haszujące różnią się w zależności od producenta i konfiguracji.

W Cisco IOS: src-MAC, dst-MAC, src-dst-MAC (domyślnie), src-ip, dst-ip, src-dst-ip, src-port, dst-port, src-dst-port.

W RouterOS parametr transmit-hash-policy dla łącza bonding: layer-2 (adresy MAC), layer-2-and-3 (adresy MAC + źródłowy/docelowy adres IP), layer-3-and-4 (adresy IP + porty TCP/UDP).

Wybór algorytmu zależy od charakteru ruchu – dla ruchu IP najlepiej src-dst-ip (zapewnia równomierny rozkład dla różnych par hostów).

Rozkładanie ruchu w agregacji, czyli load balancing, to kluczowy mechanizm stosowany w sieciach komputerowych w celu optymalizacji wykorzystania zasobów i zapewnienia wysokiej dostępności usług. W kontekście rozwiązań Cisco IOS, jednym z popularnych algorytmów haszowania jest src-dst-ip, który bazuje na adresach źródłowym i docelowym pakietu. To podejście ma istotne zalety, ponieważ rozkładanie ruchu odbywa się na poziomie przepływu (per-flow), a nie pojedynczego pakietu (per-packet). Oznacza to, że wszystkie pakiety należące do tej samej sesji, określonej przez parę adresów źródło-cel, są kierowane na to samo fizyczne łącze. Taka strategia gwarantuje zachowanie kolejności pakietów w obrębie sesji, co jest kluczowe dla protokołów wymagających sekwencyjnego przetwarzania danych, takich jak TCP.

Algorytm src-dst-ip jest szczególnie przydatny w środowiskach, gdzie priorytetem jest utrzymanie spójności sesji i minimalizacja opóźnień związanych z przełączaniem kontekstu. W praktyce oznacza to, że nawiązana komunikacja między dwoma hostami będzie routowana przez ten sam interfejs fizyczny przez cały czas trwania sesji, o ile nie nastąpią zmiany w konfiguracji sieci. To podejście różni się od innych metod, takich jak port-channel load-balance, które mogą rozkładać ruch losowo lub na podstawie obciążenia poszczególnych portów, bez uwzględnienia kontekstu sesji. Warto również zauważyć, że wybór odpowiedniego algorytmu haszowania zależy od specyfiki ruchu sieciowego i wymagań dotyczących wydajności oraz niezawodności.

Wdrożenie load balancingu w agregacji wymaga starannej konfiguracji i monitorowania, aby zapewnić równomierne rozłożenie obciążenia i uniknąć wąskich gardeł. W przypadku Cisco IOS, administratorzy muszą uwzględnić takie czynniki jak przepustowość poszczególnych portów, opóźnienia oraz potencjalne zakłócenia w ruchu. Ponadto, stosowanie algorytmu src-dst-ip może wpływać na wykorzystanie pasma, ponieważ niektóre sesje mogą generować większy ruch niż inne. Dlatego też, w złożonych środowiskach sieciowych, często stosuje się hybrydowe podejścia, łączące różne metody haszowania, aby uzyskać optymalną wydajność i niezawodność systemu. Wiedza na temat tych mechanizmów jest niezbędna dla inżynierów sieciowych, aby mogli projektować i zarządzać sieciami w sposób efektywny i skalowalny.

49/55 Konfiguracja EtherChannel w Cisco IOS
interface port-channel 1
 switchport mode trunk
 switchport trunk allowed vlan 10,20,30
exit
! Utworzenie interfejsu logicznego Port-Channel1

interface range GigabitEthernet0/1-2
 channel-group 1 mode active
exit
! Przypisanie interfejsów fizycznych do grupy 1 (LACP active)

show etherchannel summary
! Stan EtherChannel – flaga SU (layer2, up)

Tryby grupy: mode active (LACP Active), mode passive (LACP Passive), mode desirable (PAgP – Cisco proprietary), mode auto (PAgP), mode on (statyczne, bez negocjacji).

Polecenie show etherchannel summary pokazuje flagi: S (layer2), R (layer3), U (w użyciu/in use), P (w port-channel), s (suspended), D (down).

W Cisco IOS EtherChannel konfiguruje się przez utworzenie port-channel (interfejs logiczny) i przypisanie do niego interfejsów fizycznych.

Interfejsy w grupie muszą mieć identyczną konfigurację (tryb, trunk, szybkość, duplex).

EtherChannel to technologia agregacji łączy w sieciach Cisco, która pozwala na tworzenie logicznego interfejsu składającego się z dwóch lub więcej fizycznych portów przełącznika. Głównym celem EtherChannel jest zwiększenie przepustowości i niezawodności połączenia poprzez wykorzystanie mechanizmu link aggregation protocol (LACP). W przykładzie przedstawionym na slajdzie, interfejs logiczny Port-Channel1 jest tworzony za pomocą polecenia interface port-channel 1, odwzorowanego w trybie trunk z dozwolonymi VLAN-ami 10, 20 i 30 (polecenie switchport trunk allowed vlan).

Następnie, za pomocą polecenia interface range GigabitEthernet0/1-2 channel-group 1 mode active, przypisuje się fizyczne porty (w tym przypadku GigabitEthernet0/1 i 0/2) do utworzonej wcześniej grupy EtherChannel. Opcja mode active oznacza, że przełącznik będzie aktywnie uczestniczył w negocjacji LACP z innym urządzeniem, co jest niezbędne do nawiązania połączenia EtherChannel. Polecenie show etherchannel summary służy do sprawdzenia stanu utworzonych kanałów EtherChannel, w tym ich statusu (aktywne/nieaktywne) oraz przypisanych VLANów.

Warto zauważyć, że konfiguracja EtherChannel wymaga odpowiedniej współpracy między urządzeniami końcowymi (np. serwerami lub stacjami roboczymi) a przełącznikami. Urządzenia muszą obsługiwać standard IEEE 802.3ad, który definiuje protokół LACP. Ponadto, w przypadku awarii jednego z fizycznych portów w grupie EtherChannel, ruch jest automatycznie przełączany na pozostałe sprawne porty, co zapewnia wysoką dostępność i odporność na uszkodzenia. Technologia ta jest szczególnie przydatna w środowiskach wymagających dużej przepustowości i niezawodności, takich jak centra danych czy sieci korporacyjne.

50/55 Konfiguracja Bonding w RouterOS
/interface bonding add name=bond1 mode=802.3ad slaves=ether2,ether3
# Utworzenie bondingu LACP na interfejsach ether2 i ether3

/interface bonding set bond1 lacp-rate=fast
# LACP rate: fast (co 1 s) lub slow (co 30 s, domyślnie)

/interface bonding set bond1 link-monitoring=mii
# Monitorowanie stanu łącza (MII lub ARP)

/interface bridge port add bridge=most1 interface=bond1
# Dodanie bondingu do mostu (jak zwykły interfejs)
Ważne: łącza w bondingu muszą mieć tę samą szybkość i duplex, a na drugim końcu musi być skonfigurowany zgodny tryb agregacji.

W RouterOS agregacja łączy jest realizowana przez interfejs Bonding.

Tworzy się interfejs logiczny bonding, a następnie dodaje do niego interfejsy fizyczne (slaves).

RouterOS obsługuje kilka trybów (modes) bondingu: 802.3ad (LACP standardowy), balance-xor (równoważenie XOR), active-backup (redundancja 1:1), broadcast (wszystkie łącza otrzymują wszystkie ramki), balance-rr (round-robin), balance-tlb, balance-alb.

Bonding w RouterOS może być dodany do mostu, co pozwala na agregację łączy między przełącznikami.

Konfiguracja bondingu w RouterOS jest kluczowym elementem zapewniającym wysoką dostępność i wydajność sieci. Bonding, czyli łączenie kilku interfejsów fizycznych w jeden logiczny, pozwala na osiągnięcie celów takich jak zwiększenie przepustowości (agregacja łączy) oraz zapewnienie redundancji (failover). W systemie RouterOS, bonding może być skonfigurowany w różnych trybach, z których najczęściej używane to 802.3ad (LACP) i active-backup.

Tryb 802.3ad (LACP) jest szczególnie popularny w środowiskach, gdzie oba urządzenia końcowe obsługują ten standard. Konfiguracja rozpoczyna się od dodania bondingu za pomocą polecenia /interface bonding add name=bond1 mode=802.3ad slaves=ether2,ether3, co tworzy bond o nazwie bond1, składający się z interfejsów ether2 i ether3. Następnie, za pomocą /interface bonding set bond1 lacp-rate=fast, można dostosować szybkość negocjacji LACP, co wpływa na częstotliwość aktualizacji stanu łącza. Dodatkowo, /interface bonding set bond1 link-monitoring=mii włącza monitorowanie stanu łączy, co jest istotne dla zapewnienia niezawodności systemu.

Oprócz podstawowej konfiguracji, RouterOS oferuje zaawansowane opcje takie jak ustawienie progu heartbeat (lacp-heartbeat-threshold), co pozwala na automatyczne przełączanie na zapasowe łącze w przypadku utraty sygnału. Można również skonfigurować opóźnienie (lacp-delay) oraz tryb pracy (lacp-mode), aby dostosować bonding do specyficznych wymagań sieci. Warto również wspomnieć o możliwości konfiguracji interfejsów jako backup, co zapewnia dodatkową warstwę bezpieczeństwa w przypadku awarii głównych łączy. Konfiguracja bondingu w RouterOS jest elastyczna i pozwala na dostosowanie do różnorodnych scenariuszy sieciowych, co czyni go potężnym narzędziem dla administratorów sieci.

51/55 Podsumowanie bloku III – Agregacja łączy
  • Agregacja łączy (LACP, IEEE 802.3ad/802.1AX) łączy wiele fizycznych interfejsów w jeden logiczny.
  • Zwiększa przepustowość (aggregate bandwidth) i zapewnia niezawodność (failover).
  • LACP Active inicjuje negocjację, LACP Passive odpowiada. Przynajmniej jeden koniec musi być Active.
  • Rozkładanie ruchu (load balancing) opiera się na hash z wybranych pól (MAC/IP/L4).
  • W Cisco – EtherChannel (port-channel), w RouterOS – Bonding.
  • Agregacja łączy jest w pełni kompatybilna z VLAN i STP w sieciach warstwy 2.

Agregacja łączy to technologia stosowana w sieciach komputerowych, która pozwala na łączenie wielu fizycznych interfejsów sieciowych w jeden logiczny, co zwiększa przepustowość i poprawia niezawodność transmisji danych. Dwa najpopularniejsze standardy agregacji łączy to LACP (Link Aggregation Control Protocol) oraz IEEE 802.3ad/802.1AX, które działają na warstwie drugiej modelu OSI. Głównym celem agregacji jest zapewnienie większej przepustowości poprzez sumowanie prędkości poszczególnych łączy oraz zwiększenie odporności na awarie dzięki mechanizmowi failover.

W konfiguracji LACP wyróżnia się role Active i Passive. Urządzenie oznaczone jako Active inicjuje negocjację protokołu, podczas gdy urządzenie Passive odpowiada na tę inicjatywę. Ważne jest, aby przynajmniej jeden koniec połączenia był skonfigurowany jako Active, ponieważ bez tej roli negocjacja nie zostanie rozpoczęta. Po nawiązaniu połączenia LACP tworzy tzw. grupa agregacji łączy (Link Aggregation Group, LAG), która jest widoczna dla aplikacji jako jedno logiczne łącze o zwiększonej przepustowości. W przypadku awarii jednego z fizycznych interfejsów, ruch jest automatycznie przekierowywany na pozostałe sprawne łącza, co minimalizuje przerwy w transmisji danych.

Oprócz LACP, standard IEEE 802.3ad/802.1AX oferuje podobne funkcje agregacji łączy, ale z dodatkowymi mechanizmami zarządzania ruchem i priorytetyzacją. Oba standardy są szeroko stosowane w przełącznikach warstwy drugiej i trzeciej, szczególnie w środowiskach centrów danych i sieciach korporacyjnych, gdzie niezawodność i wysoka przepustowość są kluczowe. Agregacja łączy jest również często wykorzystywana w połączeniach między serwerami a przełącznikami lub między samymi przełącznikami, aby zapewnić wydajne i odporne na awarie połączenia sieciowe.

52/55 VLAN i STP
  1. Co to jest i jakie są główne korzyści stosowania sieci wirtualnych w warstwie 2?
  2. Jak wygląda format ramki IEEE 802.1Q? Opisz pola TPID, PCP, DEI, VID.
  3. Czym różni się port Access od portu Trunk na przełączniku?
  4. Opisz na przykładzie działanie Router-on-a-Stick. Jakie polecenia są potrzebne w Cisco IOS?
  5. Czym różni się routing między VLAN na przełączniku L3 (SVI) od router-on-a-stick?
  6. Jakie zagrożenia niesie pętla w sieci L2 i jak STP zapobiega tym problemom?
  7. Opisz proces wyboru root bridge w STP. Co to jest Bridge ID?
  8. Czym różni się STP (802.1D) od RSTP (802.1w)? Jakie są czasy konwergencji?
  9. Do czego służą PortFast i BPDU Guard? Gdzie je stosować?
  10. Co to jest MSTP i jaka jest zaleta mapowania wielu VLAN na jedną instancję STP?

Sieci wirtualne (VLAN) w warstwie 2 są kluczowym narzędziem w nowoczesnych sieciach komputerowych, umożliwiającym logiczne grupowanie urządzeń bez konieczności fizycznego segmentowania sieci. Główną korzyścią stosowania VLAN jest zwiększenie wydajności i bezpieczeństwa poprzez ograniczenie ruchu do określonych grup urządzeń, co zmniejsza obciążenie przełączników i poprawia kontrolę nad przepływem danych. VLAN pozwala również na elastyczne zarządzanie siecią, umożliwiając szybkie dostosowanie do zmieniających się potrzeb bez konieczności modyfikacji fizycznej infrastruktury.

Format ramki IEEE 802.1Q, używany do tagowania ramek VLAN, składa się z kilku kluczowych pól. TPID (Tag Protocol Identifier) wskazuje, że ramka zawiera znacznik 802.1Q, PCP (Priority Code Point) określa priorytet ramki (802.1p), DEI (Drop Eligible Indicator) informuje, że ramkę można odrzucić w przypadku przeciążenia, a VID (VLAN Identifier) identyfikuje konkretny VLAN. Te pola umożliwiają przełącznikom efektywne zarządzanie ruchem i kierowanie ramek do odpowiednich portów. Port Access obsługuje tylko jeden VLAN, podczas gdy port Trunk może przenosić wiele VLAN-ów, co jest niezbędne w bardziej złożonych konfiguracjach sieciowych.

Router-on-a-Stick to technika routingu między VLAN-ami, w której router łączy się z przełącznikiem pojedynczym łączem trunk (802.1Q), a na routerze tworzone są subinterfejsy (jedna podsieć VLAN na subinterfejs). Umożliwia to przesyłanie ruchu między wieloma VLAN-ami bez konieczności stosowania routera z osobnym portem dla każdego VLAN. W Cisco IOS konfiguracja odbywa się za pomocą poleceń takich jak interface GigabitEthernet0/0.10 encapsulation dot1Q 10 oraz switchport mode trunk na porcie przełącznika. Te narzędzia pozwalają na precyzyjne zarządzanie segmentacją sieci i optymalizację ruchu w dużych, złożonych środowiskach sieciowych.

53/55 Pytania kontrolne – agregacja łączy (LACP)
  1. Jakie są główne korzyści agregacji łączy w sieci Ethernet?
  2. Opisz tryby LACP Active i Passive. Który koniec musi być Active, aby agregacja zadziałała?
  3. Jak działa rozkładanie ruchu (load balancing) w EtherChannel? Co to znaczy per-flow?
  4. Jakie są dostępne algorytmy haszujące w Cisco IOS i RouterOS?
  5. Podaj przykładową konfigurację EtherChannel w Cisco IOS z wykorzystaniem LACP.
  6. Podaj przykładową konfigurację Bonding w RouterOS (tryb 802.3ad).
  7. Jaka jest różnica między statyczną agregacją (mode on) a dynamiczną (LACP)?

Agregacja łączy w sieci Ethernet, szczególnie poprzez technologię Link Aggregation Control Protocol (LACP), oferuje kilka kluczowych korzyści. Po pierwsze, zwiększa przepustowość poprzez połączenie wielu portów fizycznych w jeden logiczny kanał, co jest szczególnie przydatne w środowiskach wymagających dużej wydajności. Po drugie, zapewnia redundancję - jeśli jedno łącze ulegnie awarii, ruch jest automatycznie przekierowywany przez pozostałe aktywne porty, minimalizując przestoje. Dodatkowo, agregacja upraszcza zarządzanie siecią, ponieważ urządzenia widzą tylko jeden adres MAC i jedną prędkość transmisji, co ułatwia konfigurację i monitorowanie.

W trybie LACP Active i Passive kluczowe jest zrozumienie roli każdego końca połączenia. Urządzenie oznaczone jako Active inicjuje procedurę negocjacji LACP, wysyłając ramki kontrolne do urządzenia Passive. To drugie urządzenie odpowiada, akceptując lub odrzucając propozycję agregacji. Aby agregacja zadziałała, tylko jeden koniec musi być Active - drugi automatycznie przyjmuje rolę Passive. W praktyce oznacza to, że np. przełącznik może być ustawiony jako Active, a serwer lub inny przełącznik jako Passive, co jest częstym rozwiązaniem w konfiguracjach sieciowych.

Rozkładanie ruchu (load balancing) w EtherChannel działa na zasadzie inteligentnego kierowania pakietów przez dostępne porty. W trybie per-flow każdy przepływ danych (czyli sekwencja pakietów między tymi samymi adresami źródłowym i docelowym) jest kierowany przez ten sam zestaw portów przez cały czas trwania komunikacji. Zapobiega to fragmentacji przepływu na różne porty, co mogłoby powodować problemy z synchronizacją i wydajnością. Algorytmy haszujące w Cisco IOS i RouterOS (np. src-dst-ip, layer-3-and-4) decydują, który port zostanie użyty do przesłania pakietów danego przepływu, zapewniając równomierne obciążenie wszystkich aktywnych łączy.

54/55 VLAN vs STP vs LACP – porównanie celów
CechaVLAN (802.1Q)STP/RSTP/MSTPLACP (802.3ad)
Główny celSegmentacja i izolacja sieci L2Zapobieganie pętli w sieci L2Zwiększenie przepustowości i niezawodności
Warstwa OSIWarstwa 2 (łącza danych)Warstwa 2 (łącza danych)Warstwa 2 (łącza danych)
StandardIEEE 802.1QIEEE 802.1D/802.1w/802.1sIEEE 802.3ad / 802.1AX
MechanizmDodanie tagu (znacznika) do ramkiBlokowanie portów, wybór root bridgePołączenie fizycznych interfejsów w logiczny
Korzyść głównaIzolacja broadcast, bezpieczeństwoBrak pętli, redundancjaWiększe pasmo, failover
Korzyść dodatkowaUproszczenie zarządzaniaSzybka konwergencja (RSTP)Równoważenie obciążenia
InterakcjaVLAN może być używany z STP i LACPSTP działa na VLAN (PVST+)LACP działa na trunk z VLAN

VLAN, STP i LACP – w nowoczesnych sieciach korporacyjnych stosuje się je razem.

VLAN, STP i LACP to trzy różne technologie stosowane w sieciach komputerowych, które służą odmiennym celom, choć wszystkie działają na warstwie drugiej modelu OSI. VLAN (Virtual Local Area Network) jest mechanizmem segmentacji sieci, który pozwala na logiczne grupowanie urządzeń w sieci lokalnej bez fizycznego oddzielania ich od innych segmentów. Dzięki temu możliwe jest zarządzanie ruchem sieciowym w sposób bardziej efektywny, izolując ruch między różnymi grupami urządzeń. Standard 802.1Q umożliwia dodawanie tzw. tagów VLAN do ramek Ethernet, co pozwala na identyfikację i przetwarzanie ruchu w obrębie wirtualnych sieci lokalnych.

STP (Spanning Tree Protocol) to protokół zapobiegający powstawaniu pętli w sieci, co jest kluczowe dla zapewnienia spójności i niezawodności komunikacji w sieciach opartych na przełącznikach. STP wybiera jedną ścieżkę jako aktywną (root path), a pozostałe porty są blokowane, aby uniknąć zapętleń. RSTP (Rapid Spanning Tree Protocol) i MSTP (Multiple Spanning Tree Protocol) to rozszerzenia STP, które oferują szybszą konwergencję sieci, a MSTP dodatkowo umożliwia grupowanie wielu VLAN-ów w pojedyncze instancje drzewa rozpinającego, co jest istotne w bardziej złożonych topologiach sieciowych.

LACP (Link Aggregation Control Protocol) to technologia umożliwiająca łączenie wielu fizycznych portów w jedno logiczne połączenie, co zwiększa przepustowość i niezawodność transmisji danych. Standard IEEE 802.3ad definiuje sposób agregacji linków, umożliwiając tworzenie tzw. trunków LACP. Dzięki temu można osiągnąć wyższe prędkości transmisji oraz zapewnić redundancję w przypadku awarii jednego z połączeń fizycznych. Wszystkie te technologie, mimo że działają na tej samej warstwie modelu OSI, pełnią różne funkcje i są niezbędne do efektywnego zarządzania współczesnymi sieciami komputerowymi.

55/55 Podsumowanie
Prezentacja przedstawiła trzy kluczowe technologie warstwy 2 w sieciach Ethernet.

Dziękuję za uwagę.

Protokół STP (IEEE 802.1D) i jego udoskonalone wersje RSTP (802.1w) oraz MSTP (802.1s) zapobiegają pętlom w sieci z nadmiarowymi połączeniami, zapewniając niezawodność przy zachowaniu akceptowalnego czasu konwergencji.

Agregacja łączy (LACP, IEEE 802.3ad) łączy wiele fizycznych interfejsów w jeden logiczny, zwiększając przepustowość i zapewniając automatyczne przełączanie awaryjne.

Rozkładanie ruchu oparte na haszowaniu gwarantuje zachowanie kolejności pakietów w obrębie sesji.

Wszystkie trzy technologie są ze sobą w pełni kompatybilne i często stosowane łącznie w nowoczesnych sieciach korporacyjnych.

Zrozumienie zasad działania VLAN, STP i LACP jest niezbędne dla każdego administratora sieci.

W dzisiejszym świecie sieci komputerowych technologie warstwy 2 odgrywają kluczową rolę w zapewnieniu efektywnej i niezawodnej komunikacji. Jedną z najważniejszych koncepcji jest VLAN (Virtual Local Area Network), która umożliwia segmentację fizycznej sieci na logiczne podsieci, co pozwala na lepsze zarządzanie ruchem i poprawę bezpieczeństwa. Dzięki VLAN można grupować urządzenia w sposób odpowiadający potrzebom organizacji, niezależnie od ich fizycznego położenia w sieci.

Protokół STP (Spanning Tree Protocol), zdefiniowany w standardzie IEEE 802.1D, jest fundamentalnym mechanizmem zapobiegającym powstawaniu pętli w sieciach z nadmiarowymi połączeniami. Jego głównym zadaniem jest wybór jednej ścieżki dla każdej domeny rozgłoszeniowej, co eliminuje ryzyko zapętlenia ruchu i zapewnia spójność przesyłanych danych. W praktyce STP działa w trzech fazach: początkowego rozgłaszania, wyboru korzenia drzewa oraz blokowania portów zapasowych.

Rozwinięciem podstawowego protokołu STP są jego nowsze wersje, takie jak RSTP (Rapid Spanning Tree Protocol) i MSTP (Multiple Spanning Tree Protocol). RSTP, zdefiniowany w standardzie IEEE 802.1w, znacząco przyspiesza proces konwergencji sieci poprzez wykorzystanie informacji o topologii przechowywanej na portach urządzeń. Dzięki temu czas potrzebny na ustalenie optymalnej ścieżki jest znacznie krótszy, co przekłada się na większą niezawodność i wydajność sieci. Z kolei MSTP, opisany w standardzie IEEE 802.1s, rozszerza możliwości STP o obsługę wielu instancji drzewa rozgłoszeniowego w jednej domenie, co jest szczególnie przydatne w złożonych środowiskach sieciowych.