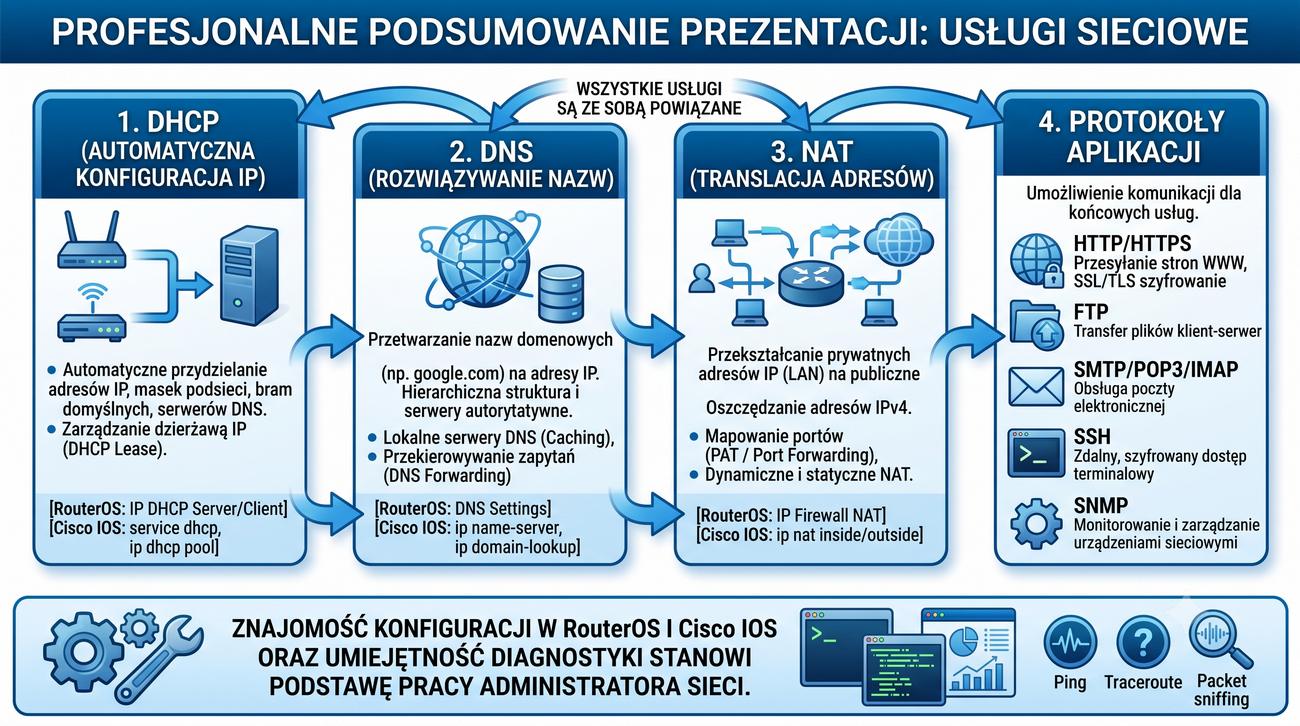
1/55 Usługi sieciowe

DHCP, DNS, NAT, HTTP/HTTPS – protokoły i serwery

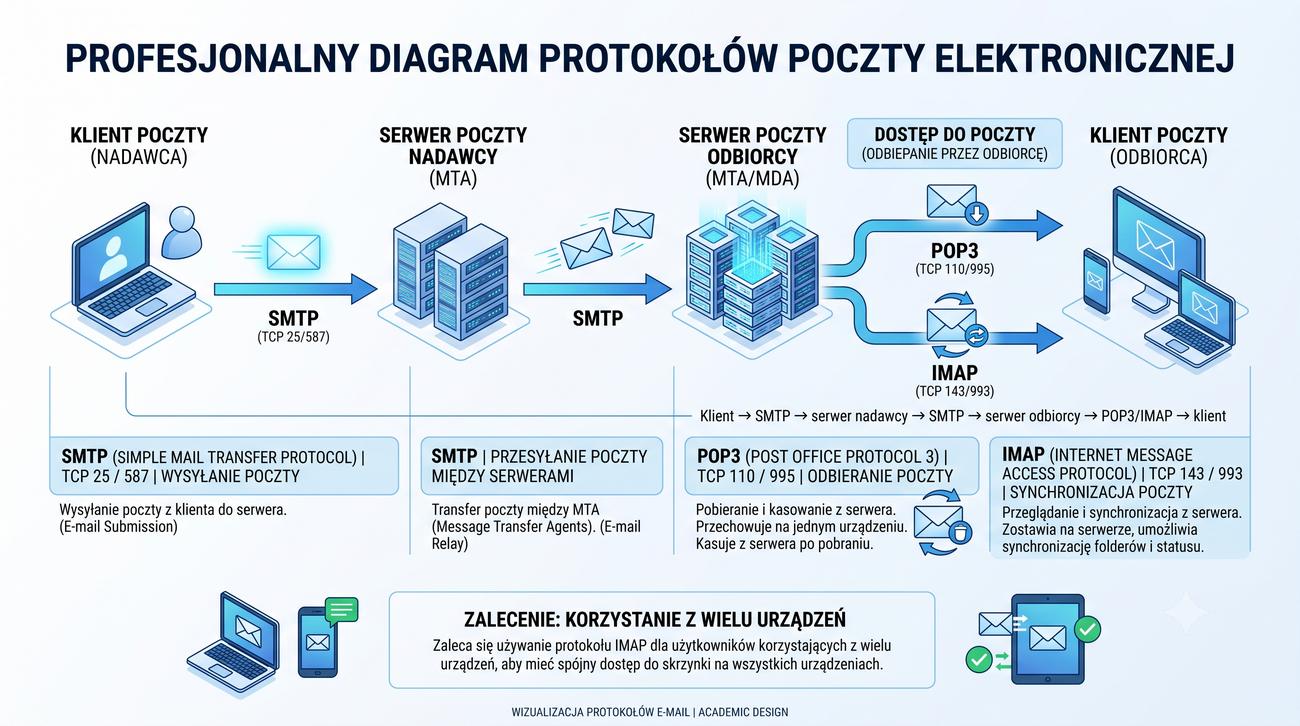
Prezentacja obejmuje cztery kluczowe usługi sieciowe: DHCP, DNS, NAT oraz protokoły warstwy aplikacji (HTTP/HTTPS, FTP, SMTP).

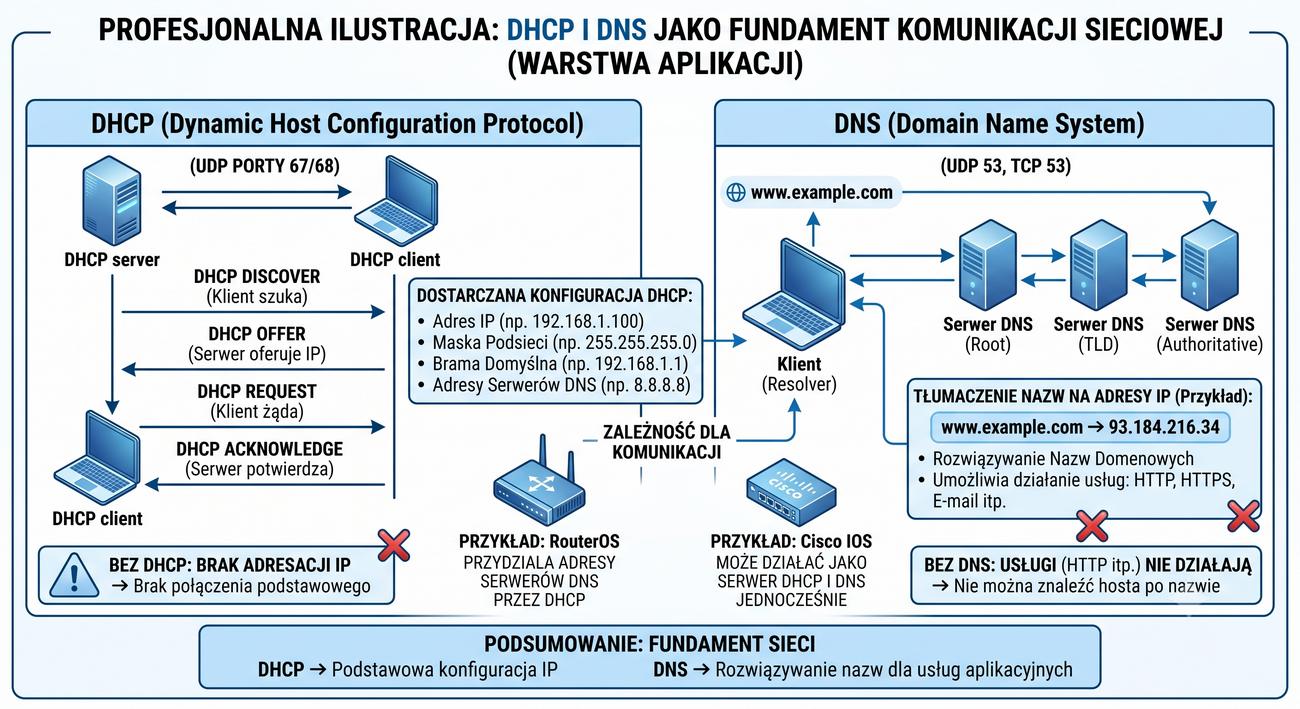
DHCP automatyzuje konfigurację IP hostów – bez niego każdy komputer wymaga ręcznego ustawienia adresu, maski, bramy i DNS.

DNS tłumaczy nazwy domenowe (przyjazne dla człowieka) na adresy IP (zrozumiałe dla urządzeń sieciowych).

NAT umożliwia wielu urządzeniom w sieci prywatnej współdzielenie jednego publicznego adresu IPv4.

Wszystkie cztery bloki są ze sobą powiązane: DHCP konfiguruje hosta, DNS umożliwia znalezienie serwera, NAT zapewnia łączność z Internetem, a protokoły aplikacji realizują właściwą komunikację między programami.
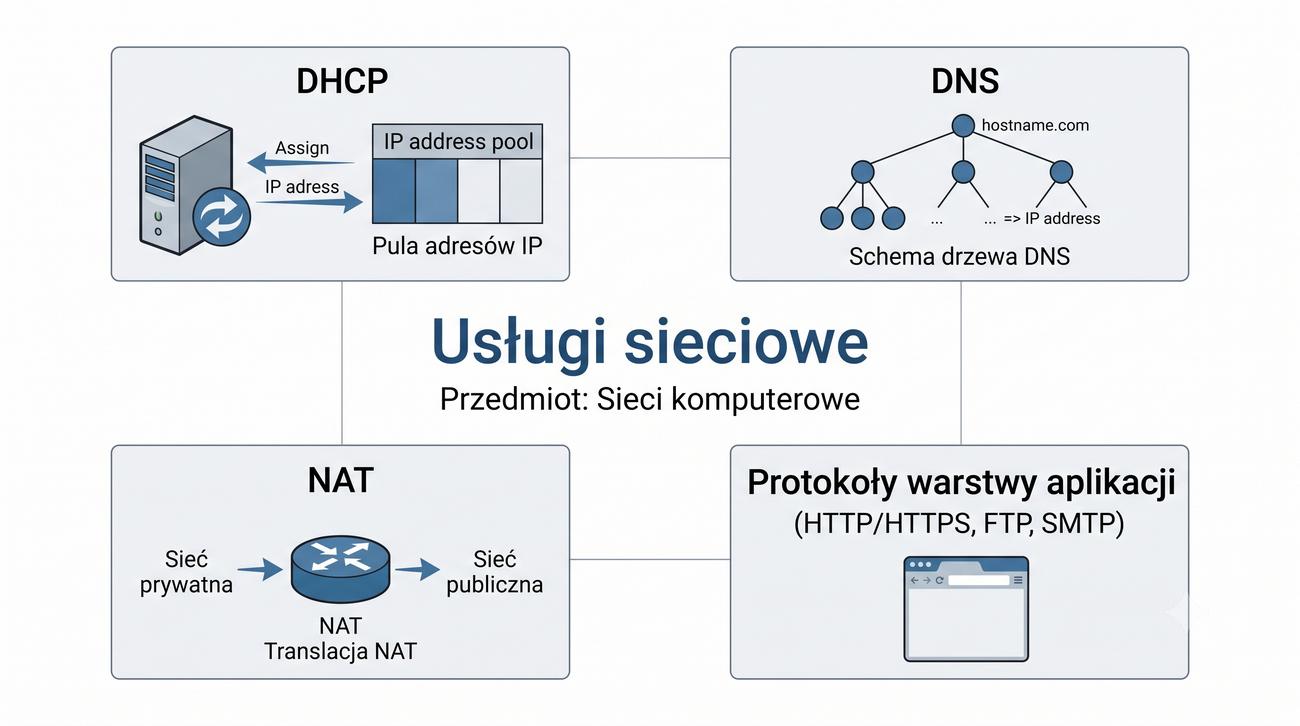
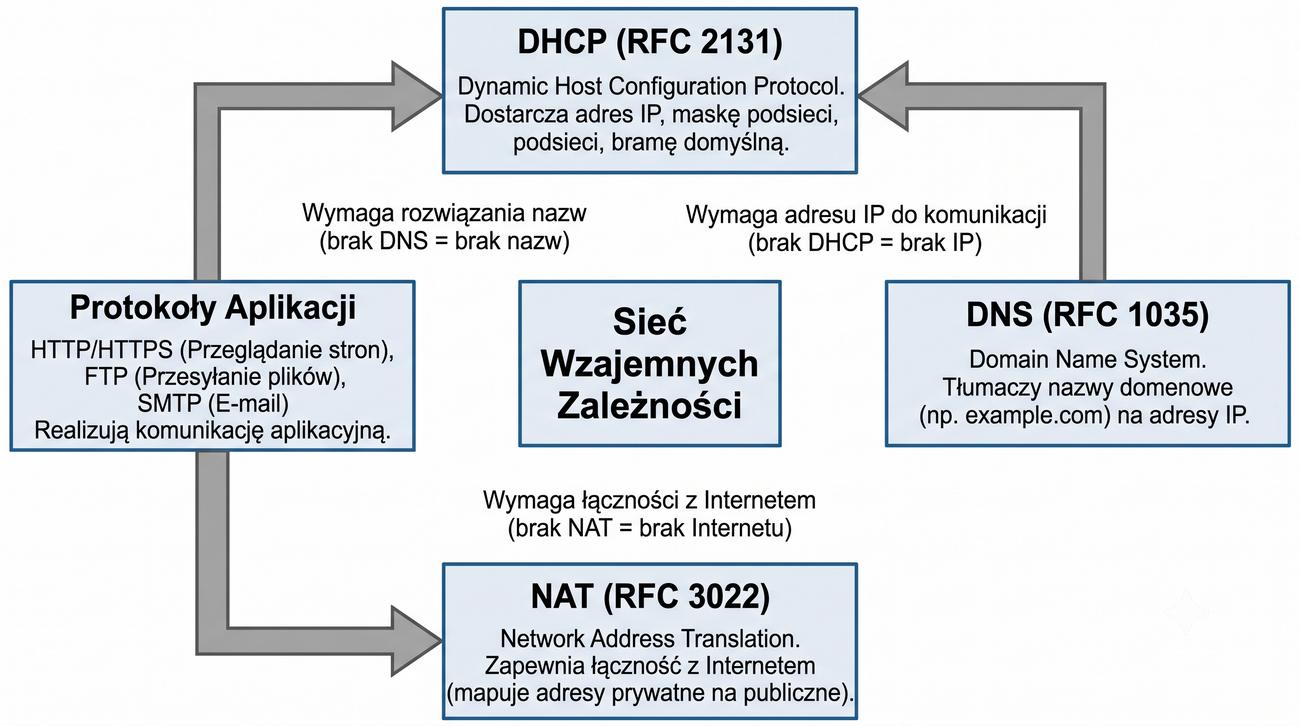
Współczesne sieci komputerowe opierają się na ścisłej współpracy kilku kluczowych protokołów i usług, które razem tworzą fundament komunikacji IP. Bez DHCP każdy administrator musiałby ręcznie konfigurować dziesiątki lub setki urządzeń, co byłoby nie tylko czasochłonne, ale również niezwykle podatne na błędy. DNS pełni rolę systemu tłumaczącego przyjazne dla człowieka nazwy domenowe na numeryczne adresy IP, bez czego korzystanie z Internetu ograniczałoby się do zapamiętywania ciągów cyfr.

NAT powstał jako odpowiedź na wyczerpywanie się puli publicznych adresów IPv4 i umożliwia całym sieciom prywatnym współdzielenie jednego adresu publicznego. Protokoły warstwy aplikacji, takie jak HTTP i HTTPS, korzystają z niższych warstw modelu TCP/IP do przesyłania danych między klientem a serwerem. Wszystkie te elementy są ze sobą nierozerwalnie powiązane – bez DHCP host nie otrzyma konfiguracji, bez DNS nie trafi do serwera, a bez NAT nie opuści sieci lokalnej.

Zrozumienie wzajemnych zależności między tymi usługami jest kluczowe dla każdego administratora sieci, ponieważ awaria jednej z nich paraliżuje działanie pozostałych. W praktyce inżynierskiej często spotyka się sytuacje, w których problem z wyświetleniem strony WWW ma źródło nie w samym HTTP, lecz w błędnie skonfigurowanym DNS lub DHCP. Dlatego niniejsza prezentacja kładzie nacisk nie tylko na szczegóły techniczne każdej usługi z osobna, ale także na ich współdziałanie w rzeczywistych scenariuszach sieciowych.

2/55 Streszczenie

DHCP, DNS i NAT – trzy filary nowoczesnych sieci IP

DHCP zgodny z RFC 2131 automatyzuje proces konfiguracji sieciowej hostów przez przydzielanie adresu IP, maski podsieci, bramy domyślnej i serwerów DNS.

DNS to hierarchiczny, rozproszony system nazw (RFC 1034/1035) tłumaczący nazwy domenowe na adresy IP zrozumiałe dla urządzeń sieciowych.

NAT zdefiniowany w RFC 2663 umożliwia wielu hostom w sieci prywatnej współdzielenie jednego publicznego adresu IP przez translację adresów i portów.

DHCP zdefiniowany w RFC 2131 automatyzuje proces nadawania konfiguracji sieciowej, eliminując potrzebę ręcznej ingerencji administratora na każdym hoście. Dzięki czteroetapowej sekwencji DORA (Discover, Offer, Request, ACK) urządzenie otrzymuje nie tylko adres IP, ale także maskę podsieci, bramę domyślną i adresy serwerów DNS. Mechanizm dzierżawy (lease) pozwala na efektywne zarządzanie pulą adresów, a odnowienie w punktach T1 i T2 zapewnia ciągłość działania bez przerywania komunikacji.

DNS według RFC 1034 i 1035 tworzy hierarchiczny, rozproszony system nazw, który jest niezbędny do działania współczesnego Internetu. Każda domena jest obsługiwana przez autorytatywne serwery nazw, a zapytania DNS mogą być realizowane w trybie rekurencyjnym lub iteracyjnym. Buforowanie odpowiedzi w pamięci podręcznej znacząco przyspiesza kolejne zapytania i odciąża serwery główne, co ma kluczowe znaczenie dla wydajności całej sieci.

NAT opisany w RFC 2663 stanowi tymczasowe, ale niezwykle praktyczne rozwiązanie problemu wyczerpania adresów IPv4. Translacja adresów i portów (PAT) pozwala tysiącom urządzeń w sieci prywatnej na współdzielenie jednego publicznego adresu IP, co jest standardem w sieciach domowych i korporacyjnych. Wszystkie trzy usługi współpracują ze sobą, tworząc spójny ekosystem komunikacji IP.

3/55 Literatura

Materiały źródłowe i dokumentacja

Książka Tanenbauma i Wetheralla to kompleksowe źródło wiedzy o usługach sieciowych w kontekście modelu TCP/IP.

Dokumentacja ISC DHCP Server i BIND 9 stanowi oficjalne źródła informacji o konfiguracji serwerów.

Podręcznik Tanenbauma i Wetheralla „Komputerowe sieci" od lat stanowi złoty standard w kształceniu inżynierów sieciowych na całym świecie, oferując zarówno teoretyczne podstawy, jak i praktyczne przykłady. Dokumentacja ISC DHCP Server oraz BIND 9 to oficjalne źródła wiedzy dla administratorów wdrażających te serwery w środowiskach produkcyjnych. Szczególnie cenne są sekcje dotyczące konfiguracji zaawansowanych opcji, takich jak rezerwacje czy mechanizm relay agent.

Nie można pominąć oryginalnych dokumentów RFC (Request for Comments), które definiują każdy z omawianych protokołów w sposób precyzyjny i jednoznaczny. Dokument RFC 2131 dla DHCP, RFC 1034 i 1035 dla DNS oraz RFC 2663 dla NAT stanowią podstawę do zrozumienia szczegółów implementacyjnych i zachowania zgodności między różnymi producentami sprzętu. Współczesnym źródłem informacji są również strony producentów sprzętu sieciowego – Cisco i MikroTik publikują rozbudowane przewodniki konfiguracyjne z konkretnymi przykładami.
Warto także sięgnąć po materiały organizacji ICANN i IETF, które zarządzają infrastrukturą DNS i opracowują nowe standardy sieciowe. Polskie zasoby, takie jak dokumentacja NASK, są istotne dla administratorów pracujących w krajowym środowisku domeny .pl i korzystających z lokalnych usług rejestracji domen.

4/55 Problem – ręczna konfiguracja IP

Ręczna konfiguracja IP – kosztowna i podatna na błędy

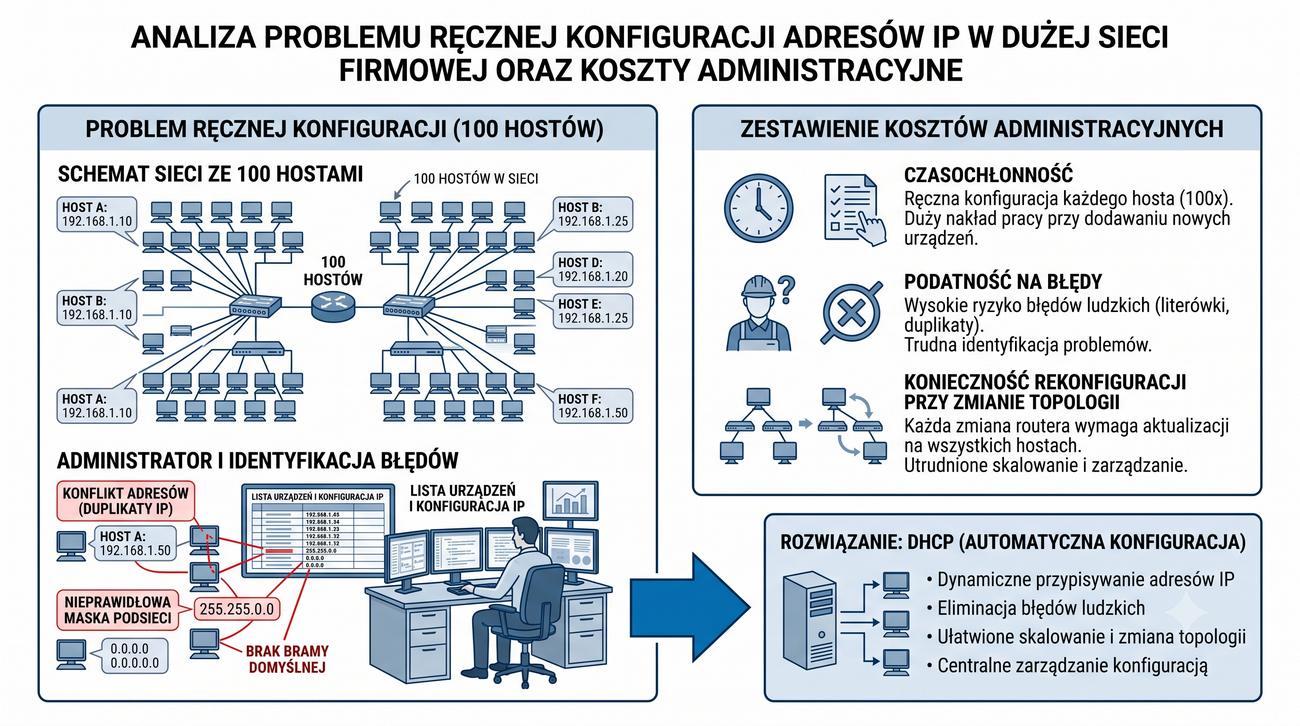
W sieci ze 100 hostami administrator musi ręcznie skonfigurować adres IP, maskę podsieci, bramę domyślną i serwer DNS na każdym komputerze.

Zmiana topologii sieci wymaga ponownej konfiguracji wszystkich hostów – bez DHCP oznacza to setki ręcznych interwencji.

Przeniesienie hosta do innej podsieci wymaga zmiany adresu IP – przy DHCP następuje to automatycznie.

Ręczna konfiguracja adresacji IP w sieci liczącej kilkaset urządzeń to zadanie nie tylko żmudne, ale przede wszystkim generujące ogromne ryzyko błędów. Każdy host wymaga poprawnego ustawienia adresu IP, maski podsieci, bramy domyślnej oraz co najmniej jednego adresu serwera DNS – pominięcie któregokolwiek z tych parametrów uniemożliwia poprawną komunikację. W praktyce błędy przy ręcznej konfiguracji są najczęstszą przyczyną problemów sieciowych w małych i średnich firmach, które nie wdrożyły jeszcze DHCP.

Sytuacja komplikuje się jeszcze bardziej, gdy konieczna jest zmiana topologii sieci lub migracja do nowej podsieci. Administrator musi wówczas odwiedzić każde urządzenie, co przy setkach hostów oznacza wiele godzin lub nawet dni pracy. W przypadku sieci korporacyjnych z rozproszonymi oddziałami ręczna rekonfiguracja jest praktycznie niemożliwa do wykonania w rozsądnym czasie bez przestojów w działaniu.

Dodatkowym wyzwaniem jest przenoszenie urządzeń między podsieciami – laptop zabrany z biura do domu wymaga całkowicie innej konfiguracji IP. Właśnie te problemy legły u podstaw powstania protokołu DHCP, który całkowicie automatyzuje proces konfiguracji i eliminuje ryzyko ludzkiego błędu, znacząco obniżając koszty administracyjne utrzymania sieci.

5/55 DHCP – definicja i rola

DHCP – Dynamic Host Configuration Protocol (RFC 2131)

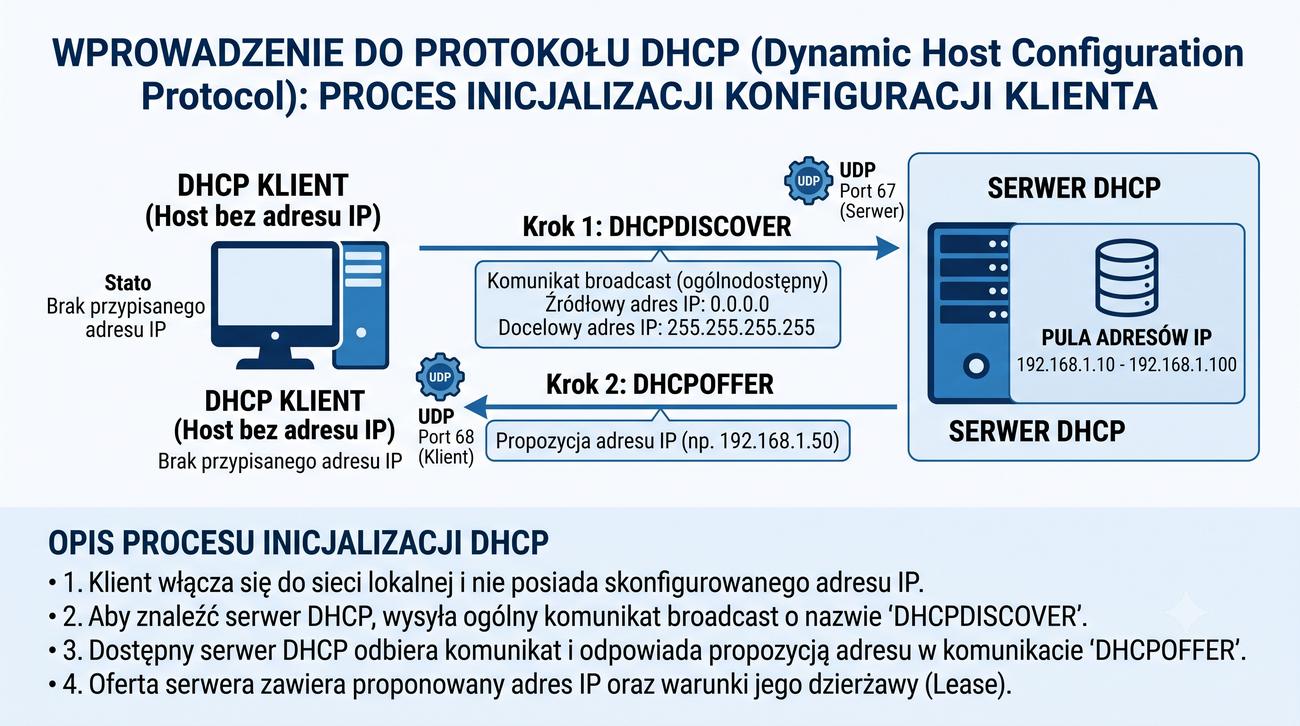
DHCP to protokół warstwy aplikacji (UDP 67 (serwer), 68 (klient)) automatyzujący przydział konfiguracji sieciowej hostom.

Model komunikacji opiera się na architekturze klient-serwer: serwer DHCP przechowuje pulę adresów i parametry konfiguracyjne.

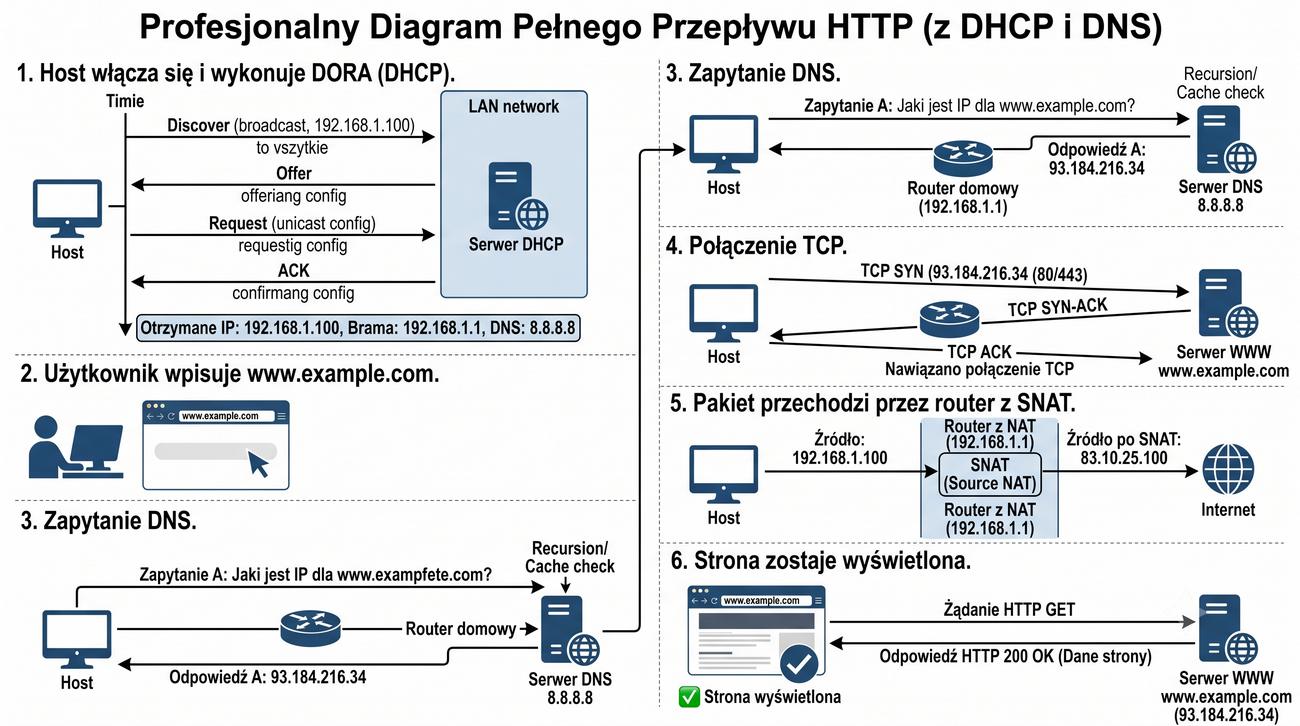
Host wysyła komunikat DHCP Discover w postaci broadcastu, a serwer odpowiada ofertą DHCP Offer z propozycją adresu i parametrów.

DHCP (Dynamic Host Configuration Protocol) działa w warstwie aplikacji modelu TCP/IP i wykorzystuje protokół transportowy UDP – serwer nasłuchuje na porcie 67, a klient na porcie 68. Komunikacja rozpoczyna się od wysłania przez klienta pakietu DHCPDISCOVER w postaci broadcastu na adres 255.255.255.255, ponieważ na tym etapie klient nie zna jeszcze własnego adresu IP ani adresu serwera. Serwer DHCP odpowiada pakietem DHCPOFFER, który zawiera propozycję adresu IP wraz z dodatkowymi parametrami sieciowymi, takimi jak maska i brama domyślna.

Architektura klient-serwer DHCP zakłada, że w jednym segmencie sieci może znajdować się wiele serwerów DHCP, a klient wybiera najlepszą ofertę spośród otrzymanych propozycji. W przypadku braku serwera w lokalnej podsieci niezbędny jest mechanizm DHCP Relay Agent, który przekazuje zapytania broadcast do serwera znajdującego się w innej sieci. Protokół DHCP rozwinął się z wcześniejszego protokołu BOOTP i jest z nim wstecznie zgodny, co ułatwiło migrację ze starszych rozwiązań.

Nowoczesne implementacje DHCP oferują zaawansowane funkcje, takie jak dynamiczne aktualizacje DNS, autoryzacja serwerów DHCP w Active Directory oraz szczegółowe logowanie wszystkich przydziałów adresów. Dzięki temu administrator ma pełny wgląd w to, które urządzenie otrzymało jaki adres IP i na jak długo, co znacznie ułatwia audyt i diagnostykę sieci.

6/55 DORA – sekwencja DHCP

DORA – czteroetapowy proces przydziału adresu

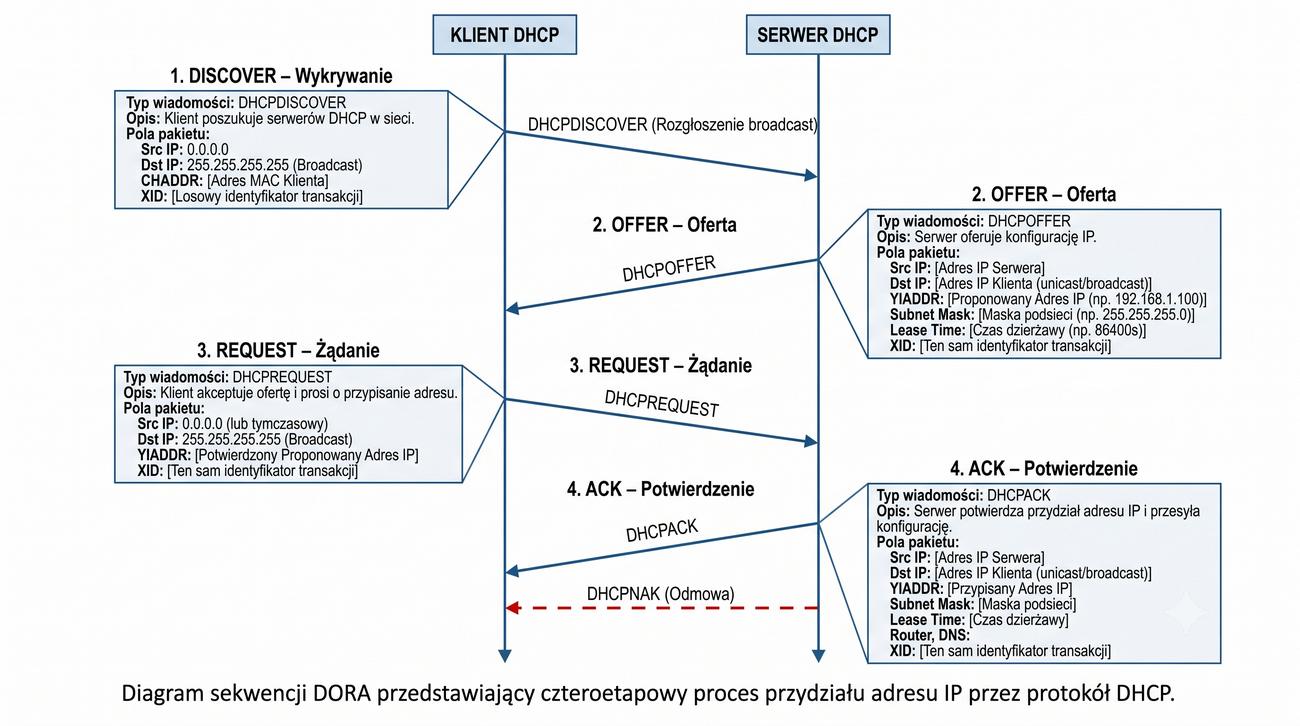
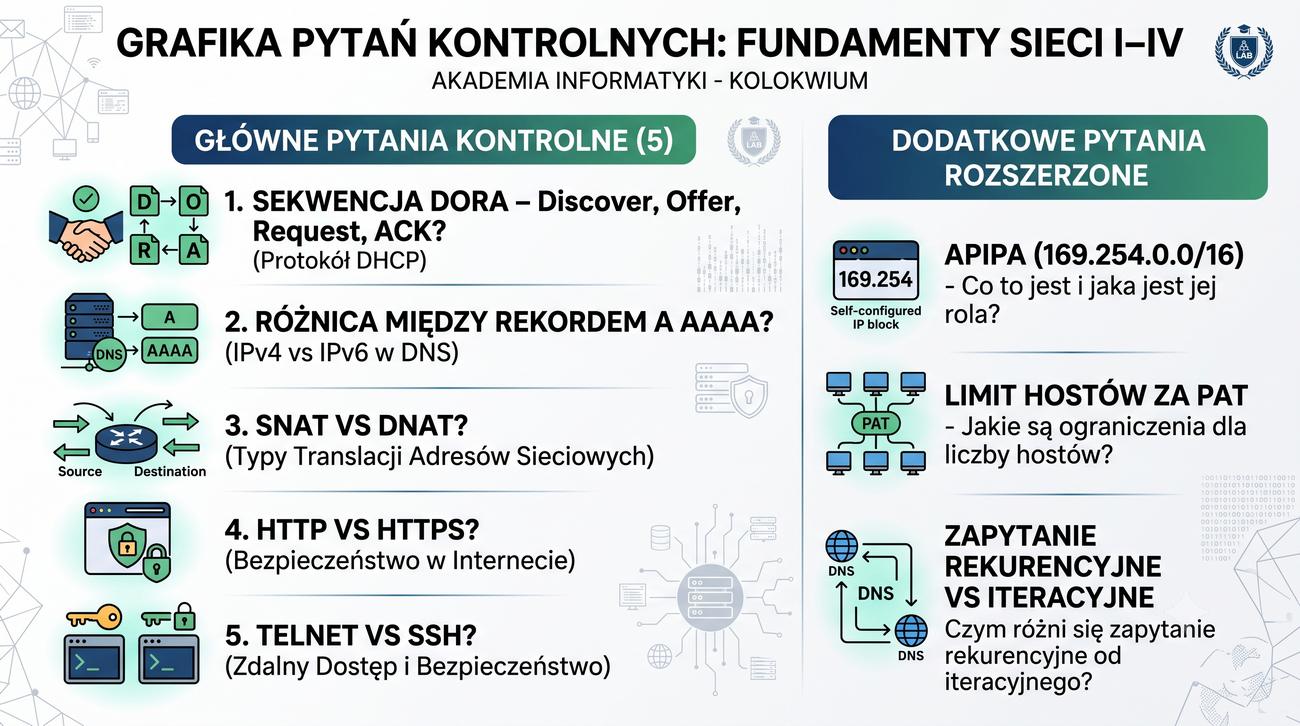
Sekwencja DORA to czteroetapowy proces przydziału adresu IP przez DHCP.

Discover: klient wysyła broadcast DHCPDISCOVER z adresem źródłowym 0.0.0.0 i docelowym 255.255.255.255, szukając serwera DHCP.

Offer: serwer odpowiada DHCPOFFER z proponowanym adresem IP, maską, czasem dzierżawy i adresem serwera.

Request: klient wysyła DHCPREQUEST, akceptując ofertę i potwierdzając wybór konkretnego serwera.

ACK: serwer potwierdza przydział DHCPACK z ostateczną konfiguracją.

Sekwencja DORA to cztery etapy, przez które przechodzi każdy klient DHCP, aby otrzymać pełną konfigurację sieciową. Pierwszym etapem jest Discover – klient wysyła pakiet DHCPDISCOVER z adresem źródłowym 0.0.0.0 i docelowym 255.255.255.255, ponieważ nie ma jeszcze własnego adresu IP. Drugi etap to Offer – serwer (lub serwery) odpowiadają pakietem DHCPOFFER, w którym proponują konkretny adres IP oraz inne parametry, takie jak maska podsieci, brama domyślna i czas dzierżawy.

W trzecim etapie, Request, klient wybiera jedną z otrzymanych ofert i wysyła pakiet DHCPREQUEST, informując tym samym wybrany serwer o akceptacji propozycji. Co istotne, klient nadal używa adresu 0.0.0.0 jako źródłowego, ponieważ adres nie został jeszcze oficjalnie przypisany i potwierdzony. Czwarty i ostatni etap to ACK – serwer potwierdza przydział pakietem DHCPACK, który zawiera ostateczną konfigurację, włączając w to adres IP, maskę, bramę, serwery DNS oraz czas dzierżawy.

W sytuacji, gdy serwer nie może przydzielić żądanego adresu (np. z powodu konfliktu lub wyczerpania puli), wysyła pakiet DHCPNAK, a klient musi rozpocząć cały proces od początku. Cała sekwencja DORA trwa zazwyczaj ułamek sekundy i jest całkowicie niewidoczna dla użytkownika końcowego, co stanowi jedną z największych zalet automatyzacji konfiguracji sieciowej.

7/55 Struktura pakietu DHCP

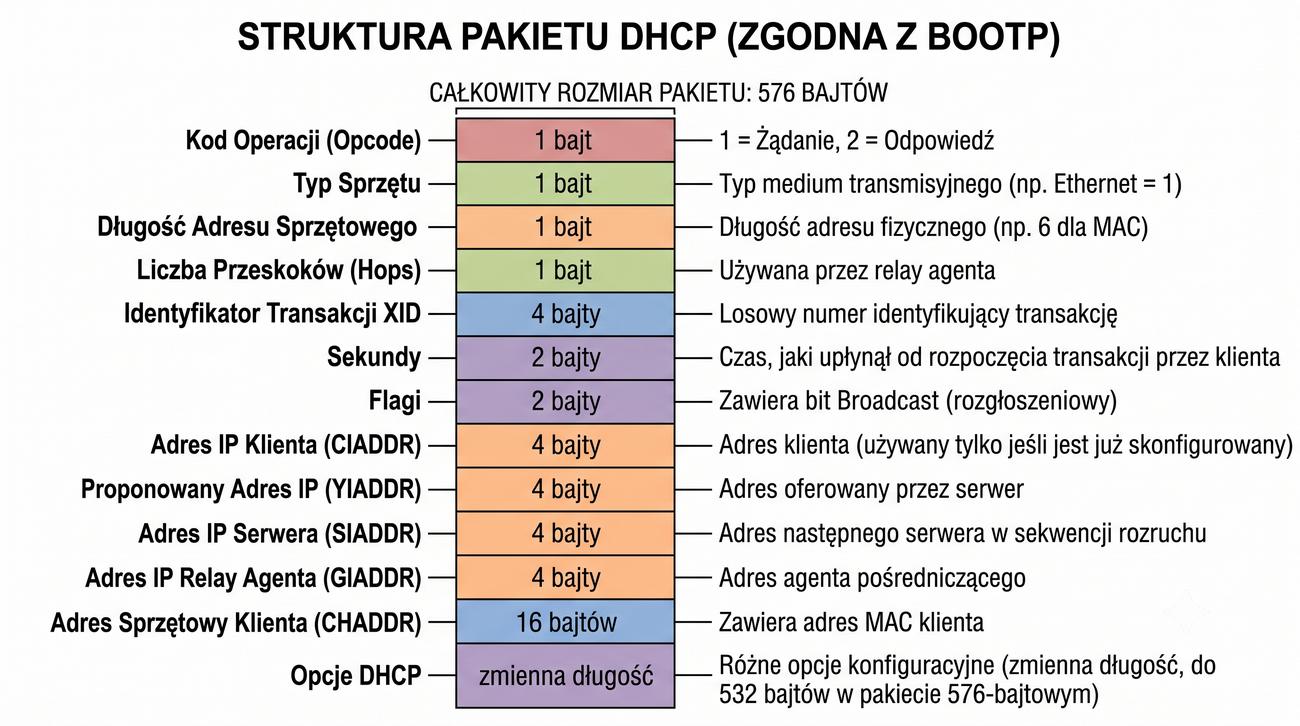
Budowa pakietu DHCP opartego na BOOTP (576 bajtów)

Pakiet DHCP jest oparty na formacie BOOTP i zgodnie z RFC 2131 mieści się w datagramie IP o długości do 576 bajtów.
  • Opcode – typ operacji (1=request, 2=reply)
  • XID (Transaction ID) – losowa wartość identyfikująca transakcję
  • YIADDR – adres IP proponowany klientowi przez serwer
  • GIADDR (Gateway IP Address) – adres relay agenta
  • CHADDR – adres MAC klienta (16 bajtów)
  • Options – pole o zmiennej długości z opcjami DHCP

Pakiet DHCP został oparty na formacie protokołu BOOTP. Zgodnie z RFC 2131 klient musi być przygotowany na odebranie komunikatu o długości do 576 bajtów, co zapewnia kompatybilność z najstarszymi implementacjami IP. Pole Opcode określa typ operacji – wartość 1 oznacza żądanie (request) wysyłane przez klienta, a wartość 2 odpowiedź (reply) od serwera. Pole XID (Transaction ID) zawiera losową 32-bitową wartość, która umożliwia powiązanie odpowiedzi serwera z konkretnym żądaniem klienta, co jest kluczowe przy wielu równoczesnych transakcjach DHCP w sieci.

Pole YIADDR (Your IP Address) przechowuje adres IP, który serwer proponuje klientowi do użytku, natomiast CHADDR (Client Hardware Address) to 16-bajtowe pole zawierające adres MAC klienta. Pole GIADDR (Gateway IP Address) jest używane przez mechanizm DHCP Relay do przechowywania adresu rutera, który przekazał zapytanie do serwera w innej sieci. Dzięki temu serwer wie, z której podsieci pochodzi żądanie i z której puli powinien przydzielić adres IP.

Najbardziej elastyczną częścią pakietu jest pole Options, które ma zmienną długość i pozwala na przesyłanie dodatkowych parametrów konfiguracyjnych wykraczających poza podstawowe informacje. Opcje są kodowane w formacie TLV (Type-Length-Value), co umożliwia łatwe rozszerzanie protokołu o nowe funkcje bez naruszania zgodności z istniejącymi implementacjami i starszymi klientami DHCP.

8/55 DHCP Lease – czas dzierżawy

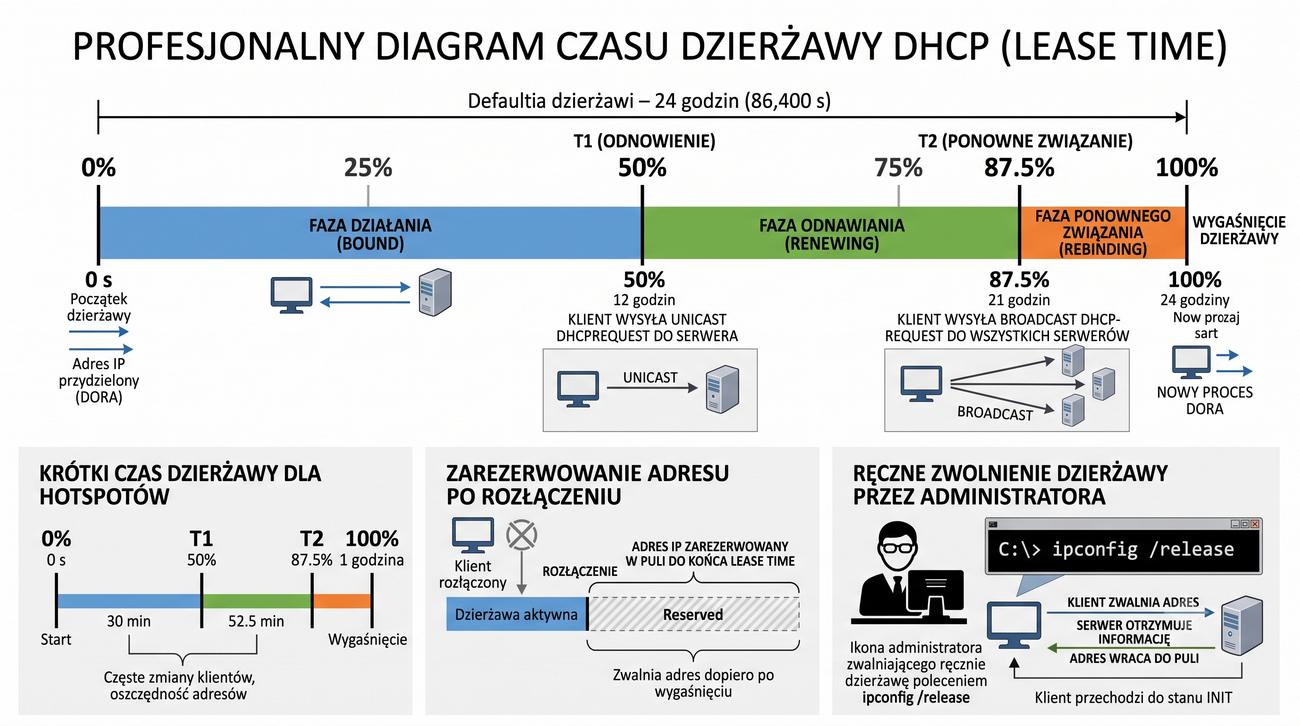
Lease Time – okres ważności przydzielonego adresu IP

T1 (50% czasu dzierżawy): klient wysyła unicast DHCPREQUEST bezpośrednio do serwera w celu odnowienia dzierżawy.

T2 (87,5% czasu): jeśli serwer nie odpowiedział w T1, klient wysyła broadcast DHCPREQUEST do wszystkich serwerów DHCP w sieci.

Po wygaśnięciu dzierżawy (100% czasu) klient musi rozpocząć proces DORA od nowa.

Czas dzierżawy (lease time) to okres, na jaki serwer DHCP przydziela adres IP klientowi – po jego upływie adres wraca do puli i może być użyty dla innego urządzenia. Mechanizm ten zapobiega marnowaniu adresów IP przez hosty, które opuściły sieć, oraz umożliwia dynamiczne zarządzanie pulą w sieciach o zmiennej liczbie użytkowników. Typowy czas dzierżawy w sieciach domowych wynosi 24 godziny, w sieciach korporacyjnych często 8 dni, a w publicznych hotspotach WiFi zaledwie 30–60 minut.

W punkcie T1 (50% czasu dzierżawy) klient próbuje odnowić dzierżawę, wysyłając unicast DHCPREQUEST bezpośrednio do serwera, który pierwotnie przydzielił adres. Jeśli serwer nie odpowiada, klient czeka do punktu T2 (87,5% czasu), po czym przechodzi do trybu broadcast – wysyła DHCPREQUEST na adres 255.255.255.255, aby dotrzeć do dowolnego serwera DHCP w sieci. Taki dwuetapowy mechanizm zapewnia wysoką niezawodność, ponieważ klient ma dwie szanse na odnowienie i dopiero przy całkowitym braku odpowiedzi traci konfigurację.

Po wygaśnięciu dzierżawy (100% czasu) klient musi rozpocząć cały proces DORA od nowa, co może skutkować otrzymaniem innego adresu IP niż poprzednio. Krótki czas dzierżawy jest zalecany w sieciach o dużej rotacji urządzeń, natomiast długi czas zmniejsza obciążenie serwera DHCP i zapewnia stabilność adresacji dla serwerów oraz urządzeń infrastrukturalnych.

9/55 DHCP Scope – pula adresów

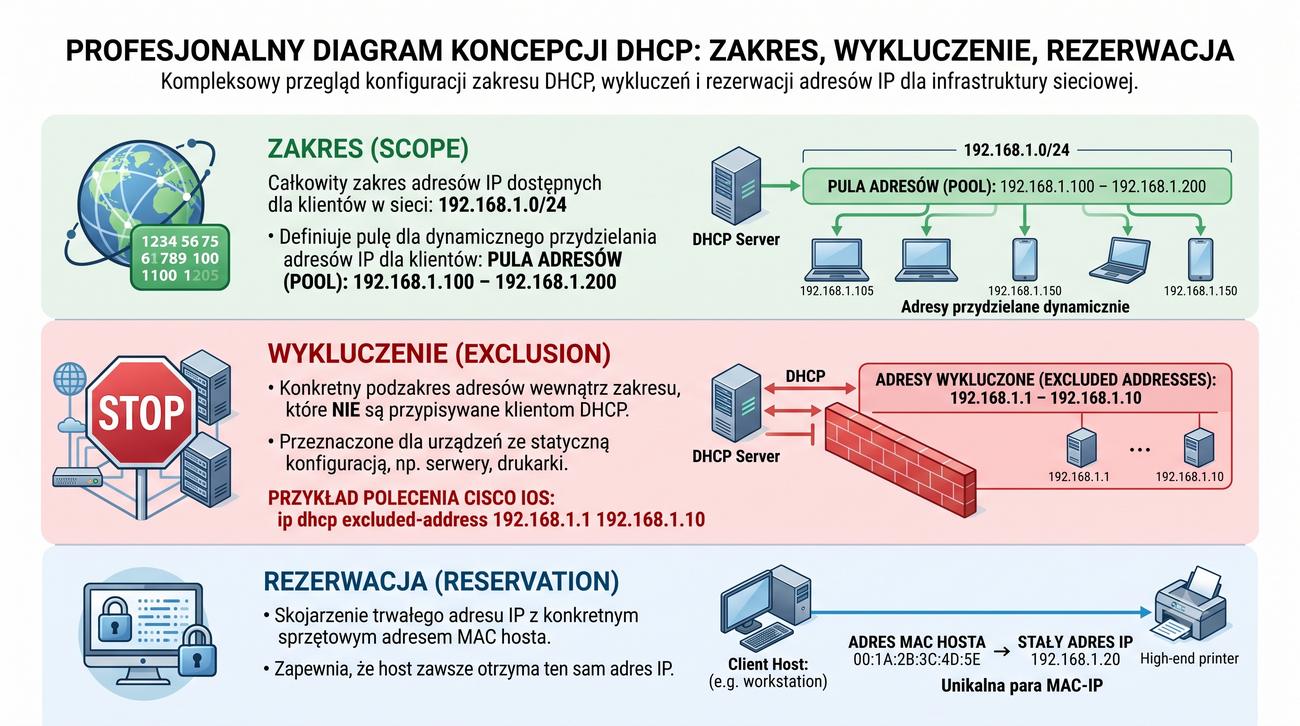
Scope, Exclusion i Reservation – zarządzanie pulą adresów

  • Scope – zakres adresów IP (np. 192.168.1.100-200/24) zdefiniowany przez adres sieci i maskę
  • Exclusion – adresy IP wyłączone z puli dla serwerów, drukarek i urządzeń wymagających stałego adresu
  • Reservation – stały przydział konkretnego adresu IP dla określonego adresu MAC hosta

Scope (zakres) to zdefiniowany przez administratora przedział adresów IP, które serwer DHCP może przydzielać klientom w danej podsieci. Definiując scope, administrator określa adres sieci i maskę podsieci, a także dodatkowe parametry, takie jak brama domyślna czy serwery DNS, które będą przekazywane klientom wraz z adresem. Scope może obejmować całą podsieć lub jej fragment, co pozwala na elastyczne zarządzanie przestrzenią adresową w zależności od potrzeb organizacji.

Exclusion (wykluczenie) to mechanizm pozwalający na wyłączenie z puli DHCP konkretnych adresów IP, które są zarezerwowane dla urządzeń wymagających stałej, ręcznie konfigurowanej adresacji. Typowe przykłady to serwery, drukarki sieciowe, przełączniki zarządzalne czy punkty dostępowe WiFi, które potrzebują niezmiennego adresu IP dla celów administracyjnych i monitorowania. Wykluczenia zapobiegają sytuacjom, w których serwer DHCP przydzieliłby adres IP zajęty już przez inne urządzenie o krytycznym znaczeniu.

Reservation (rezerwacja) idzie o krok dalej – umożliwia stałe powiązanie konkretnego adresu IP z adresem MAC klienta, zapewniając mu zawsze tę samą konfigurację przy każdym odnowieniu dzierżawy. Rezerwacje są szczególnie przydatne dla urządzeń, które muszą mieć stały adres IP, ale jednocześnie korzystają z DHCP dla pozostałych parametrów sieciowych, takich jak brama czy serwery DNS. W środowiskach korporacyjnych często łączy się scope z exclusion i reservation, aby precyzyjnie kontrolować całą adresację IP w sieci.

10/55 DHCP Relay Agent

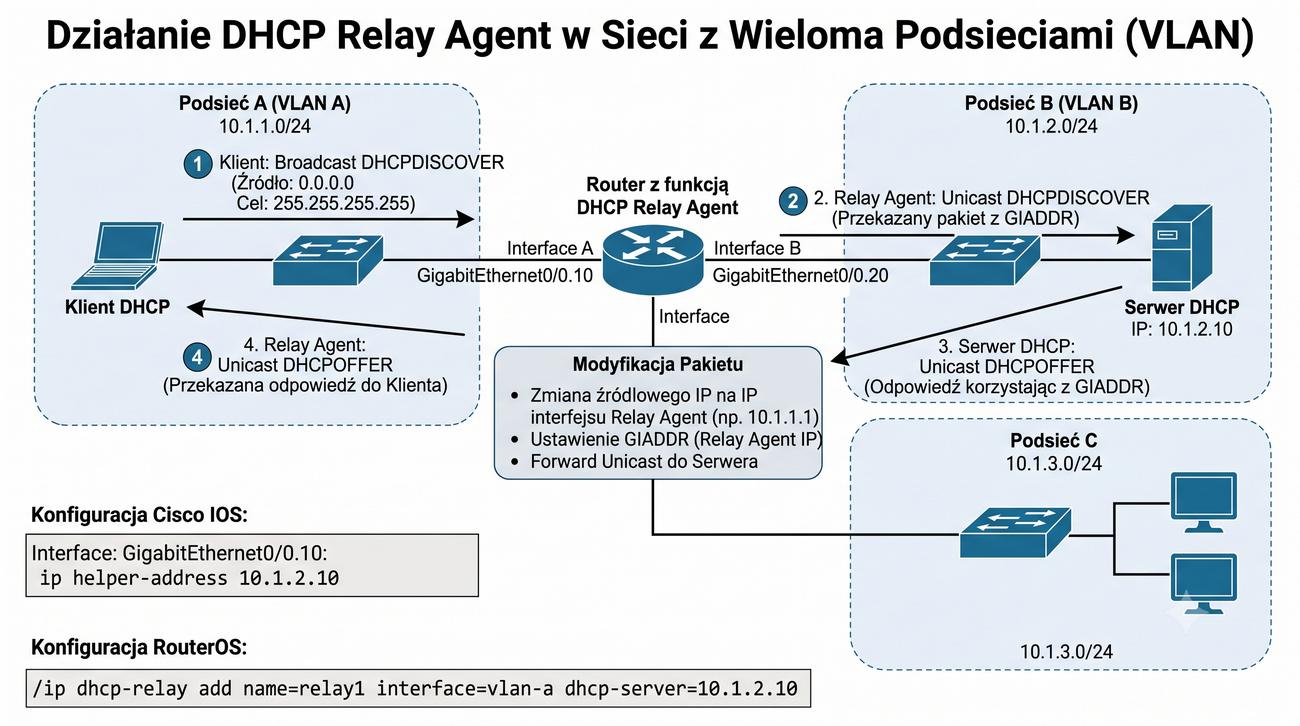
DHCP Relay – obsługa żądań DHCP między podsieciami

DHCP Discover jest pakietem broadcast, który normalnie nie jest przekazywany przez router do innych sieci.

Relay Agent przekazuje zapytania jako unicast do serwera DHCP w innej sieci, ustawiając pole GIADDR na adres interfejsu.

W Cisco IOS konfiguracja: ip helper-address na interfejsie VLAN.

Protokół DHCP wykorzystuje pakiety broadcast, które domyślnie nie są przekazywane przez routery do innych podsieci – oznacza to, że serwer DHCP może bezpośrednio obsłużyć tylko klientów w swoim segmencie sieci. Rozwiązaniem tego ograniczenia jest mechanizm DHCP Relay Agent (znany również jako DHCP helper), który pośredniczy między klientem a serwerem znajdującym się w innej podsieci. Relay Agent przechwytuje broadcastowy pakiet DHCPDISCOVER, przekształca go w pakiet unicast i wysyła bezpośrednio do skonfigurowanego serwera DHCP, eliminując ograniczenia wynikające z izolacji broadcastów.

Kluczowym elementem działania Relay Agenta jest pole GIADDR (Gateway IP Address) w pakiecie DHCP, które agent wypełnia adresem IP swojego interfejsu w sieci klienta. Dzięki temu serwer DHCP wie, z której podsieci pochodzi żądanie i może przydzielić adres IP z odpowiedniego zakresu, nawet jeśli obsługuje dziesiątki różnych podsieci. W środowiskach z wieloma sieciami VLAN, gdzie każda VLAN ma oddzielną podsieć, Relay Agent jest praktycznie niezbędny do scentralizowanego zarządzania adresacją.

W urządzeniach Cisco funkcję Relay Agenta włącza się za pomocą polecenia ip helper-address na interfejsie, podając adres IP serwera DHCP. W routerach MikroTik analogiczną funkcję realizuje narzędzie DHCP Relay dostępne w menu IP. Dzięki zastosowaniu Relay Agenta jeden serwer DHCP może obsługiwać całe przedsiębiorstwo z wieloma podsieciami, co znacząco upraszcza zarządzanie infrastrukturą sieciową i redukuje koszty.

11/55 DHCP – opcje dodatkowe

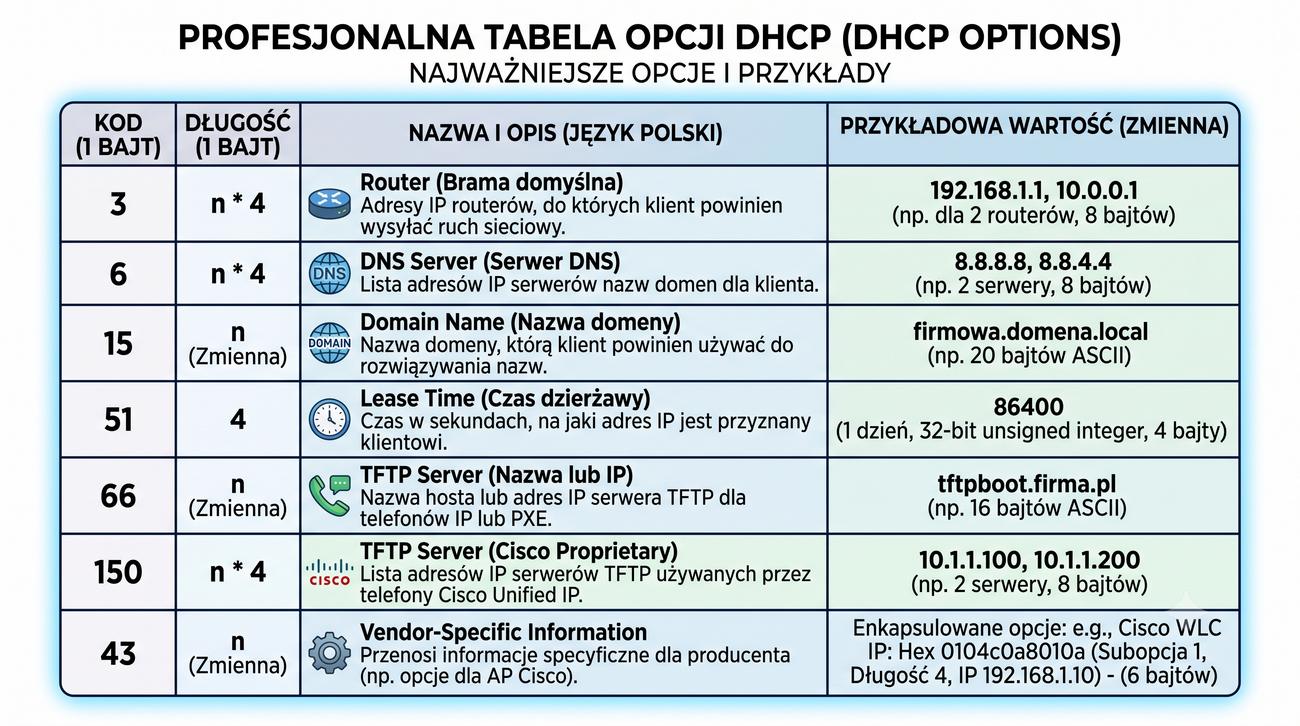
DHCP Options – rozszerzona konfiguracja przez opcje

  • Option 3 (Router) – adres bramy domyślnej
  • Option 6 (DNS Server) – adres serwera DNS
  • Option 15 (Domain Name) – nazwa domeny DNS
  • Option 51 (Lease Time) – czas dzierżawy
  • Option 66 (TFTP Server) i Option 150 – dla telefonów IP Cisco
  • Option 43 (Vendor Specific Info) – parametry producenckie

Protokół DHCP definiuje liczne opcje (options), które umożliwiają serwerowi przekazanie klientowi dodatkowych parametrów konfiguracyjnych wykraczających poza podstawowy adres IP i maskę. Każda opcja ma swój unikalny numer identyfikacyjny i jest kodowana w formacie TLV (Type-Length-Value) w polu Options pakietu DHCP, co zapewnia elastyczność i możliwość rozbudowy. Najczęściej używane opcje to Option 3 (brama domyślna), Option 6 (serwer DNS) oraz Option 51 (czas dzierżawy), które stanowią absolutną podstawę każdej konfiguracji DHCP.

Bardziej zaawansowane opcje obejmują Option 15 (nazwa domeny DNS), która pozwala automatycznie skonfigurować sufiks domeny na kliencie, oraz Option 66 (adres serwera TFTP) używaną powszechnie w środowiskach telefonii IP Cisco do pobrania konfiguracji przez telefony VoIP. Option 43 (Vendor Specific Information) umożliwia producentom sprzętu przekazywanie własnych, specyficznych parametrów, co jest szczególnie przydatne w przypadku urządzeń sieciowych różnych marek i specjalistycznych aplikacji.

W środowiskach IPv6 odpowiednikiem opcji DHCP są mechanizmy DHCPv6 z własnym zestawem opcji pełniących analogiczne funkcje. Znajomość opcji DHCP i umiejętność ich konfiguracji jest niezbędna dla administratorów sieci, ponieważ pozwala na pełną automatyzację konfiguracji wszystkich parametrów sieciowych bez konieczności ręcznej ingerencji na poszczególnych hostach.

12/55 DHCP Snooping – bezpieczeństwo

DHCP Snooping – ochrona przed Rogue DHCP Server

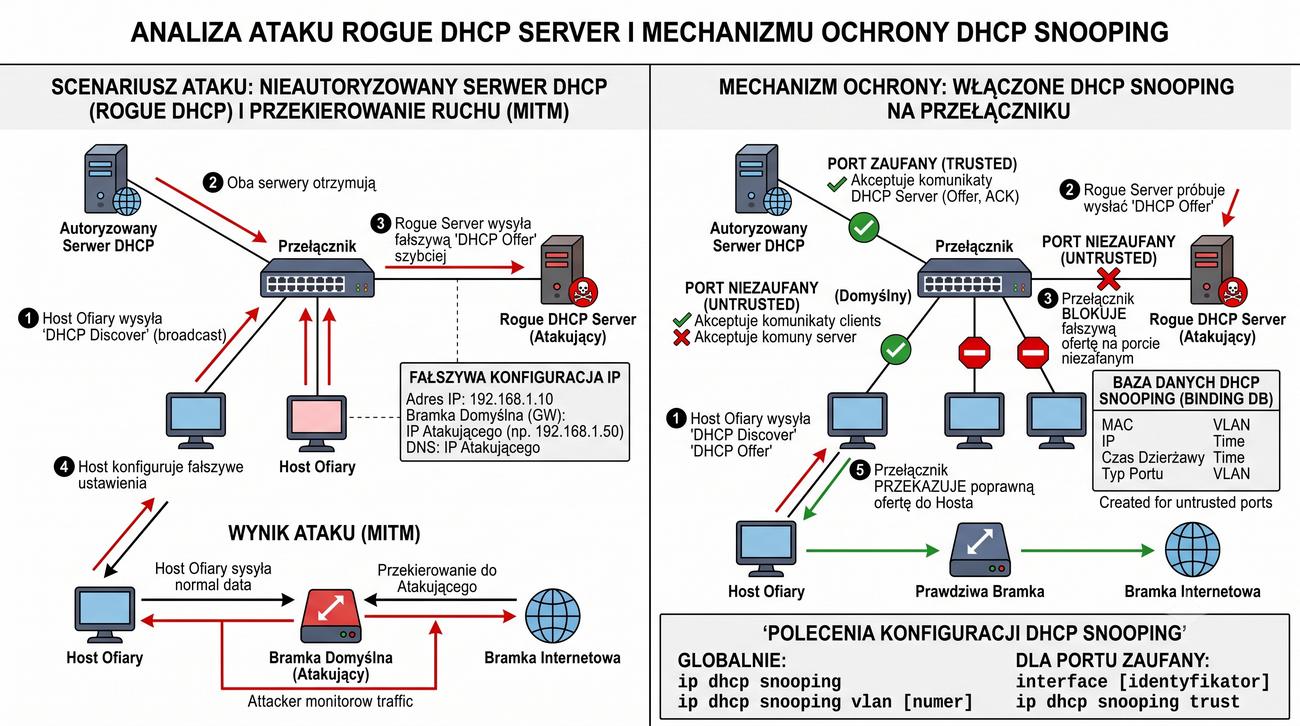
DHCP Snooping to funkcja bezpieczeństwa na przełącznikach Cisco chroniąca przed atakami Rogue DHCP Server.

Nieautoryzowany serwer DHCP podłączony do sieci może przydzielać hostom fałszywą konfigurację IP, przekierowując ruch do atakującego.

DHCP Snooping dzieli porty na trusted (zaufane, tam gdzie są autoryzowane serwery DHCP) i untrusted.

Przełącznik blokuje pakiety DHCP Offer i DHCP ACK na portach untrusted.

Mechanizm DHCP Snooping opiera się na budowaniu i utrzymywaniu przez przełącznik bazy danych wiązań DHCP – tzw. DHCP Snooping Binding Database. Każdy wpis w tej bazie zawiera adres MAC klienta, przydzielony adres IP, czas dzierżawy, numer VLAN oraz identyfikator portu, na którym klient został wykryty.

Dzięki tej bazie przełącznik jest w stanie odróżnić prawidłowe odpowiedzi DHCP od fałszywych. Gdy na porcie untrusted pojawi się pakiet DHCP Offer lub DHCP ACK, przełącznik natychmiast go odrzuca, uniemożliwiając nieautoryzowanemu serwerowi przejęcie kontroli nad konfiguracją sieciową hostów.

Oprócz ochrony przed Rogue DHCP Server funkcja DHCP Snooping zapobiega również atakom typu DHCP Starvation, polegającym na wysyłaniu ogromnej liczby fałszywych zapytań DHCP Discover z różnymi adresami MAC w celu wyczerpania puli adresów w legalnym serwerze. W nowoczesnych sieciach DHCP Snooping jest często łączony z Dynamic ARP Inspection (DAI) oraz IP Source Guard, tworząc kompleksowy mechanizm ochrony warstwy 2.

13/55 DHCP – konfiguracja w Cisco IOS

Konfiguracja serwera DHCP w Cisco IOS

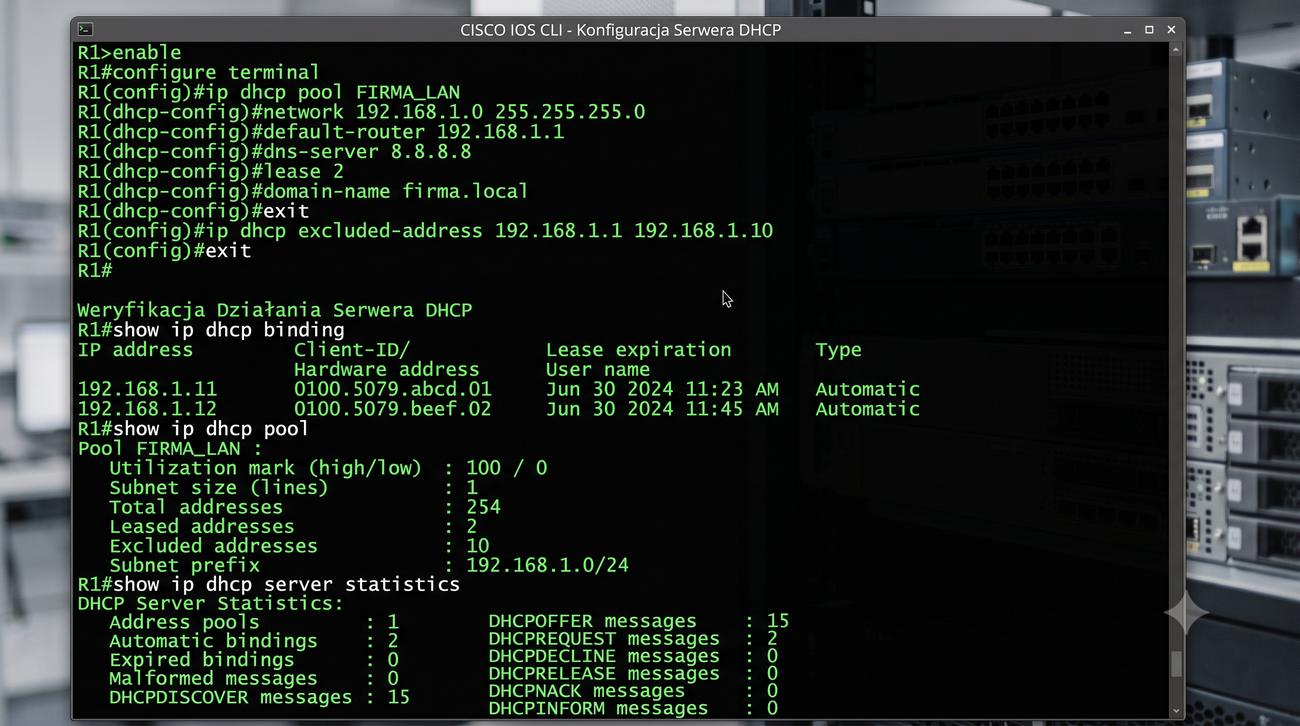
  • ip dhcp pool LAN1 – tworzy pulę DHCP
  • network 192.168.1.0 255.255.255.0 – określa sieć i maskę dla puli
  • default-router 192.168.1.1 – ustawia bramę domyślną
  • dns-server 8.8.8.8 – określa serwer DNS
  • lease 2 – czas dzierżawy na 2 dni
  • ip dhcp excluded-address – wyklucza adresy IP z puli

Po skonfigurowaniu podstawowych parametrów serwera DHCP w Cisco IOS warto pamiętać o kilku dodatkowych opcjach. Administrator może ustawić czas dzierżawy za pomocą polecenia lease {days [hours] [minutes] | infinite}, a także zdefiniować domenę DNS dla klientów komendą domain-name example.local. Dla sieci wymagających stałych adresów IP stosuje się rezerwacje: host klient1 hardware-address aaaa.bbbb.cccc.

Do weryfikacji działania serwera DHCP służy kilka przydatnych poleceń show. show ip dhcp binding wyświetla listę wszystkich aktywnych dzierżaw wraz z adresami MAC klientów i pozostałym czasem dzierżawy. show ip dhcp pool pokazuje statystyki wykorzystania poszczególnych pul, a show ip dhcp conflict ujawnia adresy, które były przedmiotem konfliktu w sieci.

W sytuacjach awaryjnych przydaje się czyszczenie dzierżaw komendą clear ip dhcp binding * oraz włączenie logowania zdarzeń DHCP za pomocą debug ip dhcp server events. Należy jednak pamiętać, że debugowanie w środowisku produkcyjnym może znacząco obciążyć procesor routera.

14/55 DHCP – konfiguracja w RouterOS

Konfiguracja serwera DHCP w RouterOS (MikroTik)

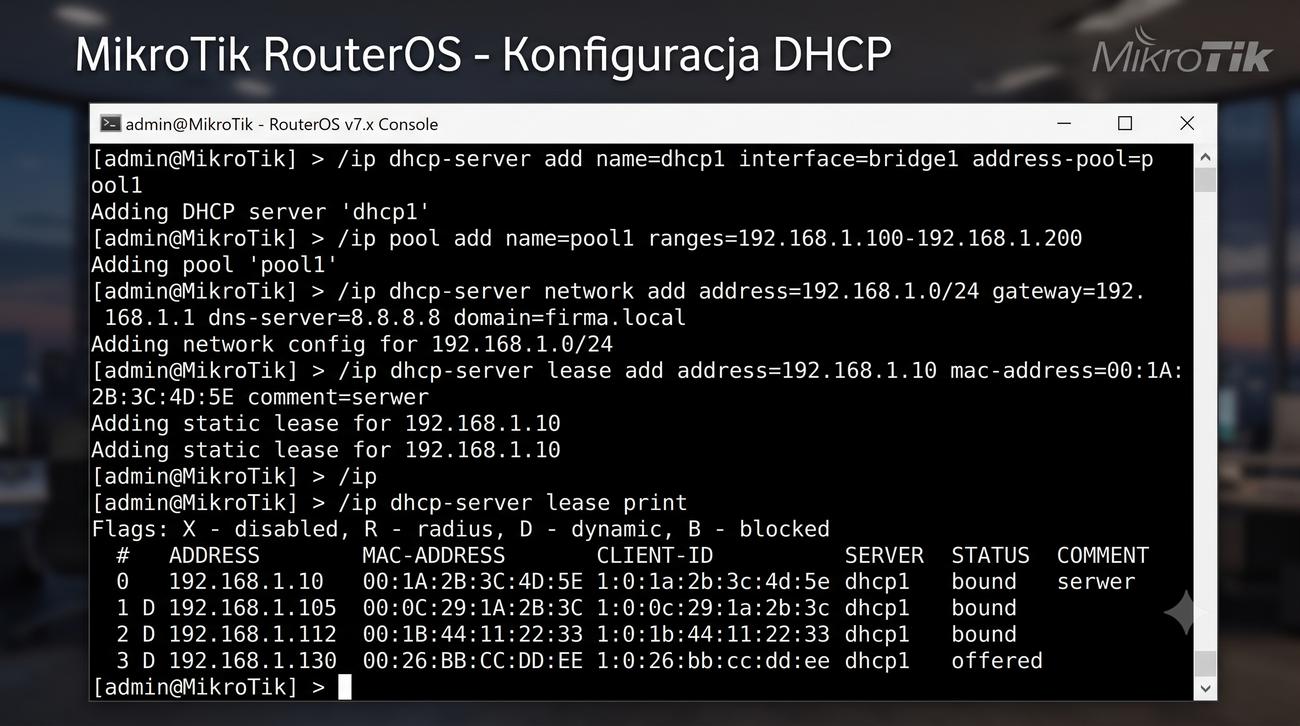
  • /ip dhcp-server add name=dhcp1 interface=bridge1 address-pool=pool1 – tworzy serwer
  • /ip pool add name=pool1 ranges=192.168.1.100-192.168.1.200 – definiuje zakres
  • /ip dhcp-server network add address=192.168.1.0/24 gateway=192.168.1.1 dns-server=8.8.8.8 – konfiguracja sieci

W RouterOS (MikroTik) konfiguracja serwera DHCP jest równie elastyczna jak w Cisco, ale odbywa się za pomocą odmiennej składni. Po utworzeniu serwera i puli adresów warto skonfigurować opcje dodatkowe, takie jak DHCP Options Sets, które pozwalają grupować wiele opcji (np. serwer NTP, serwer TFTP, adres serwera logowania) i przypisywać je do konkretnych sieci lub hostów.

Do zarządzania dzierżawami w RouterOS służy komenda /ip dhcp-server lease print, która wyświetla wszystkie aktywne przydziały i ich status. Administrator może dodać statyczną rezerwację za pomocą /ip dhcp-server lease add address=192.168.1.50 mac-address=AA:BB:CC:DD:EE:FF, co jest szczególnie przydatne dla serwerów, drukarek sieciowych i punktów dostępowych.

RouterOS oferuje również zaawansowane funkcje, takie jak DHCP Alert do wykrywania nieautoryzowanych serwerów DHCP oraz mechanizm DHCP Client Options, pozwalający klientom na żądanie konkretnych parametrów konfiguracyjnych. Weryfikację poprawności konfiguracji ułatwia narzędzie Torch w WinBox oraz logi systemowe dostępne pod /log print.

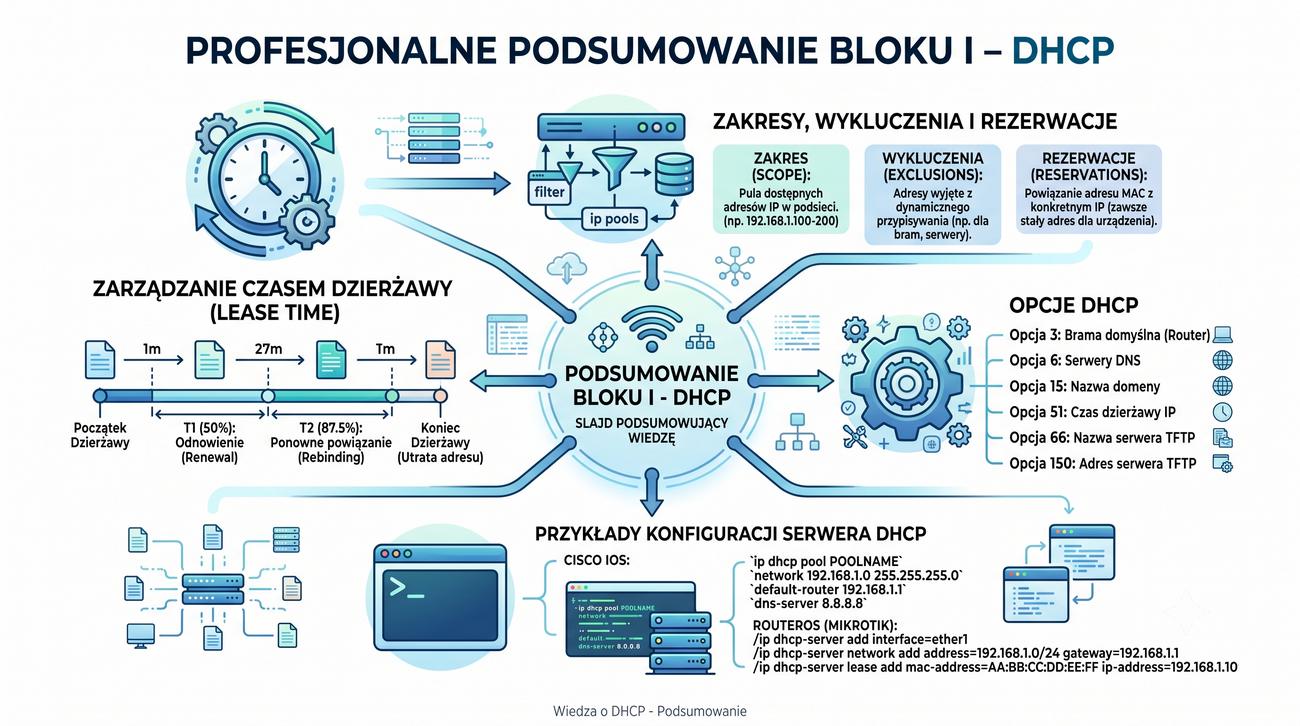
15/55 Podsumowanie bloku I – DHCP

Blok I – podsumowanie: DHCP w pigułce

  • DORA – Discover, Offer, Request, ACK – czteroetapowy proces przydziału adresu
  • Lease Time – czas dzierżawy z odnowieniem w T1 (50%) i T2 (87,5%)
  • Scope – pula adresów, Exclusion – wykluczenia, Reservation – rezerwacje
  • DHCP Relay – obsługa żądań między podsieciami
  • DHCP Snooping – ochrona przed Rogue DHCP Server

Blok DHCP, który właśnie omówiliśmy, stanowi fundament automatycznej konfiguracji hostów w każdej nowoczesnej sieci IP. Kluczowym elementem, który łączy wszystkie poznane koncepcje, jest cykl życia dzierżawy DHCP – od momentu wysłania DHCP Discover przez klienta, poprzez sekwencję DORA, aż do odnowienia lub wygaśnięcia dzierżawy.

Warto podkreślić, że mechanizm DHCP Relay umożliwia centralne zarządzanie konfiguracją nawet w rozległych sieciach korporacyjnych z wieloma sieciami VLAN i podsieciami. Z kolei DHCP Snooping stanowi niezbędną warstwę bezpieczeństwa, bez której żaden odpowiedzialny administrator nie powinien pozostawiać sieci LAN.
Znajomość różnic w konfiguracji DHCP pomiędzy platformami Cisco IOS a RouterOS (MikroTik) jest cenna w praktyce inżynierskiej – oba środowiska oferują pełną funkcjonalność, ale różnią się składnią i filozofią zarządzania. Niezależnie od platformy, zasady działania protokołu DHCP określone w RFC 2131 pozostają niezmienne.

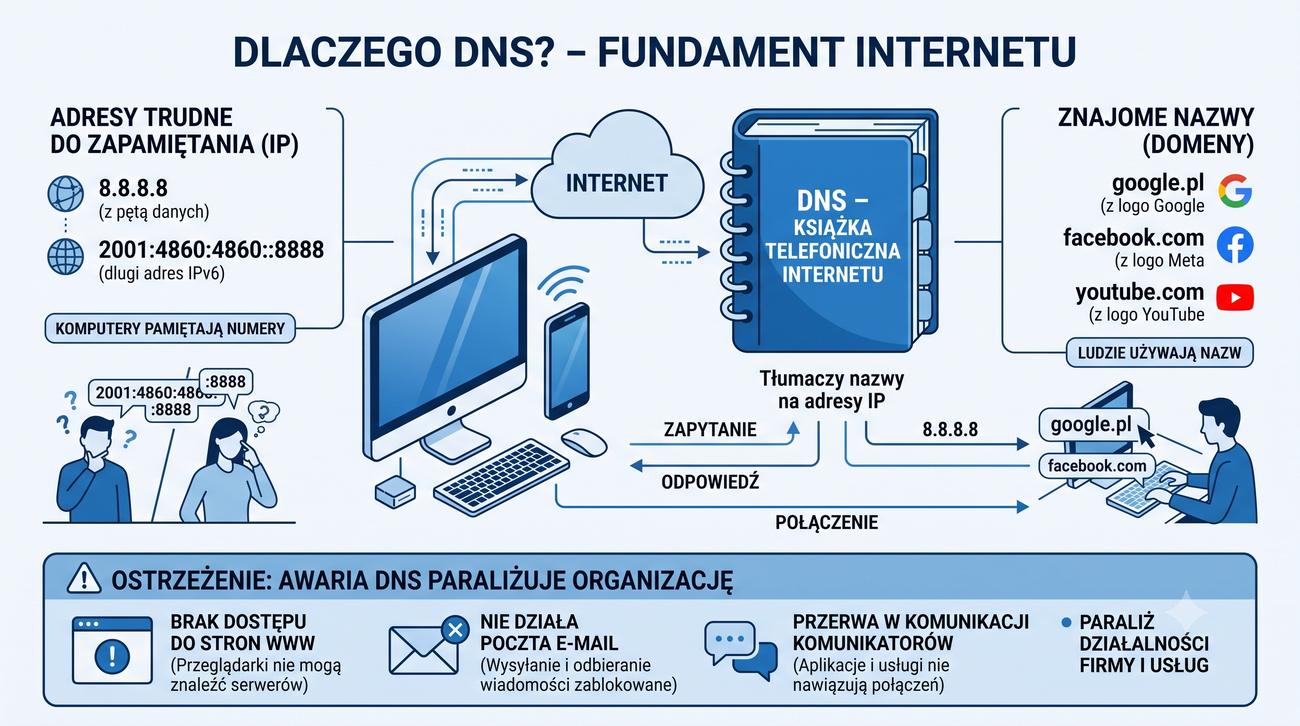
16/55 Problem – numery IP są trudne do zapamiętania

Adresy IP – trudne do zapamiętania dla człowieka

Adresy IP w formacie dziesiętnym są trudne do zapamiętania dla człowieka – DNS rozwiązuje ten problem.

Podczas gdy 8.8.8.8 jest łatwy, adres IPv6 taki jak 2001:4860:4860::8888 jest znacznie trudniejszy do zapamiętania.

DNS jest często nazywany książką telefoniczną Internetu – zamiast dzwonić pod numer, wybiera się nazwę, a system znajduje odpowiedni numer.

Problem zapamiętywania adresów IP nie polega wyłącznie na ich długości – istotne jest również to, że adresy IP mogą się zmieniać bez wiedzy użytkownika. Dostawca Internetu może modyfikować pulę adresów, firma może zmienić operatora, a administrator może przebudować schemat adresacji wewnętrznej. Gdyby użytkownicy musieli zapamiętywać adresy IP, każda taka zmiana oznaczałaby kompletny paraliż komunikacji.
DNS rozwiązuje ten problem przez wprowadzenie warstwy abstrakcji między nazwą a adresem. Zmiana adresu IP serwera wymaga wówczas jedynie aktualizacji jednego rekordu w strefie DNS, a użytkownicy nadal mogą korzystać z tej samej, niezmienionej nazwy domenowej. Bez DNS każda strona WWW, każdy serwer poczty i każde API musiałoby być dostępne pod stałym adresem IP – co w dobie chmury obliczeniowej i migracji między centrami danych jest praktycznie niemożliwe.
W kontekście IPv6 problem zapamiętywania adresów jest jeszcze bardziej dotkliwy. Pojedynczy adres IPv6 w zapisie szesnastkowym może mieć do 32 znaków, co czyni go całkowicie niezapamiętywalnym dla przeciętnego człowieka. Dlatego DNS jest dziś absolutnie niezbędnym elementem infrastruktury sieciowej, a jego awaria paraliżuje działanie całego Internetu.

17/55 DNS – hierarchia nazw

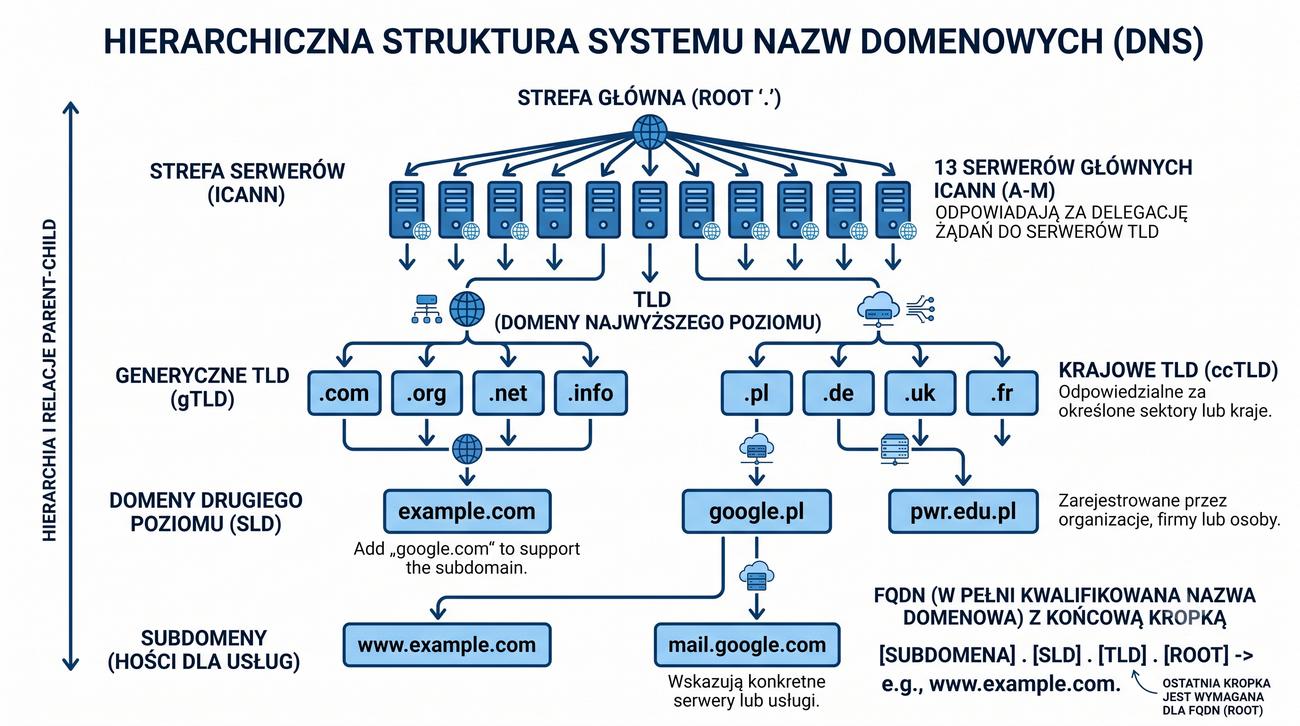
Hierarchiczna struktura DNS – root, TLD, domena drugiego poziomu

Hierarchia DNS ma strukturę drzewiastą, na której szczycie znajduje się strefa główna (root) oznaczana kropką.

Strefa główna jest obsługiwana przez 13 logicznych serwerów głównych (oznaczonych literami od A do M), których funkcjonowanie koordynuje ICANN.

TLD (Top-Level Domain) dzielą się na generyczne (gTLD: .com, .org) i krajowe (ccTLD: .pl, .de).

Poniżej TLD znajdują się domeny drugiego poziomu i subdomeny – każdy poziom oddzielony kropką.

Hierarchiczna struktura DNS nie powstała przypadkowo – jej drzewiasta organizacja pozwala na zdecentralizowane zarządzanie poszczególnymi strefami. Każda organizacja, która rejestruje domenę, staje się administratorem własnej strefy i może samodzielnie tworzyć subdomeny bez konieczności odwoływania się do centralnego rejestru. To właśnie ta decentralizacja sprawia, że system DNS jest skalowalny i odporny na awarie.

Serwery główne (root servers), oznaczone literami od A do M, są zarządzane przez różne organizacje na całym świecie – m.in. Verisign, University of Maryland, NASA i ICANN. Ich rozmieszczenie geograficzne wykorzystuje technikę anycast, dzięki czemu zapytanie do serwera głównego trafia do najbliższego geograficznie egzemplarza, co minimalizuje opóźnienia.

W praktyce przeciętny użytkownik nigdy nie kontaktuje się bezpośrednio z serwerami głównymi. Jego komputer wysyła zapytanie do lokalnego resolvera DNS (np. serwera dostawcy Internetu), który – jeśli nie ma odpowiedzi w pamięci podręcznej – rekurencyjnie przechodzi przez całą hierarchię: od serwera głównego, przez serwer TLD, aż do autorytatywnego serwera docelowej domeny.

18/55 DNS – budowa nazwy FQDN

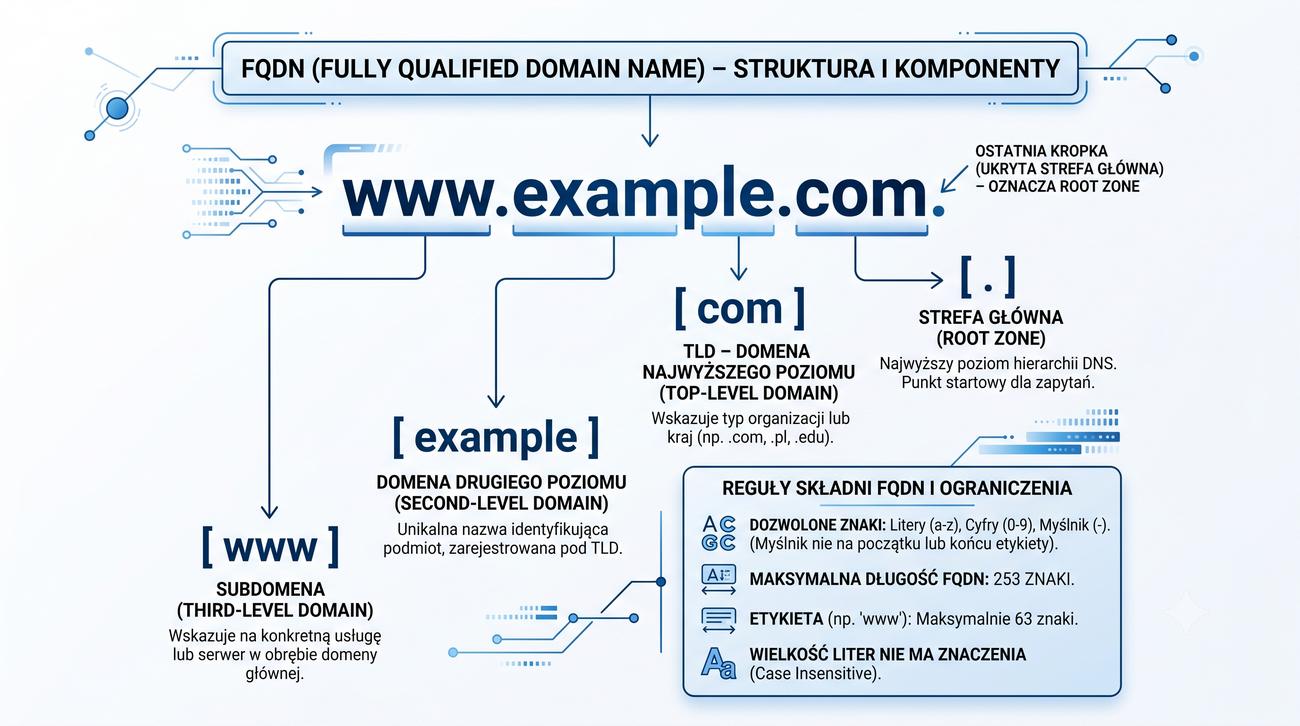
FQDN – Fully Qualified Domain Name

FQDN (Fully Qualified Domain Name) to pełna, jednoznaczna nazwa domenowa określająca dokładne położenie hosta w hierarchii DNS.
  • Przykład: www.example.com. – każda część oddzielona kropką reprezentuje inny poziom hierarchii
  • Maksymalna długość FQDN: 253 znaki ASCII
  • Pojedyncza etykieta: maksymalnie 63 znaki
  • Dozwolone znaki: litery, cyfry i myślnik (nie może zaczynać ani kończyć się myślnikiem)

Pełna kwalifikowana nazwa domenowa FQDN musi być jednoznaczna w skali całego Internetu. Jej budowa podlega ścisłym regułom określonym w RFC 1035. Każda etykieta (część nazwy między kropkami) może zawierać wyłącznie litery alfabetu angielskiego, cyfry oraz znak myślnika, przy czym myślnik nie może występować na początku ani na końcu etykiety. Wielkość liter nie ma znaczenia – przykład www.Example.Com jest równoważny www.example.com.

Końcowa kropka w FQDN (np. www.example.com.) oznacza tak zwaną strefę główną (root) i jest często pomijana w codziennym użyciu, ale ma kluczowe znaczenie w konfiguracji serwerów DNS i plików stref. Bez tej kropki nazwa może być interpretowana jako względna, a nie absolutna, co prowadzi do błędów w rozwiązywaniu nazw.

W praktyce inżynierskiej ograniczenie do 253 znaków dla całego FQDN rzadko stanowi problem, ale ograniczenie do 63 znaków dla pojedynczej etykiety może być istotne przy długich nazwach hostów. W systemach Microsoft Active Directory obowiązują dodatkowe restrykcje – nazwy domenowe nie powinny przekraczać 15 znaków dla zgodności z protokołem NetBIOS.

19/55 Rekordy DNS

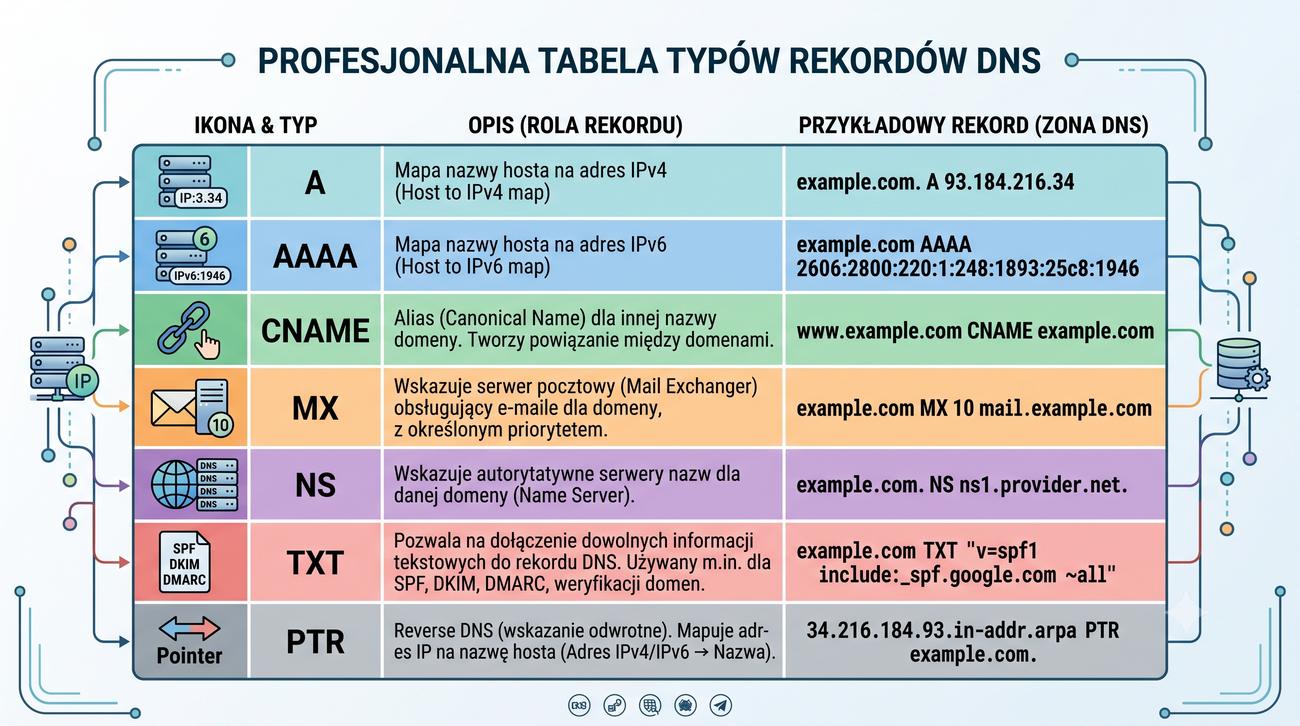
Typy rekordów DNS – A, AAAA, CNAME, MX, NS, TXT, PTR

Rekordy DNS to wpisy w strefie domeny określające mapowanie nazw na adresy IP i inne zasoby.
  • A – mapuje nazwę na adres IPv4
  • AAAA – mapuje nazwę na adres IPv6
  • CNAME – tworzy alias (www.example.com → example.com)
  • MX – określa serwer poczty dla domeny z priorytetem
  • NS – określa autorytatywne serwery DNS dla strefy
  • TXT – przechowuje dowolny tekst (SPF, DKIM, DMARC)
  • PTR – odwrotne mapowanie adresu IP na nazwę (reverse DNS)

Rekordy DNS stanowią serce całego systemu – to właśnie one przechowują rzeczywiste mapowania między nazwami a adresami IP oraz innymi zasobami. Każdy rekord ma określony czas życia TTL (Time To Live), który decyduje o tym, jak długo może być przechowywany w pamięci podręcznej resolverów. Dobór odpowiedniej wartości TTL jest sztuką kompromisu: krótki TTL pozwala szybko wprowadzać zmiany, ale zwiększa obciążenie serwerów; długi TTL odciąża serwery, ale opóźnia propagację zmian.

Rekord MX (Mail Exchange) ma szczególną strukturę – oprócz nazwy serwera poczty zawiera również priorytet (preferencję). Niższa wartość priorytetu oznacza wyższe pierwszeństwo. Dzięki temu administrator może skonfigurować podstawowy serwer poczty z priorytetem 10 i zapasowy z priorytetem 20 – w razie awarii podstawowego serwera poczta będzie dostarczana przez serwer zapasowy.

Rekordy TXT zyskały ogromne znaczenie w ostatnich latach wraz z rozwojem mechanizmów bezpieczeństwa poczty elektronicznej. To właśnie w rekordach TXT przechowuje się wpisy SPF określające, które serwery mogą wysyłać pocztę w imieniu domeny, DKIM zawierające klucz publiczny do weryfikacji podpisów wiadomości oraz DMARC definiujący politykę postępowania z wiadomościami, które nie przeszły weryfikacji.

20/55 DNS – zapytanie iteracyjne vs rekurencyjne

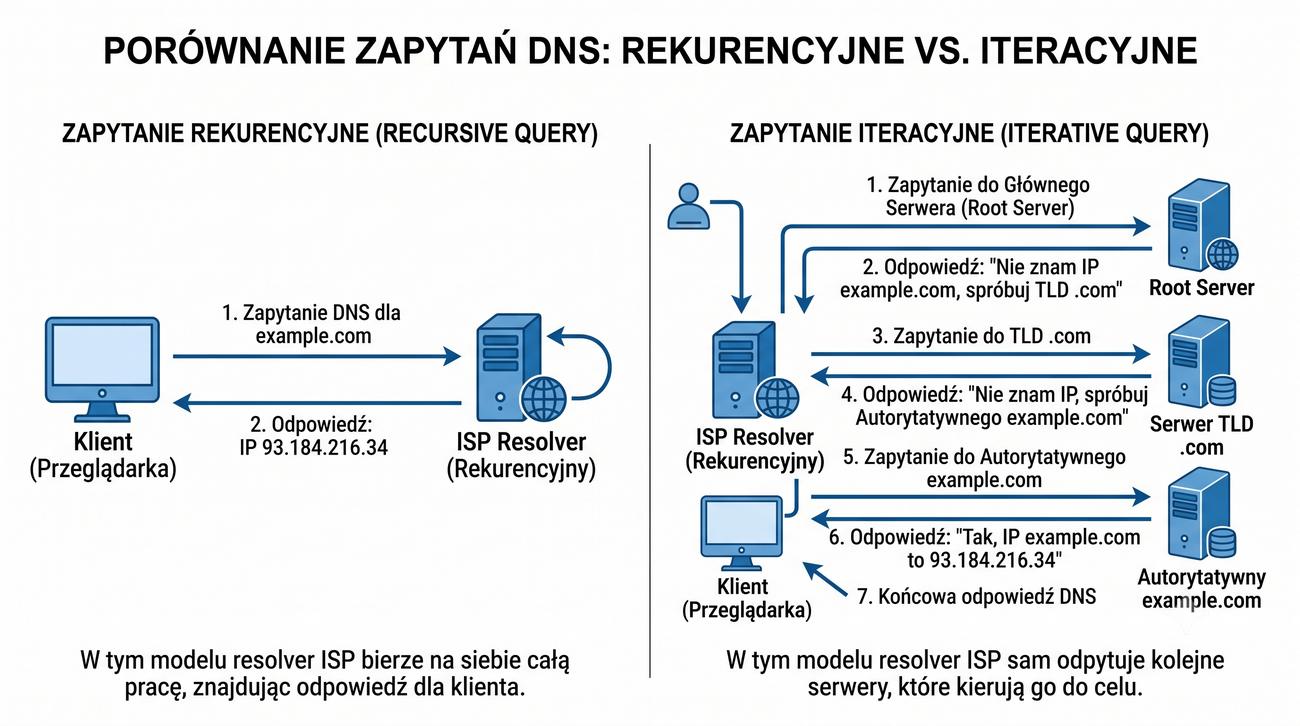
Zapytania DNS – rekurencyjne a iteracyjne

Rekurencyjne: resolver oczekuje pełnej odpowiedzi – jeśli serwer nie zna, sam znajduje przez zadawanie pytań innym serwerom.

Iteracyjne: serwer odpowiada najlepszą znaną odpowiedzią lub wskazuje inny serwer. Serwer główny kieruje do TLD, a TLD do autorytatywnego serwera.

Różnica między zapytaniem rekurencyjnym a iteracyjnym wynika przede wszystkim z tego, kto ponosi odpowiedzialność za znalezienie ostatecznej odpowiedzi. W modelu rekurencyjnym resolver (np. serwer DNS dostawcy Internetu) bierze na siebie pełną odpowiedzialność i samodzielnie przemierza hierarchię DNS, zadając kolejne pytania serwerom głównym, serwerom TLD i wreszcie autorytatywnemu serwerowi docelowej domeny.

Model iteracyjny jest znacznie lżejszy dla serwerów – każdy z nich odpowiada wyłącznie na podstawie własnej wiedzy i odsyła klienta do następnego, bardziej właściwego serwera. Serwery główne nie przechowują informacji o poszczególnych domenach – ich jedynym zadaniem jest wskazanie, który serwer odpowiada za dane rozszerzenie (TLD). Podobnie serwery TLD nie znają adresów IP poszczególnych hostów – wiedzą tylko, które serwery są autorytatywne dla danej domeny drugiego poziomu.

W praktyce większość zapytań DNS ma charakter mieszany. Lokalny klient (przeglądarka, system operacyjny) wysyła zapytanie rekurencyjne do swojego resolvera, a ten z kolei wykonuje serię zapytań iteracyjnych do kolejnych serwerów w hierarchii. Takie rozwiązanie optymalizuje ruch sieciowy i skraca czas odpowiedzi dla użytkownika końcowego.

21/55 DNS Cache – buforowanie

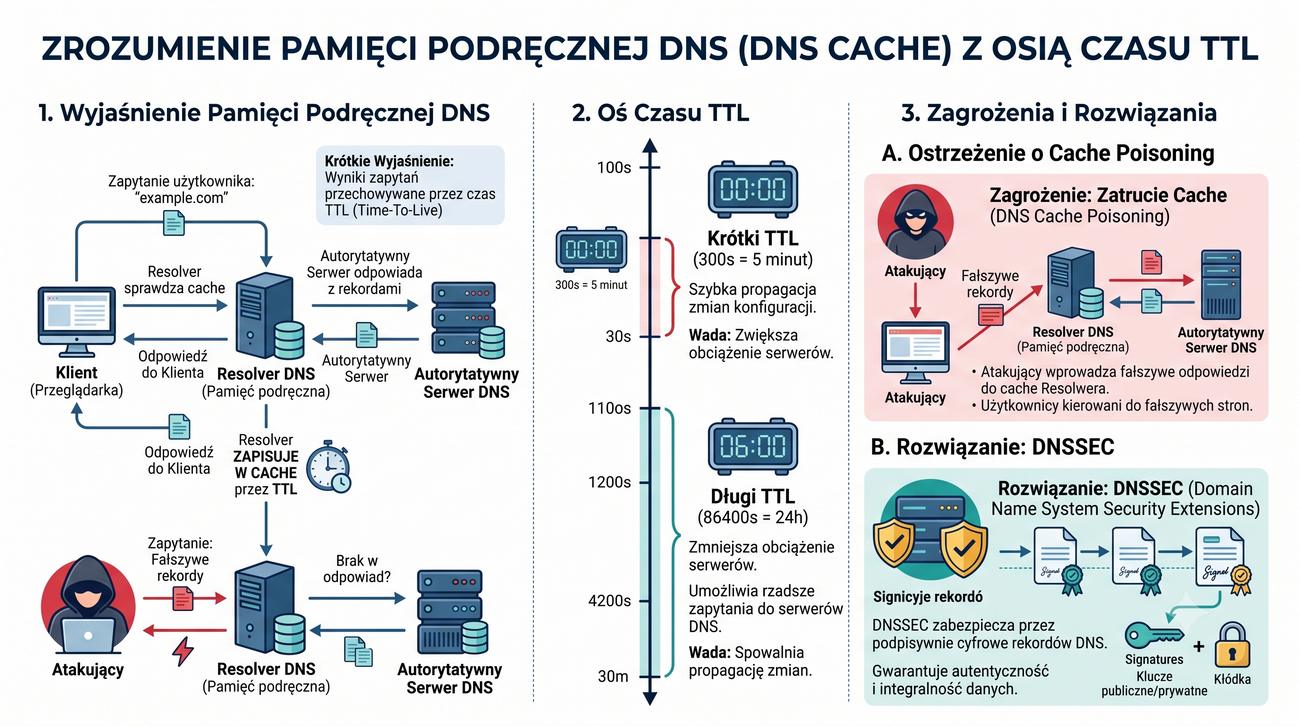
DNS Cache – przyspieszenie przez buforowanie pamięci podręcznej

Dzięki cache kolejne zapytania do tej samej domeny są obsługiwane natychmiast z pamięci podręcznej.

TTL jest określany przez administratora domeny dla każdego rekordu DNS – krótki TTL przyspiesza propagację zmian, długi TTL zmniejsza obciążenie serwerów.

Buforowanie DNS to jeden z najważniejszych mechanizmów optymalizacyjnych w całym Internecie. Gdy resolver otrzymuje odpowiedź na zapytanie DNS, przechowuje ją w pamięci podręcznej przez czas określony w polu TTL rekordu. Dzięki temu kolejne zapytania o tę samą domenę są obsługiwane natychmiast, bez konieczności ponownego przemierzania całej hierarchii DNS – co radykalnie skraca czas ładowania stron WWW i zmniejsza obciążenie serwerów.

Wartość TTL jest ustalana przez administratora domeny indywidualnie dla każdego rekordu. Pole MINIMUM rekordu SOA (Start of Authority) określa domyślny czas buforowania odpowiedzi negatywnych (NXDOMAIN). Typowe wartości TTL to 300–86400 sekund (5 minut – 24 godziny). Przy planowanej zmianie adresu IP serwera administrator może celowo obniżyć TTL na kilka dni przed zmianą, aby przyspieszyć propagację nowego adresu, a po zmianie przywrócić wyższą wartość.

Czyszczenie pamięci podręcznej DNS to częsta czynność diagnostyczna. W systemie Windows używa się polecenia ipconfig /flushdns, w systemach Linux komendy resolvectl flush-caches lub restartu usługi systemctl restart systemd-resolved. Na routerach MikroTik czyszczenie cache wykonuje się poleceniem /ip dns cache flush, a na przełącznikach Cisco – clear host *.

22/55 DNS – sekwencja zapytania

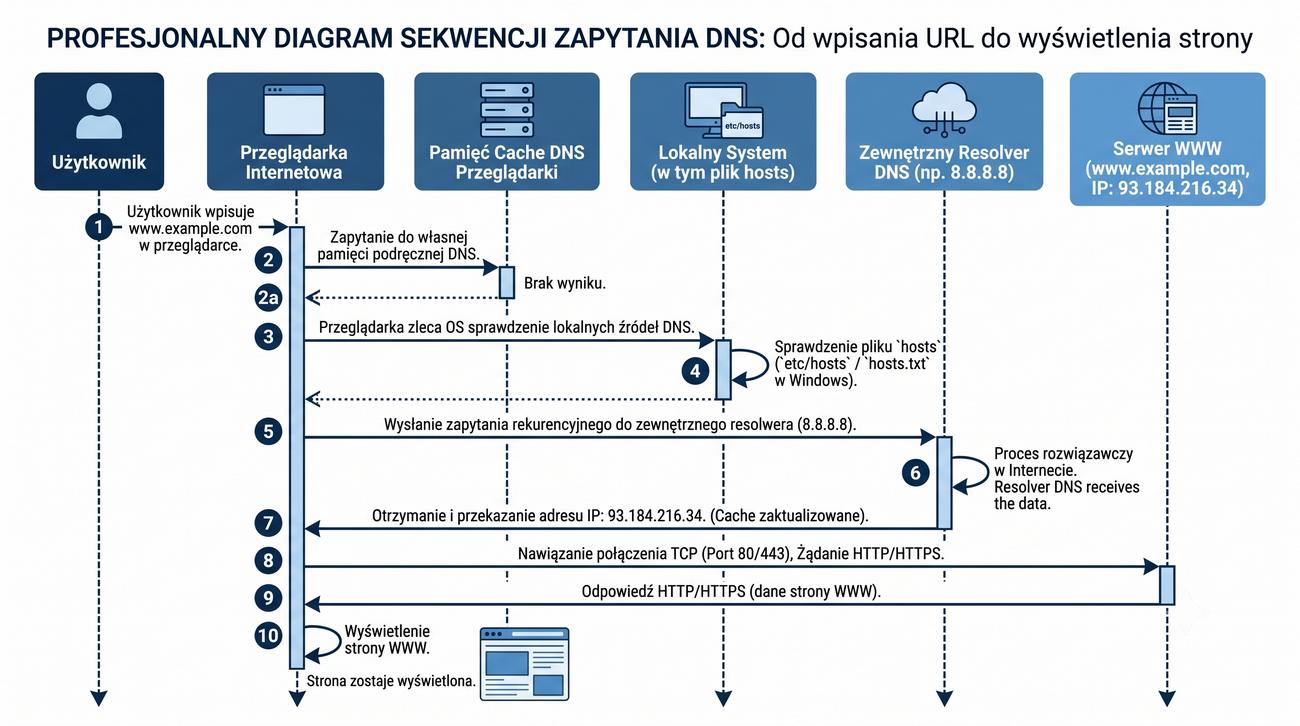
Sekwencja zapytania DNS – od adresu w przeglądarce do odpowiedzi

  • 1. Cache przeglądarki – sprawdza własny cache DNS
  • 2. Plik hosts – sprawdza lokalny plik mapowania nazw
  • 3. Lokalny resolver – sprawdza cache systemowy
  • 4. Serwer ISP – zapytanie rekurencyjne do serwera dostawcy Internetu

Gdy użytkownik wpisuje adres strony w przeglądarce, uruchamiana jest precyzyjnie zdefiniowana sekwencja rozwiązywania nazw DNS. Jako pierwszy sprawdzany jest lokalny cache przeglądarki – jeśli strona była odwiedzana niedawno, odpowiedź jest natychmiastowa i żadne zapytanie sieciowe nie jest wysyłane. Drugim krokiem jest plik hosts, który ma absolutne pierwszeństwo przed jakimkolwiek serwerem DNS – administrator może w nim zdefiniować lokalne mapowania nazw na adresy IP, co jest przydatne w środowiskach testowych i laboratoryjnych.

Dopiero gdy oba lokalne źródła zawodzą, system operacyjny wysyła zapytanie do skonfigurowanego resolvera DNS. W sieciach korporacyjnych jest to najczęściej wewnętrzny serwer DNS domeny Active Directory, a w sieciach domowych – serwer dostawcy Internetu. Lokalny resolver również posiada własną pamięć podręczną, dlatego pierwsze zapytanie do nowej domeny jest najwolniejsze, a kolejne – błyskawiczne.

Ważnym aspektem tej sekwencji jest fakt, że każdy etap może zakończyć proces sukcesem, co skraca czas odpowiedzi. Jeśli na przykład żądany adres znajduje się w pliku hosts, zapytanie nigdy nie opuszcza komputera użytkownika. Ta hierarchiczna kontrola priorytetów pozwala na elastyczne zarządzanie rozwiązywaniem nazw – od lokalnych wyjątków, przez cache systemowy, aż po globalną infrastrukturę DNS.

23/55 DNS – narzędzia diagnostyczne

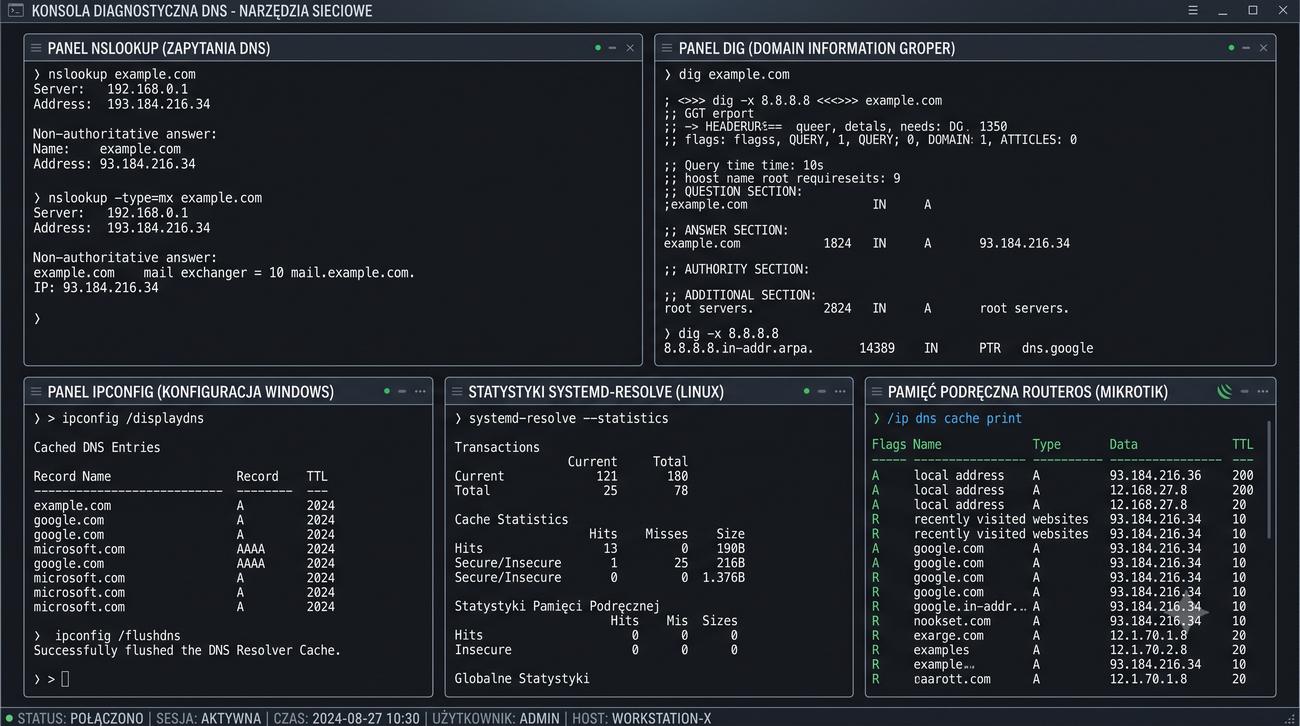
Narzędzia diagnostyczne DNS – nslookup, dig, ipconfig

  • nslookup – podstawowe narzędzie do sprawdzania adresów IP i rekordów MX
  • dig (Domain Information Groper) – zaawansowane narzędzie ze szczegółowymi informacjami o zapytaniu
  • ipconfig /displaydns – wyświetla lokalny cache DNS w systemie Windows
  • ipconfig /flushdns – czyści cache DNS

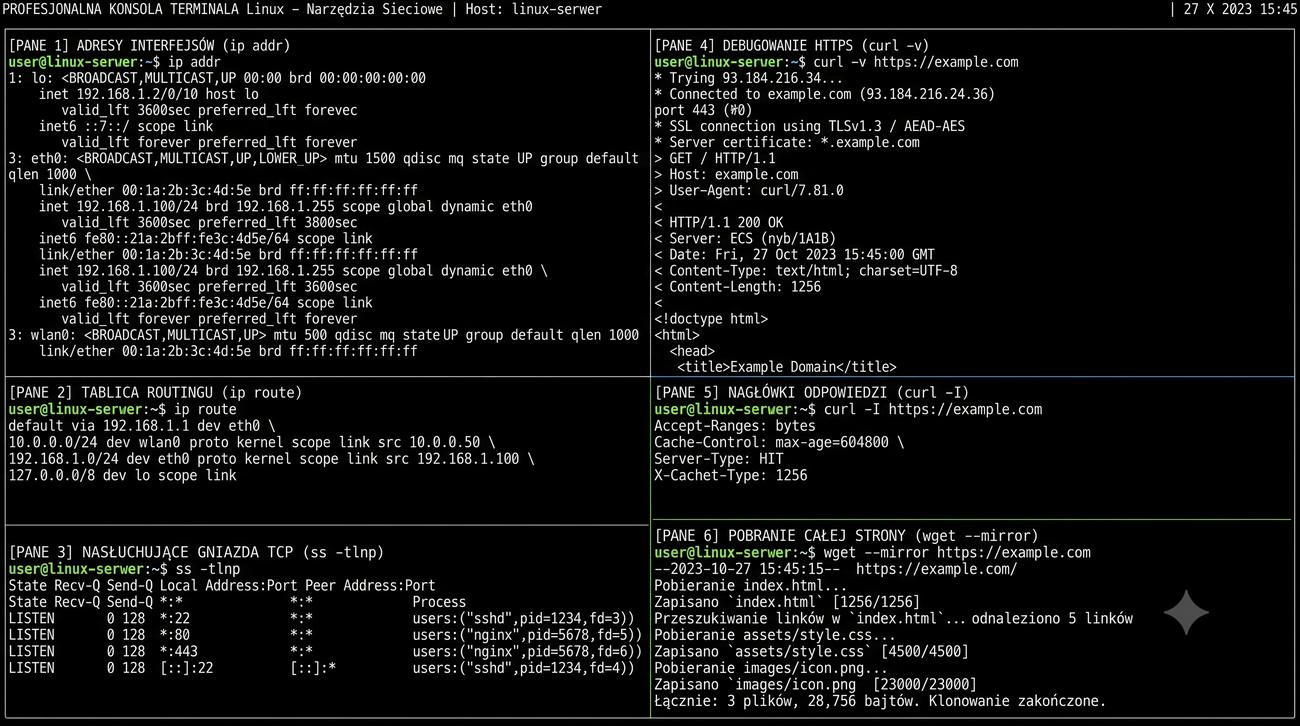
Narzędzie nslookup jest dostępne domyślnie w systemach Windows, Linux i macOS i stanowi podstawowe narzędzie diagnostyczne DNS. Uruchomione bez argumentów przechodzi w tryb interaktywny, w którym można kolejno sprawdzać różne typy rekordów. Komenda set type=MX pozwala na przykład odpytać serwer DNS o rekordy pocztowe dla danej domeny. Z kolei dig (Domain Information Groper) oferuje znacznie bardziej szczegółowe informacje, w tym czas odpowiedzi, identyfikator zapytania oraz flagi nagłówka. Dzięki dig administrator może precyzyjnie prześledzić całą ścieżkę rozwiązywania nazw od serwera lokalnego po autorytatywny.

W systemie Windows polecenia ipconfig /displaydns oraz ipconfig /flushdns umożliwiają odpowiednio podgląd i czyszczenie lokalnego cache DNS. Jest to szczególnie przydatne podczas testowania zmian w konfiguracji DNS, gdy stara odpowiedź mogła zostać zapamiętana w pamięci podręcznej. W systemach Linux cache DNS jest zarządzany przez usługę systemd-resolved lub lokalny resolver, a jego czyszczenie wykonuje się poleceniem resolvectl flush-caches lub przez restart usługi. Narzędzia te pozwalają również na diagnostykę problemów z rozwiązywaniem odwrotnym (PTR), czyli sprawdzeniem, jaka nazwa domenowa odpowiada danemu adresowi IP.

24/55 DNS – konfiguracja w RouterOS

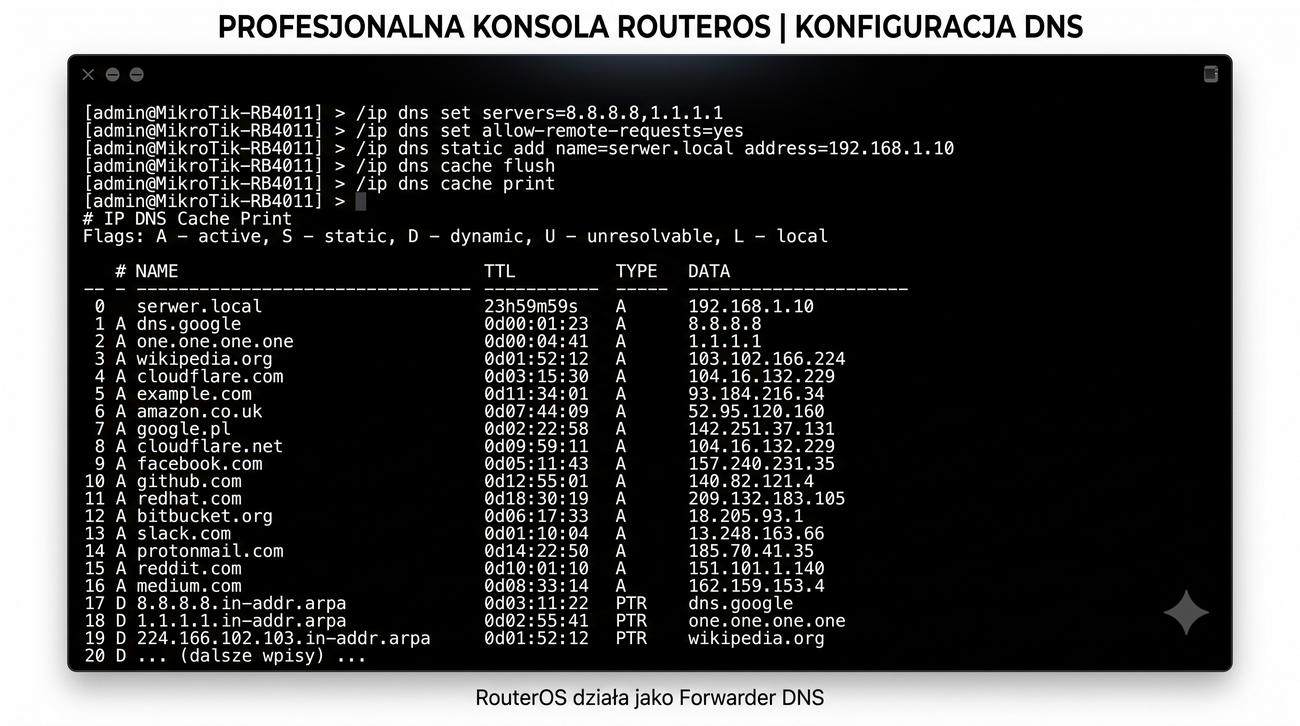
Konfiguracja DNS w RouterOS (MikroTik)

  • /ip dns set servers=8.8.8.8,1.1.1.1 – ustawia podstawowy i zapasowy serwer
  • /ip dns cache print – wyświetla zawartość cache
  • /ip dns cache flush – czyści cache
  • /ip dns static add name=serwer.local address=192.168.1.10 – statyczny wpis DNS

RouterOS firmy MikroTik oferuje elastyczny system buforowania DNS, który można skonfigurować zarówno jako prosty resolver dla sieci lokalnej, jak i zaawansowany serwer cache. Polecenie /ip dns set servers=8.8.8.8,1.1.1.1 definiuje zewnętrzne serwery DNS, do których router będzie kierował zapytania rekurencyjne. Warto zauważyć, że kolejność serwerów ma znaczenie – RouterOS wykorzystuje pierwszy serwer z listy, a do kolejnych przechodzi dopiero w razie braku odpowiedzi. Mechanizm cache DNS w MikroTiku znacząco przyspiesza odpowiedzi dla często odwiedzanych domen, redukując opóźnienia i ruch wychodzący.

Statyczne wpisy DNS konfigurowane komendą /ip dns static pozwalają na lokalne rozwiązywanie nazw bez konieczności korzystania z zewnętrznych serwerów. Jest to szczególnie przydatne w sieciach korporacyjnych, gdzie serwery wewnętrzne muszą być osiągalne pod stałymi nazwami. RouterOS umożliwia także konfigurację reguł DNS w firewallu, które mogą przekierowywać zapytania do określonych domen na alternatywne serwery. Dla zaawansowanych zastosowań dostępny jest również serwer DHCP, który automatycznie przekazuje klientom adresy serwerów DNS skonfigurowane w RouterOS.

25/55 DNS – konfiguracja w Cisco IOS

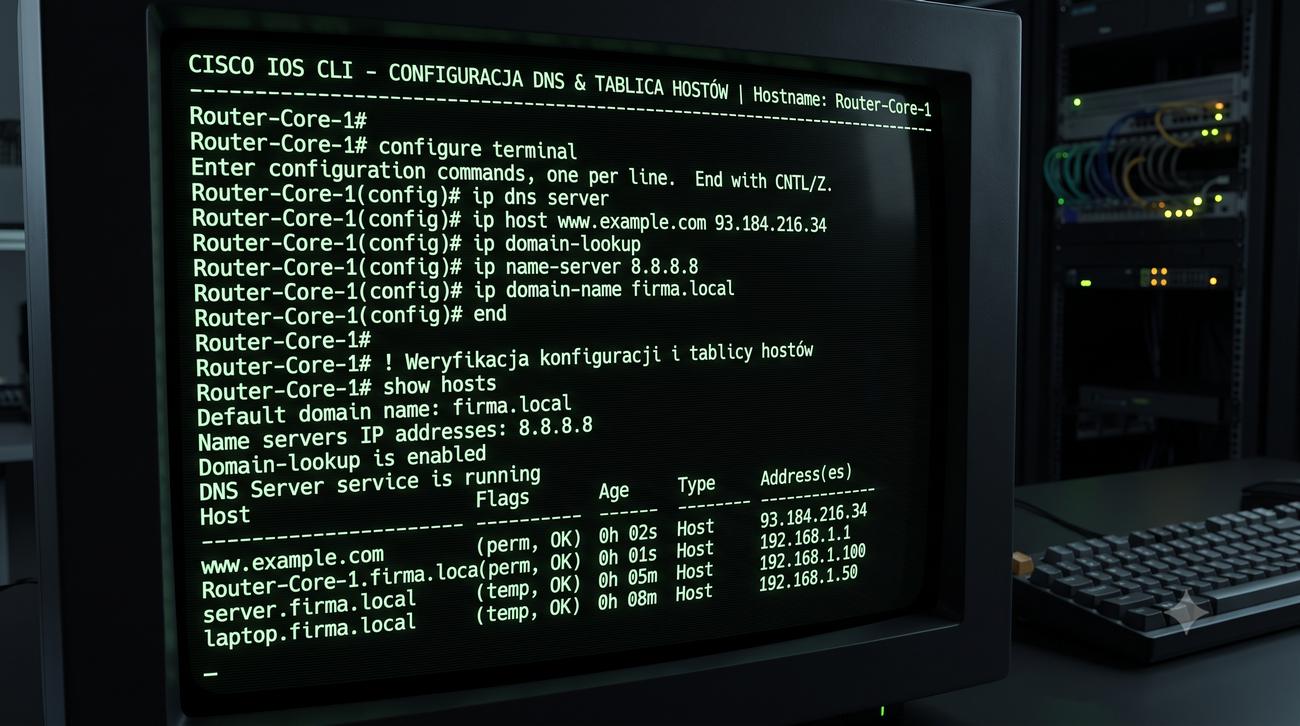
Konfiguracja DNS w Cisco IOS

  • ip dns server – włącza serwer DNS
  • ip host www.example.com 93.184.216.34 – statyczny wpis DNS
  • ip domain-lookup – włącza rozwiązywanie nazw DNS
  • ip name-server 8.8.8.8 – zewnętrzny serwer DNS

W systemie Cisco IOS mechanizm rozwiązywania nazw DNS może być skonfigurowany zarówno dla samego routera, jak i dla klientów sieci. Polecenie ip domain-lookup włącza zdolność routera do rozwiązywania nazw domenowych, co jest niezbędne przy używaniu nazw zamiast adresów IP w komendach takich jak ping czy telnet. Bez tej opcji router będzie próbował rozwiązać nazwę poprzez broadcast, co w większych sieciach jest nieskuteczne. Statyczne wpisy tworzone komendą ip host są przechowywane w pamięci NVRAM i przetrwają restart urządzenia.

Routery Cisco mogą również pełnić rolę serwera DNS dla sieci lokalnej po włączeniu usługi komendą ip dns server. W takiej konfiguracji router odpowiada na zapytania DNS od hostów w sieci lokalnej, wykorzystując własną tabelę statycznych wpisów oraz forwardując nieznane zapytania do zewnętrznych serwerów DNS. Do monitorowania działania DNS w Cisco IOS służy komenda debug ip dns, która wyświetla szczegółowe informacje o każdym zapytaniu i odpowiedzi. Diagnostykę rozwiązywania nazw ułatwiają również polecenia show hosts i show ip dns.

26/55 DNS – bezpieczeństwo (DNSSEC)

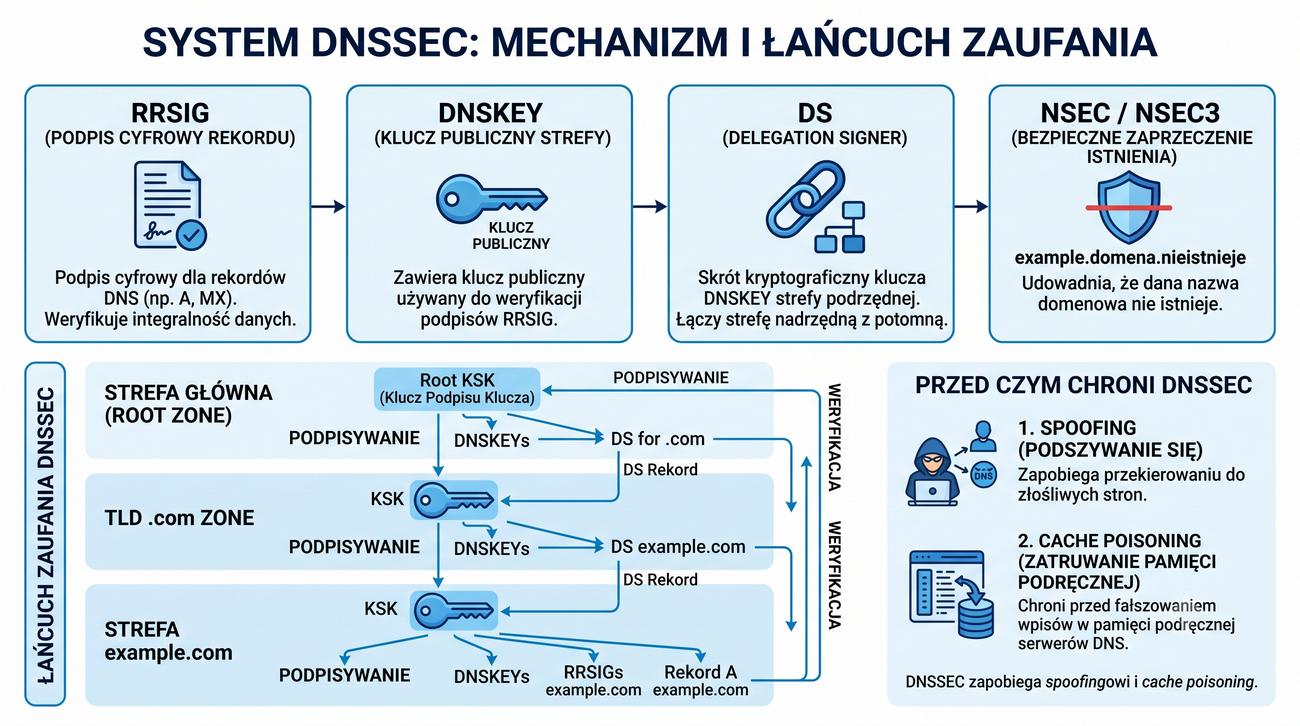
DNSSEC – DNS Security Extensions

DNSSEC (DNS Security Extensions) zapewnia autentyczność i integralność danych DNS przez podpisywanie cyfrowe rekordów.
  • RRSIG – podpis cyfrowy rekordu DNS
  • DNSKEY – klucz publiczny strefy
  • DS (Delegation Signer) – łączy strefę potomną z rodzicielską
  • NSEC/NSEC3 – określają nieistniejące nazwy w strefie

DNSSEC (DNS Security Extensions) został zaprojektowany, aby wyeliminować podstawową słabość protokołu DNS – brak weryfikacji autentyczności odpowiedzi. W klasycznym DNS atakujący może podszyć się pod serwer DNS i wysłać fałszywą odpowiedź (DNS spoofing), przekierowując użytkownika na złośliwą stronę. DNSSEC rozwiązuje ten problem poprzez wprowadzenie podpisu cyfrowego dla każdego rekordu DNS, który jest weryfikowany przy użyciu klucza publicznego strefy. Podstawą działania DNSSEC jest łańcuch zaufania (chain of trust), który rozpoczyna się od serwerów głównych i poprzez kolejne strefy prowadzi do konkretnego rekordu.

Rekordy RRSIG zawierają podpis cyfrowy rekordu, a DNSKEY przechowuje klucz publiczny strefy potrzebny do jego weryfikacji. Rekord DS (Delegation Signer) łączy strefę potomną z rodzicielską, tworząc nieprzerwany łańcuch zaufania od roota w dół. Rekordy NSEC i NSEC3 poświadczają, że określone nazwy nie istnieją w strefie; rekord NSEC3 dodatkowo haszuje nazwy, utrudniając tzw. zone walking (enumerację zawartości strefy). Wdrożenie DNSSEC wymaga współpracy rejestratora domeny, operatora serwerów DNS oraz administratora, ale znacząco podnosi poziom bezpieczeństwa całego systemu DNS.

27/55 DNS – ataki i zagrożenia

DNS Spoofing, Tunneling i DDoS – główne zagrożenia DNS

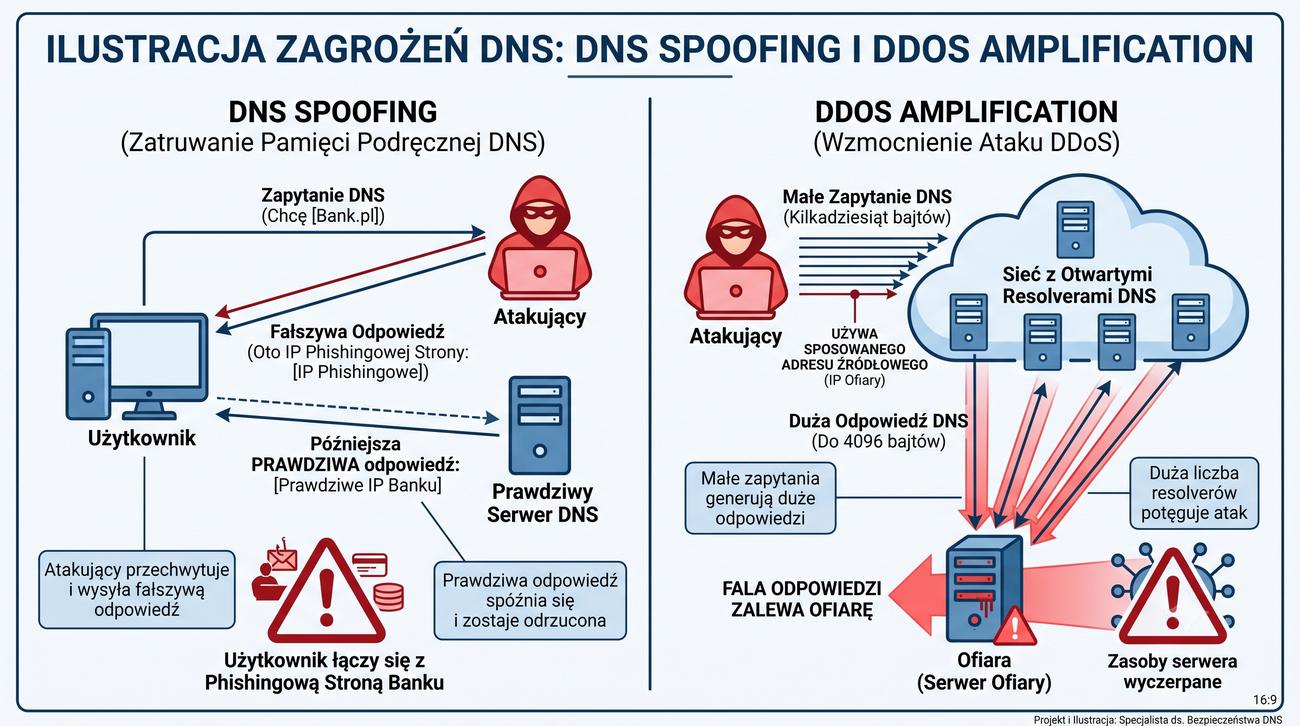
  • DNS Spoofing – wysłanie fałszywej odpowiedzi przekierowującej na złośliwą stronę
  • DNS Tunneling – ukrywanie danych w zapytaniach DNS do obchodzenia firewalli
  • DDoS Amplification – wykorzystanie otwartych resolverów do wzmocnienia ataku (zapytanie → duża odpowiedź)

DNS spoofing (zwany również DNS cache poisoning) polega na wprowadzeniu fałszywych informacji do pamięci podręcznej resolvera DNS. Atakujący wysyła do resolvera spreparowaną odpowiedź DNS, która jest szybsza niż odpowiedź od prawdziwego serwera autorytatywnego. W rezultacie resolver zapamiętuje fałszywe mapowanie nazwy na adres IP i przekazuje je wszystkim klientom, którzy o tę nazwę zapytają. Ten typ ataku może być wykorzystany do przekierowania użytkowników bankowości internetowej na strony phishingowe bez ich wiedzy. Zabezpieczeniem przed DNS spoofingiem jest stosowanie DNSSEC oraz randomizacja portów źródłowych i identyfikatorów zapytań (TXID).

DNS tunneling to technika polegająca na enkapsulacji danych innych protokołów w pakietach DNS. Ponieważ ruch DNS jest zazwyczaj przepuszczany przez firewalle bez restrykcyjnej kontroli, atakujący mogą wykorzystać go do ominięcia zabezpieczeń i nawiązania komunikacji z zewnętrznym serwerem. Z kolei DDoS amplification wykorzystuje otwarte resolvery DNS do wzmocnienia ataku – małe zapytanie może wygenerować odpowiedź o rozmiarze kilku kilobajtów, co przy milionach zapytań prowadzi do przeciążenia ofiary. Ochrona przed tymi zagrożeniami wymaga blokowania otwartych resolverów, stosowania rate limitu oraz monitorowania nietypowego ruchu DNS w sieci.

28/55 DNS – domeny w Polsce

Domeny .pl – zarządzane przez NASK

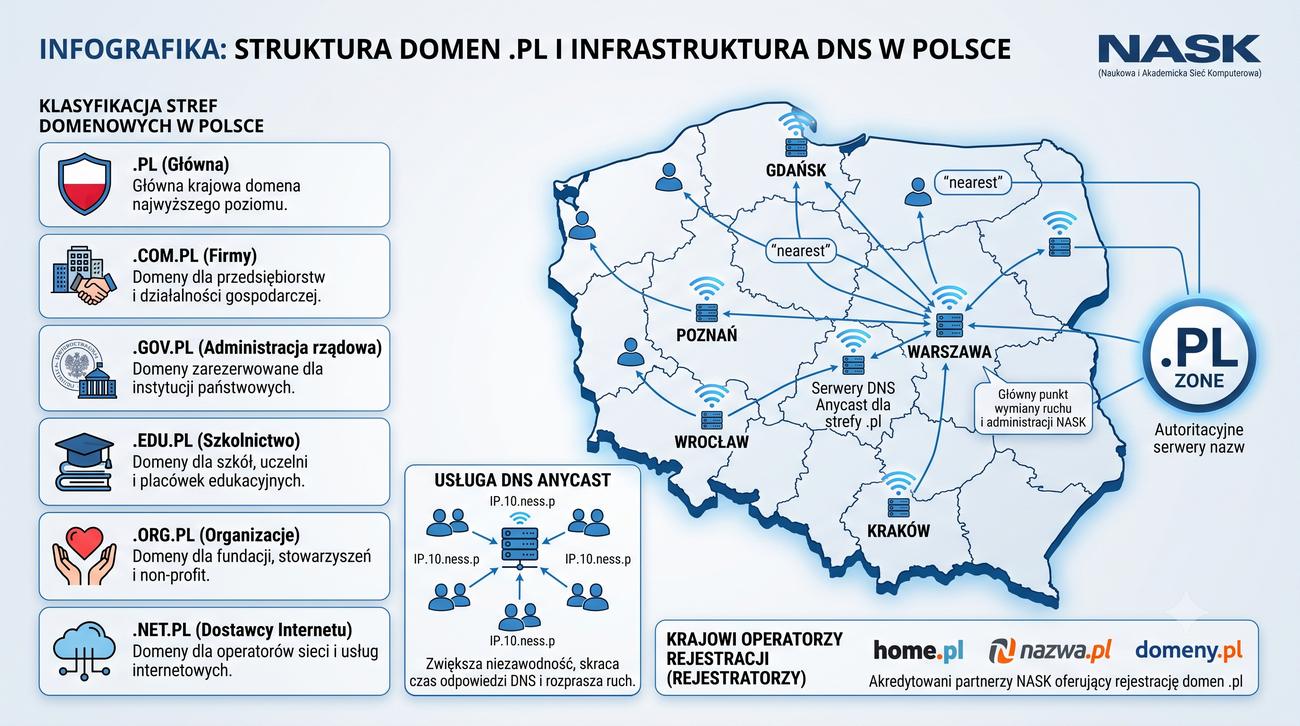
NASK pełni funkcję rejestru domeny krajowej .pl, utrzymuje serwery DNS dla strefy .pl i nadzoruje operatorów.

Rejestracja domen .pl jest możliwa przez operatorów takich jak home.pl, nazwa.pl.

Strefy domenowe: .pl, .com.pl, .gov.pl, .edu.pl, .org.pl, .net.pl – każda z innymi zasadami rejestracji.

Rejestr domeny krajowej .pl jest zarządzany przez NASK (Naukowa i Akademicka Sieć Komputerowa) – instytut badawczy działający pod nadzorem Ministra Cyfryzacji. NASK odpowiada nie tylko za prowadzenie rejestru domen .pl, ale także za utrzymanie infrastruktury autorytatywnych serwerów DNS dla strefy .pl, które są rozlokowane w różnych lokalizacjach w kraju i za granicą. System EWA umożliwia automatyzację rejestracji i zarządzania domenami poprzez protokół EPP (Extensible Provisioning Protocol). Rejestracja domeny .pl wymaga przejścia weryfikacji tożsamości i może być dokonana wyłącznie przez autoryzowanych operatorów.

Poszczególne strefy domenowe w Polsce mają różne zasady rejestracji: domeny .gov.pl są zarezerwowane dla instytucji rządowych, .edu.pl dla szkół i uczelni, a .mil.pl dla wojska. Domeny komercyjne mogą być rejestrowane w strefach .pl, .com.pl, .biz.pl i innych. NASK zapewnia również dodatkowe usługi bezpieczeństwa, takie jak DNSSEC dla strefy .pl oraz usługę .pl Registry Lock, która w głównym rejestrze blokuje nieautoryzowane zmiany danych domeny. Informacje o zarejestrowanych domenach można uzyskać przez bazę WHOIS (serwer whois.dns.pl) oraz protokół RDAP. Dla administratorów sieci w Polsce istotna jest znajomość adresów autorytatywnych serwerów DNS strefy .pl, a także możliwość sprawdzenia delegacji i rekordów DNSSEC wybranych domen.

29/55 Plik hosts – lokalne rozwiązywanie nazw

Plik hosts – lokalne rozwiązywanie nazw (pierwszeństwo przed DNS)

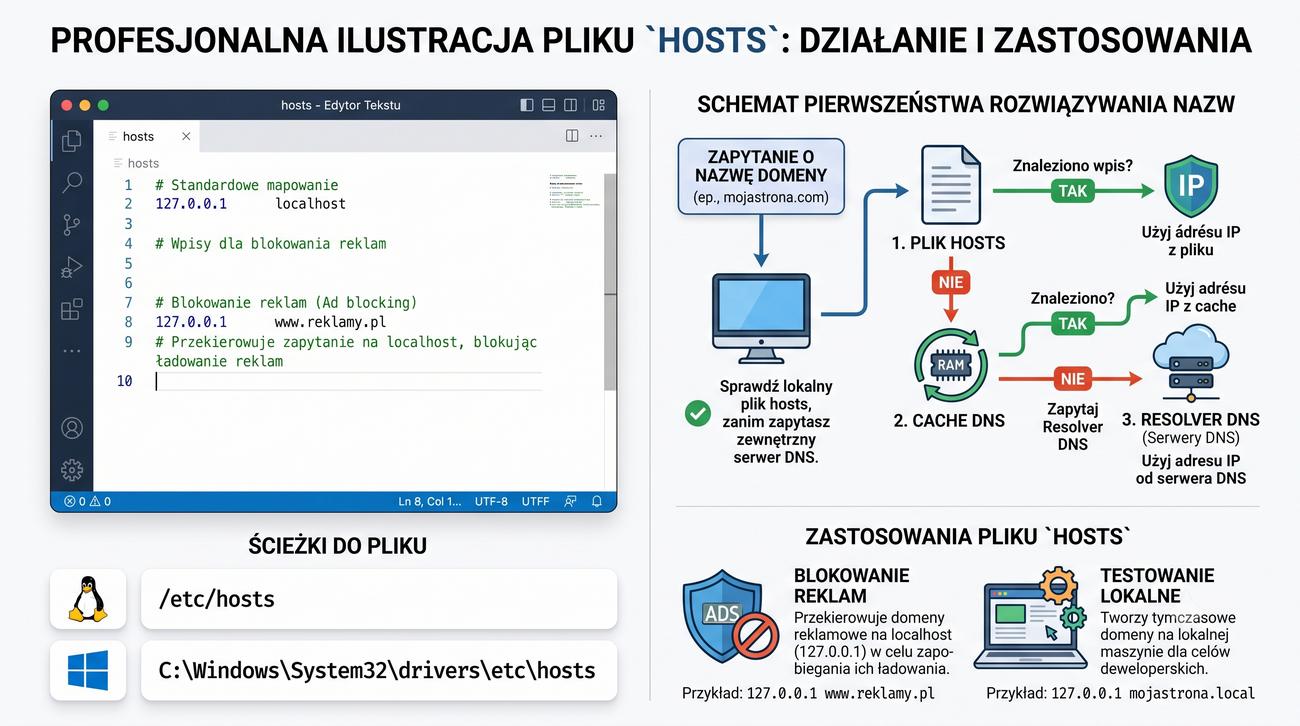
  • Windows: C:\Windows\System32\drivers\etc\hosts
  • Linux: /etc/hosts
  • Plik hosts ma pierwszeństwo przed DNS

Plik hosts jest jednym z najstarszych mechanizmów rozwiązywania nazw w sieciach IP, sięgającym czasów ARPANET. Mimo że współcześnie dominującą rolę odgrywa DNS, plik hosts wciąż ma pierwszeństwo przed zapytaniami DNS w większości systemów operacyjnych. Oznacza to, że administrator może ręcznie zdefiniować mapowanie nazwy na adres IP w pliku hosts, a system nie będzie wysyłał zapytania DNS dla tej nazwy. Jest to szczególnie przydatne w sytuacjach awaryjnych, gdy serwer DNS jest niedostępny, lub podczas testowania nowej strony internetowej przed zmianą rekordu DNS w domenie.

W administracji sieciowej plik hosts znajduje zastosowanie przy blokowaniu reklam i złośliwych domen poprzez przekierowanie ich na adres 127.0.0.1 (localhost). Istnieją gotowe listy takich wpisów, które można automatycznie dodać do pliku hosts. W środowiskach korporacyjnych plik hosts bywa wykorzystywany do wymuszenia korzystania z wewnętrznych serwerów aplikacji zamiast publicznych. Należy jednak pamiętać, że edycja pliku hosts wymaga uprawnień administracyjnych, a jego struktura jest prosta – każda linia zawiera adres IP, spację i przypisaną do niego nazwę domenową, a komentarz oznacza się znakiem #.

30/55 Podsumowanie bloku II – DNS

Blok II – podsumowanie: DNS w pigułce

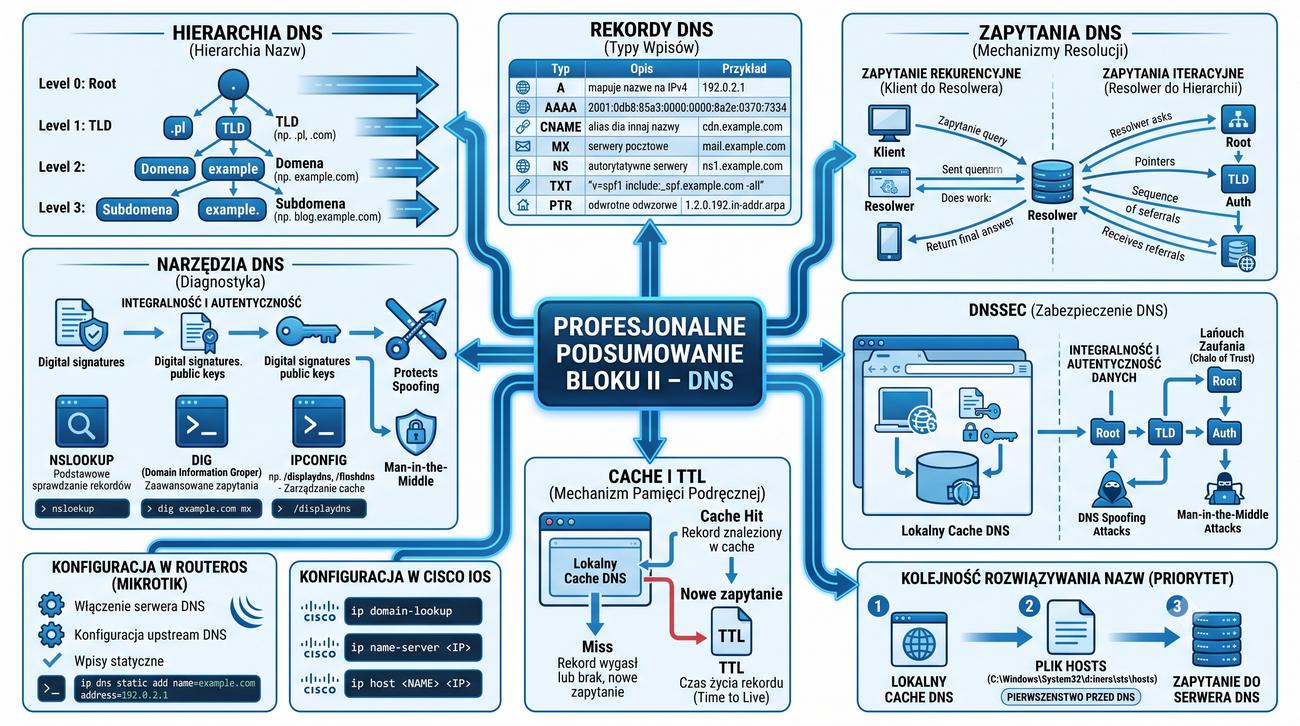
  • Hierarchia: root, TLD, domena drugiego poziomu, subdomena
  • Rekordy: A (IPv4), AAAA (IPv6), CNAME, MX, NS, TXT, PTR
  • Zapytania: rekurencyjne (pełna odpowiedź) i iteracyjne (odsyłanie do innego serwera)
  • DNSSEC: bezpieczeństwo przez podpisywanie rekordów
  • Narzędzia: nslookup, dig, ipconfig
  • Konfiguracja: w RouterOS i Cisco IOS

System DNS stanowi jeden z najważniejszych elementów infrastruktury internetowej, bez którego korzystanie z sieci w obecnej formie nie byłoby możliwe. Jego hierarchiczna struktura, z serwerami głównymi na szczycie i autorytatywnymi serwerami na niższych poziomach, zapewnia skalowalność i odporność na awarie. Zrozumienie różnicy między zapytaniami rekurencyjnymi a iteracyjnymi jest kluczowe dla skutecznej diagnostyki problemów sieciowych. W praktyce większość resolverów działających w sieciach lokalnych pracuje w trybie rekurencyjnym, oczekując pełnej odpowiedzi od serwera DNS.

Bezpieczeństwo DNS, zapewniane przez DNSSEC, staje się standardem w nowoczesnych sieciach, jednak wciąż wiele domen nie jest podpisanych cyfrowo. Narzędzia takie jak dig i nslookup pozwalają administratorowi na weryfikację poprawności konfiguracji DNS i szybkie lokalizowanie usterek. W codziennej pracy administratora sieci umiejętność analizy odpowiedzi DNS, interpretacji kodów błędów (NXDOMAIN, SERVFAIL) oraz zarządzania cache DNS jest niezbędna do utrzymania ciągłości działania usług sieciowych. Warto również pamiętać o pliku hosts jako o prostym, ale skutecznym narzędziu do lokalnego rozwiązywania nazw, które może stanowić uzupełnienie lub tymczasowe zastępstwo dla DNS.

31/55 Problem – brak publicznych adresów IPv4

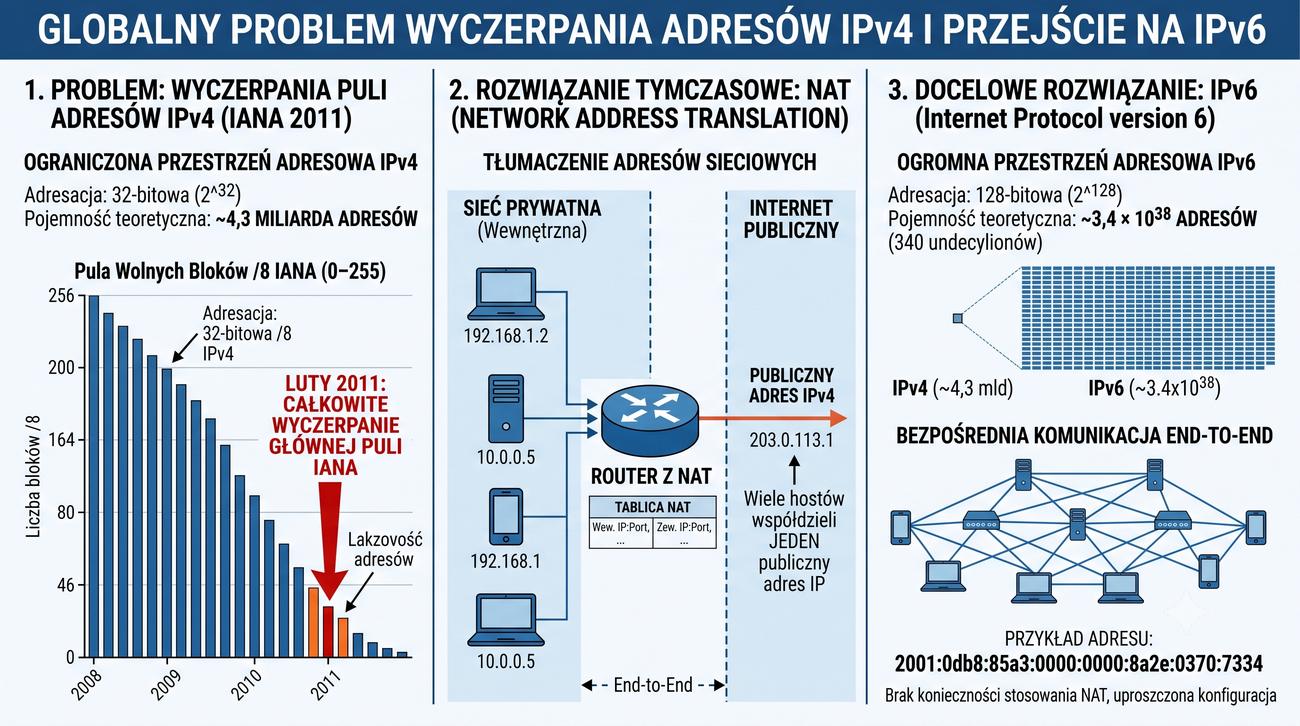
Wyczerpanie puli adresów IPv4 – 32-bitowy limit

Problem braku publicznych adresów IPv4 wynika z 32-bitowej budowy adresu, który umożliwia zaadresowanie maksymalnie 4,3 miliarda urządzeń.

Wyczerpanie puli adresów IPv4 nastąpiło w 2011 roku dla IANA.

Rozwiązaniem tymczasowym jest NAT, który umożliwia wielu hostom w sieci prywatnej współdzielenie jednego publicznego adresu IP.

Docelowym rozwiązaniem jest IPv6 z 128-bitową adresacją (3,4×10^38 adresów).

Adresacja IPv4 o długości 32 bitów pozwala teoretycznie na zaadresowanie 4 294 967 296 urządzeń, co w latach 80. XX wieku wydawało się liczbą niewyczerpalną. Jednak gwałtowny rozwój Internetu, upowszechnienie się smartfonów, laptopów i urządzeń IoT spowodowały, że pula dostępnych adresów wyczerpała się znacznie szybciej niż przewidywano. W lutym 2011 roku IANA przydzieliła ostatnie bloki adresów IPv4 regionalnym rejestrom internetowym (RIR). Europejski rejestr RIPE NCC wyczerpał swoją pulę adresów IPv4 we wrześniu 2012 roku, od tego czasu działając w trybie kolejkowym i przydzielając adresy tylko w uzasadnionych przypadkach.

Konsekwencje wyczerpania adresów IPv4 są odczuwalne do dziś – ceny adresów IPv4 na rynku wtórnym sięgają kilkudziesięciu dolarów za pojedynczy adres, a duże firmy technologiczne wykupują całe bloki adresów za miliony dolarów. Tymczasowym rozwiązaniem tego problemu stał się NAT, który pozwala wielu urządzeniom w sieci prywatnej współdzielić jeden publiczny adres IP. Długoterminowym rozwiązaniem jest migracja do IPv6, które oferuje 128-bitową przestrzeń adresową, wystarczającą dla każdego urządzenia na Ziemi. Mimo zalet IPv6, proces migracji postępuje wolno ze względu na koszty modernizacji infrastruktury sieciowej i konieczność zapewnienia kompatybilności z IPv4.

32/55 NAT – definicja i działanie

NAT – Network Address Translation (RFC 2663)

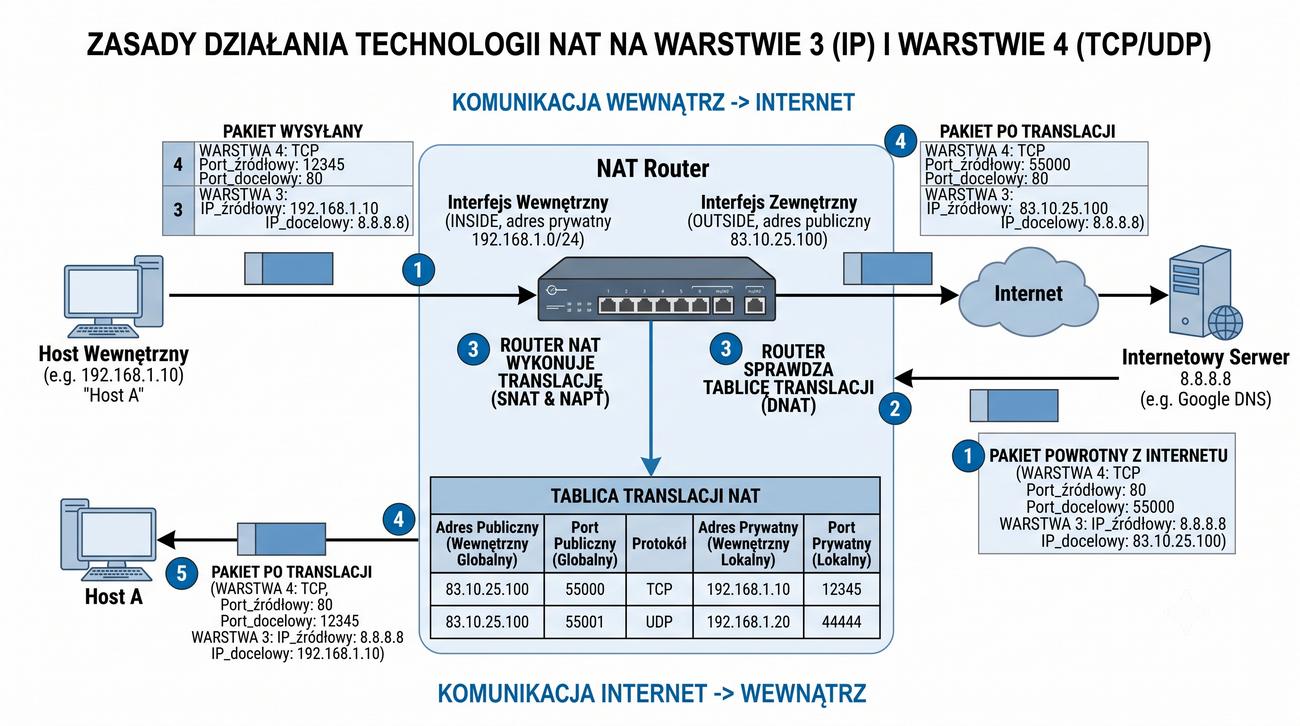
NAT (Network Address Translation) zdefiniowany w RFC 2663 to mechanizm translacji adresów IP prywatnych na publiczny adres IP i odwrotnie.

Gdy host wewnętrzny wysyła pakiet do Internetu, router zastępuje źródłowy adres prywatny swoim adresem publicznym.

Router NAT zapamiętuje każde połączenie w tablicy translacji, działając na warstwie 3 (IP) i 4 (TCP/UDP) modelu OSI.

NAT (Network Address Translation) zdefiniowany w RFC 2663 działa na routerze lub zaporze sieciowej, modyfikując nagłówki pakietów IP podczas ich transmisji między sieciami. Gdy host z sieci wewnętrznej o adresie prywatnym, np. 192.168.1.10, wysyła pakiet do Internetu, router NAT zastępuje źródłowy adres IP i port swoim adresem publicznym oraz unikalnym portem. Zmodyfikowany pakiet wędruje przez Internet, a odpowiedź zwrotna trafia na adres publiczny routera. Router, zaglądając do swojej tablicy translacji, odszukuje oryginalne parametry połączenia i przekazuje pakiet do właściwego hosta wewnętrznego. Cały proces jest przezroczysty dla hostów wewnętrznych i zewnętrznych.

NAT działa na styku warstwy 3 (sieciowej) i warstwy 4 (transportowej) modelu OSI, ponieważ modyfikuje zarówno adresy IP, jak i numery portów TCP/UDP. Router prowadzi tablicę translacji, w której każdy wpis zawiera parę Inside Local i Inside Global. Wpisy w tablicy mogą być statyczne lub dynamiczne – dynamiczne są usuwane po pewnym czasie bezczynności. Należy pamiętać, że NAT, choć powszechnie stosowany, jest rozwiązaniem tymczasowym – docelowo problem adresacji rozwiązuje IPv6.

33/55 Adresy prywatne RFC 1918

Adresy prywatne RFC 1918 – trzy zakresy

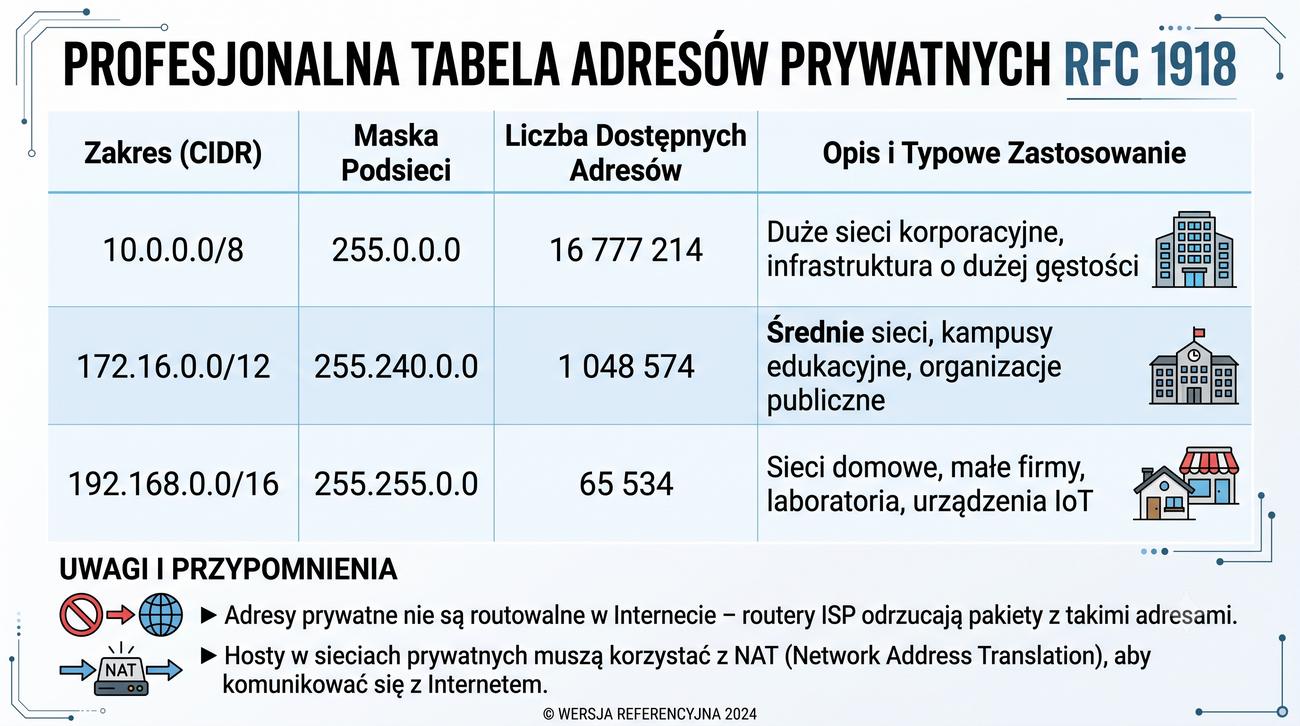
Adresy prywatne RFC 1918 to trzy zakresy adresów IP zarezerwowane do użytku w sieciach prywatnych, które nie są routowalne w Internecie.
  • 10.0.0.0/8 – ponad 16 milionów adresów IP dla dużych sieci korporacyjnych
  • 172.16.0.0/12 – około 1 miliona adresów IP dla średnich sieci
  • 192.168.0.0/16 – 65 tysięcy adresów IP dla małych sieci i domowych

Dokument RFC 1918 (Address Allocation for Private Internets) zdefiniował trzy zakresy adresów IP przeznaczonych wyłącznie do użytku w sieciach prywatnych. Adresy te nie są routowalne w publicznym Internecie – routery na styku z Internetem są skonfigurowane tak, aby odrzucać pakiety z takimi adresami źródłowymi lub docelowymi. Największy zakres 10.0.0.0/8 oferuje ponad 16 milionów adresów i jest wykorzystywany w dużych sieciach korporacyjnych. Zakres 172.16.0.0/12 (około 1 miliona adresów) jest często stosowany w sieciach średniej wielkości oraz w środowiskach chmurowych. Najpopularniejszy w sieciach domowych i małych firmach jest zakres 192.168.0.0/16, który standardowo wykorzystują routery domowe.

Wybór odpowiedniego zakresu adresów prywatnych ma znaczenie praktyczne – w małej sieci domowej zakres 192.168.0.0/24 jest w pełni wystarczający, ale w sieci korporacyjnej lepiej sprawdzi się 10.0.0.0/8 z odpowiednim podziałem na podsieci. Adresy prywatne są często mylone z adresami APIPA (169.254.x.x), które są automatycznie przydzielane przez system Windows, gdy serwer DHCP jest nieosiągalny. W przeciwieństwie do adresów RFC 1918, adresy APIPA nie są przeznaczone do stałej komunikacji, a jedynie do awaryjnej łączności w sieci lokalnej. Projektanci sieci powinni starannie planować adresację prywatną, uwzględniając możliwość przyszłej rozbudowy oraz konieczność łączenia sieci prywatnych za pomocą VPN.

34/55 NAT – typy: SNAT, DNAT, Masquerade

SNAT, DNAT i Masquerade – typy translacji NAT

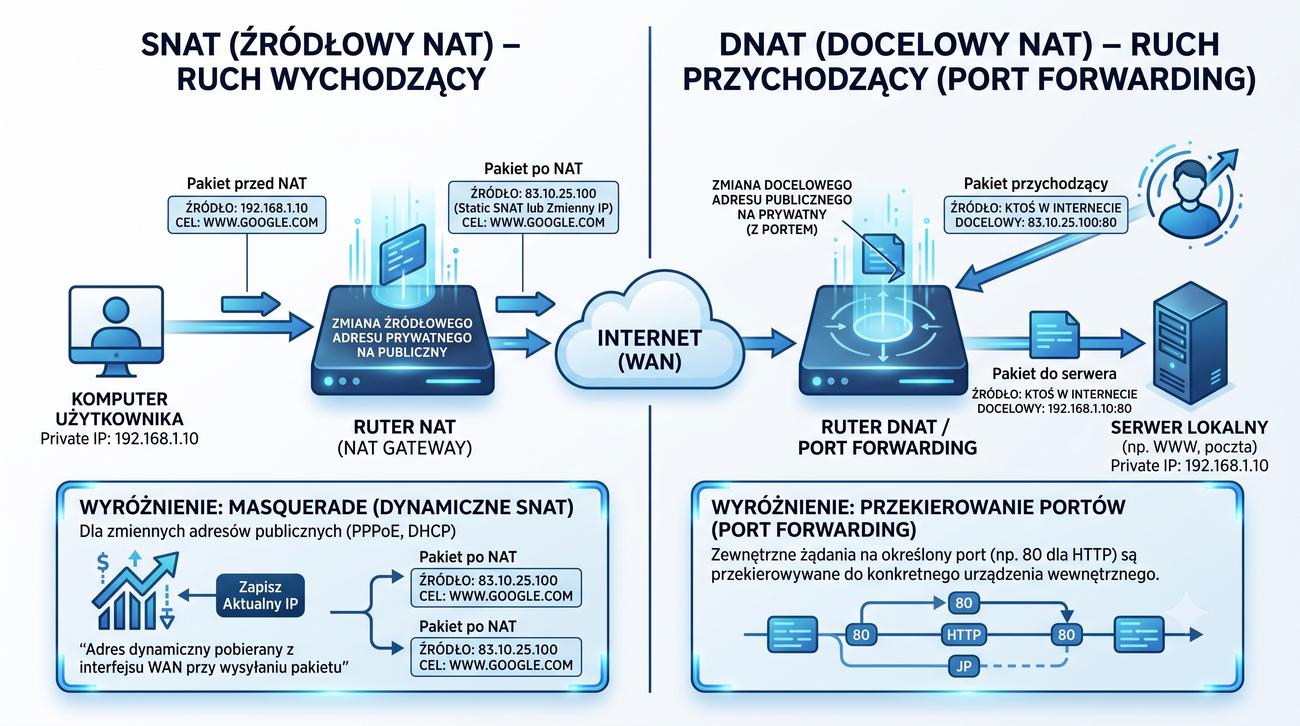
SNAT, DNAT i Masquerade to trzy podstawowe typy translacji NAT.
  • SNAT (Source NAT) – zmienia adres źródłowy pakietów wychodzących z sieci wewnętrznej do Internetu
  • DNAT (Destination NAT) – zmienia adres docelowy pakietów przychodzących z Internetu do sieci wewnętrznej
  • Masquerade – szczególny przypadek SNAT z dynamicznym adresem interfejsu (PPPoE, DHCP)

Rozróżnienie między SNAT a DNAT jest kluczowe dla zrozumienia, jak router przetwarza pakiety w różnych kierunkach. SNAT modyfikuje adres źródłowy pakietu, co pozwala hostom z sieci prywatnej na komunikację z Internetem, ale nie umożliwia inicjowania połączeń z zewnątrz. DNAT działa w przeciwnym kierunku – zmienia adres docelowy, dzięki czemu ruch przychodzący na publiczny adres routera może trafić do konkretnego serwera wewnątrz sieci LAN.

Masquerade jest szczególnie przydatny w przypadku łączy z dynamicznym adresem IP, takich jak PPPoE czy DHCP od dostawcy Internetu. W przeciwieństwie do klasycznego SNAT, który wymaga jawnego wskazania adresu źródłowego po translacji, Masquerade automatycznie odczytuje bieżący adres interfejsu wyjściowego. Dzięki temu konfiguracja pozostaje poprawna nawet po zmianie publicznego adresu IP przez operatora.

W praktyce sieciowej SNAT i Masquerade są najczęściej używane w regułach srcnat, podczas gdy DNAT znajduje zastosowanie w regułach dstnat. Obie reguły mogą współistnieć na jednym routerze, co pozwala na jednoczesne udostępnianie Internetu hostom wewnętrznym i publikowanie usług na zewnątrz. Zrozumienie różnic między tymi typami translacji jest niezbędne przy projektowaniu reguł firewall i NAT w środowiskach produkcyjnych.

35/55 PAT – Port Address Translation

PAT (NAT overload) – translacja adresów i portów

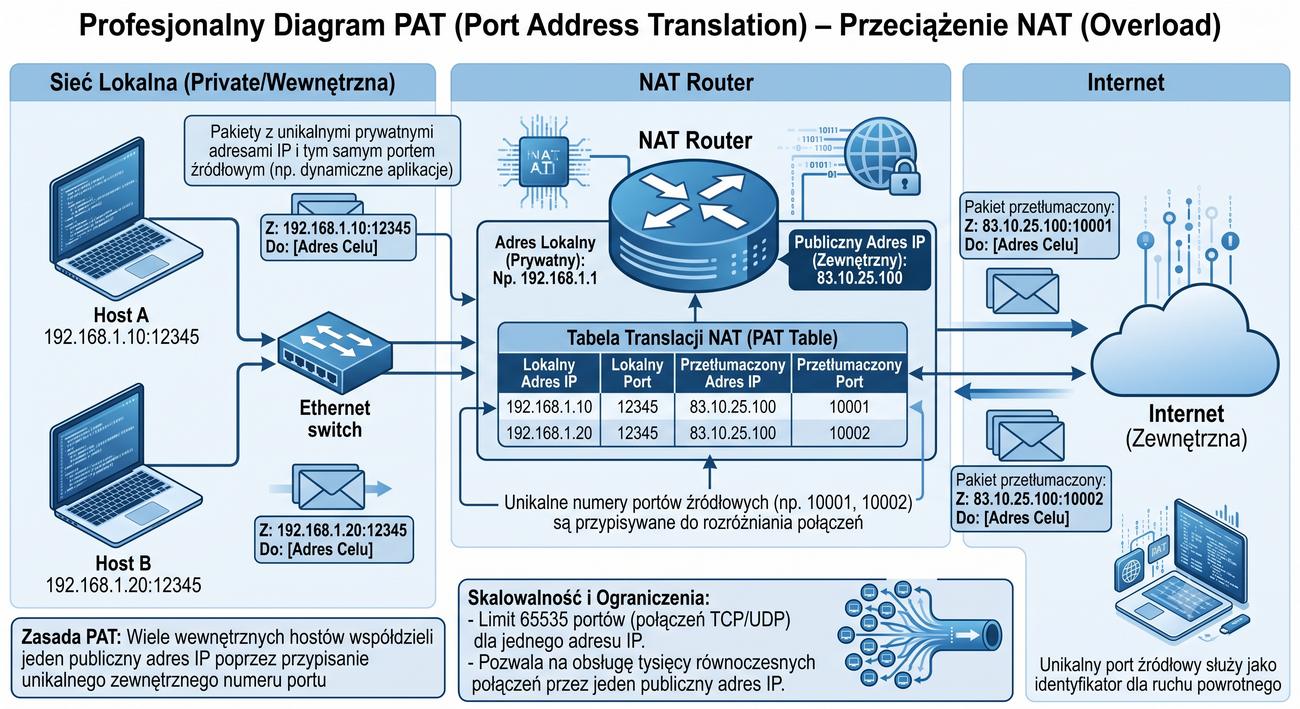
PAT (Port Address Translation) to rozszerzenie NAT, w którym router tłumaczy nie tylko adresy IP, ale także porty TCP/UDP.

PAT umożliwia wielu hostom współdzielenie jednego publicznego adresu IP przez zmianę portów źródłowych na unikalne.

Przykład: host A (192.168.1.10:12345) i host B (192.168.1.20:12345) → router nadaje im różne porty (10001 i 10002) na tym samym adresie publicznym.

Limit PAT wynika z liczby dostępnych portów (teoretycznie 65535, praktycznie kilkanaście tysięcy stabilnych połączeń na adres).

Mechanizm PAT (Port Address Translation) jest najpowszechniej stosowaną odmianą NAT w domowych routerach i sieciach firmowych. Jego istota polega na tym, że router nie tylko podmienia adres IP, ale również modyfikuje numer portu źródłowego w nagłówku TCP lub UDP. Dzięki temu możliwe jest jednoznaczne identyfikowanie, do którego hosta wewnętrznego należy zwrócić pakiet odpowiedzi, nawet gdy wiele urządzeń używa tego samego portu źródłowego.

W praktyce router prowadzi szczegółową tablicę odwzorowań, w której przechowuje pięcioelementową krotkę: protokół, źródłowy adres IP, źródłowy port, docelowy adres IP i docelowy port przed translacją oraz po translacji. Każde nowe połączenie wychodzące otrzymuje unikalny port na interfejsie zewnętrznym. Gdy pakiet powrotny dociera do routera, ten na podstawie docelowego portu odtwarza oryginalne parametry i przekazuje pakiet do właściwego hosta.

Ograniczeniem PAT jest skończona pula portów – teoretycznie 65535 na jeden adres IP i protokół. W praktyce jednak systemy operacyjne i stosy TCP/IP rezerwują pewien zakres portów, a dodatkowo każde połączenie zajmuje wpis w pamięci routera na czas trwania sesji. Dlatego rzeczywista liczba stabilnych połączeń symultanicznych za jednym adresem publicznym wynosi kilkanaście tysięcy, co przy odpowiednim projektowaniu sieci jest zwykle wystarczające.

36/55 NAT – tablica translacji

Tablica translacji NAT – Inside Local ↔ Inside Global

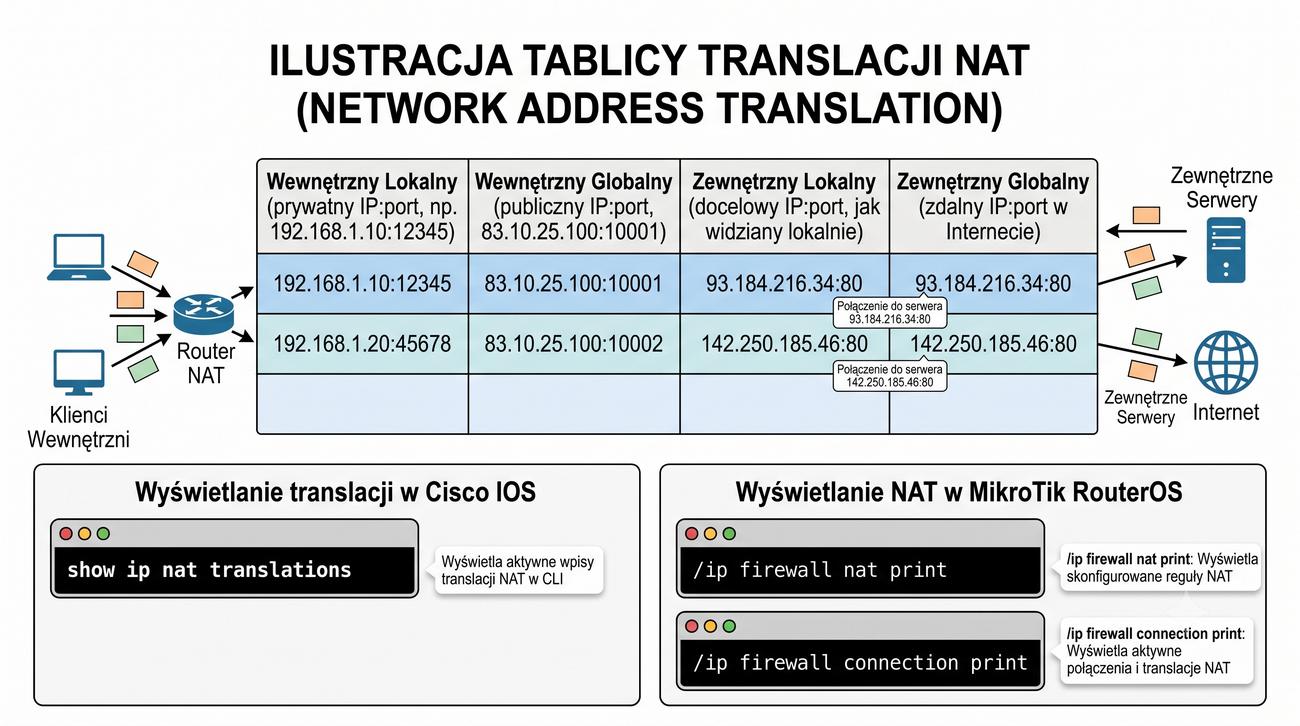
Każdy wpis zawiera adresy IP i porty: 192.168.1.10:12345 ↔ 83.10.25.100:10001.

Router na podstawie tablicy wie, do którego hosta wewnętrznego przekazać pakiet powrotny z Internetu.

W Cisco IOS podgląd: show ip nat translations. W RouterOS: /ip firewall nat print i /ip firewall connection print.

Tablica translacji NAT jest dynamiczną strukturą danych przechowywaną w pamięci routera, która umożliwia poprawne kierowanie pakietów powrotnych z Internetu do odpowiednich hostów w sieci prywatnej. Każdy wpis w tablicy zawiera informacje o adresie wewnętrznym (Inside Local), adresie zewnętrznym po translacji (Inside Global), adresie hosta docelowego (Outside Local i Outside Global) oraz używanym protokole i portach.

Routery wykorzystują czas życia wpisu (timeout), aby automatycznie czyścić nieaktywne translacje. Wartości timeout zależą od producenta i konfiguracji – w Cisco IOS domyślny timeout dla TCP wynosi 24 godziny, a dla UDP 5 minut. Gdy host wewnętrzny kończy komunikację, wpis pozostaje w tablicy do momentu wygaśnięcia timera, chyba że router otrzyma jawny sygnał zakończenia połączenia, taki jak pakiet TCP RST lub FIN.

W przypadku dużej liczby równoczesnych połączeń tablica translacji może ulec przepełnieniu, co skutkuje odrzucaniem nowych żądań. Dlatego w sieciach o znacznym ruchu warto monitorować rozmiar tablicy za pomocą poleceń takich jak show ip nat statistics w Cisco IOS czy /ip firewall connection print count w RouterOS. Regularne czyszczenie nieaktywnych wpisów i optymalizacja timeoutów pozwala utrzymać wydajność routera nawet przy intensywnym ruchu sieciowym.

37/55 NAT – zalety i wady

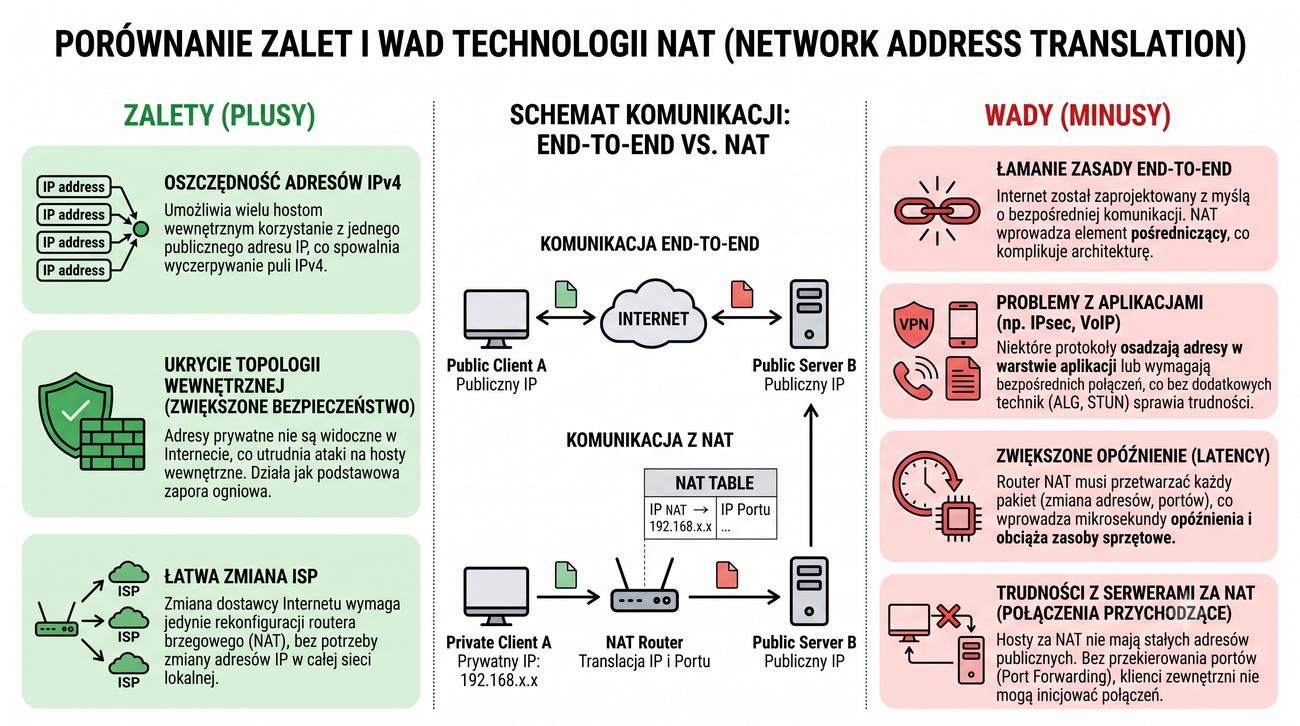
NAT – zalety (oszczędność IP) i wady (łamanie end-to-end)

NAT ma zarówno istotne zalety, jak i poważne wady wynikające z łamania zasady end-to-end.
  • Zalety: oszczędność publicznych adresów IP, ukrycie wewnętrznej topologii sieci, łatwość zmiany dostawcy Internetu, podstawowa ochrona przed dostępem z zewnątrz
  • Wady: łamanie zasady end-to-end, utrudnienia dla VPN, VoIP i FTP Active, dodatkowe opóźnienie

Zasadniczą zaletą NAT jest oszczędność publicznych adresów IP – bez tego mechanizmu wyczerpanie puli IPv4 nastąpiłoby znacznie wcześniej i odczuwalne byłoby już w codziennym użytkowaniu Internetu. Dodatkowym atutem jest ukrycie wewnętrznej struktury adresacyjnej sieci, co utrudnia potencjalnemu atakującemu rozpoznanie topologii i zaplanowanie celowanego ataku. NAT pełni więc funkcję podstawowej, choć niepełnej, zapory ogniowej.

Najpoważniejszą wadą NAT jest łamanie zasady end-to-end, która zakłada, że każdy host w Internecie może bezpośrednio komunikować się z każdym innym. W praktyce oznacza to, że hosty za NAT nie mogą przyjmować połączeń przychodzących inicjowanych z Internetu bez specjalnych reguł przekierowania portów. Ponadto protokoły takie jak IPsec VPN, SIP w VoIP czy Active FTP napotykają trudności przy przechodzeniu przez translator NAT, ponieważ przenoszą informacje o adresach IP w warstwie aplikacji.

Kolejnym wyzwaniem jest dodatkowe opóźnienie (latency) wprowadzane przez proces translacji – router musi dla każdego pakietu sprawdzić i zmodyfikować nagłówki, co przy dużym obciążeniu może prowadzić do spadku wydajności. Rozwiązaniem tych problemów jest stopniowe przechodzenie na IPv6, które eliminuje potrzebę stosowania NAT dzięki ogromnej przestrzeni adresowej. Dopóki jednak IPv6 nie zostanie w pełni wdrożony, NAT pozostaje niezbędnym elementem infrastruktury sieciowej.

38/55 NAT – Port Forwarding

Port Forwarding – udostępnianie usług za NAT (DNAT)

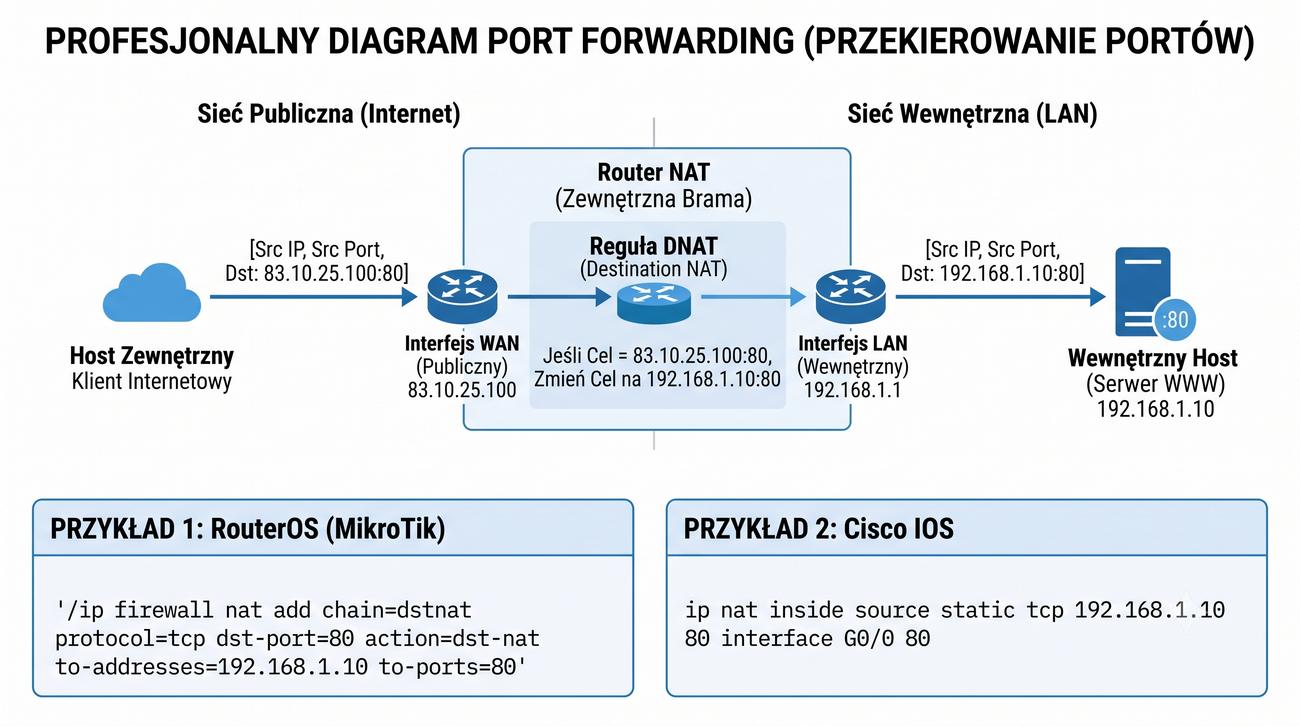
Port Forwarding (przekierowanie portów) to mechanizm DNAT umożliwiający dostęp z Internetu do usług działających na hostach w sieci prywatnej za NAT.

Port Forwarding tworzy stały wpis w tablicy NAT: ruch na publicznym adresie routera na określonym porcie jest przekierowywany do wewnętrznego hosta.

Przykład w RouterOS: /ip firewall nat add chain=dstnat protocol=tcp dst-port=80 action=dst-nat to-addresses=192.168.1.10 to-ports=80.

Port Forwarding jest realizowany przez reguły DNAT, które tworzą stałe odwzorowanie między portem na publicznym adresie routera a konkretnym hostem i portem w sieci wewnętrznej. Działa to na zasadzie: cały ruch przychodzący na router na określonym porcie TCP lub UDP jest automatycznie przekierowywany do wskazanego urządzenia w LAN, niezależnie od tego, które hosty wewnętrzne aktualnie komunikują się z Internetem.

W konfiguracji port forwarding należy pamiętać o kilku istotnych kwestiach. Po pierwsze, host docelowy musi mieć statyczny adres IP lub rezerwację DHCP, ponieważ zmiana adresu spowoduje przerwanie reguły przekierowania. Po drugie, należy starannie dobierać zakres portów – typowe usługi to port 22 dla SSH, 80 dla HTTP, 443 dla HTTPS, 3389 dla RDP. Po trzecie, otwieranie portów na routerze zwiększa powierzchnię ataku, dlatego warto łączyć port forwarding z regułami firewall ograniczającymi źródłowe adresy IP.

W zaawansowanych konfiguracjach spotyka się także przekierowanie zakresu portów (port range forwarding) oraz tłumaczenie portów (port redirection), gdzie port zewnętrzny różni się od wewnętrznego. Na przykład administrator może przekierować zewnętrzny port 8080 na wewnętrzny port 80 serwera WWW, co jest przydatne, gdy dostawca Internetu blokuje standardowe porty. Reguły port forwarding są niezbędne do publikowania usług takich jak serwery WWW, gry sieciowe czy systemy monitoringu za routerem NAT.

39/55 NAT – konfiguracja w RouterOS

Konfiguracja NAT w RouterOS (MikroTik) – srcnat i dstnat

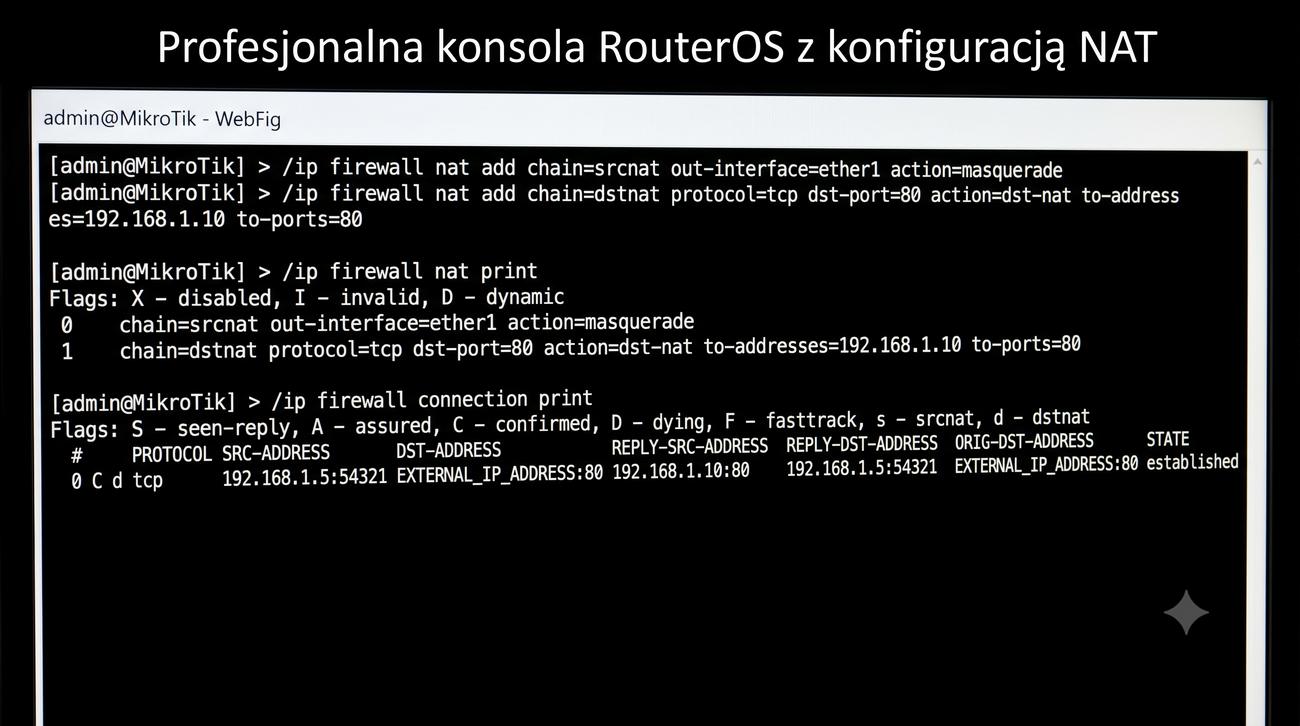
  • SNAT (Masquerade): /ip firewall nat add chain=srcnat out-interface=ether1 action=masquerade
  • DNAT (Port Forwarding): /ip firewall nat add chain=dstnat protocol=tcp dst-port=80 action=dst-nat to-addresses=192.168.1.10 to-ports=80

W systemie RouterOS firmy MikroTik konfiguracja NAT opiera się na regułach zapory ogniowej w łańcuchu /ip firewall nat. Najważniejszym parametrem każdej reguły jest określenie łańcucha: srcnat dla translacji adresu źródłowego (pakiety wychodzące) oraz dstnat dla translacji adresu docelowego (pakiety przychodzące). Kolejność reguł ma znaczenie – RouterOS przetwarza je od góry do dołu i wykonuje akcję dla pierwszej pasującej reguły.

W przypadku reguły masquerade RouterOS automatycznie wybiera adres źródłowy na podstawie interfejsu wyjściowego, co jest szczególnie wygodne przy łączach dynamicznych. Jednak w sytuacjach, gdy router ma wiele interfejsów zewnętrznych lub gdy wymagane jest użycie konkretnego adresu IP, lepiej zastosować regułę src-nat z jawnie określonym adresem to-addresses. Warto również pamiętać o regule accept dla istniejących połączeń (connection-state=established,related), która odciąża procesor przy przetwarzaniu pakietów powrotnych.

RouterOS oferuje także zaawansowane możliwości, takie jak translacja oparta na znacznikach routingu (routing-mark) czy protokole (protocol). Przydatnym narzędziem jest komenda /ip firewall connection print, która wyświetla wszystkie aktywne translacje w czasie rzeczywistym. Monitorowanie liczby połączeń pomaga w diagnozowaniu problemów z wydajnością i w odpowiednim skalowaniu konfiguracji NAT w sieciach o dużym natężeniu ruchu.

40/55 NAT – konfiguracja w Cisco IOS

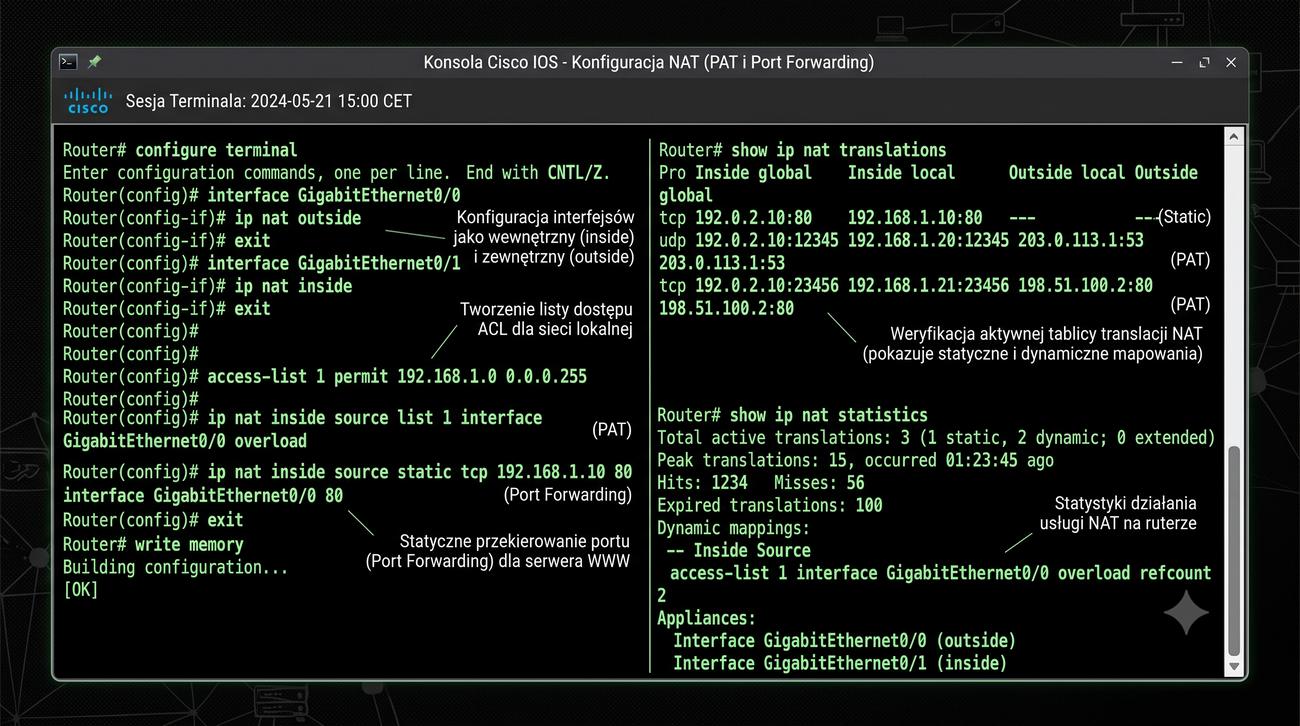
Konfiguracja NAT w Cisco IOS – inside/outside

  • interface G0/0 z ip nat outside – oznacza interfejs zewnętrzny
  • interface G0/1 z ip nat inside – oznacza wewnętrzny
  • PAT: ip nat inside source list ACL1 interface G0/0 overload
  • Port Forwarding: ip nat inside source static tcp 192.168.1.10 80 interface G0/0 80

W urządzeniach Cisco konfiguracja NAT wymaga przede wszystkim prawidłowego oznaczenia interfejsów jako inside i outside. Interfejs inside to ten, który jest podłączony do sieci wewnętrznej z adresami prywatnymi, natomiast outside łączy się z siecią zewnętrzną – najczęściej z Internetem. Oznaczenie to jest kluczowe, ponieważ router na tej podstawie decyduje, które pakiety podlegają translacji.

Do translacji wielu hostów na jeden adres publiczny stosuje się polecenie ip nat inside source list z listą ACL określającą, które adresy wewnętrzne mają być tłumaczone, oraz słowem kluczowym overload, które włącza mechanizm PAT. ACL w tym kontekście nie służy do blokowania ruchu, lecz wyłącznie do selekcji adresów podlegających translacji. W przypadku statycznego NAT dla pojedynczego hosta (np. serwera) stosuje się ip nat inside source static z mapowaniem adresu wewnętrznego na zewnętrzny.

Cisco IOS umożliwia również konfigurację NAT dla wielu pul adresów publicznych (NAT Pool) oraz translację opartą na porcie docelowym (policy NAT). Narzędzia diagnostyczne, takie jak debug ip nat, pozwalają śledzić proces translacji w czasie rzeczywistym, co jest nieocenione przy rozwiązywaniu problemów z łącznością. Warto pamiętać, że nadmierna liczba translacji może obciążać procesor routera, dlatego w dużych sieciach zaleca się stosowanie sprzętowego przyspieszania NAT (Cisco CEF).

41/55 NAT – przykłady praktyczne

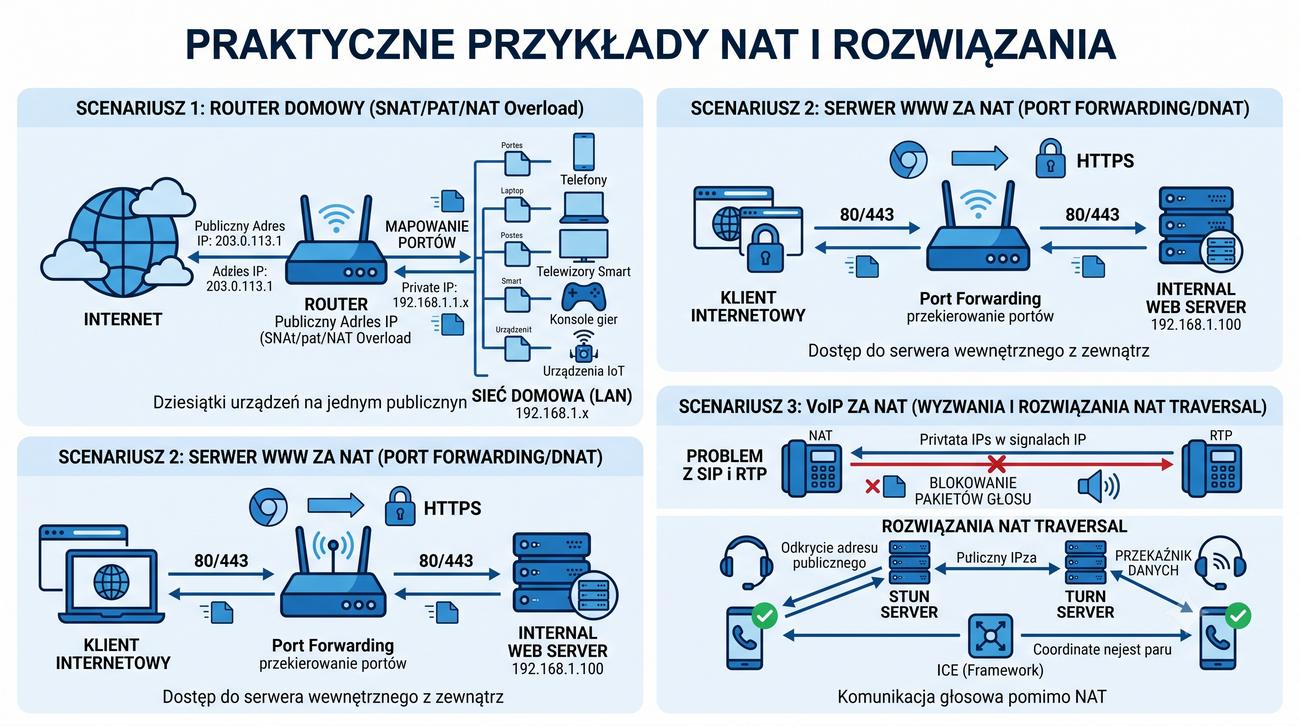
NAT w praktyce – sieć domowa, serwer WWW, VoIP

  • Sieć domowa: router obsługuje dziesiątki urządzeń (telefony, telewizory, konsole, IoT) za jednym publicznym adresem IP
  • Serwer WWW za NAT: wymaga Port Forwarding dla portów 80 i 443
  • VoIP za NAT: wyzwanie ze względu na protokoły SIP i RTP używające dynamicznych portów

W typowej sieci domowej router z NAT obsługuje jednocześnie kilkanaście lub kilkadziesiąt urządzeń – smartfony, laptopy, telewizory smart, konsole do gier, czujniki IoT i asystenty głosowe. Każde z tych urządzeń inicjuje połączenia z różnymi serwerami w Internecie, a router za pomocą PAT przypisuje im unikalne pary adres-port na interfejsie zewnętrznym. Bez tego mechanizmu dostawca Internetu musiałby przydzielić osobny publiczny adres IP każdemu urządzeniu, co byłoby niemożliwe ze względu na wyczerpanie puli IPv4.

Publikacja serwera WWW za NAT wymaga nie tylko reguły port forwarding, ale także odpowiedniego skonfigurowania zapory ogniowej, aby ruch na portach 80 i 443 był dozwolony. Dodatkowym wyzwaniem jest obsługa protokołu HTTPS z certyfikatami SSL/TLS – jeśli serwer znajduje się za NAT, certyfikat musi być wystawiony na publiczną nazwę domenową, a nie na wewnętrzny adres IP. W praktyce często stosuje się odwrotne proxy (reverse proxy), które przejmuje ruch HTTPS i przekierowuje go do wewnętrznych serwerów już jako HTTP.

Szczególnie problematycznym przypadkiem jest VoIP za NAT. Protokół SIP przesyła informacje o adresach IP w treści wiadomości, a nie tylko w nagłówkach pakietów, co powoduje, że standardowy NAT nie jest w stanie poprawnie przetłumaczyć tych danych. Rozwiązaniem są funkcje takie jak SIP ALG (Application Layer Gateway) w routerach lub protokół ICE (Interactive Connectivity Establishment), które umożliwiają negocjację parametrów połączenia między klientami VoIP znajdującymi się za różnymi translatorami NAT.

42/55 Podsumowanie bloku III – NAT

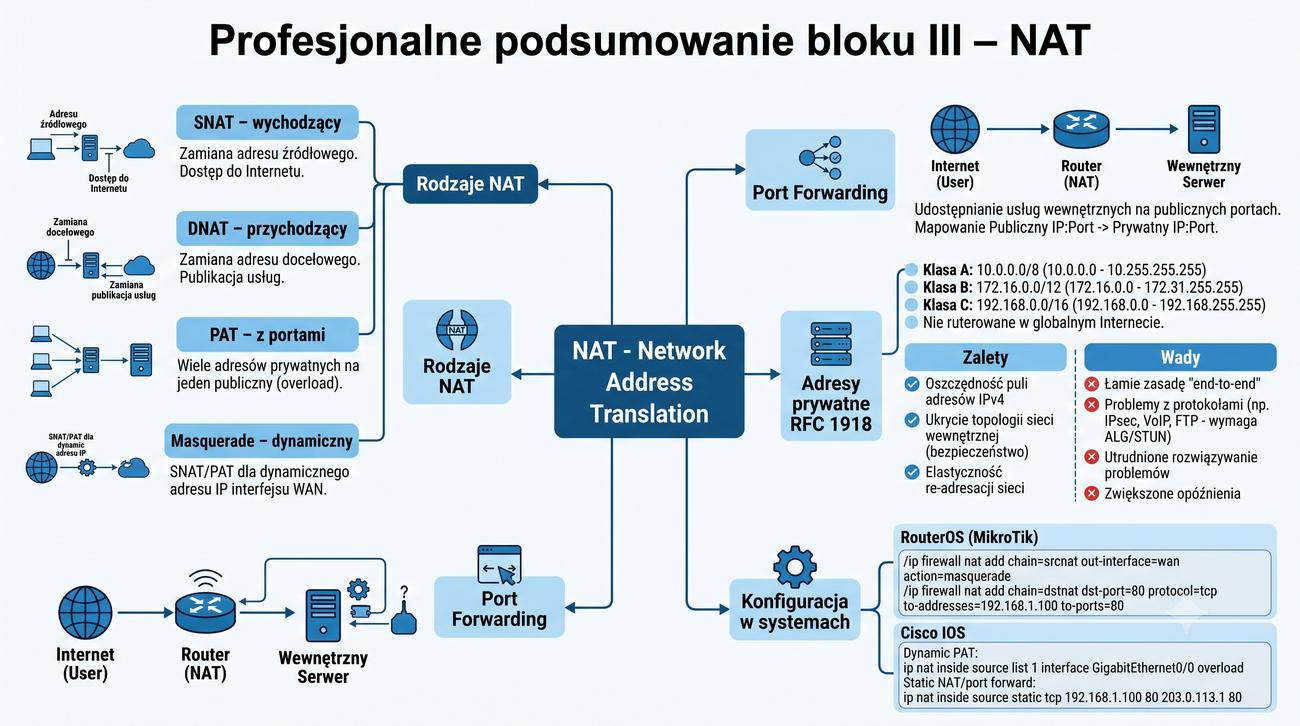
Blok III – podsumowanie: NAT w pigułce

  • SNAT – tłumaczy adres źródłowy pakietów wychodzących
  • DNAT – tłumaczy adres docelowy pakietów przychodzących (Port Forwarding)
  • PAT – NAT z tłumaczeniem portów, umożliwia współdzielenie jednego adresu
  • Zalety: oszczędność adresów, ukrycie topologii
  • Wady: łamanie end-to-end, problemy z VPN i VoIP

Mechanizm NAT, choć pierwotnie pomyślany jako tymczasowe rozwiązanie problemu wyczerpania adresów IPv4, stał się trwałym elementem architektury współczesnych sieci komputerowych. Jego implementacja w urządzeniach takich jak routery domowe, firewalle korporacyjne czy bramy VoIP różni się szczegółami, ale podstawowa zasada działania pozostaje niezmienna – translacja adresów umożliwia komunikację między sieciami o różnych przestrzeniach adresowych.

W kontekście bezpieczeństwa NAT zapewnia podstawową izolację sieci wewnętrznej, ponieważ hosty z Internetu nie mogą bezpośrednio inicjować połączeń do urządzeń za routerem. Jednak nie należy traktować NAT jako pełnoprawnego mechanizmu bezpieczeństwa – nie chroni on przed atakami inicjowanymi z wewnątrz sieci, a przy niewłaściwej konfiguracji port forwarding może wręcz zwiększyć podatność na ataki z zewnątrz. Dlatego w środowiskach korporacyjnych NAT zawsze łączy się z zaawansowanymi regułami firewall i systemami IPS/IDS.

Przyszłość NAT jest ściśle związana z migracją do IPv6. W sieciach IPv6 NAT nie jest potrzebny, ponieważ każdy host może posiadać globalnie unikalny adres, co przywraca zasadę end-to-end. Mimo to wiele organizacji stosuje NAT64 do zapewnienia komunikacji między sieciami IPv6 a starszymi zasobami IPv4. Znajomość mechanizmów NAT pozostaje więc kluczową umiejętnością każdego administratora sieci, nawet w erze stopniowego przechodzenia na IPv6.

43/55 Warstwa aplikacji w modelu TCP/IP

Warstwa aplikacji – najwyższa warstwa modelu TCP/IP

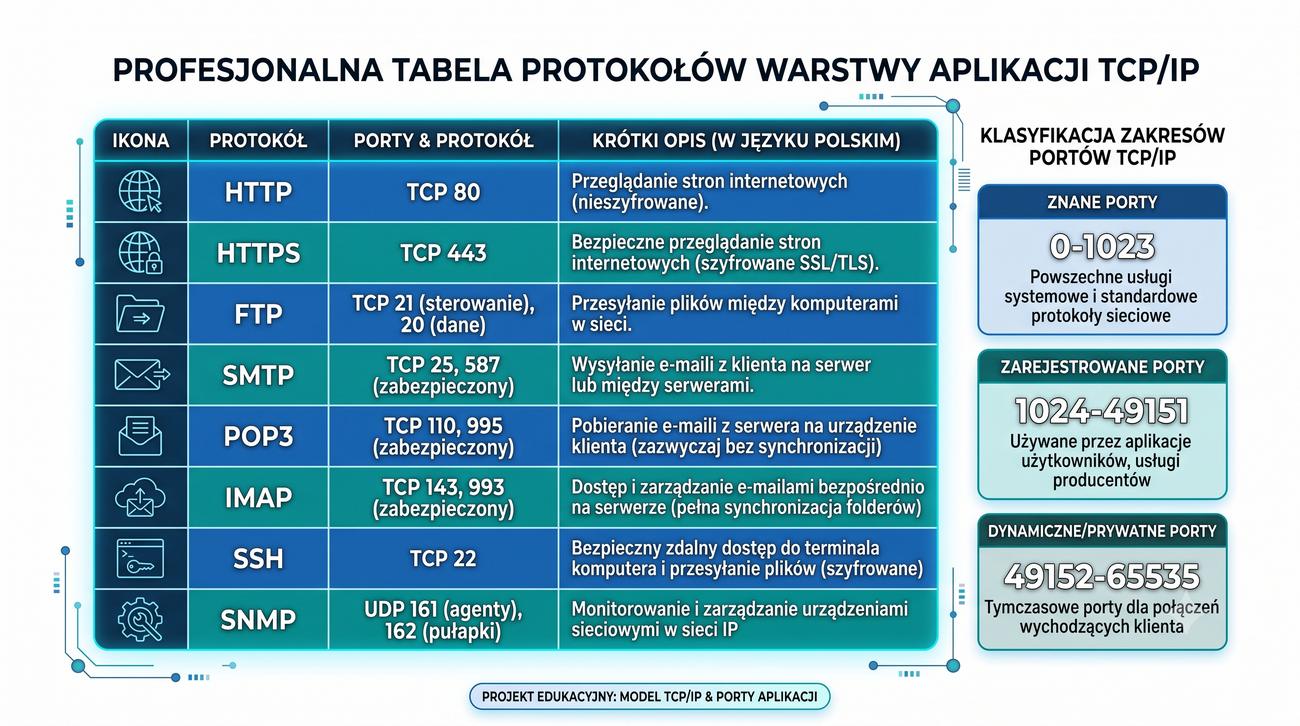
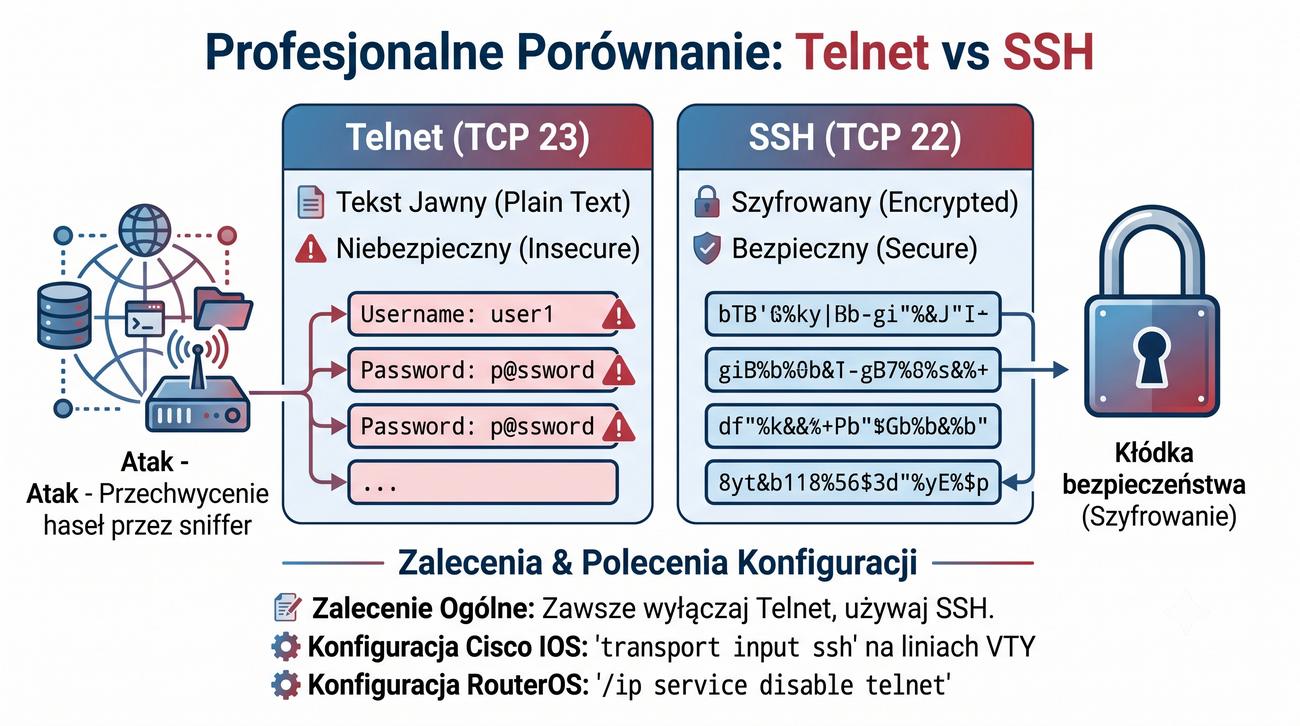
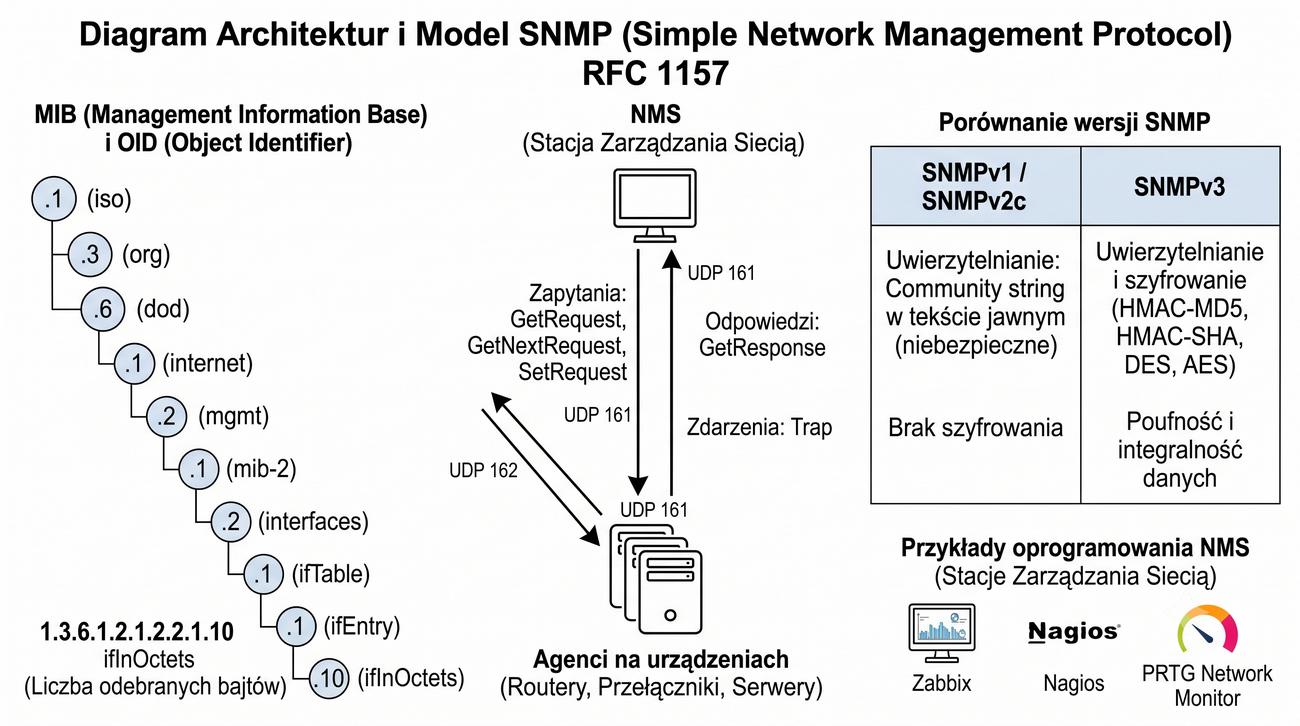
Do najważniejszych protokołów warstwy aplikacji należą: HTTP, HTTPS, FTP, SMTP, POP3, IMAP, SSH, DHCP i DNS.

Porty 0-1023: dobrze znane usługi, porty 1024-49151: zarejestrowane dla aplikacji, porty 49152-65535: dynamiczne.

Warstwa aplikacji w modelu TCP/IP stanowi interfejs między usługami sieciowymi a programami użytkowymi działającymi na hoście. W przeciwieństwie do modelu OSI, który dzieli funkcje związane z komunikacją na siedem warstw, TCP/IP łączy warstwy sesji, prezentacji i aplikacji w jedną warstwę aplikacji. To właśnie na tym poziomie definiowane są protokoły takie jak HTTP, FTP, SMTP czy DNS, które bezpośrednio obsługują żądania użytkowników i aplikacji.

Każdy protokół warstwy aplikacji korzysta z określonego portu TCP lub UDP, co umożliwia systemowi operacyjnemu hosta kierowanie ruchu do odpowiedniego procesu. Porty w zakresie 0–1023 są zarezerwowane dla dobrze znanych usług (well-known ports) i wymagają uprawnień administratora do uruchomienia. Porty 1024–49151 mogą być używane przez zarejestrowane aplikacje, natomiast porty 49152–65535 są przeznaczone do tymczasowego użytku przez klientów (ephemeral ports).

Większość protokołów warstwy aplikacji korzysta z TCP jako protokołu transportowego, ponieważ wymaga niezawodnego dostarczania danych z potwierdzeniami i retransmisją. Wyjątkiem są protokoły takie jak DHCP i DNS (dla standardowych zapytań), które używają UDP ze względu na mniejsze opóźnienie i prostszą implementację. W przypadku DNS, gdy odpowiedź nie mieści się w pakiecie UDP, serwer ustawia flagę przycięcia (truncation) i klient ponawia zapytanie na porcie TCP, co zapewnia poprawność przesyłanych danych.

44/55 HTTP – Hypertext Transfer Protocol

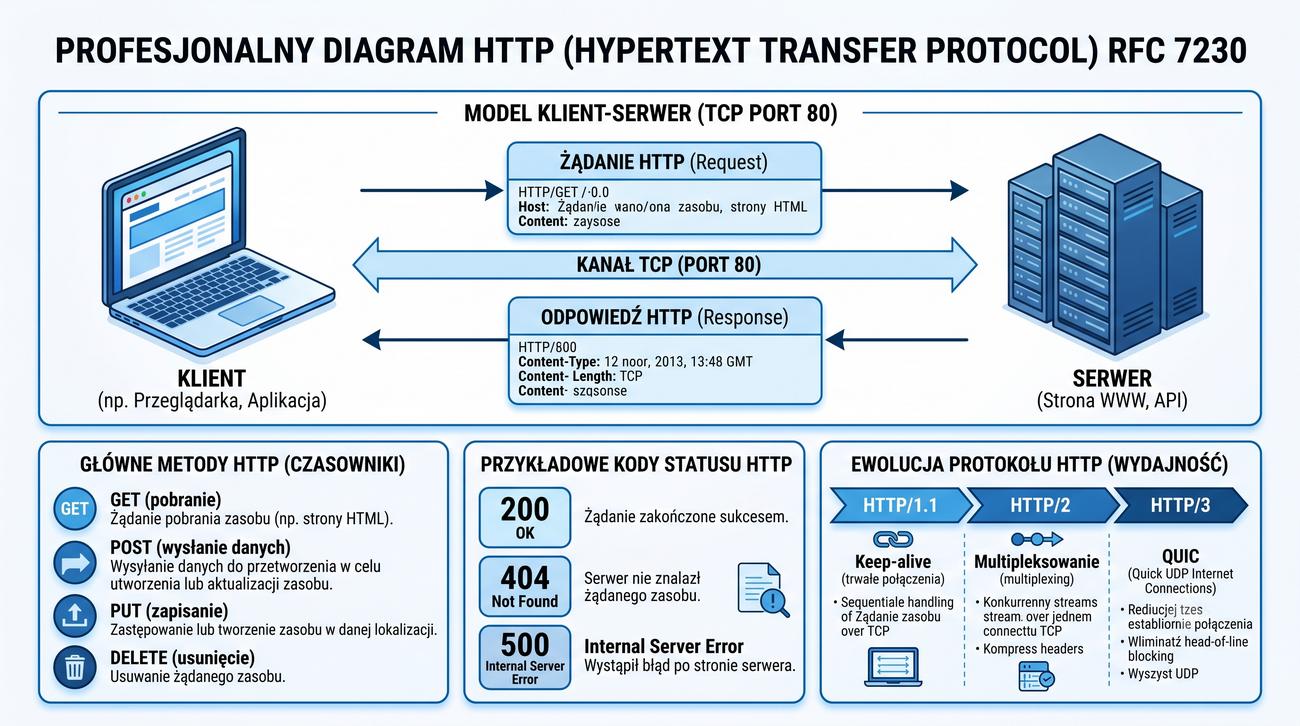
HTTP – podstawa WWW (RFC 7230, TCP 80, bezstanowy)

HTTP (Hypertext Transfer Protocol) zdefiniowany w RFC 7230 to podstawa działania World Wide Web.

HTTP działa w modelu klient-serwer na porcie TCP 80, a każde żądanie jest niezależne (stateless).

Metody HTTP: GET (pobranie), POST (wysłanie danych), PUT (zapisanie), DELETE (usunięcie).

Kody statusu: 1xx informacyjne, 2xx sukces, 3xx przekierowanie, 4xx błąd klienta, 5xx błąd serwera.

HTTP (Hypertext Transfer Protocol) jest protokołem bezstanowym, co oznacza, że każde żądanie klienta jest traktowane przez serwer jako niezależne zdarzenie – serwer nie przechowuje informacji o poprzednich żądaniach tego samego klienta. Aby obejść to ograniczenie, wprowadzono mechanizmy takie jak ciasteczka (cookies), sesje po stronie serwera czy nagłówki autoryzacyjne, które pozwalają na utrzymanie stanu między kolejnymi żądaniami HTTP. Bez tych mechanizmów niemożliwe byłoby korzystanie z koszyków zakupowych, paneli logowania czy spersonalizowanych treści.

Wersja HTTP/1.1 wprowadziła kluczowe usprawnienia, takie jak połączenia trwałe (keep-alive), które pozwalają na przesyłanie wielu żądań i odpowiedzi w ramach jednego połączenia TCP, oraz pipelining, umożliwiający wysyłanie kolejnych żądań bez oczekiwania na odpowiedź. Nowsze wersje protokołu – HTTP/2 i HTTP/3 – jeszcze bardziej zwiększają wydajność dzięki multipleksowaniu strumieni, kompresji nagłówków (HPACK w HTTP/2, QPACK w HTTP/3) i wykorzystaniu protokołu transportowego QUIC zamiast TCP, co redukuje opóźnienia przy nawiązywaniu połączenia.

Kody statusu HTTP pełnią kluczową rolę w komunikacji klient-serwer. Kody z grupy 2xx informują o powodzeniu operacji, przy czym kod 200 (OK) jest najczęściej spotykany przy poprawnym pobraniu zasobu. Kody 3xx dotyczą przekierowań – na przykład 301 (Moved Permanently) informuje przeglądarkę, że zasób zmienił adres na stałe. Kody 4xx sygnalizują błędy po stronie klienta (najbardziej znany to 404 Not Found), a kody 5xx wskazują na problemy po stronie serwera, takie jak 500 Internal Server Error. Zrozumienie tych kodów jest niezbędne przy diagnozowaniu problemów z aplikacjami webowymi.

45/55 HTTPS – HTTP Secure

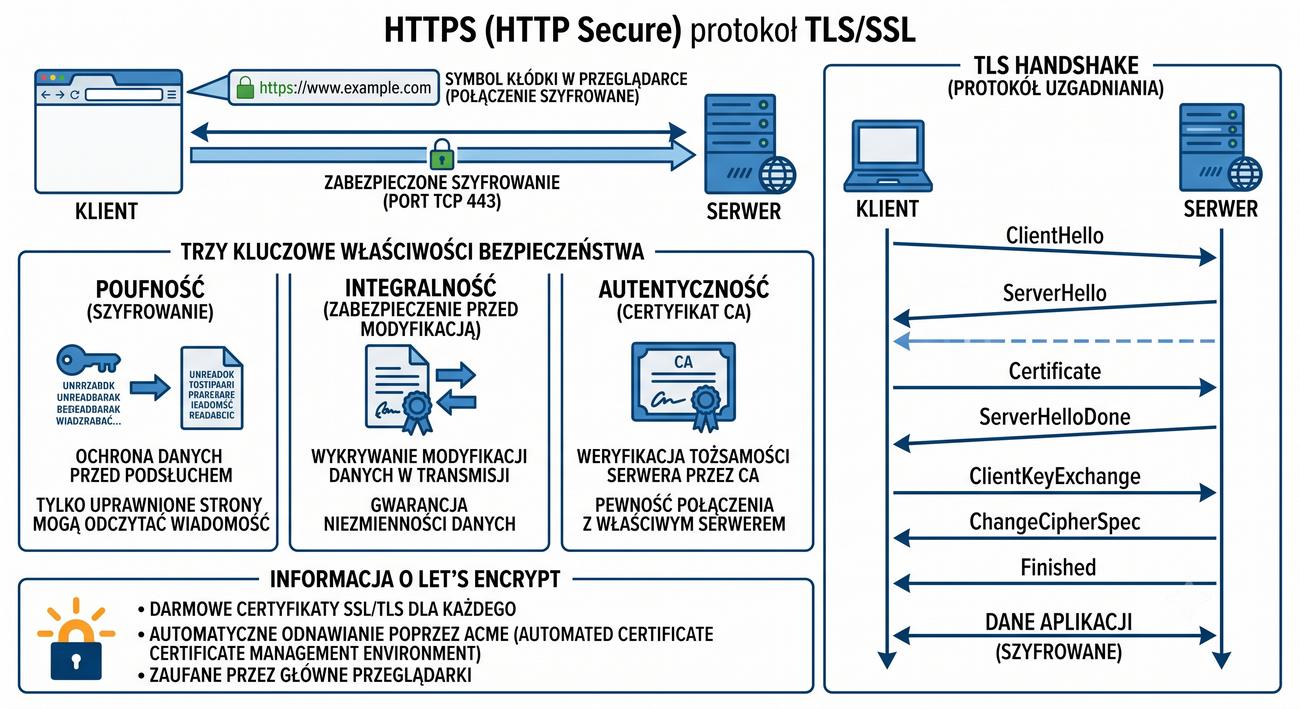
HTTPS – HTTP z szyfrowaniem TLS (TCP 443)

HTTPS (HTTP Secure) to HTTP z szyfrowaniem TLS (Transport Layer Security) działający na porcie TCP 443.

HTTPS zapewnia trzy kluczowe właściwości bezpieczeństwa: poufność, integralność i autentyczność.

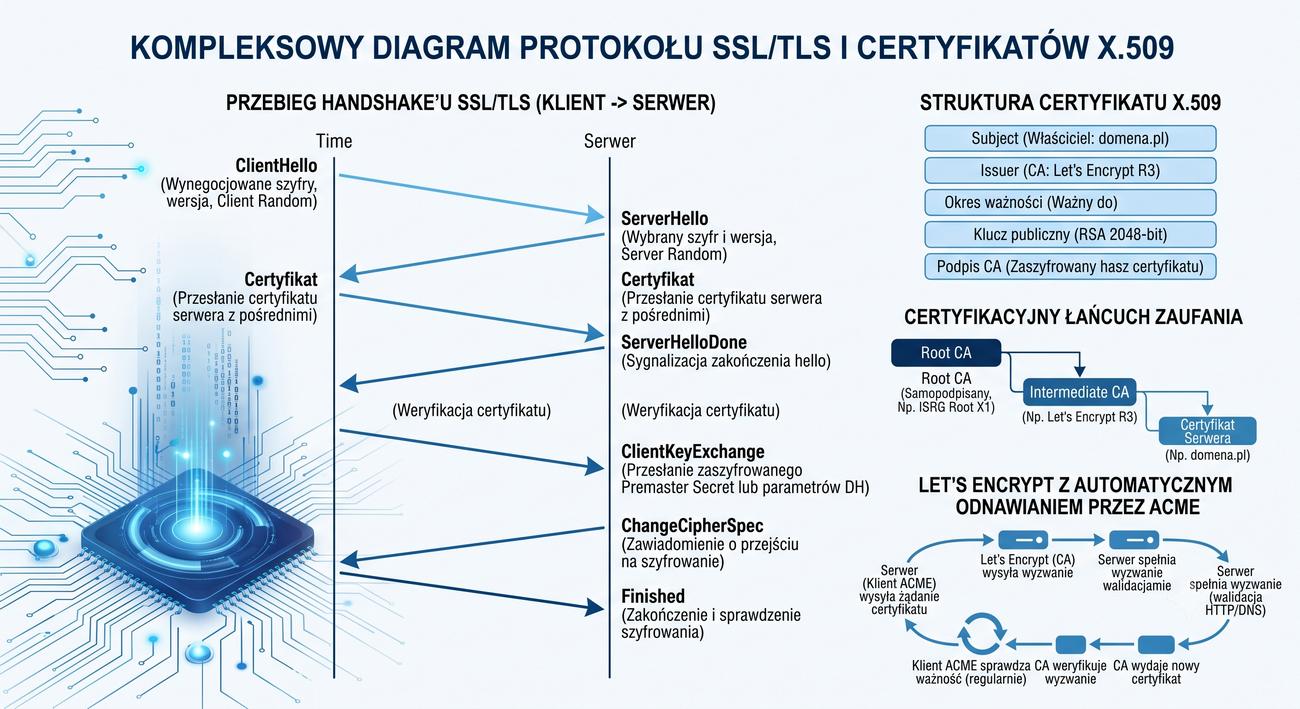
Przed wymianą danych następuje uzgadnianie TLS (TLS handshake), podczas którego klient i serwer uzgadniają wersję TLS, algorytmy szyfrowania i wymieniają klucze.

Certyfikat SSL/TLS potwierdza tożsamość serwera.

Podczas uzgadniania TLS (TLS handshake) klient i serwer wymieniają się wiadomościami ClientHello i ServerHello, uzgadniając wersję protokołu, wybór cipher suite oraz wymieniając klucze publiczne. Serwer przesyła certyfikat SSL/TLS podpisany przez urząd certyfikacji (CA), który klient weryfikuje z listą zaufanych CA w swoim systemie operacyjnym. W TLS 1.3 proces ten został skrócony do jednej rundy (1-RTT), co znacząco przyspiesza nawiązywanie połączenia w porównaniu z TLS 1.2.

Po ustaleniu klucza symetrycznego wszystkie przesyłane dane są szyfrowane, co uniemożliwia podsłuchanie treści strony przez osoby trzecie. Integralność danych jest zapewniana przez kody uwierzytelniania wiadomości (MAC), które wykrywają jakąkolwiek modyfikację pakietów w trakcie transmisji. Autentyczność serwera jest gwarantowana przez certyfikat – bez tego atakujący mógłby podszyć się pod legalną witrynę w ataku man-in-the-middle.

Współcześnie przeglądarki internetowe oznaczają strony bez HTTPS jako niezabezpieczone, a wyszukiwarki promują witryny szyfrowane wyższymi pozycjami. W praktyce przeglądarki korzystają z HTTP/2 wyłącznie z szyfrowaniem TLS, a HTTP/3 z założenia opiera się na protokole QUIC z wbudowanym TLS 1.3, co uczyniło HTTPS standardem, a nie opcją. Coraz popularniejsze stają się darmowe certyfikaty od Let's Encrypt, które automatyzują proces wystawiania i odnawiania certyfikatów.

46/55 FTP – File Transfer Protocol

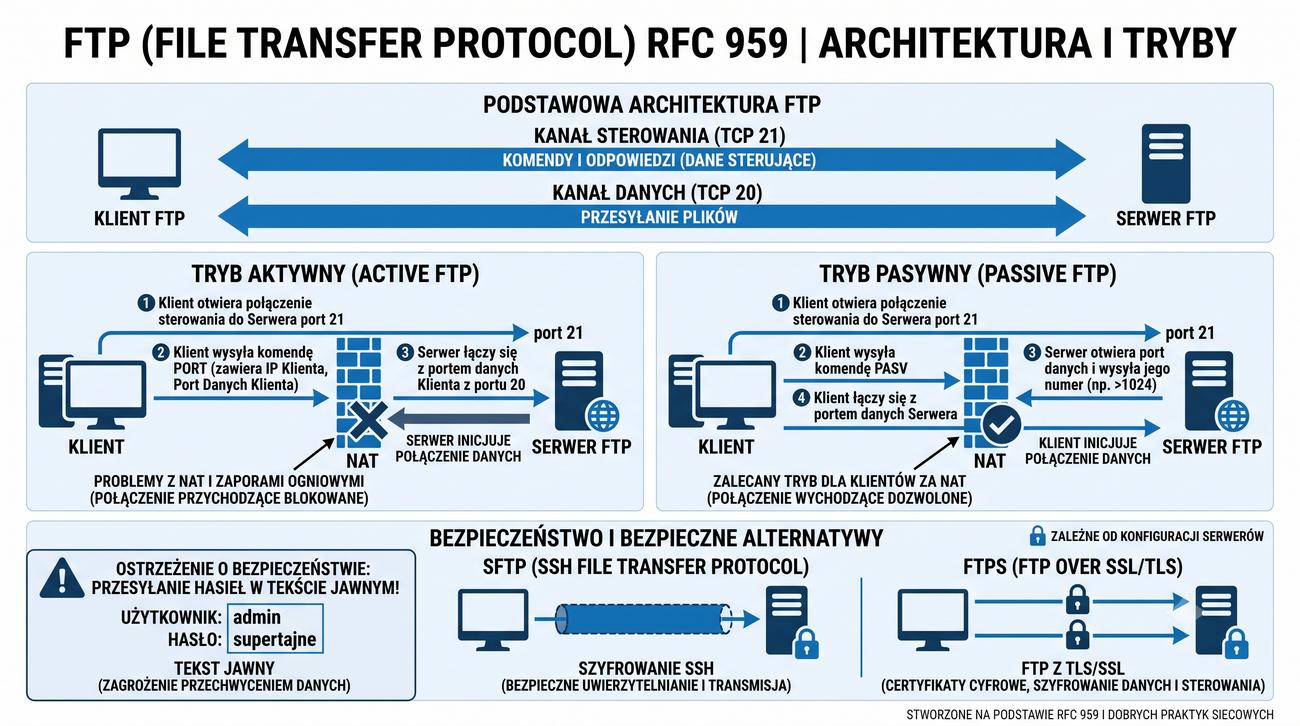
FTP – przesyłanie plików (RFC 959, TCP 21+20)

FTP (File Transfer Protocol) zdefiniowany w RFC 959 służy do przesyłania plików między klientem a serwerem.
  • Port 21 – kanał sterowania (polecenia)
  • Port 20 – kanał danych (przesyłanie plików)
  • Tryb Active: serwer inicjuje połączenie zwrotne do klienta (problem za NAT)
  • Tryb Passive: serwer otwiera port, klient sam się łączy

W trybie Active serwer FTP inicjuje połączenie zwrotne do klienta na porcie 20, co jest blokowane przez firewalle i NAT po stronie klienta. Z tego powodu w sieciach prywatnych powszechnie stosuje się tryb Passive (PASV), w którym to klient inicjuje oba połączenia, a serwer podaje adres IP i port, na którym oczekuje na połączenie danych. W trybie Passive serwer dynamicznie przydziela port, najczęściej z zakresu 49152–65535, dla każdej sesji przesyłania plików.

Bezpieczniejszymi następcami FTP są FTPS (FTP over SSL/TLS) oraz SFTP (SSH File Transfer Protocol). FTPS dodaje warstwę szyfrowania TLS do tradycyjnego FTP, działając na tych samych portach, ale z wymogiem certyfikatu. SFTP jest zupełnie innym protokołem, działającym w całości przez szyfrowany kanał SSH na porcie 22, i nie wymaga osobnych kanałów sterowania i danych.

FTP wciąż znajduje zastosowanie w środowiskach korporacyjnych, gdzie przesyła się duże pliki między serwerami, oraz w starszych systemach SCADA i IoT. Nowoczesne rozwiązania chmurowe i API REST coraz częściej wypierają FTP na rzecz rozwiązań opartych na protokole HTTP, takich jak WebDAV czy S3 API.

47/55 SMTP, POP3, IMAP – poczta elektroniczna

SMTP (TCP 25/587), POP3 (TCP 110/995), IMAP (TCP 143/993)

Poczta elektroniczna korzysta z trzech głównych protokołów: SMTP, POP3 i IMAP.
  • SMTP (TCP 25/587, RFC 5321) – wysyłanie wiadomości e-mail między serwerami i od klienta do serwera
  • POP3 (TCP 110/995, RFC 1939) – odbieranie poczty, domyślnie usuwa z serwera
  • IMAP (TCP 143/993, RFC 3501) – synchronizacja stanu między wieloma klientami, pozostawia na serwerze

Proces dostarczenia wiadomości e-mail obejmuje kilka etapów: klient wysyła list przez MUA (Mail User Agent) do serwera SMTP, który działa jako MTA (Mail Transfer Agent). MTA odnajduje serwer docelowy przez zapytanie DNS o rekord MX domeny odbiorcy, a następnie przekazuje wiadomość do serwera odbiorcy. Po odebraniu wiadomości trafia ona do skrzynki odbiorcy zarządzanej przez MDA (Mail Delivery Agent).

SMTP używa domyślnie portu 25, ale dostawcy internetowi często blokują ten port dla klientów końcowych, wymagając korzystania z portu 587 z uwierzytelnianiem (Submission). POP3 pobiera wiadomości z serwera i domyślnie usuwa je z niego, co jest wygodne przy ograniczonej przestrzeni dyskowej, ale uniemożliwia dostęp z wielu urządzeń. IMAP przechowuje wiadomości na serwerze i synchronizuje stan między klientami, co pozwala na sprawdzanie poczty z telefonu, laptopa i komputera stacjonarnego.

Oba protokoły odbiorcze mają swoje zabezpieczone wersje: POP3S (port 995) i IMAPS (port 993), które używają szyfrowania TLS. W praktyce IMAP z TLS jest standardem w nowoczesnych systemach pocztowych, podczas gdy POP3 jest stopniowo wypierany ze względu na brak synchronizacji między urządzeniami.

48/55 Telnet vs SSH

Telnet (TCP 23) vs SSH (TCP 22) – zdalne zarządzanie

Telnet (TCP 23) i SSH (TCP 22) to protokoły zdalnego zarządzania urządzeniami sieciowymi.
  • Telnet – przesyła dane w tekście jawnym, każde hasło można podsłuchać w sieci
  • SSH (Secure Shell) – szyfrowana komunikacja, uwierzytelnianie kluczem publicznym
  • SSH oferuje tunelowanie, przekazywanie portów i SFTP

Telnet był historycznie pierwszym protokołem zdalnego zarządzania, opracowanym w 1969 roku. Przesyła on wszystkie dane w tekście jawnym – zarówno polecenia, jak i hasła logowania mogą być przechwycone przez każdego, kto ma dostęp do sieci. Mimo tych poważnych wad Telnet jest wciąż używany do testowania połączeń TCP z konkretnym portem oraz do konfiguracji starszych urządzeń sieciowych, które nie obsługują SSH.

SSH (Secure Shell) opracowany przez Tatu Ylönena w 1995 roku zapewnia szyfrowanie całego ruchu między klientem a serwerem. SSH obsługuje kilka metod uwierzytelniania: hasło, klucz publiczny (asymetryczny, np. RSA lub Ed25519) oraz uwierzytelnianie dwuskładnikowe. Klucz publiczny umożliwia logowanie bez hasła, co jest powszechnie stosowane w automatyzacji i skryptach administratorskich.

Oprócz zdalnej powłoki SSH oferuje zaawansowane funkcje: tunelowanie portów (forwarding lokalny, zdalny i dynamiczny), tworzenie bezpiecznych tuneli dla innych protokołów (np. VNC przez SSH), oraz wbudowany transfer plików przez SFTP i SCP. W nowoczesnych sieciach korporacyjnych dostęp Telnet jest domyślnie wyłączony, a SSH jest jedynym dopuszczalnym protokołem zdalnego zarządzania.

49/55 SNMP – Simple Network Management Protocol

SNMP – monitoring i zarządzanie (RFC 1157, UDP 161/162)

SNMP (Simple Network Management Protocol) zdefiniowany w RFC 1157 służy do monitorowania i zarządzania urządzeniami sieciowymi.
  • Model: manager-agent, UDP port 161 (zapytania) i 162 (trapy)
  • MIB (Management Information Base) – hierarchiczna baza danych definiująca parametry urządzenia
  • OID – unikalny identyfikator parametru (np. liczba odebranych bajtów na interfejsie)

SNMP występuje w trzech głównych wersjach: SNMPv1 (RFC 1157) z podstawowym uwierzytelnianiem przez community string przesyłanym jawnym tekstem, SNMPv2c z rozszerzonymi operacjami (np. GETBULK do masowego pobierania danych) i ulepszonym formatem komunikatów, oraz SNMPv3 z pełnym szyfrowaniem, uwierzytelnianiem i kontrolą dostępu (USM – User-based Security Model). SNMPv3 jest zalecany w środowiskach produkcyjnych, choć wiele starszych urządzeń obsługuje tylko v2c.

Hierarchiczna baza MIB (Management Information Base) ma strukturę drzewiastą zgodną z normą ISO, a każdy parametr sieciowy ma unikalny identyfikator OID (Object Identifier). Przykładowo OID .1.3.6.1.2.1.2.2.1.10 odpowiada licznikowi odebranych bajtów na interfejsie sieciowym (ifInOctets). Narzędzia takie jak MRTG lub Cacti regularnie odczytują te OID-y i tworzą wykresy obciążenia sieci.

SNMP umożliwia nie tylko odczyt, ale również zapis parametrów konfiguracyjnych (operacja SET) oraz asynchroniczne powiadomienia (trapy i inform) o zdarzeniach, takich jak awaria interfejsu czy przeciążenie procesora. Protokół znajduje zastosowanie w monitorowaniu sieci (Nagios, Zabbix), zarządzaniu energią w UPS oraz konfiguracji stacji bazowych w sieciach ISP.

50/55 DHCP i DNS jako protokoły warstwy aplikacji

DHCP (UDP 67/68) i DNS (UDP 53/TCP 53) – fundament sieci IP

DHCP (UDP 67/68) automatyzuje konfigurację IP hostów – bez działającego DHCP host nie otrzyma adresu IP ani serwera DNS.

DNS (UDP 53/TCP 53) tłumaczy nazwy na adresy IP. Bez DNS niemożliwe jest korzystanie z HTTP.

Zarówno DHCP, jak i DNS są klasyfikowane jako protokoły warstwy aplikacji modelu TCP/IP, ponieważ korzystają z usług warstwy transportowej (UDP) i są realizowane przez procesy użytkownika (serwery i klienty). DHCP używa portów UDP 67 (serwer) i 68 (klient), a DNS domyślnie portu UDP 53 dla standardowych zapytań oraz TCP 53 dla transferów stref. Połączenie TCP jest używane także wtedy, gdy klient nie obsługuje rozszerzenia EDNS0, a odpowiedź jest zbyt długa, aby zmieścić się w pakiecie UDP (serwer ustawia wtedy flagę TC – truncation, a klient ponawia zapytanie na TCP).

Rola tych protokołów w stosie TCP/IP jest fundamentalna: bez DHCP host nie otrzymuje adresu IP, maski podsieci, bramy domyślnej ani serwera DNS, co czyni go praktycznie odciętym od sieci. Bez DNS użytkownik musiałby znać adres IP każdej odwiedzanej strony, co w przypadku IPv6 jest całkowicie niepraktyczne ze względu na długość i skomplikowany format adresów.

W systemie operacyjnym oba protokoły są implementowane przez usługi systemowe: w systemie Windows są to usługi DHCP Client i DNS Client (ta druga utrzymuje lokalny cache), a w systemach Linux odpowiednio dhclient lub NetworkManager oraz systemd-resolved lub BIND w roli resolwera. Ich poprawne działanie jest warunkiem koniecznym dla wszystkich wyższych usług sieciowych, takich jak HTTP czy FTP.

51/55 Przykład – pełny przepływ HTTP z DHCP i DNS

Przepływ: DHCP DORA → DNS → HTTP GET → NAT

Pełny przepływ ilustruje współdziałanie wszystkich omawianych usług – od włączenia hosta do wyświetlenia strony.
  • 1. DHCP: Discover → Offer → Request → ACK – host otrzymuje adres IP, bramę i DNS
  • 2. DNS: zapytanie o www.example.com → odpowiedź 93.184.216.34
  • 3. HTTP: przeglądarka łączy się z serwerem na TCP 80 (HTTP GET)
  • 4. NAT: router zamienia źródłowy adres prywatny na publiczny

Gdy użytkownik włącza komputer w sieci domowej, karta sieciowa wysyła broadcast DHCP Discover, na który router odpowiada ofertą DHCP Offer z adresem z puli 192.168.1.0/24. Host akceptuje ofertę przez DHCP Request, a router potwierdza przydział komunikatem DHCP ACK, przekazując również adres bramy domyślnej (192.168.1.1) i serwera DNS (np. 8.8.8.8). Od tego momentu host ma pełną łączność sieciową.

Użytkownik wpisuje w przeglądarce adres www.example.com. System najpierw sprawdza lokalny cache DNS i plik hosts, a następnie wysyła zapytanie rekurencyjne do serwera DNS dostawcy. Serwer DNS, jeśli nie ma odpowiedzi w cache, wykonuje zapytanie iteracyjne: pyta serwer główny, który kieruje do serwera TLD .com, a ten do autorytatywnego serwera example.com, który zwraca adres IP 93.184.216.34.

Przeglądarka nawiązuje połączenie TCP z serwerem na porcie 80 (HTTP) i wysyła żądanie GET z nagłówkami. Router wykonuje NAT (konkretnie PAT), zamieniając źródłowy adres prywatny hosta na publiczny adres interfejsu WAN oraz przydzielając unikalny port źródłowy. Odpowiedź serwera wraca na router, który na podstawie tablicy translacji przekierowuje ją do właściwego hosta w sieci wewnętrznej.

52/55 Pytania kontrolne

Pytania kontrolne – sprawdź swoją wiedzę

  • 1. Opisz sekwencję DORA
  • 2. Różnica między rekordem A a AAAA
  • 3. SNAT vs DNAT
  • 4. Port Forwarding
  • 5. HTTP vs HTTPS
  • 6. Telnet vs SSH

Sekwencja DORA to czteroetapowy proces przydziału adresu IP: Discover (klient szuka serwera broadcastem), Offer (serwer oferuje adres), Request (klient akceptuje ofertę), ACK (serwer potwierdza). Każdy krok ma zdefiniowane formaty pakietów i znaczniki czasowe, a w przypadku braku odpowiedzi klient ponawia próby z wykładniczo rosnącym interwałem.

Rekord A mapuje nazwę domenową na adres IPv4 (32 bity), natomiast rekord AAAA (cztery razy A) mapuje nazwę na adres IPv6 (128 bitów). Oba rekordy mogą współistnieć w tej samej strefie, co pozwala serwerom obsługiwać klientów zarówno starszych, jak i nowszych sieci. W przypadku dostępności obu adresów system wybiera IPv6, jeśli jest obsługiwany.

SNAT (Source NAT) zmienia adres źródłowy pakietów wychodzących z sieci prywatnej na publiczny, co umożliwia hostom wewnętrznym dostęp do Internetu. DNAT (Destination NAT) zmienia adres docelowy pakietów przychodzących z Internetu, kierując je do konkretnego hosta w sieci prywatnej – to podstawa Port Forwarding. HTTP przesyła dane w formacie jawnym, podczas gdy HTTPS dodaje szyfrowanie TLS.

53/55 Najważniejsze wnioski

Cztery bloki: DHCP, DNS, NAT, protokoły aplikacji

  • DHCP → DORA, lease, scope, exclusion, reservation, relay, snooping
  • DNS → hierarchia (root, TLD, domena), rekordy (A, AAAA, CNAME, MX, NS, TXT, PTR), DNSSEC
  • NAT → SNAT, DNAT, PAT, Port Forwarding
  • Protokoły: HTTP/HTTPS, FTP, SMTP/POP3/IMAP, SSH, SNMP

Usługi DHCP, DNS i NAT są ze sobą silnie powiązane i współpracują przy każdym połączeniu internetowym. DHCP dostarcza hostowi adres IP, bramę i serwer DNS, DNS tłumaczy nazwę domenową na adres IP docelowego serwera, NAT umożliwia komunikację między siecią prywatną a Internetem, a protokoły warstwy aplikacji realizują właściwą wymianę danych. Bez choćby jednego z tych elementów typowe działanie sieci nie byłoby możliwe.

Protokoły warstwy aplikacji, takie jak HTTP, HTTPS, FTP, SMTP i SSH, różnią się przeznaczeniem, używanymi portami oraz wymaganiami bezpieczeństwa. HTTP i HTTPS służą do przeglądania stron WWW, FTP do przesyłania plików, SMTP wraz z POP3/IMAP do obsługi poczty elektronicznej, a SSH do zdalnego zarządzania. Każdy z tych protokołów może działać samodzielnie, ale ich efektywne wykorzystanie wymaga sprawnego DHCP i DNS.

Znajomość tych protokołów jest niezbędna dla każdego administratora sieci. W codziennej pracy przydaje się umiejętność diagnozowania problemów z DHCP (brak adresu IP), DNS (błędna odpowiedź lub jej brak), NAT (brak dostępu do Internetu) oraz protokołów aplikacji (błędy HTTP, problemy z pocztą). Narzędzia takie jak Wireshark, tcpdump, ping i traceroute pomagają w lokalizacji i rozwiązywaniu tych problemów.

54/55 Pytania kontrolne rozszerzone

Pytania kontrolne rozszerzone – zaawansowane zagadnienia

  • 1. APIPA (169.254.x.x) – adresacja awaryjna, gdy DHCP jest nieosiągalny
  • 2. DNS używa UDP dla szybkości, TCP przy odpowiedziach przekraczających 512 bajtów oraz przy transferze stref
  • 3. Limit hostów za PAT – teoretycznie 65535, praktycznie kilkanaście tysięcy
  • 4. Rekurencyjne (oczekuje pełnej odpowiedzi) vs iteracyjne (odsyła do innego serwera)
  • 5. Protokoły warstwy aplikacji – porty i zastosowania

APIPA (Automatic Private IP Addressing) to mechanizm systemu Windows, który przydziela adres z zakresu 169.254.0.0/16, gdy serwer DHCP jest nieosiągalny. Adres APIPA umożliwia komunikację tylko w obrębie lokalnej podsieci, bez dostępu do Internetu – jest to rozwiązanie awaryjne, które informuje użytkownika o problemie z DHCP przez brak łączności sieciowej.

DNS domyślnie używa UDP na porcie 53, ponieważ zapytania są krótkie (zwykle poniżej 512 bajtów) i nie wymagają nawiązywania połączenia, co zapewnia szybkość. TCP na porcie 53 jest używany, gdy serwer ustawi flagę przycięcia (TC), informując, że odpowiedź nie zmieści się w wynegocjowanym pakiecie UDP (np. przy rekordach DNSSEC i klientach bez EDNS0), oraz podczas transferu strefy między autorytatywnymi serwerami DNS, gdzie niezawodność TCP jest kluczowa.

Limit hostów za PAT wynika z liczby dostępnych portów TCP/UDP (65535), ale w praktyce jest niższy z powodu ograniczeń pamięci routera i czasu trwania połączeń. Dodatkowo protokoły takie jak SIP (VoIP) czy FTP Active mają problemy z działaniem przez PAT, ponieważ przenoszą informacje o adresach IP w danych, a nie w nagłówkach – wymagają one specjalnych modułów ALG (Application Layer Gateway) w routerze.

55/55 Podsumowanie

DHCP + DNS + NAT = fundament sieci IP

Prezentacja przedstawiła cztery kluczowe usługi sieciowe: DHCP, DNS, NAT i protokoły warstwy aplikacji.
  • DHCP – automatyzacja konfiguracji hostów przez DORA z czasem dzierżawy
  • DNS – hierarchiczny system rozwiązywania nazw niezbędny dla HTTP i poczty
  • NAT – translacja adresów IP prywatnych na publiczne (SNAT, DNAT, PAT)
  • Protokoły: HTTP/HTTPS, FTP, SMTP/POP3/IMAP, SSH, SNMP

DHCP stanowi fundament automatyzacji konfiguracji sieciowej – bez niego każda zmiana podsieci wymagałaby ręcznej rekonfiguracji setek urządzeń. DORA, czas dzierżawy, scope i relay to mechanizmy, które czynią DHCP niezastąpionym w sieciach dowolnej wielkości. Nawet w sieciach IPv6 istnieje odpowiednik w postaci DHCPv6 oraz SLAAC (Stateless Address Autoconfiguration).

DNS jest często nazywany książką telefoniczną Internetu, ale jego rola jest znacznie szersza: rekordy MX kierują pocztę, NS delegują strefy, TXT przenoszą informacje uwierzytelniające (SPF, DKIM, DMARC), a CNAME umożliwia tworzenie aliasów. DNSSEC dodaje podpisy cyfrowe chroniące przed fałszowaniem odpowiedzi, co jest kluczowe w walce z atakami phishingowymi i DNS spoofingiem.

NAT i PAT pozostają niezbędne w erze wyczerpania adresów IPv4, ale docelowym rozwiązaniem jest IPv6, które przywraca zasadę end-to-end i eliminuje potrzebę translacji. Protokoły warstwy aplikacji (HTTP/HTTPS, FTP, SMTP, SSH, SNMP) stanowią interfejs między użytkownikiem a siecią – ich zrozumienie jest kluczowe dla projektowania, konfiguracji i diagnozowania nowoczesnych sieci komputerowych.