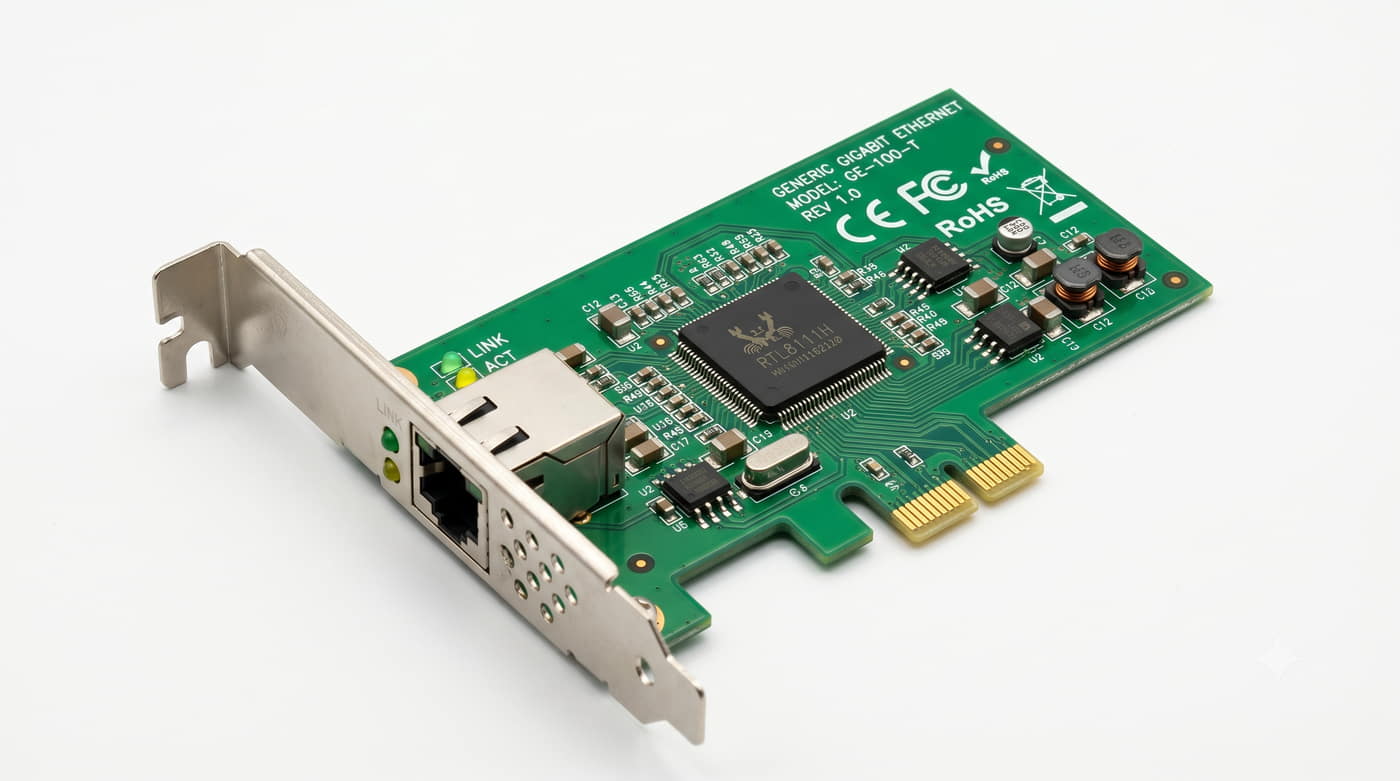
1/23 Karta sieciowa PCI Express (PCIe) – budowa i konfiguracja

Nowoczesna karta NIC dla magistrali PCI Express

Prezentacja przedstawia budowę i działanie karty sieciowej PCI Express (PCIe NIC).

Omawiamy interfejs PCIe (szeregowy, point-to-point), kontrolery MAC/PHY dla Gigabit Ethernet (RTL8111, Intel I210), funkcje offload (TSO, RSS, checksum offload), konfigurację w Linux oraz zaawansowane scenariusze (SR-IOV, DPDK).

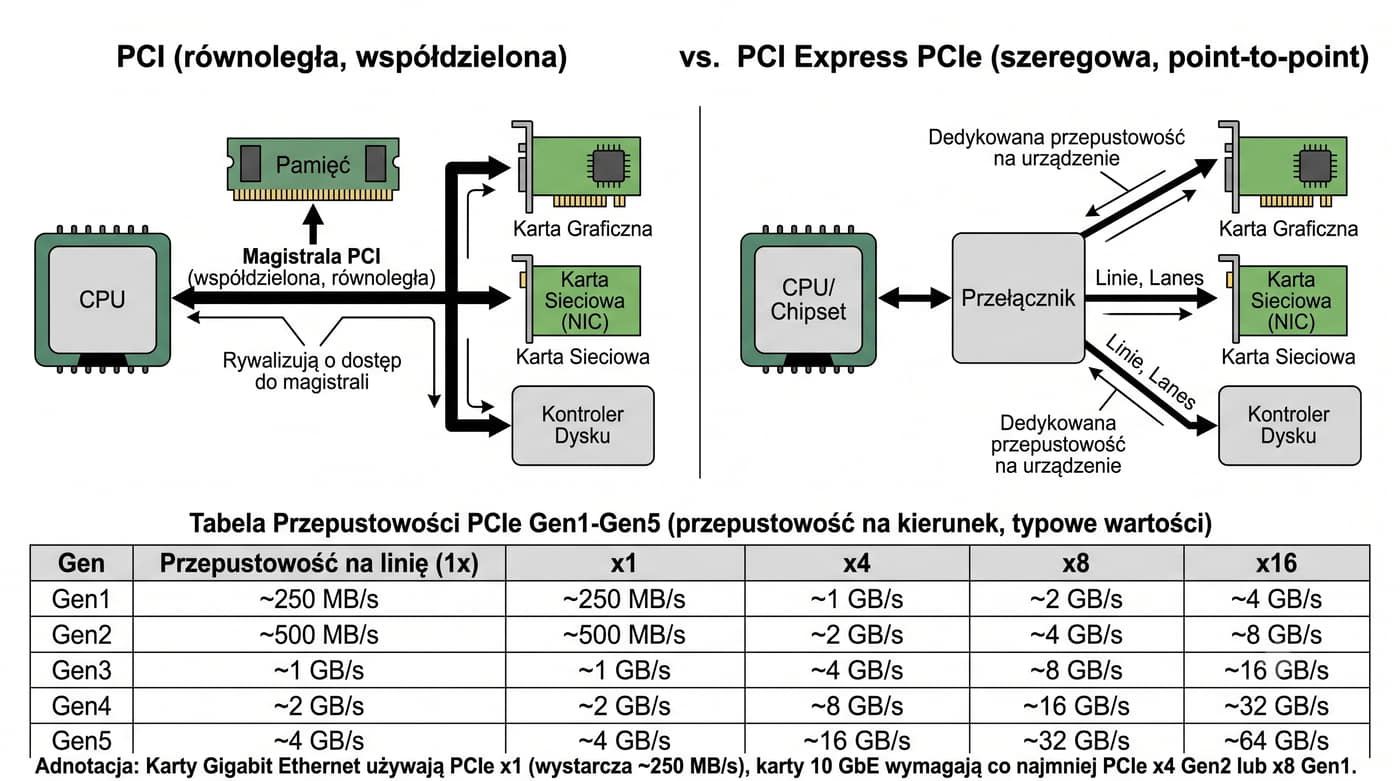
Magistrala PCI Express (PCIe) jest następcą PCI i PCI-X.

Wprowadza szeregowe łącza różnicowe typu point-to-point, które zastępują współdzieloną równoległą magistralę PCI.

Każda linia (lane) PCIe składa się z dwóch par różnicowych (nadawanie i odbiór), co umożliwia transmisję pełnego dupleksu.

Karty sieciowe PCI Express oferują przepustowość od 1 Gbps (Gigabit Ethernet) do 100 Gbps i wyższych.

W przeciwieństwie do kart PCI, karty PCIe mogą być hot-plug (wymiana bez wyłączania komputera) oraz posiadają zaawansowane funkcje wirtualizacji (SR-IOV) i odciążania CPU (offload).

W ramach wykładu omówimy również konfigurację zaawansowanych funkcji NIC w systemie Linux (ethtool, tc, RSS) oraz na przełącznikach Cisco.

2/23 Magistrala PCI Express – architektura i przepustowość

Szeregowa magistrala różnicowa point-to-point

PCIe GenPrzepustowość na lane (1x)x1x4x8x16
Gen 1 (2003)250 MB/s (2.5 GT/s)2501 GB/s2 GB/s4 GB/s
Gen 2 (2007)500 MB/s (5 GT/s)5002 GB/s4 GB/s8 GB/s
Gen 3 (2010)1 GB/s (8 GT/s)14 GB/s8 GB/s16 GB/s
Gen 4 (2017)2 GB/s (16 GT/s)28 GB/s16 GB/s32 GB/s
Gen 5 (2019)4 GB/s (32 GT/s)416 GB/s32 GB/s64 GB/s
Karty Gigabit Ethernet używają PCIe x1 (wystarcza 250 MB/s). Karty 10 GbE wymagają PCIe x4 Gen2 lub x8 Gen1.

Karty 40/100 GbE wymagają PCIe x16 Gen3 lub Gen4.

Każdy TLP zawiera nagłówek, dane i sumę kontrolną CRC.

PCI Express to magistrala szeregowa, w której dane są przesyłane za pomocą par różnicowych (dwa przewody na kierunek).

Zegar jest kodowany w sygnale (embedded clock), co eliminuje problemy ze synchronizacją typowe dla równoległych magistral PCI.

Każda linia (lane) PCIe oferuje przepustowość 250 MB/s w każdą stronę dla Gen1, 500 MB/s dla Gen2 i 1 GB/s dla Gen3.

Karty sieciowe Gigabit Ethernet (1 Gbps = 125 MB/s) z łatwością mieszczą się w jednej linii PCIe Gen1 (250 MB/s).

Karty 10 GbE (10 Gbps = 1250 MB/s) wymagają PCIe x4 Gen2 (2 GB/s) lub PCIe x8 Gen1 (2 GB/s).

Ważną cechą PCIe jest użycie pakietów (Transaction Layer Packets – TLP) do transmisji danych zamiast współdzielonej magistrali.

Przełączniki PCIe (switch) przekazują pakiety między urządzeniami, tworząc topologię drzewa.

Rodzaje pakietów TLP w PCIe: Memory (odczyt/zapis pamięci), I/O (dostęp do portów), Configuration (konfiguracja urządzeń), Message (przerwania MSI/MSI-X, zarządzanie energią).

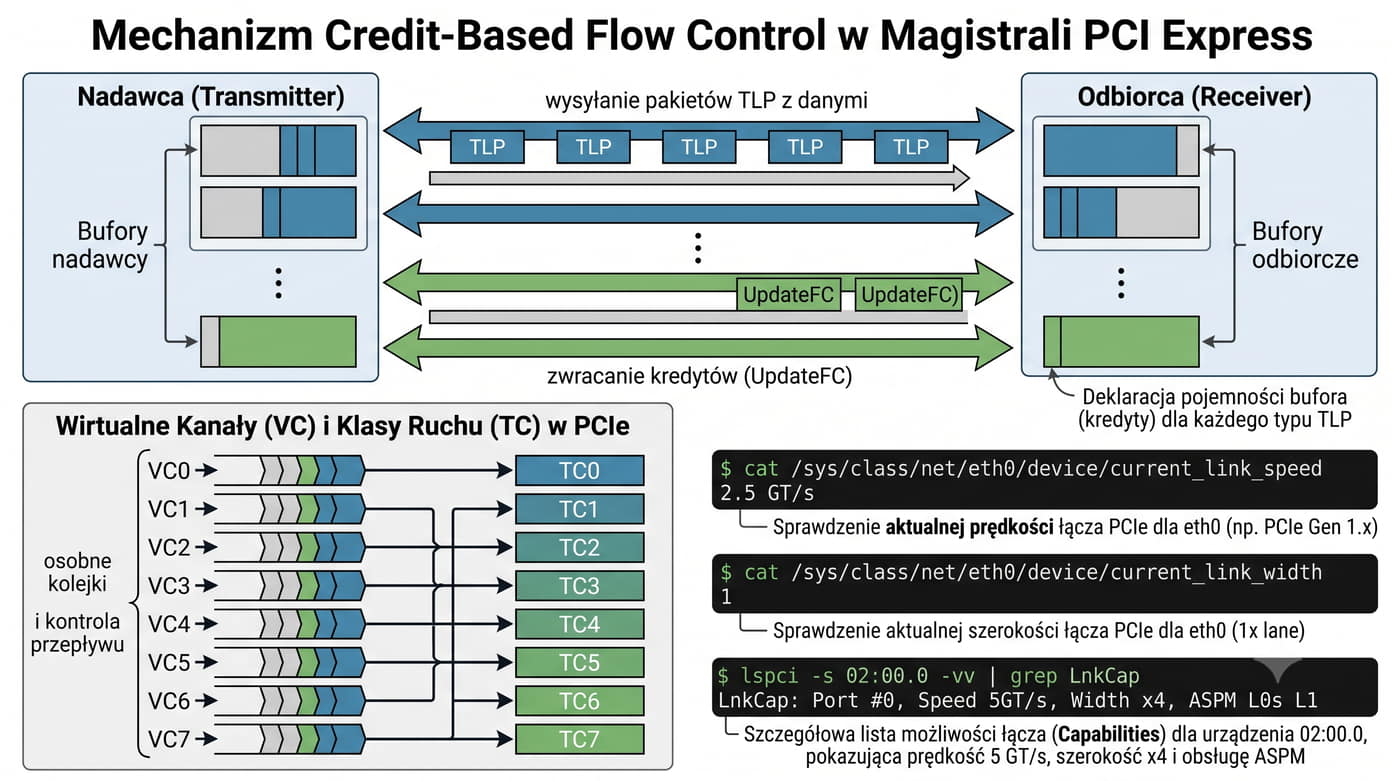
PCIe stosuje protokół przepływu oparty na kredytach (credit-based flow control). Każde urządzenie na początku deklaruje pojemność swoich buforów (kredyty), a nadawca może wysyłać tylko tyle, na ile ma kredyty.

Wirtualne kanały (Virtual Channels – VC) pozwalają na tworzenie do 8 niezależnych ścieżek komunikacyjnych (VC0-VC7) z osobnymi kolejkami i niezależną kontrolą przepływu. Klasy ruchu (Traffic Classes – TC0-TC7) mapowane są na VC, co umożliwia QoS na poziomie magistrali PCIe.

PCIe obsługuje również kolejność transakcji (Transaction Ordering) – reguły określające, które pakiety mogą wyprzedzać inne (np. zapisy mogą wyprzedzać odczyty w celu poprawy wydajności).
3/23 Kontrolery sieciowe PCI Express – RTL8111, Intel I210

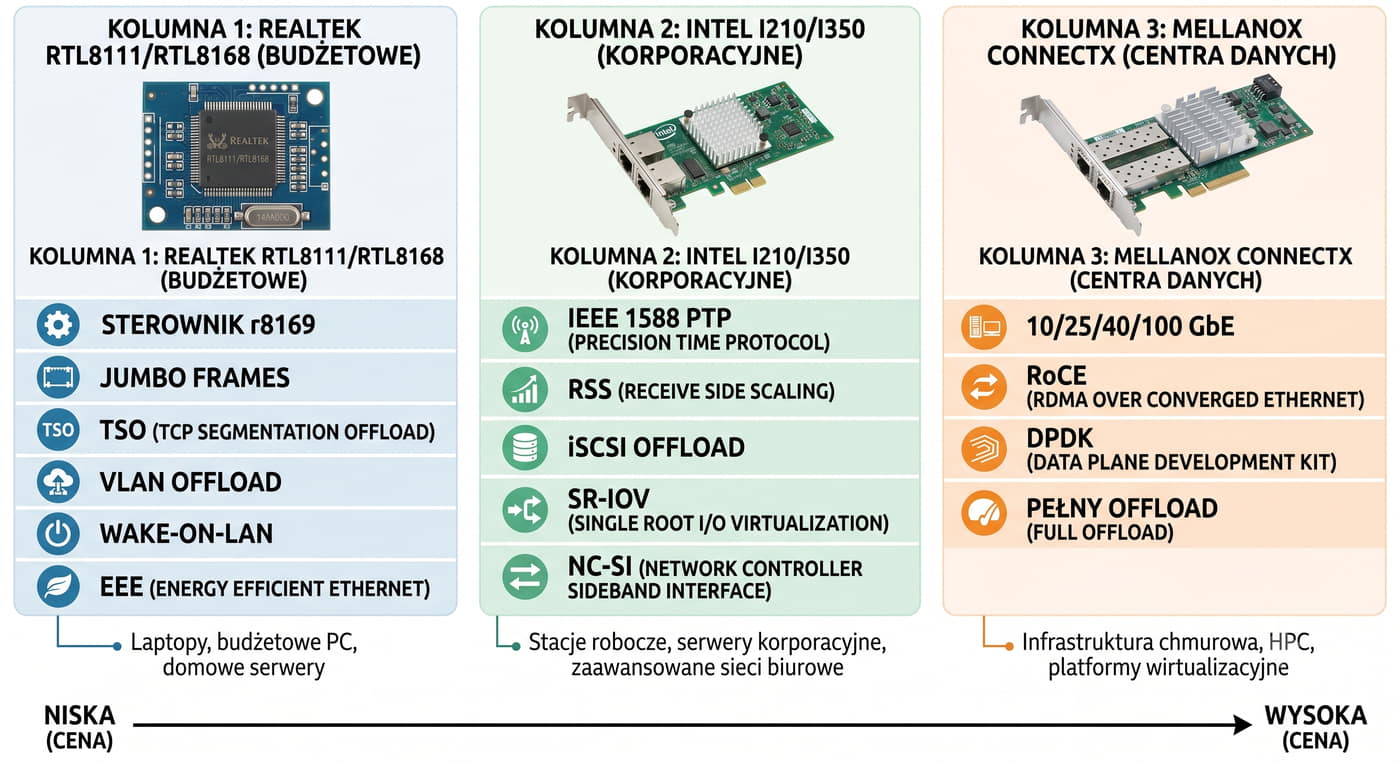
Współczesne układy MAC/PHY dla PCIe

  • Realtek RTL8111 / RTL8168: Gigabit Ethernet PCIe x1, sterownik r8169, obsługa jumbo frames (9 KB), TSO, VLAN offload, Wake-on-LAN, EEE (Energy Efficient Ethernet).
  • Intel I210: Zaawansowany kontroler z obsługą IEEE 1588 (PTP – Precision Time Protocol), RSS (Receive Side Scaling), iSCSI boot (rozruch przez iSCSI).
  • Intel I350: Rozszerzona wersja z dodatkową obsługą SR-IOV, NC-SI (management passthrough).
  • Mellanox ConnectX / Broadcom NetXtreme: Karty 10/25/40/100 GbE z pełną obsługą offload, RoCE (RDMA over Converged Ethernet), DPDK (Data Plane Development Kit).
Wybór kontrolera sieciowego PCIe ma kluczowe znaczenie dla wydajności i stabilności serwera.

Są niezbędne w środowiskach SDN i NFV.

Karty Realtek RTL8111 są powszechnie stosowane na płytach głównych konsumenckich – oferują podstawową funkcjonalność Gigabit Ethernet za niski koszt, ale mają ograniczone możliwości odciążania CPU.

Karty Intel I210 i I350 są standardem w serwerach korporacyjnych.

Oferują sprzętową obsługę RSS (równomierne rozłożenie ruchu sieciowego na wiele rdzeni CPU), TSO (odciążenie segmentacji TCP), a także obsługę VLAN i VXLAN w sprzęcie.

Intel I350 dodatkowo wspiera SR-IOV, umożliwiając wirtualizację karty sieciowej na wiele niezależnych funkcji wirtualnych (VF).

Karty Mellanox ConnectX są używane w zastosowaniach wymagających wysokiej przepustowości (HPC, centra danych).

Oferują obsługę RDMA (bezpośredni dostęp do pamięci zdalnej pomijający CPU) oraz DPDK (framework do szybkiego przetwarzania pakietów w przestrzeni użytkownika).

Intel E810 (Ethernet 800 Series): Karta 100/50/25 GbE z obsługą PCIe Gen4 x16, ADQ (Application Device Queues), VXLAN/GENEVE offload, PTP (IEEE 1588), iRDMA.

Mellanox ConnectX-6 (HDR, 200 GbE) / ConnectX-7 (NDR, 400 GbE): Karty z PCIe Gen4/5 x16, obsługą RoCEv2, VXLAN/GENEVE offload, SR-IOV (do 1000 VF), ASAP2 (accelerated switching).

Broadcom BCM575xx (NetXtreme E-Series): Karty 10/25/50/100 GbE z TrueFlow (programowalna pipeline), TruFlow, VXLAN/NVGRE offload, RoCE, DPDK.

4/23 Funkcje offload – odciążanie procesora głównego

Sprzętowe przyspieszanie przetwarzania pakietów

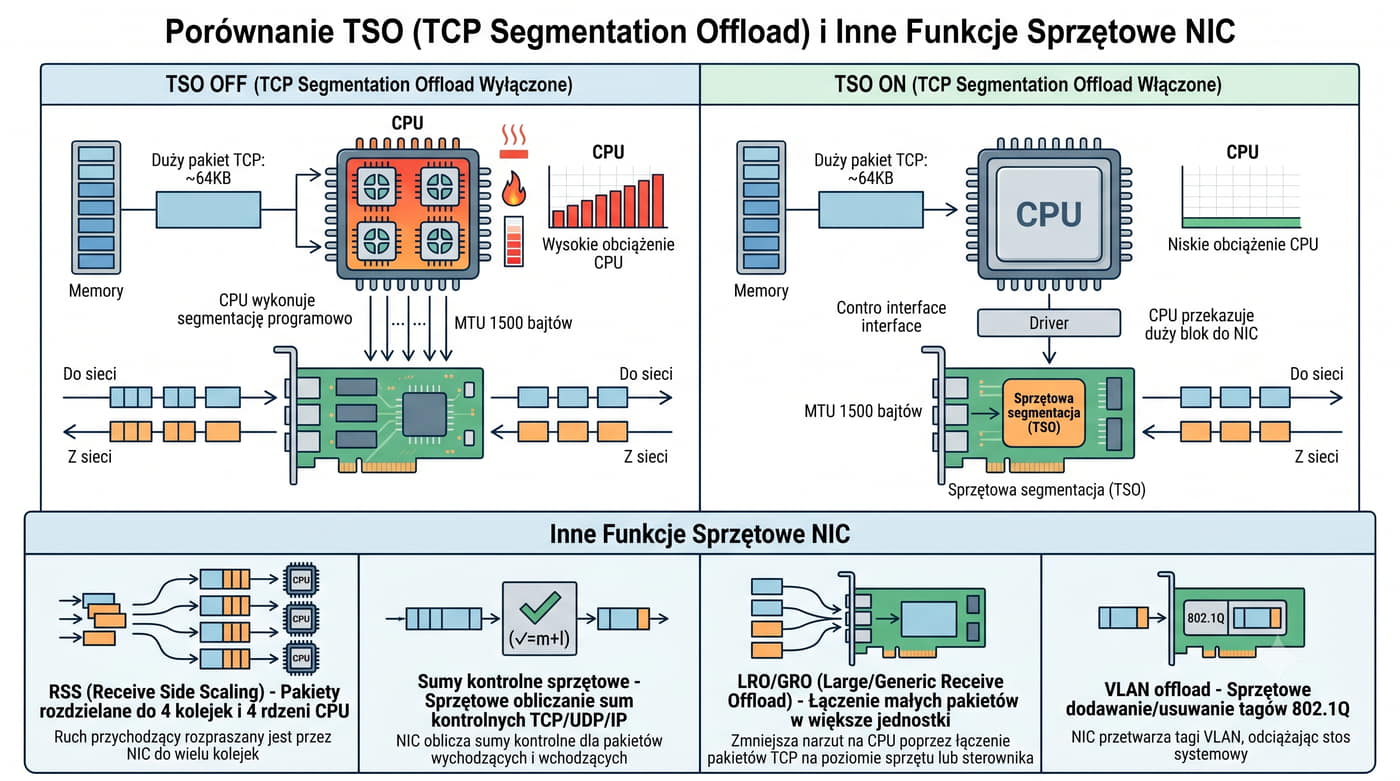
  • TSO (TCP Segmentation Offload): Karta dzieli duży pakiet TCP na mniejsze segmenty zgodne z MTU, odciążając CPU.
  • RSS (Receive Side Scaling): Karta rozdziela przychodzące pakiety na wiele kolejek Rx, kierowanych do różnych rdzeni CPU.
  • Checksum Offload: Sprzętowe obliczanie sum kontrolnych TCP/UDP/IP (Tx i Rx) – eliminuje obciążenie CPU.
  • LRO/GRO (Large Receive Offload): Łączenie małych pakietów w większe jednostki przed przekazaniem do stosu TCP/IP.
  • VLAN offload: Sprzętowe dodawanie/usuwanie tagów 802.1Q.
Jest to kluczowe dla osiągnięcia wysokiej przepustowości przy niskim opóźnieniu, szczególnie w serwerach obsługujących ruch 10 GbE i wyższy.

RSS (Receive Side Scaling) rozwiązuje problem skalowania odbioru na wielu rdzeniach CPU.

Karta oblicza hash z nagłówka pakietu (IP src/dst, port src/dst) i na jego podstawie kieruje pakiet do odpowiedniej kolejki Rx.

Każda kolejka jest obsługiwana przez inny rdzeń CPU, co pozwala na równoległe przetwarzanie ruchu.

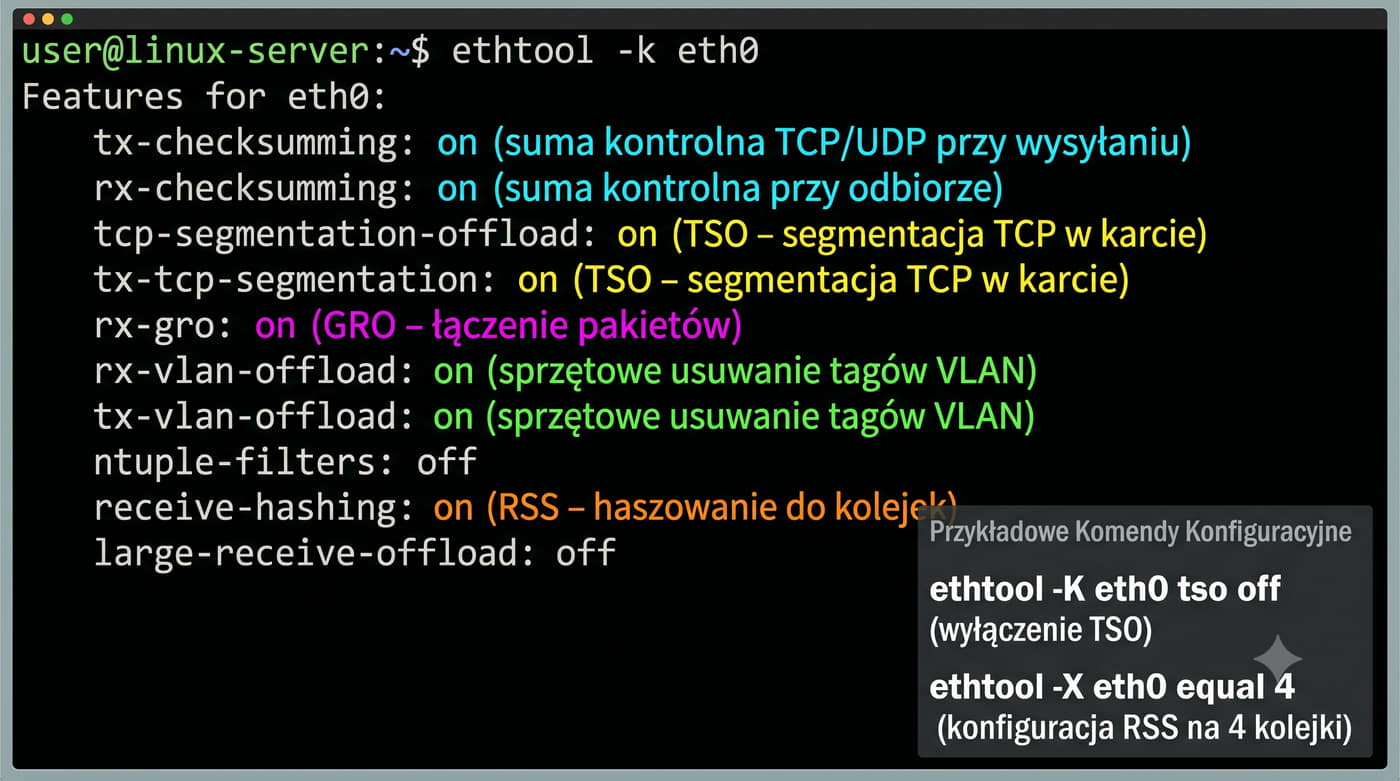
Stan funkcji offload można sprawdzić poleceniem ethtool -k eth0.

Funkcje offload w kartach sieciowych PCIe przenoszą zadania przetwarzania pakietów z CPU do sprzętu karty.

TSO (TCP Segmentation Offload) pozwala aplikacji wysłać duży blok danych (np. 64 KB) do karty, która dzieli go na mniejsze segmenty (zazwyczaj 1460 bajtów każdy) i dodaje nagłówki TCP/IP.

Bez TSO CPU musiałby wykonać tę segmentację, co przy szybkościach 10 GbE może konsumować znaczną część jego mocy obliczeniowej.

VXLAN offload: Sprzętowa enkapsulacja/dekapsulacja ramek VXLAN (RFC 7348) – karta dodaje/usuwa nagłówek VXLAN, UDP, IP i oblicza sumy kontrolne. Eliminuje obciążenie CPU w sieciach overlay chmur obliczeniowych.

NVGRE i GENEVE offload: Podobne do VXLAN offload – karta sprzętowo enkapsuluje pakiety w NVGRE (RFC 7637) lub GENEVE (RFC 8926). Wspólne oznaczenie w ethtool: tx-udp_tnl-segmentation, rx-udp_tnl-csum-offload.

IPSec offload: Sprzętowe szyfrowanie/deszyfrowanie ruchu IPsec (ESP/AH) bez angażowania CPU. Stosowane w routerach VPN nowej generacji i kartach z akceleratorem kryptograficznym.

ntuple-filters (Flow Director): Kierowanie wybranych strumieni (wg IP, portów, protokołu) do konkretnych kolejek RSS. Konfiguracja: ethtool -N eth0 flow-type tcp4 src-ip 10.0.0.1 dst-port 80 action 2.

5/23 Konfiguracja offload w Linux – ethtool -k

Zarządzanie funkcjami odciążania karty sieciowej

# Wyświetlenie bieżących ustawień offload
ethtool -k eth0
Features for eth0:
tx-checksumming: on
rx-checksumming: on
tcp-segmentation-offload: on
tx-tcp-segmentation: on
rx-gro: on
rx-vlan-offload: on
tx-vlan-offload: on
ntuple-filters: off
rx-ntuple-filter: off
receive-hashing: on
large-receive-offload: off

# Wyłączenie TSO (przydatne do diagnostyki)
ethtool -K eth0 tso off

# Włączenie RSS - wybór schematu haszowania
ethtool -X eth0 hkey b8:a9:...
ethtool -X eth0 equal 4

Polecenie ethtool -k (lub ethtool --show-features) wyświetla listę wszystkich funkcji offload obsługiwanych przez kartę sieciową wraz z ich bieżącym stanem (on/off).

W zależności od modelu karty i sterownika lista może zawierać od kilku do kilkudziesięciu pozycji.

Wyłączenie TSO (ethtool -K eth0 tso off) może być przydatne w diagnostyce problemów sieciowych – jeśli problem znika po wyłączeniu TSO, może to wskazywać na błąd w sterowniku lub karcie.

Wyłączenie checksum offload bywa konieczne w przypadku niektórych sieci VPN lub tuneli.

RSS (Receive Side Scaling) konfiguruje się poleceniem ethtool -X.

Opcja equal 4 rozkłada ruch na 4 kolejki (i tym samym 4 rdzenie CPU).

Można też ustawić niestandardowy klucz haszowania (hkey) dla lepszego rozłożenia ruchu.

W systemach z wieloma rdzeniami RSS jest krytyczny dla wydajności odbioru.

6/23 SR-IOV – wirtualizacja karty sieciowej

Single Root I/O Virtualization – jedna karta, wiele maszyn wirtualnych

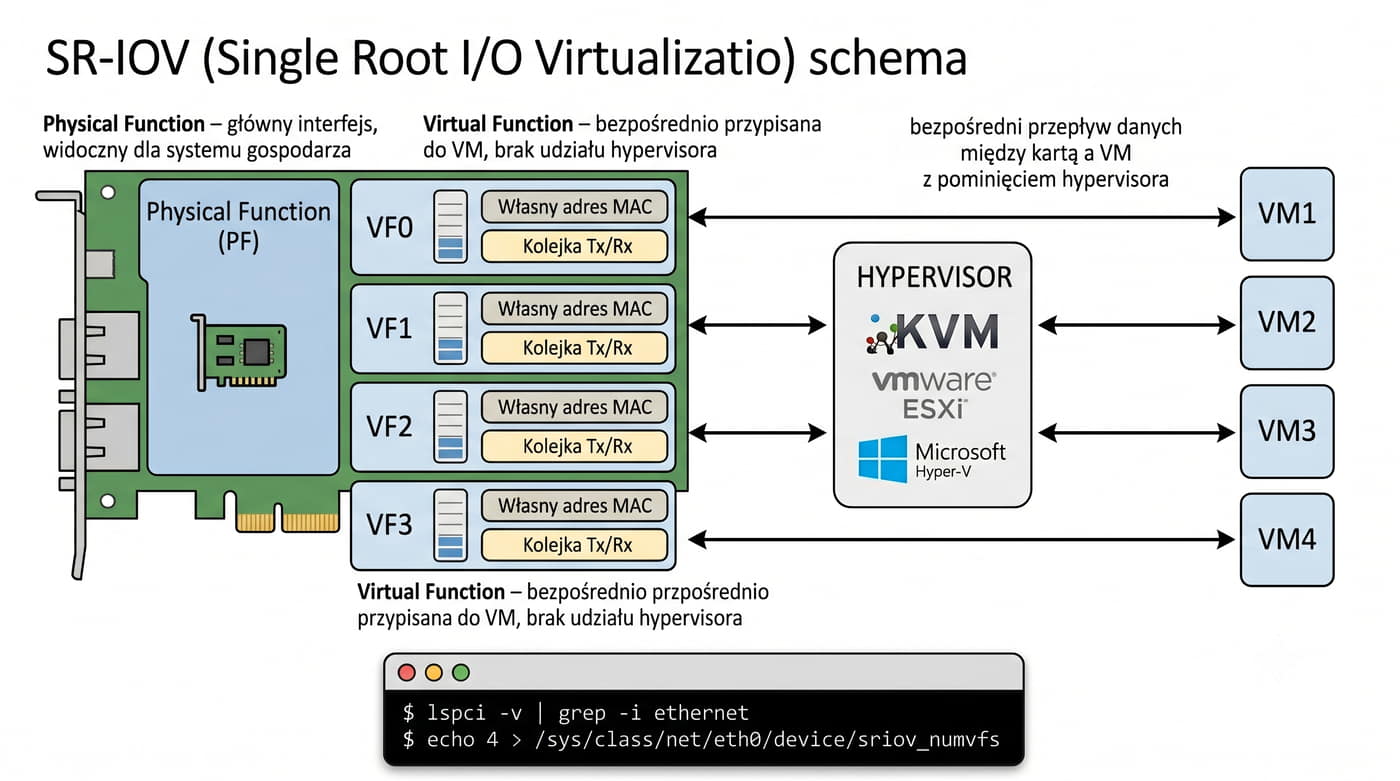
  • PF (Physical Function): Główna funkcja karty – widoczna dla systemu operacyjnego jako standardowy interfejs.
  • VF (Virtual Function): Lekkie funkcje wirtualne – każda VF ma własny adres MAC, kolejkę Tx/Rx i może być przypisana bezpośrednio do maszyny wirtualnej (VM).
  • Przepustowość: Sprzętowa izolacja – VF-y nie obciążają hypervisora, a ruch między VM nie wymaga softwarowego przełącznika.
# Sprawdzenie obsługi SR-IOV
lspci -v | grep -i ethernet
# Włączenie VF: 4 funkcje wirtualne
echo 4 > /sys/class/net/eth0/device/sriov_numvfs
# Każda VF jest widoczna jako osobny interfejs sieciowy (np. enp0s0f0, enp0s0f1)

W przypadku SR-IOV hypervisor (np. KVM, VMware ESXi, Hyper-V) nie uczestniczy w przetwarzaniu pakietów sieciowych między VM a kartą.

Jest to kluczowe w środowiskach NFV (Network Function Virtualization) i chmurach obliczeniowych.

Karta Intel I350 obsługuje do 8 VF, a karty Mellanox ConnectX-5 do 512 VF.

W systemie Linux VF są widoczne jako osobne interfejsy sieciowe, które można przypisać do maszyn wirtualnych za pomocą PCI passthrough (vfio-pci).

Polecenie ip link show pokazuje PF i VF jako oddzielne urządzenia.

SR-IOV (Single Root I/O Virtualization) to standard PCI-SIG definiujący mechanizm wirtualizacji urządzeń PCIe na poziomie sprzętowym.

Pozwala jednej fizycznej karcie sieciowej PCIe na udostępnienie wielu lekkich funkcji wirtualnych (VF), które mogą być bezpośrednio przypisane do maszyn wirtualnych.

Każda VF posiada własną pamięć, deskryptory pakietów oraz adres MAC, co zapewnia izolację i wysoką wydajność (linerate throughput).

7/23 DPDK – szybkie przetwarzanie pakietów w przestrzeni użytkownika

Data Plane Development Kit – bypass jądra systemu operacyjnego

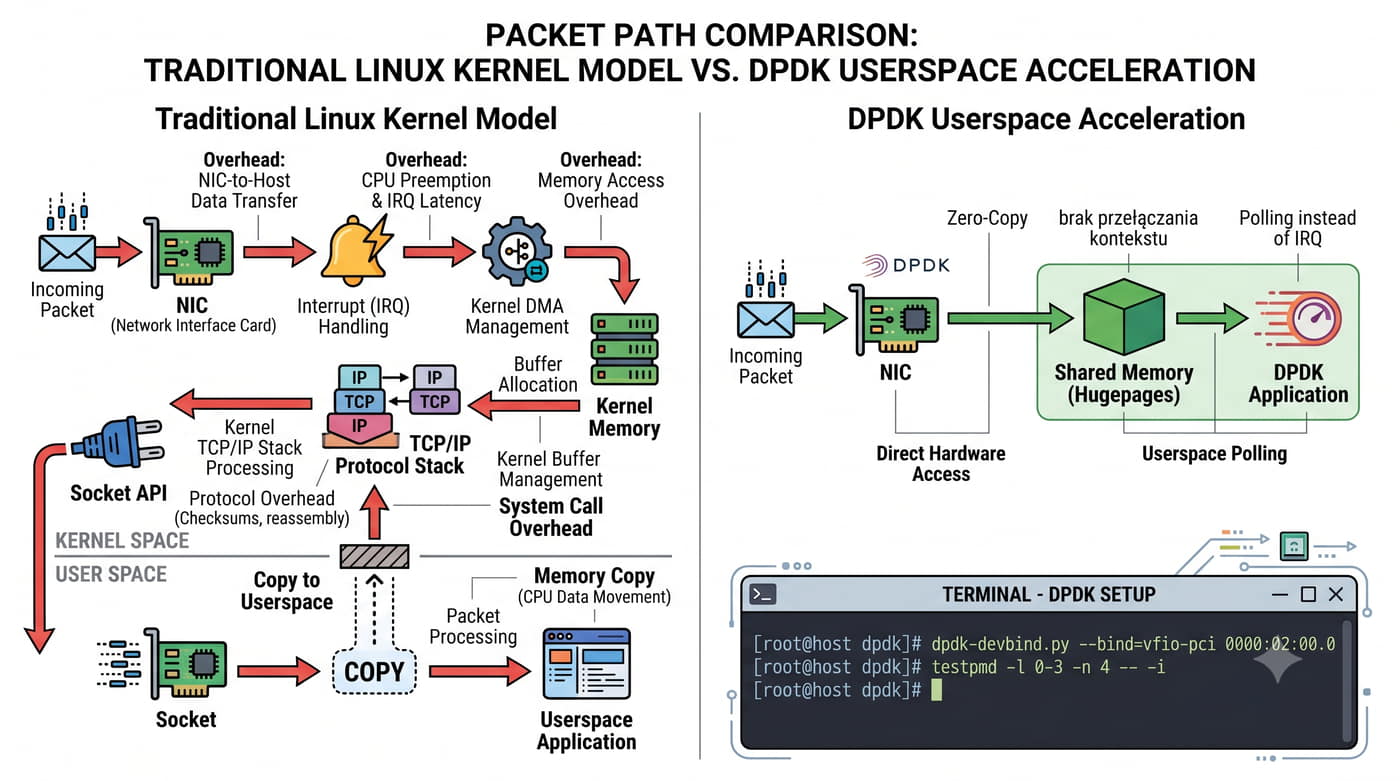
  • Zasada DPDK: Aplikacja działa w przestrzeni użytkownika (userspace) i uzyskuje bezpośredni dostęp do karty PCIe przez sterownik vfio-pci lub uio-pci-generic.
  • Zalety: Brak przełączania kontekstu między jądrem a aplikacją, brak kopiowania danych (zero-copy), stałe sondowanie (polling) zamiast przerwań.
  • Zastosowania: Routery programowalne, firewalle nowej generacji (NGFW), vSwitch (Open vSwitch z DPDK), 5G UPF.
# Powiązanie karty ze sterownikiem DPDK
dpdk-devbind.py --bind=vfio-pci 0000:02:00.0
# Test przepustowości z DPDK
testpmd -l 0-3 -n 4 -- -i

DPDK (Data Plane Development Kit), rozwijany przez fundację Linux Foundation, to zestaw bibliotek i sterowników umożliwiających szybkie przetwarzanie pakietów w przestrzeni użytkownika.

DPDK eliminuje narzut związany z obsługą przerwań i kopiowaniem danych między jądrem a aplikacją.

W tradycyjnym modelu jądra pakiet przechodzi przez: kartę → przerwanie IRQ → sterownik DMA → pamięć jądra → stos sieciowy → gniazdo (socket) → kopia do przestrzeni użytkownika.

DPDK redukuje tę ścieżkę do: karta → pamięć współdzielona (hugepages) → aplikacja (polling z pierścienia DMA).

DPDK najczęściej wykorzystuje karty sieciowe ze wsparciem dla wielu kolejek (RSS, Flow Director) i SR-IOV, choć działa również na prostszych kartach w trybie podstawowym.

Karty Intel I210/I350 oraz Mellanox ConnectX są powszechnie używane w środowiskach DPDK.

Biblioteka oferuje również funkcje QoS, kryptografii sprzętowej, kompresji i synchronizacji czasu (IEEE 1588).

8/23 Zaawansowana konfiguracja NIC w Linux – ip, tc, bond

Agregacja łączy (bonding), QoS, przestrzenie nazw

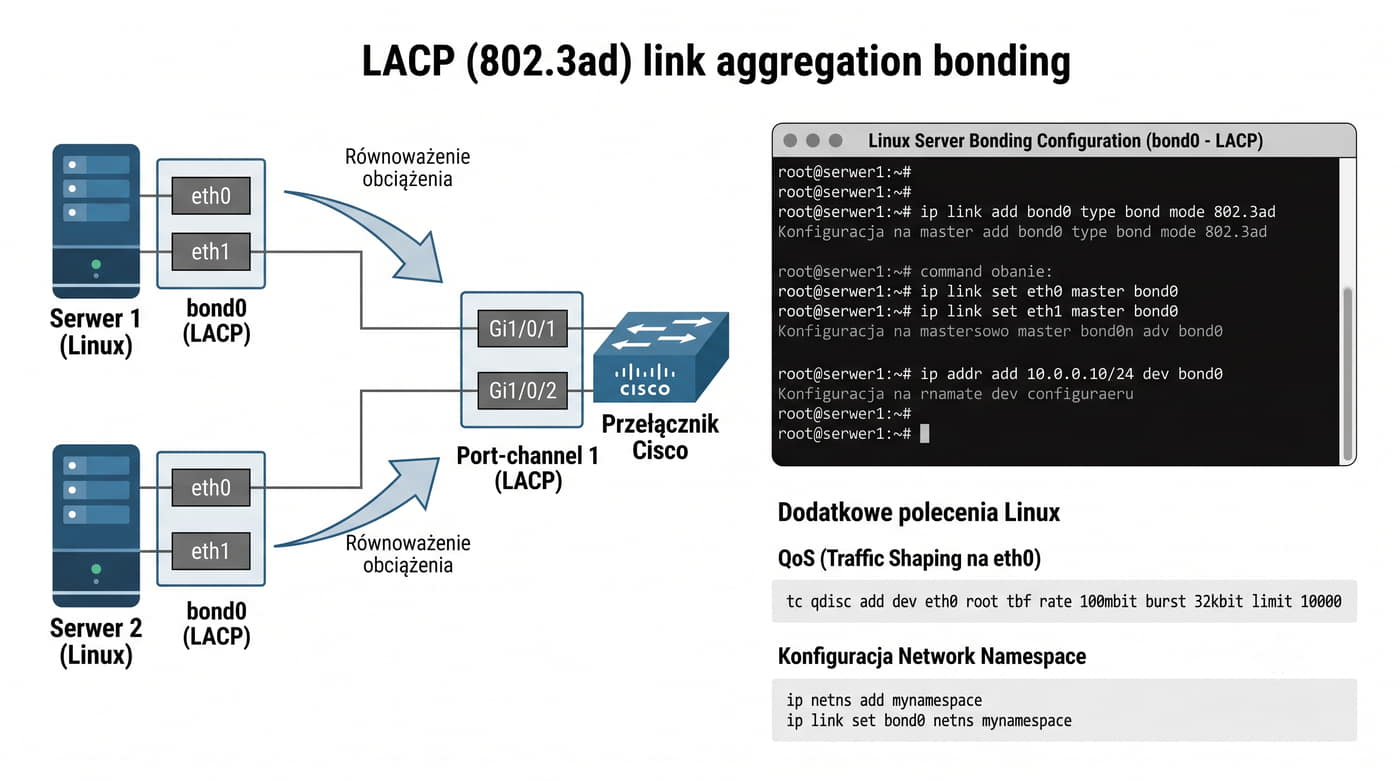
# Agregacja dwóch kart w trybie LACP (802.3ad)
ip link add bond0 type bond mode 802.3ad
ip link set eth0 master bond0
ip link set eth1 master bond0
ip addr add 10.0.0.10/24 dev bond0

# Ograniczenie przepustowości (QoS – token bucket)
tc qdisc add dev eth0 root tbf rate 100mbit burst 32kbit limit 10000

# Przestrzeń nazw sieciowych (network namespace)
ip netns add test_ns
ip link set eth0 netns test_ns
ip netns exec test_ns ip addr add 192.168.1.1/24 dev eth0

Polecenie tc qdisc add dodaje dyscyplinę kolejkowania.

Agregacja łączy (bonding) w systemie Linux pozwala na połączenie wielu fizycznych kart sieciowych w jeden logiczny interfejs.

Tryb 802.3ad (LACP – Link Aggregation Control Protocol) wymaga wsparcia po stronie przełącznika i umożliwia równoważenie obciążenia oraz redundancję.

QoS (Quality of Service) na karcie sieciowej konfiguruje się za pomocą tc (traffic control).

Przykład z tbf (Token Bucket Filter) ogranicza przepustowość do 100 Mbps.

Bardziej zaawansowane konfiguracje obejmują klasy HTB (Hierarchical Token Bucket) do priorytetyzacji ruchu.

Network namespaces pozwalają na izolację stosu sieciowego w systemie Linux.

Każda przestrzeń nazw ma własne interfejsy, tabele routingu i reguły firewalla.

Jest to podstawowa technologia wirtualizacji sieci w kontenerach Docker i Kubernetes.

9/23 Zaawansowana konfiguracja interfejsów Cisco

EtherChannel, errdisable, storm-control, spanning-tree

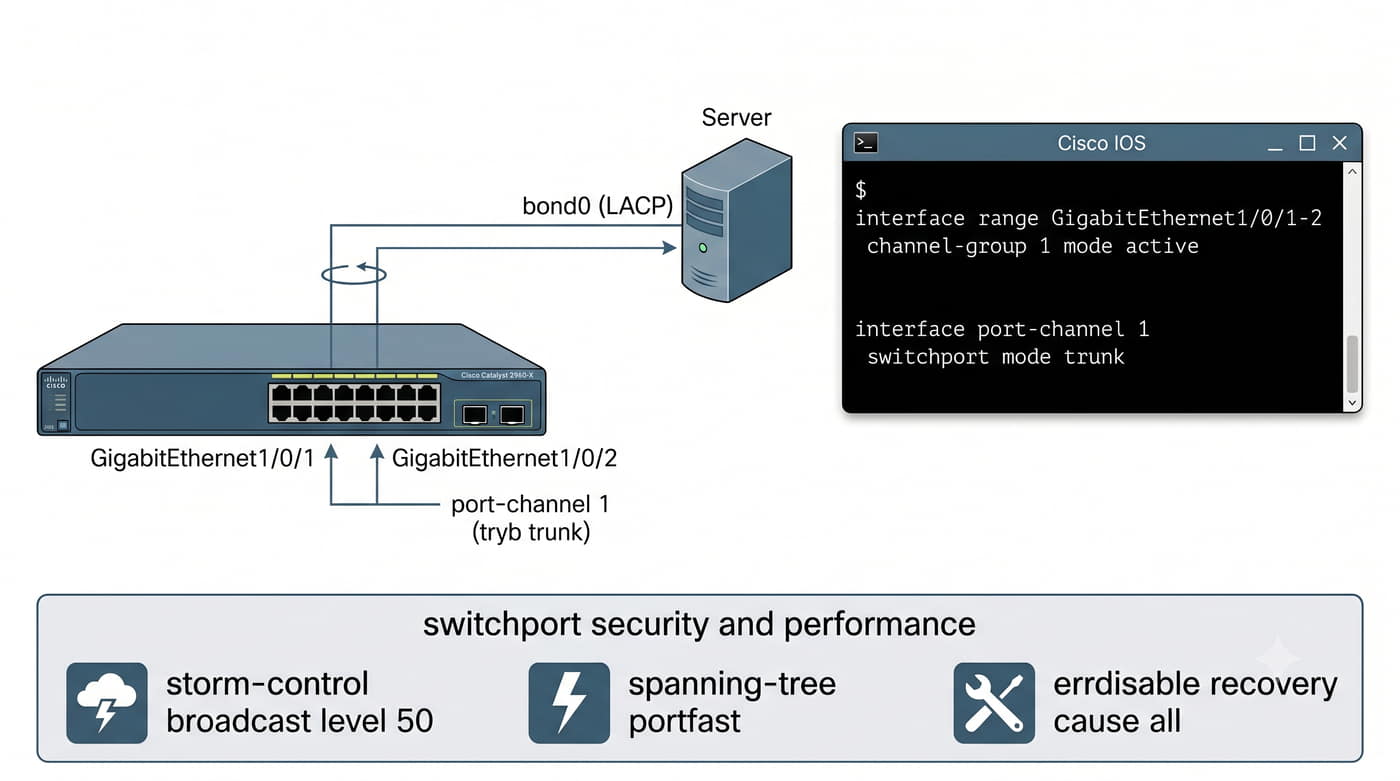
! EtherChannel (LACP) – agregacja portów
Switch(config)# interface range GigabitEthernet1/0/1-2
Switch(config-if-range)# channel-group 1 mode active
Switch(config-if-range)# interface port-channel 1
Switch(config-if)# switchport mode trunk

! Storm-control – ograniczenie broadcast/multicast
Switch(config-if)# storm-control broadcast level 50

! Spanning Tree PortFast (port końcowy)
Switch(config-if)# spanning-tree portfast

! errdisable recovery – automatyczne odblokowanie portu
Switch(config)# errdisable recovery cause all

Storm-control chroni przed burzami rozgłoszeniowymi.

EtherChannel (zwany również Port Channel lub LAG) w Cisco IOS łączy od 2 do 8 fizycznych portów w jeden logiczny interfejs.

Tryb active włącza negocjację LACP (IEEE 802.3ad), która automatycznie uzgadnia agregację z partnerem (serwerem lub innym przełącznikiem).

Gdy ruch broadcast przekroczy 50% przepustowości portu, przełącznik odrzuca nadmiarowe ramki.

Wartości można ustawić dla broadcast, multicast i unicast (unknown unicast).

Spanning Tree PortFast to funkcja przyspieszająca przejście portu w stan Forwarding.

Stosuje się ją na portach końcowych (podłączonych do stacji roboczych, serwerów), które nie uczestniczą w topologii STP.

PortFast eliminuje opóźnienie 30-50 sekund związane z nasłuchem i nauką STP.

10/23 Diagnostyka karty PCIe – ethtool, lspci, dmesg

Narzędzia diagnostyczne dla kart PCI Express

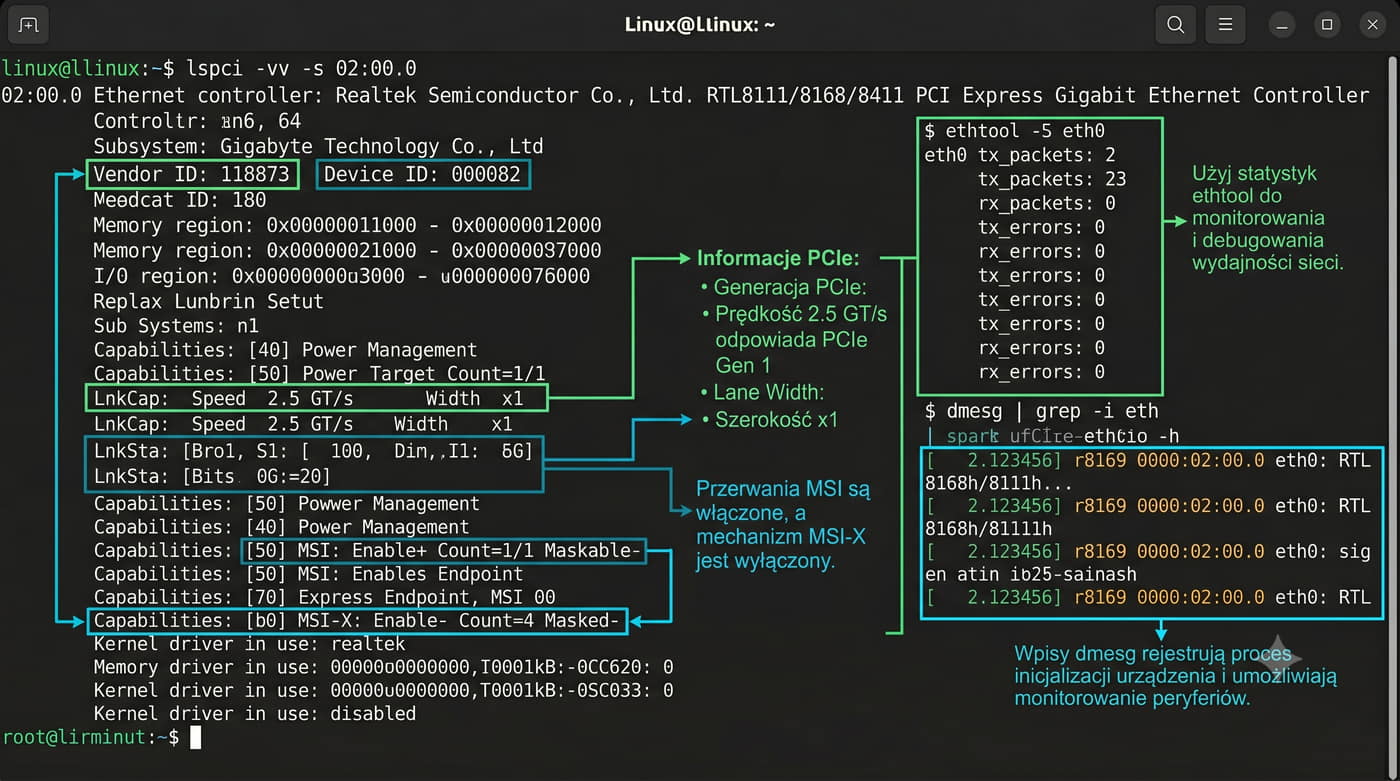
# Identyfikacja karty na magistrali PCIe
lspci -vv -s 02:00.0
02:00.0 Ethernet controller: Realtek Semiconductor Co., Ltd.
  RTL8111/8168/8411 PCI Express Gigabit Ethernet Controller
  Subsystem: Gigabyte Technology Co., Ltd
  Capabilities: [40] Power Management
  Capabilities: [50] MSI: Enable+ Count=1/1 Maskable-
  Capabilities: [70] Express Endpoint, MSI 00
  Capabilities: [b0] MSI-X: Enable- Count=4 Masked-

# Statystyki interfejsu
ethtool -S eth0

# Logi jądra związane z kartą
dmesg | grep -i eth
# Przykład:
[  2.345678] r8169 0000:02:00.0 eth0: RTL8168e/8111e, 00:1a:2b:3c:4d:5e, XID 2c2, IRQ 28
[  2.345679] r8169 0000:02:00.0 eth0: jumbo features [frames: 9194 bytes, tx checksumming: on]

Polecenie lspci jest podstawowym narzędziem do identyfikacji urządzeń na magistrali PCI/PCIe.

Opcja -vv (very verbose) wyświetla szczegółowe informacje, w tym: Vendor ID (producent), Device ID (model), Subsystem (producent karty), wersję PCIe, przepustowość (LnkCap/LnkSta) oraz obsługiwane funkcje (MSI, MSI-X, Power Management).

Interpretacja LnkCap (Link Capability): Speed 2.5 GT/s, Width x1 oznacza, że karta obsługuje PCIe Gen1 z pojedynczą linią. LnkSta (Link Status) pokazuje aktualnie negocjowaną szybkość połączenia.

W przypadku kart Gigabit Ethernet PCIe x1 Gen1 (2.5 GT/s) w zupełności wystarcza.

Logi jądra (dmesg) dostarczają informacji o inicjalizacji karty, załadowanym sterowniku, adresie MAC i funkcjach offload.

W przypadku problemów (np. karta nie jest wykrywana), logi jądra są pierwszym miejscem do sprawdzenia.

11/23 Schemat blokowy karty PCI Express – architektura wewnętrzna

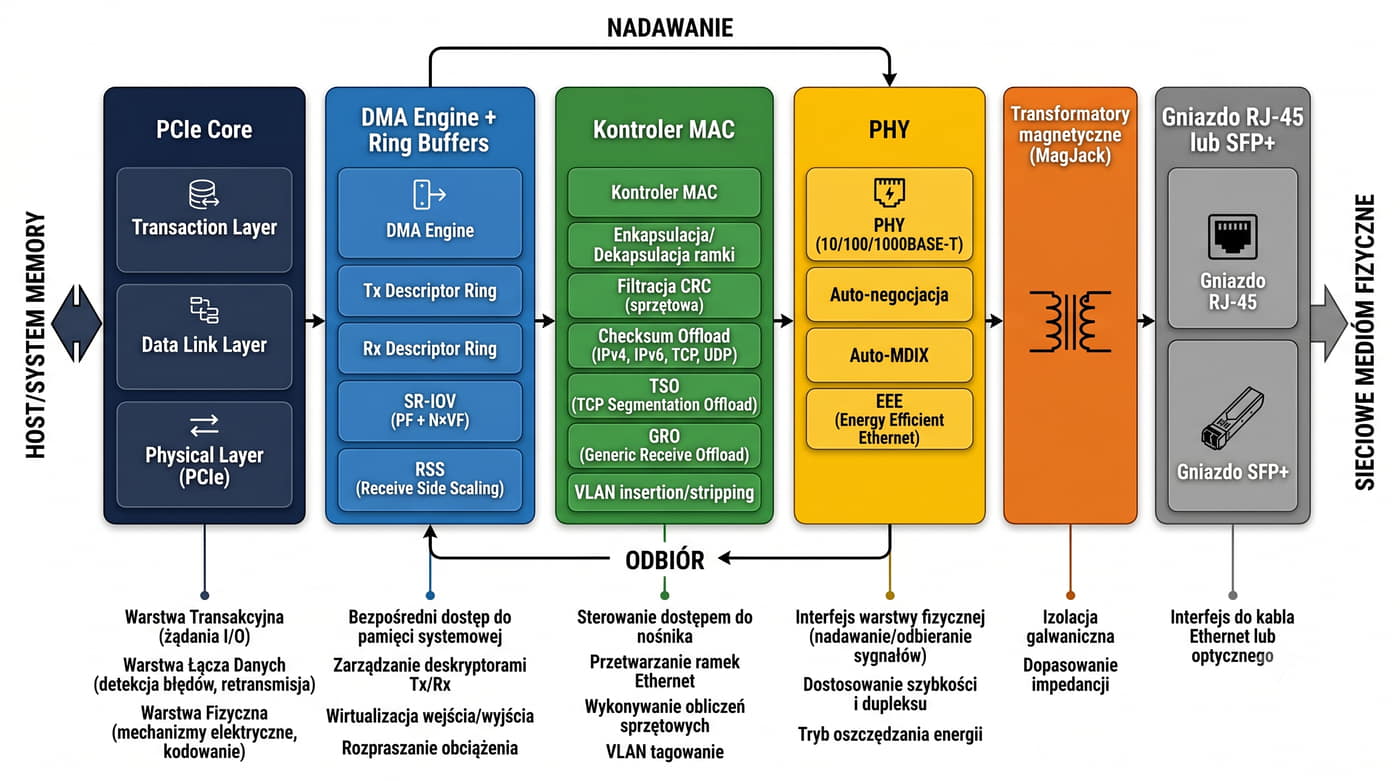
Droga pakietu w nowoczesnej karcie PCIe

 ┌──────────────────────────────────────────────────────┐
 │  RAM systemowa (pamięć główna przez DMA)  │
 └────────────────────┬─────────────────────────────────┘
  │ PCIe Transaction Layer Packets
  ▼
 ┌──────────────────────────────────────────────────────┐
 │  PCIe Core (Transaction Layer / Data Link / Phy)  │
 │  - Negocjacja łącza, skalowanie szerokości (lane)  │
 │  - MSI / MSI-X (przerwania sygnalizowane przez  │
 │  zapis do pamięci zamiast IRQ linii sprzętowych) │
 └──────┬───────────────────────────────────────────────┘
  │
  ▼
 ┌──────────────────────────────────────────────────────┐
 │  DMA Engine + Ring Buffery (Tx/Rx Descriptor Ring)│
 │  - SR-IOV: PF + N × VF z osobnymi pierścieniami  │
 │  - RSS: haszowanie → dystrybucja do kolejek  │
 └──────┬───────────────────────────────────────────────┘
  │
  ▼
 ┌──────────────────────────────────────────────────────┐
 │  Kontroler MAC (enkapsulacja, filtracja, CRC)  │
 │  - Checksum offload (TCP/UDP/IP)  │
 │  - TSO / GRO (segmentacja / łączenie)  │
 │  - VLAN insert/strip (802.1Q)  │
 └──────┬───────────────────────────────────────────────┘
  │
  ▼
 ┌──────────────────────────────────────────────────────┐
 │  PHY (warstwa fizyczna)  │
 │  - 10BASE-T / 100BASE-TX / 1000BASE-T / 10GBASE-T│
 │  - Auto-negocjacja, Auto-MDIX  │
 │  - EEE (Energy Efficient Ethernet – IEEE 802.3az) │
 └──────┬───────────────────────────────────────────────┘
  │
  ▼
 ┌──────────────────────────────────────────────────────┐
 │  Transformatory magnetyczne (MagJack)  │
 └──────┬───────────────────────────────────────────────┘
  │
  ▼
 ┌──────────────────────────────────────────────────────┐
 │  Gniazdo RJ-45 (lub SFP+ dla 10 GbE) ←→ Kabel  │
 └──────────────────────────────────────────────────────┘
  

Architektura nowoczesnej karty PCI Express różni się znacząco od starszych kart PCI.

Najważniejszą różnicą jest warstwa PCIe Core, która implementuje protokół PCIe składający się z trzech warstw: Transaction Layer (TLP – pakiety z danymi), Data Link Layer (DLLP – potwierdzenia, kontrola przepływu) i Physical Layer (kodowanie 8B/10B lub 128B/130B).

Silnik DMA w kartach PCIe obsługuje wiele pierścieni deskryptorów (descriptor rings) dla transmisji i odbioru.

Karty z SR-IOV mają osobne pierścienie dla każdej funkcji wirtualnej (VF), co zapewnia izolację między maszynami wirtualnymi.

RSS dystrybuuje pakiety do różnych kolejek na podstawie hasza z nagłówków pakietów.

Warstwa MAC w nowoczesnych kartach oferuje sprzętowe odciążenie: checksum offload (obliczanie sum kontrolnych w locie), TSO/GRO (segmentacja/łączenie pakietów) oraz VLAN offload (dodawanie/usuwanie tagów 802.1Q).

Wszystkie te funkcje redukują obciążenie CPU i zwiększają przepustowość.

12/23 Podsumowanie

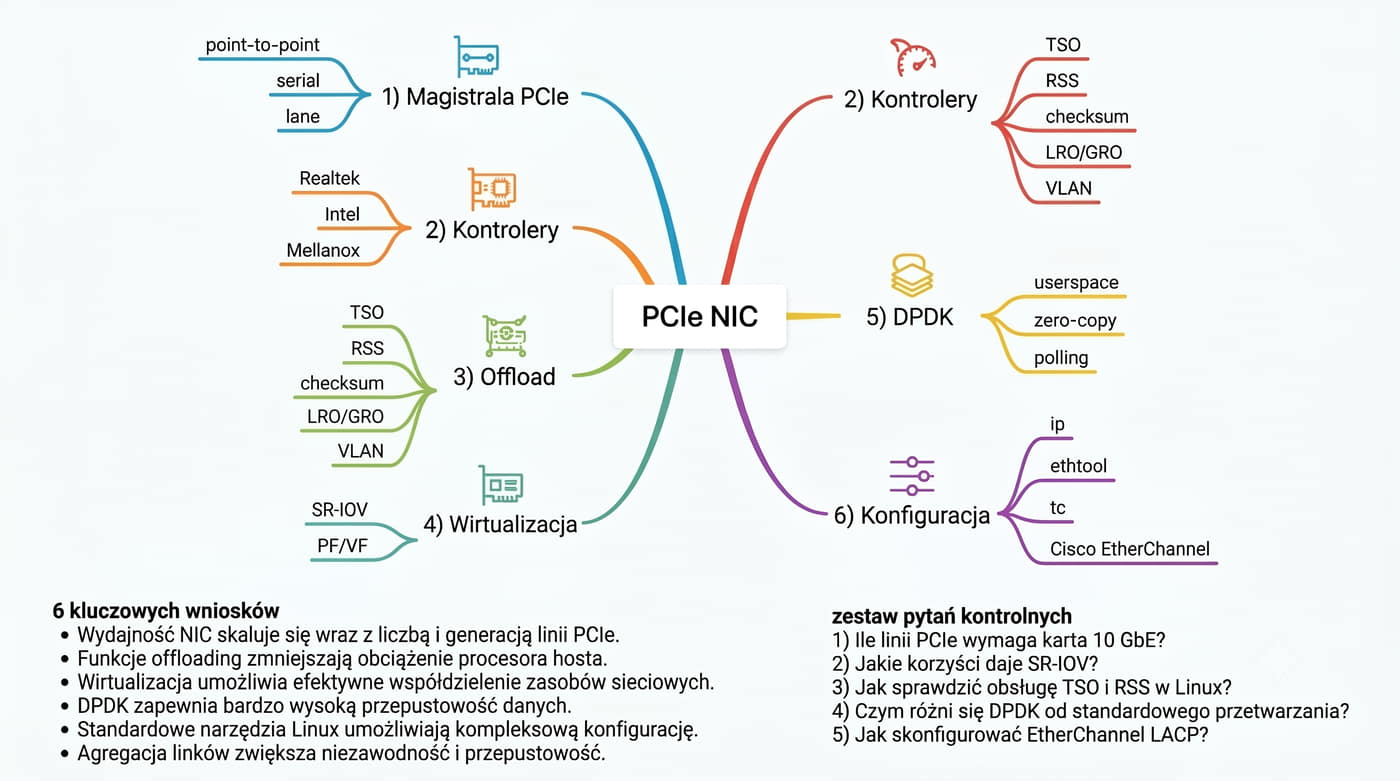
Kluczowe wnioski – karty sieciowe PCI Express

  1. PCI Express to szeregowa magistrala point-to-point – zastępuje równoległą, współdzieloną magistralę PCI.
  2. Karty Gigabit Ethernet używają PCIe x1; 10 GbE wymaga x4 (Gen2) lub x8 (Gen1); 100 GbE – x16 (Gen4/5).
  3. Funkcje offload (TSO, RSS, checksum offload) przenoszą przetwarzanie pakietów z CPU na kartę.
  4. SR-IOV umożliwia wirtualizację karty – jedna karta obsługuje wiele maszyn wirtualnych z wydajnością line rate.
  5. DPDK pozwala na przetwarzanie pakietów w przestrzeni użytkownika z pominięciem jądra (10× większa wydajność).
  6. Konfiguracja w Linux: ip, ethtool, tc; na Cisco: interfejs, EtherChannel, storm-control.
Pytania kontrolne:
  1. Ile linii PCIe wymaga karta 10 GbE i dlaczego?
  2. Jakie korzyści daje SR-IOV w środowisku serwerów wirtualnych?
  3. Jak sprawdzić w Linux, czy karta obsługuje TSO i RSS?
  4. Czym różni się DPDK od standardowego przetwarzania pakietów w jądrze Linux?
  5. Jak skonfigurować EtherChannel LACP między przełącznikiem Cisco a serwerem Linux?
Umiejętność konfiguracji i diagnostyki tych kart w systemie Linux jest fundamentalna.

Narzędzia takie jak lspci, ethtool, ip i tc pozwalają na pełną kontrolę nad funkcjami karty.

Znajomość tych narzędzi jest wymagana na egzaminach certyfikacyjnych (LPIC, RHCE) i w codziennej pracy administratora sieci.

Karty sieciowe PCI Express są fundamentem nowoczesnej infrastruktury sieciowej.

Zrozumienie ich architektury – od warstwy fizycznej PCIe przez funkcje offload i SR-IOV po DPDK – jest niezbędne dla inżynierów projektujących i utrzymujących systemy o wysokiej wydajności.

W przeciwieństwie do starszych kart PCI, gdzie przepustowość magistrali była wąskim gardłem, współczesne karty PCIe oferują przepustowość wielokrotnie przewyższającą możliwości sieci.

Głównym wyzwaniem staje się efektywne dostarczenie danych do aplikacji z jak najmniejszym obciążeniem CPU i opóźnieniem, co osiąga się poprzez offload, SR-IOV i DPDK.

13/23 PCIe Flow Control i klasy ruchu

Credit-based flow control, wirtualne kanały i klasy ruchu

  • Credit-based flow control (CBFC): Każdy odbiorca deklaruje pojemność bufora (kredyty) dla każdego typu TLP. Nadawca może wysłać tyle pakietów, na ile ma przyznane kredyty – eliminuje to potrzebę retransmisji z powodu przepełnienia bufora.
  • Wirtualne kanały (VC): Do 8 niezależnych kanałów (VC0-VC7) z oddzielnymi kolejkami, buforami i kontrolą przepływu. Każdy VC może mieć inną szerokość łącza.
  • Klasy ruchu (TC): Oznaczenie priorytetu (0-7) na poziomie TLP. TC0 – najniższy priorytet, TC7 – najwyższy. Mapowane na VC przez switche PCIe, co pozwala na QoS.
  • Typy TLP: Memory Read/Write, I/O Read/Write, Configuration Read/Write, Message (w tym MSI/MSI-X, PME, ERR).
# Odczyt aktualnej szybkości łącza PCIe z sysfs
cat /sys/class/net/eth0/device/current_link_speed
2.5 GT/s
# Odczyt szerokości łącza
cat /sys/class/net/eth0/device/current_link_width
1
# Sprawdzenie maksymalnych możliwości PCIe karty
lspci -s 02:00.0 -vv | grep -i "LnkCap"
LnkCap: Port #0, Speed 5GT/s, Width x4, ASPM L0s L1

W PCIe każdy port ma dedykowane bufory dla każdego typu pakietu: NP (posted – zapisy), P (non-posted – odczyty), Cpl (completions). Dla każdego typu są osobne kredyty.

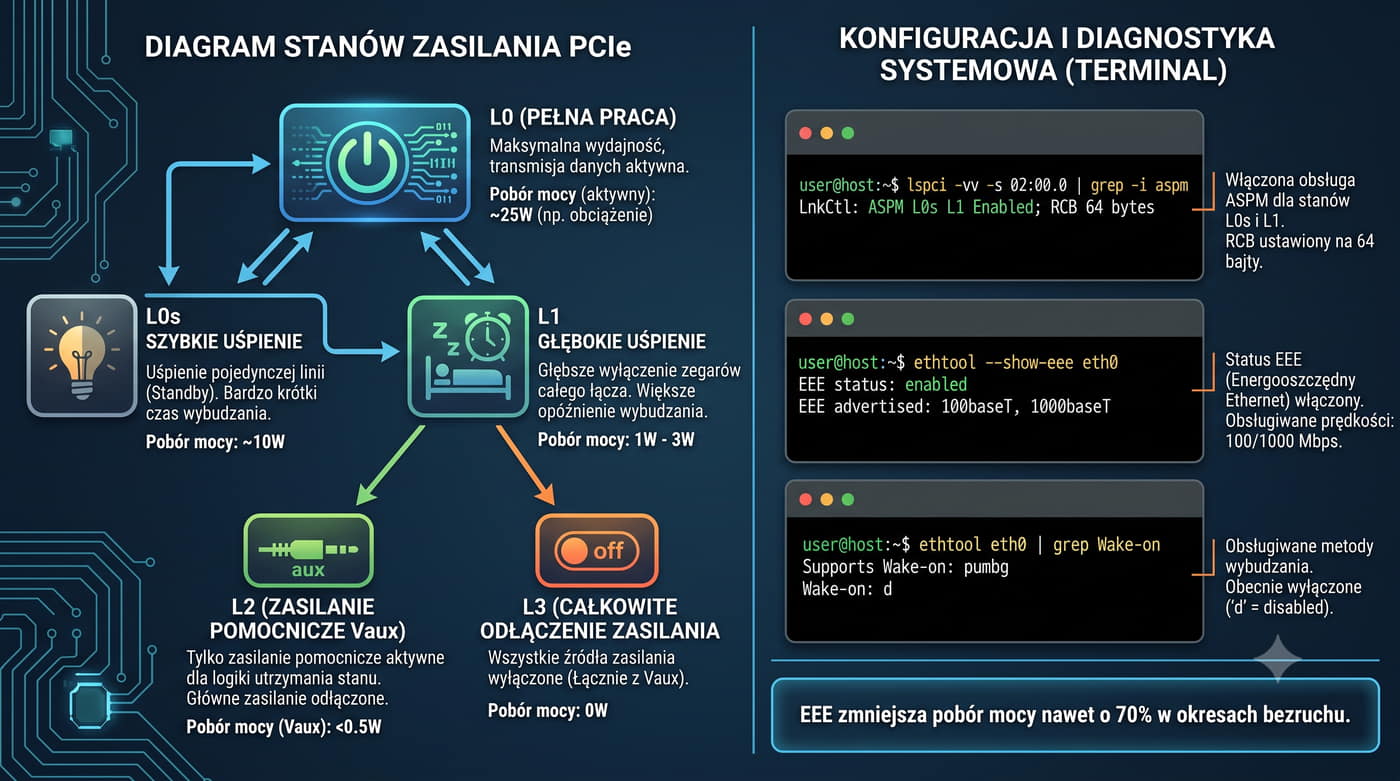
Inicjalizacja łącza PCIe obejmuje negocjację szybkości (LTSSM – Link Training and Status State Machine), która przechodzi przez stany: Detect, Polling, Configuration, L0 (pełna praca), L0s, L1 (oszczędzanie), L2 (zasilanie pomocnicze).

Pakiety DLLP (Data Link Layer Packet) są używane do potwierdzeń (ACK/NAK), kontroli przepływu (InitFC, UpdateFC) oraz zarządzania energią (PM_Enter_L1, PM_Active_State_Nak).

Mechanizm ACK/NAK na warstwie łącza zapewnia bezstratną transmisję TLP między sąsiednimi urządzeniami PCIe. Każdy TLP otrzymuje sekwencyjny numer, a odbiorca potwierdza (ACK) lub żąda retransmisji (NAK).

W systemie Linux informacje o PCIe można odczytać z sysfs (/sys/bus/pci/devices/) oraz przez lspci z opcjami -vv, -xxx, -t (topologia drzewa).

14/23 Wirtualizacja sieci na kartach PCIe – VXLAN, NVGRE, GENEVE

Sprzętowe przyspieszanie sieci overlay w chmurach

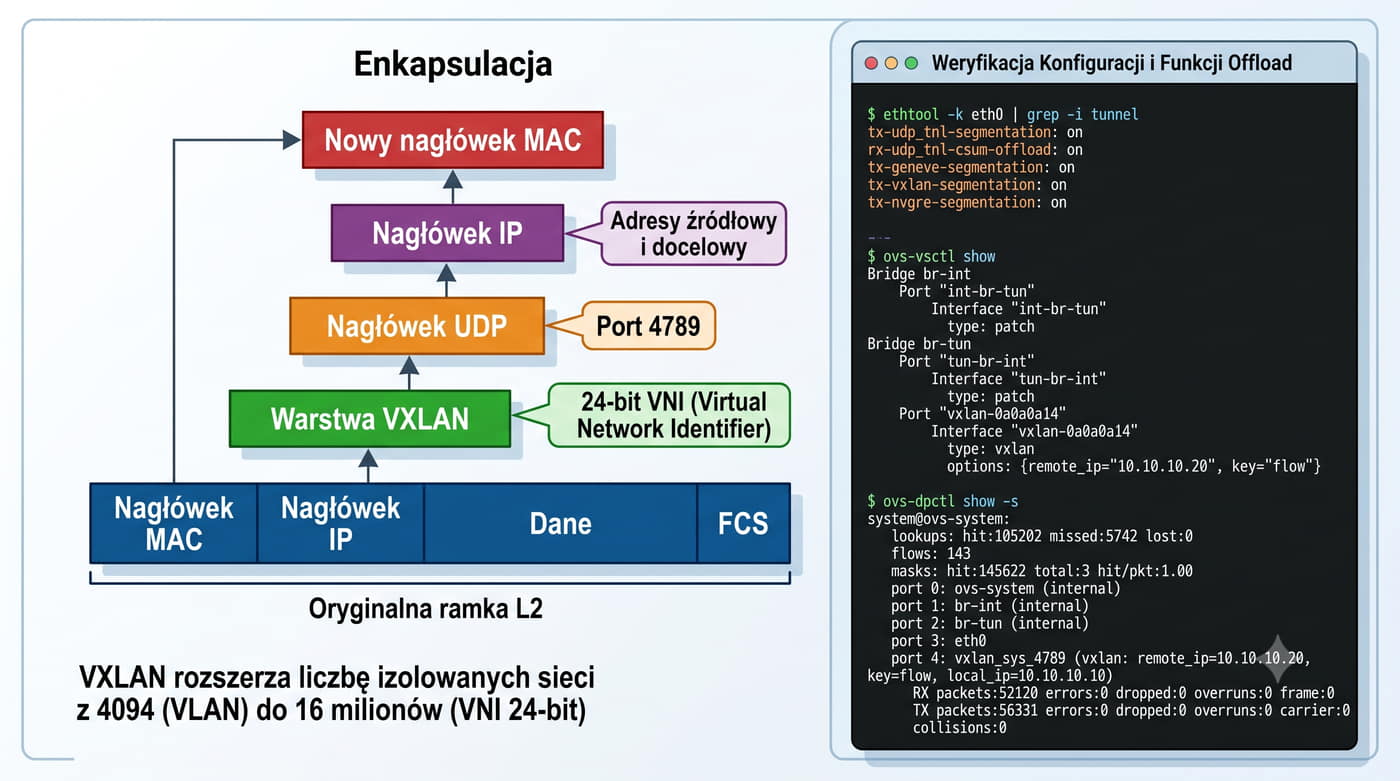
  • VXLAN (Virtual Extensible LAN): Enkapsulacja ramek L2 w pakiety UDP (port 4789). 24-bitowy VNI (Virtual Network Identifier) – 16 mln izolowanych sieci.
  • NVGRE (Network Virtualization using GRE): Enkapsulacja w GRE z 24-bitowym VSID. Alternatywa dla VXLAN stosowana w Hyper-V.
  • GENEVE (Generic Network Virtualization Encapsulation): Elastyczny protokół enkapsulacji łączący zalety VXLAN i NVGRE – opcjonalne opcje TLV.
  • Offload: Nowoczesne karty (Intel E810, Mellanox ConnectX, Broadcom NetXtreme) obliczają sumy kontrolne TCP/UDP pakietów wewnętrznych, segmentują TSO przez tunel i rozkładają ruch RSS na haszach z wewnętrznych nagłówków.
# Sprawdzenie obsługi offload dla tuneli VXLAN
ethtool -k eth0 | grep -i tunnel
tx-udp_tnl-segmentation: on
rx-udp_tnl-csum-offload: on
tx-geneve-segmentation: on
tx-vxlan-segmentation: on
tx-nvgre-segmentation: on

# Statystyki przełącznika Open vSwitch z DPDK
ovs-vsctl show
ovs-dpctl show -s

W chmurach obliczeniowych (AWS, Azure, Google Cloud) każde środowisko dzierżawcy (tenant) wymaga izolacji sieciowej. Tradycyjny VLAN (4094 sieci) nie wystarcza – VXLAN rozszerza to do 16 milionów sieci.

VXLAN offload na karcie sieciowej pozwala hypervisorowi na enkapsulację/dekapsulację bez angażowania CPU. Karta dodaje nagłówek VXLAN+UDP+IP+MAC, oblicza sumy kontrolne i segmentuje jak zwykły TSO.

NVGRE (RFC 7637) używa GRE z kluczem 24-bitowym (VSID). Różni się od VXLAN brakiem portu UDP – używa EtherType 0x6558. Niektóre karty sieciowe obsługują oba protokoły.

GENEVE (RFC 8926) to najnowszy standard enkapsulacji – elastyczny nagłówek z opcjami TLV. Karty Intel E810 i Mellanox ConnectX-6+ obsługują GENEVE offload.

W środowiskach SDN (Software-Defined Networking) offload tuneli na kartach PCIe jest kluczowy dla wydajności – bez niego CPU musiałoby wykonać enkapsulację programowo, co drastycznie obniża przepustowość.

15/23 Zarządzanie energią w PCIe i kartach sieciowych

ASPM, stany oszczędzania energii, EEE, Wake-on-LAN

  • ASPM (Active State Power Management): L0s (szybkie przejście w stan gotowości pojedynczej linii), L1 (głębszy stan oszczędzania całego łącza). Konfiguracja w BIOS lub przez setpci.
  • L2/L3 – Aux Power: L2 – główne zasilanie wyłączone, tylko Vaux (3.3V aux). L3 – całkowite odłączenie zasilania (mechaniczne).
  • EEE (Energy Efficient Ethernet): IEEE 802.3az – zmniejszenie mocy w okresach niskiego ruchu (Low Power Idle – LPI). Negocjowane w auto-negocjacji.
  • Wake-on-LAN (WoL): Karta nasłuchuje ramki magic packet (wiersz zawierający 16 powtórzeń adresu MAC) i budzi system przez PME#.
# Sprawdzenie ASPM i zarządzania energią PCIe
lspci -vv -s 02:00.0 | grep -i aspm
LnkCtl: ASPM L0s L1 Enabled; RCB 64 bytes
# Sprawdzenie EEE na karcie
ethtool --show-eee eth0
EEE status: enabled
EEE advertised: 100baseT, 1000baseT
# Stan Wake-on-LAN
ethtool eth0 | grep Wake-on
Supports Wake-on: pumbg
Wake-on: d

ASPM jest zarządzany przez BIOS/system operacyjny. W przypadku kart sieciowych o niskim opóźnieniu (np. w środowiskach HFT – High-Frequency Trading) ASPM często wyłącza się w BIOS, ponieważ przejścia między stanami L0-L1 mogą wprowadzać dodatkowe opóźnienia mikrosekundowe.

W Linux stan ASPM można kontrolować przez: echo performance > /sys/module/pcie_aspm/parameters/policy (polityka jądra: powersave, performance, powersupersave).

EEE (IEEE 802.3az) na linii Ethernet zmniejsza pobór mocy nawet o 70% w okresach bezruchu. Gdy nie ma ramek do wysłania, karta wysyła sygnał LPI (Low Power Idle) i przechodzi w stan oszczędzania. Po pojawieniu się ramki karta budzi się w ciągu kilku mikrosekund.

Wake-on-LAN wykorzystuje sygnał PME (Power Management Event) na magistrali PCIe do wybudzenia systemu. W ethtool: Wake-on: d (disabled), p (PHY activity), u (unicast), m (multicast), b (broadcast), g (magic packet).

Energooszczędność kart PCIe jest istotna w centrach danych – tysiące kart x kilka watów oszczędności na każdej daje znaczące oszczędności energetyczne.

16/23 Testowanie wydajności kart sieciowych PCIe

iPerf3, netperf, statystyki ethtool, monitoring

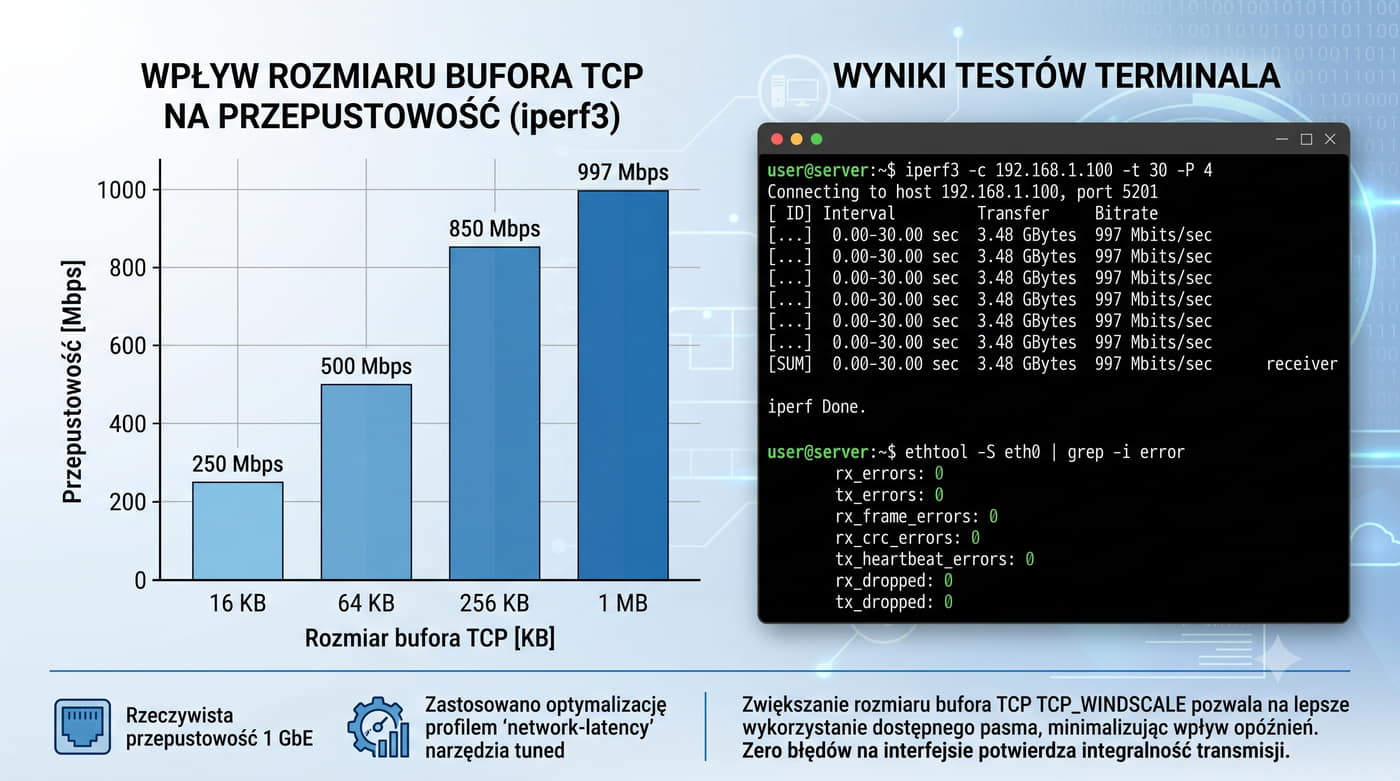
  • iPerf3: Standardowe narzędzie do pomiaru przepustowości TCP/UDP. Obsługa strumieni równoległych (P), odwróconego kierunku (R), bidirekcjonalnego (--bidir).
  • Netperf: Zaawansowany benchmark sieciowy – pomiar przepustowości (TCP_STREAM, UDP_STREAM), liczby transakcji na sekundę (TCP_RR, UDP_RR), opóźnień (TCP_CRR).
  • Statystyki ethtool: ethtool -S eth0 pokazuje szczegółowe liczniki sprzętowe karty – liczba odebranych/wysłanych pakietów, błędów CRC, kolizji, spadków bufora.
  • Monitoring w czasie rzeczywistym: sar -n DEV 1 (sysstat), nload, bmon, iftop – obserwacja ruchu sieciowego w interfejsie.
# Test przepustowości TCP (serwer i klient)
# Serwer: iperf3 -s
# Klient:
iperf3 -c 192.168.1.100 -t 30 -P 4
[ ID] Interval           Transfer     Bitrate
[  5]   0.00-30.00  sec  3.48 GBytes  997 Mbits/sec  (1×1GbE)
# Test dwukierunkowy (bidirectional)
iperf3 -c 192.168.1.100 -t 30 --bidir
# Sprawdzenie błędów na interfejsie
ethtool -S eth0 | grep -i error
rx_crc_errors: 0
tx_errors: 0

W testach wydajności kart sieciowych PCIe kluczowe jest zidentyfikowanie wąskiego gardła: magistrala PCIe, sterownik karty, przerwania IRQ, rozmiar buforów pierścieniowych (ring buffer).

Rozmiar bufora pierścieniowego (ring buffer) można regulować: ethtool -G eth0 rx 4096 tx 4096 – większe bufory zmniejszają ryzyko utraty pakietów przy skokach ruchu, ale zwiększają opóźnienie.

Rzeczywista przepustowość karty Gigabit Ethernet (1 GbE) powinna osiągać ~940-980 Mbps (narzut nagłówków TCP/IP, Ethernet). Dla 10 GbE: 9.4-9.8 Gbps.

W systemie Linux do strojenia wydajności sieci służy narzędzie tuned (np. tuned-adm profile network-throughput), które optymalizuje ustawienia jądra (buforowanie, kolejkowanie, przerwania).

Narzędzie perf (perf stat -e cycles,instructions,cache-misses) pozwala na profilowanie wydajności karty na poziomie sprzętowym – identyfikacja nadmiernych przerwań, braków pamięci cache przy obsłudze pakietów.

Przy testach 10 GbE i wyższych należy uwzględnić opóźnienia PCIe – karta 25 GbE na PCIe Gen2 x8 może być ograniczona przez magistralę (4 GB/s ~ 32 Gbps, więc 25 GbE jest OK, ale przy dwóch portach 25 GbE już nie).

17/23 SmartNIC, DPU i przyszłość kart sieciowych PCIe

Programowalne karty sieciowe nowej generacji

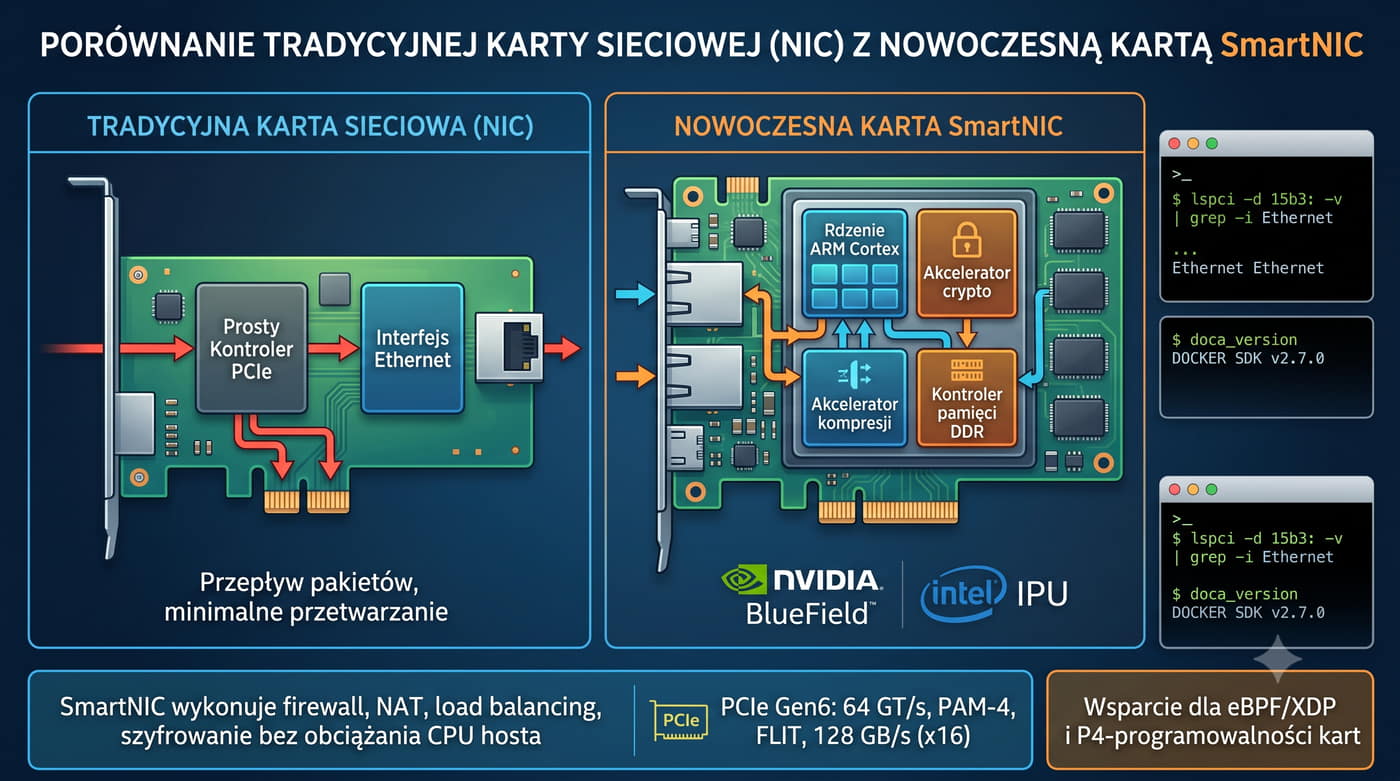
  • SmartNIC: Karta sieciowa z wbudowanym procesorem (ARM, RISC-V) wykonującym przetwarzanie sieci, bezpieczeństwo i zarządzanie bez angażowania CPU hosta.
  • DPU (Data Processing Unit): NVIDIA BlueField – pełnoprawny system na karcie z wielordzeniowym ARM, akceleratorami (compress, crypto, regex), NVIDIA DOCA SDK.
  • IPU (Infrastructure Processing Unit): Intel IPU (Mount Evans, Oak Springs Canyon) – odciąża infrastrukturę chmury (sieć, pamięć masową, zarządzanie) z CPU hosta.
  • PCIe Gen6: 64 GT/s, PAM-4, FLIT (512B z FEC), 128 GB/s (x16). Oczekiwana standaryzacja 2025. Gen7: 128 GT/s w planach na 2028.
# Identyfikacja karty SmartNIC w systemie
lspci -d 15b3: -v | grep -i "Ethernet\|BlueField"
# Status DOCA (NVIDIA DOCA SDK) na BlueField
doca_version
DOCKER SDK v2.7.0
# Sprawdzenie PCIe Gen6 w przyszłych systemach
# 64 GT/s, x16 = 128 GB/s pełny dupleks

SmartNIC-e rewolucjonizują centra danych. Tradycyjna karta NIC tylko przesyła pakiety – SmartNIC przetwarza je: firewall, NAT, load balancing, szyfrowanie, kompresja, monitorowanie, a wszystko to bez obciążania CPU hosta.

NVIDIA BlueField-3 oferuje: 16 rdzeni ARM Cortex-A78, 400 GbE, 32 GB RAM, akceleratory kryptograficzne i kompresji. Używany w chmurach (AWS Nitro, Azure Boost) do odciążenia infrastruktury.

Intel IPU (Mount Evans – ASIC, Oak Springs Canyon – FPGA) współpracuje z Intel Xeon, oferując: zarządzanie pamięcią masową (NVMe virtualizacja), przetwarzanie sieci (VXLAN, telemetry) i bezpieczeństwo (IPSec, TLS).

PCIe Gen6 wprowadza PAM-4 (4 poziomy sygnału) i kodowanie FLIT (512B+20B FEC) zamiast tradycyjnego 128B/130B. Zapewnia opóźnienie poniżej 10 ns na mostek i przepustowość 64 GT/s na linie, czyli 128 GB/s w konfiguracji x16 (pełny dupleks).

Prędkości Ethernet rosną: 200 GbE (IEEE 802.3bs), 400 GbE (IEEE 802.3bs), 800 GbE (IEEE 802.3df) i 1.6 TbE w planach. Każda nowa generacja wymaga szybszych kart PCIe.

Kolejnym krokiem jest P4-programowalność kart (Intel Tofino, NVIDIA Spectrum) – przepływ pakietów definiowany przez programistę w języku P4, nie przez sztywny układ ASIC.

eBPF/XDP w Linux umożliwia programowalne przetwarzanie pakietów w jądrze, a z offload na kartę (XDP offload) – wykonanie programów eBPF bezpośrednio w karcie sieciowej, co daje wydajność DPDK z elastycznością programowalnego przetwarzania.

18/23 Karty sieciowe 10 Gigabit Ethernet i 25 Gigabit Ethernet

10GBASE-T, SFP+, SFP28, Direct Attach Copper

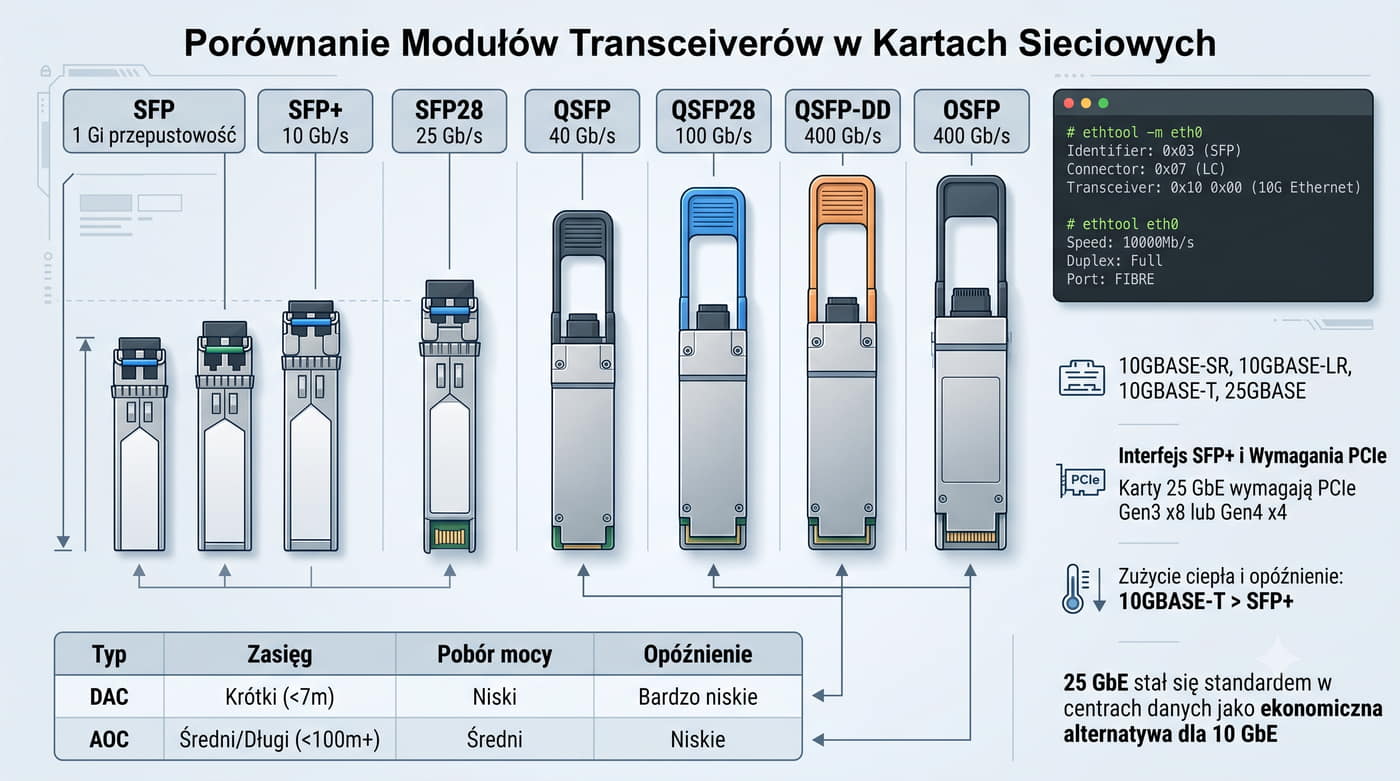
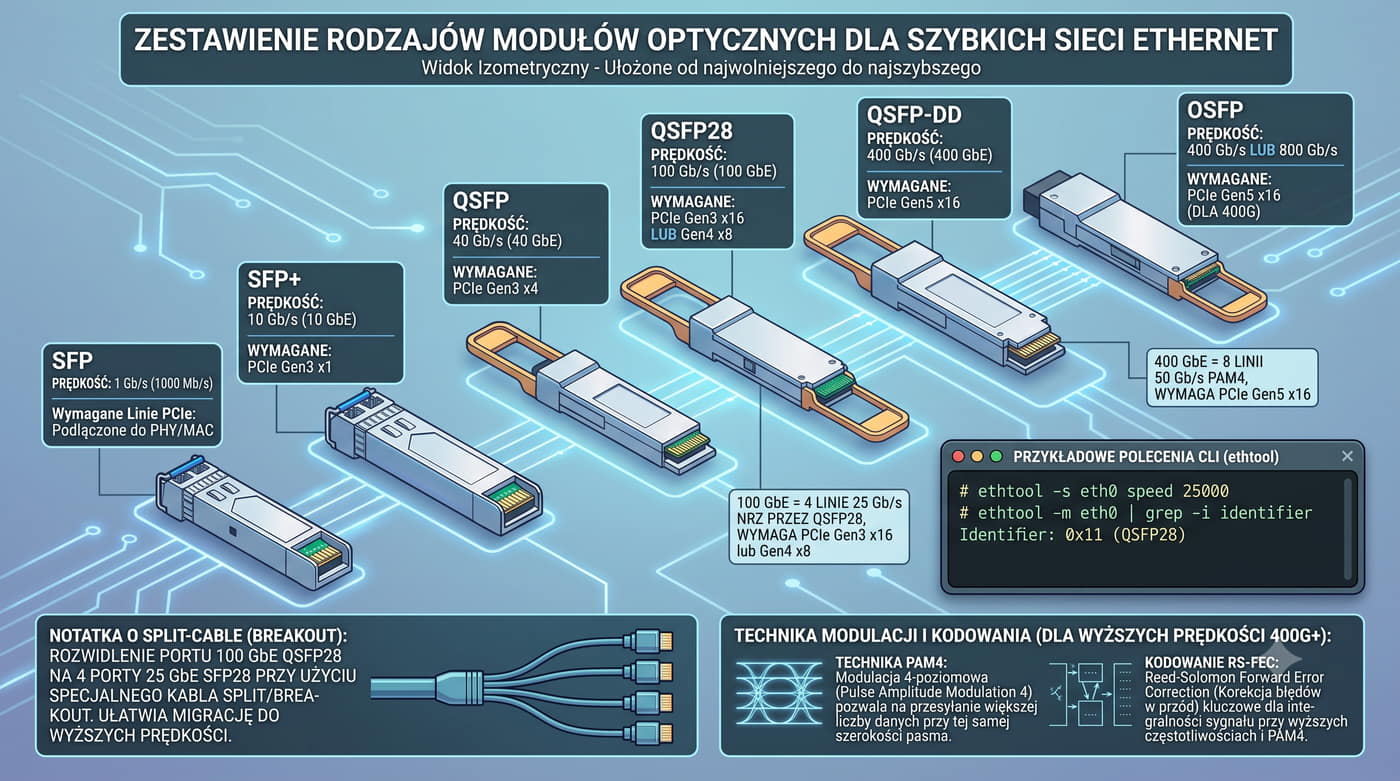
  • 10 GbE (IEEE 802.3ae): 10 Gbps = 1250 MB/s. Typy: 10GBASE-SR (850 nm, 300 m OM3/OM4), 10GBASE-LR (1310 nm, 10 km), 10GBASE-ER (1550 nm, 40 km), 10GBASE-T (Cat6a/Cat7, 100 m). Interfejs SFP+.
  • 25 GbE (IEEE 802.3by): 25 Gbps = 3125 MB/s. Pojedyncza linia 25 Gb/s NRZ. W pełni kompatybilny wstecz z 10 GbE. Interfejs SFP28. Wymagane PCIe x8 Gen3 (8 GB/s) dla pojedynczego portu.
  • DAC (Direct Attach Copper): Kabel miedziany z wbudowanym transceiverem – niskie opóźnienie, niski pobór mocy, zasięg 1-7 m (SFP+) lub 1-5 m (SFP28). Najczęściej stosowany w szafach serwerowych.
  • AOC (Active Optical Cable): Kabel światłowodowy z wbudowanymi modułami optycznymi – dłuższy zasięg (do 100 m), mniejsza waga, odporny na zakłócenia EM.
# Identyfikacja typu transceivera SFP+
ethtool -m eth0
Identifier: 0x03 (SFP)
Connector: 0x07 (LC)
Transceiver: 0x10 0x00 (10G Ethernet)
# Określenie nośnika i szybkości
ethtool eth0
Speed: 10000Mb/s
Duplex: Full
Port: FIBRE

# Statystyki karty 25 GbE
ethtool -S eth0 | head -20

Wybór między 10GBASE-T a SFP+ zależy od odległości i istniejącej infrastruktury. 10GBASE-T działa na Cat6a/Cat7 do 100 m, ale generuje więcej ciepła (2-4 W na port) i ma większe opóźnienie (2-4 us) niż SFP+ (0.5-1 W, <1 us).

25 GbE stał się standardem w centrach danych jako ekonomiczna alternatywa dla 10 GbE – dwukrotnie wyższa przepustowość przy podobnym koszcie okablowania. Karty 25 GbE obsługują również 10 GbE (downshift), co ułatwia migrację.

DAC to najpopularniejsze połączenie w szafach rack – niski koszt (20-50 USD za kabel 3 m), małe opóźnienie (0.1 us), brak konwersji optoelektronicznej. Wady: ograniczony zasięg (max 7 m), sztywność kabla.

Karty 25 GbE wymagają PCIe Gen3 x8 (8 GB/s > 3.125 GB/s) lub Gen4 x4 (8 GB/s). Dwa porty 25 GbE (6.25 GB/s łącznie) mieszczą się w PCIe Gen3 x8 (8 GB/s).

W systemie Linux karty 10/25 GbE korzystają ze sterowników: mlx5_core (Mellanox), i40e (Intel XL710/XXV710), ena (Amazon ENA), bnxt_en (Broadcom).

19/23 Karty sieciowe 40 GbE, 100 GbE i 200 GbE

QSFP+, QSFP28, QSFP56, OSFP – szybkie interfejsy Ethernet

  • 40 GbE (IEEE 802.3ba): 4 linie 10 Gb/s NRZ przez QSFP+. 40GBASE-SR4 (100 m OM3/OM4, 4 pary MPO), 40GBASE-LR4 (10 km, 4 długości fali CWDM). Wymaga PCIe Gen3 x8 (8 GB/s).
  • 100 GbE (IEEE 802.3ba/802.3bj): 4 linie 25 Gb/s przez QSFP28 lub 10 linii 10 Gb/s przez CFP. 100GBASE-SR4 (100 m OM4), 100GBASE-LR4 (10 km). Wymaga PCIe Gen3 x16 (16 GB/s) lub Gen4 x8 (16 GB/s).
  • 200 GbE (IEEE 802.3bs): 4 linie 50 Gb/s PAM4 przez QSFP56 lub 8 linii 25 Gb/s NRZ. 200GBASE-SR4 (100 m OM5, PAM4). Wymaga PCIe Gen4 x16 (32 GB/s) lub Gen5 x8 (32 GB/s).
  • 400 GbE (IEEE 802.3bs): 8 linii 50 Gb/s PAM4 przez QSFP-DD lub OSFP. 400GBASE-SR8 (100 m OM4, MPO-16). Wymaga PCIe Gen5 x16 (64 GB/s).
# Podział portu 100 GbE na 4x25 GbE (split-cable)
ethtool -s eth0 speed 25000
ethtool -s eth1 speed 25000
# Identyfikacja typu modułu QSFP
ethtool -m eth0 | grep -i "identifier\|connector\|compliance"
Identifier: 0x0d (QSFP28)
Connector: 0x0c (MPO)
Compliance: 100GBASE-SR4

Split-cable (breakout) pozwala podzielić jeden port 100 GbE na 4 porty 25 GbE za pomocą kabla MPO-4xLC lub QSFP28-4xSFP28. Jest to ekonomiczny sposób na zwiększenie gęstości portów w przełącznikach i serwerach.

PAM4 (Pulse Amplitude Modulation 4-level) to technika kodowania stosowana od 200 GbE – przesyła 2 bity na symbol (00,01,10,11) kosztem mniejszego marginesu szumu. Wymaga niższego tłumienia kanału i zaawansowanych korekcji błędów (FEC – RS-FEC, FC-FEC).

RS-FEC (Reed-Solomon Forward Error Correction) jest obowiązkowy dla 25 GbE i wyższych. Wprowadza narzut ~3% (544/514 kodowanie) i opóźnienie ~100 ns, ale poprawia stosunek sygnału do szumu o ~2 dB.

Karty 100 GbE (Intel E810, Mellanox ConnectX-5/6) są standardem w serwerach HPC i chmurze. Karta Intel E810 oferuje 2 porty 100 GbE na PCIe Gen4 x16 (32 GB/s wystarcza dla 2×12.5 GB/s = 25 GB/s).

Okablowanie MPO/MTP (wielowłóknowe) jest standardem dla SR4/SR8 – jeden kabel MPO-12 zastępuje 6 kabli duplex LC. MPO-16 dla 400GBASE-SR8 wymaga precyzyjnego ułożenia włókien (polaryzacja typu A, B lub C).

20/23 RDMA – Remote Direct Memory Access

RoCEv2, iWARP, InfiniBand – bezpośredni dostęp do pamięci zdalnej

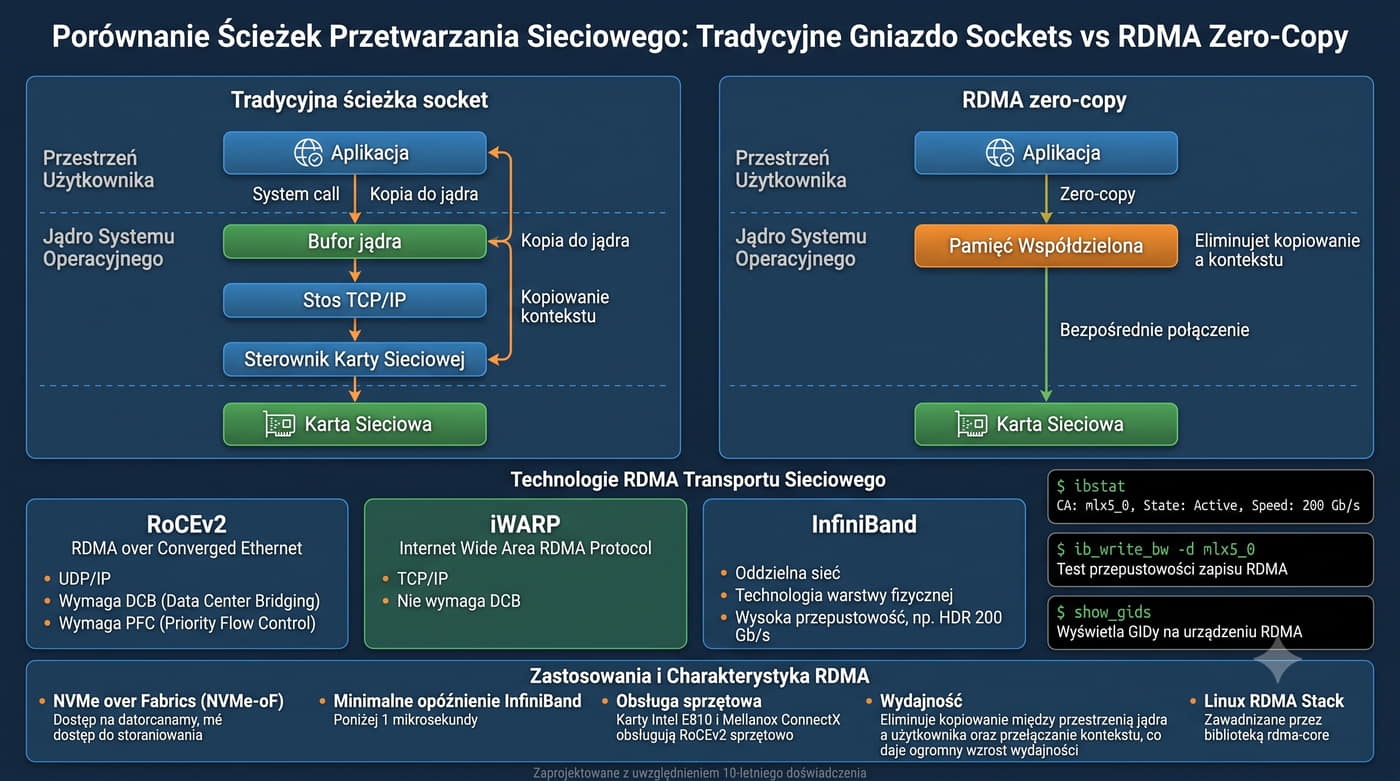
  • RDMA (Remote Direct Memory Access): Mechanizm pozwalający aplikacji odczytać/zapisać pamięć zdalnego komputera bez angażowania CPU, jądra OS i bez kopiowania danych (zero-copy).
  • RoCEv2 (RDMA over Converged Ethernet v2): RDMA przez UDP/IP (RFC 5040). Wymaga DCB (Data Center Bridging) – PFC (802.1Qbb), ETS (802.1Qaz). Karty: Mellanox ConnectX, Intel E810, Broadcom NetXtreme.
  • iWARP: RDMA przez TCP (RFC 5040-5042). Nie wymaga DCB, ale ma większe opóźnienie przez stos TCP. Karty: Intel I350 (częściowo), Chelsio T5/T6.
  • InfiniBand: Oddzielna sieć (nie Ethernet) z własnymi przełącznikami i kartami (HCA). Przepustowość: HDR (200 Gb/s), NDR (400 Gb/s), XDR (800 Gb/s). Najmniejsze opóźnienie (<1 us).
# Sprawdzenie obsługi RDMA na karcie
ibstat
CA: 'mlx5_0'
State: Active
Physical state: LinkUp
Speed: 200 Gb/s (4x HDR)

# Test przepustowości RDMA
ib_write_bw -d mlx5_0
# Sprawdzenie konfiguracji RoCE (GID)
show_gids

RDMA eliminuje trzy główne źródła opóźnienia w tradycyjnym przetwarzaniu sieciowym: kopiowanie między przestrzenią jądra a użytkownika (zero-copy), przełączanie kontekstu (context switch) i przetwarzanie stosu TCP/IP (kernel bypass).

RoCEv2 enkapsuluje pakiety RDMA w UDP (port 4791). Dla poprawnego działania wymaga włączonego PFC (Priority Flow Control – 802.1Qbb) na przełącznikach, aby uniknąć utraty pakietów (RDMA jest wrażliwy na straty – retransmisja odbywa się na poziomie transportu).

NVMe over Fabrics (NVMe-oF) to zastosowanie RDMA do dostępu do pamięci masowej – serwer NVMe-oF może obsłużyć miliony IOPS z opóźnieniem poniżej 10 us. To standard w nowoczesnych macierzach all-flash.

W systemie Linux stos RDMA obsługuje biblioteka rdma-core (librdmacm, libibverbs). Narzędzia: ibv_devinfo, ibv_rc_pingpong, rdma link show, rping (test iWARP).

InfiniBand pozostaje liderem w HPC (Top500) – oferuje najniższe opóźnienia (<0.6 us MPI latency) i najwyższe przepustowości. Jednak koszt infrastruktury (przełączniki, kable) jest znacznie wyższy niż w przypadku Ethernet.

21/23 MACsec, IPsec i bezpieczeństwo kart sieciowych

Sprzętowe szyfrowanie ruchu sieciowego na karcie PCIe

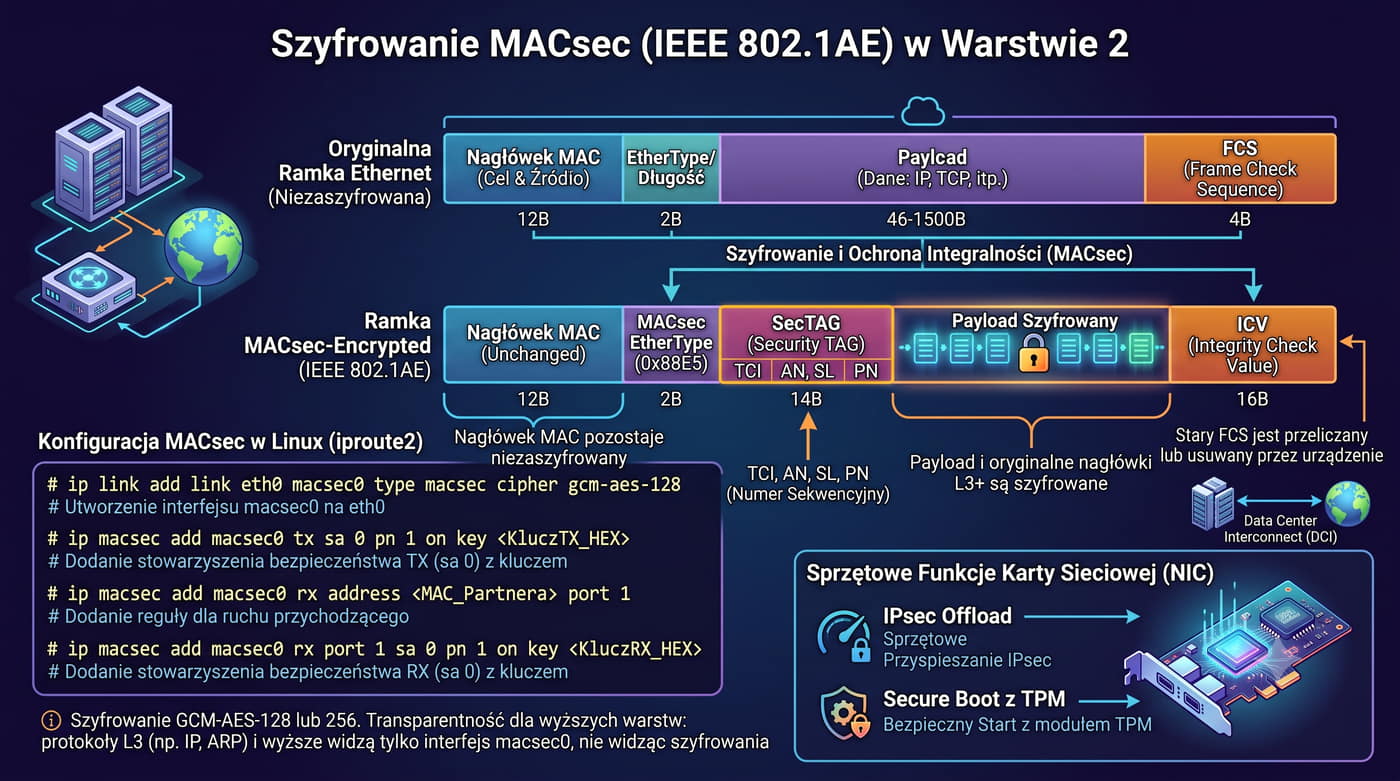
  • MACsec (IEEE 802.1AE): Szyfrowanie i uwierzytelnianie na warstwie 2 (Ethernet). Każda ramka jest szyfrowana GCM-AES-128/256 z kluczem sesji. Karty: Intel I350, Mellanox ConnectX, Broadcom NetXtreme.
  • IPsec offload: Sprzętowe szyfrowanie/deszyfrowanie ESP/AH, obliczanie ICV, obsługa SA (Security Association). Odciąża CPU przy VPN IPsec. Karty: Intel E810, Mellanox ConnectX-6, Chelsio T6.
  • Secure Boot i Measured Boot: Karta weryfikuje podpis cyfrowy firmware przed uruchomieniem. Mierzy łańcuch zaufania (TPM, UEFI). Zapobiega atakom na firmware karty (malicious DMA).
  • Trusted Platform Module (TPM) na karcie: Niektóre karty (BlueField, Intel IPU) mają wbudowany TPM 2.0 do przechowywania kluczy i attestacji sprzętowej.
# Sprawdzenie obsługi MACsec na interfejsie
ip macsec show
# Konfiguracja MACsec (przykład z key server)
ip link add link eth0 macsec0 type macsec cipher gcm-aes-128
ip macsec add macsec0 tx sa 0 pn 1 key 02 09876543210987654321098765432109
ip macsec add macsec0 rx address 00:1a:2b:3c:4d:5e port 1
ip macsec add macsec0 rx address 00:1a:2b:3c:4d:5e port 1 sa 0 pn 1 key 02 01234567890123456789012345678901

MACsec działa na warstwie 2, przez co jest transparentny dla wyższych warstw – nie wymaga zmian w aplikacjach. Każda ramka otrzymuje nowy wektor inicjalizacyjny (PN – Packet Number) i znacznik ICV (Integrity Check Value). Idealne do szyfrowania ruchu między centrami danych (DCI).

IPsec offload na karcie sieciowej przyspiesza szyfrowanie VPN. W Linux konfiguracja odbywa się przez strongSwan/libreswan z XFRM. Karta przejmuje obliczenia kryptograficzne (AES-GCM, SHA-256), co na CPU daje wzrost wydajności nawet 5-10x w porównaniu do szyfrowania programowego.

Bezpieczeństwo firmware karty sieciowej jest krytyczne – atak na firmware NIC (np. Bootkit przez DMA) może pozwolić attackerowi na odczyt pamięci hosta. Intel i Mellanox stosują podpisywanie firmware i Secure Boot na karcie.

NC-SI (Network Controller Sideband Interface) i MCTP (Management Component Transport Protocol) pozwalają na zarządzanie kartą przez BMC (IPMI, Redfish) nawet gdy host jest wyłączony – to dodatkowa powierzchnia ataku wymagająca zabezpieczenia.

W środowiskach chmurowych karty z MACsec/IPsec offload są niezbędne do szyfrowania ruchu między dzierżawcami (tenant isolation) bez obciążania CPU serwera.

22/23 MSI, MSI-X, irqbalance i zarządzanie przerwaniami

Nowoczesne mechanizmy przerwań w kartach PCI Express

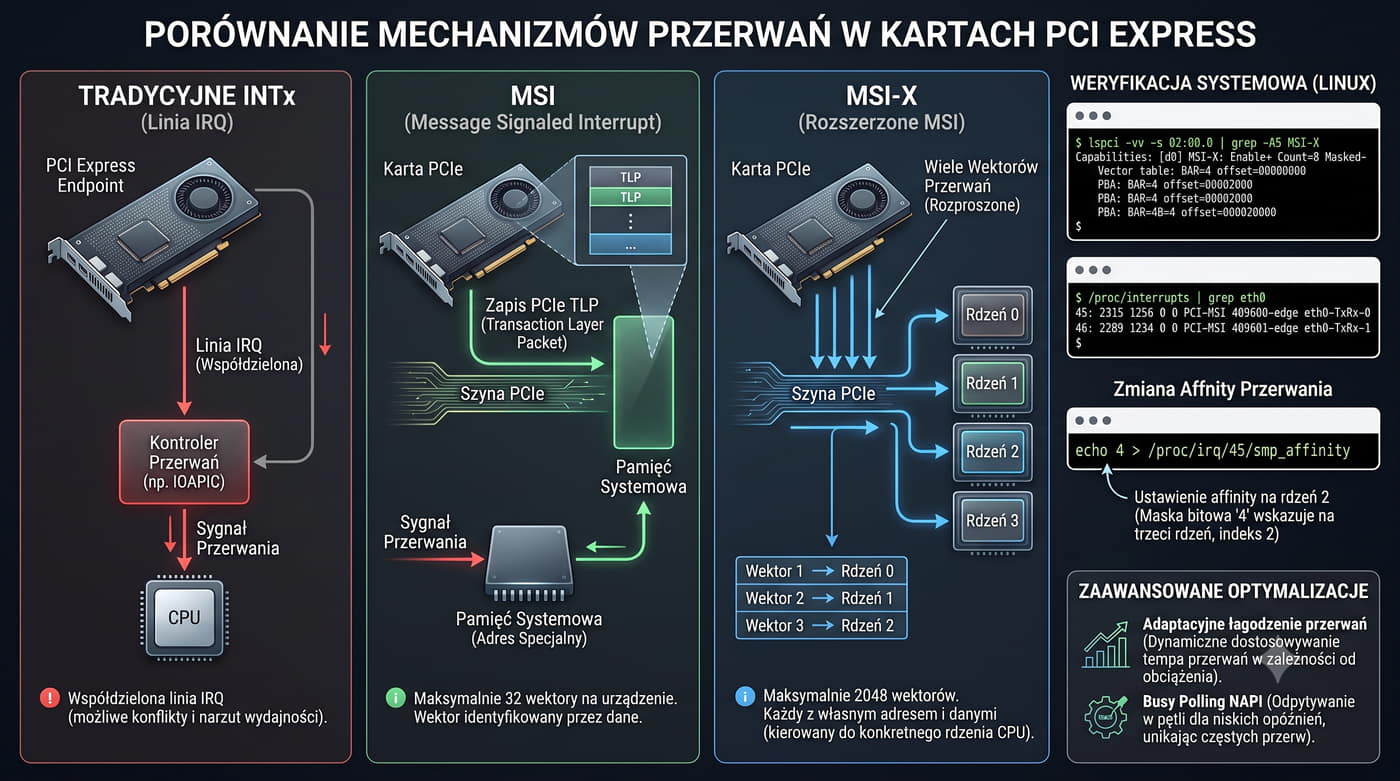
  • MSI (Message Signaled Interrupt): Przerwanie generowane przez zapis PCIe TLP do specjalnego adresu pamięci zamiast sygnału na linii IRQ. Do 32 wektorów na urządzenie, wspólny adres, różne dane.
  • MSI-X: Rozszerzenie MSI – do 2048 wektorów na urządzenie, każdy z własnym adresem i danymi. Każdemu wektorowi można przypisać inny rdzeń CPU (IRQ affinity). Wymagane dla RSS na wielu kolejkach.
  • irqbalance: Usługa systemowa dystrybuująca przerwania sprzętowe między rdzenie CPU – zapobiega przeciążeniu pojedynczego rdzenia przy intensywnym ruchu sieciowym.
  • Adaptive Interrupt Moderation: Karta dynamicznie reguluje częstotliwość przerwań – przy niskim ruchu wysyła przerwanie po każdym pakiecie (niskie opóźnienie), przy wysokim grupuje pakiety (niski narzut CPU).
# Sprawdzenie MSI-X na karcie sieciowej
lspci -vv -s 02:00.0 | grep -A5 "MSI-X"
Capabilities: [b0] MSI-X: Enable+ Count=4 Masked-
Vector table: BAR=0 offset=00002000
PBA: BAR=0 offset=00003000

# Mapa przerwań (IRQ affinity)
cat /proc/interrupts | grep eth0
 45:  12345  0  0  0  PCI-MSI  eth0-TxRx-0
 46:      0  2345  0  0  PCI-MSI  eth0-TxRx-1

# Ustawienie affinity przerwania na rdzeń 2
echo 4 > /proc/irq/45/smp_affinity

MSI-X jest kluczowe dla nowoczesnych kart wielordzeniowych – każda para kolejek Tx/Rx może mieć własny wektor przerwania, co pozwala na rozłożenie obsługi ruchu sieciowego na wiele rdzeni CPU. Karty z 64 kolejkami (np. Mellanox ConnectX) mogą używać 64 wektorów MSI-X.

W Linux mechanizm XPS (Transmit Packet Steering) i RPS (Receive Packet Steering) umożliwiają programowe kierowanie pakietów do konkretnych rdzeni w jądrze, niezależnie od sprzętowego RSS. Konfiguracja przez /sys/class/net/eth0/queues/.

Adaptive Interrupt Moderation (nazywane też adaptive RX/TX coalescing) konfiguruje się w ethtool: ethtool -C eth0 adaptive-rx on adaptive-tx on. Można też ustawić stałe wartości: rx-usecs 100 (opóźnienie 100 us) dla niższego narzutu CPU kosztem opóźnienia.

Interrupt coalescing grupuje przychodzące pakiety przed wywołaniem przerwania – im dłuższe opóźnienie, tym mniej przerwań na sekundę (więcej pakietów na przerwanie), ale wyższe opóźnienie. Dla 10 GbE przy 64B pakietach: ~14.8 Mpps, przy 1 przerwaniu na 100 pakietów → ~148k IRQ/s na kolejkę.

Busy polling (NAPI) w Linux – tryb, w którym jądro cyklicznie sprawdza nowe pakiety zamiast czekać na przerwanie. Redukuje opóźnienie przy wysokim ruchu kosztem 100% użycia rdzenia. Konfiguracja: echo 2 > /sys/class/net/eth0/gro_flush_timeout.

23/23 NUMA, wielordzeniowe przetwarzanie i strojenie wydajności

Topologia NUMA, pinowanie procesów, dobór kolejek

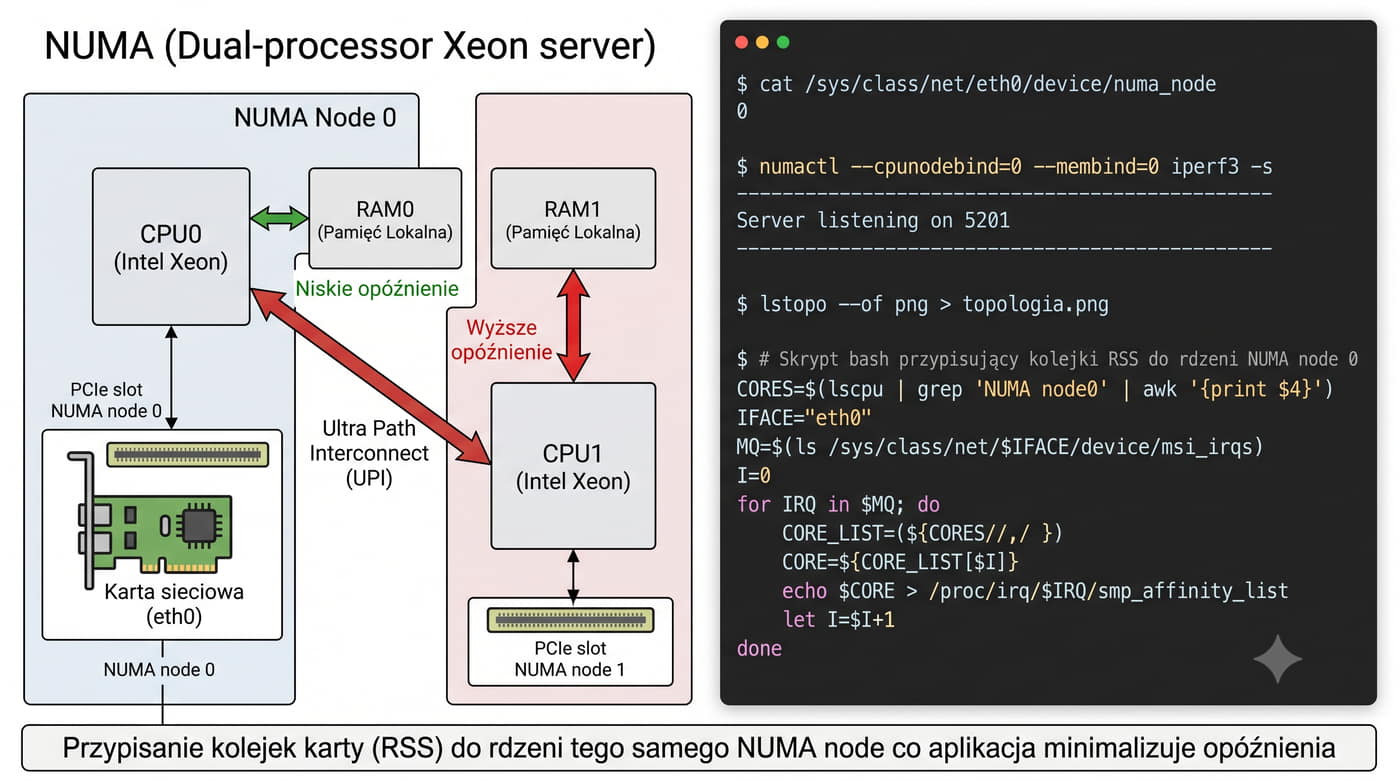
  • NUMA (Non-Uniform Memory Access): W systemach wieloprocesorowych każdy procesor ma własną, lokalną pamięć RAM. Dostęp do pamięci innego procesora (remote) jest wolniejszy (większe opóźnienie i mniejsza przepustowość).
  • PCIe a NUMA: Każdy slot PCIe jest przypisany do konkretnego procesora (NUMA node). Jeśli karta jest na node 0, a aplikacja na node 1, każdy pakiet przechodzi przez most QPI/UPI – to dodatkowe opóźnienie.
  • CPU Pinning i Queue Steering: Przypisanie kolejek karty (RSS) do rdzeni tego samego NUMA node co aplikacja. W Linux: /proc/irq/*/smp_affinity, ethtool -X, numactl --cpunodebind.
  • Narzędzia do analizy topologii: lstopo (hwloc), numactl --hardware, lscpu, /sys/devices/system/cpu/ – identyfikacja NUMA node i przypisania PCIe.
# Identyfikacja NUMA node karty sieciowej
cat /sys/class/net/eth0/device/numa_node
0
# Uruchomienie aplikacji na tym samym NUMA node
numactl --cpunodebind=0 --membind=0 iperf3 -s
# Wyświetlenie topologii procesora i PCIe
lstopo --of png > topologia.png
# Przypisanie kolejek RSS do rdzeni NUMA node 0
for i in 0 1 2 3; do echo 1 > /sys/class/net/eth0/queues/rx-$i/rps_cpus; done

W dwuprocesorowym serwerze (np. Intel Xeon) karta PCIe w slocie blisko CPU0 jest przypisana do NUMA node 0. Jeśli proces aplikacji (np. serwer WWW) działa na CPU1, a karta jest na node 0, każdy dostęp do bufora pakietów przechodzi przez most UPI (Ultra Path Interconnect) – tracimy 30-70 ns na dostęp.

Aby tego uniknąć, należy: (1) sprawdzić NUMA node karty, (2) uruchomić aplikację na tym samym node (numactl --cpunodebind), (3) przypisać przerwania karty do rdzeni tego node, (4) użyć RSS z haszowaniem rozkładającym ruch równomiernie na dostępne kolejki.

W systemach jednoprocesorowych (socket) NUMA może być wirtualny (Intel Cluster-on-Die, AMD Zen) – podział na logiczne NUMA domeny wewnątrz jednego układu. Różnice w opóźnieniu są mniejsze (10-20%), ale nadal znaczące przy 100 GbE.

Dobór liczby kolejek RSS: optymalnie tyle, ile rdzeni w NUMA node przypisanym do karty. Zbyt dużo kolejek (więcej niż rdzeni) nie poprawia wydajności – przerwania konkurują o te same rdzenie (thundering herd), a przełączanie kontekstu zwiększa opóźnienie.

Zaawansowane strojenie obejmuje: ustawienie buforów pierścieniowych (ethtool -G), wybór polityki zarządzania energią (tuned-adm profile network-throughput), wyłączenie usług zakłócających (irqbalance, chrony), ustawienie priorytetu procesu (chrt -f 99).

Wielkość MTU (jumbo frames – 9000 B) na szybkich kartach zmniejsza liczbę przerwań na sekundę i narzut nagłówków. Dla 10 GbE: 64B pakiety → 14.8 Mpps, 1500B → 0.82 Mpps, 9000B → 0.14 Mpps. Mniej przerwań = niższe obciążenie CPU.